从标准数据类型、标准扩展数据类型,到自定义数据类型,我们用3篇文章讲透了CoDeSys的整个数据类型体系。在实际项目开发中,很多开发者不是“不会用”,而是“用不好”——比如选了不合适的类型导致内存浪费、使用指针/联合体时出现数据错乱、数组下标越界导致程序崩溃……
本文作为CoDeSys数据类型系列的终篇,将从实战角度出发,总结数据类型选择技巧、内存优化方法、常见错误与避坑指南,并结合工业项目案例,给出最佳实践方案,让你不仅会用CoDeSys数据类型,还能用得高效、用得安全、用得规范。
一、数据类型核心选择技巧:按需选择,匹配场景
选择数据类型的核心原则是:“够用就好,匹配场景”——不盲目选择大类型(如用LINT存储0~100的数值),也不选择小类型导致取值范围不足,同时结合变量的用途、取值范围、运算需求选择,具体技巧如下:
1. 开关量(二值状态):优先选BOOL
- 适用场景:传感器信号、阀门状态、电机启停、报警灯、按钮等;
- 避坑:不要用INT/UINT存储开关量,浪费内存;BOOL数组不节省内存,无需为了节省内存使用BOOL数组。
2. 整数数值:优先选匹配取值范围的整型,遵循“最小够用”
|
取值范围 |
推荐类型 |
适用场景 |
|
0~255 |
BYTE/USINT |
单字节寄存器、8位无符号数据、小范围计数 |
|
-128~127 |
SINT |
8位有符号小范围数据 |
|
0~65535 |
WORD/UINT |
16位无符号计数、模拟量标度值(0~65535) |
|
-32768~32767 |
INT |
16位有符号计数、常规整数运算、小范围模拟量 |
|
0~4294967295 |
DWORD/UDINT |
32位无符号大范围计数、内存地址、设备编号 |
|
-2147483648~2147483647 |
DINT |
32位有符号大范围计数、大型产线累计产量 |
✅ 示例:计数范围0~1000,选UINT即可,无需选UDINT/DINT,节省内存。
3. 小数数值:优先选REAL,高精度场景选LREAL(需确认PLC支持)
- 适用场景:温度、压力、流量、转速等模拟量,浮点运算;
- 避坑:LREAL并非所有PLC都支持,编译前需查看目标设备手册,避免转换为REAL导致精度丢失;实数转整型时,需判断是否超出整型范围,否则结果不确定。
4. 字符处理:优先选STRING(指定长度),多语言选WSTRING
- 核心技巧:务必指定字符串长度,按实际需要的最大字符数定义,避免默认80字符导致内存浪费;
- 示例:存储设备厂家名称(最多20个字符),选STRING(20),而非默认STRING。
5. 时间/日期:按需选择专用时间类型,严格遵循格式
- 短时间计时(如设备运行时长):用TIME(毫秒级,满足常规需求);
- 高精度计时(如高速设备):用LTIME(纳秒级);
- 时刻(如上班时间):用TIME_OF_DAY/TOD;
- 日期(如生产日期):用DATE;
- 日期+时刻(如故障发生时间):用DATE_AND_TIME/DT;
- 避坑:时间类型必须加前缀(如T#、TOD#),单位按顺序排列,否则编译报错。
6. 复杂场景:优先选扩展类型/自定义类型
|
应用场景 |
推荐数据类型 |
|
数据拆分/整合(如2BYTE→1WORD) |
联合体(UNION) |
|
高精度纳秒计时 |
长时间(LTIME) |
|
变量别名,简化复杂引用 |
引用(REFERENCE TO) |
|
间接访问内存,动态操作数据 |
指针(POINTER TO)(配合校验) |
|
批量处理同类型数据 |
数组(ARRAY) |
|
封装对象的不同类型参数 |
结构体(STRUCT) |
|
批量管理多对象(如多台电机) |
结构体数组(ARRAY OF STRUCT) |
|
定义离散状态(如运行/故障/停止) |
枚举(ENUM) |
|
限定数值范围,软件钳位(如模拟量输出) |
子范围(SUBRANGE) |
二、内存优化指南:CoDeSys数据类型内存节省技巧
PLC的内存资源有限(尤其是小型PLC),数据类型的选择直接影响内存占用,掌握以下技巧,可大幅节省内存,提升程序运行效率:
1. 整型:遵循“最小够用”原则,不盲目选大类型
- 1个LINT(64位)占用8字节,1个UINT(16位)仅占用2字节,若取值范围允许,优先选小类型;
- 示例:计数范围0~100,用USINT(1字节)比用UDINT(4字节)节省3字节,大量变量时效果显著。
2. 字符串:强制指定长度,避免默认80字符
- 未指定长度的STRING占用81字节,指定为STRING(10)仅占用11字节,节省70字节/个;
- 项目中有大量字符串变量时(如设备名称、故障信息),这是最有效的内存优化手段。
3. 多参数对象:用结构体封装,避免零散变量的内存对齐浪费
- CoDeSys为变量分配内存时,会按数据类型长度对齐(如INT按2字节对齐,DWORD按4字节对齐),零散变量会因对齐产生内存碎片;
- 结构体封装后,成员按声明顺序连续存储,减少内存碎片,节省内存。
4. 同内存多类型解析:用联合体,避免分配独立内存
- 联合体所有成员共用同一段内存,比如用联合体存储BYTE/WORD/DWORD,仅占用4字节(DWORD长度),而单独声明则占用1+2+4=7字节,节省3字节。
5. 布尔量:避免大量单独BOOL变量,可用BYTE/WORD按位存储
- 1个BOOL变量占用8字节,而1个BYTE(8字节)可按位存储8个布尔量,节省7/8的内存;
- 示例:8个传感器信号,用1个BYTE存储,通过位操作bSensor := BYTE.0访问,比8个单独BOOL变量节省56字节。
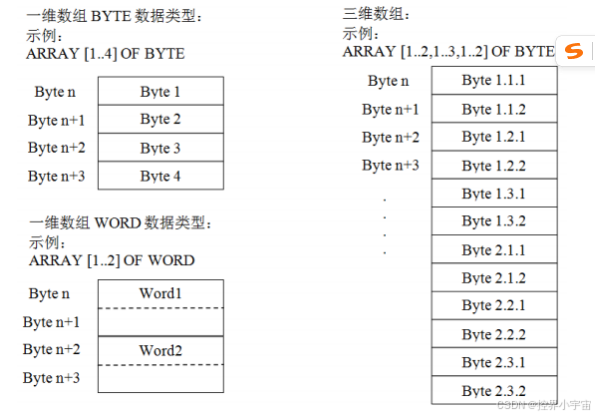
6. 数组:按需定义维度和大小,避免过度定义
- 不要定义超出实际需求的数组大小(如实际需要10个温度点,定义成[1..20]),浪费内存;
- 三维数组占用内存较大,非必要不使用,可拆分为多个二维/一维数组。
三、CoDeSys数据类型常见错误与避坑指南
在实际开发中,数据类型的错误是最常见的编程错误之一,轻则编译报错,重则程序运行异常、设备故障,以下是高频错误、原因分析与避坑方案,建议收藏。
错误1:类型不匹配赋值(如整型赋值给布尔型)
- 现象:编译报错C0032:不能将类型‘USINT’转化为类型‘BOOL’;
- 原因:不同类型变量直接赋值,CoDeSys不支持隐式转换(除了子范围与基本整型);
- 避坑方案:
示例:bFlag := INT_TO_BOOL(nValue);(将INT转换为BOOL后赋值)。
错误2:字符串赋值长度超出定义,导致数据截断
- 现象:赋值的字符串被从右至左截断,如STRING(12)赋值'Hello CoDeSys',结果为'Hello CoDeSy';
- 原因:字符串定义长度小于赋值字符串的实际长度,CoDeSys自动截断;
- 避坑方案:定义字符串时,按实际最大需要的字符数+1(预留结束符),避免截断。
错误3:数组下标越界(如[1..10]的数组访问[11])
- 现象:程序运行异常、数据错乱,甚至PLC死机;
- 原因:访问了数组定义范围之外的元素,导致内存越界;
- 避坑方案:
错误4:指针使用不当(如空指针、地址偏移错误)
- 现象:程序崩溃、内存数据错乱、PLC通讯中断;
- 常见原因:指针未绑定有效地址、地址偏移量与数据类型不匹配、访问已释放的内存;
- 避坑方案(指针安全使用三原则):
错误5:联合体成员类型长度不一致,导致数据错乱
- 现象:修改一个成员,其他成员的值出现乱码,非预期结果;
- 原因:联合体成员的内存长度不一致,修改短成员会覆盖长成员的部分内存;
- 避坑方案:定义联合体时,确保所有成员的内存长度一致,如BYTE/WORD/DWORD分别组成联合体,不混合使用。
错误6:枚举变量赋值非定义值,导致程序逻辑混乱
- 现象:程序运行逻辑异常,无法按预期执行;
- 原因:直接给枚举变量赋值整型数值(如eStatus := 5),而5并非定义的枚举状态;
- 避坑方案:
错误7:子范围未添加校验函数,导致赋值超出范围编译报错
- 现象:赋值超出子范围上下限的数值,编译报错C0032;
- 原因:未添加范围校验函数,CoDeSys不允许超出范围的赋值;
- 避坑方案:添加范围校验函数CheckRangeSigned/CheckRangeUnsigned,实现自动钳位(超出范围自动赋值为上下限),而非编译报错。
四、CoDeSys数据类型最佳实践:工业项目案例
结合以上技巧,以一条小型产线(2台电机+8个温度采集点+4个阀门) 为例,给出数据类型的最佳实践方案,让你直接复用。
项目需求
数据类型设计方案