代码实现
// 核心方法:对异位词进行分组
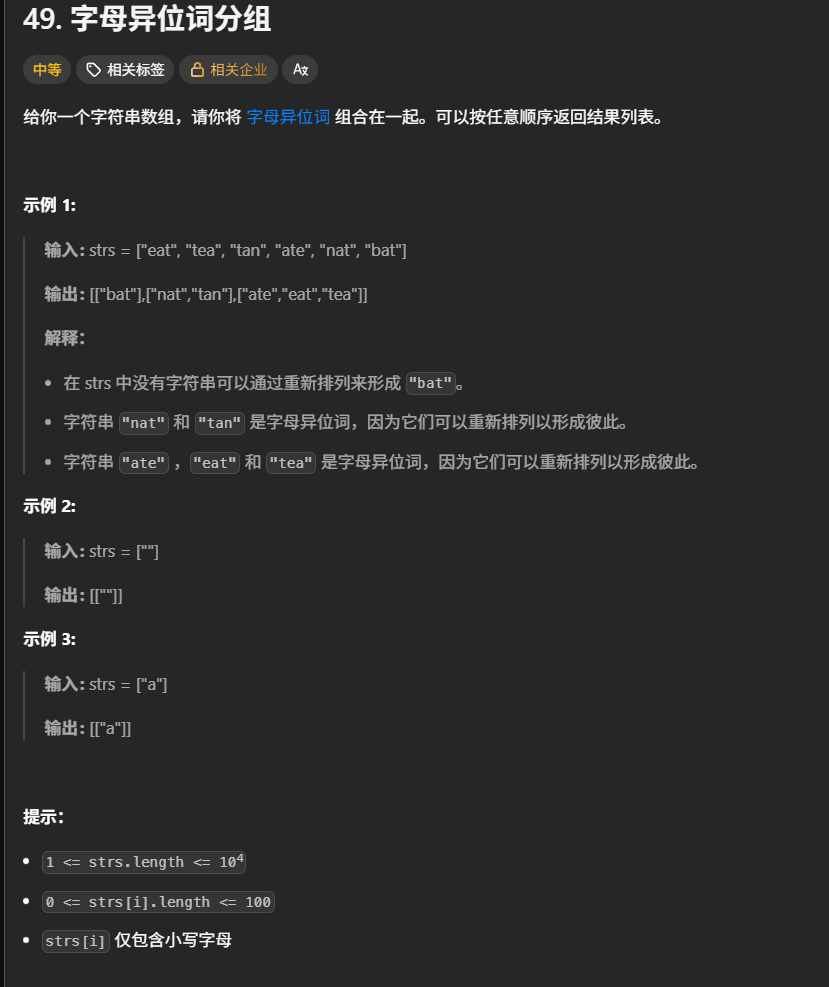
public List<List<String>> groupAnagrams(String[] strs) {
// 定义哈希表:key=排序后的标准化字符串,value=对应异位词列表
Map<String, List<String>> map = new HashMap<>();
for (String s : strs) {
// 1. 将字符串转为字符数组(方便排序,String是不可变的)
char[] charArr = s.toCharArray();
// 2. 对字符数组排序(异位词排序后数组完全相同)
Arrays.sort(charArr);
// 3. 排序后的字符数组转回字符串,作为Map的key
String key = new String(charArr);
// 4. 若key不存在,新建空列表;存在则直接获取已有列表
if (!map.containsKey(key)) {
map.put(key, new ArrayList<>());
}
// 5. 将原字符串加入对应key的列表中
map.get(key).add(s);
}
// 6. 将Map的所有value转为List返回(即最终的分组结果)
return new ArrayList<>(map.values());
核心代码解释
部分代码优化
for (String s : strs) {
char[] charArr = s.toCharArray();
Arrays.sort(charArr);
String key = new String(charArr);
// computeIfAbsent:key不存在则执行第二个参数新建列表,存在则直接返回已有列表
map.computeIfAbsent(key, k -> new ArrayList<>()).add(s);
}