一、为什么需要 JMM?(先建立直觉)
先想一个问题 多线程访问同一个变量,为什么会出问题?
int a = 0; // 线程1 a = 1; // 线程2 System.out.println(a);
你以为一定打印 1? 不一定。
原因不在 Java 语法,而在 硬件 + 编译器 + CPU 优化:
-
CPU 有 多级缓存
-
编译器会 指令重排
-
不同线程可能运行在 不同 CPU 核心
JMM 的本质目标:
在各种 CPU、操作系统、编译器下, 规范多线程如何“看到”内存数据
二、JMM 到底是什么?
JMM(Java 内存模型)是 Java 规范的一部分,不是 JVM 实现
它做了三件事:
定义 线程与内存之间如何交互
规定 哪些重排序是允许的
提供 并发安全的可见性、原子性、有序性保证
注意: JMM 不关心内存多大、不关心 GC,只关心 并发语义
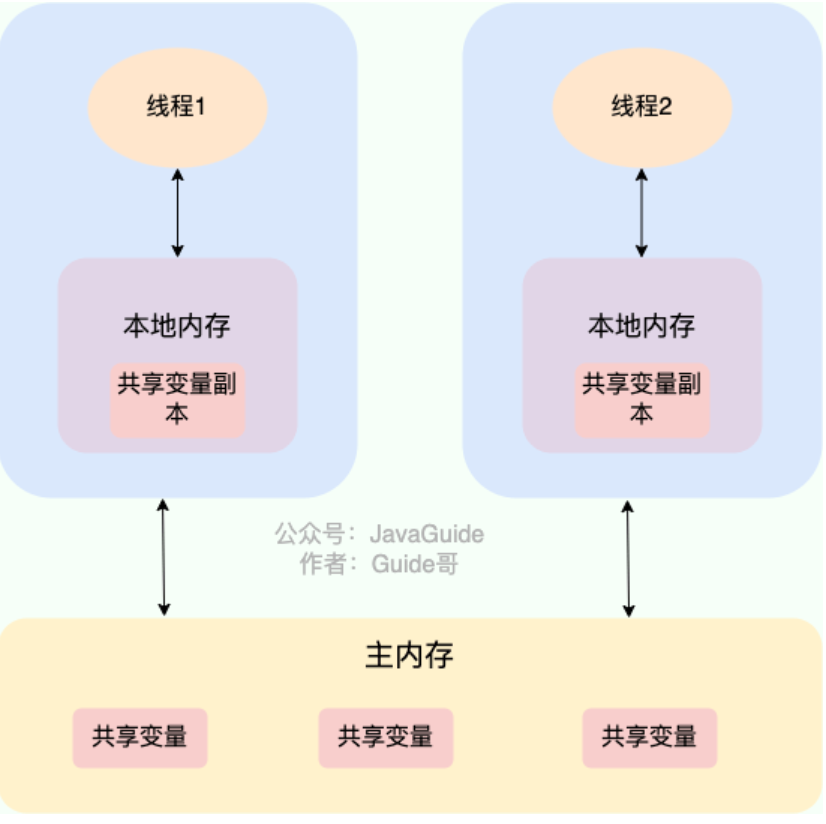
下图来自于JMM(Java 内存模型)详解 | JavaGuide
三、JMM 的核心结构
主内存 & 工作内存
JMM 抽象出两个概念:
- 主内存:所有线程创建的实例对象都存放在主内存中,不管该实例对象是成员变量,还是局部变量,类信息、常量、静态变量都是放在主内存中。为了获取更好的运行速度,虚拟机及硬件系统可能会让工作内存优先存储于寄存器和高速缓存中。
- 本地内存:每个线程都有一个私有的本地内存,本地内存存储了该线程已读 / 写共享变量的副本。每个线程只能操作自己本地内存中的变量,无法直接访问其他线程的本地内存。如果线程间需要通信,必须通过主内存来进行。本地内存是 JMM 抽象出来的一个概念,并不真实存在,它涵盖了缓存、写缓冲区、寄存器以及其他的硬件和编译器优化。
主内存是所有线程共享的内存区域,用来存放共享变量; 工作内存是每个线程私有的内存区域,保存共享变量的副本, 线程对变量的读写必须先在工作内存中进行,再同步到主内存。
主内存与工作内存的交互流程(完整示例)
示例代码
class Example {
static int count = 0;
}
现在有两个线程 A 和 B 同时操作 count。
1. 初始状态
-
主内存:count = 0
-
线程 A 工作内存:空
-
线程 B 工作内存:空
2. 线程 A 读取 count
-
从主内存读取 count = 0
-
保存到线程 A 的工作内存
3. 线程 B 读取 count
-
从主内存读取 count = 0
-
保存到线程 B 的工作内存
4. 线程 A 修改 count
count++;
-
线程 A 在自己的工作内存中将 count 改为 1
-
此时主内存仍然是 0
5. 线程 B 继续使用旧值
-
线程 B 仍然使用自己工作内存中的 count = 0
-
无法感知线程 A 的修改
这就是典型的 可见性问题。
四、JMM 三大核心特性(重点)
1️⃣ 原子性(Atomicity)
一个操作,要么全部执行,要么不执行
原子操作
-
基本类型读写(除 long / double 在旧规范中)
-
AtomicInteger.incrementAndGet()
非原子操作
i++; // 实际是 3 步
// 1. 读 i
// 2. i + 1
// 3. 写回
解决方案:
-
synchronized
-
Lock
-
原子类(CAS)
2️⃣ 可见性(Visibility)
一个线程修改变量,其他线程能立即看到
问题代码
private boolean running = true;
解决方式
private volatile boolean running = true;
volatile 的本质作用:
-
写:立即刷新到主内存
-
读:每次从主内存读取
3️⃣ 有序性(Ordering)
程序执行顺序,是否和代码顺序一致?
指令重排示例
int a = 1;
int b = 2;
编译器可能变成:
int b = 2;
int a = 1;
单线程没问题,多线程可能炸。
五、happens-before 规则(JMM 灵魂)
JMM 通过 happens-before 规则来保证有序性。
- 官方定义:如果操作 A happens-before 操作 B(记作 A hb-> B),那么 A 的执行结果对 B 可见,且 A 的执行顺序一定在 B 之前;
- 传递性:如果 A hb-> B 且 B hb-> C,那么自动推导 A hb-> C;
- 关键误区:happens-before 描述的是结果可见性和执行顺序约束,不是字面意义上的 “先执行完”,它屏蔽了底层指令重排的细节,是程序员编写并发代码的语义保证。
几个你必须记住的规则
1️⃣ 程序顺序规则
规则:在同一个线程内,按照代码的书写顺序,前面的操作 happens-before 后面的所有操作。
- 说明:单线程下,JMM 保证最终执行结果和代码顺序执行的结果一致;即使发生指令重排,也不会破坏单线程的执行结果。
- 示例: // 单线程中
int a = 1; // 操作A
int b = 2; // 操作B
// A hb-> B,a的赋值结果对b可见
2️⃣ volatile 规则
规则:对一个volatile变量的写操作 happens-before 后续对该变量的读操作。
- 说明:volatile 禁止指令重排序,同时保证可见性,是轻量级的线程同步方案;
- 场景:常用于状态标记位(如线程停止标志)。
3️⃣ 锁规则
规则:对同一个锁的解锁操作 happens-before 后续对该锁的加锁操作。
- 说明:这是synchronized能保证线程安全的底层依据,线程 A 释放锁前的所有修改,对后续获取同一把锁的线程 B 完全可见。
- 示例:
- Object lock = new Object();
int num = 0;// 线程1
synchronized (lock) { // 加锁
num = 10; // 修改共享变量
} // 解锁:操作U// 线程2
synchronized (lock) { // 加锁:操作L
System.out.println(num); // 一定输出10
}
// 解锁U hb-> 加锁L,线程1的修改对线程2可见
4️⃣ 线程启动规则
规则:Thread.start() 方法调用 happens-before 该线程内的所有操作。
Thread t = new Thread(() -> {
// 线程体操作:操作B
System.out.println("线程运行");
});
// 主线程执行start:操作A
t.start();
// A hb-> B,主线程在start前的修改,对子线程完全可见
5️⃣ 线程终止规则
规则:线程内的所有操作 happens-before 其他线程检测到该线程终止(thread.join()返回、thread.isAlive()返回 false)。
Thread t = new Thread(() -> num = 100);
t.start();
t.join(); // 主线程阻塞等待t结束
// 线程t的所有操作 hb-> join()返回,此时主线程读取num一定为100
一句话总结:
happens-before 保证的是可见性和有序性,而不是时间先后