用一个最小可计算的例子,把 CBOW(Continuous Bag of Words)的前向计算、softmax、损失与反向传播的直觉一次讲清楚。
一、问题设定
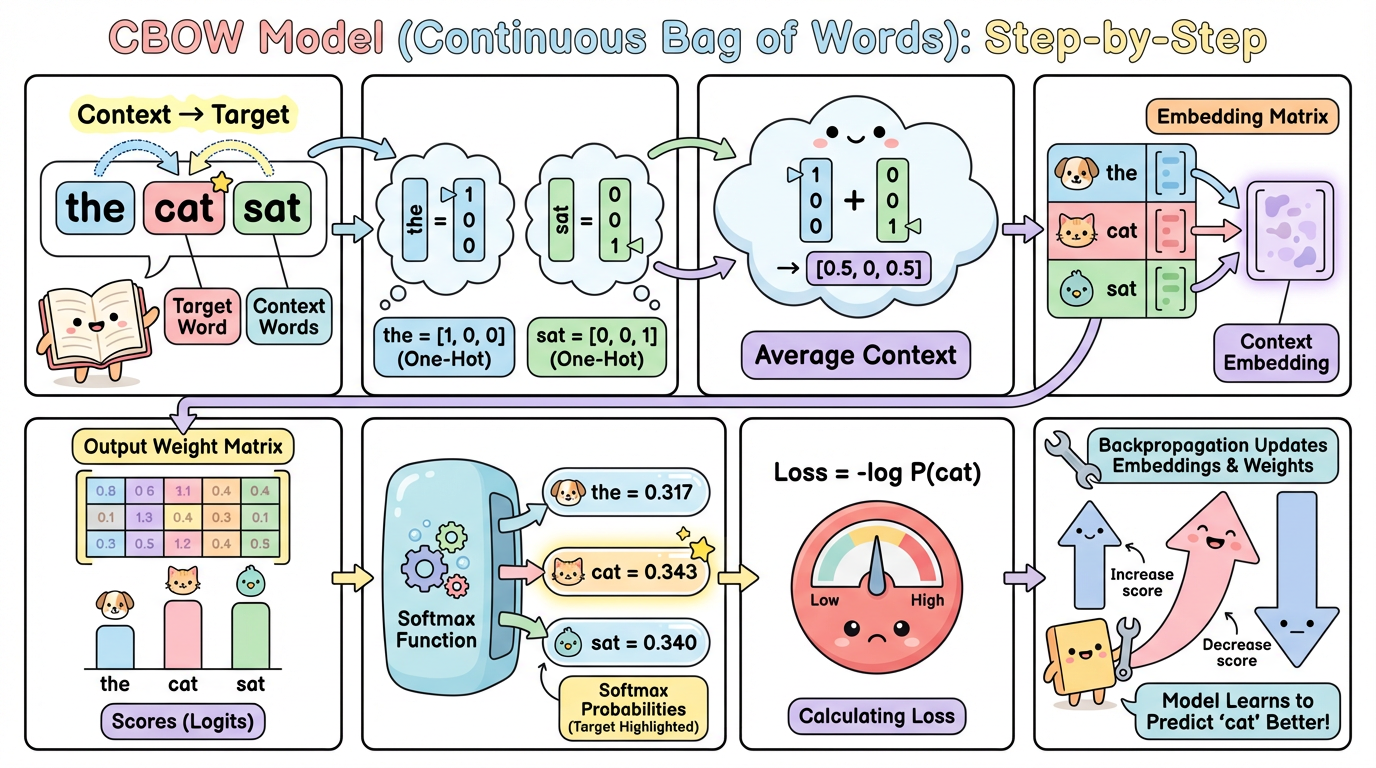
我们用一个极小的例子来理解 CBOW 的核心思想:根据上下文词 ["the", "sat"],预测中心词 "cat"。
-
示例句子(窗口大小 = 1):
the cat sat
- 目标词(Target):cat
- 上下文词(Context):[the, sat]
-
词表(Vocabulary):
["the", "cat", "sat"]
-
词表大小
∣
V
∣
=
3
|V| = 3
∣V∣=3
-
后面的所有 one-hot 向量、嵌入矩阵和输出概率,都会基于这个词表展开。
-
二、计算过程
2.1 Step1: 上下文词的独热(One-Hot)表示
按照词表顺序 [the, cat, sat]:
| the | 0 |
[ 1 , 0 , 0 ] [1, 0, 0] [1,0,0] |
| cat | 1 |
[ 0 , 1 , 0 ] [0, 1, 0] [0,1,0] |
| sat | 2 |
[ 0 , 0 , 1 ] [0, 0, 1] [0,0,1] |
上下文是 [the, sat],因此我们得到两个 one-hot 向量。
-
v
the
=
[
1
,
0
,
0
]
\\mathbf{v}_{\\text{the}}= [1,0,0]
vthe=[1,0,0] -
v
sat
=
[
0
,
0
,
1
]
\\mathbf{v}_{\\text{sat}}= [0,0,1]
vsat=[0,0,1]
2.2 Step2: 上下文向量求平均(CBOW 的核心)
CBOW 不关心顺序,只关心**“袋子里的词”**。
(1) 求和
$$ \\begin{aligned} \\mathbf{v}{\\text{[the, sat]}} &= \\mathbf{v}{\\text{the}} + \\mathbf{v}_{\\text{sat}} \\ &= [1, 0, 0] + [0, 0, 1] \\ &= [1,0,1]
\\end{aligned} $$
(2) 取平均(2 个上下文词)
v
=
1
2
v
[the, sat]
=
[
1
2
,
0
,
1
2
]
\\mathbf{v} = \\frac{1}{2} \\mathbf{v}_{\\text{[the, sat]}} = [\\frac{1}{2}, 0, \\frac{1}{2}]
v=21v[the, sat]=[21,0,21]
这个向量表示:当前上下文中,the 和 sat 各占一半。
2.3 Step3: 嵌入矩阵(Embedding Matrix)
设嵌入维度为
d
=
2
d = 2
d=2,随机初始化嵌入矩阵
W
in
∈
R
∣
V
∣
×
d
\\mathbf{W}_{\\text{in}} \\in \\mathbb{R}^{|V|×d}
Win∈R∣V∣×d:
W
in
=
[
0.1
0.2
0.0
0.5
0.3
0.8
]
\\mathbf{W}_{\\text{in}} = \\begin{bmatrix} 0.1 & 0.2 \\\\ 0.0 & 0.5 \\\\ 0.3 & 0.8 \\end{bmatrix}
Win=
0.10.00.30.20.50.8
| the | 0.1 | 0.2 |
| cat | 0.0 | 0.5 |
| sat | 0.3 | 0.8 |
每一行对应一个词的 embedding向量。
2.4 Step4: 计算上下文嵌入向量
用 平均后的 one-hot 向量 乘以嵌入矩阵:
h
=
W
in
T
v
=
[
0.1
0.0
0.3
0.2
0.5
0.8
]
[
0.5
0
0.5
]
=
[
0.2
0.5
]
\\begin{aligned} \\mathbf{h} &= \\mathbf{W}^T_{\\text{in}} \\mathbf{v} \\\\ &=\\begin{bmatrix} 0.1 & 0.0 & 0.3 \\\\ 0.2 & 0.5 & 0.8 \\end{bmatrix} \\begin{bmatrix} 0.5 \\\\ 0 \\\\ 0.5 \\end{bmatrix} \\\\ &= \\begin{bmatrix} 0.2 \\\\ 0.5 \\end{bmatrix} \\end{aligned}
h=WinTv=[0.10.20.00.50.30.8]
0.500.5
=[0.20.5]
这一步本质上是:把上下文词的 embedding 做平均。
2.5 Step5: 输出权重矩阵
输出矩阵
W
out
∈
R
d
×
∣
V
∣
\\mathbf{W}_{\\text{out}} \\in \\mathbb{R}^{d×|V|}
Wout∈Rd×∣V∣(随机初始化):
W
out
=
[
0.2
0.1
0.3
0.4
0.6
0.5
]
\\mathbf{W}_{\\text{out}} = \\begin{bmatrix} 0.2 & 0.1 & 0.3 \\\\ 0.4 & 0.6 & 0.5 \\end{bmatrix}
Wout=[0.20.40.10.60.30.5]
| dim1 | 0.2 | 0.1 | 0.3 |
| dim2 | 0.4 | 0.6 | 0.5 |
2.6 Step 6:计算每个词的打分(Logits)
W
out
T
h
=
[
0.2
0.4
0.1
0.6
0.3
0.5
]
[
0.2
0.5
]
=
[
0.24
0.32
0.31
]
\\begin{aligned} \\mathbf{W}_{\\text{out}}^T \\mathbf{h} &= \\begin{bmatrix} 0.2 & 0.4 \\\\ 0.1 & 0.6 \\\\ 0.3 & 0.5 \\end{bmatrix} \\begin{bmatrix} 0.2 \\\\ 0.5 \\end{bmatrix} \\\\ &= \\begin{bmatrix} 0.24 \\\\ 0.32 \\\\ 0.31 \\end{bmatrix} \\end{aligned}
WoutTh=
0.20.10.30.40.60.5
[0.20.5]=
0.240.320.31
2.7 Step 7:Softmax 转换为概率
(1) 指数计算
exp
(
0.24
)
=
1.271
exp
(
0.32
)
=
1.377
exp
(
0.31
)
=
1.363
\\text{exp}(0.24) = 1.271 \\\\ \\text{exp}(0.32) = 1.377 \\\\ \\text{exp}(0.31) = 1.363
exp(0.24)=1.271exp(0.32)=1.377exp(0.31)=1.363
(2) 求和
1.271
+
1.377
+
1.363
=
4.011
1.271 + 1.377 + 1.363 = 4.011
1.271+1.377+1.363=4.011
(3) Softmax概率计算
| the |
1.271 4.011 ≈ 0.317 \\frac{1.271}{4.011} \\approx 0.317 4.0111.271≈0.317 |
| cat |
1.377 4.011 ≈ 0.343 \\frac{1.377}{4.011} \\approx 0.343 4.0111.377≈0.343 |
| sat |
1.363 4.011 ≈ 0.340 \\frac{1.363}{4.011} \\approx 0.340 4.0111.363≈0.340 |
模型当前最看好的是 cat,但信心还不够高。
2.8 Step8: 损失函数(交叉熵)
在得到预测概率之后,CBOW 通过交叉熵损失来衡量当前预测的好坏。
(1) 损失计算
目标词是 cat,其预测概率为 0.343:
L
=
−
log
(
P
(
cat
∣
[the,sat]
)
)
=
−
log
(
0.343
)
≈
1.07
\\mathcal{L} = -\\log(P(\\text{cat}|\\text{[the,sat]}))=-\\log(0.343) \\approx 1.07
L=−log(P(cat∣[the,sat]))=−log(0.343)≈1.07 这个损失并不仅仅是一个数字,它同时也是一个信号,告诉模型:“这次预测哪里做得不够好,下一次该往哪个方向调整。”
(2) 损失的直觉
- 如果
P
(
cat
∣
[the, sat]
)
=
1
P(\\text{cat}|\\text{[the, sat]}) = 1
P(cat∣[the, sat])=1 →L
=
0
\\mathcal{L} = 0
L=0完美预测) - 如果
P
(
cat
∣
[the, sat]
)
=
0
P(\\text{cat}|\\text{[the, sat]}) = 0
P(cat∣[the, sat])=0 →L
→
∞
\\mathcal{L} \\to \\infin
L→∞(极差) - 当前是 中等置信度 → 中等损失
2.9 Step9: 反向传播
为了改进模型,本轮训练将根据损失函数对参数进行更新,使模型在相同上下文下 提高对目标词 "cat" 的预测概率,同时降低其他词的预测概率。
(1) Softmax输出层的梯度
- 在 CBOW 中,输出层首先计算每个词的打分(logits):
z
=
W
out
T
h
\\mathbf{z} = \\mathbf{W}_{\\text{out}}^T \\mathbf{h}
z=WoutTh
其中,
h
\\mathbf{h}
h为上下文embedding向量,
W
out
T
\\mathbf{W}^T_{\\text{out}}
WoutT为输出权重矩阵,
z
i
z_i
zi表示词表中第
i
i
i个词的得分。
经过softmax后,得到预测概率
p
i
p_i
pi,因为目标词采用onehot表示,我们记为
y
i
y_i
yi。
- 对于 softmax + 交叉熵损失,其对 logits 的梯度为:
∂
L
∂
z
i
=
p
i
−
y
i
\\frac{\\partial \\mathcal{L}}{\\partial z_i} = p_i – y_i
∂zi∂L=pi−yi
这里:
p
i
p_i
pi是模型对第
i
i
i个词的预测概率,
y
i
y_i
yi是真实标签(目标词对应位置为 1,其余为 0)
该公式直接反映了预测与真实标签之间的偏差。
-
计算每个词的梯度
Word p
i
p_i
piy
i
y_i
yiGradient:p
i
−
y
i
p_i-y_i
pi−yithe 0.317 0 0.317 cat 0.343 1 -0.657 sat 0.340 0 0.340
(2) 梯度的含义
-
对 cat:梯度为 负 ,下次应该提高它的得分
-
对 the / sat:梯度为 正 ,下次应该降低它们的得分
可以将该梯度理解为:预测偏大的词被压低,预测偏小的词被拉高。
(3) 更新权重
该梯度首先用于更新输出权重矩阵
W
out
\\mathbf{W}_{\\text{out}}
Wout,随后继续向前传播至上下文向量
h
\\mathbf{h}
h,并最终更新输入嵌入矩阵中上下文词(the、sat)对应的词向量。
目标词 "cat" 的输入嵌入在本轮 CBOW 更新中不会被更新,因为它并未参与上下文向量的构造。
三、总结
通过这个完整的 CBOW 示例,我们从一次最小的训练过程出发,串联起了模型学习语义的全过程。 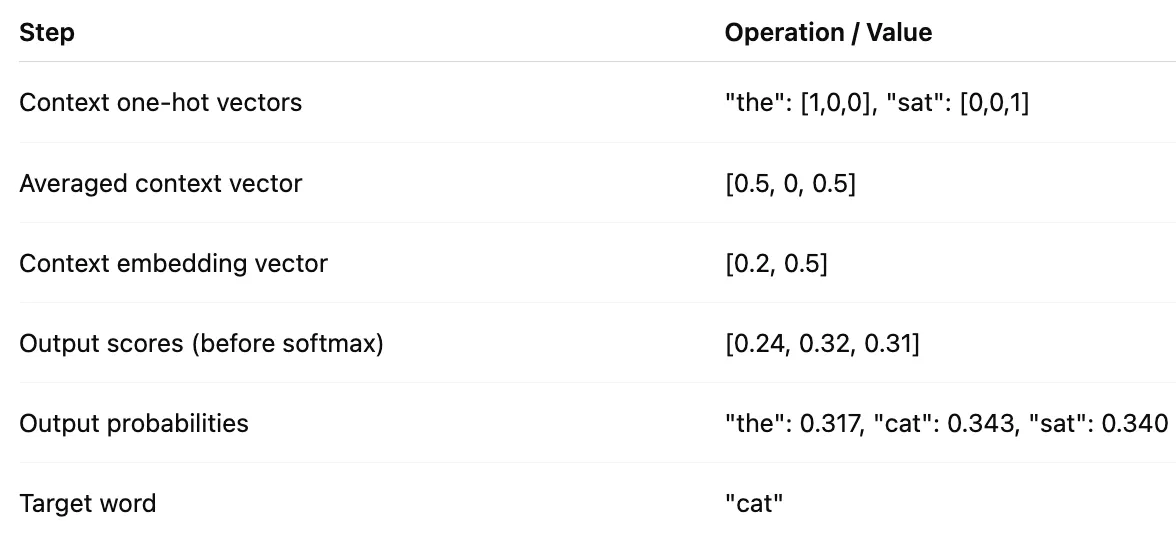
在前向传播阶段,CBOW 将上下文词映射为词向量,并对其取平均,形成一个上下文语义表示;随后通过输出层和 softmax,计算每个词作为中心词的预测概率。
在反向传播阶段,交叉熵损失刻画了模型预测与真实目标词之间的偏差。这一偏差通过梯度的形式传回模型参数,使目标词的得分被提升,非目标词的得分被抑制。
需要注意的是,在 CBOW 中,真正被直接更新的是上下文词的词向量以及输出层的权重,而不是目标词本身的输入词向量。这意味着模型并不是孤立地“记住某个词”,而是在不断调整:哪些上下文组合,应该更容易指向哪个中心词。
当这样的更新在大规模语料上反复进行时,具有相似上下文的词,其词向量会在嵌入空间中逐渐靠近;语义不同的词,则会自然分离。 这正是词向量能够捕捉语义相似性与语义结构的根本原因。