一、核心流程梳理(对应流程图)
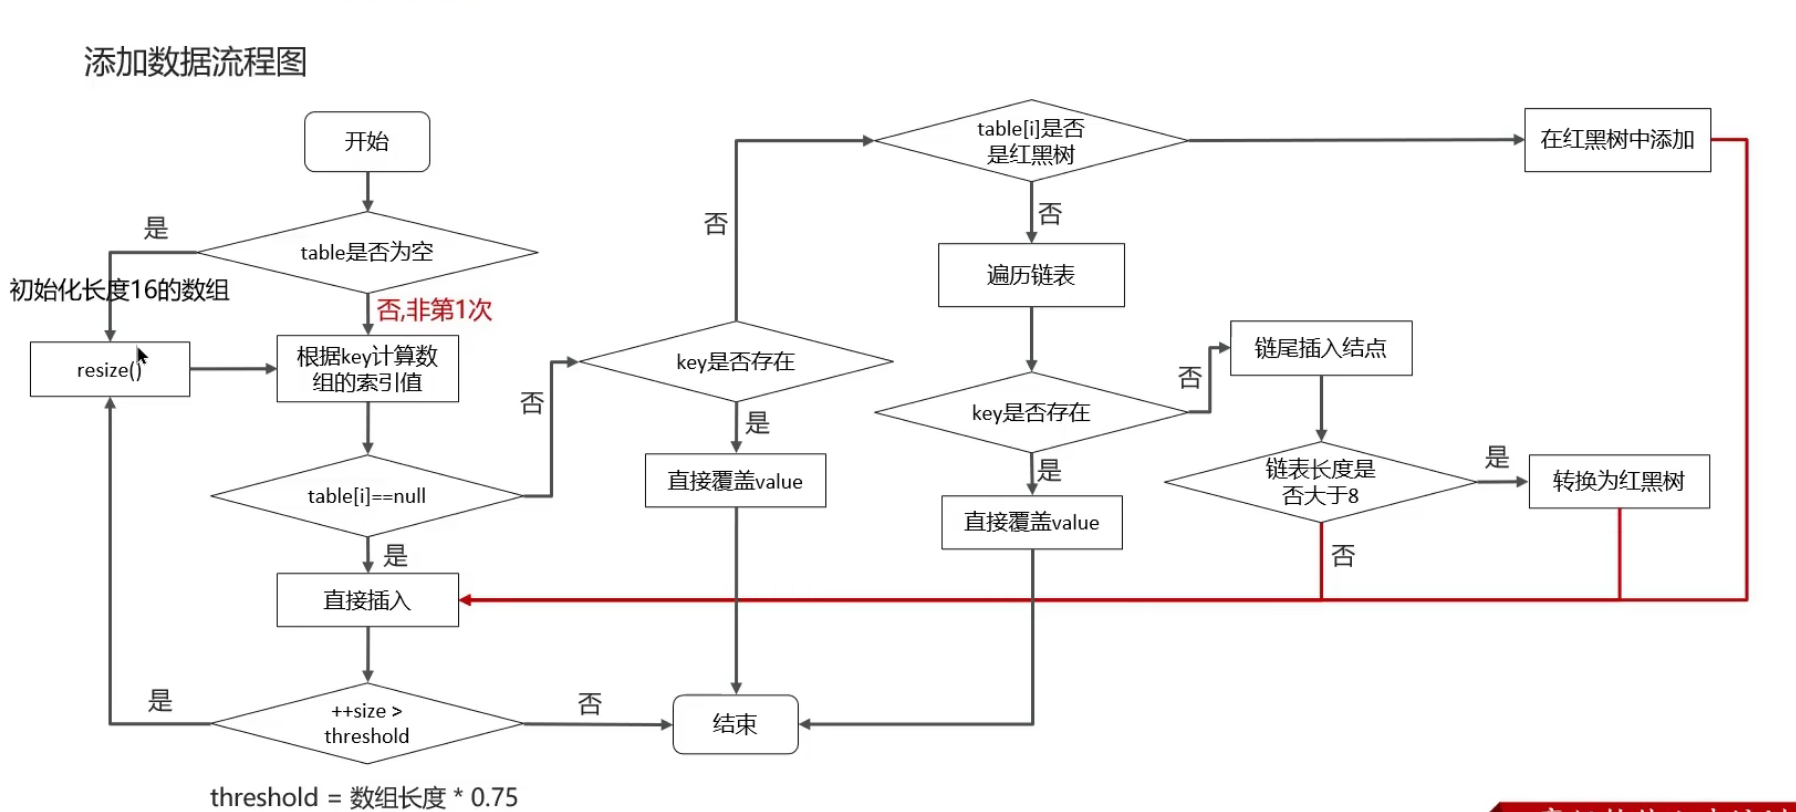
这张图完整还原了 HashMap 插入元素的核心逻辑,结合 JDK 8 源码,我们可以把流程拆解为以下步骤:
1. 初始化阶段
- 判断数组是否为空:如果 table 数组为 null(首次调用 put),则调用 resize() 方法初始化数组。默认初始容量为 16,负载因子 0.75,所以阈值 threshold = 16 * 0.75 = 12。
- 非首次插入:如果数组非空但需要扩容(size > threshold),同样会触发 resize()。
2. 计算索引 & 定位桶位
根据 key 的 hashCode() 计算哈希值,再通过 (n – 1) & hash 得到数组索引 i,定位到具体的桶 table[i]。
final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) {
Node<K,V>[] tab; Node<K,V> p; int n, i;
// 步骤1:判断table是否为空,为空则初始化(resize)
if ((tab = table) == null || (n = tab.length) == 0)
n = (tab = resize()).length;
// 步骤2:计算索引,判断桶位是否为空
if ((p = tab[i = (n – 1) & hash]) == null)
tab[i] = newNode(hash, key, value, null);
else {
// 桶位不为空的情况
Node<K,V> e; K k;
// 3.1 检查桶中第一个节点的key是否与插入key完全匹配
if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k))))
e = p;
// 3.2 判断桶是否是红黑树结构
else if (p instanceof TreeNode)
e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
// 3.3 桶是链表结构,遍历链表
else {
for (int binCount = 0; ; ++binCount) {
if ((e = p.next) == null) {
p.next = newNode(hash, key, value, null);
// 链表长度超过8,转红黑树
if (binCount >= TREEIFY_THRESHOLD – 1)
treeifyBin(tab, hash);
break;
}
if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k))))
break;
p = e;
}
}
// 4. key已存在,覆盖value
if (e != null) {
V oldValue = e.value;
if (!onlyIfAbsent || oldValue == null)
e.value = value;
afterNodeAccess(e);
return oldValue;
}
}
++modCount;
// 5. 检查是否需要扩容
if (++size > threshold)
resize();
afterNodeInsertion(evict);
return null;
}
3. 处理桶位冲突
- 桶位为空:直接创建新节点插入。
- 桶位不为空:
- key 已存在:如果桶中第一个节点的 hash 和 key 与插入的完全匹配,直接覆盖 value。
- 红黑树结构:如果桶是红黑树(TreeNode),则调用 putTreeVal 插入或更新节点。
- 链表结构:遍历链表,如果找到相同 key 则覆盖;否则在链表尾部插入新节点。插入后如果链表长度 ≥8,调用 treeifyBin 将链表转为红黑树。
4. 扩容判断
插入元素后,检查 size 是否超过阈值 threshold,如果超过则触发 resize(),将数组容量翻倍,并重新哈希所有元素。
二、面试高频回答思路
1. 完整回答示例
答:HashMap 的 put 方法核心流程可以分为这几步:
- 如果对应桶位为空,直接插入新节点。
- 如果桶位不为空,先检查第一个节点的 key 是否匹配,匹配则覆盖 value;
- 如果桶是红黑树结构,就用红黑树的方式插入;
- 如果是链表,就遍历链表,存在相同 key 则覆盖,否则在链尾插入。插入后如果链表长度≥8,会转成红黑树来优化查询性能。
JDK 8 相比之前的版本主要做了两个优化:一是链表插入从头插改成了尾插,避免了并发下的死链问题;二是链表长度超过 8 时转为红黑树,把链表的 O (n) 查询复杂度降到了 O (log n)。
2. 面试高频追问点
- 为什么链表转红黑树的阈值是 8? 因为 HashMap 的哈希分布遵循泊松分布,链表长度达到 8 的概率非常低(约 0.00000006),这是时间和空间的平衡选择。
- 为什么扩容是 2 的幂次? 为了让 (n-1) & hash 这个计算索引的操作更高效,同时保证哈希分布更均匀。
- JDK 8 之前头插法的问题? 在并发扩容时,头插会导致链表节点的引用顺序反转,从而形成循环链表,引发死循环。