功能(使用场景):分类:二分类、多分类
底层逻辑:他是将数据转换成数字然后通过线性回归计算出每个特诊的权重值,再通过sigmoid(h(w) = sigmoid(w^Tx + b )将权重值转换成0-1之间的概率值,最终找到一个阈值去将我们的值分类
过程图解
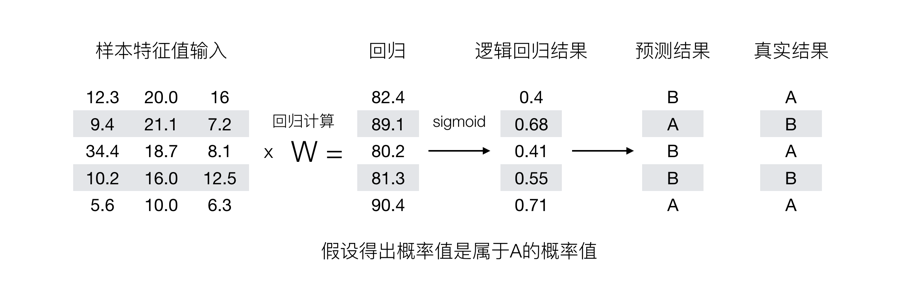
核心:
损失函数:交叉熵损失函数:伯努利分布的似然函数是逻辑回归交叉熵损失的来源,对其取负对数,直接得到交叉熵损失!
损失函数优化
apisklear.linear_model.LogisticRegression(slover = 'liblinear ',penalty=‘l2’, C = 1.0
liblinear 对小数据集场景训练速度更快,sag 和 saga 对大数据集更快一些。
penalty:正则化的种类,l1 或者 l2
C:正则化力度
逻辑回归评估:
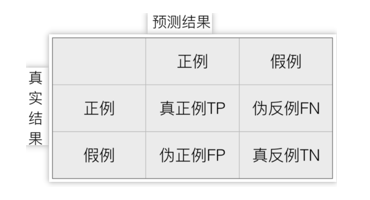
混淆矩阵:模型的预测结果与实际标签的对比情况
背景:是因为在某些行业中,不能靠单独的预测分数去判断这个模型的好坏程度,所以出现了这个评判分类函数的方法
方法简介:做成预测结果和真实结果的表格
正例子:我们分类后最关注的一个分类
假例子:我们分类后次要的关注分类
TP:真实结果时真,预测结果是真
FP:真实结果是真,预测结果是假
FN:真实结果是假,预测结果是真
TN:真实结果是假,预测结果是假
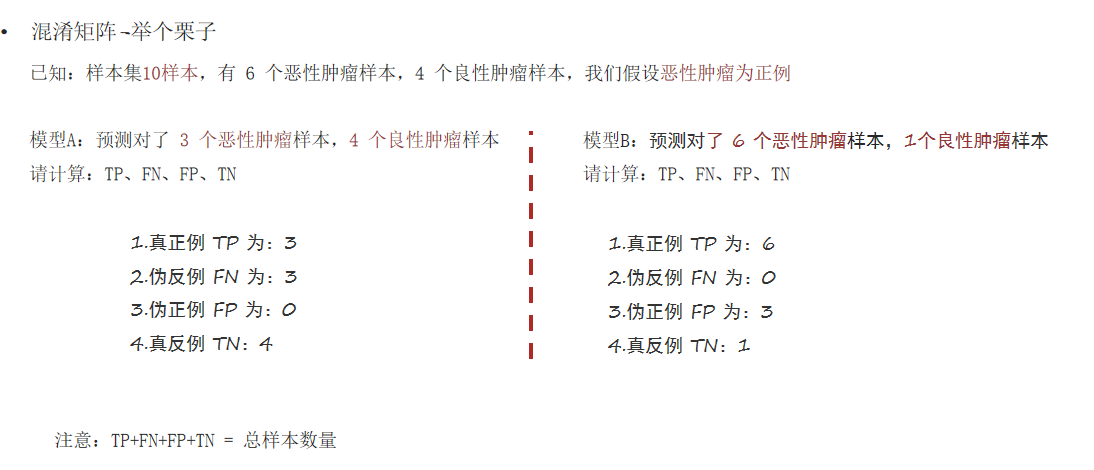
例子:
评估指标:
精确率:=TP/(TP+FP) 预测真确的样本站所有应该正确样本的比例(Precision Score)
召回率:= TP/(TP+FN) 真正正确的真实样本在所有预测为正样本的概率(recall_score
f1分数: = 2 ∗Precision ∗Recall/Precision+Recall (r1_score)
模型的精确率、召回率都有要求,模型在这两个评估方向的综合预测能力
AUC和ROC:
注意:二者需要同时使用
功能:评估模型好坏
AUC:阈值分割线
真正率(TPR):TP/(TP+FP)
假正率(FPR):FP/(FP+TN)
图解:1,0 代表这全部预测正确
0,1 代表全部预测错误
0,0 代表假的预测正确了,真的预测错了
1,0 代表真预测正确了,假的预测错了
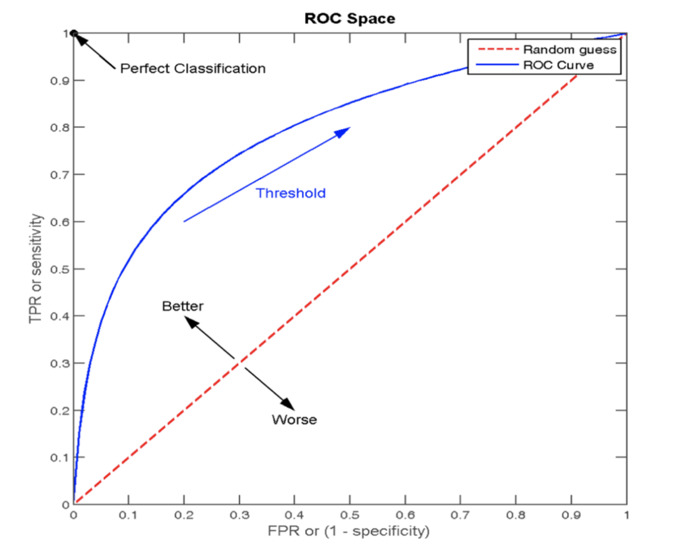
ROC:曲线下面积
线的上半部分代表预测的正确的占比,反之亦然
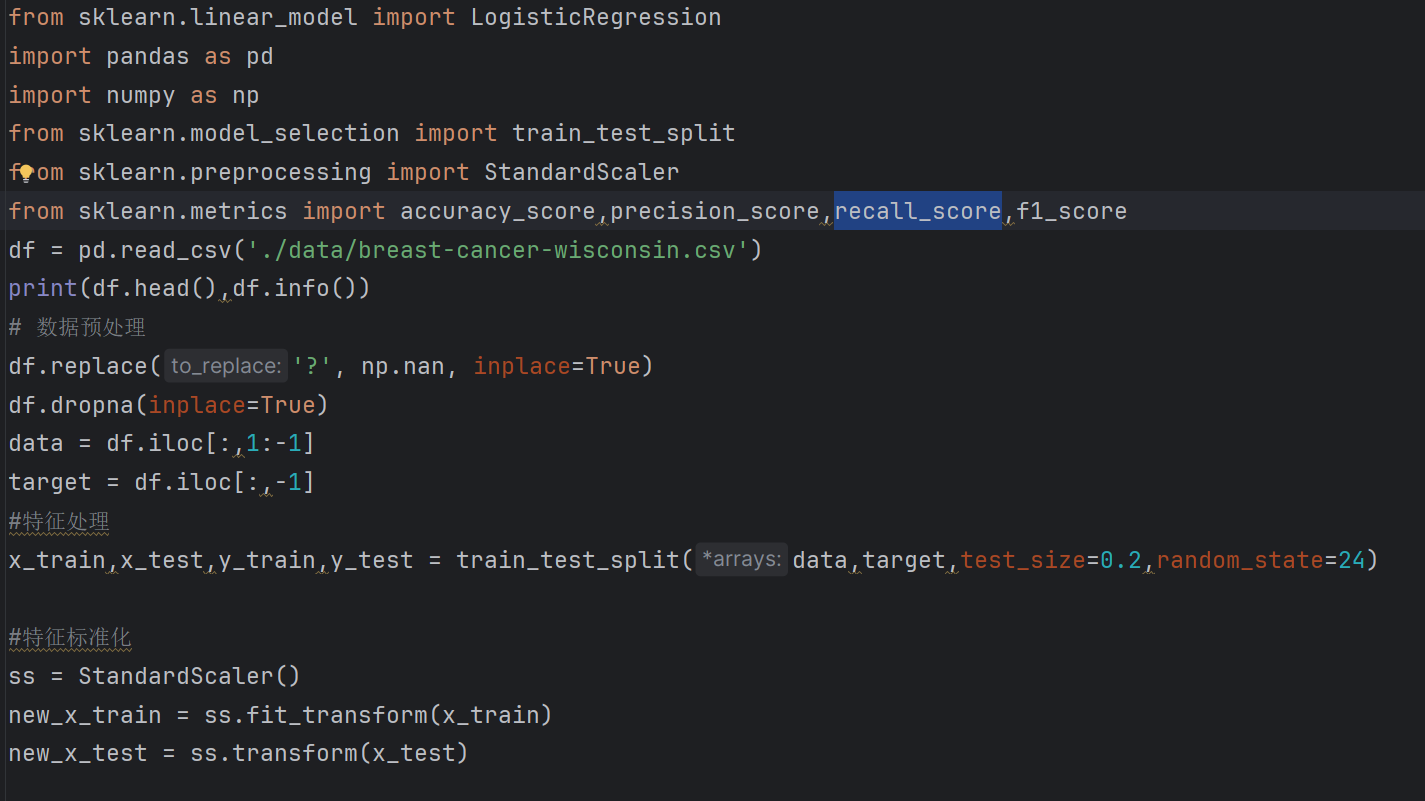
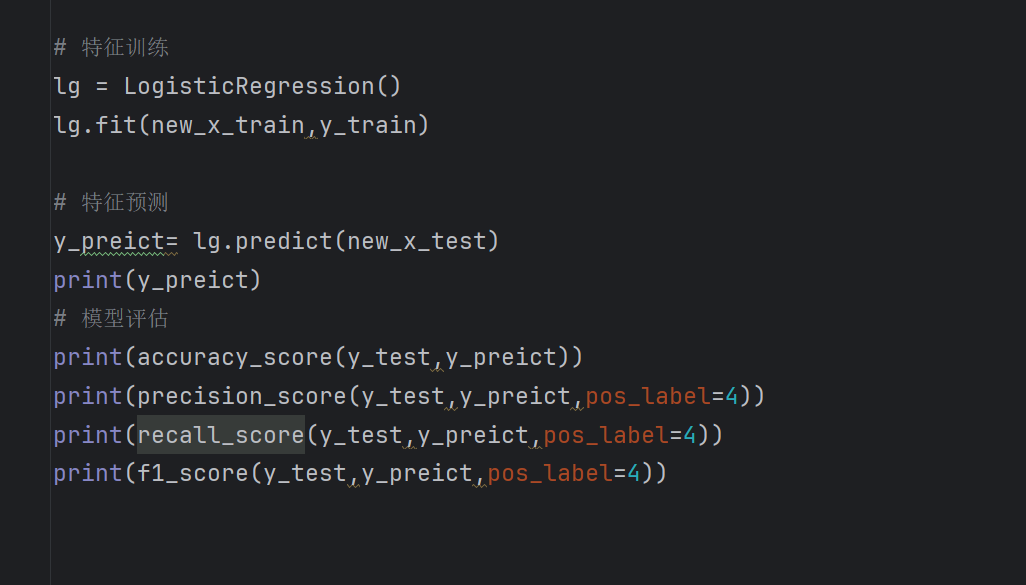
代码展示: