本次以泰坦尼克号生存预测这一经典二分类任务为核心,完成了从数据预处理到模型集成的机器学习全流程实践,先后围绕 Pandas 数据处理、特征工程、传统机器学习建模、深度学习尝试、模型调优及集成方法展开了系列讲解,最终实现了较好的预测效果。本文将对整个项目的流程、核心技巧、问题解决及实践感悟做全面总结。
一、项目核心目标与数据集
泰坦尼克号生存预测是机器学习入门经典任务,基于 891 名乘客的个人信息、舱位、票价等 15 个原始特征,构建模型预测乘客在沉船事故中的生存状态(0 = 遇难,1 = 存活),属于典型的二分类问题。
该数据集具备入门级项目的典型特征:存在缺失值、类别特征与数值特征混杂、部分特征冗余、数据量适中(891 条),既适合练习基础的数据处理技巧,也能落地特征工程、建模调优的核心思路,是衔接理论与实战的优质数据集。
二、项目全流程核心步骤与关键技巧
整个项目遵循数据预处理→特征工程→模型构建→模型调优→模型集成的机器学习标准流程,围绕 “提升模型泛化能力” 展开,以下为各环节的核心操作与实战技巧:
(一)数据预处理:机器学习的 “地基”
数据预处理的质量直接决定模型上限,本次项目针对数据集的缺失值、类别特征两大核心问题,落地了针对性的处理策略,也是工业级数据处理的通用方法:
- 高缺失率特征(deck 舱位甲板,缺失 688 条):直接删除,避免无效填充引入噪声;
- 数值特征(age 年龄,缺失 177 条):用中位数填充,抗异常值影响,比均值更稳健;
- 类别特征(embarked 登船港口、embark_town 登船城市,各缺失 2 条):用众数填充,符合多数样本特征;
- 核心原则:关键字段缺失删行,低缺失率数值特征用中位数 / 均值,类别特征用众数 / 新增未知类别。
- 有序类别(pclass 客舱等级):直接保留数值,利用其顺序信息;
- 无序类别(sex 性别、embarked 登船港口):优先使用独热编码(pd.get_dummies),消除类别有序性的误导;
- 简单类别映射(who 乘客类型):手动映射为 0/1/2,适合类别少且无顺序的特征;
- 补充:入门阶段可先手动编码熟悉原理,再用 factorize () 自动编码提升效率,自动化编码需注意编码映射的可解释性。
(二)特征工程:从数据中挖掘 “有效信息”
特征工程是提升模型效果的核心环节,本次围绕泰坦尼克号数据集完成了基础特征探索与分析,为建模提供了优质的特征矩阵,核心操作包括:
(三)模型构建:传统机器学习与深度学习的对比尝试
基于处理后的特征矩阵,我们分别尝试了传统机器学习模型和深度学习模型,并清晰落地了两者在数据处理、建模思路上的核心差异:
- 尝试模型:逻辑回归、随机森林、决策树、SVM、KNN;
- 效果表现:决策树(82.12%)> 随机森林(81.56%)> 逻辑回归(80.45%),SVM 和 KNN 效果较差(62.01%/67.04%);
- 核心发现:树模型(决策树、随机森林)对小数据集、非正态分布数据的适应性更好,是入门二分类任务的优选模型。
- 数据预处理:对数值特征做StandardScaler 标准化,将特征缩放到均值为 0、方差为 1 的范围,加速模型收敛;
- 模型构建:实现基础 MLP 与改进 MLP(添加批归一化 BatchNorm、Dropout 正则化),改进后模型准确率达到 82.12%,与最优传统模型持平;
- 核心问题:数据集量小(仅 891 条),深度学习无法发挥特征自动学习的优势,且易出现过拟合(epoch 增加后准确率下降);
- 传统 ML 与 DL 的核心差异:ML 依赖手动特征工程,适配中小数据集;DL 特征工程部分自动化,需大规模数据集支撑,预处理更复杂(如张量转换、批量处理)。
(四)模型调优:找到模型的 “最优参数”
模型的默认参数往往不是最优解,本次分别针对传统机器学习和深度学习实现了高效的超参数调优方法,核心思路是 “在参数空间中筛选最优组合,提升模型泛化能力”:
- 核心优势:对比网格搜索(GridSearchCV),随机采样参数组合,大幅减少计算量,适配参数空间大的场景;
- 核心操作:定义模型核心参数空间(如随机森林的 n_estimators、max_depth,决策树的 criterion、min_samples_split),设置 5 折交叉验证,随机采样 10 组参数组合,选择 CV 分数最高的参数作为最优参数;
- 核心原则:树模型调参围绕 **“平衡拟合能力与过拟合”** 展开,通过限制树深度、增加节点分裂样本数等抑制过拟合。
- 核心优势:区别于随机 / 网格搜索的 “无记忆采样”,贝叶斯优化通过构建概率模型,智能聚焦参数空间的 “最优潜力区域”,用更少的试错次数找到最优参数;
- 核心操作:定义待调参的超参数(学习率 lr、Dropout 率),设置优化方向为 “最大化验证准确率”,迭代 10 次试错,选择最优参数后全量训练模型;
- 核心技巧:深度学习调参需注意训练模式与评估模式的切换(model.eval () + torch.no_grad ()),避免 Dropout/BatchNorm 影响验证结果。
(五)模型集成:让多个模型 “互相弥补错误”
模型集成是机器学习中 “花小钱办大事” 的核心技巧,即使单个模型效果平平,通过合理组合也能提升预测准确率和稳定性,本次落地了三种经典的集成方法,核心思路是让参与集成的模型 “有差异”,错得不一样:
三、后续
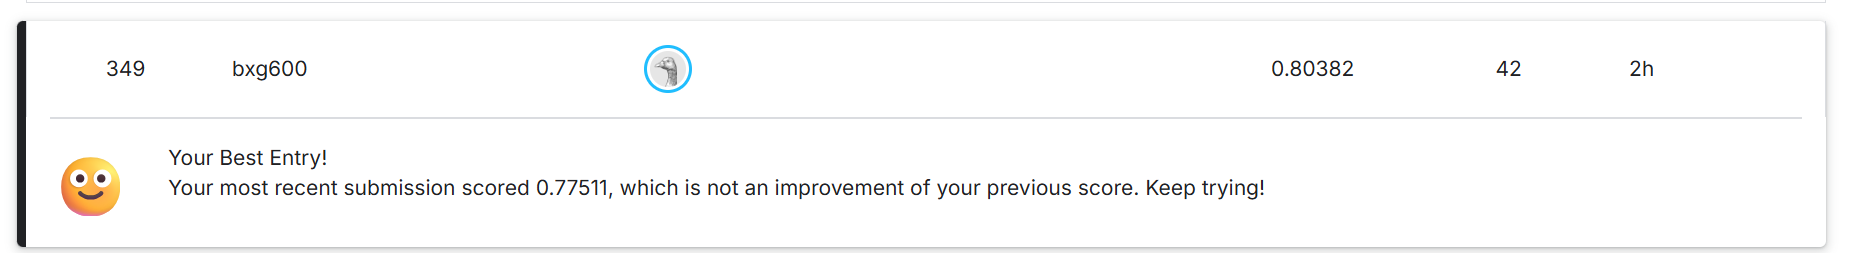
当前,目前只完成了最基础的工作,之后我通过提升特征工程,在 Kaggle 上达到 Top3% 的成绩。因此之后计划在补充一些文章来进行讲述。
此外,发现pytabkit非常适合kaggle竞赛,但目前并不能找到很好的教程,后续也计划进行补充。
四、完整代码
我习惯用jupyter来写,下面的代码中应该有部分内容是不必要的,但核心内容都在
# %% [markdown]
# ### 加载数据集
# %%
import pandas as pd
df = pd.read_csv('titanic/train.csv')
df.head()
# %% [markdown]
# ### 数据预处理
# %%
# 检查缺失值
print("缺失值统计:")
print(df.isnull().sum())
# %%
# 处理缺失值
# Age 用中位数填充
df['Age'] = df['Age'].fillna(df['Age'].median())
# Embarked 用众数填充
df['Embarked'] = df['Embarked'].fillna(df['Embarked'].mode()[0])
# 删除 Cabin 列,如果存在的话
if 'Cabin' in df.columns:
df.drop('Cabin', axis=1, inplace=True)
print("处理缺失值后:")
print(df.isnull().sum())
# %%
# 编码分类变量
# Sex: male=0, female=1
df['Sex'] = df['Sex'].map({'male': 0, 'female': 1})
# Embarked: S=0, C=1, Q=2
df['Embarked'] = df['Embarked'].map({'S': 0, 'C': 1, 'Q': 2})
print("编码后数据类型:")
print(df.dtypes)
# %%
# 删除不必要的列
df.drop(['PassengerId', 'Name', 'Ticket'], axis=1, inplace=True)
print("预处理后的数据集:")
df.head()
# %% [markdown]
# ### 特征探索
# %%
# 描述性统计
print("数据集描述性统计:")
df.describe()
# %%
# 相关性矩阵
print("特征相关性矩阵:")
correlation_matrix = df.corr(numeric_only=True)
correlation_matrix
# %% [markdown]
# ### 共线性检查
# %%
# 分离特征和标签(如果尚未分离)
X = df.drop('Survived', axis=1)
y = df['Survived']
# 计算方差膨胀因子 (VIF)
from statsmodels.stats.outliers_influence import variance_inflation_factor
vif_data = pd.DataFrame()
vif_data["feature"] = X.columns
vif_data["VIF"] = [variance_inflation_factor(X.values, i) for i in range(len(X.columns))]
print("方差膨胀因子 (VIF) 检查结果:")
print(vif_data)
print("\\nVIF > 5 表示潜在共线性问题,VIF > 10 表示严重共线性。")
# %% [markdown]
# ### 分布分析
# %%
# 密度图查看特征分布
import seaborn as sns
import matplotlib.pyplot as plt
numerical_features = ['Age', 'Fare', 'SibSp', 'Parch']
plt.figure(figsize=(12, 8))
for i, feature in enumerate(numerical_features, 1):
plt.subplot(2, 2, i)
sns.kdeplot(data=df, x=feature, fill=True)
plt.title(f'{feature} 密度分布')
plt.tight_layout()
plt.show()
# 检查偏斜度
print("特征偏斜度 (Skewness):")
for feature in numerical_features:
skew = df[feature].skew()
if abs(skew) > 1:
print(f"{feature}: {skew:.2f} (高度偏斜)")
else:
print(f"{feature}: {skew:.2f} (绝对值 ≤ 1 表示偏斜较小)")
# %%
# 正态性检验 (Shapiro-Wilk)
import scipy.stats as stats
print("正态性检验 (Shapiro-Wilk):")
for feature in numerical_features:
stat, p = stats.shapiro(df[feature].dropna())
print(f"{feature}: p-value = {p:.4f} (p < 0.05 表示非正态)")
# %% [markdown]
# ### 分类特征与目标关联
# %%
# 分类特征与目标关联分析
categorical_features = ['Pclass', 'Sex', 'Embarked']
for feature in categorical_features:
print(f"\\n{feature} 与 Survived 的交叉表:")
crosstab = pd.crosstab(df[feature], df['Survived'], normalize='index')
print(crosstab)
# 卡方检验
from scipy.stats import chi2_contingency
chi2, p, dof, expected = chi2_contingency(pd.crosstab(df[feature], df['Survived']))
print(f"卡方检验: chi2 = {chi2:.2f}, p-value = {p:.4f} (p < 0.05 表示显著关联)")
# %%
# 可视化分类特征与存活率
plt.figure(figsize=(15, 5))
for i, feature in enumerate(categorical_features, 1):
plt.subplot(1, 3, i)
sns.barplot(x=feature, y='Survived', data=df)
plt.title(f'{feature} vs Survived')
plt.ylabel('Survival Rate')
plt.tight_layout()
plt.show()
# %% [markdown]
# ### 数据分割
# %%
# 数据分割
from sklearn.model_selection import train_test_split
# 分割为训练集和验证集 (80% 训练, 20% 验证)
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y)
print("数据分割完成:")
print(f"训练集: X_train {X_train.shape}, y_train {y_train.shape}")
print(f"验证集: X_val {X_val.shape}, y_val {y_val.shape}")
print(f"训练集存活率: {y_train.mean():.2f}")
print(f"验证集存活率: {y_val.mean():.2f}")
# %% [markdown]
# ### 模型训练
# %%
# 训练逻辑回归模型
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
# 特征缩放
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_val_scaled = scaler.transform(X_val)
# 创建模型
model = LogisticRegression(random_state=42, max_iter=1000)
# 训练模型
# model.fit(X_train, y_train)
model.fit(X_train_scaled, y_train)
# 在验证集上预测
y_pred = model.predict(X_val_scaled)
# 评估模型
accuracy = accuracy_score(y_val, y_pred)
print(f"验证集准确率: {accuracy:.4f}")
print("\\n分类报告:")
print(classification_report(y_val, y_pred))
print("\\n混淆矩阵:")
print(confusion_matrix(y_val, y_pred))
# %% [markdown]
# ### 尝试其他模型
# %%
# 尝试其他模型并比较准确率
from sklearn.ensemble import RandomForestClassifier
from sklearn.svm import SVC
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
models = {
'Random Forest': RandomForestClassifier(random_state=42),
'SVM': SVC(random_state=42),
'Decision Tree': DecisionTreeClassifier(random_state=42),
'KNN': KNeighborsClassifier()
}
results = {}
for name, model in models.items():
#model.fit(X_train, y_train)
model.fit(X_train_scaled, y_train)
y_pred = model.predict(X_val_scaled)
acc = accuracy_score(y_val, y_pred)
results[name] = acc
print(f"{name}: {acc:.4f}")
# %%
# 改进的深度学习模型(添加dropout和batch normalization)
import torch
import torch.nn as nn
import torch.optim as optim
# 转换为tensor(复用之前的)
X_train_tensor = torch.tensor(X_train_scaled, dtype=torch.float32)
y_train_tensor = torch.tensor(y_train.values, dtype=torch.float32).unsqueeze(1)
X_val_tensor = torch.tensor(X_val_scaled, dtype=torch.float32)
y_val_tensor = torch.tensor(y_val.values, dtype=torch.float32).unsqueeze(1)
# 定义改进的MLP模型
class ImprovedMLP(nn.Module):
def __init__(self, input_size):
super(ImprovedMLP, self).__init__()
self.fc1 = nn.Linear(input_size, 128)
self.bn1 = nn.BatchNorm1d(128)
self.dropout1 = nn.Dropout(0.3)
self.fc2 = nn.Linear(128, 64)
self.bn2 = nn.BatchNorm1d(64)
self.dropout2 = nn.Dropout(0.3)
self.fc3 = nn.Linear(64, 32)
self.bn3 = nn.BatchNorm1d(32)
self.dropout3 = nn.Dropout(0.3)
self.fc4 = nn.Linear(32, 1)
self.sigmoid = nn.Sigmoid()
def forward(self, x):
x = self.dropout1(torch.relu(self.bn1(self.fc1(x))))
x = self.dropout2(torch.relu(self.bn2(self.fc2(x))))
x = self.dropout3(torch.relu(self.bn3(self.fc3(x))))
x = self.sigmoid(self.fc4(x))
return x
model = ImprovedMLP(X_train_scaled.shape[1])
# 损失函数和优化器(调整学习率)
criterion = nn.BCELoss()
optimizer = optim.Adam(model.parameters(), lr=0.0005)
# 训练模型
epochs = 50
for epoch in range(epochs):
model.train()
optimizer.zero_grad()
outputs = model(X_train_tensor)
loss = criterion(outputs, y_train_tensor)
loss.backward()
optimizer.step()
# 预测
model.eval()
with torch.no_grad():
y_pred_prob = model(X_val_tensor)
y_pred = (y_pred_prob > 0.5).float()
# 计算准确率
from sklearn.metrics import accuracy_score
accuracy = accuracy_score(y_val, y_pred.numpy().flatten())
print(f"改进深度学习模型验证集准确率: {accuracy:.4f}")
# %% [markdown]
# ### 模型调参和保存
# %%
# 模型调参和保存
import joblib
from sklearn.model_selection import RandomizedSearchCV
import optuna
import torch
import torch.nn as nn
import torch.optim as optim
saved_models = []
# 定义TunedMLP类(全局)
class TunedMLP(nn.Module):
def __init__(self, input_size, dropout_rate):
super(TunedMLP, self).__init__()
self.fc1 = nn.Linear(input_size, 128)
self.bn1 = nn.BatchNorm1d(128)
self.dropout1 = nn.Dropout(dropout_rate)
self.fc2 = nn.Linear(128, 64)
self.bn2 = nn.BatchNorm1d(64)
self.dropout2 = nn.Dropout(dropout_rate)
self.fc3 = nn.Linear(64, 32)
self.bn3 = nn.BatchNorm1d(32)
self.dropout3 = nn.Dropout(dropout_rate)
self.fc4 = nn.Linear(32, 1)
self.sigmoid = nn.Sigmoid()
def forward(self, x):
x = self.dropout1(torch.relu(self.bn1(self.fc1(x))))
x = self.dropout2(torch.relu(self.bn2(self.fc2(x))))
x = self.dropout3(torch.relu(self.bn3(self.fc3(x))))
x = self.sigmoid(self.fc4(x))
return x
# 1. RandomForest调参
print("调参RandomForest…")
param_dist_rf = {
'n_estimators': [100, 200, 300],
'max_depth': [None, 10, 20, 30],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4]
}
random_search_rf = RandomizedSearchCV(
RandomForestClassifier(random_state=42),
param_dist_rf,
n_iter=10,
cv=5,
random_state=42,
n_jobs=-1
)
random_search_rf.fit(X_train_scaled, y_train)
best_rf = random_search_rf.best_estimator_
saved_models.append(('RandomForest', best_rf, random_search_rf.best_score_))
print(f"RandomForest最佳CV分数: {random_search_rf.best_score_:.4f}")
# 2. DecisionTree调参
print("调参DecisionTree…")
param_dist_dt = {
'max_depth': [None, 10, 20, 30],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4],
'criterion': ['gini', 'entropy']
}
random_search_dt = RandomizedSearchCV(
DecisionTreeClassifier(random_state=42),
param_dist_dt,
n_iter=10,
cv=5,
random_state=42,
n_jobs=-1
)
random_search_dt.fit(X_train_scaled, y_train)
best_dt = random_search_dt.best_estimator_
saved_models.append(('DecisionTree', best_dt, random_search_dt.best_score_))
print(f"DecisionTree最佳CV分数: {random_search_dt.best_score_:.4f}")
# 3. MLP调参 (Optuna)
print("调参MLP…")
# 定义TunedMLP类(全局)
class TunedMLP(nn.Module):
def __init__(self, input_size, dropout_rate):
super(TunedMLP, self).__init__()
self.fc1 = nn.Linear(input_size, 128)
self.bn1 = nn.BatchNorm1d(128)
self.dropout1 = nn.Dropout(dropout_rate)
self.fc2 = nn.Linear(128, 64)
self.bn2 = nn.BatchNorm1d(64)
self.dropout2 = nn.Dropout(dropout_rate)
self.fc3 = nn.Linear(64, 32)
self.bn3 = nn.BatchNorm1d(32)
self.dropout3 = nn.Dropout(dropout_rate)
self.fc4 = nn.Linear(32, 1)
self.sigmoid = nn.Sigmoid()
def forward(self, x):
x = self.dropout1(torch.relu(self.bn1(self.fc1(x))))
x = self.dropout2(torch.relu(self.bn2(self.fc2(x))))
x = self.dropout3(torch.relu(self.bn3(self.fc3(x))))
x = self.sigmoid(self.fc4(x))
return x
def objective(trial):
lr = trial.suggest_float('lr', 1e-5, 1e-1, log=True)
dropout_rate = trial.suggest_float('dropout', 0.1, 0.5)
model = TunedMLP(X_train_scaled.shape[1], dropout_rate)
optimizer = optim.Adam(model.parameters(), lr=lr)
criterion = nn.BCELoss()
# 简短训练
for epoch in range(20):
model.train()
optimizer.zero_grad()
outputs = model(X_train_tensor)
loss = criterion(outputs, y_train_tensor)
loss.backward()
optimizer.step()
# 验证准确率
model.eval()
with torch.no_grad():
y_pred_prob = model(X_val_tensor)
y_pred = (y_pred_prob > 0.5).float()
acc = accuracy_score(y_val, y_pred.numpy().flatten())
return acc
study = optuna.create_study(direction='maximize')
study.optimize(objective, n_trials=10)
best_params = study.best_params
print(f"MLP最佳参数: {best_params}, 验证准确率: {study.best_value:.4f}")
# 训练最佳MLP
best_mlp = TunedMLP(X_train_scaled.shape[1], best_params['dropout'])
optimizer = optim.Adam(best_mlp.parameters(), lr=best_params['lr'])
criterion = nn.BCELoss()
for epoch in range(50): # 更长训练
best_mlp.train()
optimizer.zero_grad()
outputs = best_mlp(X_train_tensor)
loss = criterion(outputs, y_train_tensor)
loss.backward()
optimizer.step()
saved_models.append(('MLP', best_mlp, study.best_value))
# 保存8个较好模型(如果少于8个,保存所有)
saved_models.sort(key=lambda x: x[2], reverse=True)
top_models = saved_models[:8]
print("\\n保存的8个较好模型:")
for i, (name, model, score) in enumerate(top_models):
filename = f'model_{i+1}_{name}.pkl'
joblib.dump(model, filename)
print(f"{i+1}. {name}: CV/验证分数 {score:.4f}, 保存为 {filename}")
print("调参和保存完成。")
# %% [markdown]
# ### 模型集成和提交
# %%
# 模型集成和提交
import joblib
import pandas as pd
import torch
from sklearn.ensemble import VotingClassifier
from sklearn.metrics import accuracy_score
# 加载保存的模型
rf_model = joblib.load('model_1_RandomForest.pkl')
dt_model = joblib.load('model_3_DecisionTree.pkl')
mlp_model = joblib.load('model_2_MLP.pkl')
# 由于MLP是PyTorch模型,使用手动集成(概率平均)
# 先加载测试数据
test_df = pd.read_csv('titanic/test.csv')
# 预处理测试数据(与训练相同)
# 处理缺失值
test_df['Age'] = test_df['Age'].fillna(df['Age'].median()) # 用训练中位数
test_df['Fare'] = test_df['Fare'].fillna(df['Fare'].median()) # Fare也可能缺失
test_df['Embarked'] = test_df['Embarked'].fillna(df['Embarked'].mode()[0])
# 删除Cabin
if 'Cabin' in test_df.columns:
test_df.drop('Cabin', axis=1, inplace=True)
# 编码
test_df['Sex'] = test_df['Sex'].map({'male': 0, 'female': 1})
test_df['Embarked'] = test_df['Embarked'].map({'S': 0, 'C': 1, 'Q': 2})
# 删除不必要列
test_df.drop(['Name', 'Ticket'], axis=1, inplace=True)
# 保存PassengerId
test_passenger_ids = test_df['PassengerId']
test_df.drop('PassengerId', axis=1, inplace=True)
# 标准化
X_test_scaled = scaler.transform(test_df)
# 转换为tensor for MLP
X_test_tensor = torch.tensor(X_test_scaled, dtype=torch.float32)
# 预测概率
rf_prob = rf_model.predict_proba(X_test_scaled)[:, 1] # 生存概率
dt_prob = dt_model.predict_proba(X_test_scaled)[:, 1]
mlp_model.eval()
with torch.no_grad():
mlp_prob = mlp_model(X_test_tensor).squeeze().numpy()
# 平均概率
ensemble_prob = (rf_prob + dt_prob + mlp_prob) / 3
ensemble_pred = (ensemble_prob > 0.5).astype(int)
# 加载gender_submission.csv作为模板
submission = pd.read_csv('titanic/gender_submission.csv')
# 替换Survived
submission['Survived'] = ensemble_pred
# 保存submission.csv
submission.to_csv('submission.csv', index=False)
print("submission.csv 已生成,可用于Kaggle提交。")
print(f"集成模型预测生存率: {ensemble_pred.mean():.4f}")
# 可选:验证集成在验证集上的准确率
# 复用之前的X_val_scaled
rf_val_prob = rf_model.predict_proba(X_val_scaled)[:, 1]
dt_val_prob = dt_model.predict_proba(X_val_scaled)[:, 1]
mlp_model.eval()
with torch.no_grad():
mlp_val_prob = mlp_model(X_val_tensor).squeeze().numpy()
ensemble_val_prob = (rf_val_prob + dt_val_prob + mlp_val_prob) / 3
ensemble_val_pred = (ensemble_val_prob > 0.5).astype(int)
ensemble_acc = accuracy_score(y_val, ensemble_val_pred)
print(f"集成模型验证集准确率: {ensemble_acc:.4f}")
# %% [markdown]
# ### RandomForest单独提交
# %%
# RandomForest单独提交
import joblib
import pandas as pd
# 加载RandomForest模型
rf_model = joblib.load('model_1_RandomForest.pkl')
# 加载测试数据
test_df = pd.read_csv('titanic/test.csv')
# 预处理测试数据(与训练相同)
test_df['Age'] = test_df['Age'].fillna(df['Age'].median())
test_df['Fare'] = test_df['Fare'].fillna(df['Fare'].median())
test_df['Embarked'] = test_df['Embarked'].fillna(df['Embarked'].mode()[0])
if 'Cabin' in test_df.columns:
test_df.drop('Cabin', axis=1, inplace=True)
test_df['Sex'] = test_df['Sex'].map({'male': 0, 'female': 1})
test_df['Embarked'] = test_df['Embarked'].map({'S': 0, 'C': 1, 'Q': 2})
test_df.drop(['Name', 'Ticket'], axis=1, inplace=True)
test_passenger_ids = test_df['PassengerId']
test_df.drop('PassengerId', axis=1, inplace=True)
# 标准化
X_test_scaled = scaler.transform(test_df)
# 预测
rf_pred = rf_model.predict(X_test_scaled)
# 生成submission.csv
submission_rf = pd.read_csv('titanic/gender_submission.csv')
submission_rf['Survived'] = rf_pred
submission_rf.to_csv('submission_rf.csv', index=False)
print("submission_rf.csv 已生成,可用于Kaggle提交。")
print(f"RandomForest预测生存率: {rf_pred.mean():.4f}")
# 验证集准确率
rf_val_pred = rf_model.predict(X_val_scaled)
rf_val_acc = accuracy_score(y_val, rf_val_pred)
print(f"RandomForest验证集准确率: {rf_val_acc:.4f}")