一、树的重心
题目:深度之和最小的点
思考一下,如果问题换成以下另外两种,答案还会是原问题的解吗?
- 寻找一个点,使得以这个节点为根时,最大的子树的最小。
- 寻找一个点,使得以这个节点为根时,所有子树的大小不超过
 。
这三个问题的答案是一样的,它的名字叫做重心。加上原问题,这三个问题也称为重心的三个定义。
。求重心有一个通用的转移方程:
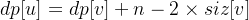
其中  表示以 u 为根时,u 到树中所有其他节点的距离之和,
 表示以
 为根的子树的大小。
关于重心还有几个额外的性质:
- 重心可能有
 个。
- 若有两个重心,这两个重心一定是同一条边的相邻点。
- 给这棵树增加或减少一个叶子节点,转移后的重心最多只会移动一条边。
- 将两棵树合并后,新的重心一定在原来的两个重心的路径上
上述是关于没有边权的情况。
对于一棵有边权的树,若其边权全为正数,那么所有节点到重心的边权和最小,且与边权的分布无 关。
树的重心代码实现(主要部分):
void dfs1(int u, int father) {
siz[u] = 1;
for (auto v : graph[u]) {
if (v == father) continue;
dfs1(v, u);
dp[u] += dp[v] + 1;
siz[u] += siz[v];
}
}
void dfs2(int u, int father) {
for (auto v : graph[u]) {
if (v == father) continue;
dp[v] = dp[u] + n – siz[v] – siz[v];
dfs2(v, u);
}
}
二、树的同构
在开始之前,我们先讨论两个问题:
1. 如何判断两棵有根树是否相同,例如下列两棵树。
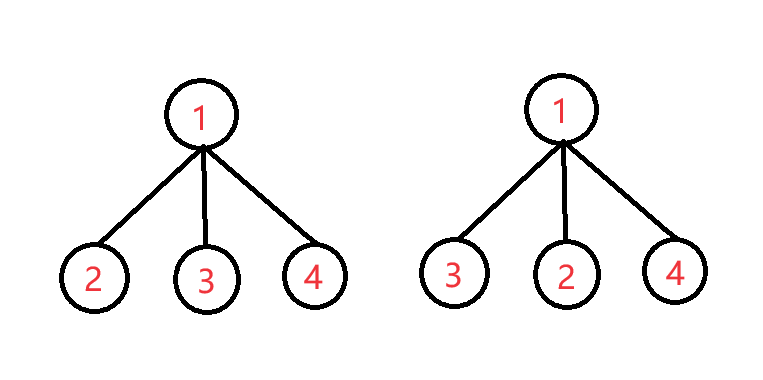
可以将有根树转化为序列( DFS 序)进行判断。
每个点遍历时都先对自己的子节点排序,先遍历小的。
最后DFS序如果相同,那么肯定相同。
2. 如何判断两棵树是否形态相同(同构),例如下列两棵树。
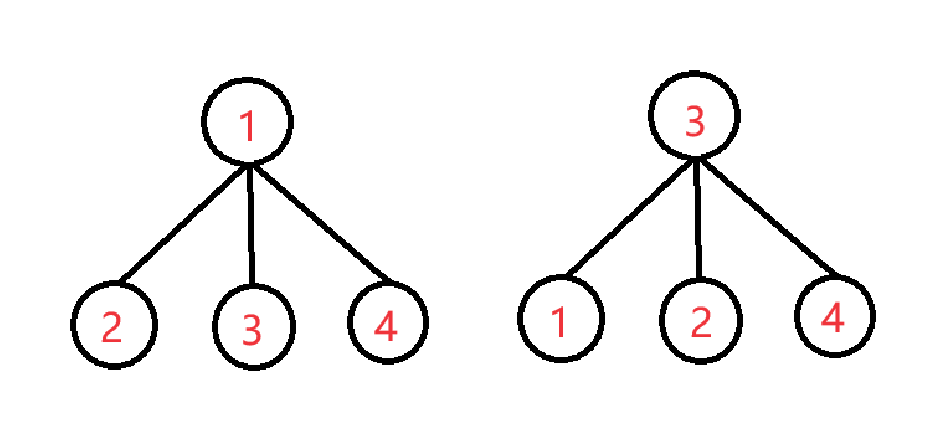
要解决这个问题,就要进入正题:树的同构。
1. 有根树同构
解决有根树同构有两种方法:
1. 换一个与编号无关,但是又能够表示树的方式来判断。
2. 哈希法。
方法 1:
括号表示法:将递归过程中的进入子树使用左括号表示,完全离开子树采用右括号表示。那么此时可以用括号序列唯一表示一次 DFS 。
潜在的问题:字符串的排序,合并属于复杂度较大的操作。
下面是代码实现:
set<string> se;
void dfs(int u, int father) {
vector<string> tmp;
for (auto v : graph[u]) {
if (v == father) continue;
dfs(v, u);
tmp.push_back(ans[v]);
}
sort(tmp.begin(), tmp.end());
ans[u] = "(";
for (auto v : tmp) ans[u] += v;
ans[u] += ")";
se.insert(ans[u]);
}
其中,  是用来个数的,因为
 能够自动去重,所以最后的答案输出
 就可以了。
方法 2:
哈希法的核心在于如何设计哈希函数。
单个节点的哈希值不妨设置为常数  (其他常数也可以)。
现在根据树形 DP 的设计方法,如果已有 的子树  的哈希值
 ,如何得到 的哈希值?
可以采用加和的方法。
实际实现中,累加子树哈希值之前,通常还会对子树哈希的值再进行一次哈希,用函数  表示。
给出一种 函数的代码实现:
using ulint = unsigned long long;
mt19937_64 rnd(time(0)); // 生成随机数
const ulint mask = rnd();
ulint f(ulint x) {
x ^= mask;
x ^= x << 13;
x ^= x >> 7;
x ^= x << 17;
x ^= mask;
// 这样的组合下,大概可以翻转一半的位。
return x;
}
则完整的有根树哈希代码为:
using ulint = unsigned long long;
mt19937_64 rnd(time(0)); // 生成随机数
const ulint mask = rnd();
ulint f(ulint x) {
x ^= mask;
x ^= x << 13;
x ^= x >> 7;
x ^= x << 17;
x ^= mask;
// 这样的组合下,大概可以翻转一半的位。
return x;
}
void dfs(int u, int father) {
ans[u] = 1;
for (auto v : graph[u]) {
if (v == father) continue;
dfs(v, u);
ans[u] += f(ans[v]);
}
}
2. 无根树同构
如果没有根了,该怎么办?
依旧有两种方法:
1. 选择一个比较特殊的点,作为根节点,变为有根树。要求:这个点比较唯一,是前面讲过 的重心。
2. 每个点都来一遍,然后比较集合。
方法 1:
只有一个重心的树和只有两个重心的树的做法肯定是不同的,因此分别处理。
- 若是只有一个重心的树,选择这个点作为起点,进行 DFS 哈希即可。
- 若是只有两个重心的树,两个点分别 DFS 一次,获得两个值,以这个这两个值作为哈希的结果。
下面是具体代码:
using ulint = unsigned long long;
mt19937_64 rnd(time(0));
ulint f(ulint x) {
x ^= mask;
x ^= x << 13;
x ^= x >> 7;
x ^= x << 17;
x ^= mask;
return x;
}
void dfs(int u, int father, vector<int> &arr) {
siz[u] = 1;
dp[u] = 0;
for (auto v : graph[u]) {
if (v == father) continue;
dfs(v, u, arr);
siz[u] += siz[v];
dp[u] = max(dp[u], siz[v]);
}
dp[u] = max(dp[u], n – siz[u]);
if (dp[u] <= n / 2) arr.push_back(u);
}
ulint Hsh(int u, int father) {
ulint sum = 1;
for (auto v : graph[u]) {
if (v == father) continue;
sum += f(Hsh(v, u));
}
return sum;
}
pair<ulint, ulint> ptr() {
if (n == 1) return {0, 1};
vector<int> w;
dfs(1, 0, w);
ulint tmp1 = Hsh(w[0], 0);
if (w.size() == 1) return {0, tmp1};
ulint tmp2 = Hsh(w[1], 0);
return {min(tmp1, tmp2), max(tmp1, tmp2)};
}
方法 2:
选择换根 DP ,求出每个点作为根的哈希值。
换根方程的推导:
- 设
 表示以 为根的子树哈希值。
- 设
 表示以 为根的整棵树的哈希值。
那么:
这里的 函数同上。
这些点的哈希值,构成了一个集合。
我们可以再用一次将子树哈希合并为完整的树的方法。
即 若以每个点为根的哈希值分为 。
此时我们可以进行多重集合的比较。
或者对多重集合进行哈希。