全文摘要
这篇论文探讨了如何利用大语言模型(LLM)来进行时间序列预测。通过将时间序列编码为数字串,可以将其视为文本中的下一个标记预测问题。作者发现,GPT-3和LLaMA-2等大型语言模型可以在零样本情况下有效地外推时间序列,并且其性能可以与专门用于下游任务的时间序列模型相媲美甚至更好。为了实现这种性能,作者提出了有效的时间序列数据分词化方法以及将离散分布转换为连续值密度的方法。他们认为,LLM在时间序列方面的成功归因于它们能够自然地表示多模态分布,结合对简单性和重复性的偏好,这与许多时间序列中具有重要特征的趋势重复现象相符。此外,作者还展示了LLM如何可以通过非数值文本处理缺失数据、处理文本侧信息并回答问题以帮助解释预测结果。虽然作者发现在增加模型大小时一般会提高时间序列性能,但他们也指出GPT-4可能比GPT-3表现更差,因为它的数字分词化方式较差,而且由于RLHF等干预措施导致不确定性校准不佳。
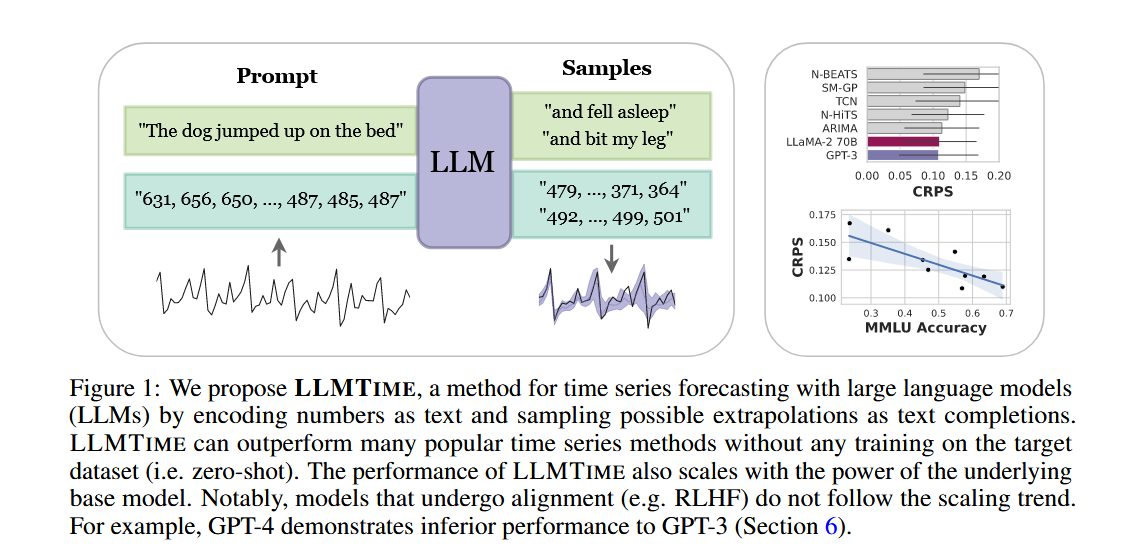
(我们提出的 LLMTIME 是一种利用大型语言模型(LLM)进行时间序列预测的方法,它将数字编码为文本,并将可能的推断采样为文本补全。LLMTIME 不需要在目标数据集上进行任何训练(即零次抽样),就能超越许多流行的时间序列方法。LLMTIME 的性能还与基础模型的能力有关。值得注意的是,经过配准的模型(如 RLHF)并不遵循这一缩放趋势。例如,GPT-4 的性能不如 GPT-3(第 6 节)。)
论文方法
方法描述
LLMTIME是一种使用语言模型进行时间序列预测的方法。该方法包括以下步骤:
方法改进
与传统的基于神经网络的时间序列预测方法相比,LLMTIME具有以下优点:
解决的问题
LLMTIME可以用于解决以下问题:
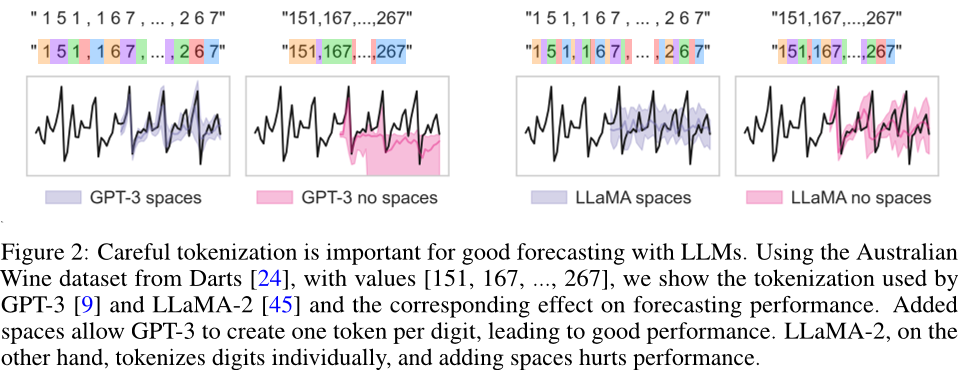
(注:不同 LLM 使用的 tokenizer 不同,空格会显著改变数字的 token 划分方式。对于 GPT-3,添加空格有助于将多位数字拆分为单个数字 token,从而暴露数值结构;而 LLaMA-2 本身已将数字拆分,加空格反而引入噪声,降低预测性能。)
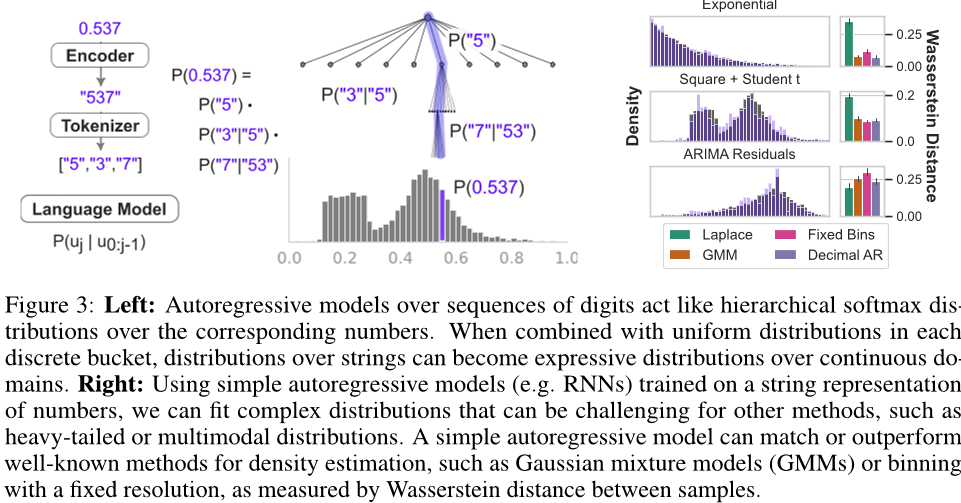
(注:图 3 展示了逐位数字的自回归模型在概率分布建模上的表达能力。左图说明数字序列的自回归生成等价于一种分层 softmax,其对应于连续区间上的概率密度;右图通过合成分布实验表明,即便是简单的数字级语言模型,也能有效拟合重尾、多峰等复杂分布,在 Wasserstein 距离上不逊于甚至优于 GMM 等传统密度估计方法。)
论文实验
本文主要介绍了作者使用预训练语言模型(LLMTIME)对时间序列数据进行预测的实验,并与传统的时间序列方法进行了比较。实验中使用的基准数据集包括Darts、Monash和Informer等,涉及多种类型的时间序列数据。实验结果表明,LLMTIME在各种指标上均优于传统的时间序列方法,包括CRPS和MAE等。
接下来,本文将详细介绍每个对比实验的具体内容:
零样本预测能力实验:该实验旨在测试LLMTIME是否能够在没有任何训练数据的情况下进行预测。实验结果显示,LLMTIME能够以较高的概率生成合理的完成序列,而且其零样本预测能力比专门用于时间序列的方法更好。
确定性结果实验:该实验通过计算MAE值来评估LLMTIME的确定性预测能力。实验结果显示,LLMTIME在所有考虑的基准数据集上的表现都排名前两位,而没有可训练参数。
概率性结果实验:该实验通过对Darts数据集进行分析,比较了LLMTIME和其他基准方法的概率性能。实验结果显示,LLMTIME在CRPS和MAE等指标上都显著优于其他方法。
与PromptCast的比较实验:该实验旨在比较LLMTIME和PromptCast两种方法的性能差异。实验结果显示,LLMTIME在Darts数据集上的CRPS和MAE等指标上均优于PromptCast。
零样本预测能力的原因分析实验:该实验旨在探讨LLMTIME具有零样本预测能力的原因。实验结果显示,LLMTIME的泛化能力与其偏好的简单规则有关,同时它也能够处理一些常见的模式,如周期性和趋势性等。
综上所述,本文通过对多个实验的比较分析,证明了LLMTIME作为一种预训练语言模型,在时间序列预测方面具有很高的潜力和优越性。
论文总结
文章优点
该论文提出了一种新的时间序列预测方法LLMTIME,利用预训练的语言模型来处理时间序列数据,并通过将数值转换为文本的方式来实现。这种方法具有以下优点:
方法创新点
该论文的主要贡献是提出了LLMTIME这一新方法,其创新点在于:
未来展望
该论文为时间序列预测领域带来了新的思路和方法,但仍有一些挑战需要解决。例如,如何处理多变量时间序列数据以及如何进一步优化模型的不确定性表示等。此外,还需要更多的研究来探索如何有效地微调预训练模型以适应特定的任务和数据集。总之,这篇论文为时间序列预测领域的研究提供了有益的启示和指导。
其实
论文总结
文章优点
该论文提出了一种新的时间序列预测方法LLMTIME,利用预训练的语言模型来处理时间序列数据,并通过将数值转换为文本的方式来实现。这种方法具有以下优点:
方法创新点
该论文的主要贡献是提出了LLMTIME这一新方法,其创新点在于:
未来展望
该论文为时间序列预测领域带来了新的思路和方法,但仍有一些挑战需要解决。例如,如何处理多变量时间序列数据以及如何进一步优化模型的不确定性表示等。此外,还需要更多的研究来探索如何有效地微调预训练模型以适应特定的任务和数据集。总之,这篇论文为时间序列预测领域的研究提供了有益的启示和指导。
作者做了两件事:
把时间序列伪装成 LLM 能看懂的输入,
再把 LLM 的离散输出拼成连续概率。
结果发现:即使不训练、不微调,
LLMTIME 也能在很多任务上追平甚至超过专门的时间序列模型。
这得益于 LLM 天生对规律、重复和不确定性的建模能力。
再总结一下这个模型对于序列数据的处理方法:
核心思想是将时间序列预测转化为文本生成中的“下一个Token预测”任务。
为了实现这一点,LLMTIME 提出了一套非常具体且关键的数据预处理流程,主要包含以下几个步骤:
1. 数值缩放 (Rescaling)
LLM 虽然见过很多数字,但如果直接把原始的、跨度极大的数值(比如数百万或极小的浮点数)扔进去,效果不好且浪费 Context 长度。
-
方法:作者没有使用常见的 Min-Max 归一化(即除以最大值),而是采用了一种调整后的缩放方法。他们将数值缩放,使得第
 百分位的数值等于 1。
-
目的:保留数值大小变化的“物理意义”。如果直接除以最大值,所有数都变成 0.xx,模型就很难学习到“进位”的概念(例如从 99 变成 100,位数增加了)。通过保留一部分大于1的数值,让模型能够理解数值位数的增长。
-
细节:通过在验证集上调整
和偏移量  来寻找最佳缩放参数。
2. 序列化与精度控制 (Serialization)
将缩放后的数值数组转化为字符串。
-
去除小数点:由于采用了固定精度,小数点是多余的。文章的做法是直接丢弃小数点。
-
例如:保留2位小数精度,0.123 变成 12,1.23 变成 123,123.0 变成 12300。
-
-
分隔符:使用逗号 , 来分隔时间步。
-
转化结果:原本的时间序列数组变成了一串由数字和逗号组成的文本字符串。
3. 分词处理 (Tokenization) —— 这是最核心的步骤
这是文章为了解决 LLM 算术能力弱点而提出的关键技术(Figure 2)。
-
问题:传统的 BPE(Byte-Pair Encoding)分词器会根据频率把数字切分成奇怪的组合。
-
例如:42235630 可能会被切成 [422, 35, 630]。这种切分破坏了数字的位值结构,使得模型很难进行数学运算或模式识别。
-
-
解决方案(针对不同模型):
-
针对 GPT-3:强制插入空格。
-
方法:在每个数字之间插入空格,将 123 转化为 " 1 2 3"。
-
效果:强制分词器将每一个数字(0-9)单独作为一个 Token。这样模型就能像处理字符一样处理每一位数字,从而更容易学习到算术和周期规律。
-
-
针对 LLaMA-2:不加空格。
-
原因:LLaMA 的分词器设计得比较好,默认就会把数字切分为独立的数字 Token。如果额外加空格,反而会引入无意义的空格 Token,增加序列长度并干扰模型。
-
-
4. 采样与反序列化 (Sampling / Forecasting)
-
预测:将处理好的字符串作为 Prompt 输入给 LLM,让 LLM 生成后续的 Token。
-
采样:通过多次采样(例如 20 次)来构建概率分布。
-
还原:将生成的文本 Token(如 " 4", " 8", " 5")拼接回数字字符串,再逆转之前的缩放操作,得到最终的预测数值。
5. 连续概率分布 (Continuous Likelihoods)
文章还做了一个理论上的转化。虽然 LLM 输出的是离散的 Token 概率(比如下一个词是 "5" 的概率),但作者将其转化为连续的概率密度函数(PDF)。
-
原理:将每个数字 Token 视为一个层级 Softmax(Hierarchical Softmax)。
-
实现:假设每个数字对应一个宽度为
 的区间(
 是进制,n是精度),将离散概率均匀分布在这个区间内,从而计算出连续的对数似然(Log Likelihood)和 CRPS 分数。这使得 LLM 可以与传统的概率时间序列模型进行公平比较。
6. 缺失值处理 (Missing Data)
这是一个非常有趣的特性(见文中 Figure 8)。
-
方法:不需要像传统方法那样进行插值(填补平均值等)。直接在文本中使用 "NaN" 或其他文本标记来代表缺失数据。
-
输入示例:"64, NaN, NaN, 49, NaN, 16"。
-
结果:LLM 能够理解这种文本模式,并根据上下文自动推断缺失部分的趋势,直接进行预测。
总结:
LLMTIME 的数据处理核心在于“把数字当文字看”。通过精细的空格分隔(针对 GPT)和固定精度缩放,迫使 LLM 关注数字的每一位(Digit-level),从而激活了 LLM 强大的模式识别和外推能力。