目录
一、网络结构总览
1. 输入:
2. 模板特征提取:
3. RGBT特征融合:
3.1 C(C dimension operation)通道注意力
3.2 H dimension operation(高度方向自注意力)
3.3 W dimension operation(宽度方向自注意力)
3.4 融合
3.5 总结
4. 分类回归子网络:
该模型出自论文DuSiamIE: A Lightweight Multidimensional Infrared-Enhanced RGBTTracking Algorithm for Edge Device Deployment,影响因子2.69。可能分析的对可能不对,我不论网络设计是否合理,就从作者出发,分析一下作者当时的思路,我不懂事写着玩的。
一、网络结构总览
这并不是一个通用目标检测网络,而是Siamese(孪生)单目标跟踪网络。论文里明确把任务表述为:利用初始帧信息(模板分支)持续定位同一目标(tracking),而不是在全图里找所有类别目标(detection)。
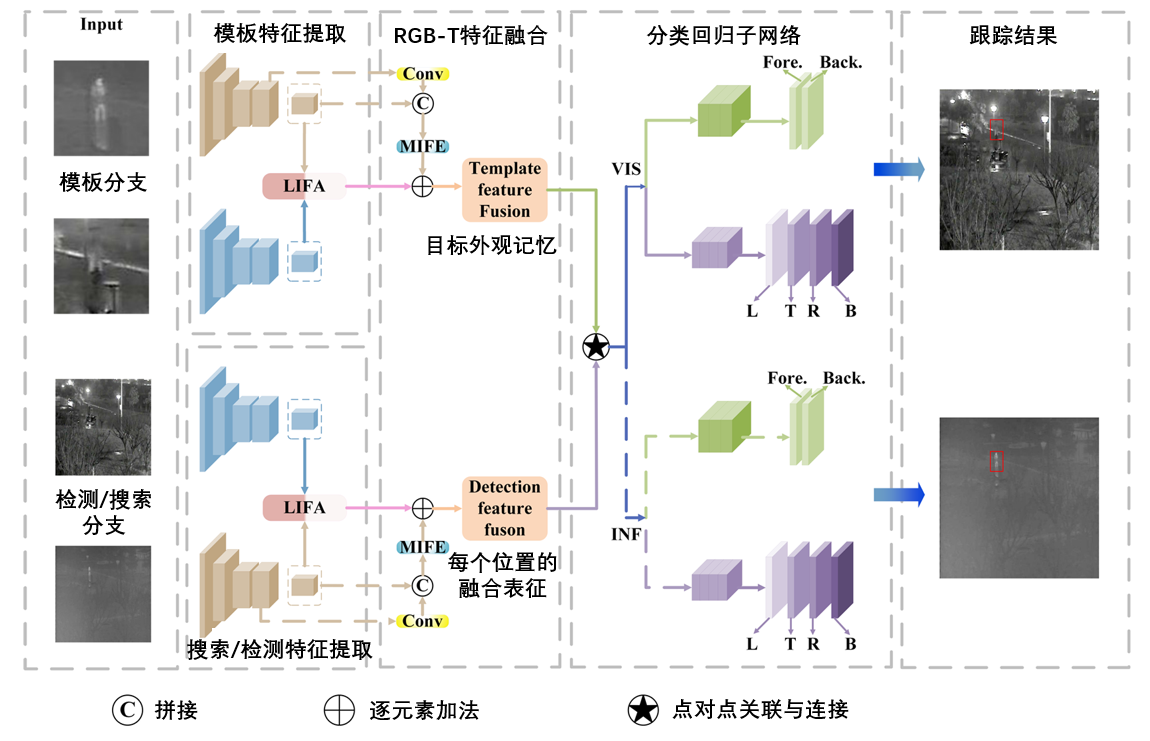
网络分为五个部分,分别为:输入、模板特征提取、RGBT特征融合、分类回归子网络、跟踪结果输出,我会通过四个部分来分析这个网络。
1. 输入:
包含红外和可见光图像,上面是模板分支,输入的是模板图像;下面的是检测分支,也就是目标检测用的图像。实际上是从第一帧中目标框里裁剪出来一个小块,然后利用模板特征去条件化匹配这个搜索区域,再在搜索区域内输出目标框(分类+回归)。
2. 模板特征提取:
从模板与检测图像中提取特征,使用MobileNetV3作为骨干网络,并且VIS深层特征+IR深层特征会进入LIFA(质量感知)模块中进行光照质量感知,输出模态权重调节,输出粉色箭头(调节后的特征)。LIFA的结构如下

LIFA有两路输入,Vis. Feature:可见光分支 backbone 提出来的特征图;Inf. Feature:红外分支 backbone 提出来的特征图。同时,第一帧的可见光图像会被送入光感知网络内,用初始可见光帧去感知光照并产生权重。光感知网络内首先是两次Conv+ReLU+BN,卷积用在初始可见光帧/光照信息上提取与亮度/对比度相关的低层相应,BN操作是对每个通道C(特征图通道数)独自运算,BN操作包括三步:第一,统计均值和方差;第二,归一化原特征;第三,每个通道乘以一个缩放系数再加上一个平移系数,公式如下:
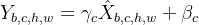
γ 是每个通道一个缩放系数,β 是每个通道一个平移系数。因为 γ 和 β 是参数,跟卷积核一样,会参与训练,通过 loss 反向传播更新,SGD/Adam 会调整它们的值,所以模型可以学到,哪些通道该缩放或者偏移。
重点来了,那么通道是怎么知道他的缩放和偏移都该怎么设置呢,这同样是理解网络到底怎么学参数的核心。靠的是损失函数 + 反向传播。假设现在在训练跟踪网络,最后会有一个loss,比如分类loss,或者回归loss,这部分详细的到第四部分分类回归子网络再讲,现在只说BN的参数是怎么得到的。假设反向传播流程如下
Loss
↓
Head(分类+回归)
↓
融合层(Fusion)
↓
匹配层(Matching)
↓
Backbone(ResNet等)
↓
Backbone(BN/Conv)
↓
输入图像
当梯度传回BN时,BN输出为:
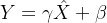
Loss对 的敏感程度,也就是对的梯度为:
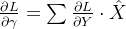
Loss对 的敏感程度,也就是对的梯度为:

含义:
 :归一化后的输入(例如 BN 之后)
- :缩放系数(scale)
- :平移系数(shift)
 :输出
 :最终 loss
现在试着推导的梯度公式,因为:
①
那么等式两边对求导,得到:
 ②
现在使用链式法则:
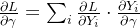 ③
将②代入③中后得到:
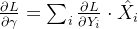 ④
的推导方法与相同,那么 代表什么,他表示如果我把
 增大一点,
 会发生什么变化。
若 :说明增大会让变大,网络希望减小,其实就是斜率向上倾斜。
若 :说明增大会让变小,网络希望增加,其实就是斜率向下倾斜。
 又代表什么呢,他是当前位置的“输入方向/符号”和“强度”。
若 :在这个位置,增大会让增大(因为
)。
若 :在这个位置,增大会让减小(因为乘了负数)。
那么根据和的符号,一共有四种情况:
且:则 正 x 正 = 正,且当增大时增大,又因为,使得增大会让增大,网络会倾向于减小来让减小。如果此处再假如对于的考量,实质上做的是整体抬高或压低,那么在的情况下,减小会导致整体减小,从而让减小。且:则 正 x 负 = 负,且当增大时增大,又因为,使得减小会让增大,网络会倾向于增大来让减小。那么在的情况下,减小会导致整体减小,从而让减小。且:则 负 x 正 = 负,且当增大时减小,又因为,使得增大会让增大,网络会倾向于增大来让减小。那么在的情况下,增大会导致整体增大,从而让减小。且:则 负 x 负 = 正,且当增大时减小,又因为,使得减小会让增大,网络会倾向于减小来让减小。那么在的情况下,增大会导致整体增大,从而让减小。 同时注意,和的更新取决于“所有位置求和后的结果”,而不是某一个“位置 ”。
做了什么,他在做的是整体平移,做的事情是:
也就是说,增大一点点,所有位置的输出都同时增加。那么梯度:

含义: ,
 就是第个位置的上游梯度(误差信号)。所以,的梯度就是误差信号的“整体平均方向”。
做了什么,它不是整体加,而是“按输入模式缩放”,做的事情是:
当增加了一点点 时:

改变输出时,不是每个位置都加同样的量,而是按的大小和符号去变化,如果某个位置,增加会让增加;如果某个位置,增加会让减小;如果某个位置 ,增加对它没影响。所以控制的是输出是否要沿着这个形状(pattern)变得更强或更弱。
用向量/几何解释,定义向量:


那么的梯度其实是内积:

而内积的意义是:衡量两个向量是否“同方向”,如果它们夹角很小(方向一致),内积为正;如果夹角 90°(正交),内积 0;如果方向相反,内积为负。所以:的梯度大 ⇔ 误差方向和输入模式方向对齐;的梯度小 ⇔ 误差方向和输入模式无关。这就是的“相关性”,而是“均值趋势”。
那么和的正负又是谁决定的呢?首先来看BatchNorm(批归一化)中的归一化公式,公式如下:

其中:
 是原始输入数据(一个批次中的某个样本或者某个特征)。
 是该批次数据的均值(在整个batch(批次)内进行计算)。
 是该批次数据的标准差(在整个batch(批次)内进行计算)。
- 是归一化后的结果(mean=0,std=1)。
所以对于BatchNorm,归一化的过程是对每个输入数据做以下操作:从该批次所有数据中减去均值,然后除以标准差,以保证归一化后的数据具有零均值和单位标准差。对此有,若 ;若
 所以的正负是由当前 batch 的统计分布决定的,它反映的是“这个位置的激活高于平均还是低于平均”,正值 = 激活偏强,负值 = 激活偏弱,它是前向传播的结果。
而对于由 后面的网络结构 + 损失函数 + 当前预测误差 决定。假设我们的损失函数使用的是均方误差(MSE):

其中:
 是模型的输出。
 是真实值(标签)。
也就是说,如果某个通道的输出对降低loss有帮助,那么梯度是:

如果 (预测值大于真实值),则,意味着网络应该 减小,因此调整相应的参数来降低输出。如果
 (预测值小于真实值),则,意味着网络应该 增大,因此调整相应的参数来增大输出。所以的符号直接反映了模型 预测与真实值之间的误差。
最后看看GAP,FC,Norm.的作用。

GAP(Global Average Pooling,全局平均池化):其实就是对每个通道,直接把 H×W 的所有像素求平均,因为作者想预测的是“光照强弱”这种东西,不需要知道“哪一块亮”,你更关心“整体偏亮还是偏暗”,并且GAP 是最省 FLOPs 的全局聚合方式之一。
FC(Fully Connected,全连接层):FC1做“抽象”,把卷积+GAP得到的光照描述向量,映射到一个更合适的隐藏空间。FC2做“降维 + 输出权重 logits”,最终输出两个权重,也就是VIS与IR之间的权重。
Norm.(Softmax ,归一化):这个没啥好说的,就是保证融合是“在两种模态之间分配信任度”,不会出现权重同时都很大导致整体幅度乱飘。
只用第一帧图像来分配权重,后续就直接使用计算好的权重,无需再次计算。其实说BN + GAP + FC 连起来看的话,本质上就是一个非常经典的结构:轻量化的“全局条件门控网络”(gating network),他做的就是从初始可见光帧提取一个“光照向量”,然后输出两个权重:
 :信任可见光多少
 :信任红外多少
并且满足:。
3. RGBT特征融合:
下面说RGBT特征融合部分。

可以看到他提取了红外的中层与深层特征,中层首先经过一次Conv,目的是特征图尺寸与通道数对齐,和深层特征进行拼接,目的就是同时保留中层的空间信息和深层的语义信息,这样做的原因是作者认为:红外是短板,需要增强;VIS 已经足够强。
这其实是一种非对称融合,使用质量感知后的红外+可见光特征,再把红外特征原封不动加进去的,这样达到的效果是红外为主 + 可见光为辅,毕竟红外是决定检测性能下限的,用来兜底。所以他实际上是在红外已经可靠检测的情况下根据可见光来提供增益。其实这也是一个残差结构,同时保证红外永远主导。所以他实际上是:

而不是:

下面进入MIFE模块,如下图所示:

他是一个三维分解的自注意力模块,输入的是红外特征图,我们假设张量为(C = 256,H = 20,W = 20),它分别在 C、H、W 三个维度上做“自注意力建模”,然后把三个结果融合。
先说一下自注意力是什么,自注意力做的是:让某个位置(或某个通道)能够“直接参考”其它所有位置(或其它通道)的信息,并按相关性加权汇总。核心产物是一个表示两两关系的注意力矩阵。
那么为什么要把MIFE拆开呢?如果对整个三维张量做“全局注意力”,最直接的方法是把空间展平成 N=HW,空间注意力矩阵大小是 N×N ,例如 H=W=20,N=400,矩阵是 400×400,但如果更大分辨率,成本会迅速爆炸。所以MIFE的思想就是不要一次性做“3D全局注意力”,而是把“全局交互”拆成三种更便宜的交互。
3.1 C(C dimension operation)通道注意力
目的是让不同通道互相交流(哪些通道应该增强/抑制)。我们假设H = 20,W = 20,C = 256,首先把空间展平:

意思是:每个通道 = 一个长度为 HW 的向量,这个向量描述了该通道在所有空间位置的分布。然后他会得到一个矩阵,通道注意力:256 × 256:

这个矩阵表示: ,也就是第 i 个通道 和 第 j 个通道 有多相似也就是一个“通道关系表”。 类似下表,
| 通道1 | ||||
| 通道2 | 0.1 | 0.5 | 0.3 | 0.1 |
| 通道3 | ||||
| 通道4 |
表示的是通道2在更新自己时,要参考其他通道多少,然后将通道重新组合

意思是第 i 个通道 = 所有通道的加权组合。我用通俗的话解释一下就是:每个特征图都表示了目标的一部分特征,例如边缘,中心亮度或者背景噪声,所有特征图之间评价一下是哪个通道可能是冗余或者不重要。这样,最终每个通道就可以得到优化后的信息。
网络是怎么知道这个通道重不重要呢?其实就是调整通道的权重,当发现目标相关的权重被放大时,loss会降低,这样就是正确的调整方向。
那又是怎么判断有联系的呢?其实就是一个很简单的事情,就是相似度比较,如果两个通道在大部分位置上的数值变化趋势相似,激活位置也类似,那他们就有联系。他会得到一个关系分数。
注意力的本质实际上是学习一个“动态加权矩阵”。怎么得到的?其实就是网络这样分配加权方式能让loss最低。
3.2 H dimension operation(高度方向自注意力)
目标是建立行与行之间的全局依赖,其实就是把整张特征图切成很多“横条”,每一条横条就是一行。他把每一行拉成一个向量:

意思是:每一行包含所有通道 + 所有列的信息,之后计算第 r 行和第 s 行是不是相关。

计算方法和C类似,最后的计算方法就是,第 r 行 = 所有行的加权组合。

| 行1 | ||||
| 行2 | 0.1 | 0.5 | 0.3 | 0.1 |
| 行3 | ||||
| 行4 |
红外图像纹理弱,但“上下结构”是稳定的。这一步帮模型:建立纵向结构一致性。
3.3 W dimension operation(宽度方向自注意力)
和高度方向注意力很像,就是把整张特征图切成很多“横条”,然后构建加权网络。首先:

然后:

最后:

意思是:左边区域和右边区域互相参考。
3.4 融合
首先先相加:

然后为了防止分支叠加后数值变成三分,所以取个平均:

3.5 总结
-
通道注意力关注的是:每个通道和其他通道之间的关系。比如说:通道1和通道2之间是不是有类似的特征?
-
行注意力关注的是:每一行(空间上的某一行)和其他行之间的关系。比如说:图像的上半部分和下半部分是不是有某种结构上的联系?
-
列注意力关注的是:每一列(空间上的某一列)和其他列之间的关系。比如说:图像左边和右边是不是有某些共同的特点?
它们的本质就是在做加权组合。首先,每个“通道”或“行”或“列”都会与其他所有的“通道”或“行”或“列”进行相似度计算(你可以理解为“商量”或者“对比”)。然后,这些计算结果会转化成“加权系数”——越相似的关系越强,越不相似的关系越弱。最后,每个“通道”或“行”或“列”会根据这些加权系数,从所有其他的“通道”或“行”或“列”中汲取信息,重新加权组合,得到新的特征。
这三者的区别就在于,加权的“对象”不同:
- 通道注意力:加权的是不同通道(不同特征图)之间的关系;
- 行注意力:加权的是同一张特征图不同行之间的关系;
- 列注意力:加权的是同一张特征图不同列之间的关系。
4. 分类回归子网络:
接下来说分类回归子网络里的这个星号,也就是点对点关联与连接部分。
他其实是经典 Siamese Tracking 里的“相关操作”,他输入的是目标外观记忆和每个位置的融合表征,他在做的是用模板特征去“扫描”搜索特征图,来找搜索图里的哪个位置最像模板。其实他的操作类似卷积,就是把模板当作卷积核,在检测图上滑动。他的操作大概如下:
Template_VIS
│
Search_VIS ── ★ ──> VIS_response
Template_INF
│
Search_INF ── ★ ──> INF_response
最终输出可见光和红外的双模态特征。
继续往后说。

先说什么是LTRB,在很多现代检测/跟踪模型中(尤其 anchor-free 结构),不是预测:(x,y,w,h),而是预测:(L,T,R,B)。
假设在特征图上有一个点(或者一个候选位置),这个点相当于“预测中心”。LTRB 表示:
- L:目标到左边界的距离
- T:目标到上边界的距离
- R:目标到右边界的距离
- B:目标到下边界的距离
图示理解:
T
↑
|
L ← • → R
|
↓
B
假设当前点坐标是 (50, 60),目标真实框是:左上角:(40, 45),右下角:(80, 90)那么:
- L = 50 – 40 = 10
- T = 60 – 45 = 15
- R = 80 – 50 = 30
- B = 90 – 60 = 30
真实标签就是:(10,15,30,30)。不过这个标签不是相对于原图的,而是相对于特征图的。他的跟踪流程如下:
第1帧:给定目标框
↓
之后每一帧:
1. 根据上一帧预测框
2. 在其周围裁剪一个 search patch
3. 在 patch 上做匹配
假设原图大小为640*640,网络输入的不是整张640*640的图像,而是基于目标附近裁剪的比如160*160的小图,因为目标在视频中通常连续运动,且位移有限,所以下一帧目标大概率在裁剪的小图内。但如果运动的太剧烈,那当然就跟踪失败了,需要针对快速移动进行更多处理。
特征图是规则下采样得到的,假设:原图 → backbone → stride=8也就是得到的是20*20像素的特征图。那么,特征图上的每个位置 (i, j)对应原图: ,这是线性可逆映射。
现在来看回归头LTRB以及前面的那一大坨方块。

他是Backbone 输出的共享特征图,(比如 20×20×C),每一个通道(C)都代表一种特征响应,有的通道学边缘,有的通道学纹理,有的通道学语义(比如“像人”“像车”“像目标中心”)。这些通道不是输出结果,是中间表示。
最后一层把很多通道合并成四个回归通道,这时网络通过多个卷积操作(可能是 1×1 的卷积核)对每个位置的特征图进行处理。最终,网络会生成 4 个通道(L、T、R、B)。比较常见的是L/T/R/B 这 4 个输出通道,每一个都是用“全部 256 个通道”共同算出来的。也就是说:不是切块分配,而是加权融合。
但是需要注意的是,并不是每个特征图都包含LTRB这四个值,而是特征图中的每个像素都包含这四个值,比如:
| (0,0) | 2 | 1 | 5 | 4 |
| (0,1) | 1 | 2 | 6 | 3 |
| (0,2) | … | … | … | … |
| … | … | … | … | … |
但是并不是每个特征图的每个像素都有这四个值,而是一个特征图(单通道)每个位置只有 L/T/R/B 其中一个值,四张特征图叠在一起同一个位置可以组合成完整的 LTRB。
然后靠分类分支(Fore/Back)打分,每个位置有一个前景概率,找到前景概率分数最高的像素,然后取这个位置的 LTRB,解码成最终框。一般来说越靠近目标中心的点前景概率分数越高。不过有一些跟踪模型会加入惩罚机制,意思就是不允许预测跳得太远,鼓励选靠近上一帧中心的点。所以最终实际选的不是“绝对最大”,而是: 。
最后再说一个1×1卷积是怎么工作的:用一个 大小为 1×1 的卷积核,该卷积核的数量是 4 个,对应 4 个输出通道。1×1 卷积为每个位置的 256 个通道学习一组权重,然后用这些权重计算输出通道(也就是 L、T、R、B)中每一个值,每个通道的输出都是对每个位置的 256 个特征值进行加权求和,最后就会得到 4 个新的特征图,分别对应 L、T、R、B。
接下来看分类头

Fore.是前景,就是目标;Back.是后景,就是背景之类的。
首先说为什么要有后景,因为如果没有“背景”这个概念,网络根本不知道什么是“不是目标”。机器学习一定是对比学习。没有反例,就学不会正例。
如果只有前景,网络会倾向于判断所有位置都是前景。其实本质上是一个二分类问题。
- 框内 → label = 1(前景)
- 框外 → label = 0(背景)
分析到这里,关于这篇论文网络基础部分就已经说的差不多了。数据分析还没写,有点写力竭了,以后再写。


