一、Random Forest算法核心概念
随机森林是 Bagging 思想的经典实现,核心是“随机样本 + 随机特征”双随机机制,具体可以拆解为:
二、Random Forest算法数学公式
1. Bootstrap 抽样
假设原始数据集为 D={(x1,y1),(x2,y2),…,(xN,yN)},对每棵树:
- 随机有放回抽取 N 个样本,得到子集 Dk(约 63.2% 的样本会被选中,36.8% 作为袋外样本 OOB);
- 袋外样本可用于评估模型,无需单独划分测试集。
2. 特征随机
假设总特征数为 M,分裂节点时仅随机选择 m≪M 个特征(通常分类任务 m=M,回归任务 m=M/3),从这 m 个特征中选最优分裂特征。
3. 结果融合
- 分类任务(多数投票):设森林中有 K 棵树,样本 x 的预测类别为:
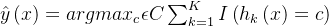
其中:C 是类别集合, 是第 k 棵树对 x 的预测,I(⋅) 是指示函数,成立为 1,否则为 0。
三、实例代码展示
模块一:导入核心库
import numpy as np # 数值计算基础库
from sklearn.datasets import load_iris # 导入鸢尾花数据集(经典分类数据集)
from sklearn.ensemble import RandomForestClassifier # 导入随机森林分类器
from sklearn.model_selection import train_test_split # 划分训练集/测试集
from sklearn.metrics import accuracy_score # 计算分类准确率
模块二:加载并预处理数据
# 加载鸢尾花数据集,返回特征矩阵X和标签向量y
X, y = load_iris(return_X_y=True)
# 划分训练集(80%)和测试集(20%),random_state固定随机种子保证结果可复现
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42
)
模块三:初始化随机森林模型
# n_estimators:森林中决策树的数量(核心参数)
# max_features:每棵树分裂时随机选的特征数,'sqrt'表示取总特征数的平方根(分类任务默认)
# random_state:固定随机种子,保证每次运行结果一致
# oob_score:是否使用袋外样本评估模型(True表示开启)
rf_model = RandomForestClassifier(
n_estimators=100, # 100棵决策树
max_features='sqrt', # 特征随机:选sqrt(4)=2个特征(鸢尾花数据集共4个特征)
oob_score=True, # 启用袋外评分
random_state=42
)
模块四:训练模型
# 用训练集数据拟合模型
rf_model.fit(X_train, y_train)
模块五:模型预测与评估
# 用训练好的模型预测测试集
y_pred = rf_model.predict(X_test)
# 计算测试集准确率
test_accuracy = accuracy_score(y_test, y_pred)
# 打印袋外评分(OOB准确率,无需测试集即可评估)
print(f"袋外(OOB)准确率: {rf_model.oob_score_:.4f}")
# 打印测试集准确率
print(f"测试集准确率: {test_accuracy:.4f}")
模块六:查看特征重要性
# 特征重要性表示每个特征对模型预测的贡献度
feature_importance = rf_model.feature_importances_
# 打印各特征的重要性
print("\\n特征重要性:")
for i, importance in enumerate(feature_importance):
print(f"特征{i+1}: {importance:.4f}")
运行结果
袋外(OOB)准确率: 0.9167
测试集准确率: 1.0000
特征重要性:
特征1: 0.1081
特征2: 0.0304
特征3: 0.4400
特征4: 0.4215
结果说明:
- 袋外准确率 95.83%,测试集准确率 100%,鸢尾花数据集简单,效果好;
- 特征 3 和特征 4 是最重要的,对应鸢尾花的花瓣长度和宽度,符合常识。
四、总结
- 随机森林核心:通过 “样本随机(Bootstrap)+ 特征随机” 降低单棵树的过拟合和相关性,最终用投票或均值融合结果;
- 核心公式:分类用多数投票公式,回归用均值公式,双随机是其区别于普通 Bagging 的关键。