1、说说你了解的JVM内存模型
得分点
类加载子系统、运行时数据区、执行引擎
JVM由三部分组成:类加载子系统、运行时数据区、执行引擎
类加载子系统:通过类加载机制加载类的class文件,如果该类是第一次加载,会执行加载、验证、解析。只负责class文件的加载,至于是否可运行,则由执行引擎决定。
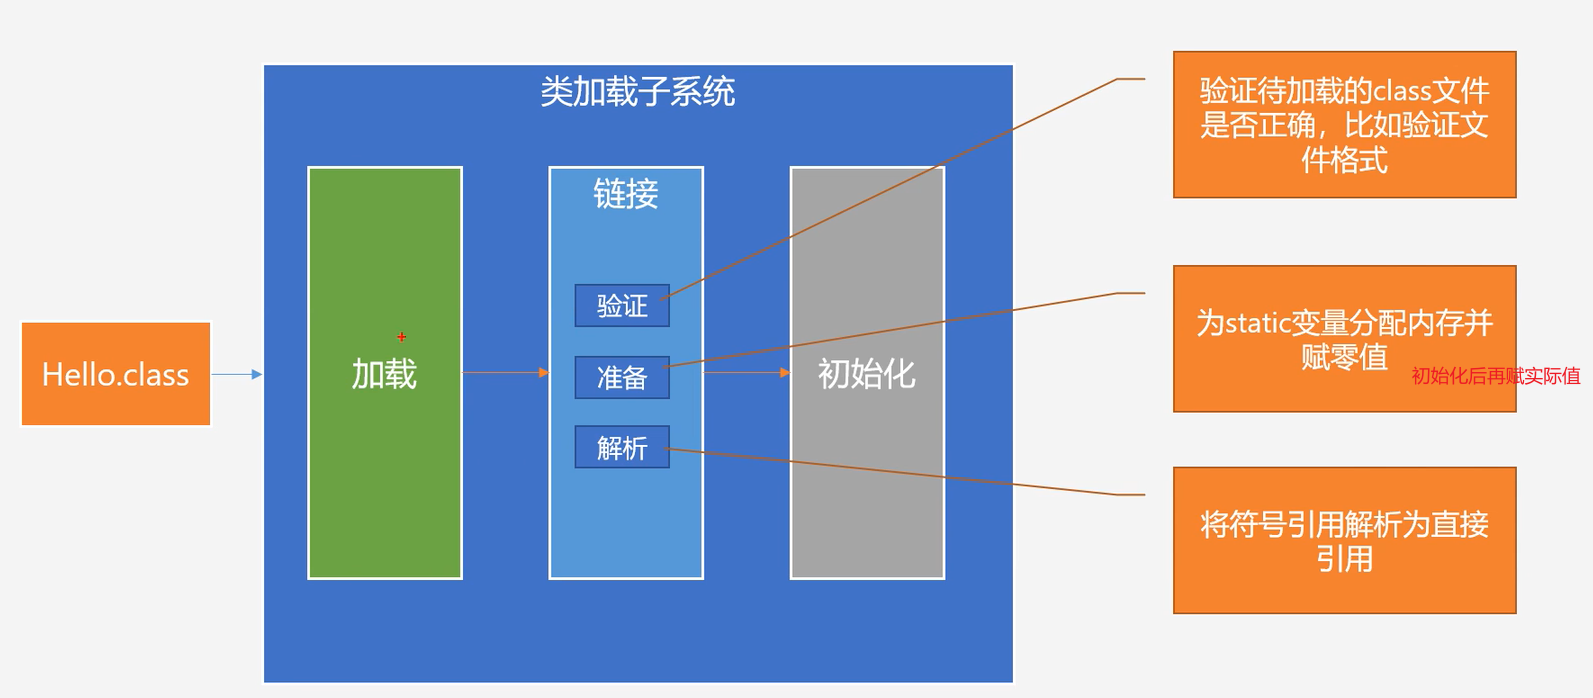
类加载过程是在类加载子系统完成的:加载 –> 链接(验证 –> 准备 –> 解析) –> 初始化
运行时数据区:
在程序运行时,存储程序的内容(例如字节码、对象、参数、返回值等)。运行时数据区包括本地方法栈、虚拟机栈、方法区、堆、程序计数器。
只有方法区和堆是各线程共享的进程内存区域,其他运行区都是每个线程可以独立拥有的。
本地方法栈 存放本地方法调用过程中的栈帧。用于管理本地方法的调用,本地方法是C语言写的。不是所有虚拟机都支持本地方法栈,例如Hotspot虚拟机就是将本地方法栈和虚拟机栈合二为一。栈解决程序的运行问题,即程序如何执行、如何处理数据。
栈帧 栈帧是栈的元素,由三部分组成:
虚拟机栈 存放Java方法调用过程中的栈帧。用于管理Java方法的调用,Java方法是开发时写的Java方法。
方法区 可以看作是一块独立于Java堆的内存空间,方法区是各线程共享的内存区域。
方法区和永久代、元空间的关系 方法区是一个抽象概念,永久代和元空间是方法区的实现方式。
- 永久代:属于JVM方法区的内存,用来存储类的元数据,如类名、方法信息、字段信息等一些静态的数据。JDK7及之前方法区也叫永久代。缺点是内存大小固定,容易出现oom问题。可以通过-XX:PermSize设置永久代大小。永久代对象只能通过Major GC(又称Full GC)进行垃圾回收。
- 元空间:是Hotspot在JDK8引入的,用于取代永久代。元空间属于本地内存,由操作系统直接管理,不再受JVM管理。同时内存空间可以自动扩容,避免内存溢出。默认情况下元空间可以无限使用本地内存,也可以通过-XX:MetaspaceSize限制内存大小。
常量池 就是一张表,JVM根据这张常量表找到要执行的类信息和方法信息。
- 类常量池:是.class字节码文件中的资源仓库,主要存放字面量(表示字符串值和数值,例如字符串值"abc"、final常量、静态变量)和符号引用(类和接口的全限定名、字段名、方法名)。
- 运行时常量池:类加载的“加载”阶段会创建运行时常量池,统一存放各个类常量池去重后的符号引用。在类加载的“解析”阶段JVM会把运行时常量池的这些符号引用转为直接引用。类常量池在字节码文件中的,运行时常量池在内存中。
- 字符串常量池:专门针对String类型设计的常量池。是当前应用程序里所有线程共享的,每个jvm只有一个字符串常量池。存储字符串对象的引用。在创建String对象时,JVM会先在字符串常量池寻找是否已存在相同字符串的引用,如果有的话就直接返回引用,没的话就在堆中创建一个对象,然后常量池保存这个引用并返回引用。
堆 存放对象实例、实例变量、数组,包括新生代(伊甸园区、幸存区S0和S1)和老年代。堆是垃圾收集器管理的内存区域。堆解决的是数据存储的问题,即数据怎么放、放在哪儿。堆实际内存空间可以不连续,大小可以选择固定大小或可扩展,堆是各线程共享的内存区域。
程序计数器(PC寄存器) 存放下一条字节码指令的地址,由执行引擎读取下一条字节码指令并转为本地机器指令进行执行。是程序控制流(分支、循环、跳转、线程恢复)的指示器,只有它不会抛出OutOfMemoryError。每个线程有自己独立的程序计数器,以便于线程在切换回来时能知道下一条指令是什么。程序计数器生命周期与线程一致。
执行引擎:将字节码指令解释/编译为对应平台上的本地机器指令。充当了将高级语言翻译为机器语言的译者。执行引擎在执行过程中需要执行什么样的字节码指令依赖于PC寄存器。每当执行完一项指令操作后,PC寄存器就会更新下一条需要被执行的指令地址。
- 字节码指令(JVM指令):字节码文件中的指令,内部只包含一些能够被JVM所识别的字节码指令、符号表,以及其他辅助信息,不能够直接运行在操作系统之上。
- 本地机器指令:可以直接运行在操作系统之上。
详细参考:
什么是JVM的内存模型?详细阐述Java中局部变量、常量、类名等信息
内存模型:
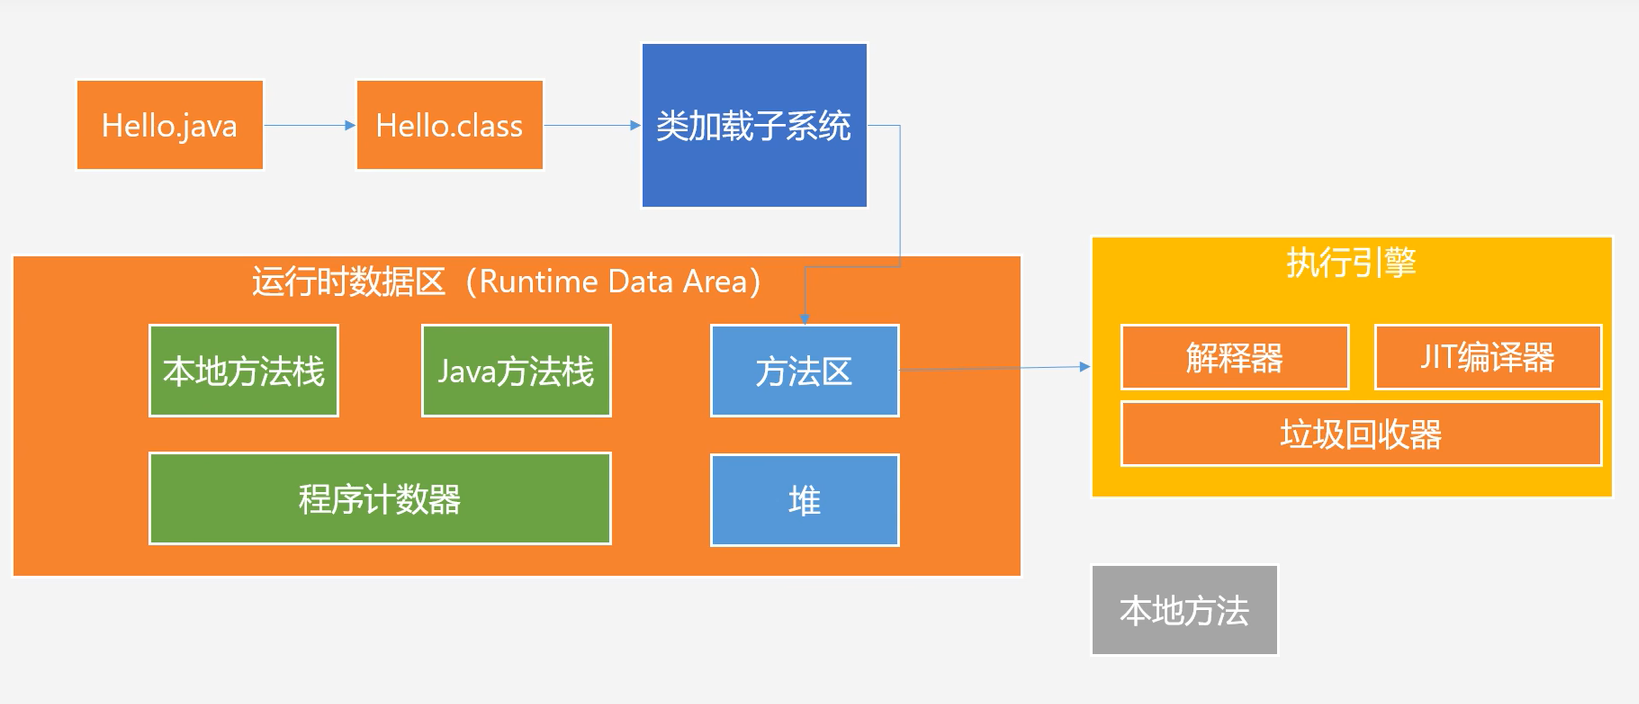
内存模型里的运行时数据区:
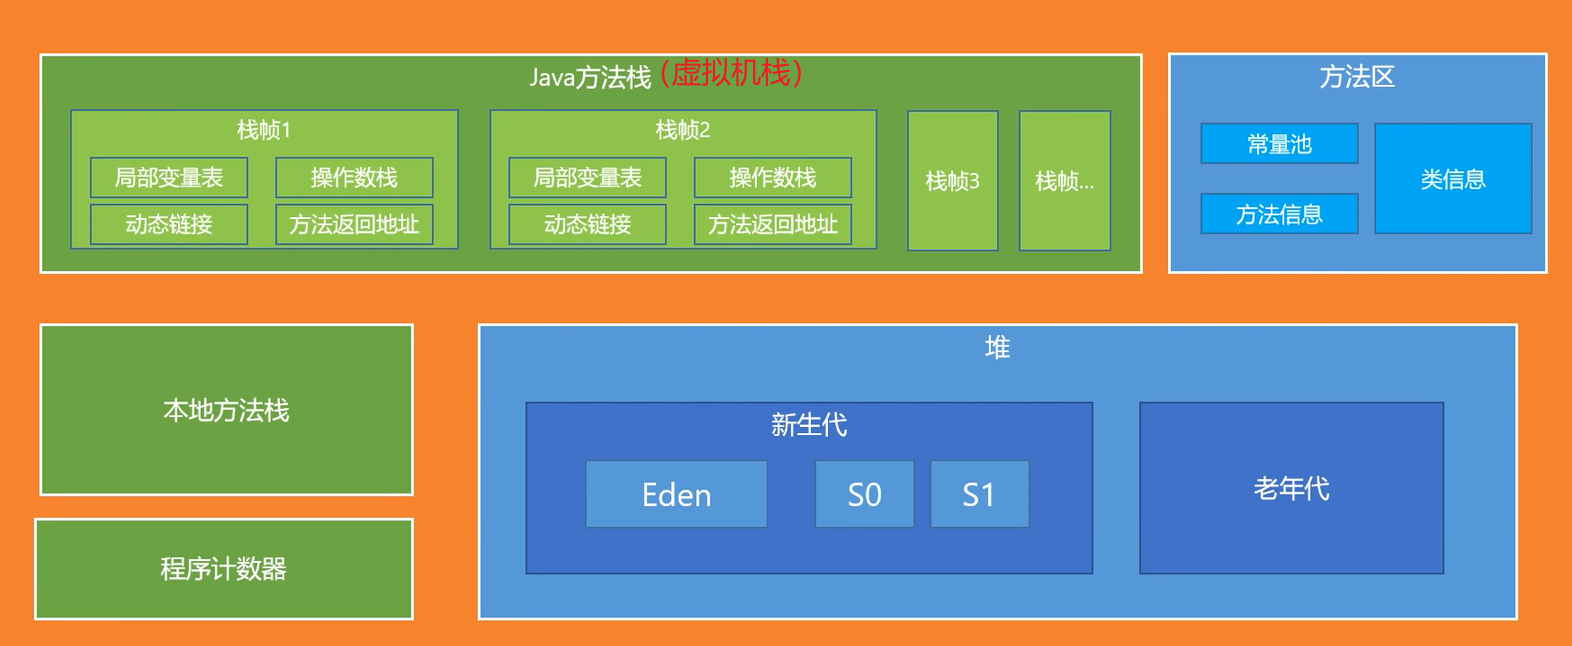
JVM组成 JVM由三部分组成:类加载子系统、执行引擎、运行时数据区。
加分回答 – 运行时数据区 运行时数据区是开发者重点要关注的部分,因为程序的运行与它密不可分,很多错误的排查也需要基于对运行时数据区的理解。在运行时数据区所包含的几块内存空间中:
- 线程共享区域:方法区、堆。
- 线程私有区域:虚拟机栈、本地方法栈、程序计数器(即每个线程都有自己的这个区域)。
2、简单说下你对JVM的了解
得分点
Java跨平台、HotSpot、热点代码探测技术、内存模型、垃圾回收算法、垃圾回收器
跨平台 Java跨平台,JVM不跨平台。 JVM是Java语言跨平台的关键,Java在虚拟机层面隐藏了底层技术的复杂性以及机器与操作系统的差异性。运行程序的物理机千差万别,而JVM则在千差万别的物理机上面建立了统一的运行平台,实现了在任意一台JVM上编译的程序,都能在任何其他JVM上正常运行。这一极大的优势使得Java应用的开发比传统C/C++应用的开发更高效快捷,程序员可以把主要精力放在具体业务逻辑,而不是放在保障物理硬件的兼容性上。通常情况下,一个程序员只要了解了必要的Java类库、Java语法,学习适当的第三方开发框架,就已经基本满足日常开发的需要了,JVM会在用户不知不觉中完成对硬件平台的兼容及对内存等资源的管理工作。
默认Java虚拟机 HotSpot HotSpot是Sun/Oracle JDK和OpenJDK中的默认Java虚拟机,也是目前使用范围最广的Java虚拟机。HotSpot既继承了Sun之前两款商用虚拟机的优点,也有许多自己新的技术优势:
- 热点代码探测技术:名称中的“HotSpot”指的就是这项技术。它通过执行计数器找出最具有编译价值的代码,然后通知即时编译器以方法为单位进行编译。
- 触发机制:如果一个方法被频繁调用,或方法中有效循环次数很多,将会分别触发标准即时编译和栈上替换编译行为。
- 协同工作:通过编译器与解释器恰当地协同工作,可以在最优化的程序响应时间与最佳执行性能中取得平衡。
- 优势:无须等待本地代码输出才能执行程序,即时编译的时间压力也相对减小,这样有助于引入更复杂的代码优化技术,输出质量更高的本地代码。
- 栈结构:在HotSpot中,本地方法栈和Java方法栈是合并的。
内存模型 JVM由三部分组成:类加载子系统、运行时数据区、执行引擎。
3、说说类加载机制
得分点 加载、验证、准备、解析、初始化
标准回答:类加载过程
类加载过程包括:加载、链接(验证、准备、解析)、初始化。这个过程是在类加载子系统完成的。
1. 加载
生成类的 Class 对象。
- 通过类的全限定名获取该类的二进制字节流
- 类的全限定名:即“包名。类名”,例如 Object 类的全限定名是 java.lang.Object。包名的各个部分之间,包名和类名之间,使用点号分割。
- 类的二进制字节流:即类的字节码文件,是一组以8个字节 (64位) 为基础单位的二进制流。各个单位内部及之间都排列紧凑,中间没有添加任何分隔符和空隙,这使得整个 Class 文件中存储的内容几乎都是程序运行的必要数据。当遇到需要占用8个字节以上空间的数据项时,则会按照高位在前的方式分割成若干个8个字节进行存储,保证每个基础单位只有8个字节。
- 将这个字节流的静态存储结构,转化为方法区的运行时数据结构
- 包括创建运行时常量池,将类常量池的部分符号引用放入运行时常量池。
- 静态存储结构:二进制文件。存储内容包括魔数、版本号、常量池、访问标识、类索引、字段表、方法表、属性表。
- 运行时数据结构:存储在内存中的 JVM 内存模型中的运行时数据区 – 方法区。存储内容是类常量池、运行时常量池、字符串常量池。存储形式是永久代(JDK7及之前)和元空间(JDK8及之后)。
- 在内存中生成一个代表这个类的 java.lang.Class 对象
- 作为方法区这个类各种数据的访问入口。
- 注意:类的 Class 对象是运行时生成的、存在内存中的对象;类的 .class 字节码文件是编译时生成的、存在磁盘中的文件。
2. 链接
将类的二进制数据合并到 JRE 中。该过程分为以下3个阶段:
-
验证:确保代码符合 Java 虚拟机规范和安全约束。
- 文件格式验证:验证字节码文件是否符合规范。
- 魔数:是否以 0xCAFEBABE 开头。
- 版本号:版本号是否在 JVM 兼容范围。
- 常量类型:类常量池里常量类型是否合法。
- 索引值:索引值是否指向不存在或不符合类型的常量。
- 元数据验证:元数据是字节码里类的全名、方法信息、字段信息、继承关系等。
- 标识符:验证类名、接口名标识符有没有符合规范。
- 接口实现方法:有没有实现接口的所有方法。
- 抽象类实现方法:有没有实现抽象类的所有抽象方法。
- final类:是不是继承了 final 类。
- 指令验证(字节码验证):主要校验类的方法体,通过数据流和控制流分析,保证方法在运行时不会危害虚拟机安全。
- 类型转换:保证方法体中的类型转换是否有效(例如把某个类强转成没继承关系的类)。
- 跳转指令:保证跳转指令不会跳转到方法体以外的字节码指令上。
- 操作数栈:保证任意时刻操作数栈的数据类型与指令代码序列都能配合工作。
- 符号引用验证:确保后面解析阶段能正常执行。
- 类全限定名地址:验证类全限定名是否能找到对应的类字节码文件。
- 引用地址:引用指向地址是否存在实例。
- 引用权限:是否有权引用。
- 文件格式验证:验证字节码文件是否符合规范。
-
准备:为类变量(即 static 变量)分配内存并赋零值。
-
解析:将方法区 – 运行时常量池内的符号引用(类的名字、成员名、标识符)转为直接引用(实际内存地址,不包含任何抽象信息,因此可以直接使用)。
3. 初始化
类变量赋初值、执行静态语句块。
详细参考:
JDK编译生成的.class字节码文件是什么?从底层结构到代码验证,深度解析Java字节码文件-CSDN博客
Java的类是怎样在虚拟机中加载的?详细阐述JVM的加载、验证和解析过程
一个类型从被加载到虚拟机内存中开始,到卸载出内存为止,它的整个生命周期将会经历加载、验证、准备、解析、初始化、使用、卸载七个阶段,其中验证、准备、解析三个部分统称为连接,而前五个阶段则是类加载的完整过程。
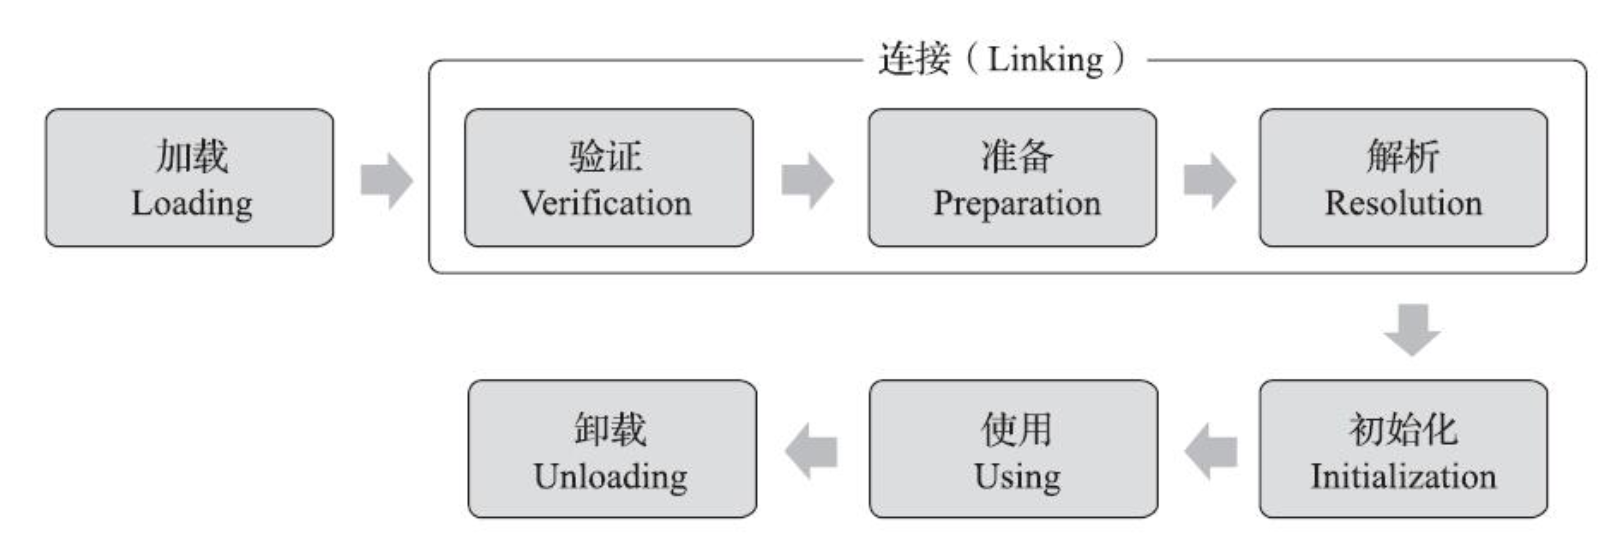
1. 在加载阶段JVM需要在内存中生成一个代表这个类的Class对象,作为方法区这个类的各种数据的访问入口。 2. 验证阶段大致上会完成下面四个阶段的检验动作:文件格式验证、元数据验证、字节码验证、符号引用验证。 3. 准备阶段是正式为类中定义变量(静态变量)分配到内存并设置类变量初始值的阶段,这些变量所使用的内存都应当在方法区中进行分配,但必须注意到方法区本身是一个逻辑上的区域。 4. 解析阶段是Java虚拟机将常量池内的符号替换为直接引用的过程,符号引用以一组符号来描述所引用的目标,直接引用是可以直接指向目标的指针、相对偏移量或者一个能间接定位到目标的句柄。 5. 类的初始化阶段是类加载过程的最后一个步骤,直到初始化阶段,Java虚拟机才真正开始执行类中编写的Java程序代码,将主导权移交给应用程序。本质上,初始化阶段就是执行类构造器的过程。并不是程序员在Java代码中直接编写的方法,它是Javac编译器的自动生成物。
加分回答 关于在什么情况下需要开始类加载过程的第一个阶段“加载”,《Java虚拟机规范》中并没有进行强制约束,这点可以交给虚拟机的具体实现来自由把握。但是对于初始化阶段,《Java虚拟机规范》则是严格规定了有且只有六种情况必须立即对类进行“初始化”: 1. 使用new实例化对象、读写类的静态字段、调用类的静态方法时。 2. 使用java.lang.reflect包的方法对类型进行反射调用时。 3. 当初始化类时,若发现其父类还没有进行过初始化,则先初始化这个父类。 4. 虚拟机启动时,需要指定一个要执行的主类,虚拟机会先初始化这个主类。 5. 当使用JDK 7新加入的动态语言支持时,如果一个java.lang.invoke.MethodHandle实例最后的解析结果为REF_getStatic、REF_putStatic、REF_invokeStatic、REF_newInvokeSpecial四种类型的方法句柄,并且这个方法句柄对应的类没有进行过初始化,则需要先触发其初始化。 6. 当一个接口中定义了JDK 8新加入的默认方法(被default关键字修饰的接口方法)时,如果有这个接口的实现类发生了初始化,那该接口要在其之前被初始化。
4、说说对象的实例化过程
得分点
类加载、分配内存(内存规整和不规整)、处理并发安全问题、设置对象头、成员变量赋初值、执行构造方法
对象的实例化过程
判断对应类是否加载过
- 首先 JVM 检查在方法区(Metaspace/元空间)的常量池里能否定位到该类的符号引用。
- 若已定位:通过符号引用检查该类是否已经过加载、链接、初始化。
- 若未定位:
- 在双亲委派机制下,当前类加载器调用 findClass() 方法查找类的 .class 字节码文件。
- 然后调用 loadClass("类全限定名") 方法,遵循双亲委派机制将类加载、链接、初始化到内存中。
- 生成类的 Class 对象,作为方法区这个类各种数据的访问入口。
创建对象
- 分配堆内存空间
- 如果内存规整(例如使用标记整理算法):采用指针碰撞法为新对象分配内存(移动指针跳过已占用空间)。
- 如果内存不规整(有内存碎片,例如使用标记清除算法):在空闲列表里找到合适大小的空闲内存分配给新对象。
- 注:现在主流虚拟机新生代都是使用标记复制算法,内存通常是规整的。
- 处理并发安全问题
- 方式包括:CAS 失败重试、区域加锁、或为每个线程分配一块 TLAB(Thread Local Allocation Buffer)内存缓冲区。
- 设置对象头
- 将哈希码、GC 分代年龄、锁信息、GC 标记等信息存入对象头的 Mark Word 中。
- 成员变量赋初值
- 若代码中指定了初值,则赋指定的值。
- 若未指定初值,则基本类型赋 0 或 false,引用类型赋 null。
- 执行构造方法
- 若有父类,子类构造方法的第一行会隐式或手动显式地加上 super(),先执行父类构造,再执行子类构造逻辑。
指针碰撞法: 指针一直在空闲和已用内存中间,分配空间时,指针往空闲内存方向移动一段距离,使这段距离刚好满足新对象内存大小。
元空间(Metaspace)
- 引入背景:HotSpot 在 JDK 8 引入,用于取代永久代(PermGen)。
- 内存归属:属于本地内存,由操作系统直接管理,不再受 JVM 堆内存限制。
- 扩容机制:内存空间可以自动扩容,避免内存溢出(OOM)。
- 配置选项:
- 默认情况下可以无限使用本地内存。
- 可通过 -XX:MetaspaceSize 限制初始大小或触发回收的阈值。
指针碰撞法(Bump the Pointer)
- 原理:假设所有用过的内存在一边,空闲的内存在另外一边,中间放着一个指针作为分界点。分配内存时,仅需将指针向空闲方向挪动一段与对象大小相等的距离。
- 适用场景:
- 要求内存绝对规整(无碎片)。
- 通常配合带有 Compact(整理) 过程的垃圾收集器使用,例如 Serial、ParNew 等基于压缩算法的收集器。
回顾 synchronized 用到的对象头 synchronized 锁机制基于对象头的 Mark Word。锁升级的四个状态中:
- 偏向锁 和 轻量级锁:基于 CAS 原子替换操作。
- 重量级锁:基于 Monitor 对象。
对象头结构
锁信息详解(Mark Word 中的锁标志位)
- 01:未锁定 或 可偏向(具体看偏向锁标志位)。
- 00:轻量级锁。
- 10:重量级锁。
- 11:垃圾回收标记(GC Mark)。
不同锁状态下的存储内容:
- 偏向锁:存储偏向线程 ID、时间戳等。
- 轻量级锁:存储指向栈中 锁记录(Lock Record) 的指针。
- 重量级锁:存储指向堆中 Monitor 对象 的指针。
【Java面试八股文】Java多线程篇_java多线程八股文_vincewm的博客-CSDN博客
在JVM中,对象的创建遵循如下过程:
当JVM遇到一条字节码new指令时,首先将去检查这个指令的参数是否能在常量池中定位到一个类的符号引用,并且检查这个符号引用代表的类是否已被加载、解析和初始化过。如果没有,那必须先执行相应的类加载过程。
在类加载检查通过后,接下来虚拟机将为新生对象分配内存。对象所需内存的大小在类加载完成后便可完全确定,为对象分配空间的任务实际上便等同于把一块确定大小的内存块从Java堆中划分出来。
内存分配完成之后,虚拟机必须将分配到的内存空间都初始化为零值,如果使用了TLAB的话,这一项工作也可以提前至TLAB分配时顺便进行。这步操作保证了对象的实例字段在Java代码中可以不赋初始值就直接使用,使程序能访问到这些字段的数据类型所对应的零值。
接下来,虚拟机还要对对象进行必要的设置,例如这个对象是哪个类的实例、如何才能找到类的元数据信息、对象的哈希码、对象的GC分代年龄等信息。这些信息存放在对象的对象头之中。根据虚拟机当前运行状态的不同,如是否启用偏向锁等,对象头会有不同的设置方式。
在上面工作都完成之后,从虚拟机的视角来看,一个新的对象已经产生了。但是从Java程序的视角看来,对象创建才刚刚开始——构造函数,即Class文件中的`<init>()`方法还没有执行,所有的字段都为默认的零值,对象需要的其他资源和状态信息也还没有按照预定的意图构造好。
一般来说,new指令之后会接着执行`<init>()`方法,按照程序员的意愿对对象进行初始化,这样一个真正可用的对象才算完全被构造出来。
5、说说JVM的双亲委派模型
得分点
三个默认类加载器、工作过程、作用
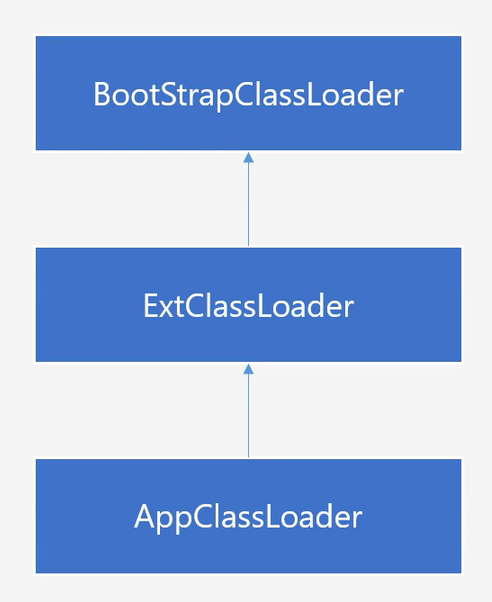
双亲委派模型 当一个类加载器接收到加载类的请求时,它首先会将这个请求委派给其父类加载器处理。只有在父类加载器无法完成加载任务时(即父类加载器在其搜索范围内未找到该类),才会由该类加载器自己去尝试加载。
JVM 三个默认类加载器
启动类加载器 (Bootstrap ClassLoader)
- 层级:最顶端(根加载器)。
- 实现语言:底层使用 C++ 实现,是虚拟机自身的一部分,因此不继承 java.lang.ClassLoader 类。
- 加载内容:负责加载 Java 的核心类库(如 java.lang 包中的类等)。
- 路径:JAVA_HOME\\lib 目录下的类库。
- 自定义路径:被 -Xbootclasspath 参数指定的路径中的类库。
- 引用特性:不能被 Java 程序直接引用。因为是 C++ 实现的,Java 代码中获取不到其实例,只能处理委派过来的加载请求。
扩展类加载器 (Extension ClassLoader)
- 层级:中间层(Bootstrap 的子加载器)。
- 实现语言:Java 实现 (sun.misc.Launcher$ExtClassLoader)。
- 加载内容:负责加载扩展类库。
- 路径:JAVA_HOME\\lib\\ext 目录中的所有类库。
- 自定义路径:被 java.ext.dirs 系统变量所指定的路径中的所有类库。
- 引用特性:可以被直接引用。既可以直接用来加载指定路径的类,也可以通过双亲委派机制加载类。
- 名称含义:Ext 是 Extract 的缩写,意为扩展、提取。
应用程序类加载器 (Application ClassLoader / System ClassLoader)
- 层级:最低端(Ext 的子加载器,也是用户自定义类加载器的默认父加载器)。
- 实现语言:Java 实现 (sun.misc.Launcher$AppClassLoader)。
- 加载内容:负责加载用户类路径(Classpath)上的所有类库。
- 在大多数情况下,我们编写的 Java 程序都是由这个类加载器加载的。
- 引用特性:可以被直接引用。可以直接在代码中通过 ClassLoader.getSystemClassLoader() 获取并使用。
双亲委派模型的工作过程
检查父类加载器是否已经加载过这个类
- JVM 首先询问父类加载器是否已经加载了该类。
- 如果已经加载过,直接返回该类的 Class 对象,不再进行后续步骤。
委派给父类加载器加载
- 如果父类加载器没有加载过该类,JVM 将委托给父类加载器进行加载。
- 每一层类加载器都遵循此规则,继续向上委派,直到达到最顶层的启动类加载器 (Bootstrap ClassLoader)。
尝试加载类
- 如果父类加载器无法加载该类(即所有的父类加载器在其搜索范围内都未找到该类),当前的类加载器才会尝试使用自己的加载逻辑去加载该类。
实际流程示例 当 JVM 需要加载一个类时:
- 若 Bootstrap ClassLoader 加载成功:直接返回结果。
- 若 Bootstrap ClassLoader 加载失败:返回给 ExtClassLoader,由 ExtClassLoader 尝试自己加载。
- 若 ExtClassLoader 也加载失败:返回给 AppClassLoader,由 AppClassLoader 尝试自己加载。
双亲委派模型的作用
避免类的重复加载
- 无论哪一个类加载器要加载某类,最终都会委派给最顶端的启动类加载器去尝试。如果父类加载器能加载,子类加载器就不会再加载,从而保证了一个类在 JVM 中只会被加载一次,确保全局唯一性。
防止核心 API 被篡改(沙箱安全机制)
- 如果没有双亲委派模型,各个类加载器自行加载,用户若编写了一个名为 java.lang.Object 的类并放在 ClassPath 中,系统就会出现多个不同的 Object 类。
- 这将导致 Java 类型体系中最基础的行为无法保证,应用程序将会变得混乱甚至不安全。
- 通过双亲委派,核心类库(如 java.lang.*)永远由最信任的启动类加载器加载,用户自定义的同名类无法覆盖核心类,从而保障了系统的安全性。
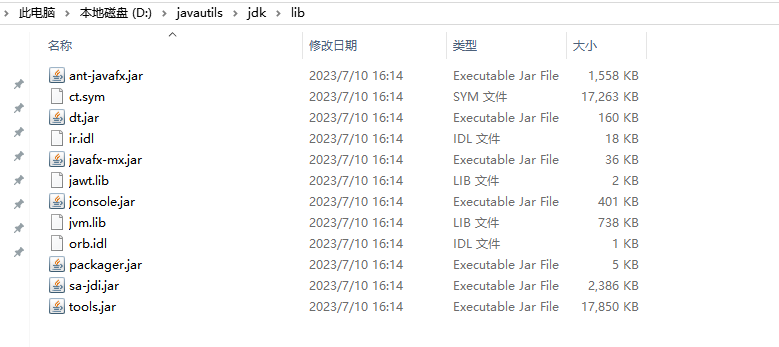
JAVA_HOME\\lib 目录详解
1. 定义与位置
- 位置:JDK (Java Development Kit) 安装目录下的 lib 子目录。
- 作用:包含 Java 核心类库、基础类和工具类。这些是 Java 编程语言的基础,为 Java 程序的编译和运行提供必要支持。
2. 重要文件列表 该目录下包含多个关键的 .jar 文件,主要包括:
-
rt.jar (Runtime)
- 内容:Java 运行时的核心库。
- 包含包:java.lang、java.util、java.io、java.net 等最基础的类库。
- 地位:最核心的类库,几乎所有 Java 程序都依赖它。
-
charsets.jar
- 内容:包含字符集支持的类库,用于处理不同编码格式的转换。
-
jfxrt.jar (JavaFX Runtime)
- 内容:JavaFX 运行时的核心库,用于构建富客户端应用程序(注:JDK 11 起 JavaFX 已模块化并移除出 JDK 默认发行版)。
-
tools.jar
- 内容:包含 Java 开发工具的类库。
- 用途:供编译器 (javac)、调试器 (jdb)、文档生成器 (javadoc) 等开发工具使用。
- 注意:仅在 JDK 中存在,JRE 中通常没有此文件。
-
dt.jar (Design Time)
- 内容:包含 Java 开发工具包的类库,主要涉及图形界面工具和设计时支持。
3. 加载机制
- 加载者:启动类加载器 (Bootstrap ClassLoader)。
- 过程:在编译和运行 Java 程序时,Bootstrap ClassLoader 会自动加载 JAVA_HOME\\lib 目录下的核心类库(特别是 rt.jar)。
- 目的:确保程序能够使用 Java 核心类库提供的功能,且这些核心类具有最高的优先级和安全性。
JAVA_HOME\\lib\\ext 目录详解
1. 定义与位置
- 位置:JDK (Java Development Kit) 安装目录下的 lib/ext 子目录。
- 作用:用于存放 Java 的扩展类库。这些类库提供了 Java 平台的标准扩展功能,如 XML 解析、网络协议支持、加密解密服务等。
2. 加载机制
- 加载者:扩展类加载器 (Extension ClassLoader / ExtClassLoader)。
- 自动加载:位于此目录下的所有 .jar 文件会被 ExtClassLoader 自动加载,无需手动配置类路径(Classpath)。
- 系统变量:除了默认目录,还可以通过系统变量 java.ext.dirs 指定额外的扩展目录。
3. 常见扩展类库文件 该目录下通常包含以下 JAR 文件,提供特定领域的高级功能:
- dnsns.jar
- 功能:DNS 名称服务提供者实现,用于处理域名解析相关的网络功能。
- jaccess.jar
- 功能:Java Access Bridge 实现,主要用于支持辅助技术(如屏幕阅读器)与 Java 应用程序的交互。
- ldapsec.jar
- 功能:LDAP (轻量级目录访问协议) 安全实现,提供基于 LDAP 的安全认证支持。
- sunjce_provider.jar
- 功能:Sun 提供的 JCE (Java Cryptography Extension) 实现,包含各种加密算法(如 AES, DES, RSA 等)和密钥生成器。
- sunpkcs11.jar
- 功能:Sun 提供的 PKCS#11 提供者实现,允许 Java 程序通过本地硬件安全模块 (HSM) 或智能卡进行加密操作。
4. 使用场景与注意
- 按需使用:这些扩展类库提供了高级功能,但并非所有 Java 运行时环境都会用到。
- 类路径配置:
- 在标准 JDK/JRE 环境中,放在 ext 目录下的 jar 包会被自动识别并加载。
- 如果将 jar 包移出该目录,则需要手动将其添加到程序的类路径(Classpath)中才能被访问。
- 版本演进提示:从 JDK 9 开始,引入了模块化系统 (Project Jigsaw),ext 目录机制已被废弃。扩展机制被模块路径 (Module Path) 取代,原有的扩展类库大多转化为标准模块或独立模块。上述描述主要适用于 JDK 8 及之前 的版本。
类路径:
classpath:类路径classpath是编译之后的target文件夹下的WEB-INF/class文件夹。内容等同于打包前的src.main.java和src.main.resource下的目录和文件
classpath* :不仅包含class路径,还包括jar文件中(class路径)进行查找.
对于JDK8及其之前版本的Java应用,都会使用到以下3个系统提供的类加载器来进行加载:
1.启动类加载器
这个类加载器负责加载存放在`<java_home>\\lib`目录,或者被-Xbootclasspath参数所指定的路径中存放的,而且是Java虚拟机能够识别的类库加载到虚拟机的内存中。注意,Java虚拟机会按照文件名识别类库,例如rt.jar、tools.jar,对于名字不符合的类库即使放在lib目录中也不会被加载。启动类加载器无法被Java程序直接引用,用户在编写自定义类加载器时,如果需要把加载请求委派给引导类加载器去处理,那直接使用null代替即可,即让java.lang.ClassLoader.getClassLoader()返回null。
2.扩展类加载器
这个类加载器是在类sun.misc.Launcher$ExtClassLoader中以Java代码的形式实现的。它负责加载`<java_home>\\lib\\ext`目录中,或者被java.ext.dirs系统变量所指定的路径中所有的类库。由于扩展类加载器是由Java代码实现的,开发者可以直接在程序中使用扩展类加载器来加载Class文件。
3.应用程序类加载器
这个类加载器由sun.misc.Launcher$AppClassLoader来实现。它负责加载用户类路径(ClassPath)上所有的类库,开发者同样可以直接在代码中使用这个类加载器。
用户还可以加入自定义的类加载器来进行拓展,这些类加载器之间的协作关系“通常”如下图所示。图中展示的各种类加载器之间的层次关系被称为类加载器的“双亲委派模型”。双亲委派模型要求除了顶层的启动类加载器外,其余的类加载器都应有自己的父类加载器。不过这里类加载器之间的父子关系一般不是以继承的关系来实现的,而是通常使用组合关系来复用父加载器的代码。
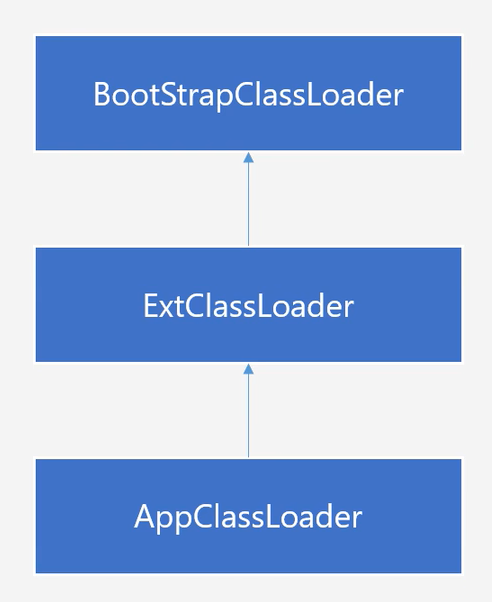
对于JDK9及其之后版本的Java应用,类加载机制发生了重大变革,主要引入了模块化系统(JPMS),原有的三层结构调整为以下3个核心类加载器:
这个类加载器负责加载Java核心模块(如java.base)以及指定的系统模块。在JDK9中,它不再仅仅依赖<java_home>\\lib目录下的特定JAR文件(因为rt.jar等已被移除,合并为lib/modules镜像文件),而是基于模块路径加载。实现类从C++变为了Java代码实现的jdk.internal.loader.BuiltinClassLoader。注意,虽然它现在由Java实现,但在大多数场景下仍被视为顶层加载器,用户在编写自定义类加载器时,如果需要把加载请求委派给启动类加载器处理,通常依然使用null代替,或者通过模块系统自动处理。
这个类加载器是在类jdk.internal.loader.PlatformClassLoader中以Java代码的形式实现的。它取代了JDK8中的扩展类加载器(ExtClassLoader)。它负责加载除核心模块以外的其他Java平台模块(如java.sql, java.xml等),这些模块以前可能位于<java_home>\\lib\\ext目录或作为独立JAR存在。由于扩展机制(java.ext.dirs)在JDK9中被废弃,开发者不能再依赖ext目录自动加载类库,而应将这些库放在类路径或通过模块路径指定。开发者可以直接在程序中使用平台类加载器(通过ClassLoader.getSystemClassLoader().getParent()获取)来加载Class文件。
这个类加载器由jdk.internal.loader.ClassLoaders$AppClassLoader来实现(JDK8中为sun.misc.Launcher $ AppClassLoader)。它负责加载用户类路径(ClassPath)上所有的类库,以及未声明为模块的普通JAR包。开发者同样可以直接在代码中使用这个类加载器(通过ClassLoader.getSystemClassLoader()获取)。在模块化应用中,它还负责加载应用模块路径(–module-path)上的应用模块。
用户还可以加入自定义的类加载器来进行拓展,这些类加载器之间的协作关系“通常”如下图所示(逻辑层次为:启动 -> 平台 -> 应用 -> 自定义)。图中展示的各种类加载器之间的层次关系依然遵循“双亲委派模型”的核心思想,但具体实现有所调整。双亲委派模型要求除了顶层的启动类加载器外,其余的类加载器都应有自己的父类加载器。不过这里类加载器之间的父子关系一般不是以继承的关系来实现的,而是通常使用组合关系来复用父加载器的代码。此外,JDK9+更加强调模块间的可见性约束,类加载不仅受父子委派限制,还受模块描述符(module-info.java)中exports和requires语句的限制。
这是 JVM 类加载机制的默认行为和核心原则。
具体执行逻辑
当这三个类加载器中的任何一个收到加载请求(调用 loadClass() 方法)时,都会执行以下标准流程:
- 应用程序类加载器 (AppClassLoader) 收到请求 -> 委派给 平台类加载器 (PlatformClassLoader / JDK8为ExtClassLoader)。
- 平台类加载器 收到请求 -> 委派给 启动类加载器 (BootstrapClassLoader)。
- 如果启动类加载器找不到该类,它会返回“加载失败”的信号给子加载器(平台类加载器)。
- 平台类加载器收到失败信号后,才会在自己的加载路径(如模块路径或 lib/ext)中尝试加载。
- 如果平台类加载器也找不到,它再返回失败信号给应用程序类加载器。
- 最后,应用程序类加载器 才会尝试在自己的类路径(Classpath)中加载该类。
为什么要遵守?
这三个系统类加载器严格遵守双亲委派,主要是为了实现前文提到的两个核心作用:
保证核心类库的唯一性和安全性:
- 确保 java.lang.Object、java.lang.String 等核心类永远只能由最顶层的启动类加载器加载。
- 防止用户在 Classpath 下自定义一个 java.lang.Object 来篡改核心逻辑(因为请求会先委派给启动类加载器,它找到了标准的 Object 就直接返回了,根本轮不到应用类加载器去加载用户自定义的那个)。
避免类的重复加载:
- 确保同一个类在 JVM 中只被加载一次。如果父加载器已经加载了,子加载器就不会再加载,从而保证系统中该类的唯一性。
特殊情况说明(“破坏”双亲委派)
虽然这三个默认加载器本身的设计逻辑是遵守双亲委派的,但在某些特定场景下,Java 程序可以通过手段绕过这一模型:
- SPI 机制(如 JDBC):核心接口由启动类加载器加载,但实现类由应用类加载器加载。此时核心代码会使用线程上下文类加载器 (Thread Context ClassLoader) 来“逆向”委托子加载器去加载实现类。这看似破坏了模型,但实际上是应用代码主动发起的特殊加载逻辑,而非默认类加载器自动违背了规则。
- 自定义类加载器:开发者可以编写自定义类加载器,重写 loadClass() 方法,强行让自己先加载,或者指定特定的父加载器,从而打破双亲委派。但这属于用户自定义行为,不是系统默认的三个类加载器的行为。
总结: 系统自带的三个类加载器(Bootstrap, Platform/Ext, App)在默认实现中是严格死守双亲委派模型的。任何“破坏”行为通常都是开发者为了特定需求(如 SPI、热部署),通过代码手段(如使用线程上下文类加载器或自定义加载器)主动干预的结果。
工作过程
双亲委派模型的工作过程是:如果一个类加载器收到了类加载的请求,它首先不会自己去尝试加载这个类,而是把这个请求委派给父类加载器去完成。每一个层次的类加载器都是如此,因此所有的加载请求最终都应该传送到最顶层的启动类加载器中。只有当父加载器反馈自己无法完成这个加载请求(即在其搜索范围内未找到该类)时,子加载器才会尝试自己去完成加载。
作用
- 避免类的重复加载:保证一个类在 JVM 中只被加载一次。
- 防止核心 API 被篡改:确保核心类库(如 java.lang.Object)的安全性。
使用双亲委派模型来组织类加载器之间的关系,一个显而易见的好处就是 Java 中的类随着它的类加载器一起具备了一种带有优先级的层次关系。例如类 java.lang.Object,它存放在 rt.jar(JDK 8 及之前)之中,无论哪一个类加载器要加载这个类,最终都是委派给处于模型最顶端的启动类加载器进行加载,因此 Object 类在程序的各种类加载器环境中都能够保证是同一个类。
反之,如果没有使用双亲委派模型,都由各个类加载器自行去加载的话,如果用户自己也编写了一个名为 java.lang.Object 的类,并放在程序的 ClassPath 中,那系统中就会出现多个不同的 Object 类,Java 类型体系中最基础的行为也就无从保证,应用程序将会变得一片混乱。
加分回答 – 双亲委派模型的 3 次被破坏
双亲委派模型并不是一个具有强制性约束的模型,而是 Java 设计者推荐给开发者们的类加载器实现方式。在 Java 的世界中大部分的类加载器都遵循这个模型,但也有例外的情况,双亲委派模型主要出现过 3 次较大规模的“被破坏”的情况:
1. 双亲委派模型的第一次“被破坏”:发生在模型出现之前(兼容旧代码)
- 背景:双亲委派模型在 JDK 1.2 之后才被引入,但类加载器的概念和抽象类 ClassLoader 在 Java 第一个版本中就已存在。
- 原因:为了兼容那些在 JDK 1.2 之前已经存在的、自定义了加载逻辑的用户代码,设计者不能强制修改 loadClass() 的行为。
- 解决方案:在 ClassLoader 中新增了一个 protected 方法 findClass(),并引导用户在编写自定义类加载器时,尽可能重写 findClass() 方法,而不是重写 loadClass()。
- 结果:loadClass() 中实现了双亲委派的默认逻辑(先委托父类,失败后调用 findClass())。这样既不影响旧代码(如果旧代码重写了 loadClass() 则按旧逻辑走),又保证了新写的类加载器符合双亲委派规则。
2. 双亲委派模型的第二次“被破坏”:由模型自身的缺陷导致(SPI 机制)
- 背景:双亲委派很好地解决了基础类型的一致性,但在“基础类型调用用户代码”的场景下失效。
- 典型案例:JNDI (Java Naming and Directory Interface) 服务。
- JNDI 接口由启动类加载器(Bootstrap)加载,属于核心基础类。
- JNDI 的具体实现(SPI,如厂商提供的驱动)部署在应用的 ClassPath 下,应由应用程序类加载器(AppClassLoader)加载。
- 矛盾:根据双亲委派,Bootstrap 加载器无法委托 AppClassLoader 去加载底层的实现类,导致核心接口找不到实现。
- 解决方案:引入线程上下文类加载器 (Thread Context ClassLoader)。
- 通过 Thread.setContextClassLoader() 设置,默认为 AppClassLoader。
- SPI 服务(由 Bootstrap 加载)通过 Thread.currentThread().getContextClassLoader() 获取到 AppClassLoader。
- 利用这个“子加载器”去加载 SPI 的实现类。
- 结果:这是一种父类加载器请求子类加载器完成类加载的行为,逆向打通了双亲委派模型的层次结构,违背了一般性原则,但解决了 SPI 服务发现的问题。
3. 双亲委派模型的第三次“被破坏”:由于用户对程序动态性的追求(热部署/模块化)
- 背景:追求代码热替换、模块热部署(Hot Swap / Hot Deployment)。希望像插拔 USB 设备一样,不用重启机器就能更新代码。
- 典型案例:OSGi (Open Service Gateway initiative)。
- 在 OSGi 环境下,每个程序模块(Bundle)都有自己独立的类加载器。
- 当需要更换一个 Bundle 时,直接丢弃旧的类加载器实例,创建新的类加载器实例重新加载类。由于类加载器实例不同,JVM 视为不同的类,从而实现热替换。
- 结构变化:
- 类加载器不再是简单的树状结构,而是发展为更加复杂的网状结构。
- 每个 Bundle 可以指定依赖其他 Bundle,类加载器之间互相委托,不再严格遵循自顶向下的双亲委派。
- 结果:为了实现高度的动态性和模块化隔离,彻底打破了标准的双亲委派模型,建立了自定义的类加载协作机制。
热部署打破双亲委派机制,重写classLoader.loadClass——>先找自己再找父
6、说说JVM调优思路
JVM调优三步骤、性能监控、性能分析、性能调优
第一步:监控发现问题
观察服务器是否出现以下情况,若有则需要进行调优:
- GC 频繁:Young GC 或 Full GC 次数过多。
- CPU 负载过高:用户态或内核态 CPU 占用率异常。
- OOM (Out Of Memory):内存溢出错误。
- 内存泄露:对象无法被回收,内存持续增长。
- 死锁:线程互相等待资源,程序停滞。
- 响应时间过长:程序处理请求延迟高。
第二步:工具分析问题
使用分析工具定位 OOM、内存泄漏、死锁等具体问题。
1. 调优依据(核心原则)
- 吞吐量 vs 停顿时间:两者通常不可兼得。
- 后台批处理/科学计算(少交互):优先提升吞吐量。
- Web 服务/交互式应用(频繁交互):优先缩短停顿时间。
2. 常用工具介绍
A. GC 日志分析
- 工具:GCViewer, VisualVM, GCEasy。
- 作用:分析 GC 频率、停顿时间、内存变化趋势。
B. JDK 自带命令行工具 (适合无 GUI 环境)
| jps | 查看正在运行的 Java 进程及启动参数。 | jps -v (查看 JVM 参数) |
| jstat | 查看 JVM 统计信息(堆分区、GC 次数/时长)。纯文本环境首选。 | jstat -gc <pid> 1000 (每秒刷新) |
| jinfo | 实时查看和修改 JVM 配置参数。 | jinfo -flag <param> <pid> |
| jstack | 打印线程快照。定位死锁、阻塞、长时间等待。 | jstack <pid> (若死锁会明确提示) |
| jmap | 生成堆转储文件 (Heap Dump)。 | jmap -dump:live,format=b,file=heap.hprof <pid> |
注:线程快照包含进程内每条线程正在执行的方法堆栈集合。
C. JDK 自带可视化工具
- JConsole:基础监控 CPU、内存、线程。
- VisualVM:功能更强,可监视 CPU、GC、堆、方法区,查看线程快照、JVM 参数、系统属性,支持插件扩展。
D. 专业分析工具 (MAT)
- 工具:Eclipse Memory Analyzer (MAT)。
- 作用:解析 .hprof 堆转储文件。
- 查看 GC Roots 和 引用链。
- 分析对象信息、类信息、线程信息。
- 快速生成内存泄漏报表,定位大对象。
- 下载:Eclipse Foundation 官网 (JDK8 推荐 MAT 1.10.0+)。
3. 生成 Heap Dump (堆转储) 的方式
方式一:命令行 (jmap)
jmap -dump:live,format=b,file=heap_dump.hprof <PID>
方式二:JVM 参数自动触发 (推荐生产环境配置)
# 发生 OOM 时自动生成 dump 文件
-XX:+HeapDumpOnOutOfMemoryError
# 指定 dump 文件保存路径 (%p=进程ID, %t=时间戳)
-XX:HeapDumpPath=/tmp/java_%p_%t.hprof
# Full GC 前生成 dump 文件 (JDK 9 已废弃,仅限旧版本)
-XX:+HeapDumpBeforeFullGC
方式三:可视化工具导出
- 使用 VisualVM 或 MAT 直接连接进程导出。
第三步:性能调优
1. 排查大对象与内存泄漏
- 使用 MAT 分析堆转储文件。
- 查找大对象(直接进入老年代,导致 Full GC 频繁)是否合理。
- 查找内存泄漏(对象不再使用但无法被 GC Roots 断开引用)。
2. 调整 JVM 参数策略
A. 核心指标调整
- 减少停顿时间:
- 参数:-XX:MaxGCPauseMillis=<n> (单位毫秒)。
- 说明:GC 收集器会尽力达到此目标,但设置过小可能导致 GC 频繁,吞吐量下降。
- 提高吞吐量:
- 公式:吞吐量 = 运行时长 / (运行时长 + GC 时长)。
- 参数:-XX:GCTimeRatio=<n>。
- 说明:例如 n=99 代表吞吐量约为 99% (1/(1+99))。一般建议不低于 95%。
B. 堆内存大小与比例
- 堆总大小:
- -Xms:初始堆大小。
- -Xmx:最大堆大小。建议 -Xms 与 -Xmx 设为相同值,避免动态扩容带来的性能开销。
- 经验值:堆大小 ≈ 老年代存活对象大小 × 3~4 倍。
- 新生代大小:
- -Xmn:设置新生代大小。官方建议占堆的 3/8。
- 内存比例:
- -XX:SurvivorRatio=8:Eden : Survivor = 8 : 1 : 1 (默认)。
- -XX:NewRatio=2:新生代 : 老年代 = 1 : 2 (默认)。
- 调优场景:若 Young GC 频繁,可适当增大新生代比例。
C. 对象晋升策略
- 晋升年龄:
- 参数:-XX:InitialTenuringThreshold=<n>。
- 说明:JDK8 默认 15 次 YGC 后晋升老年代;JDK9+ 默认 7 次。
- 调优场景:若 Full GC 频繁,可提高此值,让对象在新生代多待一会。
- 大对象阈值:
- 参数:-XX:PretenureSizeThreshold=<bytes>。
- 说明:大于此值的对象直接在老年代分配,跳过新生代。默认 0 (无限制,视 GC 策略而定)。
- 调优场景:若 Full GC 频繁且由大对象引起,可提高此阈值或优化代码减少大对象。
D. GC 触发条件
- CMS 收集器:
- 参数:-XX:CMSInitiatingOccupancyFraction=<percent>。
- 说明:默认老年代使用率达 68% 时触发。建议调低至 60% 左右,预留空间避免 "Concurrent Mode Failure" 导致的 Serial Old 卡顿。
- G1 收集器:
- 参数:-XX:G1MixedGCLiveThresholdPercent=<percent>。
- 说明:Region 中存活对象超过此比例 (默认 85%) 时,会在 Mixed GC 中被回收。
3. 选择合适的垃圾收集器
根据硬件资源和业务场景选择(最有效的方式是升级 JDK 版本以使用最新收集器):
| 单核/客户端 | 单核 | 简单/省内存 | Serial (+ Serial Old) | JDK8 默认客户端模式 |
| 后台/批处理 | 多核 | 吞吐量 | Parallel Scavenge + Parallel Old | JDK8 默认服务端模式 |
| 低延迟 (旧版) | 多核 | 停顿时间 | ParNew + CMS | JDK 8 及以前,JDK 9 已移除 CMS |
| 低延迟 (新版) | 多核 | 停顿时间 | G1 | JDK 9+ 默认,JDK 8 需手动开启 (-XX:+UseG1GC),适合大堆 (>6G) |
4. 其他优化手段
- 优化业务代码(最重要):
- 减少非必要对象创建(如循环内 new 对象)。
- 防止内存泄漏(静态集合、未关闭的资源)。
- 以时间换空间(复用对象、对象池)。
- 增加机器:横向扩展,分散节点压力。
- 调整线程池:合理设置核心线程数、最大线程数和队列长度。
- 引入中间件:使用缓存 (Redis)、消息队列 (MQ) 削峰填谷,降低 JVM 压力。
附录:常用 JVM 参数速查表
内存大小设
-XX:MetaspaceSize=128m # 元空间初始大小
-XX:MaxMetaspaceSize=256m # 元空间最大大小 (建议设置,防止无限占用本地内存)
-Xms1024m # 堆初始大小 (建议等于 -Xmx)
-Xmx1024m # 堆最大大小
-Xmn256m # 新生代大小
-Xss256k # 每个线程栈大小 (默认通常 1M,高并发时可调小)
内存比例设置
-XX:SurvivorRatio=8 # Eden : Survivor = 8 : 1 (即 Eden 占新生代 8/10)
-XX:NewRatio=2 # 新生代 : 老年代 = 1 : 2
垃圾收集器选择
-XX:+UseSerialGC # 使用 Serial (新生代) + Serial Old (老年代)
-XX:+UseParallelOldGC # 使用 Parallel Scavenge (新生代) + Parallel Old (老年代)
-XX:+UseConcMarkSweepGC # 使用 ParNew (新生代) + CMS (老年代) [JDK9+ 不支持]
-XX:+UseG1GC # 使用 G1 收集器
GC 行为控制
-XX:MaxGCPauseMillis=200 # 最大 GC 停顿时间目标 (G1/CMS 有效)
-XX:InitialTenuringThreshold=7 # 对象晋升老年代的最小年龄 (JDK8 默认 15)
-XX:PretenureSizeThreshold=1m # 大对象直接进入老年代的阈值 (0 表示不限制,视具体 GC 而定)
-XX:CMSInitiatingOccupancyFraction=60 # CMS 触发回收的老年代占比 (默认 68%)
-XX:G1MixedGCLiveThresholdPercent=65 # G1 Mixed GC 的存活率阈值 (默认 85%)
诊断与日志
-XX:+HeapDumpOnOutOfMemoryError # OOM 时自动 Dump 堆
-XX:HeapDumpPath=/path/to/dump # Dump 文件路径
-XX:+PrintGCDetails # 打印详细 GC 日志 (JDK 8)
-XX:+PrintGCTimeStamps # 打印 GC 时间戳 (JDK 8)
-XX:+PrintGCDateStamps # 打印 GC 日期戳 (JDK 8)
-Xlog:gc*:file=gc.log:time # GC 日志配置 (JDK 9+, 替代上述 Print 参数)
新版本收集器ZGC
| 引入版本 | JDK 9 (实验), JDK 10+ (默认) | JDK 11 (实验), JDK 15+ (生产就绪), JDK 21 (分代 ZGC) |
| 设计目标 | 可预测的停顿时间 ( 200ms) | 超低停顿时间 ( 1ms),几乎无感知 |
| 最大堆支持 | TB 级别 (通常建议 32GB~64GB 效果最佳) | PB 级别 (官方测试过 16TB 堆,停顿依然 1ms) |
| 停顿时间 | 毫秒级 (通常几十到几百毫秒) | 亚毫秒级 (通常 1ms,甚至 < 0.1ms) |
| 吞吐量 | 较高 (略低于 ParallelGC) | 略低于 G1 (但在 JDK 21 分代 ZGC 中已大幅提升) |
| 算法核心 | Region 分区 + 标记 – 整理 + 混合回收 | 染色指针 (Colored Pointers) + 读屏障 (Load Barriers) |
| 是否压缩 | 是 (整理过程会有停顿) | 是 (并发整理,几乎无停顿) |
| 适用场景 | 大多数通用服务端应用,堆内存 32GB | 超大堆内存 (> 32GB),对延迟极其敏感的系统 |
2. G1 收集器 (Garbage First)
地位:JDK 9+ 的默认收集器,目前生产环境使用最广泛的低延迟收集器。
- 工作原理:
- 将堆内存划分为多个大小相等的 Region (区域)。
- 不再物理分代(新生代/老年代),而是逻辑分代(Young Region, Old Region, Humongous Region)。
- 核心策略:优先回收垃圾最多的 Region(故名 Garbage First),以在有限时间内获取最大回收效率。
- 停顿来源:主要在“初始标记”、“混合回收”后的“最终标记”和“筛选回收”阶段需要短暂暂停用户线程(STW)。
- 优点:
- 可预测的停顿模型(通过 -XX:MaxGCPauseMillis 控制)。
- 不会像 CMS 那样产生内存碎片(基于整理算法)。
- 技术成熟,社区案例多。
- 缺点:
- 当堆内存非常大(如 > 64GB)时,为了维持低停顿,GC 频率会变高,可能影响吞吐量。
- 在极端大堆场景下,停顿时间偶尔会超过预期。
3. ZGC (Z Garbage Collector)
地位:JDK 未来的终极目标,专为超大内存和超低延迟设计。
- 工作原理:
- 染色指针 (Colored Pointers):利用 64 位指针中的几位颜色位来标记对象状态(如是否被移动、是否存活),而不是像传统 GC 那样维护庞大的位图。
- 读屏障 (Load Barriers):在应用程序读取对象引用时,插入一段极小的代码,检查指针颜色。如果对象被移动了,立即修正指针指向新地址。这使得 GC 的大部分工作(标记、整理)都可以与用户线程完全并发执行。
- 分层设计 (JDK 21+):
- JDK 11-17:不分代 ZGC(所有对象混在一起,小对象频繁分配会导致屏障压力大,吞吐量较低)。
- JDK 21+ (Generational ZGC):引入了分代 ZGC,区分新生代和老年代。吞吐量大幅提升,甚至超过了 G1,同时保持了 < 1ms 的停顿。
- 优点:
- 停顿时间极短:无论堆多大(4MB 到 16TB),停顿时间几乎恒定在 1ms 以内。
- 扩展性极强:轻松支持 TB 级甚至 PB 级堆内存。
- 简单配置:只需 -XX:+UseZGC,几乎没有可调参数。
- 缺点:
- CPU 消耗略高:由于大量使用读屏障和并发线程,会占用更多 CPU 资源(通常吞吐量会比 G1 低 5%-15%,但 JDK 21 分代 ZGC 已抹平此差距)。
- 版本依赖:生产环境建议使用 JDK 17 (稳定版) 或 JDK 21+ (分代版,性能最强)。JDK 11 的 ZGC 不建议用于高吞吐场景。
4. 如何选择?(决策指南)
场景 A:常规 Web 服务 / 微服务 (堆内存 < 32GB)
- 首选:G1
- 理由:技术最成熟,默认配置即可满足绝大多数需求,吞吐量与停顿时间的平衡最好。
- 参数:-XX:+UseG1GC -XX:MaxGCPauseMillis=200
场景 B:大数据处理 / 缓存服务 / 实时计算 (堆内存 > 32GB,甚至上百 GB)
- 首选:ZGC (需 JDK 17 或 21+)
- 理由:G1 在大堆下难以保证低停顿,而 ZGC 能确保即使堆有 100GB,GC 停顿也不会超过 1ms,避免系统卡顿。
- 参数:-XX:+UseZGC (JDK 21+ 自动开启分代)
场景 C:对吞吐量极度敏感,不在乎停顿 (如离线批处理)
- 首选:Parallel Scavenge + Parallel Old
- 理由:这是吞吐量优先的收集器,停顿时间可能较长,但整体运行速度最快。
- 参数:-XX:+UseParallelOldGC
场景 D:老旧系统 (JDK 8)
- 选择:CMS 或 G1 (JDK 8u40+ 支持 G1)
- 注意:JDK 8 不支持 ZGC。如果必须用 JDK 8 且需要低延迟,只能调优 CMS 或尝试 G1。
G1和ZGC原理
核心组成结构 (Composition)
表格
| 内存划分 | Region (区域) 堆被划分为多个大小相等的 Region (1MB~32MB)。 逻辑上分为:Young, Old, Humongous。 | Page (页) 堆被划分为更小的 Page (2MB 或 4MB)。 不分代 (JDK 21 前) 或 分代 (JDK 21+)。 动态组合成逻辑上的新生代/老年代。 |
| 核心数据结构 |
1. Card Table (卡表): 记录跨代引用。 2. RSet (Remembered Set): 每个 Region 维护的“谁引用了我”的集合。 3. SATB Queue: 标记期间的快照队列。 4. 三色标记算法 |
1. Colored Pointers (染色指针): 指针高位存状态 (JDK 11-17)。 2. Forwarding Table (转发表): 本地内存中的映射表,旧地址->新地址。 3. Load Barrier Stack: 读屏障逻辑。 |
| 垃圾回收策略 | 优先清理垃圾最多的 Region。 基于 RSet 快速定位存活对象,计算垃圾占比,排序后优先回收。 | 并发整理 (Concurrent Compaction)。 直接移动对象到新 Page,通过读屏障实时修正指针,无碎片。 |
2. 如何查看对象是否被引用 (Reference Tracking)
这是两者最根本的区别:G1 靠“记帐”,ZGC 靠“自查”。
G1:写屏障 + 记忆集 (RSet)
- 机制:被动记录。
- 过程:
- 当发生引用赋值(如 A.ref = B)时,写屏障触发。
- 写屏障将所在的内存页(Card)标记为“脏”。
- 后台线程扫描脏卡,将引用关系记录到 B 所在 Region 的 RSet 中。
- 结论:如果 B 的 RSet 里有记录,说明 B 被引用了。GC 时只需扫描 RSet,无需扫描全堆。
- 标记算法:SATB (Snapshot-At-The-Beginning)。
- 标记开始时打个快照。
- 期间断开的引用,通过 SATB 队列 记录下来,视为“依然存活”,防止误删。
ZGC:读屏障 + 染色指针
- 机制:主动检查。
- 过程:
- 不维护复杂的 RSet 或卡表。
- 对象的“存活状态”和“移动状态”直接存在指针的高位(染色位)。
- GC 线程并发标记时,只需修改指针的染色位(Marked bits)。
- 结论:不需要预先知道谁引用了谁。只要线程访问对象,读屏障就会检查指针颜色。如果颜色不对(未标记或已移动),立即修正或标记。
- 标记算法:并发标记 + 读屏障修正。
- 不需要 SATB。读屏障在运行时实时保证视图一致性。
3. 读写屏障详解 (Barriers)
| 主要屏障类型 | 写屏障 (Store Barrier) | 读屏障 (Load Barrier) |
| 触发时机 | 写引用时 (obj.field = value) 每次对象引用关系发生变化时触发。 | 读引用时 (value = obj.field) 每次访问对象字段时触发。 |
| 核心任务 | 1. 更新 Card Table (标记脏卡)。 2. 记录 SATB 队列 (保存旧引用,用于并发标记一致性)。 | 1. 检查 染色位 (是否被移动/标记)。 2. 查询 转发表 (如果已移动,获取新地址)。 3. 自我修复 (更新当前指针为新地址)。 |
| 性能影响 | 写操作变慢。 因为写操作相对读操作较少,整体吞吐量影响较小。 | 读操作变慢 (理论上)。 但现代 CPU 优化极好,且大多情况只需位运算,实际延迟极低 (<1ms)。 |
| STW 来源 | 最终标记 (Final Mark): 需要 STW 来处理剩余的 SATB 队列和 RSet 更新。 | 几乎无 STW: 所有工作(标记、整理、指针修正)都并发完成。仅在根扫描等极短瞬间停顿。 |
-
G1 像一个精明的会计:
- 组成:把仓库分成小区(Region)。
- 追踪:每次货物移动(写引用)都记账(写屏障+RSet+SATB)。
- 清理:定期算账,优先扔掉垃圾最多的小区(Mixed GC)。
- 代价:记账要花时间,最后算总账时要大家停下手(STW)。
-
ZGC 像一个会魔法的搬运工:
- 组成:把仓库分成小页(Page),货物贴魔法标签(染色指针)。
- 追踪:不记账。你每次拿货物(读引用)时,魔法标签会自动告诉你货物有没有被搬走(读屏障)。
- 清理:边干活边搬运,你拿货物时如果发现地址变了,瞬间自动修正(自我修复)。
- 代价:每次拿货物都要看一眼标签(读屏障开销),但大家完全不用停手(无 STW)。
选型建议:
- 堆 < 32GB,追求吞吐与延迟平衡 -> G1 (默认首选)。
- 堆 > 32GB,或对延迟极度敏感 (<1ms) -> ZGC (JDK 17/21+)。
7、项目中有没有实际的JVM调优经验?
7.1 CPU 飙升排查指南
1. 常见原因
- 高并发计算:大量线程同时执行复杂计算任务。
- 死循环/逻辑 bug:代码陷入 while(true) 或无效递归。
- 锁竞争激烈:
- 自旋锁:CAS 操作失败后不断自旋重试,空转消耗 CPU。
- 死锁:线程互相等待资源(通常伴随 CPU 等待,但也可能表现为高负载)。
- 外部攻击/异常流量:Redis/数据库被攻击、网站遭受 DDoS/CC 攻击。
- 频繁 I/O:虽然 I/O 本身阻塞,但频繁的上下文切换、序列化/反序列化、网络包处理会消耗大量 CPU。
- 频繁 GC:垃圾回收线程占用大量 CPU 资源(需结合 GC 日志判断)。
2. 定位步骤 (标准四步法)
第一步:定位进程 ID (PID)
使用 top 命令查看系统整体负载,找到 CPU 使用率最高的 Java 进程。
bash
编辑
top
# 记录 PID (例如: 12345)
第二步:定位线程 ID (TID)
查看该进程下所有线程的 CPU 使用情况,找到最耗 CPU 的线程。
bash
编辑
top -Hp 12345
# 记录消耗 CPU 最高的线程 ID (例如: 12346)
第三步:线程 ID 转十六进制
jstack 输出的线程快照中,线程 ID 是以十六进制显示的 (nid),需要转换。
bash
编辑
printf "%x\\n" 12346
# 输出: 303a (假设结果)
第四步:定位代码堆栈
使用 jstack 打印进程快照,并过滤出该十六进制线程 ID 的堆栈信息。
bash
编辑
jstack 12345 | grep -A 20 "0x303a"
# 或者
jstack 12345 > thread_dump.txt
# 在文件中搜索 "nid=0x303a"
- 分析:查看该线程正在执行的方法行号。
- 如果是业务代码:检查是否有死循环、复杂计算。
- 如果是 VM Thread 或 GC Task Thread:说明是 GC 导致,需转去 GC 调优。
- 如果是 Locked 状态:检查是否有死锁(jstack 通常会直接提示 "Found one Java-level deadlock")。
3. 解决方案
- 代码优化:修复死循环、优化算法复杂度、减少不必要的对象创建。
- 锁优化:减少锁粒度,避免长时间持有锁,将自旋锁改为阻塞锁(如果自旋时间过长)。
- 资源扩容:增加服务器节点(横向扩展)或升级 CPU 核数。
- 限流降级:针对恶意攻击或突发流量,实施限流策略。
7.2 GC 调优实战案例
1. 调优目标与基准
- 理想指标:
- Young GC (YGC):频率 < 10 秒/次,耗时 < 500ms。
- Full GC (FGC):频率 < 1 次/天 (生产环境优秀标准),耗时 < 1s。
- 注意:如果一小时一次 FGC,已属于频繁,需立即干预。
2. 问题场景描述
- 现象:业务高峰时段(上午 8 点),用户反馈明显卡顿。
- 监控数据:
- TP99:显著升高,出现周期性毛刺。
- 内存曲线:呈现剧烈的“锯齿状”周期性波动。
- 初步诊断:怀疑 GC 频繁导致 STW (Stop-The-World)。
3. 命令行分析与确认
使用 jstat 实时观察 GC 统计信息:
bash
编辑
jstat -gcutil <pid> 1000
- 正常基线:YGC 每 10 分钟一次,FGC 每 10 小时一次。
- 异常现状:
- YGC:频率激增至 1 分钟一次 (原 10min)。
- FGC:频率激增至 3 小时一次 (原 10h)。
- 结论:Young GC 过于频繁,导致大量对象过早进入老年代(或老年代本身增长过快),进而触发频繁的 Full GC,造成系统卡顿。
4. 解决方案 (基于 Parallel GC / CMS 环境)
A. 排查代码与内存泄漏
- 使用 MAT 分析 Heap Dump,排查是否存在内存泄漏或未关闭的资源。
- 检查是否有大对象(Big Object)直接分配进老年代。
B. 调整 JVM 参数策略
表格
| 扩大堆内存 | 增加物理内存并调整堆大小 | -Xms8g -Xmx8g | 避免堆动态扩容开销,提供更大缓冲空间。建议 -Xms = -Xmx。 |
| 调整新生代比例 | 增大新生代占比 | -XX:NewRatio=2 | 默认 1:2 (新:老)。若 YGC 频繁,可尝试增大新生代(如设为 1 或 2),让对象在新生代多存活一会。 |
| 调整晋升年龄 | 降低晋升年龄 (加速流转) | -XX:InitialTenuringThreshold=7 | JDK8 默认 15。若老年代空闲且 YGC 频繁,可降低年龄(如改为 7),让对象尽快进入老年代,减少 YGC 扫描压力,利用 Mixed GC 清理。(注:此策略视具体情况,有时需提高年龄) |
| 大对象直入老年代 | 设置大对象阈值 | -XX:PretenureSizeThreshold=1048576 | 默认 0。设置大于 1MB 的对象直接进入老年代,避免在新生代复制大对象消耗时间。 |
| 升级垃圾收集器 | 切换到 G1 (推荐) | -XX:+UseG1GC | JDK8 默认是 Parallel GC (吞吐量优先)。切换为 G1 (低延迟优先),更好地控制停顿时间。 |
(注:关于“降低升老年龄”的策略需辩证看待。如果是因为新生代太小导致对象没来得及死就老了,应增大新生代或提高年龄;如果是因为新生代扫描太慢,才考虑让对象快点老去以便由并发 GC 处理。上述案例中主要是为了配合 G1 的混合回收机制。)
C. G1 收集器专项调优
若已升级 G1,可进一步微调:
- 降低混合回收阈值:让 Region 更早参与回收。bash
编辑
-XX:G1MixedGCLiveThresholdPercent=85 # 默认值,若回收不及时可适当调低
- 调整 IHOP:提前启动并发标记。bash
编辑
-XX:InitiatingHeapOccupancyPercent=35 # 默认 45%,调小可让标记更早开始
5. 调优效果验证
- 压测结果:
- TP99:较调优前降低 60%,毛刺消失。
- Full GC:耗时降低 80%,频率恢复至天级别。
- Young GC:次数减少 30%,单次耗时稳定。
- 结论:系统稳定性显著提升,符合预期。
7.3 如果使用 ZGC 该如何调优?
如果你的环境是 JDK 11/15/17/21+,强烈建议直接使用 ZGC。ZGC 的设计初衷就是解决“大堆”和“低延迟”问题,其调优逻辑与传统 GC 截然不同。
1. 核心优势
- 无需关注分代比例:ZGC (JDK 11-17) 不分代,无需设置 -XX:NewRatio, -XX:SurvivorRatio。
- 几乎无 STW:无论堆多大,停顿时间始终控制在 1ms 以内。
- 自动适应:ZGC 具有极强的自适应能力,大多数情况下无需手动调优。
2. ZGC 调优策略
A. 基础启用 (JDK 11+)
只需添加一个参数即可开启,无需复杂的组合配置。
bash
编辑
-XX:+UseZGC
(JDK 15+ 生产可用,JDK 21+ 默认包含分代 ZGC,性能更强)
B. 关键参数调整 (仅在极端场景下需要)
表格
| 最大堆内存 | 动态 | -Xmx (建议设大) | ZGC 适合大堆。直接给足内存 (如 32G, 64G, 甚至 TB 级),ZGC 能高效管理,无需像 G1 那样精打细算。 |
| 软页大小 (Soft Page Size) | 自动 | -XX:ZPageSize=2m/4m | 仅在超大内存 (>1TB) 或特定硬件架构下需要调整,一般保持默认。 |
| 最大暂停时间目标 | 无显式参数 | (ZGC 自动保证 <1ms) | ZGC 不像 G1 有 -XX:MaxGCPauseMillis,它硬编码了亚毫秒级目标。 |
| 返回未使用内存 | 关闭 | -XX:ZUncommitDelay=300 | 设置 ZGC 在多少秒后将未使用的堆内存返还给操作系统。默认 300s,容器化环境可调小。 |
| 分代模式 (JDK 21+) | 自动开启 | -XX:-ZGenerational | JDK 21 默认开启分代 ZGC (性能更好)。若遇兼容性问题可关闭,但不建议。 |
C. ZGC 场景下的排查思路变化
如果在 ZGC 环境下依然出现性能问题(通常是吞吐量下降而非卡顿):
- ZGC 通过读屏障和并发线程工作,会消耗更多的 CPU 资源来换取低延迟。
- 对策:如果 CPU 打满,考虑增加 CPU 核数,而不是调整 GC 参数。
- 如果应用分配对象的速度极快(超过 ZGC 并发整理的速度),可能会触发保护机制导致停顿。
- 对策:优化代码,减少临时对象创建(这是通用建议)。
编辑
-Xlog:gc*:file=zgc.log:time,uptime,level,tags
- 关注 Pause Mark Start, Pause Mark End, Pause Relocation Start 等阶段的耗时,确认是否真的超过了 1ms(极少见)。
- 关注 GC Rate,如果 GC 频率过高,说明内存给小了或对象创建太快。
3. ZGC 调优总结
- 首选动作:升级 JDK 到 21 (享受分代 ZGC 的高吞吐量 + 低延迟)。
- 主要手段:给足内存 (-Xmx)。ZGC 在大内存下表现远优于小内存。
- 放弃动作:不再需要调整 -XX:NewRatio, -XX:TenuringThreshold, -XX:PretenureSizeThreshold 等分代参数。
- 核心逻辑:用 CPU 资源 换 时间 (延迟)。如果 CPU 充足,ZGC 几乎是“免调优”的最佳选择。
8、安全点
1. 核心定义
- 是什么:安全点不是内存中的一个地址,而是代码执行流中的特定位置(机器指令)。
- 作用:它是 JVM 线程唯一允许被暂停的地方。确保线程暂停时,其栈帧完整、对象引用状态稳定,没有正在进行的“半截子”写操作。
- 本质:它是并发 GC 的“检查站” (Checkpoint),用于冻结世界,保证 GC 扫描时数据的一致性。
2. 触发机制:如何到达安全点?
JVM 不会强行掐断线程,而是通过“自愿配合”的方式:
表格
| 轮询检测 (Polling) | JIT 编译器在特定指令后插入检查指令。线程执行到这里,检查全局标志位 SafepointFlag。若为 true,则暂停。 | 大多数正常运行的线程。 |
| 安全区域 (Safe Region) | 针对长时间不经过轮询点的线程(如 sleep 或死循环)。线程进入该区域时声明“我不改引用”,若此时 GC 请求,立即暂停。 | 休眠线程、长循环线程。 |
3. 常见的安全点位置
JVM 只在关键路径插入检查,以平衡性能:
4. 关键搭档:OopMap (Ordinary Object Pointer Map)
- 问题:线程停在安全点后,GC 怎么知道栈里哪些数字是对象引用?
- 解决:在每个安全点,JVM 都维护一张 OopMap。
- 记录了:此刻栈帧中哪个偏移量存放的是有效的对象引用。
- 作用:GC 无需遍历整个栈去猜,直接查表即可精准找到所有 GC Roots,极大缩短 STW 时间。
5. 时间窗口与写屏障的配合
- 时间差风险:从“GC 发出暂停信号”到“所有线程真正停在安全点”,中间有短暂的时间差。期间线程可能修改引用。
- 解决方案:写屏障 (Write Barrier)。
- 在时间差内发生的引用修改(如 obj = null),会被写屏障记录下来(如放入 SATB 队列)。
- GC 在 STW 开始后,先处理这些记录,确保逻辑快照的一致性。
第二部分:不同收集器的“对象销毁/标记”策略总结
所有收集器的目标一致:准确识别垃圾,绝不误删活对象。但实现手段因“是否并发”而异。
1. 并行收集器 (Parallel GC / Serial GC)
- 模式:独占式 (Stop-The-World)。
- 核心逻辑:
- 不并发:GC 工作时,所有应用线程必须全部暂停在安全点。
- 全量扫描:GC 独享 CPU,利用 OopMap 扫描所有线程栈和堆。
- 如何处理“中途修改”:
- 不需要处理。因为线程都停了,世界是静止的,数据天然一致。
- 如果 obj = null 后线程停了,GC 看到 null 且无其他引用,直接回收。
- 优点:实现简单,吞吐量高。
- 缺点:停顿时间长,堆越大停顿越久。
- 是否需要屏障/SATB:不需要。
2. CMS 收集器 (Concurrent Mark Sweep)
- 模式:并发标记 + 增量更新。
- 核心逻辑:
- 并发标记:应用线程和 GC 线程一起跑。
- 增量更新 (Incremental Update):
- 写屏障:记录新增的引用(谁引用了新对象)。
- 脏卡表:标记哪些内存页变了。
- 重新标记 (Remark, STW):
- 这是 CMS 的关键。在最终 STW 阶段,GC 拿着脏卡表,把并发期间变过的地方重新扫描一遍。
- 如果有新引用加入,补上标记;如果引用断了(obj=null),只要初始标记时它是活的,且没被证明彻底不可达,就保留(浮动垃圾)。
- 如何处理“中途修改”:靠 Remark 阶段的二次扫描 来修正并发期间的变化。
- 优点:低延迟(大部分工作并发做)。
- 缺点:Remark 阶段 STW 时间受并发修改频率影响大;产生浮动垃圾;内存碎片。
- 是否需要 SATB:不需要(用的是增量更新)。
3. G1 收集器 (Garbage First)
- 模式:并发标记 + SATB。
- 核心逻辑:
- 并发标记:应用线程和 GC 线程一起跑。
- SATB (Snapshot-At-The-Beginning):
- 写屏障:记录断开的旧引用(obj=null 前的旧值)。
- 哲学:“只要标记开始时你是活的,整个周期你都是活的。”
- 最终标记 (Final Mark, STW):
- 处理 SATB 队列。把队列里的旧引用当作根,重新标记为存活。
- 不需要像 CMS 那样重新扫描大量脏卡,只需处理队列。
- 如何处理“中途修改”:靠 SATB 队列 强行保住那些“中途断开引用”的对象(视为浮动垃圾)。
- 优点:停顿时间可控(可预测);无内存碎片(整理算法);适合大堆。
- 缺点:SATB 队列占用额外内存;有一定吞吐量损耗。
- 是否需要 SATB:必须需要。
4. ZGC / Shenandoah
- 模式:完全并发 + 读屏障。
- 核心逻辑:
- 并发标记 & 并发整理:几乎所有工作都并发完成。
- 读屏障 (Load Barrier) + 染色指针:
- 不记录日志(无 SATB/卡表)。
- 当应用线程读取引用时,检查指针颜色。如果对象被移动了,立即修正指针并协助标记。
- 如何处理“中途修改”:
- 实时修正。不需要事后扫描或处理队列。
- 对象移动后,旧指针带“毒”(染色位),读到即解毒(修正)。
- 优点:超低停顿(<1ms);堆大小几乎无限制。
- 缺点:读操作有微小开销;实现极其复杂;消耗更多 CPU。
- 是否需要 SATB:不需要(用读屏障替代)。
横向对比总结表
| 是否并发标记 | ❌ 否 (全停) | ✅ 是 | ✅ 是 | ✅ 是 |
| 一致性保障机制 | 全局暂停 (STW) | 增量更新 + Remark 重扫 | SATB (快照) + 最终标记 | 读屏障 + 实时修正 |
| 对 obj=null 的处理 | 暂停后直接看结果,无引用即收 | 记录变化,Remark 阶段确认,通常保留为浮动垃圾 | 写屏障记旧值,最终标记强制保活 (浮动垃圾) | 读屏障实时发现,指针自修复 |
| STW 主要耗时点 | 整个标记 + 整理过程 | Remark (重新标记) 阶段 | Final Mark (处理 SATB) 阶段 | 极短 (仅根扫描/重映射同步) |
| 浮动垃圾 | 无 (扫得干净) | 较多 | 较多 (SATB 策略导致) | 极少 |
| 适用场景 | 后台批处理,追求吞吐 | 老版本低延迟需求 (已废弃) | 通用服务端,大堆低延迟 | 超大堆,极致低延迟 |
核心结论
- 安全点是所有收集器(除了纯并发的 ZGC 部分阶段)进行 STW 操作的前提,确保线程停在“安全”的状态。
- 对象销毁的准确性:
- Parallel GC 靠“停”来解决(简单粗暴)。
- CMS/G1 靠“记”来解决(记录变化,事后补救)。
- ZGC 靠“修”来解决(实时修正,无需补救)。
对象销毁时机
public void test() {
Object A = new Object(); // 1. A 是局部变量 (GC Root),对象 O1 存活
Object B = A; // 2. B 也指向 O1。现在有两个 Root 指向 O1
A = null; // 3. 代码逻辑:A 断了。
// 此时:O1 还能通过 B 到达吗?能!
// JVM 判定:O1 **不是** 垃圾。
B = null; // 4. 代码逻辑:B 也断了。
// 此时:O1 还能通过任何 Root 到达吗?不能了!
// JVM 判定:O1 **是** 垃圾。
} // 5. 方法结束,栈帧销毁,所有局部变量消失。
// 即使你没写 null,O1 也自动变成垃圾。
9、请你说说内存溢出
1. 定义
内存溢出:申请的内存大于系统能提供的内存。
2. 溢出原因及场景
(1) 本地直接内存溢出 (Direct Memory OOM)
- 原因:本地直接内存设的太小导致溢出。
- 配置:设置直接内存最大值 -XX:MaxDirectMemorySize。若不指定,则默认与 Java 堆最大值 (-Xmx) 一致。
(2) 虚拟机栈和本地方法栈溢出 (StackOverflowError / OOM)
- 原因:如果虚拟机的栈内存允许动态扩展,并且方法递归层数太深时,导致扩展栈容量时无法申请到足够内存。
(3) 方法区溢出 (Metaspace/PermGen OOM)
- 原因:运行时生成大量动态类时会内存溢出。
- 典型场景:
- CGlib 动态代理:
- 原理:CGlib 在内存中构建子类对象实现对目标对象功能扩展,产生大量类填满了整个方法区(存储常量池、类信息、方法信息)。
- 触发条件:若设置 enhancer.setUseCache(false) 关闭用户缓存,每次创建代理对象都是一个新的实例。创建过多会导致方法区溢出。
- 对比:JDK 动态代理不会导致方法区溢出。
- JSP:大量 JSP 或动态产生 JSP 文件的应用(JSP 第一次运行时需要编译为 Java 类)。
- CGlib 动态代理:
(4) 堆溢出 (Java Heap Space OOM)
- 死循环创建对象:代码逻辑错误导致无限创建对象。
- 内存泄漏:集合类中有对对象的引用,使用完后未清空,使得 JVM 不能回收。
- 数据量过大:
- 一次从数据库取出的数据集太大。
- 第三方接口传输的大对象。
- 接收的 MQ 消息太大。
- Tomcat 参数设置不当:
- Tomcat 会给每个线程创建两个默认 4M 大小的缓冲区。
- 高并发情况下会导致缓冲区创建过多,导致 OOM。
(5) 不会溢出的区域
- 程序计数器:不会抛出 OutOfMemoryError。
3. 使用 JDK 命令行工具判断 OOM 风险
步骤一:查看进程
使用 jps 命令查看当前 Java 进程 ID。
步骤二:统计 GC 情况
使用 jstat 命令多次统计 GC 信息,比较 GC 时长占运行时长的比例。
- 命令示例:jstat -gcutil <pid> <interval> <count>
步骤三:判定标准
- GC 比例 > 20%:代表堆压力已经很大。
- GC 比例 > 98%:说明这段时期内几乎一直在 GC,堆里几乎没有可用空间,随时都可能抛出 OOM 异常。
4. 定位工具:MAT (Memory Analyzer Tool)
- 作用:解析 Heap Dump(堆转储)文件,定位内存泄漏和大对象。
- 核心功能:
- 查看 GC Roots。
- 分析引用链。
- 查看对象信息、类信息、线程信息。
- 快速生成内存泄漏报表。
MAT定位导致OOM:示例代码:写死循环创建对象,不断添加到list里,导致堆内存溢出;
1.导出dump文件
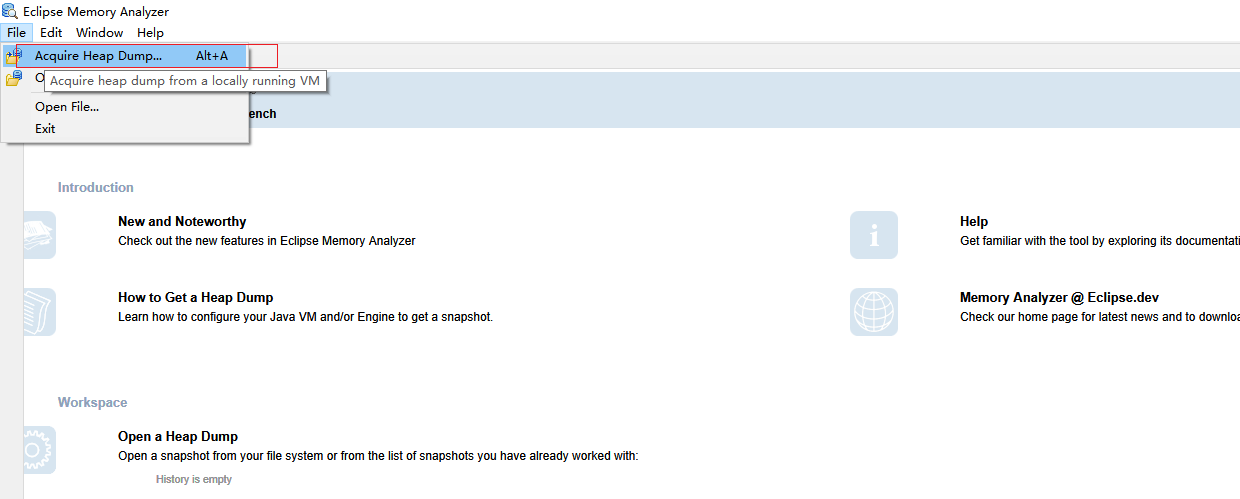
# 1.查看进程号
jps
# 2.根据进程号导出
jmap -dump:format=b,file=D:\\heapdump.hprof <pid>
2.MAT解析dump文件
3.定位大对象:点击直方图图标(Histogram),对象会按内存大小排序,查看内存占用最大的对象;右键 “List Objects” -> “with outgoing references”,找到特定实例,选择 “Path to GC Roots” -> “Exclude all phantom/weak/soft etc. references”。这将显示从垃圾收集根(GC Roots)到该对象的引用路径。找到路径上的类,分析源代码 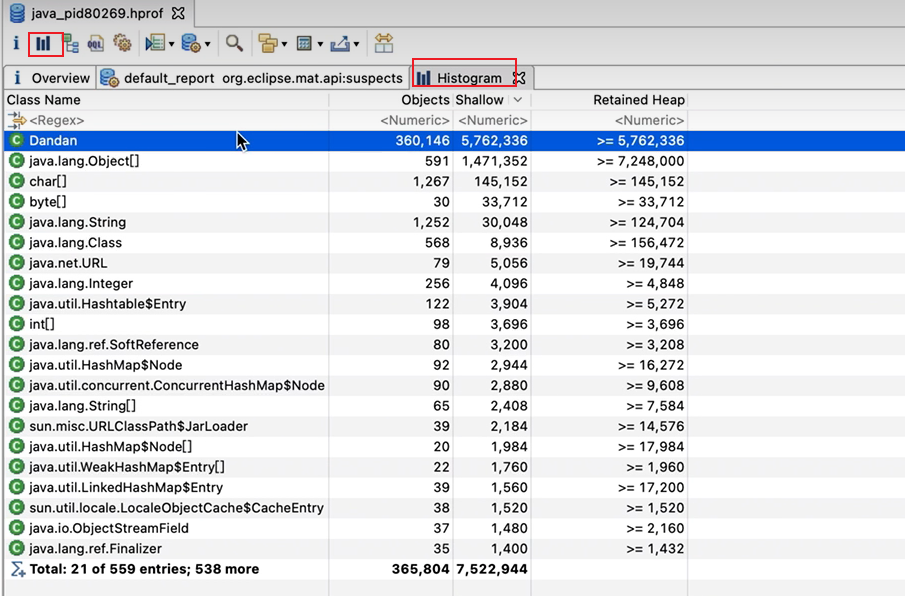
4.这个对象被谁引用:点击支配树(dominator tree),看大对象被哪个线程调用。这里可以看到是被主线程调用。
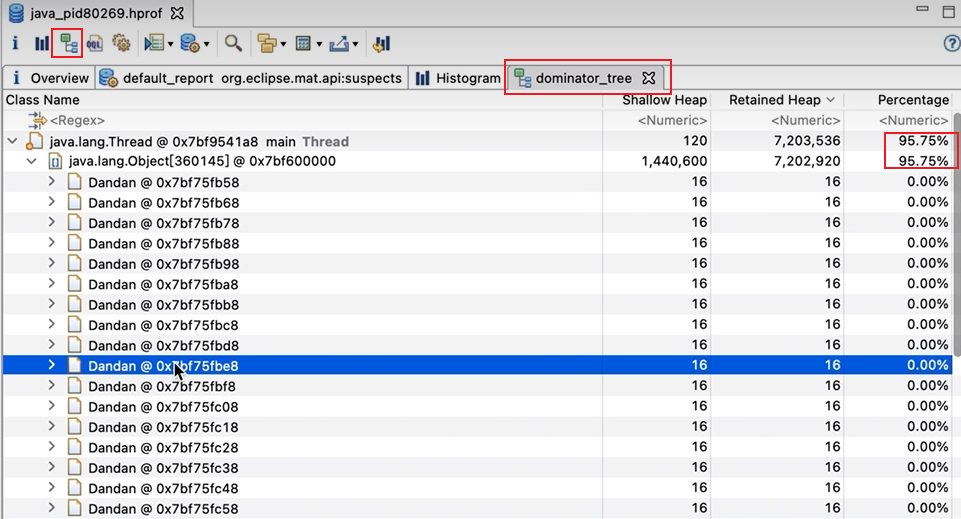
5.定位具体代码:点击概述图标(thread_overview),看线程的方法调用链和堆栈信息,查看大对象所属类和第几行,定位到具体代码,解决问题
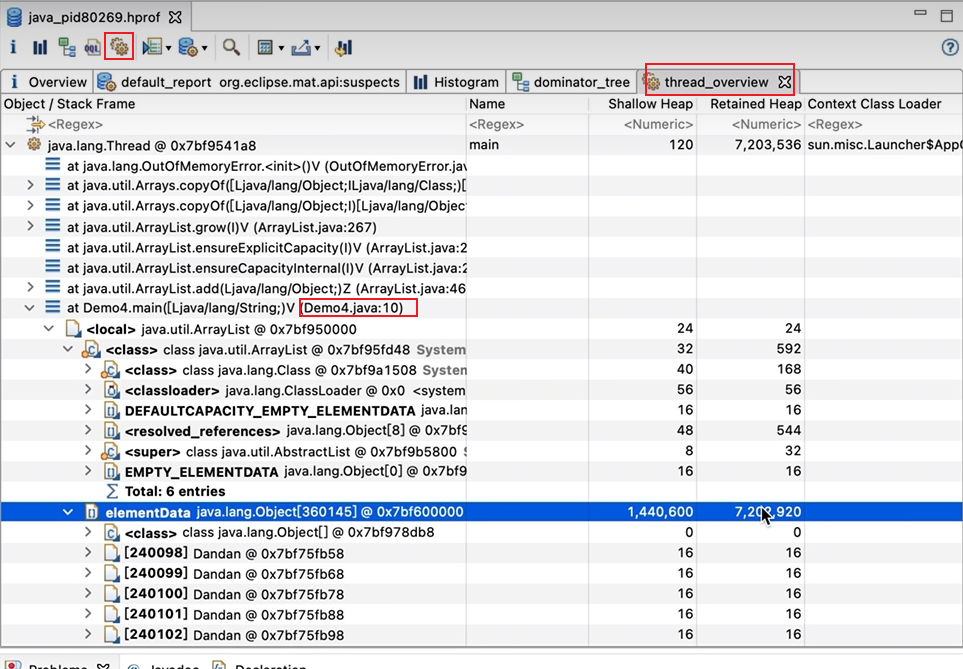
解决方案:
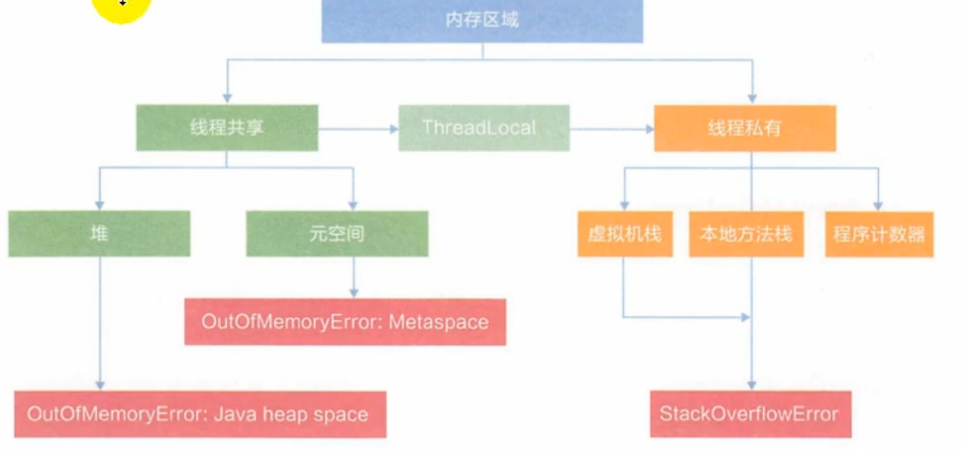
内存溢出,简单地说内存溢出就是指程序运行过程中申请的内存大于系统能够提供的内存,导致无法申请到足够的内存,于是就发生了内存溢出。
引起内存溢出的原因有很多种,常见的有以下几种:
1. 内存中加载的数据量过于庞大,如一次从数据库取出过多数据;
2. 集合类中有对对象的引用,使用完后未清空,使得JVM不能回收;
3. 代码中存在死循环或循环产生过多重复的对象实体;
4. 使用的第三方软件中的BUG;
5. 启动参数内存值设定的过小。
加分回答
除了程序计数器外,虚拟机内存的其他几个运行时区域都有发生OOM异常的可能。
1. Java堆溢出
Java堆用于储存对象实例,我们只要不断地创建对象,并且保证GC Roots到对象之间有可达路径来避免垃圾回收机制清除这些对象,那么随着对象数量的增加,总容量触及最大堆的容量限制后就会产生内存溢出异常。
2. 虚拟机栈和本地方法栈溢出
HotSpot虚拟机中并不区分虚拟机栈和本地方法栈,如果虚拟机的栈内存允许动态扩展,当扩展栈容量无法申请到足够的内存时,将抛出OutOfMemoryError异常。
3. 方法区和运行时常量池溢出
方法区溢出也是一种常见的内存溢出异常,在经常运行时生成大量动态类的应用场景里,就应该特别关注这些类的回收状况。这类场景常见的包括:程序使用了CGLib字节码增强和动态语言、大量JSP或动态产生JSP文件的应用、基于OSGi的应用等。 在JDK 6或更早之前的HotSpot虚拟机中,常量池都是分配在永久代中,即常量池是方法区的一部分,所以上述问题在常量池中也同样会出现。而HotSpot从JDK 7开始逐步“去永久代”的计划,并在JDK 8中完全使用元空间来代替永久代,所以上述问题在JDK 8中会得到避免。
4. 本地直接内存溢出
直接内存的容量大小可通过`-XX:MaxDirectMemorySize`参数来指定,如果不去指定,则默认与Java堆最大值一致。如果直接通过反射获取Unsafe实例进行内存分配,并超出了上述的限制时,将会引发OOM异常。
10、请你说说内存泄漏
得分点
内存泄漏、内存泄露的9种情况、性能分析工具判断是否有内存泄漏、解决办法
内存泄漏: 不再使用的对象仍然被引用,导致GC无法回收;
内存泄露的9种情况:
- 静态容器里的对象:静态集合类的生命周期与 JVM 程序一致,容器里的对象引用也将一直被引用得不到GC;Java里不准静态方法引用非静态方法也是防止内存泄漏。
- 单例对象引用的外部对象:单例模式里,如果单例对象如果持有外部对象的引用,因为单例对象不会被回收,那么这个外部对象也不会被回收
- 外部类跟随内部类被引用:内部类持有外部类,这个内部类对象被长期引用了,即使那个外部类实例对象不再被使用,但由于内部类持有外部类的实例对象,这个外部类对象将不会被垃圾回收,这也会造成内存泄漏。
- 数据库、网络、IO等连接忘记关闭:在对数据库进行操作的过程中,首先需要建立与数据库的连接,当不再使用时,需要调用 close 方法来释放与数据库的连接。如果对 Connection、Statement 或 ResultSet 不显性地关闭,将会造成大量的对象无法被回收,从而引起内存泄漏。
- 变量作用域不合理:例如一个变量只会在某个方法中使用,却声明为成员变量,并且被使用后没有被赋值为null,将会导致这个变量明明已经没用了,生命周期却还跟对象一致。
- HashSet中对象改变哈希值:当一个对象被存储进 HashSet 集合中以后,就不能修改这个对象中的那些参与计算哈希值的字段了。否则对象哈希值改变,找不到对应的value。
- 缓存引用忘删除:一旦你把对象引用放入到缓存中,他就很容易遗忘,缓存忘了删除,将导致引用一直存在。
- 逻辑删除而不是真实删除:监听器和其他回调:如果客户端在你实现的 API 中注册回调,却没有显示的取消,那么就会积聚。需要确保回调立即被当作垃圾回收的最佳方法是只保存它的弱引用,例如将他们保存成为 软WeakHashMap 中的键。例如出栈只是移动了指针,而没有将出栈的位置赋值null,导致已出栈的位置还存在引用。
- 线程池时,ThreadLocal忘记remove():使用线程池的时候,ThreadLocal 需要在使用完线程中的线程变量手动 remove(),否则会内存泄漏。因为线程执行完后没有销毁而是被线程池回收,导致ThreadLocal中的对象不能被自动垃圾回收。
性能分析工具判断是否有内存泄漏:
1. 性能分析工具判断内存泄漏
(1) JDK 自带命令行工具 (jstat)
- 操作方法:每隔一段较长的时间,通过 jstat 命令采样多组 OU(老年代内存量) 的最小值。
- 判定标准:如果这些最小值呈现持续上涨趋势,说明无法回收的对象在不断增加,极可能是内存泄漏导致。
(2) MAT (Memory Analyzer Tool) 监视诊断
- 生成堆转储文件:MAT 可直接从 Java 进程导出 dump 文件,或通过 jmap 生成后导入。
- 分析步骤:
- 查看泄漏怀疑:打开报告,查看 Leak Suspects(泄漏怀疑)部分,找到内存泄漏的可疑点。
- 查看可疑线程:点击可疑点的 Details(详情),定位到具体的可疑线程。
- 定位代码:查看 See stacktrace(线程调用栈),找到问题代码的具体位置(行号)。
(3) 其他辅助手段
- GC 详细日志:
- 启动参数开启:-XX:+PrintGCDetails。
- 设置日志地址:-Xloggc:/path/to/gc.log。
- 作用:观察 GC 频率和回收效果,辅助判断。
- 编译器警告:查看 Eclipse 等 IDE 的内存泄漏警告信息。
- Java 基准测试工具:分析代码性能,对比不同实现的内存消耗。
2. 内存泄漏定义与危害
- 定义:内存泄漏是指不再使用的对象仍然被引用,导致垃圾收集器(GC)无法回收它们的内存。
- 后果:由于不再使用的对象无法清理,这种情况可能会越积越多,最终耗尽堆内存,导致致命的 OutOfMemoryError。
- 通俗理解:内存泄漏视为一种“疾病”,它通过阻塞重要的内存资源降低应用性能。若不治愈,随时间推移会导致应用崩溃。
3. 解决思路与最佳实践
(1) 核心编码规范
- 及时断开引用:当一个对象不会被使用时,给它的所有引用赋值 null。
- 警惕静态容器:提防 static 集合类(如 static Map/List)长期持有对象引用。
- 资源管理:记得关闭数据库连接、IO 流、网络连接等资源。
- 避免逻辑删除陷阱:仅在集合中标记删除而未真正移除对象,可能导致泄漏。
- 合理控制作用域:只要用到了引用,变量的作用域要合理,尽量缩短生命周期。
(2) 使用弱引用
- 方法:使用 java.lang.ref 包中的 WeakReference。
- 原理:弱引用对象在下一次垃圾收集器工作时即可被回收,适用于缓存等场景。
(3) 系统化分析流程
- 配置:添加 JVM 参数 -verbose:gc (或 -XX:+PrintGCDetails)。
- 目的:跟踪 GC 详细进度,观察内存回收细节。
4. 总结
- 没有一刀切的解决方案:内存泄漏可能通过各种不同事件发生,必须具体问题具体分析。
- 核心要求:解决内存泄漏需要对 Java 语言有深刻理解并掌握复杂的命令工具。
- 预防策略:采用最佳实践、定期执行严格的代码演练和分析,可将内存泄漏风险降到最低。
11、JVM中一次完整的GC流程是怎样的
堆分为哪几个区、GC流程、注意大对象和年龄15(JDK8)
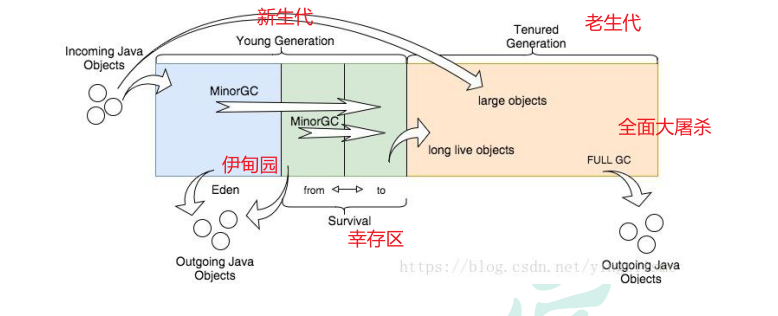
1、首先,任何新对象都分配到 eden 空间。两个幸存者空间开始时都是空的。 2、当 eden 空间填满时,将触发一个Minor GC(年轻代的垃圾回收,也称为Young GC),删除所有未引用的对象,大对象(需要大量连续内存空间的Java对象,如那种很长的字符串)直接进入老年代。 3、所有被引用的对象作为存活对象,将移动到第一个幸存者空间S0,并标记年龄为1,即经历过一次Minor GC。之后每经过一次Minor GC,年龄+1。GC分代年龄存储在对象头的Mark Word里。 4、当 eden 空间再次被填满时,会执行第二次Minor GC,将Eden和S0区中所有垃圾对象清除,并将存活对象复制到S1并年龄加1,此时S0变为空。 5、如此反复在S0和S1之间切换几次之后,还存活的年龄等于15的对象(JDK8默认15,JDK9默认7,-XX:InitialTenuringThreshold=7)在下一次Minor GC时将放到老年代中。 6、如果老年代内存不足够存储新对象,则会执行Full GC(清空整个新生代和老年代)。 7、当老年代满了时会触发Full GC或者Major GC(老年代的垃圾回收,清理整个老年代空间)。具体是Full GC还是Major GC取决于用哪个垃圾回收器,传统垃圾回收器会Full GC,G1(优先使用Mixed GC,清空部分新生代和老年代)、ZGC(直接抛出内存溢出错误)等现代回收器会避免Full GC。
12、如何避免Full GC?
在触发以下条件时,JVM会执行Full GC, 将整个堆(包括整个新生代和老年代)内存清空。
触发条件:
1、调用System.gc():调用 System.gc() (用于请求 JVM 执行垃圾回收)时,JVM 会建议执行 Full GC(具体是否执行取决于垃圾回收器实现的System.gc()逻辑,例如Parallel GC、CMS等传统垃圾回收器该方法会Full GC,而G1、ZGC等现代回收器不会Full GC)。 2、空间分配担保失败:当对象从新生代晋升到老年代前,要检查老年代是否有足够空间容纳新对象,这叫做空间分配担保。如果空间不足,则空间分配担保失败,JVM会执行Full GC。 3、老年代满了:当老年代满了时会触发Full GC或者Major GC(老年代的垃圾回收,清理整个老年代空间)。具体是Full GC还是Major GC取决于用哪个垃圾回收器,传统垃圾回收器会Full GC,G1(优先使用Mixed GC,清空部分新生代和老年代)、ZGC(直接抛出内存溢出错误)等现代回收器会避免Full GC。 4、方法区满了:当方法区(Method Area)空间不足时,会触发Full GC。
避免Full GC:
Full GC 的执行时间最长,也是JVM调优的重点
- 调大老年代比例
- 增加整个堆内存
- 使用G1、ZGC等现代回收器
13、说说JVM的垃圾回收机制
得分点
新生代收集、老年代收集、混合收集、整堆收集
依据分代假说理论,垃圾回收可以分为: 新生代收集、老年代收集、混合收集、整堆收集
当前商业虚拟机的垃圾收集器,大多数都遵循了“分代收集”的理论进行设计,分代收集名为理论,实质是一套符合大多数程序运行实际情况的经验法则。而分代收集理论,建立在如下三个分代假说之上,即弱分代假说、强分代假说、跨代引用假说。依据分代假说理论,垃圾回收可以分为如下几类:
1. 新生代收集:目标为新生代的垃圾收集。
2. 老年代收集:目标为老年代的垃圾收集,目前只有CMS收集器会有这种行为。
3. 混合收集:目标为整个新生代及部分老年代的垃圾收集,目前只有G1收集器会有这种行为。
4. 整堆收集:目标为整个堆和方法区的垃圾收集。
加分回答-垃圾收集器
HotSpot虚拟机内置了很多垃圾收集器,其中针对新生代的垃圾收集器有Serial、ParNew、Parallel Scavenge,针对老年代的垃圾收集器有CMS、Serial Old、Parallel Old。此外,HotSpot还内置了面向整堆的G1收集器。
在上述收集器中,常见的组合方式有:
1. Serial + Serial Old,是客户端模式下常用的收集器。
2. ParNew + CMS,是服务端模式下常用的收集器。
3. Parallel Scavenge + Parallel Old,适用于后台运算而不需要太多交互的分析任务。
4.G1
5.ZGC
14、说说GC的可达性分析算法
可达性分析算法:
以根对象集合(GC Roots)的每个跟对象为起始点,根据引用关系向下搜索,将所有与GC Roots直接或间接有引用关系的对象在对象头的Mark Word里标记为可达对象,即不需要回收的有引用关系对象。搜索过程所走过的路径称为“引用链” 。
GC Roots:即GC根节点集合,是一组必须活跃的引用。可作为GC Roots的对象:
1、栈引用的对象:Java方法栈、本地方法栈中的参数引用、局部变量引用、临时变量引用等。临时变量是方法里的中间操作结果。 2、方法区中常量、静态变量引用的对象; 3、所有被同步锁持有的对象; 4、所有线程对象; 5、所有跨代引用对象; 6、JVM内部的引用:如基本数据类型对应的Class对象,常驻的异常对象,以及应用程序类类加载器;
非可达对象被回收需要两次标记:
1、第一次标记后筛选非可达对象:第一次被标记后,会进行一次筛选,筛选的条件是此对象是否有必要执行finalize()方法,也就是是否有机会自救。假如对象没有覆盖或者已被JVM调用过finalize()方法,也就是说不想自救或已自救过,那么此对象需要被回收;假如对象覆盖并没被JVM调用过finalize()方法,该对象将会被放置在一个名为F-Queue的队列之中,并在稍后由一条由虚拟机自动建立的、低调度优先级的Finalizer线程去执行它们的finalize()方法。 2、第二次标记F-Queue里的未自救对象:稍后,收集器将对F-Queue中的对象进行第二次小规模的标记。如果对象要在finalize()中成功拯救自己——只要重新与引用链上的任何一个对象建立关联即可,譬如把自己(this)赋值给某个引用类型的类变量或者对象的成员变量,那在第二次标记时它将被移出“即将回收”的F-Queue。如果对象这时候还没有逃脱,那基本上它就真的要被回收了。
finalize()方法:
finalize()方法是对象逃脱死亡命运的最后一次机会,需要注意的是,任何一个对象的finalize()方法都只会被系统自动调用一次,如果对象面临下一次回收,它的finalize()方法不会被再次执行。
另外,finalize()方法的运行代价高昂,不确定性大,无法保证各个对象的调用顺序,如今已被官方明确声明为不推荐使用的语法。
当前主流的商用程序语言的内存管理子系统,都是通过可达性分析算法来判定对象是否存活的。
这个算法的基本思路就是通过一系列称为“GC Roots”的根对象作为起始节点集,从这些节点开始,根据引用关系向下搜索,搜索过程所走过的路径称为“引用链”,如果某个对象到GC Roots间没有任何引用链相连,或者用图论的话来说就是从GC Roots到这个对象不可达时,则证明此对象是不可能再被使用的。
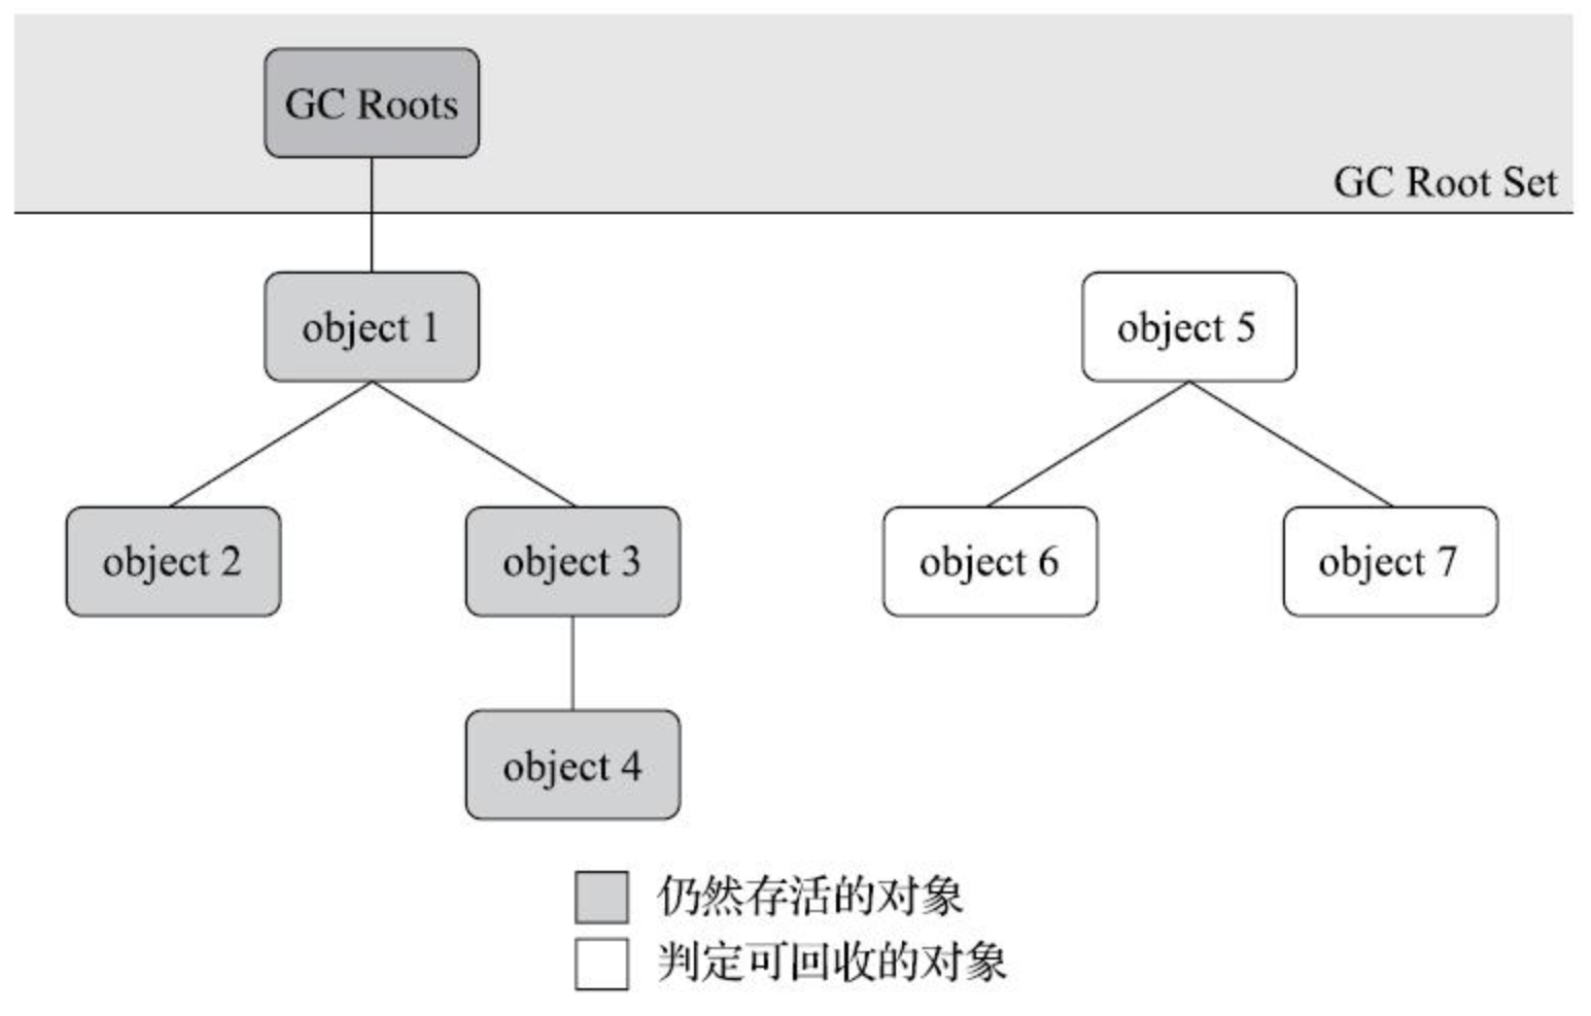
GC Roots 到底是什么东西呢,哪些对象可以作为 GC Root 呢?
- 是一组必须活跃的引用。在Java技术体系里面,固定可作为GC Roots的对象包括以下几种:
- 在虚拟机栈中引用的对象,譬如各个线程被调用的方法堆栈中使用到的参数、局部变量、临时变量等;
- 在方法区中类静态属性引用的对象,譬如Java类的引用类型静态变量;
- 在方法区中常量引用的对象,譬如字符串常量池里的引用;
- 在本地方法栈中引用的对象;
- JVM内部的引用,如基本数据类型对应的Class对象,常驻的异常对象,以及系统类加载器;
- 所有被同步锁持有的对象;
- 反映Java虚拟机内部情况的JMXBean、JVMTI中注册的回调、本地代码缓存等。
加分回答-宣告对象死亡要经历两次标记 真正宣告一个对象死亡,至少要经历两次标记过程: 1. 第一次标记 如果对象在进行可达性分析后发现没有与GC Roots相连接的引用链,那它将会被第一次标记,随后进行一次筛选,筛选的条件是此对象是否有必要执行finalize()方法。假如对象没有覆盖finalize()方法,或者finalize()方法已经被虚拟机调用过,那么虚拟机将这两种情况都视为“没有必要执行”。反之,该对象将会被放置在一个名为F-Queue的队列之中,并在稍后由一条由虚拟机自动建立的、低调度优先级的Finalizer线程去执行它们的finalize()方法。 2. 第二次标记 稍后,收集器将对F-Queue中的对象进行第二次小规模的标记。如果对象要在finalize()中成功拯救自己——只要重新与引用链上的任何一个对象建立关联即可,譬如把自己(this)赋值给某个类变量或者对象的成员变量,那在第二次标记时它将被移出“即将回收”的集合。如果对象这时候还没有逃脱,那基本上它就真的要被回收了。 finalize()方法是对象逃脱死亡命运的最后一次机会,需要注意的是,任何一个对象的finalize()方法都只会被系统自动调用一次,如果对象面临下一次回收,它的finalize()方法不会被再次执行。另外,finalize()方法的运行代价高昂,不确定性大,无法保证各个对象的调用顺序,如今已被官方明确声明为不推荐使用的语法。
15、说说JVM的垃圾回收算法
得分点
标记清除、标记复制、标记整理,比较优缺点(效率、空间浪费、调整引用、stw)、使用场景
标记清除算法、标记复制算法、标记整理算法。
标记清除算法(Mark-Sweep):
标记、清除:当堆中有效内存空间被耗尽时,会STW(stop the world,暂停其他所有工作线程),然后先标记,再清除。 标记:可达性分析法,从GC Roots开始遍历,找到可达对象,并在对象头中进行标记。 清除:堆内存内从头到尾进行线性遍历,“清除”非可达对象。注意清除并不是真的置空,垃圾还在原来的位置。实际是把垃圾对象的地址维护在空闲列表,对象实例化的申请内存阶段会通过空闲列表找到合适大小的空闲内存分配给新对象。 优点:简单 缺点: 效率不高:需要可达性遍历和线性遍历,效率差。 STW导致用户体验差:GC时需要暂停其他所有工作线程,用户体验差。 有内存碎片,要维护空闲列表:回收垃圾对象后没有整理,导致堆中出现一块块不连续的内存碎片。 适用场景:适合小型应用程序,内存空间不大的情况。应用程序越大越不适用这种回收算法。
标记复制算法(Copying) :
标记、复制、清除:将内存空间分为两块,每次只使用一块。在进行垃圾回收时,先可达性分析法标记可达对象,然后将可达对象复制到没有被使用的那个内存块中,最后再清除当前内存块中的所有对象。后续再按同样的流程来回复制和清除。 优点: 垃圾多时效率高:只需可达性遍历,效率很高。 无内存碎片:因为有移动操作,所以内存规整。 缺点: 内存利用率低,浪费内存:始终有一半以上的空闲内存。 需要调整引用地址:可达对象移动后,内存地址发生了变化,需要调整所有引用,指向移动后的地址。 垃圾少时效率相对差,但还是比其他算法强:如果可达对象比较多,垃圾对象比较少,那么复制算法的效率就会比较低。只为了一点垃圾而移动所有对象未免有些小题大做。所以垃圾对象多的情况下,复制算法比较适合。 适用场景:适合垃圾对象多,可达对象少的情况,这样复制耗时短。非常适合新生代的垃圾回收,因为新生代要频繁地把可达对象从伊甸园区移动到幸存区,而且是新生代满了适合再Minor GC,垃圾对象占比高,所以回收性价比非常高,一次通常可以回收70-90%的内存空间,现在的商业虚拟机都是用这种GC算法回收新生代。
标记整理算法(Mark-Compact) :
标记、整理、清除:首先可达性分析法标记可达对象,然后将可达对象按顺序整理到内存的一端,最后清理边界外的垃圾对象。相当于内存碎片优化版的标记清楚算法,不用维护空闲列表。 优点: 无内存碎片:内存规整。 内存利用率最高:内存既规整又不用浪费一般空间。 缺点: 效率最低:效率比其他两种算法都低 需要调整引用地址:可达对象移动后,内存地址发生了变化,需要调整所有引用,指向移动后的地址。 STW导致用户体验差:移动时需要暂停其他所有工作线程,用户体验差。
分代收集算法:将堆分为新生代、老年代不同生命周期的对象放在不同的代,采用不同的收集算法,以提高回收效率。
引用计数法
每个对象都保存一个引用计数器属性,用户记录对象被引用的次数。
可达性分析法
可达性分析法会以GC Roots作为起始点,然后一层一层找到所引用的对象,被找到的对象就是存活对象,那么其他不可达的对象就是垃圾对象。
1. 标记清除算法
算法分为“标记”和“清除”两个阶段,首先标记出所有需要回收的对象,在标记完成后,统一回收掉所有被标记的对象,也可以反过来,标记存活的对象,统一回收所有未被标记的对象。它主要有如下两个缺点: 第一个是执行效率不稳定,如果Java堆中包含大量对象,而且其中大部分是需要被回收的,这时必须进行大量标记和清除的动作,导致标记和清除两个过程的执行效率都随对象数量增长而降低。 第二个是内存空间碎片化问题,标记、清除之后会产生大量不连续的内存碎片,空间碎片太多可能会导致当程序在运行过程中需要分配较大对象时无法找到足够的连续的内存而不得不提前触发另一次垃圾收集。
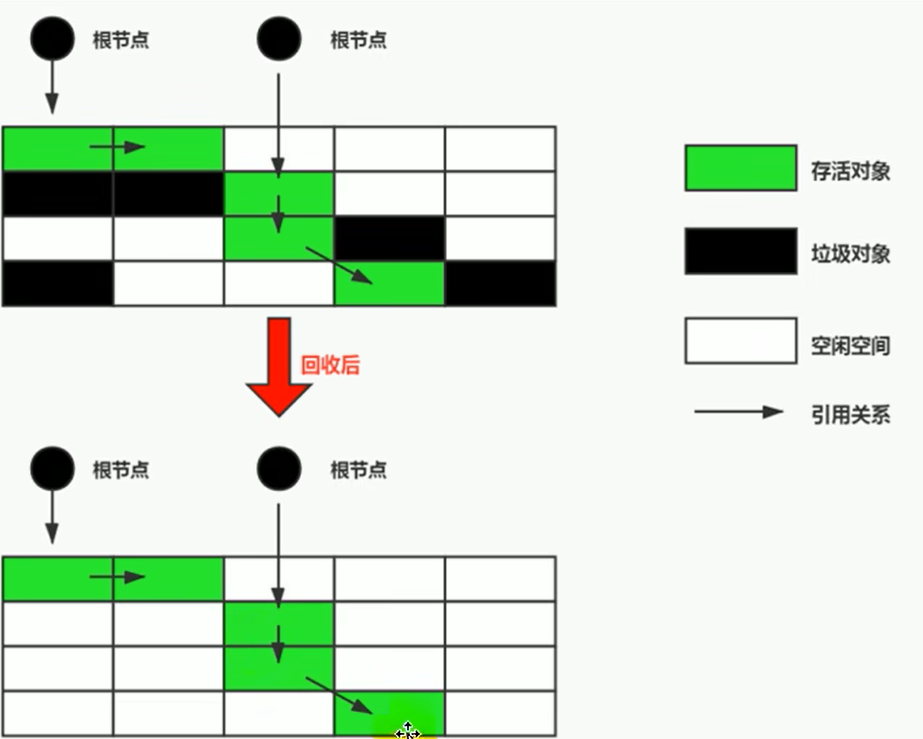
2. 标记复制算法
将可用内存按容量划分为大小相等的两块,每次只使用其中的一块。当这一块的内存用完了,就将还存活着的对象复制到另外一块上面,然后再把已使用过的内存空间一次清理掉。对于多数对象都是可回收的情况,算法需要复制的就是占少数的存活对象,而且每次都是针对整个半区进行内存回收,分配内存时也就不用考虑有空间碎片的复杂情况,只要移动堆顶指针,按顺序分配即可。
这种复制回收算法的代价是将可用内存缩小为了原来的一半,空间浪费未免太多了一点。另外,如果内存中多数对象都是存活的,这种算法将会产生大量的内存间复制的开销。所以,现在的商用Java虚拟机大多都优先采用了这种收集算法去回收新生代。 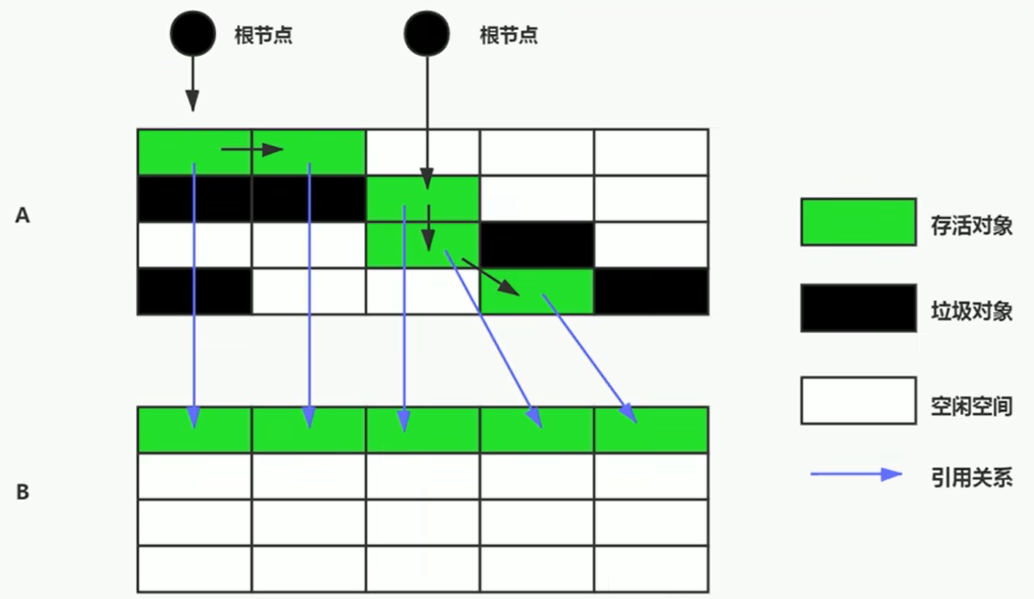
3. 标记整理算法
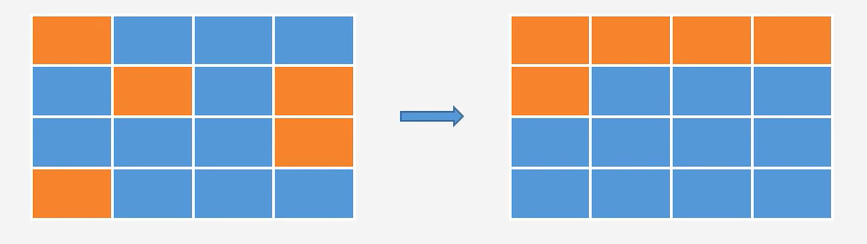
针对老年代对象的存亡特征,1974年Edward Lueders提出了另外一种有针对性的“标记-整理”算法,其中的标记过程仍然与“标记-清除”算法一样,但后续步骤不是直接对可回收对象进行清理,而是让所有存活的对象都向内存空间一端移动,然后直接清理掉边界以外的内存。
如果移动存活对象,尤其是在老年代这种每次回收都有大量对象存活区域,移动存活对象并更新所有引用这些对象的地方将会是一种极为负重的操作,而且这种对象移动操作必须全程暂停用户应用程序才能进行,像这样的停顿被最初的虚拟机设计者形象地描述为“Stop The World”。
加分回答
目前,新生代的垃圾回收采用标记复制算法比较多,老年代的垃圾回收采用标记整理算法比较多。而标记复制算法浪费一半内存的缺点长期以来被人诟病,所以业界也有人针对该算法给出了改进的方案。
IBM公司曾有一项专门研究对新生代“朝生夕灭”的特点做了更量化的诠释——新生代中的对象有98%熬不过第一轮收集。因此并不需要按照1∶1的比例来划分新生代的内存空间。在1989年,Andrew
Appel针对具备“朝生夕灭”特点的对象,提出了一种更优化的半区复制分代策略,现在称为“Appel式回收”。
Appel式回收的具体做法是把新生代分为一块较大的Eden空间和两块较小的Survivor空间,每次分配内存只使用Eden和其中一块Survivor。发生垃圾搜集时,将Eden和Survivor中仍然存活的对象一次性复制到另外一块Survivor空间上,然后直接清理掉Eden和已用过的那块Survivor空间。
HotSpot虚拟机的Serial、ParNew等新生代收集器均采用了这种策略来设计新生代的内存布局。HotSpot虚拟机默认Eden和Survivor的大小比例是8:1:1,也即每次新生代中可用内存空间为整个新生代容量的90%(Eden的80%加上一个Survivor的10%),只有一个Survivor空间,即10%的新生代是会被“浪费”的。
98%的对象可被回收仅仅是“普通场景”下测得的数据,任何人都没有办法百分百保证每次回收都只有不多于10%的对象存活,因此Appel式回收还有一个充当罕见情况的“逃生门”的安全设计,当Survivor空间不足以容纳一次Minor
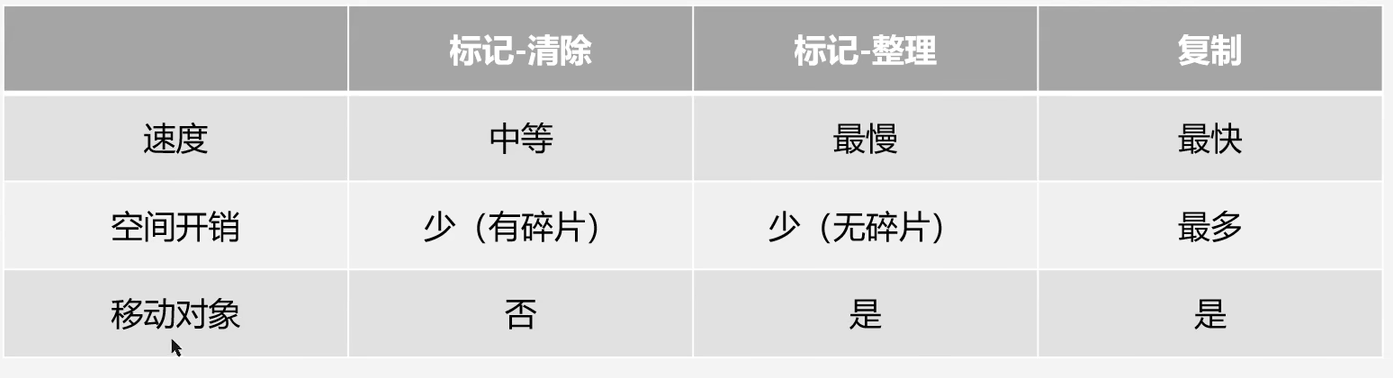
GC之后存活的对象时,就需要依赖其他内存区域(实际上大多就是老年代)进行分配担保。 对比三种垃圾回收算法:
16、请你讲下CMS(并发标记清除)回收器
得分点
介绍、算法、回收区域、四个步骤、优缺点(并发、停顿、内存碎片、浮动垃圾、回收条件)、应用场景
CMS(并发标记清除收集器):
介绍:以最短停顿时间为目标,JDK1.5推出,第一次实现了垃圾收集线程和用户线程同时工作。多线程并行回收老生代,低stw。初始标记和重新标记需要stw,但耗时很短。 算法:标记清除算法。不使用标记整理算法是为了保证清除时不影响用户线程中的工作线程,如果使用标记整理算法的话工作线程引用指向的对象地址就都变了。 回收区域:老年代 步骤: 初始标记:标记GC Roots直接关联的对象。单线程且停顿用户线程,速度很快。 并发标记:从直接关联对象并发遍历整个图,标记可达对象。并发不停顿。 重新标记:修正上一步用户线程变动的标记。并发停顿。速度远比并发标记阶段快。注意只能修正原有对象不能修正新增对象,即只能修正原有对象非可达变可达、可达变非可达。 并发清除:并发线性遍历并清理未被标记的对象。并发不停顿。 优点: 并发速度快; 低停顿:用户线程和垃圾回收器同时执行,仅初始标记和重新标记阶段需要停顿,这两个阶段运行速度很快。 缺点: 并发占线程拖慢速度 有内存碎片:内存不规整,需要维护空闲列表。 无法处理浮动垃圾:并发标记阶段会产生新对象,重新标记阶段又只能修正不能新增,所以会出现浮动垃圾。 回收时要确保用户线程有足够内存:不能等老年代满了再回收,而是内存到达某个阈值后回收,防止用户线程在并发执行过程中新创建对象导致内存不够,导致虚拟机补偿使用Serial Old收集器进行回收并处理内存碎片,从而浪费更多时间。CMS默认是老年代68%时触发回收机制。-XX:CMSInitiatingOccupancyFraction 应用场景:因为底层是标记清除算法,所以有内存碎片,适合小应用。

CMS收集器是一种以获取最短回收停顿时间为目标的收集器,从名字上就可以看出CMS收集器是基于标记清除算法实现的,它的运作过程相对于前面几种收集器来说要更复杂一些,整个过程分为四个步骤,包括:初始标记、并发标记、重新标记、并发清除。其中初始标记、重新标记这两个步骤仍然需要“Stop The World”。
STW:Stop-The-World是在垃圾回收算法执行过程中,将jvm内存冻结,停顿的一种状态。即暂停用户线程。
1. 初始标记仅仅只是标记一下GC Roots能直接关联到的对象,速度很快。
2. 并发标记阶段就是从GC Roots的直接关联对象开始遍历整个对象图的过程,这个过程耗时较长但是不需要停顿用户线程,可以与垃圾收集线程一起并发运行。
3. 重新标记阶段则是为了修正并发标记期间,因用户程序继续运作而导致标记产生变动的那一部分对象的标记记录,这个阶段的停顿时间通常会比初始标记阶段稍长一些,但也远比并发标记阶段的时间短。
4. 并发清除阶段,清理删除掉标记阶段判断的已经死亡的对象,由于不需要移动存活对象,所以这个阶段也是可以与用户线程同时并发的。 指定老年代使用CMS GC:
-XX:+UseConcMarkSweepGC
加分回答-优缺点
CMS是一款优秀的收集器,它最主要的优点在名字上已经体现出来:并发收集、低停顿(单位时间内占用用户线程的时间更少了),一些官方公开文档里面也称之为“并发低停顿收集器”。
CMS收集器是HotSpot虚拟机追求低停顿的第一次成功尝试,但是它还远达不到完美的程度,至少有以下三个明显的缺点:
1. 并发阶段,它虽然不会导致用户线程停顿,却因为占用一部分线程而导致应用程序变慢,降低总吞吐量。
2. 它无法处理“浮动垃圾”,有可能会出现“并发失败”进而导致另一次Full GC的发生。
3. 它是一款基于标记清除算法实现的收集器,这意味着收集结束时会有大量内存碎片产生。
17、请你讲下G1垃圾优先回收器
G1(Garbage-First,垃圾优先收集器):
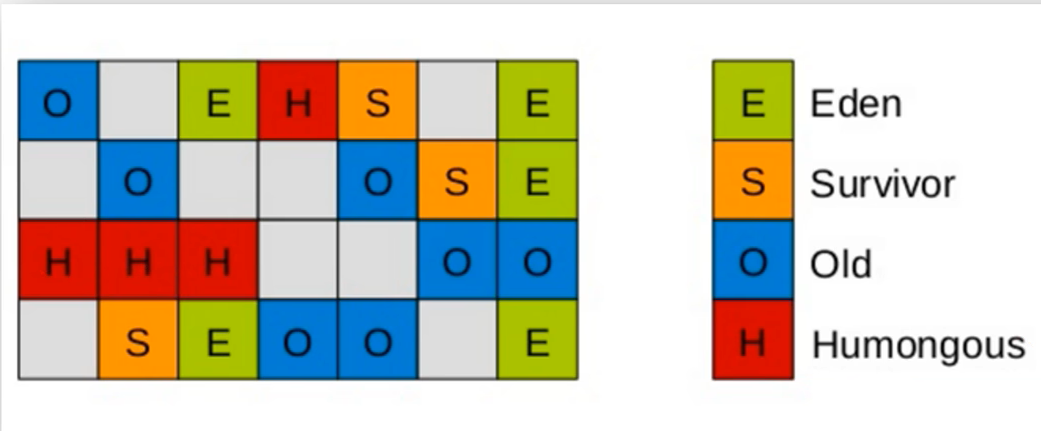
介绍:以延迟可控并保证高吞吐量为目标,为了适应内存大小和处理器数量不断扩大而在JDK7推出的垃圾回收器。开创了收集器面向局部收集的设计思路和基于Region(区域)的内存布局形式。JDK8支持并发类卸载后被Oracle官方称为“全功能的垃圾收集器”。并行低停顿,除了并发标记外需要stw,但耗时很短(初始标记和最终标记是真短,筛选回收是有指定STW)。 实现机制:不再把堆划分为连续的分代,而是将堆内存分割成2048个大小相等的Region,各Region根据需要扮演伊甸园区、幸存区、老年代区、巨大区。垃圾优先收集器跟踪各Region里垃圾的回收价值(回收空间大小和预计回收时长),在后台维护一个优先级列表,每次根据用户设定允许的收集停顿时间,回收优先级最高的那些Region,以达到垃圾优先的效果。 设置最大停顿时间:-XX:MaxGCPauseMillis=默认0.2s Humongous Region(巨大区):存储大小超过Region一半空间的大对象,如果大对象的内存大小超过了Region大小,将会被存在几个连续的巨大区里。G1的大多数行为把巨大区看作老年代的一部分。 算法:分区收集算法(整体是标记整理算法、Region之间标记复制算法) 回收区域:整堆。整堆里哪个Region垃圾最多,回收收益最大。 步骤: 初始标记:标记GC Roots直接关联的可达对象。单线程且停顿用户线程,速度很快。 并发标记:从直接关联对象并发遍历整个图,标记可达对象。并发不停顿。 最终标记:重新标记所有存活的对象。并发停顿。采用SATB算法,效率比CMS重新标记高。并发停顿。 筛选回收:根据优先级列表,回收价值高的一些Region,将存活对象通过标记复制算法复制到同类型的空闲Region。根据指定的最大停顿时间回收,因此可能来不及回收所有垃圾对象,但能保证回收到最高回收价值的垃圾。并发停顿。 记忆集:是一个抽象概念。每个Region都维护一个记忆集Rset,用来记录其他Region对象对本Region对象的引用。本Region在回收后对象地址会改变,用记忆集就能直接知道直接找到对应引用修改指向的地址,从而不用全局扫描。 卡表(CardTable):是记忆集的一种实现方式。卡表是一个字节数组,每个元素对应一个内存块,每个内存块大小都是2^n字节(Hotspot是2^9=512字节)。 写屏障:当前对象被其他Region对象通过引用关系赋值时,赋值前后会插入写前屏障和写后屏障中断当前Region垃圾回收。 CMS的记忆集和写屏障:其他回收器也用了记忆集和写后屏障,用来防止回收导致位置改变时,不用为了更正引用地址而扫描整个堆。例如CMS记忆集记录老年代指向年轻代的引用。但只有G1用到了写前屏障。 优点: 无内存碎片:因为整体和局部是整理和复制,都不会产生内存碎片。 无浮动垃圾:最终标记阶段不但会修正,也会标记新增对象。 缺点: 比CMS更耗费内存和负载。 可能来不及回收所有垃圾:根据指定的STW时间(默认0.2s)回收,因此可能来不及回收所有垃圾对象,但能保证回收到最高回收价值的垃圾。 比CMS更耗费内存和负载:因为使用写前屏障和写后屏障维护记忆集,而cms只用写后屏障。 应用场景:适合多核CPU且内存大的大应用,小应用不及其他回收器,但未来会越来越适合。
//G1混合垃圾回收周期中要包括的旧区域设置占用率阈值。默认占用率为 65%
-XX:G1MixedGCLiveThresholdPercent=65

Garbage First(G1)垃圾优先收集器开创了收集器面向局部收集的设计思路和基于Region的内存布局形式。在G1收集器出现之前的所有其他收集器,垃圾收集的目标范围要么是整个新生代,要么就是整个老年代,再要么就是整个Java堆。而G1跳出了这个限制,它可以面向堆内存任何部分来组成回收集进行回收,衡量标准不再是它属于哪个分代,而是哪块内存中存放的垃圾数量最多,回收收益最大,这就是G1收集器的Mixed GC模式。 
G1也仍是遵循分代收集理论设计的,但其堆内存的布局与其他收集器有非常明显的差异:G1不再坚持固定大小以及固定数量的分代区域划分,而是把连续的Java堆划分为多个大小相等的独立区域(Region),每一个Region都可以根据需要,扮演新生代的Eden空间、Survivor空间,或者老年代空间。
巨大区:此外,还有一类专门用来存储大对象的特殊区域(Humongous Region)。G1认为只要超过了Region一半的对象即可判定为大对象。而对于那些超过了整个Region容量的超级大对象,将会被存放在N个连续的Humongous Region之中,G1的大多数行为都把Humongous Region作为老年代的一部分来进行看待。
更具体的处理思路是,让G1收集器去跟踪各个Region里面的垃圾堆积的“价值”大小(垃圾数量),价值即回收所获得的空间大小以及回收所需时间的经验值,然后在后台维护一个优先级列表,每次根据用户设定允许的收集停顿时间,优先处理回收价值收益最大的那些Region,这也就是“Garbage First”名字的由来。
G1收集器的运作过程大致可划分为以下四个步骤:初始标记、并发标记、最终标记、筛选回收。其中,初始标记和最终标记阶段仍然需要停顿所有的线程,但是耗时很短。
加分回答-G1与CMS的对比:
G1从整体来看是基于标记整理算法实现的收集器,但从局部上看又是基于标记复制算法实现。无论如何,这两种算法都意味着G1运作期间不会产生内存空间碎片,垃圾收集完成之后能提供规整的可用内比起CM存。S,G1的弱项也可以列举出不少。例如在用户程序运行过程中,G1无论是为了垃圾收集产生的内存占用还是程序运行时的额外执行负载都要比CMS要高。
G1与CMS的选择:
目前在小内存应用上CMS的表现大概率仍然要会优于G1,而在大内存应用上G1则大多能发挥其优势,这个优劣势的Java堆容量平衡点通常在6GB至8GB之间。以上这些也仅是经验之谈,随着HotSpot的开发者对G1的不断优化,也会让对比结果继续向G1倾斜。
G1比CMS更耗费内存和负载:因为使用写前屏障和写后屏障维护记忆集,而cms只用写后屏障。

18、ZGC和G1回收原理
简单来说:
- G1 是 “分区整理 + 最终标记 STW”:先记账,最后停一下统一搬运。
- ZGC 是 “并发搬运 + 读屏障实时修正”:边跑边搬,用户无感知。
一、G1 收集器 (Garbage First) 回收过程
G1 的核心是将堆划分为多个 Region,回收过程主要分为 Young GC 和 Mixed GC(包含并发标记周期)。这里重点描述最复杂的 Mixed GC(混合回收) 过程,因为它涉及老年代回收。
阶段 1:初始标记 (Initial Mark) —— [STW]
- 动作:暂停所有线程。
- 内容:直接从 GC Roots 出发,标记直接关联的对象。
- 特点:速度极快,只扫描根节点,不遍历整个堆。
阶段 2:并发标记 (Concurrent Marking) —— [并发]
- 动作:应用线程和 GC 线程同时运行。
- 内容:
- GC 线程从初始标记的对象开始,遍历整个对象图,标记存活对象。
- 写屏障介入:应用线程修改引用时,写屏障将变化记录到 SATB 队列(保证标记一致性)。
- 目的:找出哪些 Region 垃圾最多(计算垃圾占比)。
阶段 3:最终标记 (Final Mark) —— [STW]
- 动作:再次暂停所有线程。
- 内容:
- 处理 SATB 队列:将队列中记录的旧引用标记为存活(防止误删)。
- 更新 RSet (记忆集):确保跨代引用信息最新。
- 计算优先级:根据垃圾占比,对 Region 进行排序,选出要回收的“候选集合”(Collection Set, CSet)。
- 特点:停顿时间比初始标记长,但依然可控。
阶段 4:筛选回收 (Cleanup / Evacuation) —— [STW + 并发]
这是真正的对象移动和清理阶段:
- 动作:
- 选择 Region:从 CSet 中挑选出一部分 Region(保证停顿时间在目标范围内)。
- 复制存活对象:将选中 Region 中的存活对象,一次性复制到空闲的 Region中(整理过程)。
- 更新引用:GC 线程更新所有指向这些对象的引用(包括栈、其他对象字段),指向新地址。
- 清空旧 Region:将旧 Region 整个标记为“空闲”,下次可直接分配。
- 特点:
- 这是一个 Copy Algorithm (复制算法) 的过程。
- STW 主要发生在这里:因为要暂停用户线程来复制对象和更新引用。
- 如果 CSet 太大,一次做不完,会分多次 Mixed GC 完成。
二、ZGC 收集器 (Z Garbage Collector) 回收过程
ZGC 的核心是 染色指针 (Colored Pointers) 和 读屏障 (Load Barriers)。它的目标是所有耗时操作都并发完成,STW 时间恒定在亚毫秒级。
(注:以下以 JDK 11-17 的染色指针版本为例,JDK 21+ 分代 ZGC 逻辑类似但引入了分代)
阶段 1:并发标记 (Concurrent Mark) —— [并发]
- 动作:GC 线程与应用线程同时运行。
- 内容:
- GC 线程遍历对象图,给存活对象的指针打上 Marked (标记位) 染色。
- 读屏障介入:应用线程读取对象时,如果发现标记位不对,协助 GC 进行标记。
- 特点:完全并发,无 STW。
阶段 2:初始标记 (Pause Mark Start) —— [STW < 1ms]
- 动作:极短暂停。
- 内容:标记 GC Roots,并设置全局标记状态。
- 特点:仅同步根节点状态,瞬间完成。
阶段 3:并发预备重映射 (Concurrent Prepare for Remap) —— [并发]
- 动作:GC 线程并发运行。
- 内容:
- 为即将移动的对象准备新地址(分配新的 Page)。
- 建立 转发表 (Forwarding Table):记录 旧地址 -> 新地址 的映射关系。
- 特点:完全并发。
阶段 4:最终标记 (Pause Mark End) —— [STW < 1ms]
- 动作:极短暂停。
- 内容:
- 再次扫描根节点,确保没有漏网之鱼。
- 确认哪些对象需要被移动。
- 特点:瞬间完成。
阶段 5:并发重映射 (Concurrent Remap) —— [并发] (核心差异点)
这是 ZGC 真正的对象移动和清理阶段,大部分工作是与应用线程并发完成的:
GC 线程并发搬运:
- GC 线程将存活对象从旧 Page 复制到新 Page。
- 在旧地址处写入 转发指针 (Forwarding Pointer),指向新地址。
- 将新对象指针的 Remapped (重映射位) 染色位置为 1(表示已移动)。
应用线程自我修复 (读屏障 magic):
- 当应用线程尝试访问一个已被移动但引用未更新的对象时:
- 读屏障触发:检查指针的 Remapped 位。
- 发现异常:发现位为 1,说明对象搬家了。
- 查表修正:通过旧地址查 转发表,拿到新地址。
- 原子更新:立即将当前指针更新为新地址,并清除染色位。
- 继续执行:应用线程拿着新地址访问对象,完全无感知。
结果:
- 随着应用线程不断访问对象,所有旧指针都被逐步修正为新指针。
- 当所有指针都修正完毕,旧 Page 彻底无人引用,直接释放。
阶段 6:初始重映射 (Pause Remap Start) —— [STW < 1ms]
- 动作:极短暂停(可选,视实现版本而定,通常用于同步最后的状态)。
- 内容:确保所有线程都看到了最新的映射关系。
- 将旧page状态变成空闲,旧数据不做清理,新数据进入空闲(旧)page物理覆盖旧数据
三、核心对比总结
表格
| 对象移动时机 | STW 期间 (筛选回收阶段)。 GC 独占 CPU,批量复制对象。 | 并发期间 (Concurrent Remap)。 GC 线程搬,应用线程边用边修。 |
| 指针更新方式 | GC 线程统一更新。 GC 在 STW 期间遍历所有引用,一次性改好。 | 应用线程自我修复。 读屏障在每次读取时,发现旧指针立刻修正。 |
| STW 来源 | 复制对象 + 更新引用 耗时较长。 堆越大,复制越多,停顿越久。 | 仅同步根状态。 对象移动和指针修正都在并发期完成,停顿与堆大小无关。 |
| 数据结构依赖 | RSet + SATB。 依赖复杂的记忆集和快照队列。 | 染色指针 + 转发表。 依赖指针高位状态和轻量级映射表。 |
| 形象比喻 | 搬家公司: 大家先停下(STW),搬家公司把家具全搬走,改好地址标签,大家再开工。 | 魔法搬运工: 搬家公司偷偷搬家具。你回家开门(读屏障),发现家具位置变了,魔法自动把你手里的钥匙改成新门的钥匙,你完全没感觉。 |
结论
- G1 是通过 “集中力量办大事”(STW 期间批量复制和更新)来换取实现的相对简单和吞吐量的平衡。
- ZGC 是通过 “化整为零”(将更新指针的工作分摊到每一次读操作中)来换取极致的低延迟。
为什么ZGC从不分代变成分代了。原因:
隔离与优化:减少大堆扫描风暴和读屏障误伤
1. 读屏障的“误伤” (Load Barrier Overhead)
- 机制:ZGC 依赖读屏障。每次访问对象,都要检查指针的染色位。
- 问题:Java 应用中 99% 的对象都是“朝生夕死”的(短命对象,如临时变量、循环内的对象)。
- 在不分代模式下,这些刚创建、马上就会死的对象,依然要被读屏障检查。
- 更糟糕的是,当 GC 进行并发标记时,这些短命对象可能正处于“半标记”状态,导致读屏障频繁触发慢路径(Slow Path),去查表、去同步状态。
- 后果:CPU 大量时间花在检查那些马上就要变成垃圾的对象上,做了很多无用功。
2. 大堆下的“扫描风暴”
- 机制:并发标记需要遍历所有存活对象。
- 问题:如果堆很大(比如 64GB),且应用分配率极高(每秒创建几 GB 临时对象)。
- 不分代 ZGC 必须尝试去标记所有这些临时对象。
- 虽然它们很快会死,但在标记窗口期内,GC 线程要和它们“赛跑”。
- 如果分配速度 > 标记速度,GC 就会跟不上,被迫触发保护机制(如降低分配速率或退化为 STW),导致吞吐量下降。
这就是原因: