论文信息: HAMFace: Hardness Adaptive Margin Loss for Face Recognition with Various Intra-class Variations 作者: Jiazhi Li, Degui Xiao, Tao Lu, Yuqi Wei, Jia Li(湖南大学)
目录
一、这篇论文要解决什么问题?
1.1 人脸识别的拦路虎:类内变化
1.2 以前的方法怎么做的?
1.3 HAMFace的切入点
二、什么是"Hard Positive Example"(难正样本)?
三、公式逐一解析
公式1:通用Margin-based Loss(背景知识)
公式2:难样本判断函数 (Hard Example Selection)
公式3:难度缩放函数
公式4:自适应Margin函数 (核心设计)
公式5:HAM Loss(最终损失函数)
四、与之前方法的对比:创新点在哪里?
4.1 和固定Margin方法(ArcFace/CosFace)的区别
4.2 和AdaptiveFace(类级别自适应)的区别
4.3 和MagFace/AdaFace(图像质量自适应)的区别
4.4 和JAMsFace的区别
五、实验结果
跨姿态(CFP-FP / CPLFW)
跨年龄(CALFW / AgeDB-30 / CACD-VS)
混合变化(IJB-B / IJB-C,TAR@FAR=1e-4)
通用基准(LFW / MegaFace)
六、超参数分析
七、总结
一、这篇论文要解决什么问题?
1.1 人脸识别的拦路虎:类内变化
在现实场景中,同一个人的照片可能差异极大——不同年龄、不同角度、不同光线、低分辨率、有遮挡……这些都叫做类内变化(Intra-class Variation)。
类内变化是人脸识别最棘手的难题之一。现有的主流方法(ArcFace、CosFace等)在"标准"测试集上表现很好,但一碰到大姿态、跨年龄这类场景,性能就会明显下滑。
1.2 以前的方法怎么做的?
思路一(针对具体变化单独处理):
- 专门训练一个跨姿态模型
- 专门训练一个跨年龄模型
- 两个合在一起用
缺点:遇到多种变化混合的场景就歇菜了,而且每种变化都要单独处理,复杂度高。
思路二(自适应Margin):
- AdaptiveFace:按类别给不同margin
- MagFace、AdaFace:用图像质量(feature norm)来衡量难度,给不同margin
缺点:图像质量 ≠ 样本难度。一张清晰的大姿态人脸,图像质量很高,但对模型来说很难识别;相反,一张模糊的正脸,质量低,但模型识别起来不一定困难。用图像质量代替难度,逻辑上是有偏差的。
1.3 HAMFace的切入点
HAMFace的思路非常直接:不管你是什么原因导致的难,我直接测量你有多难,然后给你分配对应大小的margin。
核心主张:
难样本(Hard Positive Examples)需要更大的margin,把它们推向类中心,从而压缩类内方差。
二、什么是"Hard Positive Example"(难正样本)?
在人脸识别中:
- Easy Example(简单样本):正面、清晰、标准的人脸,模型很容易正确识别
- Hard Positive Example(难正样本):同一个人的照片,但由于姿态、年龄、遮挡等原因,特征向量离类中心很远,模型容易搞错
用角度来理解: 特征向量  和它对应的类别中心权重
 之间的夹角
 越大,说明这个样本越难。
直觉图示:
W_y(类中心)
/
/ ← θ小 = 简单样本(靠近类中心)
/
x_easy
W_y(类中心)
/
/
/ ← θ大 = 难样本(远离类中心)
/
/
x_hard
三、公式逐一解析
公式1:通用Margin-based Loss(背景知识)
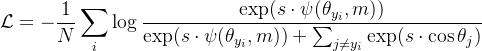
这是SphereFace、CosFace、ArcFace的统一形式。
参数说明:
 |
缩放因子(通常为64),防止cos值太小 |
 |
固定margin值 |
 |
第  个样本的真实类别标签 |
 |
特征向量与第  类权重的夹角 |
 |
margin函数,不同方法定义不同 |
三种经典方法的margin函数:
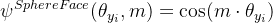
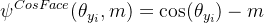
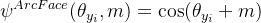
共同缺陷: 是固定常数,对所有样本一视同仁,完全忽略了样本的难易程度。
公式2:难样本判断函数  (Hard Example Selection)
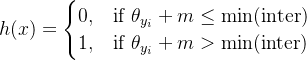
参数说明:
|
样本特征与正确类别权重的夹角(越大越难) |
|
固定的角度margin |
 |
样本与所有非正确类别权重夹角中的最小值 |
 |
简单样本 |
 |
难正样本 |
通俗理解: 如果一个样本加上固定margin之后,仍然比它"最相似的错误类别"更接近正确类别,那它就是简单样本;反之,它已经快被错误类别"抢走"了,就是难样本。
场景理解
假设训练集有5个人(5个类别),每个类别有一个"代表向量"(权重向量 W),可以理解为这个人的"标准模板"。
现在来了一张照片 x,它的真实身份是 第1个人。
计算所有夹角
模型会计算 x 的特征向量与每个类别模板之间的夹角:
x 与 W₁(正确类,第1人)的夹角 = θ_y ← 这是"正确类"的角度
x 与 W₂(错误类,第2人)的夹角 = 60°
x 与 W₃(错误类,第3人)的夹角 = 45° ← 最小!最相似的错误类
x 与 W₄(错误类,第4人)的夹角 = 80°
x 与 W₅(错误类,第5人)的夹角 = 70°
那么 min(inter) 就是45° ,也就是"所有错误类别中,和 x 最像的那个类别"的夹角。
为什么用这个值来判断难易?
h(x) 的判断条件是:
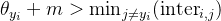
拆开来说就是:
- 如果正确类的角度 + margin 仍然比最危险的错误类角度小,说明样本还比较安全,是简单样本
- 如果正确类的角度 + margin 已经超过了最危险的错误类,说明这个样本快被"抢走"了,是难正样本
打个比方
x 是一张张三的照片,W3 是李四的模板,两者夹角只有45°,说明这张照片"长得有点像李四"。
如果张三这张照片本身识别就不太准(  较大),再加上margin之后,已经比45°更大了,意味着模型更倾向于认为它是李四——这就是 难正样本,需要更大的margin把它往张三的方向"压"回去。
这个函数来自作者团队之前的工作IHEM,HAMFace在此基础上进一步设计了自适应margin。
公式3:难度缩放函数 

通俗理解: 这个函数用来量化样本的难度,并把难度映射成一个缩放系数。
- 当
 (样本很简单,特征靠近类中心):
 ,缩放系数接近0
- 当
 (样本很难,特征远离类中心):
 ,缩放系数接近1
函数是凸增函数(如论文Fig.4所示),这意味着越难的样本, 增长越快,体现了对极难样本的重点关注。

公式4:自适应Margin函数  (核心设计)

参数说明:
|
基础固定margin(与ArcFace相同) |
 |
缩放因子,控制自适应margin的幅度,论文取  |
|
难样本判断(0或1) |
|
难度缩放系数(连续值,越难越大) |
三种情况分析:
① 简单样本():

退化为固定margin,和ArcFace完全一样。
② 难正样本(,代入 ):

越大(越难), 越大,施加的惩罚越强。
③ 极端情况( ):

整体退化为标准ArcFace。
一句话总结公式4的设计思路: 简单样本用固定margin保持稳定训练,难正样本根据难度动态加大margin,像楔子一样把难样本"挤压"回类中心。
公式5:HAM Loss(最终损失函数)

这个公式分两种形式:
对简单样本(Easy examples,):

→ 等价于标准ArcFace,简单样本的训练不受影响。
对难正样本(Hard examples,):

其中 , margin随难度动态增大。
训练中的比例: 简单样本数量远多于难正样本,主导整体训练方向;难正样本虽少,但通过更大的margin得到重点优化。
四、与之前方法的对比:创新点在哪里?
4.1 和固定Margin方法(ArcFace/CosFace)的区别
| Margin粒度 | 全局固定,所有样本相同 | 样本级别,每个样本不同 |
| 难样本处理 | 和简单样本一视同仁 | 专门分配更大margin |
| 自适应依据 | 无 | 样本与类中心的角度距离 |
4.2 和AdaptiveFace(类级别自适应)的区别
AdaptiveFace按类别(class-level)分配margin,同一个人的所有照片用同一个margin。
HAMFace按样本(sample-level)分配margin,同一个人的照片中,难的那张用大margin,简单的那张用小margin,粒度更细。
4.3 和MagFace/AdaFace(图像质量自适应)的区别
| MagFace | Feature norm(特征模长)≈ 图像质量 | 质量高的给大margin |
| AdaFace | Feature norm ≈ 图像质量 | 质量高的受重视,质量低的被忽略 |
| HAMFace | (与类中心的角度)= 识别难度 |
难的给大margin |
关键区别: MagFace和AdaFace用图像质量代替难度,逻辑上存在偏差——一张清晰的大角度侧脸,图像质量高,但识别难度同样高。HAMFace直接用角度距离衡量难度,更加直接准确。
4.4 和JAMsFace的区别
上一篇JAMsFace的创新是:把角度和余弦两个空间的margin联合使用,并按类别做自适应。
HAMFace的创新是:按样本难度做自适应,粒度更细,且自适应依据从"类别样本数量"变成了"每个样本与类中心的角度距离"。
两篇论文解决的是不同侧面的问题:
- JAMsFace关注的是类间不均衡(长尾分布)
- HAMFace关注的是类内不均衡(同一类内的难易样本不均衡)
五、实验结果
HAMFace在9个基准数据集上进行了验证,覆盖跨姿态、跨年龄、混合变化和通用场景。
跨姿态(CFP-FP / CPLFW)
| ArcFace | 98.27 | 92.08 |
| MagFace | 98.46 | 92.87 |
| IHEM | 99.03 | 93.25 |
| HAMFace | 99.06 | 93.33 |
相比ArcFace,CFP-FP提升了0.79%,CPLFW提升了1.25%,在跨姿态场景改善明显。
跨年龄(CALFW / AgeDB-30 / CACD-VS)
| ArcFace | 95.45 | 98.15 |
| AdaFace | 96.02 | 98.17 |
| HAMFace | 96.27 | 98.45 |
混合变化(IJB-B / IJB-C,TAR@FAR=1e-4)
| ArcFace | 94.25 | 95.65 |
| MagFace | 94.51 | 95.97 |
| HAMFace | 95.04 | 96.46 |
通用基准(LFW / MegaFace)
| ArcFace | 99.83 | 81.03 |
| CurricularFace | 99.80 | 81.26 |
| HAMFace | 99.87 | 81.54 |
六、超参数分析
论文做了两个关键超参数的消融实验:
超参数 (控制自适应margin的幅度)
| 0(=ArcFace) | 99.42 | 95.23 | 94.27 |
| 0.10 | 99.45 | 96.91 | 94.48 |
| 0.20 | 99.53 | 97.13 | 94.60 |
| 0.25 | 99.40 | 96.71 | 94.55 |
时完全退化为ArcFace,随着 增大性能提升,但过大会导致训练不稳定,最优值为 。
超参数 (基础固定margin)
实验表明  效果最佳,与ArcFace的推荐值保持一致。
七、总结
HAMFace的核心思想一句话概括:
不用图像质量,不用类别数量,直接用样本与类中心的角度距离来衡量难度,然后给难正样本分配更大的自适应margin,把它们"挤"回类中心。
方法的简洁之处在于:整个设计就是在ArcFace的基础上,把固定margin 替换成了动态margin ,实现简单,但效果显著。
HAMFace的亮点:
- 自适应粒度:样本级别(比类级别更细)
- 自适应依据:识别难度而非图像质量(更直接)
- 方法简洁:无需特殊网络结构,即插即用
- 场景通用:一个模型统一应对跨姿态、跨年龄、混合变化等多种场景
局限性:
- 自适应依据()的合理性有一定假设:角度大 = 样本难,这在某些场景下可能不完全成立
- 引入了新的超参数 ,需要额外调参