大家读完觉得有机的关注和点赞!!!
摘要
技术进步已经彻底改变了众多行业,包括交通运输业。虽然数字化、自动化和互联性提升了安全性和效率,但它们也引入了新的漏洞。鉴于95%的数据泄露可归因于人为错误,提升交通运输领域的网络安全意识变得日益关键。尽管全球交通系统遭受了无数网络攻击,但这些事件的全面和集中记录仍然稀缺。为弥补这一差距并增强网络意识,本文提出了一种基于大语言模型(LLM)的方法,用于从公开可用的数据集中提取和组织与交通相关的网络事件。这项工作的一个关键贡献是利用生成式AI将非结构化、异构的网络事件数据转换为结构化格式。事件来源包括国际战略研究中心(CSIS)重大网络事件清单、马里兰大学网络事件数据库(UMCED)、欧洲网络事件库(EuRepoC)、海事网络攻击数据库(MCAD)以及美国交通部(U.S. DOT)的交通网络安全与恢复力(TraCR)项目中的交通网络攻击案例(2018年至2022年)。这些事件通过微调的LLM被分类为五种交通模式:航空、海事、铁路、公路和多式联运,从而形成一个交通专用的网络事件数据库。这项工作的另一个关键贡献是开发了一个检索增强生成(Retrieval Augmented Generation)问答系统,旨在通过使用户能够查询精心整理的数据库以获取交通相关网络事件的具体细节,来增强可访问性和实用性。通过利用LLM进行数据提取和用户交互,本研究贡献了一种新颖、易用的工具,用于改善交通领域的网络安全意识。
关键词: 交通运输,网络安全,网络意识,劳动力发展,大语言模型
引言
交通运输业变得比以往任何时候都更加数字化、自动化和互联。虽然这对安全和效率有益,但网络空间的这种扩展极大地增加了该领域的攻击面。2024年IBM数据泄露成本报告指出,2024年交通运输行业数据泄露的平均成本为443万美元 (1)。据报道,2020年海事行业在过去三年中经历的网络攻击激增了900% (2)。洛杉矶港首席信息安全官报告称,该港口遭受的网络攻击从2014年的每月700万次大幅增加到2024年的每月惊人的6000万次 (3)。据报道,2024年铁路相关网络攻击在过去五年中增加了220% (4)。据报道,截至2025年,汽车行业在过去三年中经历的网络攻击增加了225% (5)。2025年的一份报告指出,航空业经历的勒索软件攻击同比增长了600% (6)。
网络攻击在数量和复杂性上都在不断增加 (7)。然而,不容忽视的是,95%的数据泄露是人为错误的结果 (8)。随着系统变得越来越先进,人类必须与智能系统紧密合作;因此,训练不足的员工构成了严重的网络安全风险,因为他们经常被攻击者通过社会工程学手段利用 (9)。由此可见,改善交通领域网络安全的一种方式是通过员工教育,从而提升劳动力的网络意识 (10)。员工教育的一种手段是确保员工能够获取关于过去几年交通领域发生的网络事件的最新信息。然而,要找到跨越多年的交通网络事件数据库或清单颇具挑战性。
在过去十年中,各种公开的存储库旨在编录跨行业(包括交通)的网络事件。例如,马里兰大学的网络事件数据库(UMCED)汇集了可追溯到2014年的已报告攻击,提供了来自新闻报道和新闻稿的结构化事件摘要 (11)。欧洲网络事件库(EuRepoC)同样提供了一个开放获取、每日更新的全球事件日志,尽管其关注点涵盖所有领域而非仅限于交通 (12)。虽然这些资源提供了宝贵的档案,但它们通常需要手动浏览或自定义数据导出脚本才能找到与特定领域或问题相关的事件。同时,国家漏洞数据库(NVD)等漏洞跟踪器索引软件缺陷和漏洞利用,但并未直接将其与现实世界的交通网络事件联系起来 (13)。来自网络安全和基础设施安全局(CISA)和欧盟网络安全局(ENISA)等机构的交通领域指南提供了最佳实践和全行业威胁评估 (14, 15)。然而,它们缺乏事件级别的搜索能力,无法回答诸如“交通机构发生了什么?”或“哪些货运运营商遭受了勒索软件攻击?”之类的自然语言查询。
LLM先前已被用于文本分类和数据库开发任务。例如,Kumar等人 (16) 对GPT和LLaMA-2模型进行了微调,并比较了它们在一系列文本分类任务中的性能,结论是两种模型在此领域都表现出强大的能力。类似地,Berkane等人 (17) 开发了一个端到端、人在回路的LLM应用程序,利用文本描述通过网络爬虫构建目标数据集,说明了LLM如何帮助数据库构建。我们的方法也采用了LLM,特别是微调的GPT-3.5 Turbo模型,来对网络事件中受影响的交通模式进行分类以生成数据库。然而,与Berkane等人 (17) 不同,我们不依赖网络爬虫;相反,我们从可靠的网络安全特定数据源中过滤事件。
LLM也已应用于各种网络安全任务。Xu等人 (18) 对185篇关于LLM在网络安全中应用的论文进行了系统性文献回顾,概述了在网络、信息、软件、硬件和区块链安全中的应用。他们的研究强调了常用开源、收集和构建的数据集,以及常见技术如检索增强生成(RAG)、提示工程和微调。该综述还指出主要使用了解码器专用模型,如GPT-2、GPT-3.5和GPT-4。然而,Xu等人 (18) 并未发现专门为交通领域或网络安全教育设计的LLM应用。相比之下,Salek等人 (19) 将LLM与RAG和微调集成在一个威胁建模框架中,以映射交通信息物理系统中的攻击路径,同时最大限度地减少专家干预。我们的方法不同之处在于,它旨在支持用户学习和意识提升,而不是减少人类在威胁分析中的参与。
LLM在网络安全教育中的应用也正在兴起。例如,CyberRAG (20) 提供了一个交互式问答系统,利用本体感知的RAG支持网络安全教育。类似地,IntellBot (21) 利用LangChain和RAG,从包含报告、安全书籍、博客和国家漏洞数据库的知识库中提取信息,创建了一个聊天机器人,帮助用户主动防范网络威胁。虽然这些系统与我们的工作共享教育目标,但我们的方法独特地专注于交通领域,并专门设计用于回答用户关于影响交通系统的网络事件的问题。
本研究受到先前在基于LLM的数据库构建和自然语言查询方面工作的启发。基于Kumar等人和Berkane等人的方法,它引入了三个关键创新。首先,它针对交通领域,该领域在LLM驱动的网络安全研究中代表性不足。其次,它放弃了网络爬虫,转而使用经过验证的、领域特定的异构数据源。为了协调这些不同的格式,我们采用了生成式AI和精心设计的一次性提示(one-shot prompt),将数据转换为统一的JSON结构。第三,它不仅是教育性质的,而且是专门为帮助用户探索交通领域的历史网络事件而构建的。
我们的工作有两个核心贡献。第一个是创建了一个结构化的、按模式分类的交通相关网络事件数据库,通过使用微调的GPT-3.5 Turbo模型从可信的网络安全数据集中提取和分类条目而构建。第二个是开发了一个使用RAG和GPT-4o mini的问答(Q-A)系统,该系统利用这个静态数据库来响应用户查询。图1说明了这两个组件是如何连接的。
通过将异构数据转换为统一格式,并汇编每个条目的关键细节,如攻击类型、日期、交通模式和简要描述,我们的系统既可作为交通专用的网络事件数据库,又可为用户提供精确的、上下文相关的摘要。例如,像“2022年对起亚汽车美国的网络攻击中索要了多少赎金?”这样的查询,会从整理的数据中得出有针对性的回答,在回答问题的同时提供相关的上下文细节。强调准确性、领域特异性和用户意识,我们的系统填补了现有工具的空白,而不提供实时警报或取证分析。
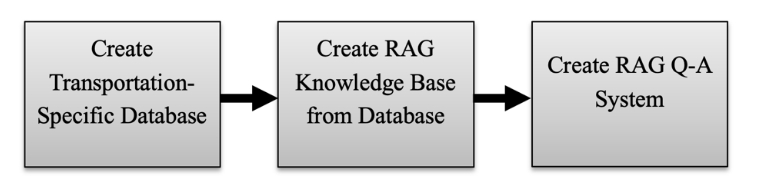
图 1 从数据库创建到用户问答系统的流程
基于LLM的网络事件信息提取方法
这种基于LLM的网络事件信息提取方法使交通运输行业的个人能够更多地了解其各自交通模式中发生的网络攻击。它利用现有数据库,过滤掉与交通无关的事件,创建一个交通相关的网络事件数据库。此工具的目的是使用户更全面地了解交通行业的网络威胁态势。
现有数据集
本研究使用了五个数据源:马里兰大学网络事件数据库(UMCED)(11)、欧洲网络事件库(EuRepoC)数据库(12)、国际战略研究中心(CSIS)重大网络事件清单(22)、NHL Stenden海事网络攻击数据库(MCAD)(23)以及交通网络安全与恢复力(TraCR)项目中的2018年至2022年交通网络攻击案例(我们手动编制的2018年至2022年交通网络事件数据集)。后两个数据源仅包含与交通相关的网络事件,而前三个数据源包含关键行业(包括交通)相关的网络事件。UMCED包含从2014年至今与网络事件相关的公开信息。该数据库由马里兰大学国际与安全研究中心开发。它的创建是为了提供结构化数据,为网络事件预防和响应的投资决策提供信息(11)。EuRepoC数据库包含从2000年至今的事件。该数据库为网络事件的科学分析而编制,旨在更好地理解当前的网络威胁态势(12)。CSIS数据源是自2006年以来发生的重大网络事件清单。此清单包含对“政府机构、国防和高科技公司的攻击,或造成超过百万美元损失的经济犯罪”的描述(22)。MCAD收录了自2001年以来海事领域的网络事件。该数据库包含超过160起网络事件的公开信息,旨在提升海事行业的网络安全意识(23)。TraCR数据库包含2018年至2022年发生在航空、海事、铁路和公路交通中的网络事件。这些数据是从学术文章和网络安全报告中收集的,以深入了解研究期间交通领域的威胁态势。表1总结了本研究使用的数据集及其提供的信息。
表 1 用于构建本研究交通专用数据库的网络事件数据库概览
|
UMCED |
从2014年至今与网络事件相关的公开信息 |
14,041 |
多个行业和领域 |
(11) |
|
EuRepoC |
从2000年至今为网络事件科学分析而编制的事件 |
3,414 |
多个行业和领域 |
(12) |
|
CSIS |
自2006年以来对“政府机构、国防和高科技公司,或造成超过百万美元损失的经济犯罪”的攻击描述 |
(未指定, 97页事件) |
多个行业和领域 |
(22) |
|
TraCR |
2018年至2022年发生的与航空、海事、铁路和公路交通相关的网络事件案例 |
124 |
仅交通行业 (航空、海事、铁路、公路和多式联运) |
|
|
MCAD |
自2001年以来海事领域网络事件的公开信息 |
279 |
仅海事 |
(23) |
数据库准备
本研究使用了上述五个数据源的数据。如前所述,在这五个数据集中,两个仅包含与交通相关的网络事件,另外三个包含关键领域相关事件的混合。由于这些数据源的格式不同,每个数据集都被转换为JSON文件。图2演示了数据源如何被组织成JSON格式。TraCR和CSIS数据集是PDF文件,因此使用GPT-4o从事件中提取相关字段并为每个事件分配交通模式,以形成JSON文件中的结构化条目,为每个数据集创建一个文件(见图2 (a))。UMCED数据集以Excel文件提供,EuRepoC文件以CSV文件提供,MCAD被爬取为结构化的文本文件。因此,这些数据集无需使用LLM即可轻松转换为JSON格式(见图2 (b))。

图 2 (a) 使用GPT-4o将PDF数据集转换为JSON;(b) CSV、XLS和TXT文件无需LLM参与即解析为JSON
由于TraCR数据集已经包含124个交通网络事件示例(115个条目,因为有些条目涉及多个事件)及其具体模式,这些条目以及来自UMCED、CSIS和EuRepoC数据源的85个非交通相关事件示例,作为一个训练集,用于微调GPT-3.5 Turbo模型,以正确分类网络事件的交通模式。为了为每个事件分配交通模式标签,我们使用了一个单轮提示(single-turn prompt),指示模型根据JSON对象中找到的事件数据对涉及的交通模式进行分类。该提示包括来自结构化条目的关键字段,如攻击名称、事件类型、描述、受害者、攻击者和动机。然后要求模型使用预定义的指南填充交通模式字段。这些指南将领域特定术语映射到五个类别之一:公路(Road)、铁路(Rail)、海事(Maritime)、航空(Aviation)或多式联运(Multimodal)。如果不存在与交通相关的元素,则指示模型将该字段留空(null)。微调模型在200个事件上训练了两个周期(epochs)。
使用微调后的LLM,为UMCED、CSIS和EuRepoC数据集根据其描述分配了交通模式。为了评估模型,使用固定随机种子从每个数据集的每个交通模式(“航空”、“海事”、“多式联运”、“铁路”、“公路”和“无”)中抽取了五个事件。评估集总共有90个随机选择的事件。经过过滤器保留的事件以及TraCR和MCAD事件被转换为向量存储嵌入(vector store embeddings),作为问答系统的知识库。图3总结了数据库准备过程,图4显示了来自CSIS数据集的保留事件示例。

图 3 数据库准备流程
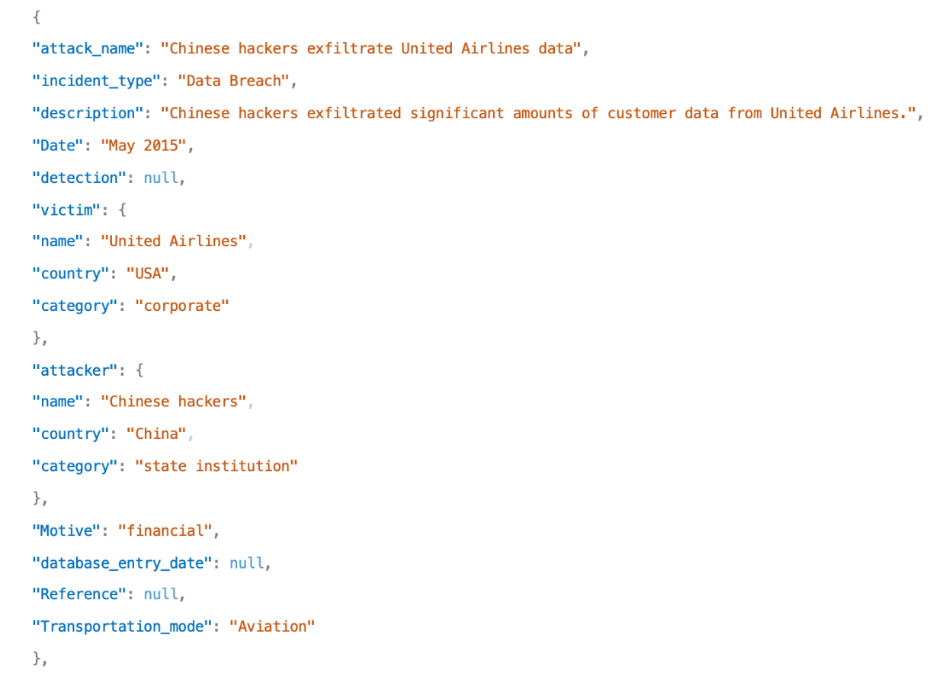
图 4 经过过滤器分配交通模式后,从CSIS数据集中保留的事件条目示例
基于检索增强生成(RAG)的问答方法
上述数据库作为问答方法的知识库。其文本内容使用LlamaIndex进行处理,通过OpenAI的text-embedding-ada-002模型将文档转换为嵌入(embeddings)。这些嵌入存储在一个持久化的向量存储中,允许构建一个向量索引,以实现高效的基于相似性的检索。创建向量存储索引时使用了768个令牌(tokens)的块(chunks)和100个令牌的重叠(overlap)。
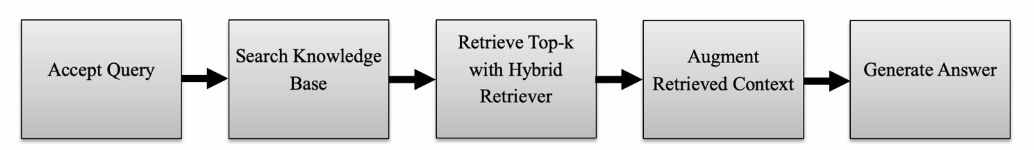
图 5 使用混合检索的基于RAG的问答系统
对于问答任务,使用了以ChatGPT-4o mini为底层模型的RAG。RAG通过从外部知识库检索前k个最相关的块并将其纳入提示(prompt)中,有助于缓解幻觉问题(即大型语言模型有时产生的错误或捏造的回答)。这在像网络安全这样的领域尤其重要,因为LLM可能知识有限,且新事件频繁发生。通过将模型的回答建立在相关的领域特定信息之上,RAG有助于确保用户获得关于不断演变的威胁态势的准确和及时的见解。图5展示了我们的RAG问答系统的工作原理。
混合检索器(Hybrid retrievers)通过捕获语义相似性和词汇重叠,在检索任务上的表现优于单独的稠密或稀疏方法 (24, 25)。我们的RAG系统使用了一个结合稠密和稀疏检索的混合检索器。稠密检索器基于向量相似性,而稀疏检索器使用BM25 (26)。稠密检索器利用查询和信息块之间的向量相似性来识别每个查询最相关的文档。查询q和块c之间的相似性通过余弦相似度计算:

BM25(稀疏检索器)利用词项频率(term frequency)和逆文档频率(inverse document frequency),并对块长度进行归一化。查询q和块c的BM25分数计算如下:
BM25(q,c)=t∈q∑IDF(t)⋅f(t,c)+k1⋅(1−b+b⋅avgcl∣c∣)f(t,c)⋅(k1+1)(2)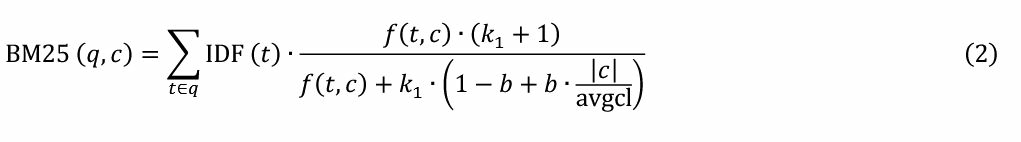
其中,
f(t,c)是词项t在块c中的频率,
∣c∣是块c的长度,
avgcl 是知识库中的平均块长度,
k1是词项频率的超参数(使用默认值1.5),
b是块长度归一化的超参数(使用默认值0.75),
且 IDF(t)=log(n(t)+0.5N−n(t)+0.5+1),其中N是块总数,n(t)是包含词项t的块数。
每个块的混合分数计算如下:
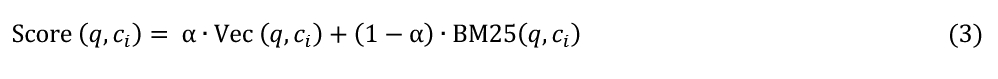
其中 α∈[0,1]是一个平衡稀疏和稠密检索方法影响的参数。本实验选择 α=0.5,以给予语义相似性和稀疏检索方法同等权重。检索每个检索器的前k个块,对于重叠的块,计算混合分数。块根据其混合分数降序排列,列表中的前k个块作为查询的上下文。
为了生成结构化的自然语言答案,我们设计了一个单轮提示模板,具有清晰的格式和与问答任务相关的上下文,指示LLM扮演网络安全分析师的角色,回答有关交通相关网络事件的问题。为了在不超过模型输入限制的情况下最大限度地利用相关信息,该方法采用了令牌感知批处理(token-aware batching)。这种方法在聚合检索到的上下文段落时跟踪总令牌数,并在必要时将它们分成多个批次。这使得模型能够在不被截断的情况下推理更多内容。此外,生成温度(generation temperature)设置为零,以确保一致和可重复的输出。提示明确指示模型仅使用提供的上下文进行回应,而不明确引用它。为了鼓励忠实和注重细节的回答,指示中强调了包含日期、受影响地点和影响摘要。当多个上下文条目引用同一事件时(例如,重叠的实体和时间范围),要求模型将它们合并成一个统一的答案,同时直接利用描述进行最小程度的重新表述。回答被限制为专业的段落式摘要,不含引文、推测或来源提及。提示中提供了一个示例答案以锚定预期格式。这些组件共同创建了一个有效平衡准确性、一致性和上下文感知的系统,以提供关于交通领域不断演变的网络威胁态势的可靠答案。
评估
为了评估系统的可靠性和有效性,评估分两个阶段进行:数据库准备和问答。第一阶段的目的是确定LLM是否能准确提取和组织跨不同交通模式的结构化网络事件数据。为了测试这一点,使用固定随机种子从三个过滤后的数据集中,每个交通模式类别随机抽取了五个事件。第二阶段旨在评估LLM使用整理后的数据库为用户查询提供准确、相关和完整答案的能力。通过将语言模型生成的一组50个测试问题的回答与真实答案(ground-truth answers)进行比较,来评估问答系统。使用ROUGE-1、ROUGE-2、ROUGE-L、精确度(precision)、准确度(accuracy)和召回率(recall)作为评估指标。此外,还手动检查了问答响应,以评估LLM回答的事实准确性和完整性,这超出了自动指标所能捕获的范围。
过滤器评估
从CSIS、UMCED和EuRepoC三个数据集中各抽取了30个事件,每个交通模式类别五个。数据库准备LLM的性能总结在表2中。手动检查来自CSIS、UMCED和EuRepoC数据集的90个样本后,发现微调后的LLM能够以88.89%的准确率对事件的交通模式进行分类。虽然有八个样本被错误分类,但应注意其中六个事件是多式联运事件,LLM仅指出了事件中受影响的一种模式,而不是将事件分类为多式联运。这些事件仅是部分正确分类。82个事件被正确分类。两个完全错误的事件中,一个是影响海军空中武器计划(Naval Air Weapons Program)的事件。这是一个航空事件,但被分类为海事事件。另一个完全错误的事件涉及对国际海事培训师协会(International Marine Trainers’ Association)的攻击。该事件与交通无关,但被分类为海事事件。这些事件可能因为存在 consistently 与海事行业相关的词汇,如“Naval”和“Marine”,而被分类为与海事相关。值得注意的是,在15个被分类为与交通无关的事件中,零个事件被错误分类。在我们的样本中,没有发生交通相关事件被分类为与交通无关的情况。在抽样分类为交通相关并保留的75个事件中,98.67%(即74个事件)与交通相关。虽然这种方法成功地保留了交通事件以形成数据库和知识库,但值得注意的是,多个数据集报告了相同的事件,导致缺乏对交通中发生的单个事件的全面统计。我们并不声称已经捕获了所有曾经发生过的交通相关网络事件。
表 2 过滤方法性能
|
准确度 |
88.89% |
正确分类了90个抽样事件中的82个 |
|
错误标记 |
8个事件 |
6个错误分类的事件是多式联运事件,其中一种模式被正确分类;另外2个事件完全错误分类 |
|
正确标记 |
82个事件 |
跨模式的高分类率 |
|
错误空值抽样 |
0个事件 |
在15个抽样分类为与交通无关的事件中,零个事件被错误分类 |
|
部分正确标记 |
6个事件 |
多种模式中的一种被正确分类;多式联运分类需要改进 |
|
完全错误 |
2个事件 |
两个事件都被错误分类为影响海事,可能由于存在通常与海事领域相关的词汇 |
|
保留事件中与交通相关的百分比 |
98.67% |
在75个抽样分类为影响交通的事件中,74个与交通行业相关 |
问答评估
为了评估问答任务,从五个数据集中各选择了10个事件,并根据事件描述中包含的信息提出了一个问题。为了评估起见,这些测试问题仅限于封闭式问题。问题的真实答案(ground-truths)是通过合并所有数据集中每个报告事件的事件描述来构建的。如果一个事件出现在多个数据集中,则将其各自的描述合并成一个单一的参考答案。这些重复项是通过匹配相似的短语、日期和描述手动识别的。然而,这个手动过程可能导致一些相关条目在最终的真实答案中被忽略。图6显示了一个LLM对交通相关网络事件问题的响应示例及其真实答案。本研究使用ROUGE-1、ROUGE-2和ROUGE-L分数以及精确度、准确度和召回率来评估问答方法。

图 6 LLM对关于交通相关事件问题的问答响应示例,后跟该问题的真实答案
ROUGE (27) 是一种评估指标,它考虑生成文本和参考文本之间n-gram、词序列和词对的词汇重叠。一些变体包括ROUGE-1(一元组重叠)、ROUGE-2(二元组重叠)和ROUGE-L(最长公共子序列)。本研究我们使用ROUGE-1、2和L作为部分评估指标。图7、8和9显示了生成响应的ROUGE分数。平均ROUGE-1、ROUGE-2和ROUGE-L分数分别为0.54、0.33和0.50。这些结果表明,模型生成的答案捕获了相关内容的很大一部分(由ROUGE-1分数指示),并且通常遵循参考摘要的结构(由ROUGE-L分数指示)。较低的ROUGE-2分数表明在短语级别上的一致性较低。
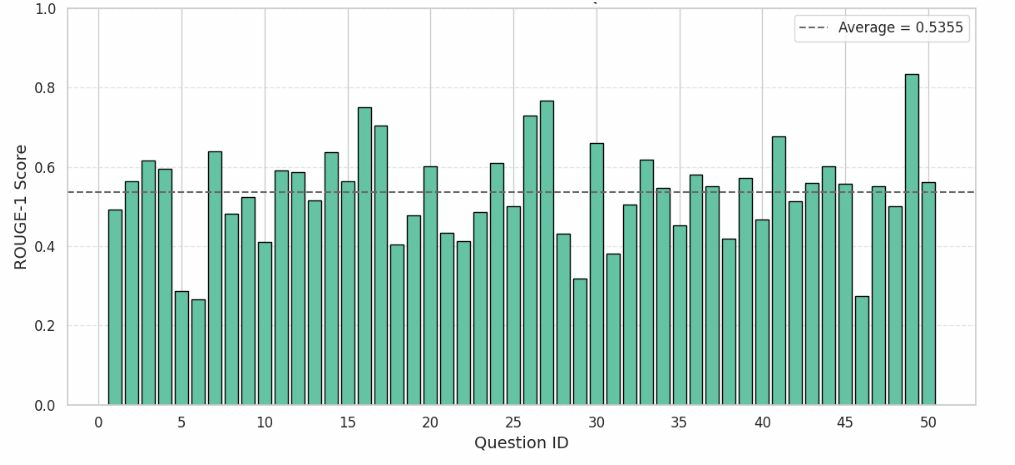
图 7 问答LLM的ROUGE-1分数

图 8 问答LLM的ROUGE-2分数
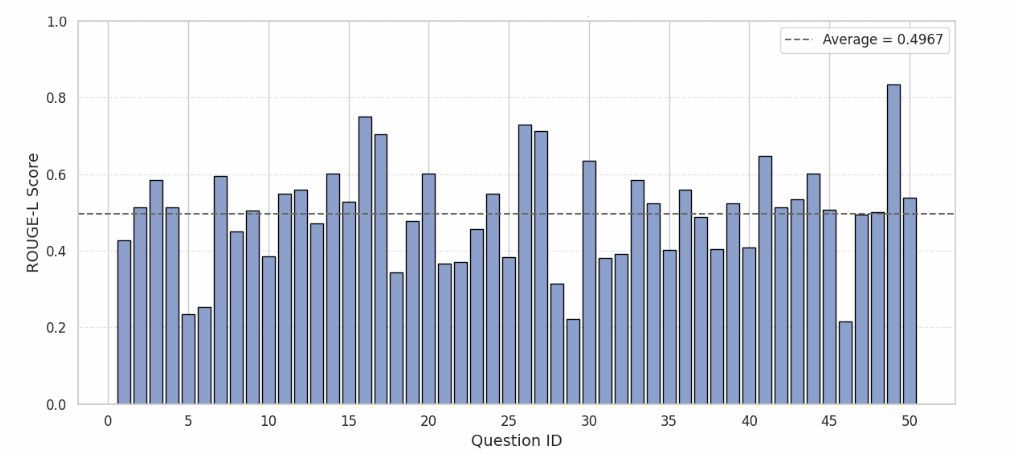
图 9 问答LLM的ROUGE-L分数
除了ROUGE,我们还使用令牌级别的精确度、召回率和准确度指标来评估生成答案的质量。图10、11和12显示了所有响应的精确度、召回率和准确度。这种方法评估系统响应中的令牌与参考答案中的令牌匹配的数量。“精确度”衡量生成响应中正确匹配参考答案中词汇的比例。“召回率”量化参考文本中的词汇在生成响应中被成功捕获的程度。“准确度”反映了重叠词汇相对于参考或生成响应中存在的总唯一词汇的比例。这些指标有助于不仅在重叠方面,而且在更细粒度上量化答案的正确性和完整性,这比单独使用ROUGE更精细。该模型实现了0.52的精确度、0.60的召回率和0.37的准确度。这些结果表明,系统成功检索了大部分相关内容(高召回率),但也包含了一些参考答案中不存在的额外令牌(中等精确度)。整体令牌级别的准确度为37%,反映了生成与参考文本完全匹配的挑战。这些结果表明,模型倾向于恢复关键事实,但可能会转述或分享参考文本中未包含的信息,导致与参考措辞有些分歧。表3总结了用于评估LLM性能的自动评估指标。
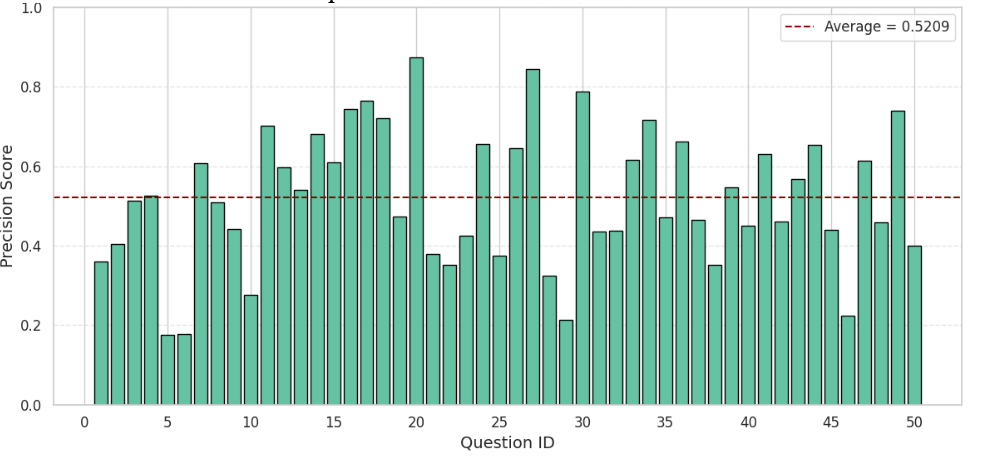
图 10 问答LLM的精确度
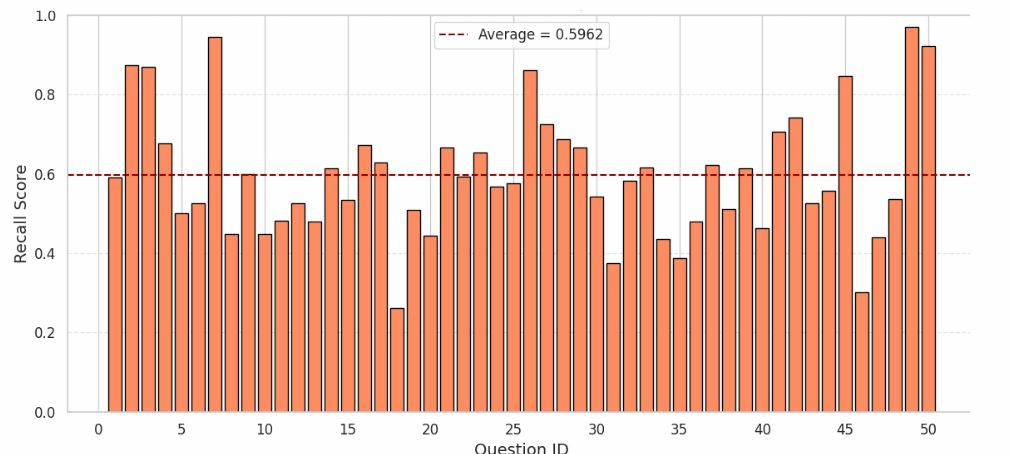
图 11 问答LLM的召回率
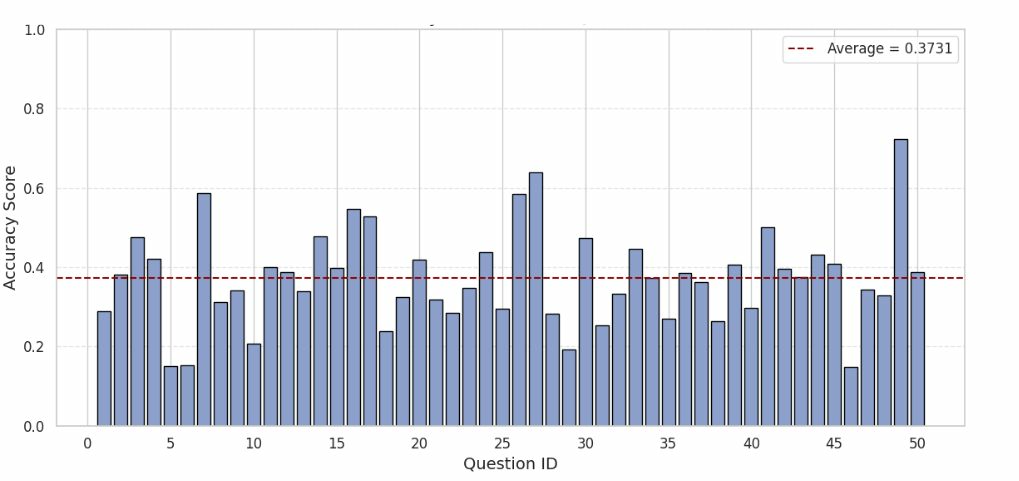
图 12 问答LLM的准确度
表 3 自动问答评估指标总结
|
平均 ROUGE-1 |
0.54 |
良好的一元组重叠;相关内容被捕获 |
|
平均 ROUGE-2 |
0.33 |
短语级别对齐度较低;存在一些结构偏移 |
|
平均 ROUGE-L |
0.50 |
强序列匹配;遵循参考结构 |
|
平均精确度 |
0.52 |
中等相关性;存在一些无关信息 |
|
平均召回率 |
0.60 |
高内容覆盖率;关键事实常被恢复 |
|
平均准确度 |
0.37 |
部分令牌匹配;因转述导致偏差 |
问答响应的手动检查
对问答系统的响应进行了手动检查,并与真实答案(ground-truth answers)进行比较,以评估其事实准确性和完整性。手动检查的结果总结在表4中。总体而言,LLM产生了信息丰富、连贯且基本准确的响应,始终超越简单地回答问题,提供了关于事件的额外相关细节。如前所述,本研究中的真实答案主要源自事件描述。LLM正确回答了50个问题中的49个。唯一错误的回答是针对问题“2022年白俄罗斯铁路网络攻击影响了哪些城市?”。尽管LLM准确地描述了更广泛的事件,但它表示“可用信息中未详细说明受此网络攻击影响的具体城市”,尽管数据集中存在此类细节。这反映了一个更广泛的趋势,即模型在识别位置时似乎严重依赖“受害者:国家”字段,偶尔忽略了“描述”字段中可用的更具体的地理信息。尽管如此,响应通常提供了简洁准确的事件摘要,同时回答了每个问题的核心。然而,在16个案例中,尽管真实答案中存在相关信息(如受影响城市、技术执行细节或额外受影响国家),但部分信息被遗漏。相反,在10个案例中,LLM产生了准确且信息丰富的响应,其中包含的信息在真实答案中并不存在,通常是利用了“攻击类型”等额外字段,或综合了来自多个相关条目的相关细节,这些细节可能在真实答案创建过程中被忽略。这些发现突显了模型在上下文理解和综合方面的优势,同时也揭示了在位置特异性和细节覆盖方面需要改进的领域。
表 4 RAG问答响应手动检查结果
|
正确回答的问题 |
49 |
强事实准确性;大多数答案与真实答案一致 |
|
错误回答的问题 |
1 |
遗漏了描述中提到的城市;事件其余部分被正确捕获 |
|
遗漏真实答案细节的响应 |
16 |
省略了细粒度信息(例如,城市、攻击细节、次要受影响国家、受害者名称) |
|
包含真实答案中未有的额外细节的响应 |
10 |
从其他条目组件或多个条目中添加了相关上下文;比真实答案更全面 |
结论
本文提出了一种新颖的、领域特定的方法,通过利用微调的GPT-3.5 Turbo模型、RAG和GPT-4o mini来增强交通行业的网络意识。该系统用于构建结构化的交通相关网络事件数据库,并回答有关过去交通相关事件的问题。在我们的评估中,LLM辅助的分类过程在90个事件中准确识别了82个事件的交通模式。它成功保留了75个相关事件中的74个,证明了模型在结构化数据过滤方面的有效性。观察到的准确性和保留率表明,该过滤器有效地区分了交通相关和非交通相关事件,支持了交通专用数据库的构建。问答组件实现了平均分数:ROUGE-1为0.54,ROUGE-2为0.33,ROUGE-L为0.50,精确度为0.52,召回率为0.60,准确度为0.37。这些数字表明,系统检索并生成的响应广泛反映了参考答案的核心信息,这体现在相对较高的召回率上。然而,中等的精确度和较低的令牌级准确度表明,答案可能包含额外的上下文或偏离预期的措辞。对问答系统的手动检查证实了其强大的事实准确性,50个问题中有49个被正确回答。LLM通过整合来自其他字段和数据集内多个条目的相关细节,持续超越了真实答案的响应,展示了其跨来源综合信息的能力。然而,在16个响应中,它遗漏了具体细节,如受影响城市、攻击执行方法或次要受影响国家,这可能是由于依赖更高级别的字段(如“受害者:国家”)而非更具描述性的叙述字段。这些发现既突显了模型在上下文理解方面的优势,也揭示了其在一致检索某些细粒度细节方面的局限性。
尽管该系统展现出前景,但必须承认几个局限性。对于分类流程,需要更清晰地理解假阴性(false negatives)。因为彻底验证每个数据集中所有事件的交通相关性需要对数千个条目进行人工审查,我们无法在抽样测试集之外最终确定过滤器的召回率。此外,模型在多式联运事件上表现最差,这可能是由于它们在训练数据中代表性不足,其中大多数条目仅涉及单一交通模式。另一个局限性源于不同数据集中事件描述的差异性。一些记录仅包含简要摘要,这限制了参考答案和模型生成简洁响应的能力。因此,LLM偶尔会产生比真实答案更长或更详尽的答案。尽管存在这些局限性,这项工作为开发实用的、基于LLM的交通领域网络安全意识工具迈出了重要一步。
未来工作
本研究在推进交通领域网络安全意识方面具有巨大潜力。已经确定了一些未来的方向,以增强和扩展现有框架,更好地实现这一目标,重点在于提高可访问性、纳入自动化和改进可用性。这项工作的动机源于最初尝试为TraCR数据集收集交通专用网络事件数据时遇到的挑战。这些改进旨在为研究人员、从业人员和政策制定者简化获取此类信息的过程。
鉴于总体目标是提升交通领域的网络安全意识,通过用户友好的在线界面公开提供该系统将大有裨益。该平台将为公共和私营交通部门的利益相关者提供更好的访问途径,获取与其领域相关的网络攻击信息。该网站可以包括一个可搜索和可过滤的交通相关网络攻击数据库,使用户能够按模式、地区或时间段探索事件。此外,可以整合一个交互式仪表板,显示关键统计数据和趋势,提供交通领域当前网络安全态势的高层次概览。这将使用户无需提交特定查询即可快速获得态势感知。
目前,系统使用的知识库是静态的,需要手动集成到基于检索增强生成的问答方法中。然而,由于新的网络事件频繁发生,维护最新的知识库至关重要。一个自然的扩展将涉及通过实施定期网络爬取来自动化此过程,爬取来源包括精选的网络事件数据库和安全新闻平台。收集的数据随后可以通过现有的过滤方法进行处理,仅保留与交通相关的事件。通过将过滤系统连接到问答模块,系统可以维护最新的知识库,并根据可用的最新信息提供响应,从而增强其在实时态势感知中的实用性。