本篇博客将为你深度拆解 2024 年发表于 IEEE Journal of Biomedical and Health Informatics (JBHI) 的重磅论文:MSTFNet
Title:Multiscale Spatial-Temporal Feature Fusion Neural Network for Motor Imagery BrainComputer Interfaces
中文名:用于运动想象脑机接口的多尺度时空特征融合神经网络
作者:Jing Jin*, Senior Member, IEEE, Weijie Chen, Ren Xu, Wei Liang, Xiao Wu, Xinjie He, Xingyu Wang, Andrzej Cichocki, Life Fellow, IEEE
期刊:2024 IEEE
网址:https://www.ieee.org/publications/rights/index.html
信息:DOI 10.1109/JBHI.2024.3472097
一、 引言:什么是运动想象脑机接口?
想象一下,你坐在轮椅上,只需在大脑中构思“向左转”或“向右转”,轮椅就能自动行驶;或者残疾人士只需通过思考,就能控制机械臂抓取水杯。这不是科幻电影,而是**脑机接口(BCI)**技术正在实现的场景 。
其中最重要的一类技术叫运动想象(Motor Imagery, MI) 。它的原理是:当你想象肢体运动(即使身体没动)时,大脑的相关区域会产生特定的电信号变化 。我们的任务,就是用人工智能模型把这些微弱的电信号“翻译”成机器能懂的指令 。
二、目前所面临的困难
运动想象是主要的脑机接口(BCI)范式之一,已广 泛应用于众多 BCI 应用中,例如残疾人与外部设备之间的交互。 精确解码是实现高效稳定交互的最重要方面之一,受到了大量的深入研究。然而现有技术有其较大的局限性:
为了解决这些问题,金晶教授团队提出了一种全新的模型——MSTFNet(多尺度时空特征融合神经网络),它利用的是多尺度卷积和高效的通道注意机制。
三、 MSTFNet 主要框架:四大模块协同作战
MSTFNet 的设计就像是一个精密的工厂,由四个专门的“车间”组成,负责从不同维度处理信号 。


1. 特征增强模块(FEM)(Feature Enhancement Module)
这是整个流程的起点,负责将原始的“粗糙”信号转化为神经网络更易处理的特征张量。就是简单的预处理作用主要步骤为:
 (样本数、通道数、时间点)。
这个模块不仅丰富了特征表达,还为后续的时间维度提取扫清了噪声障碍,确保后续模块处理的是“增强后”的信号 。
在 FEM 模块中,小空间卷积核通过以下公式捕获局部特征公式为 :

 是初步处理后的信号,这个公式就像是一个“滑动扫描仪”,在不同的电极通道(
 )之间移动。它将相邻电极的信号加权求和,从而识别出大脑特定区域的局部活动趋势 。
2. 多尺度时间特征提取模块(MTFE )(Multiscale Temporal Feature Extraction Module)
这一步是模型的灵魂,它将 FEM 输出的数据同时分流到四个并行的“加工车间”。主要用来捕捉不同尺度的高低频信号,步骤为:
 。这种并行结构确保了模型不会像单一卷积核那样“顾此失彼” 。
最后将这些信息合并,确保护模型既能看到“瞬时闪烁”,也能看到“长时起伏” 。
在 MTFE 模块中,四路不同宽度的“放大镜”扫描后,进行特征叠加 :

 代表四个不同尺度(5/25/45/65)提取出的特征。这个公式极其简单,但意义重大——它将“瞬时变化”和“长期趋势”直接堆叠在一起,确保后续层能同时看到这两个维度的信息 。
3. 空间特征提取模块(SFEM)(Spatial Feature Extraction Module)
-
全通道聚合:通过一个大小为
 的空间卷积核,一次性将所有电极通道(例如数据集 1 中的 22 个 EEG 通道)的信息进行深度融合 。
-
维度压缩:利用 (1, 4) 的最大池化层 过滤冗余信息,在保留关键空间特征的同时,降低数据的计算量 。
-
数据对接:它将时间模块产出的多维信息高度压缩,转化为具有强空间判别性的特征图,为最后的分类做准备 。
4. 特征融合模块(Feature Fusion Module)
这是流水线的最后一道工序,决定了模型最终的判断精度。
-
深度可分离卷积(DSCB):由于脑电信号通道多、数据量大,DSCB 在这里起到“瘦身”作用,极大地减少了参数量,同时增强通道特征集成 。
-
高效通道注意(ECAB):这是最关键的协同点。脑电信号中并非所有通道都对“左手想象”有用。ECAB 通过全局平均池化(GAP)感知全局,然后自动给重要的通道加权重,给无关的噪声通道降权重
-
端到端对接:经过重新校准的特征最后进入全连接层(FC)和 Softmax,将高度抽象的特征直接映射为对应的动作类别(左手、右手、脚或舌头) 。
亮点技术:
深度可分离卷积: 在保证效果的同时,大大减少了计算量,让模型更轻量
高效通道注意(ECA)模块: 这就像给模型装了自动对焦,它会自动识别哪些特征通道更重要,给它们分配更高的权重,而忽略无关的背景噪音 。
高效通道注意(ECA)权重公式:
在 FFM 模块中,为了决定哪些通道更重要,模型使用一维卷积自动计算权重,卷积核大小  由以下公式动态决定 :

 是通道数(这里设为 32)。这个公式能根据通道的总数,自动计算出一个最合适的“观察窗口”。窗口内的通道会互相“沟通”,强者(特征明显的通道)被赋予更高的权重,弱者被抑制,实现精准对焦 。

四、 模型的微调与训练
1. 信号的“去噪与精剪”(预处理)
为了让 MSTFNet 接触到最纯净的信号,设定为 1.5 。这不仅能平衡原始数据和增强数据之间的差异,还能防止模型由于“死记硬背”导致的泛化能力差 。研究人员进行了以下操作:
1.频段过滤:统一应用了 0.5-40Hz 的带通滤波 。这就像是一个筛子,过滤掉无用的低频漂移和高频电网噪声,保留运动想象最相关的波段(如  节律和
 节律)。
2.注入高斯噪声(数据增强): 既然数据不够,作者就在原始数据里加入适量的随机干扰(高斯噪声) 。这就像给模型进行“抗压训练”,让它在面对复杂环境时更稳健 。
3.重采样与截取:
A.数据集 1 & 2:从每次试验中截取 4秒 的片段进行分析 。
B.数据集 3:截取 3秒 的片段 。
4.陷波处理:针对实验室数据集(数据集 3),特别使用了 50Hz 陷波滤波器 来消除环境中的电线干扰 。


2. 让模型更准的“精密调教”(微调与训练)
MSTFNet 的卓越性能离不开这些关键的超参数设置:
-
优化器:采用了 Adam 优化器,并配合 余弦退火衰减策略 调制学习率(初始为 0.001) 。这种策略让模型在训练初期快速收敛,在后期则像“慢火炖肉”一样细致寻找最优解。
-
防过拟合系数:
-
R-Drop 系数 (
 ):设定为 0.5 。实验证明,若 过大(如 1.5),性能反而会恶化,因为过强的约束限制了模型的学习能力 。训练中的 R-Drop 正则化公式(双向 KL 散度)这是防止模型“死记硬背”的关键。训练时,同一数据跑两遍,计算两遍结果之间的差异 :
-
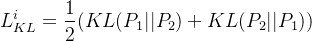
最终总损失函数为 :

 是判断对错的损失(分类准不准),
 是判断模型“稳不稳”的损失。模型不仅要猜对结果,还要保证在不同的 Dropout 状态下(相当于不同的思维路径)得出的结论高度一致,这样训练出来的模型才具有极强的泛化能力。


五、 实验结果:刷新纪录
MSTFNet 在多个国际公认的比赛数据集上表现惊人 :
1. EEGNet:小而美的全能选手
-
原理:这是 BCI 领域的标杆 。它引入了深度可分离卷积,用极少的参数量同时处理时间和空间特征。
-
缺点:虽然高效,但它忽略了不同通道间信息的交互,且只有单一的观察尺度 。
2. FBCSP(滤波器组公共空间模式):传统派大师
-
原理:它先将信号分成不同的频段,然后计算空间滤波器,让不同类别(如左手 vs 右手)的差异最大化 。
-
缺点:它是传统的机器学习方法,需要人工手动提取特征,且在面对复杂、非线性的脑电数据时显得力不从心 。
3. ATCNet:引入了“注意力机制”
- 原理:结合了时间卷积、滑动窗口和注意力机制 。
- 缺点:虽然性能很强,但 MSTFNet 通过多尺度(Multiscale)设计,能比它更全面地捕捉到不同时长的动作意图信号 。
MSTFNet分类准确率: 在 BCI Competition IV 2a 数据集上达到了 83.62%,显著优于传统的 EEGNet 等经典模型 。


- 通用性: 即使是以前没见过的新用户(留一主题实验),它也能达到 66.31% 的分类精度 。
- 传输速率: 它的信息传输率(ITR)在三个实验数据集中均排名第一,这意味着它能更快、更准地传达人类指令 。
- 模型复杂度
最后,为了衡量脑机接口系统的综合性能,论文使用了信息传输率(ITR) :

 是任务数,
 是准确率,
 是决策时间 。这个公式告诉我们:一个优秀的 BCI 系统,不仅要猜得准(大),还要反应快( 小) 。MSTFNet 在 ITR 上的优势,证明了它在实际应用场景中能比其他模型更高效地“输出”人类的意图 。


六、硬核分析——实验结果到底说明了什么?
论文通过三类实验全方位展示了 MSTFNet 的统治力。
1. 跨会话实验(Cross-session):模拟真实应用
这种实验用第一天的数据训练,测试第二天的效果。
- 结果:在数据集 1 上,MSTFNet 达到了 83.62% 的准确率,比 EEGNet 高出 13.4%,比传统的 FBCSP 高出 15.87% 。
- 分析:这说明 MSTFNet 能够克服脑电信号随时间变化的特性,具有很强的实用价值。
2. 留一法实验(Leave-one-subject-out):挑战是否能真正识别
用 8 个人的数据训练,去猜第 9 个完全陌生人的意图。就是用八个人的数据训练模型,然后用训练好的模型去测试第九个人的数据看看准确性。
- 结果:MSTFNet 实现了 66.31% 的分类准确率 。
- 分析:虽然准确率看似下降,但这在 BCI 领域是非常优秀的成绩 。它证明了模型学到了大脑运动想象的共性规律,而不仅仅是记住了某个人的特征。


3. 消融实验:证明所有的模型都是做出贡献的
研究人员逐一拆掉模型的组件进行测试 :
- 去掉数据增强 (DA):准确率在三个数据集中分别下降了 1.8%~2.59% 。
- 去掉特征增强模块 (FEM):下降了 1.29%~2.25% 。
- 去掉通道注意模块 (ECAB):下降了 1.22%~2.02% 。
结论:这证明了每一个精心设计的“车间”都在为最终的高精度分类做贡献 。


七、深度解析——特征的可视化表现
如果你看 t-SNE 可视化图,你会发现: 在其他模型中,不同意图(如左手、右手、脚、舌头)的特征点像一团乱麻纠缠在一起 ;而在 MSTFNet 经过处理后,同类别的点紧紧抱团,不同类别的点界限分明 。这直观地解释了为什么 MSTFNet 猜得更准——因为它把模糊的信号变成了清晰的特征群。


八、 未来面临的未解决问题
尽管 MSTFNet 取得了显著成就,但要真正让脑机接口像手机一样普及,还面临以下挑战:
个体差异巨大: 不同人的大脑结构和思考方式差异很大,目前的模型在跨受试者应用时性能仍有下降空间 。
更精细的频率识别: 目前主要关注空间和时间,未来需要更精细地分析不同频段(如 Alpha 波、Beta 波)之间的微妙关系 。
模型轻量化: 虽然 MSTFNet 已经比较高效,但要集成到可穿戴设备中,仍需要进一步压缩模型体积,同时不损失精度 。
总结
MSTFNet 通过多尺度观察和智能特征融合,成功为运动想象识别提供了一套更强、更稳的方案 。随着技术的不断迭代,也许不久的将来,我们真的能实现“所思即所得”!