如何高效部署Qwen3-VL-4B-Instruct?用Qwen3-VL-WEBUI镜像秒启动
1. 背景与痛点:视觉语言模型部署为何如此复杂?
在当前多模态AI快速发展的背景下,Qwen系列作为阿里开源的代表性视觉语言模型(Vision-Language Model, VLM),凭借其强大的图文理解、空间感知和代理能力,正被广泛应用于智能客服、自动化测试、内容生成等场景。
然而,尽管模型能力强大,传统部署方式却存在诸多痛点:
- 环境依赖复杂:PyTorch版本、CUDA驱动、transformers库等需精确匹配
- 安装步骤繁琐:从代码克隆、依赖安装到模型下载,每一步都可能出错
- 配置调试耗时:Web UI端口设置、显存优化、设备映射等问题频发
- 新手门槛高:非专业开发者难以独立完成全流程部署
以 Qwen2-VL-7B-Instruct 的手动部署为例,用户需要依次执行:
git clone https://github.com/QwenLM/Qwen2-VL
pip install qwen-vl-utils[decord] transformers accelerate modelscope
再通过ModelScope SDK下载模型,并手动调整路径与端口——整个过程平均耗时超过30分钟,且极易因版本不兼容导致失败。
2. 解决方案:Qwen3-VL-WEBUI 镜像一键部署
为解决上述问题,Qwen3-VL-WEBUI 镜像应运而生。该镜像是由阿里官方支持、社区优化的预置环境镜像,内置以下核心组件:
| 模型名称 | Qwen3-VL-4B-Instruct |
| 框架基础 | PyTorch 2.3.0 + CUDA 12.1 |
| 多模态处理 | qwen-vl-utils[decord], transformers>=4.37 |
| 推理加速 | 支持 Flash Attention 2 |
| Web交互界面 | 自带 web_demo_mm.py 可视化UI |
| 环境管理 | Conda虚拟环境预配置 |
✅ 一句话总结优势:只需一次点击,即可在AutoDL等平台实现“镜像拉取 → 自动启动 → 浏览器访问”的全链路秒级部署。
2.1 Qwen3-VL 核心能力升级概览
相比前代模型,Qwen3-VL-4B-Instruct 在多个维度实现显著增强:
| 视觉代理能力 | 可识别PC/移动端GUI元素,调用工具完成任务(如点击按钮、填写表单) |
| 视觉编码输出 | 支持从图像生成 Draw.io 架构图、HTML/CSS/JS 前端代码 |
| 空间感知 | 精准判断物体位置、遮挡关系,支持2D→3D推理 |
| 上下文长度 | 原生支持256K tokens,可扩展至1M,适用于长文档与数小时视频分析 |
| OCR能力 | 支持32种语言,低光、模糊、倾斜条件下仍保持高精度 |
| 多模态推理 | 在STEM/数学题中表现优异,具备因果分析与逻辑推导能力 |
| 文本融合 | 实现与纯LLM相当的文本理解质量,图文信息无缝融合 |
这些能力使得 Qwen3-VL 不仅能“看懂图片”,更能“理解场景”并“采取行动”。
3. 快速部署实战:三步启动 Qwen3-VL-4B-Instruct
本节将基于 AutoDL 平台演示如何使用 Qwen3-VL-WEBUI 镜像完成极速部署。
3.1 第一步:选择并部署镜像
💡 硬件建议: – 显存 ≥ 24GB(推荐4090/A100/L40S) – 存储空间 ≥ 100GB(含模型缓存)
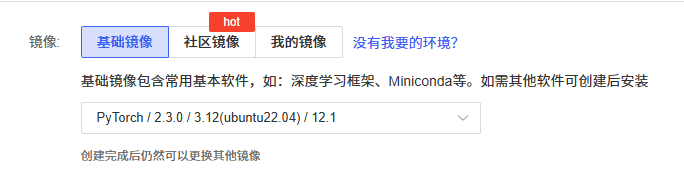
系统将在约2分钟内自动完成以下操作: – 拉取镜像 – 加载 Qwen3-VL-4B-Instruct 模型权重 – 启动Web服务进程 – 开放指定端口
无需任何命令行操作!
3.2 第二步:等待自动初始化完成
部署成功后,系统会自动执行初始化脚本,包括:
# 内部自动执行流程(无需手动输入)
conda activate qwen3vl
cd /workspace/Qwen3-VL
python -m pip install qwen-vl-utils[decord] transformers accelerate –upgrade
python web_demo_mm.py –server-port=6006 –device-map="auto"
你可以在控制台日志中看到如下输出:
INFO: Uvicorn running on http://0.0.0.0:6006 (Press CTRL+C to quit)
INFO: Started reloader process [12345] using statreload
INFO: Started server process [12347]
INFO: Waiting for application startup.
INFO: Application startup complete.
这意味着服务已就绪。
3.3 第三步:通过网页直接访问推理界面
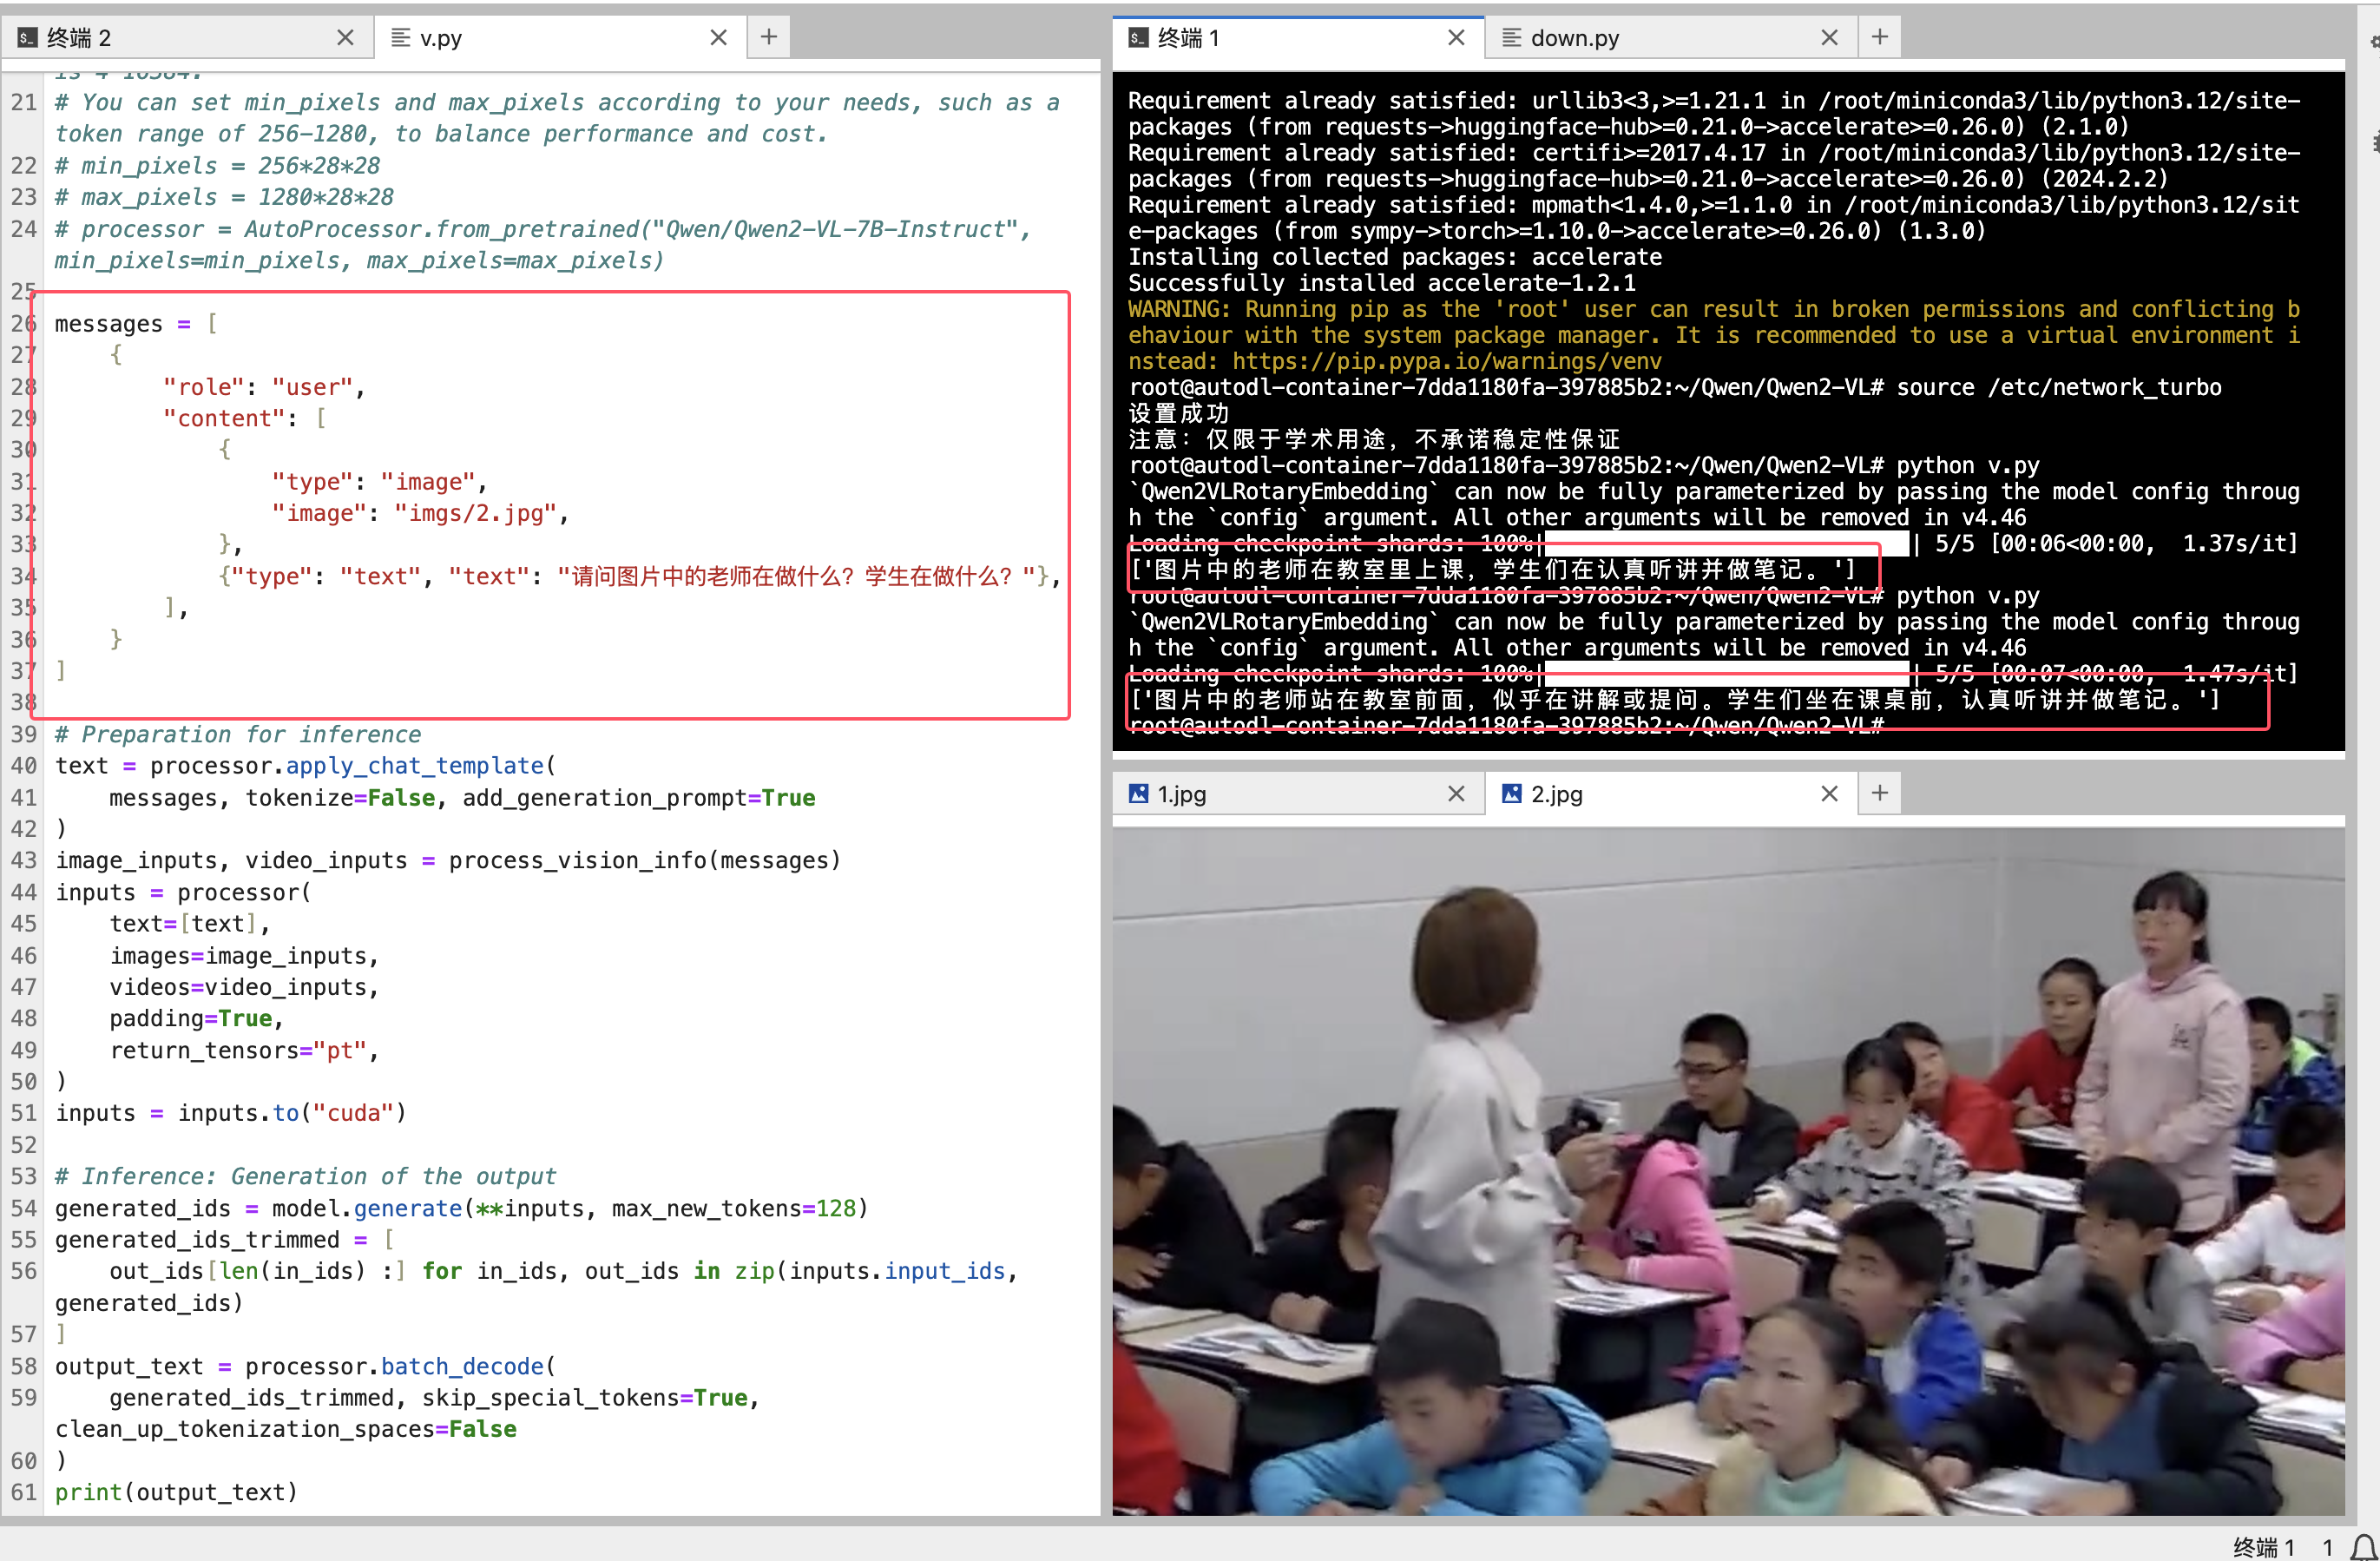
进入页面后,你可以: – 上传本地图片或输入网络URL – 输入自然语言指令(如“描述这张图”、“提取表格数据”) – 查看模型实时生成的回答 – 支持连续对话与历史记录回溯
4. 进阶配置:自定义模型参数与性能优化
虽然镜像开箱即用,但针对特定需求,仍可进行精细化调整。
4.1 修改Web UI端口与主机绑定
若默认端口冲突,可在启动时修改:
# 示例:改为监听 7860 端口
python web_demo_mm.py –server-port=7860 –server-name=0.0.0.0
也可编辑 web_demo_mm.py 文件中的参数:
parser.add_argument('–server-port', type=int, default=6006, help='Demo server port.')
将其改为所需端口号并保存。
4.2 调整视觉Token范围以平衡性能与成本
Qwen3-VL 支持动态视觉token分配。可通过 min_pixels 和 max_pixels 控制分辨率范围:
from transformers import AutoProcessor
# 设置最小256×256,最大1280×1280的输入尺寸
min_pixels = 256 * 28 * 28
max_pixels = 1280 * 28 * 28
processor = AutoProcessor.from_pretrained(
"Qwen/Qwen3-VL-4B-Instruct",
min_pixels=min_pixels,
max_pixels=max_pixels
)
⚠️ 注意:过高分辨率会显著增加显存占用和推理延迟。
4.3 启用Flash Attention 2 加速推理
对于支持的GPU(如A100/4090),启用Flash Attention可提升速度30%以上:
model = Qwen2VLForConditionalGeneration.from_pretrained(
"Qwen/Qwen3-VL-4B-Instruct",
torch_dtype=torch.bfloat16,
attn_implementation="flash_attention_2",
device_map="auto"
)
确保已安装支持包:
pip install flash-attn –no-build-isolation
5. 对比分析:镜像部署 vs 手动部署
| 部署时间 | ≤ 3分钟 | ≥ 30分钟 |
| 技术门槛 | 零代码基础也可操作 | 需熟悉Linux/Python环境 |
| 环境一致性 | 完全一致,避免版本冲突 | 易出现CUDA/Torch不兼容 |
| 可靠性 | 高(经社区验证) | 中(依赖个人经验) |
| 可定制性 | 中(可通过挂载目录修改) | 高(完全自由控制) |
| 适用人群 | 初学者、产品经理、快速验证者 | 研发工程师、算法调优人员 |
📊 选型建议: – 若目标是快速体验、产品原型验证、教学演示 → 优先使用镜像 – 若需深度定制、微调训练、集成到生产系统 → 推荐手动部署
6. 总结
本文详细介绍了如何利用 Qwen3-VL-WEBUI 镜像实现 Qwen3-VL-4B-Instruct 模型的极简部署。
我们重点覆盖了:
得益于 Qwen3-VL 在视觉代理、OCR增强、长上下文理解等方面的全面升级,结合 Qwen3-VL-WEBUI 镜像的便捷性,开发者现在可以前所未有地高效构建多模态AI应用。
无论是用于智能文档解析、自动化测试脚本生成,还是教育辅助工具开发,这套组合都能极大缩短MVP(最小可行产品)的开发周期。
💡 获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。