🚀 开发者狂喜!Gemini 3.1 Flash-Lite今日上线:高并发场景下,我实测后直接把竞品API全换了!
大家好,我是Maynor。就在刚刚(2026年3月3日),谷歌DeepMind正式放出Gemini 3.1 Flash-Lite预览版!
这不是又一个“参数吹”的模型,而是专为高并发、低延迟、大规模调用量身打造的“性价比之王”。我昨天抢先在Google AI Studio里刷了整整一晚上,做了5个真实开发者场景实测……结果让我当场决定:明天就把公司所有高频接口从2.5 Flash和Claude Haiku全切到它!
想知道它到底有多香?快跟我一起看这篇干货满满的实测报告!
一、先说结论:为什么开发者必须立刻关注它?
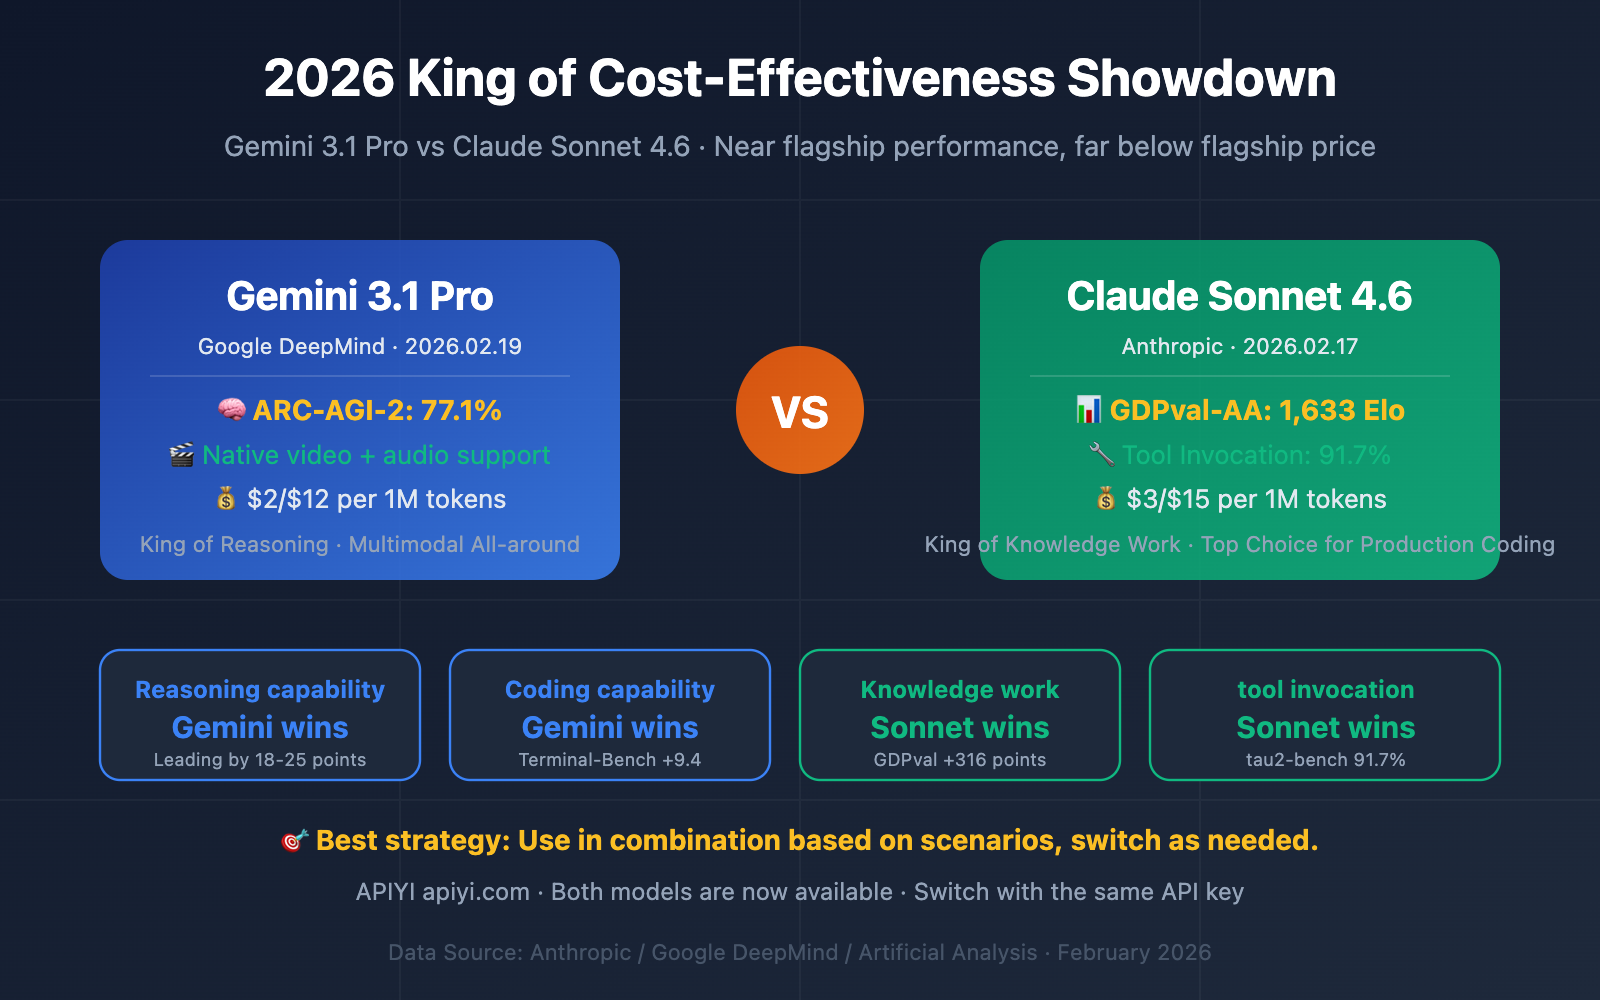
Gemini 3系列目前形成了完美梯队:
- 3.1 Pro → 复杂推理王者(2月19日已上线)
- 3.1 Flash-Lite → 高并发性价比之王(今天刚发!)
官方数据直击痛点:
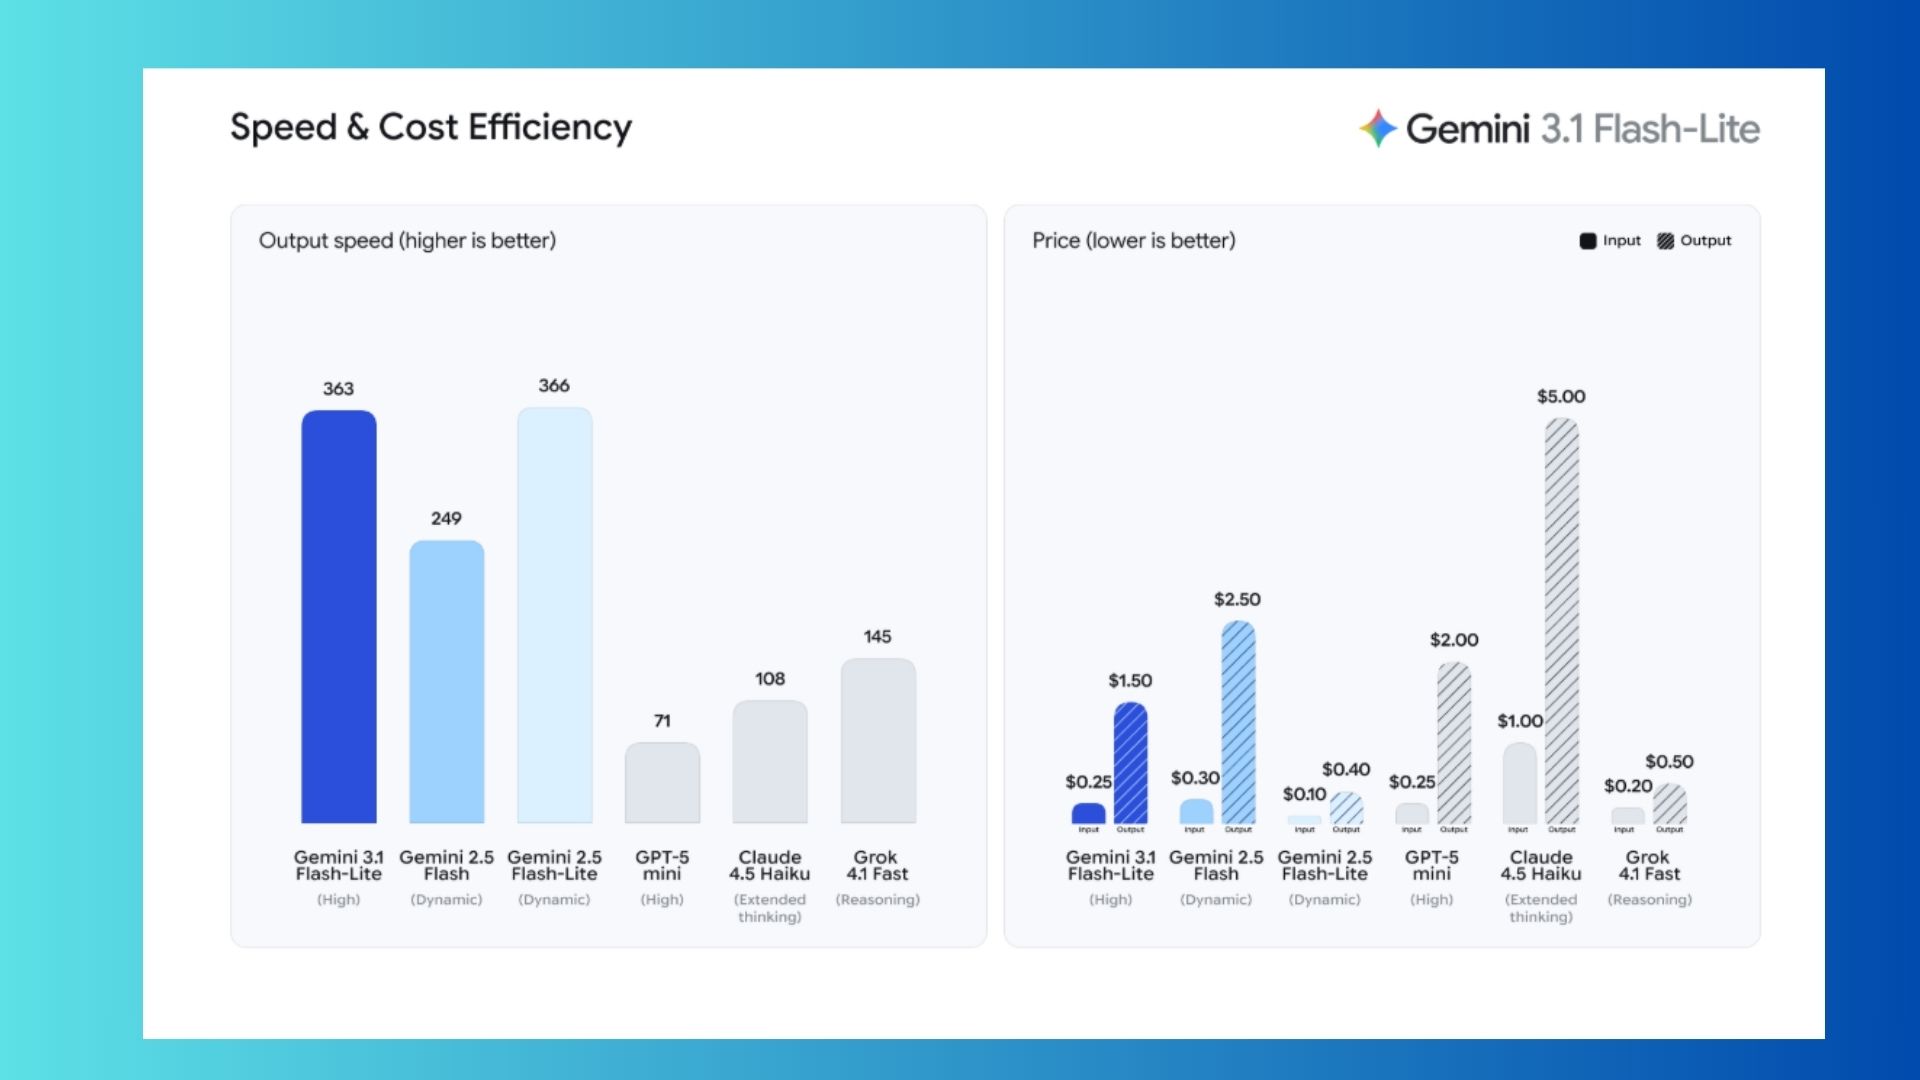
- 输出速度:363 tokens/秒(比Gemini 2.5 Flash快46%)
- 价格:输入**$0.25**/百万tokens,输出**$1.50**/百万tokens(比很多竞品便宜30%-70%)
- 上下文:1M tokens原生支持
- 多模态:文本+图片+音频+视频+PDF全能
简单粗暴一句话:以前高并发场景要么用便宜但弱的模型,要么用强但贵的模型;现在Gemini 3.1 Flash-Lite把“又快又强又便宜”三个字一次性安排明白了!
二、5个真实场景实测:我都干了啥?
三、和竞品硬刚对比:它赢在哪?
| 输出速度 | 363 t/s | 249 t/s | 108 t/s | 71 t/s |
| 输入价格 | $0.25 | $0.30 | $1.00 | $0.25 |
| 输出价格 | $1.50 | $2.50 | $5.00 | $2.00 |
| GPQA Diamond | 86.9% | 82.8% | 73.0% | 82.3% |
| 高并发稳定性 | 极强 | 中等 | 一般 | 一般 |
真实结论:在高并发场景下,综合性价比它直接把其他模型打成弟弟!
四、普通开发者/中小企业怎么立刻用上?
温馨提醒:Gemini 3 Pro Preview 3月9日就要下线了,赶紧迁移到3.1系列吧!
写在最后:AI已经进入“谁用得起谁就赢”的时代
2026年的今天,AI不再是拼参数,而是拼真实落地成本和速度。 Gemini 3.1 Flash-Lite的出现,让中小企业、独立开发者也能用得起“谷歌级”智能。
你已经在用哪个模型做高并发了? 准备切换到Flash-Lite吗?欢迎评论区交流你的实测数据~
点赞+转发+收藏,下期我继续分享更多Gemini 3.1系列落地干货! (数据来源:Google DeepMind官方模型卡、AI Studio实测、Artificial Analysis 2026.3最新基准)
AI降本增效,你准备好了吗? 🔥