1、什么是 java 序列化,如何实现 java 序列化 难度系数:⭐
2、Http 常见的状态码 难度系数:⭐
3、GET 和POST 的区别 难度系数:⭐
4、Cookie 和Session 的区别 难度系数:⭐
无论客户端做怎样的设置,session 都能够正常工作。当客户端禁用 cookie 时将无法使用 cookie
在存储的数据量方面:session 能够存储任意的java 对象,cookie 只能存储 String 类 型的对象
第二章-Java高级篇
1、HashMap底层源码 难度系数:⭐⭐⭐
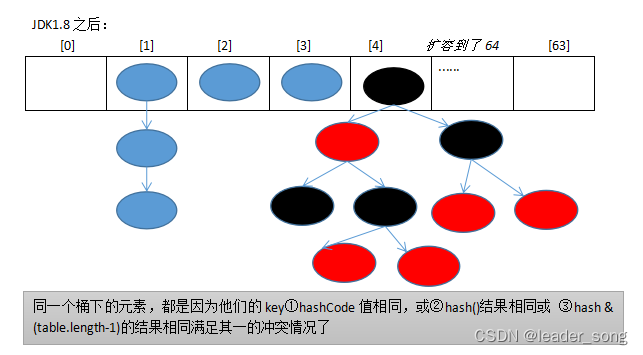
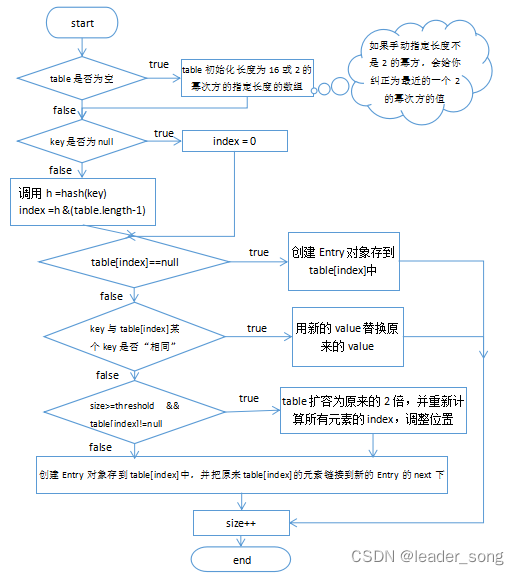
HashMap的底层结构在jdk1.7中由数组+链表实现,在jdk1.8中由数组+链表+红黑树实现,以数组+链表的结构为例。
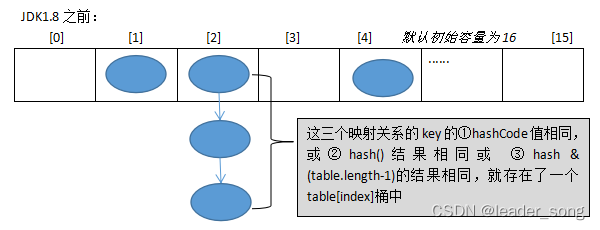
JDK1.8之前Put方法:
篇幅限制下面就只能给大家展示小册部分内容了。整理了一份核心面试笔记包括了:Java面试、Spring、JVM、MyBatis、Redis、MySQL、并发编程、微服务、Linux、Springboot、SpringCloud、MQ、Kafc
需要全套面试笔记及答案【点击此处即可/免费获取】 https://docs.qq.com/doc/DQXdYWE9LZ2ZHZ1ho
JDK1.8之后Put方法:
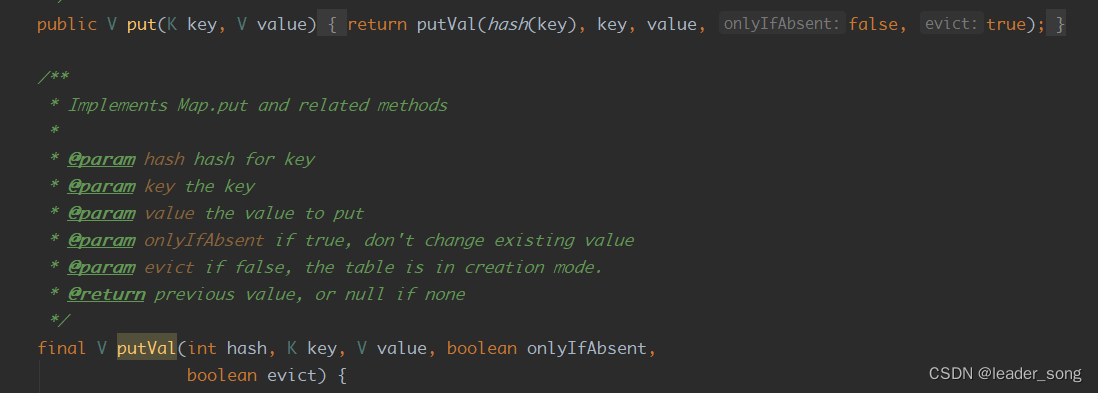
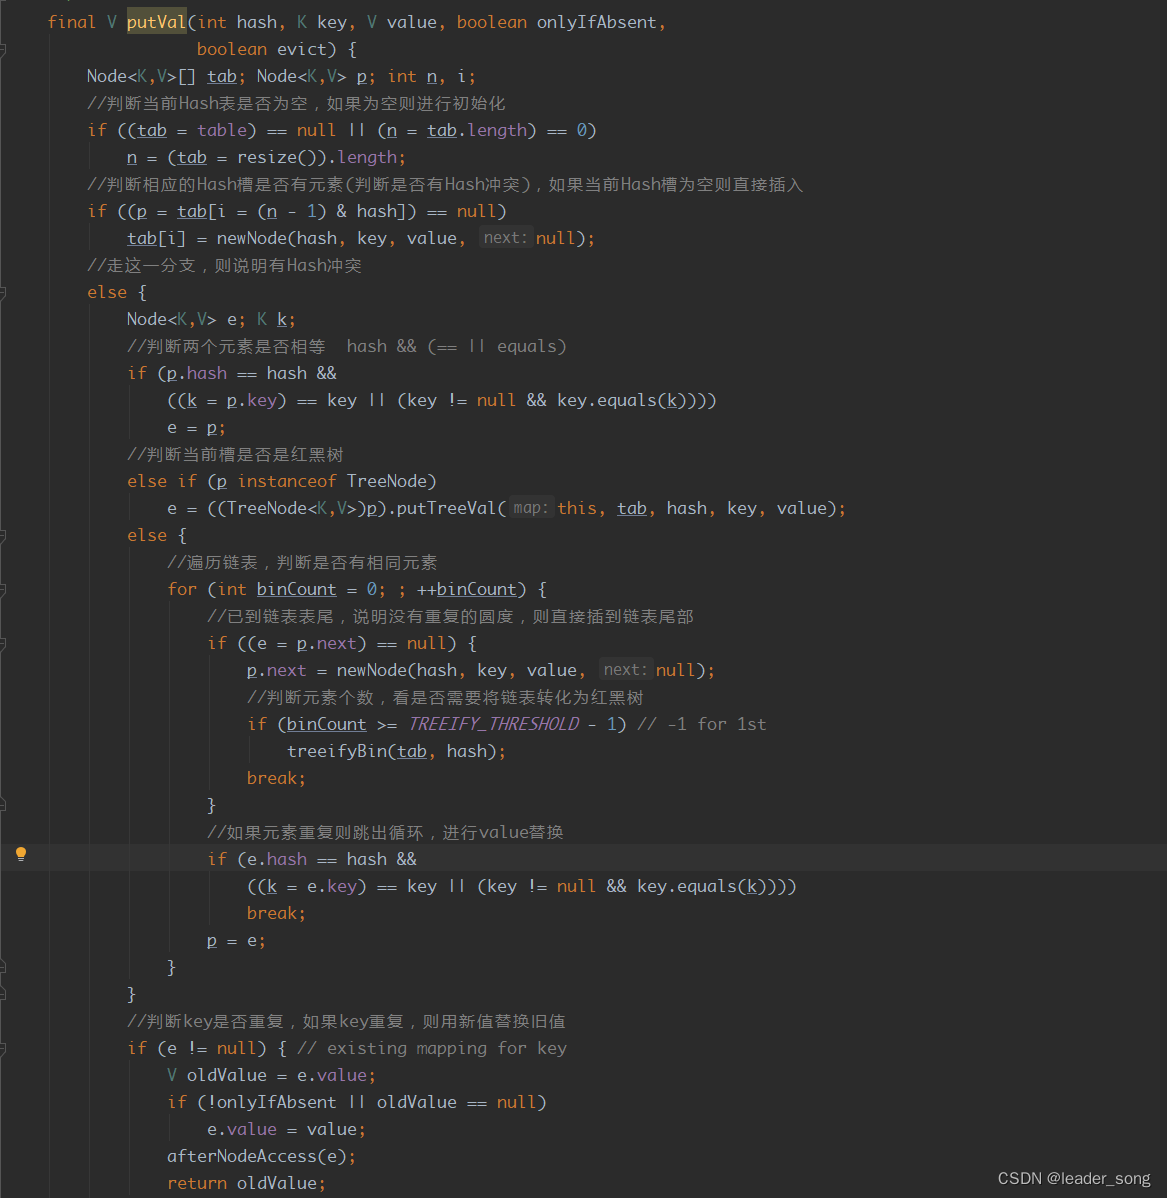
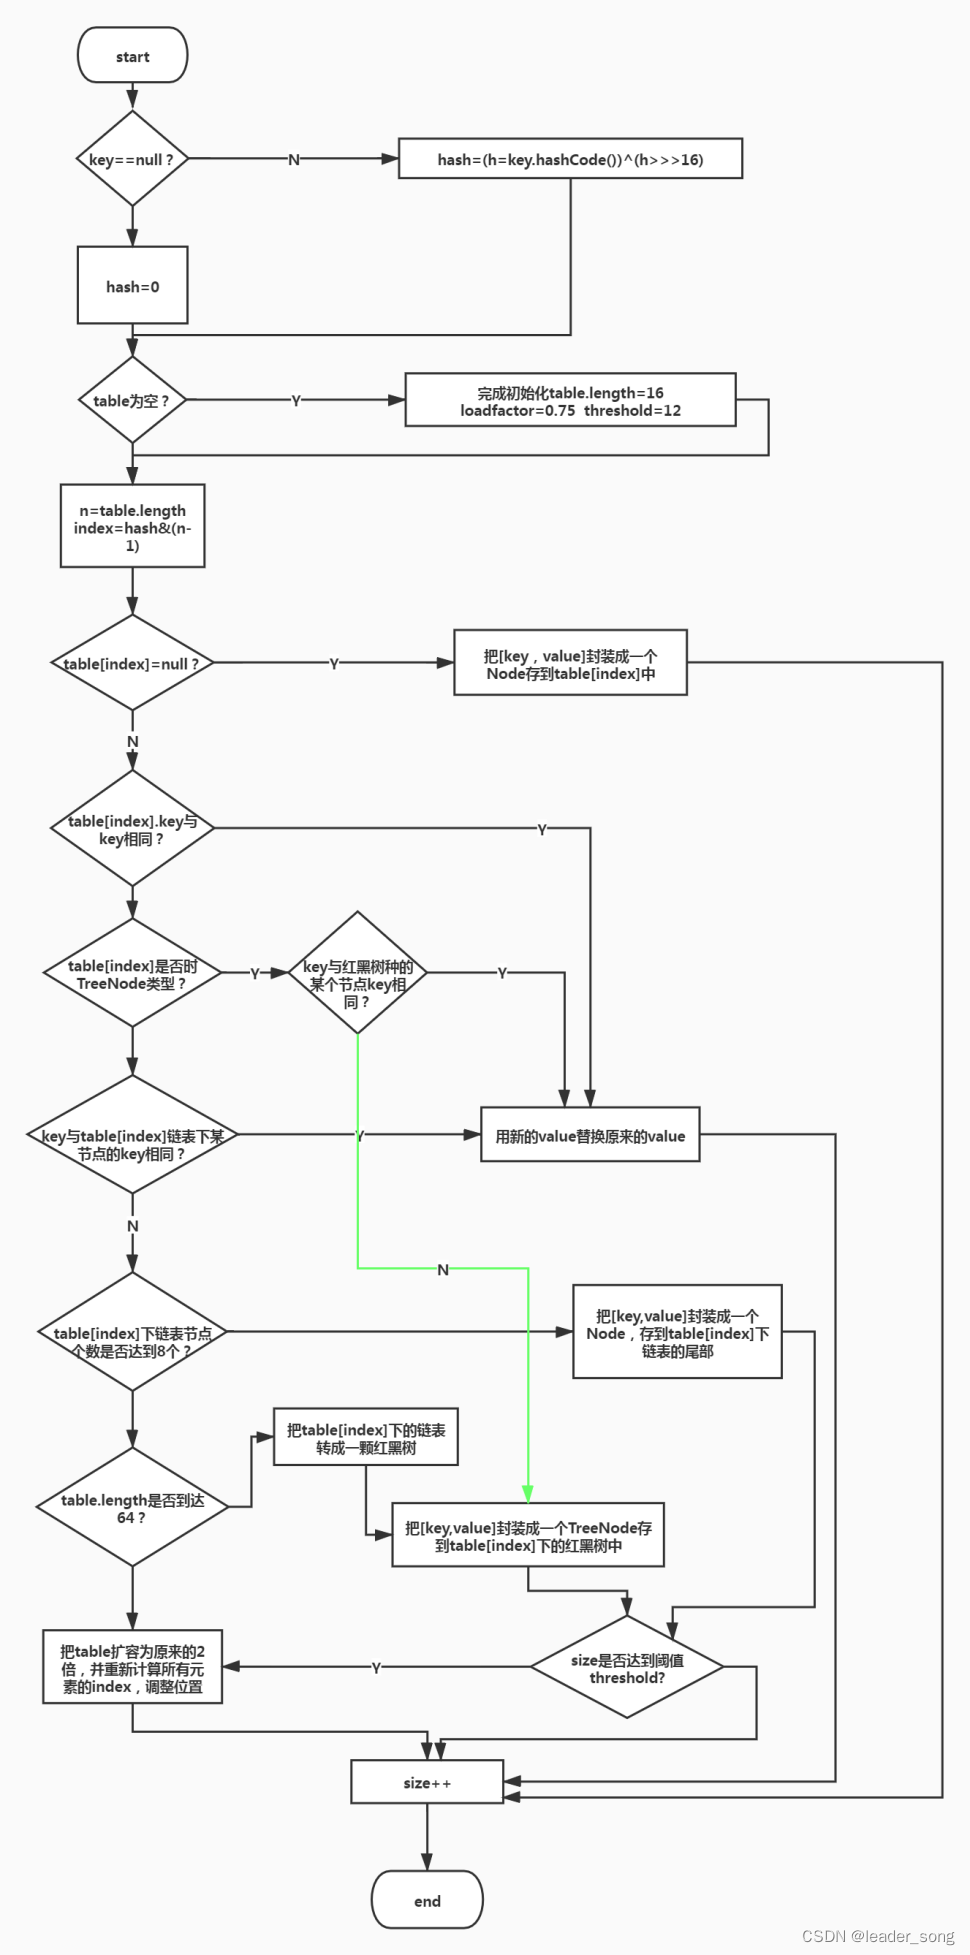
HashMap基于哈希表的Map接口实现,是以key-value存储形式存在,即主要用来存放键值对。HashMap 的实现不是同步的,这意味着它不是线程安全的。它的key、value都可以为null。此外,HashMap中的映射不是有序的。
JDK1.8 之前 HashMap 由 数组+链表 组成的,数组是 HashMap 的主体,链表则是主要为了解决哈希冲突(两个对象调用的hashCode方法计算的哈希码值一致导致计算的数组索引值相同)而存在的(“拉链法”解决冲突).JDK1.8 以后在解决哈希冲突时有了较大的变化,当链表长度大于阈值(或者红黑树的边界值,默认为 8)并且当前数组的长度大于64时,此时此索引位置上的所有数据改为使用红黑树存储。
补充:将链表转换成红黑树前会判断,即使阈值大于8,但是数组长度小于64,此时并不会将链表变为红黑树。而是选择进行数组扩容。
这样做的目的是因为数组比较小,尽量避开红黑树结构,这种情况下变为红黑树结构,反而会降低效率,因为红黑树需要进行左旋,右旋,变色这些操作来保持平衡 。同时数组长度小于64时,搜索时间相对要快些。所以综上所述为了提高性能和减少搜索时间,底层在阈值大于8并且数组长度大于64时,链表才转换为红黑树。具体可以参考 treeifyBin方法。
当然虽然增了红黑树作为底层数据结构,结构变得复杂了,但是阈值大于8并且数组长度大于64时,链表转换为红黑树时,效率也变的更高效。
2、JVM内存分哪几个区,每个区的作用是什么 难度系数:⭐⭐
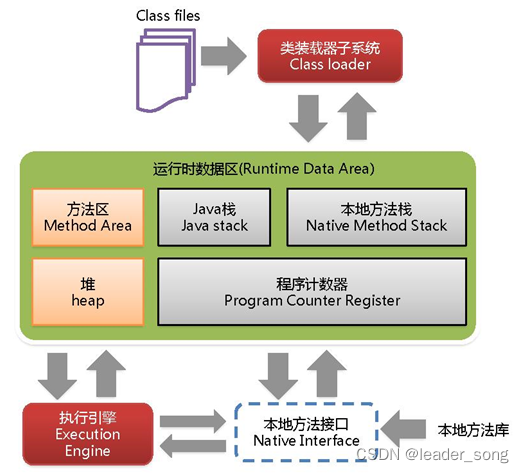
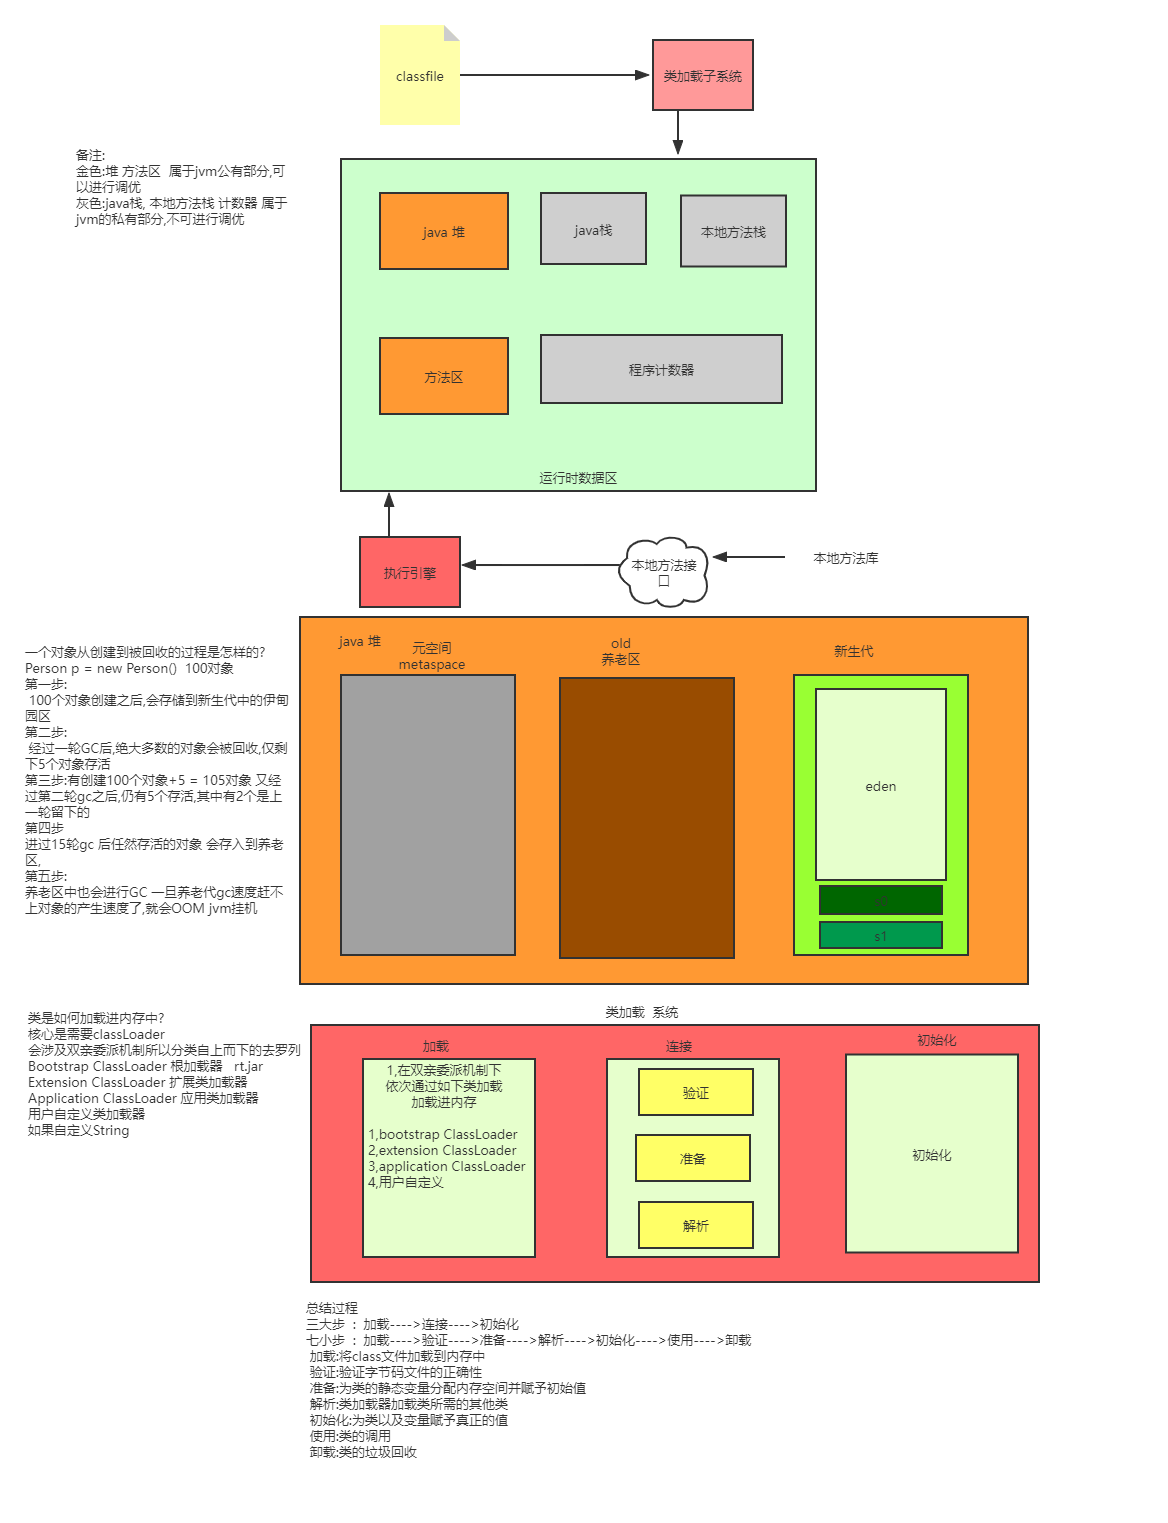
java虚拟机 主要分为以下几个区
本地方法栈和虚拟机栈类似,只不过本地方法栈为Native方法服务。
java堆是所有线程所共享的一块内存,在虚拟机启动时创建,几乎所有的对象实例都在这里创建,因此该区域经常发生垃圾回收操作。
内存空间小,字节码解释器工作时通过改变这个计数值可以选取下一条需要执行的字节码指令,分支、循环、跳转、异常处理和线程恢复等功能都需要依赖这个计数器完成。该内存区域是唯一一个java虚拟机规范没有规定任何OOM情况的区域。
JEP 122: Remove the Permanent Generation 介绍 静态变量、字符串常量从永久代移动到堆中
3、Java中垃圾收集的方法有哪些 难度系数:⭐
采用分区分代回收思想:
a) 效率高,缺点:需要内存容量大,比较耗内存
b) 使用在占空间比较小、刷新次数多的新生区
a) 效率比较低,会差生碎片。
a) 效率低速度慢,需要移动对象,但不会产生碎片。
4、如何判断一个对象是否存活(或者GC对象的判定方法) 难度系数:⭐
所谓引用计数法就是给每一个对象设置一个引用计数器,每当有一个地方引用这个对象时,就将计数器加一,引用失效时,计数器就减一。当一个对象的引用计数器为零时,说明此对象没有被引用,也就是“死对象”,将会被垃圾回收.
引用计数法有一个缺陷就是无法解决循环引用问题,也就是说当对象A引用对象B,对象B又引用者对象A,那么此时A,B对象的引用计数器都不为零,也就造成无法完成垃圾回收,所以主流的虚拟机都没有采用这种算法。
- 该算法的基本思路就是通过一些被称为引用链(GC Roots)的对象作为起点,从这些节点开始向下搜索,搜索走过的路径被称为(Reference Chain),当一个对象到GC Roots没有任何引用链相连时(即从GC Roots节点到该节点不可达),则证明该对象是不可用的。
- 在java中可以作为GC Roots的对象有以下几种:虚拟机栈中引用的对象、方法区类静态属性引用的对象、方法区常量池引用的对象、本地方法栈JNI引用的对象。
5、什么情况下会产生StackOverflowError(栈溢出)和OutOfMemoryError(堆溢出)怎么排查 难度系数:⭐⭐
- 无限递归循环调用(最常见)
- 执行了大量方法,导致线程栈空间耗尽
- 方法内声明了海量的局部变量
- native 代码有栈上分配的逻辑,并且要求的内存还不小,比如 java.net.SocketInputStream.read0 会在栈上要求分配一个 64KB 的缓存(64位 Linux)。
- 内存中加载的数据量过于庞大,如一次从数据库取出过多数据
- 集合类中有对对象的引用,使用完后未清空,使得JVM不能回收
- 代码中存在死循环或循环产生过多重复的对象实体
- 启动参数内存值设定的过小
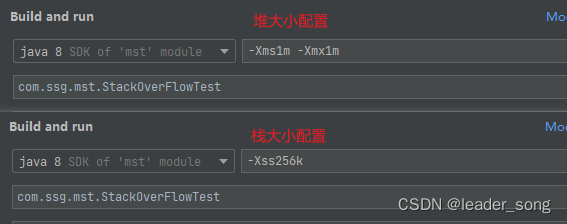
public class StackOverFlowTest { private static int count = 1; public static void main(String[] args) { //模拟栈溢出 //getDieCircle(); //模拟堆溢出 getOutOfMem(); } public static void getDieCircle(){ System.out.println(count++); getDieCircle(); } public static void getOutOfMem(){ while (true) { Object o = new Object(); System.out.println(o); } } }
Java
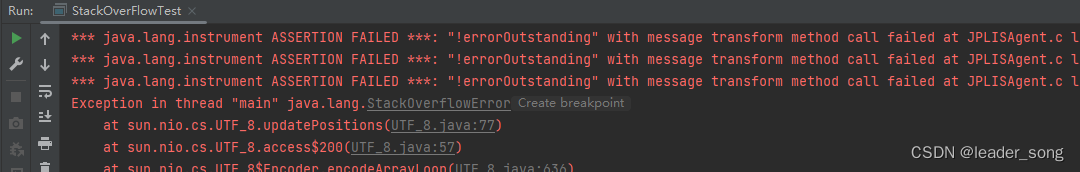
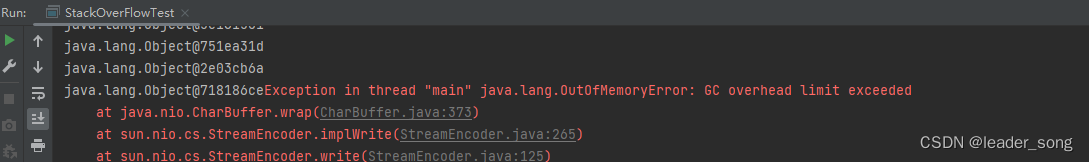
篇幅限制下面就只能给大家展示小册部分内容了。整理了一份核心面试笔记包括了:Java面试、Spring、JVM、MyBatis、Redis、MySQL、并发编程、微服务、Linux、Springboot、SpringCloud、MQ、Kafc
需要全套面试笔记及答案【点击此处即可/免费获取】https://docs.qq.com/doc/DQXdYWE9LZ2ZHZ1ho
6、什么是线程池,线程池有哪些(创建) 难度系数:⭐
线程池就是事先将多个线程对象放到一个容器中,当使用的时候就不用 new 线程而是直接去池中拿线程即可,节省了开辟子线程的时间,提高的代码执行效率
在 JDK 的 java.util.concurrent.Executors 中提供了生成多种线程池的静态方法。
ExecutorService newCachedThreadPool = Executors.newCachedThreadPool();
ExecutorService newFixedThreadPool = Executors.newFixedThreadPool(4);
ScheduledExecutorService newScheduledThreadPool = Executors.newScheduledThreadPool(4);
ExecutorService newSingleThreadExecutor = Executors.newSingleThreadExecutor();
然后调用他们的 execute 方法即可。
这4种线程池底层 全部是ThreadPoolExecutor对象的实现,阿里规范手册中规定线程池采用ThreadPoolExecutor自定义的,实际开发也是。
创建一个可缓存线程池,如果线程池长度超过处理需要,可灵活回收空闲线程,若无可回收,则新建线程。这种类型的线程池特点是:
工作线程的创建数量几乎没有限制(其实也有限制的,数目为Interger. MAX_VALUE), 这样可灵活的往线程池中添加线程。
如果长时间没有往线程池中提交任务,即如果工作线程空闲了指定的时间(默认为1分钟),则该工作线程将自动终止。终止后,如果你又提交了新的任务,则线程池重新创建一个工作线程。
在使用CachedThreadPool时,一定要注意控制任务的数量,否则,由于大量线程同时运行,很有会造成系统瘫痪。
创建一个指定工作线程数量的线程池。每当提交一个任务就创建一个工作线程,如果工作线程数量达到线程池初始的最大数,则将提交的任务存入到池队列中。FixedThreadPool是一个典型且优秀的线程池,它具有线程池提高程序效率和节省创建线程时所耗的开销的优点。但是,在线程池空闲时,即线程池中没有可运行任务时,它不会释放工作线程,还会占用一定的系统资源。
创建一个单线程化的Executor,即只创建唯一的工作者线程来执行任务,它只会用唯一的工作线程来执行任务,保证所有任务按照指定顺序(FIFO, LIFO, 优先级)执行。如果这个线程异常结束,会有另一个取代它,保证顺序执行。单工作线程最大的特点是可保证顺序地执行各个任务,并且在任意给定的时间不会有多个线程是活动的。
创建一个定长的线程池,而且支持定时的以及周期性的任务执行。例如延迟3秒执行。
7、为什么要使用线程池 难度系数:⭐
第一:降低资源消耗。通过重复利用己创建的线程降低线程创建和销毁造成的消耗。
第二:提高响应速度。当任务到达时,任务可以不需要的等到线程创建就能立即执行。
第三:提高线程的可管理性。线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进 行统一的分配,调优和监控
8、线程池底层工作原理 难度系数:⭐
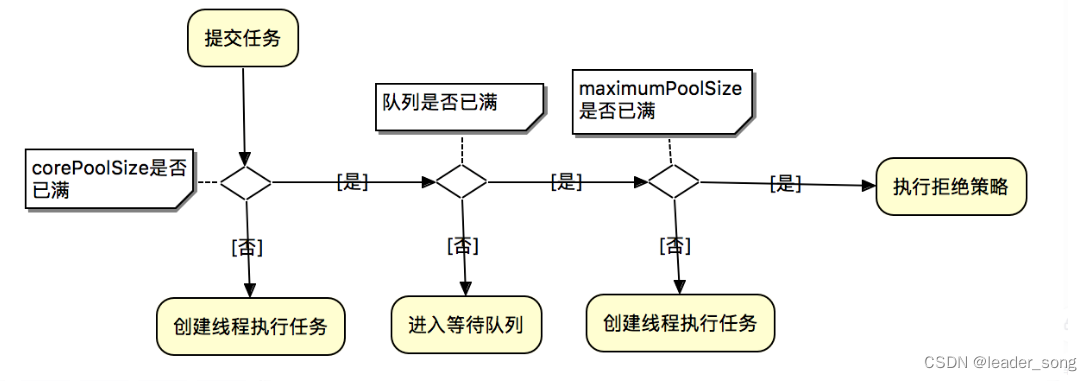
9、ThreadPoolExecutor对象有哪些参数 怎么设定核心线程数和最大线程数 拒绝策略有哪些 难度系数:⭐
参数与作用:共7个参数
在ThreadPoolExecutor中有一个与它相关的配置:allowCoreThreadTimeOut(默认为false),当allowCoreThreadTimeOut为false时,核心线程会一直存活,哪怕是一直空闲着。而当allowCoreThreadTimeOut为true时核心线程空闲时间超过keepAliveTime时会被回收。
线程池能容纳的最大线程数,当线程池中的线程达到最大时,此时添加任务将会采用拒绝策略,默认的拒绝策略是抛出一个运行时错误(RejectedExecutionException)。值得一提的是,当初始化时用的工作队列为LinkedBlockingDeque时,这个值将无效。
当非核心空闲超过这个时间将被回收,同时空闲核心线程是否回收受allowCoreThreadTimeOut影响。
常用有三种队列,即SynchronousQueue,LinkedBlockingDeque(无界队列),ArrayBlockingQueue(有界队列)。
ThreadFactory是一个接口,用来创建worker。通过线程工厂可以对线程的一些属性进行定制。默认直接新建线程。
也是一个接口,只有一个方法,当线程池中的资源已经全部使用,添加新线程被拒绝时,会调用RejectedExecutionHandler的rejectedExecution法。默认是抛出一个运行时异常。
线程池大小设置:
如果是 CPU 密集型,主要是执行计算任务,响应时间很快,cpu 一直在运行,这种任务 cpu的利用率很高,那么线程数的配置应该根据 CPU 核心数来决定,CPU 核心数=最大同时执行线程数,加入 CPU 核心数为 4,那么服务器最多能同时执行 4 个线程。过多的线程会导致上下文切换反而使得效率降低。那线程池的最大线程数可以配置为 cpu 核心数+1 如果是 IO 密集型,主要是进行 IO 操作,执行 IO 操作的时间较长,这是 cpu 出于空闲状态,导致 cpu 的利用率不高,这种情况下可以增加线程池的大小。这种情况下可以结合线程的等待时长来做判断,等待时间越高,那么线程数也相对越多。一般可以配置 cpu 核心数的 2 倍。
一个公式:线程池设定最佳线程数目 = ((线程池设定的线程等待时间+线程 CPU 时间)/ 线程 CPU 时间 )* CPU 数目
这个公式的线程 cpu 时间是预估的程序单个线程在 cpu 上运行的时间(通常使用 loadrunner测试大量运行次数求出平均值)
拒绝策略:
10、常见线程安全的并发容器有哪些 难度系数:⭐
11、Atomic原子类了解多少 原理是什么 难度系数:⭐
Java 的原子类都存放在并发包 java.util.concurrent.atomic下,如下图:
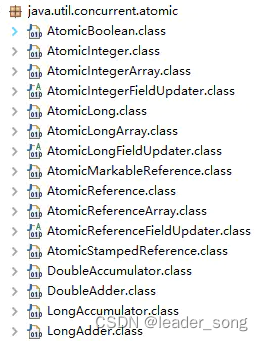
基本类型
- 使用原子的方式更新基本类型
- AtomicInteger:整型原子类
- AtomicLong:长整型原子类
- AtomicBoolean:布尔型原子类
数组类型
- 使用原子的方式更新数组里的某个元素
- AtomicIntegerArray:整形数组原子类
- AtomicLongArray:长整形数组原子类
- AtomicReferenceArray:引用类型数组原子类
引用类型
- AtomicReference:引用类型原子类
- AtomicStampedReference:原子更新引用类型里的字段原子类
- AtomicMarkableReference :原子更新带有标记位的引用类型
- AtomicIntegerFieldUpdater:原子更新整形字段的更新器
- AtomicLongFieldUpdater:原子更新长整形字段的更新器
- AtomicStampedReference:原子更新带有版本号的引用类型。该类将整数值与引用关联起来,可用于解决原子的更新数据和数据的版本号,以及解决使用 CAS 进行原子更新时可能出现的 ABA 问题
12、synchronized底层实现是什么 lock底层是什么 有什么区别 难度系数:⭐⭐⭐
Synchronized原理:
方法级的同步是隐式,即无需通过字节码指令来控制的,它实现在方法调用和返回操作之中。JVM可以从方法常量池中的方法表结构(method_info Structure) 中的 ACC_SYNCHRONIZED 访问标志区分一个方法是否同步方法。当方法调用时,调用指令将会 检查方法的 ACC_SYNCHRONIZED 访问标志是否被设置,如果设置了,执行线程将先持有monitor(虚拟机规范中用的是管程一词),然后再执行方法,最后再方法完成(无论是正常完成还是非正常完成)时释放monitor。
代码块的同步是利用monitorenter和monitorexit这两个字节码指令。它们分别位于同步代码块的开始和结束位置。当jvm执行到monitorenter指令时,当前线程试图获取monitor对象的所有权,如果未加锁或者已经被当前线程所持有,就把锁的计数器+1;当执行monitorexit指令时,锁计数器-1;当锁计数器为0时,该锁就被释放了。如果获取monitor对象失败,该线程则会进入阻塞状态,直到其他线程释放锁。
Lock原理:
Lock与synchronized的区别:
|
synchronized |
Lock |
|
关键字 |
类 |
|
自动加锁和释放锁 |
需要手动调用unlock方法释放锁 |
|
jvm层面的锁 |
API层面的锁 |
|
非公平锁 |
可以选择公平或者非公平锁 |
|
锁是一个对象,并且锁的信息保存在了对象中 |
代码中通过int类型的state标识 |
|
有一个锁升级的过程 |
无 |
篇幅限制下面就只能给大家展示小册部分内容了。整理了一份核心面试笔记包括了:Java面试、Spring、JVM、MyBatis、Redis、MySQL、并发编程、微服务、Linux、Springboot、SpringCloud、MQ、Kafc
需要全套面试笔记及答案【点击此处即可/免费获取】https://docs.qq.com/doc/DQXdYWE9LZ2ZHZ1ho
13、了解ConcurrentHashMap吗 为什么性能比HashTable高,说下原理 难度系数:⭐⭐
ConcurrentHashMap是线程安全的Map容器,JDK8之前,ConcurrentHashMap使用锁分段技术,将数据分成一段段存储,每个数据段配置一把锁,即segment类,这个类继承ReentrantLock来保证线程安全,JKD8的版本取消Segment这个分段锁数据结构,底层也是使用Node数组+链表+红黑树,从而实现对每一段数据就行加锁,也减少了并发冲突的概率。
hashtable类基本上所有的方法都是采用synchronized进行线程安全控制,高并发情况下效率就降低 ,ConcurrentHashMap是采用了分段锁的思想提高性能,锁粒度更细化
14、ConcurrentHashMap底层原理 难度系数:⭐⭐⭐
public V put(K key, V value) {
Segment<K,V> s;
if (value == null)
throw new NullPointerException();
int hash = hash(key);
// hash 值无符号右移 28位(初始化时获得),然后与 segmentMask=15 做与运算
// 其实也就是把高4位与segmentMask(1111)做与运算
// this.segmentMask = ssize – 1;
//对hash值进行右移segmentShift位,计算元素对应segment中数组下表的位置
//把hash右移segmentShift,相当于只要hash值的高32-segmentShift位,右移的目的是保留了hash值的高位。然后和segmentMask与操作计算元素在segment数组中的下表
int j = (hash >>> segmentShift) & segmentMask;
//使用unsafe对象获取数组中第j个位置的值,后面加上的是偏移量
if ((s = (Segment<K,V>)UNSAFE.getObject // nonvolatile; recheck
(segments, (j << SSHIFT) + SBASE)) == null) // in ensureSegment
// 如果查找到的 Segment 为空,初始化
s = ensureSegment(j);
//插入segment对象
return s.put(key, hash, value, false);
}
/**
* Returns the segment for the given index, creating it and
* recording in segment table (via CAS) if not already present.
*
* @param k the index
* @return the segment
*/
@SuppressWarnings("unchecked")
private Segment<K,V> ensureSegment(int k) {
final Segment<K,V>[] ss = this.segments;
long u = (k << SSHIFT) + SBASE; // raw offset
Segment<K,V> seg;
// 判断 u 位置的 Segment 是否为null
if ((seg = (Segment<K,V>)UNSAFE.getObjectVolatile(ss, u)) == null) {
Segment<K,V> proto = ss[0]; // use segment 0 as prototype
// 获取0号 segment 里的 HashEntry<K,V> 初始化长度
int cap = proto.table.length;
// 获取0号 segment 里的 hash 表里的扩容负载因子,所有的 segment 的 loadFactor 是相同的
float lf = proto.loadFactor;
// 计算扩容阀值
int threshold = (int)(cap * lf);
// 创建一个 cap 容量的 HashEntry 数组
HashEntry<K,V>[] tab = (HashEntry<K,V>[])new HashEntry[cap];
if ((seg = (Segment<K,V>)UNSAFE.getObjectVolatile(ss, u)) == null) { // recheck
// 再次检查 u 位置的 Segment 是否为null,因为这时可能有其他线程进行了操作
Segment<K,V> s = new Segment<K,V>(lf, threshold, tab);
// 自旋检查 u 位置的 Segment 是否为null
while ((seg = (Segment<K,V>)UNSAFE.getObjectVolatile(ss, u))
== null) {
// 使用CAS 赋值,只会成功一次
if (UNSAFE.compareAndSwapObject(ss, u, null, seg = s))
break;
}
}
}
return seg;
}
final V put(K key, int hash, V value, boolean onlyIfAbsent) {
// 获取 ReentrantLock 独占锁,获取不到,scanAndLockForPut 获取。
HashEntry<K,V> node = tryLock() ? null : scanAndLockForPut(key, hash, value);
V oldValue;
try {
HashEntry<K,V>[] tab = table;
// 计算要put的数据位置
int index = (tab.length – 1) & hash;
// CAS 获取 index 坐标的值
HashEntry<K,V> first = entryAt(tab, index);
for (HashEntry<K,V> e = first;;) {
if (e != null) {
// 检查是否 key 已经存在,如果存在,则遍历链表寻找位置,找到后替换 value
K k;
if ((k = e.key) == key ||
(e.hash == hash && key.equals(k))) {
oldValue = e.value;
if (!onlyIfAbsent) {
e.value = value;
++modCount;
}
break;
}
e = e.next;
}
else {
// first 有值没说明 index 位置已经有值了,有冲突,链表头插法。
if (node != null)
node.setNext(first);
else
node = new HashEntry<K,V>(hash, key, value, first);
int c = count + 1;
// 容量大于扩容阀值,小于最大容量,进行扩容
if (c > threshold && tab.length < MAXIMUM_CAPACITY)
rehash(node);
else
// index 位置赋值 node,node 可能是一个元素,也可能是一个链表的表头
setEntryAt(tab, index, node);
++modCount;
count = c;
oldValue = null;
break;
}
}
} finally {
unlock();
}
return oldValue;
}
Java