聊一个老生常谈,但 90% 的人只知其一不知其二的话题:Kafka 为什么这么快?
很多同学在面试时都能背出那几句八股文:“零拷贝、顺序写、页缓存”。但如果面试官追问一句:“你能在 Java 里写出零拷贝的代码吗?你知道页缓存什么时候会失效吗?Kafka 的索引文件为什么要用 mmap 而不是 sendfile?”
这时候,很多人就开始支支吾吾了。😅
读完这篇,你不仅能搞定面试,更能掌握处理高并发 I/O 的架构思维。
1. 为什么你的磁盘 I/O 这么慢?
痛点与误区
在很多开发者的潜意识里,磁盘(Disk)就是慢的代名词,内存(RAM)才是王道。 这是一个巨大的误区。
现代操作系统的文件系统极其聪明,如果你顺着它的脾气来(顺序写),磁盘的速度甚至可以逼近内存。Kafka 的核心哲学就是:压榨操作系统的每一滴性能,而不是试图在 JVM 层面重新造轮子。
如果你的系统 I/O 慢,通常不是磁盘的问题,而是你使用磁盘的方式出了问题。
2. 核心原理深度剖析
2.1 顺序写(Sequential Write):磁盘的正确打开方式
Kafka 的 Log 文件是只能追加(Append Only)的。这看似笨重,实则是性能的源泉。
原理:
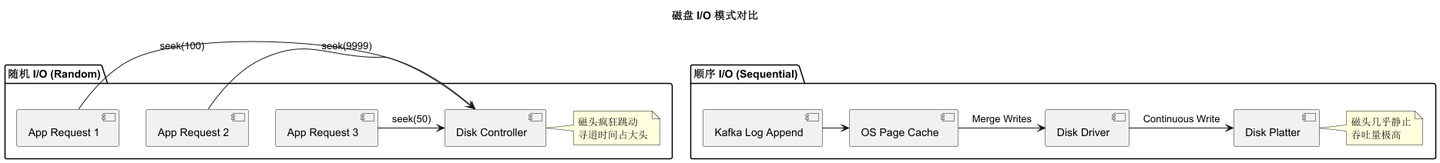
- 随机 I/O:磁盘磁头需要频繁寻道(Seek),这是物理机械动作,极慢。即使是 SSD,随机写的写放大(Write Amplification)和 GC 也会严重拖慢速度。
- 顺序 I/O:磁头几乎不动,数据像水流一样灌入。操作系统会进行预读(Read-Ahead)和写合并(Write Combining)。
👨💻 代码实战:随机写 vs 顺序写
我们用 Java 21 来模拟这两种场景,看看差距有多大。
// 示例 1: 顺序写与随机写性能对比基准测试
// 运行环境建议:SSD 磁盘, Java 21
import java.io.*;
import java.nio.ByteBuffer;
import java.nio.channels.FileChannel;
import java.nio.file.*;
import java.util.Random;
public class DiskBenchmark {
private static final int RECORD_COUNT = 1_000_000;
private static final int RECORD_SIZE = 1024; // 1KB
private static final byte[] DATA = new byte[RECORD_SIZE];
static {
new Random().nextBytes(DATA);
}
public static void main(String[] args) throws IOException {
testSequentialWrite();
testRandomWrite();
}
// 顺序写:模拟 Kafka 追加日志
private static void testSequentialWrite() throws IOException {
Path path = Path.of("sequential.dat");
long start = System.currentTimeMillis();
try (FileChannel channel = FileChannel.open(path,
StandardOpenOption.CREATE, StandardOpenOption.WRITE)) {
ByteBuffer buffer = ByteBuffer.allocateDirect(RECORD_SIZE);
for (int i = 0; i < RECORD_COUNT; i++) {
buffer.clear();
buffer.put(DATA);
buffer.flip();
channel.write(buffer);
}
}
System.out.println("顺序写耗时: " + (System.currentTimeMillis() – start) + "ms");
Files.deleteIfExists(path);
}
// 随机写:模拟普通数据库的随机更新
private static void testRandomWrite() throws IOException {
Path path = Path.of("random.dat");
// 先预分配文件
try (FileChannel channel = FileChannel.open(path,
StandardOpenOption.CREATE, StandardOpenOption.WRITE)) {
channel.write(ByteBuffer.wrap(new byte[1])); // 简单占位
}
long start = System.currentTimeMillis();
try (RandomAccessFile raf = new RandomAccessFile(path.toFile(), "rw")) {
Random random = new Random();
for (int i = 0; i < RECORD_COUNT / 10; i++) { // 减少数量,否则跑太久
long pos = Math.abs(random.nextLong()) % (RECORD_COUNT * RECORD_SIZE);
raf.seek(pos);
raf.write(DATA);
}
}
System.out.println("随机写(1/10数据量)耗时: " + (System.currentTimeMillis() – start) + "ms");
Files.deleteIfExists(path);
}
}
运行结果说明: 你會发现顺序写的速度非常快(通常在几秒内完成 1GB 写入),而随机写即使数据量只有十分之一,耗时也可能是顺序写的几十倍。这就是 Kafka 坚持 Append Only 的原因。
📊 架构图解:I/O 模式对比
2.2 页缓存(Page Cache):操作系统的神助攻
Kafka 在写入数据时,并没有直接刷入磁盘,而是写入了操作系统的 Page Cache。
架构师视角: 很多 Java 程序员喜欢在 JVM 内部做各种复杂的缓存。但在 Kafka 这种场景下,最好的缓存是操作系统提供的缓存。
👨💻 代码实战:利用 OS Cache 读写
这个例子展示了当我们写入文件后,立即读取,实际上并没有发生物理磁盘读操作,而是直接从 Page Cache 拿数据。
// 示例 2: 验证 Page Cache 的存在
import java.io.IOException;
import java.nio.ByteBuffer;
import java.nio.channels.FileChannel;
import java.nio.file.*;
public class PageCacheDemo {
public static void main(String[] args) throws IOException {
Path path = Path.of("pagecache_test.dat");
int size = 100 * 1024 * 1024; // 100MB
byte[] data = new byte[size]; // 填充数据
// 1. 写入文件 (此时数据主要在 Page Cache 中)
long startWrite = System.nanoTime();
try (FileChannel channel = FileChannel.open(path,
StandardOpenOption.CREATE, StandardOpenOption.WRITE)) {
channel.write(ByteBuffer.wrap(data));
}
System.out.println("写入耗时: " + (System.nanoTime() – startWrite) / 1_000_000 + "ms");
// 2. 立即读取 (命中 Page Cache,速度极快)
long startRead = System.nanoTime();
try (FileChannel channel = FileChannel.open(path, StandardOpenOption.READ)) {
ByteBuffer buffer = ByteBuffer.allocateDirect(size);
channel.read(buffer);
}
System.out.println("读取耗时 (Page Cache Hit): " + (System.nanoTime() – startRead) / 1_000_000 + "ms");
Files.delete(path);
}
}
生产启示: 在 Kafka 调优时,千万别把机器内存都分给 JVM Heap。比如 32GB 内存的机器,建议 Heap 给 6GB-8GB 足够了,剩下的全部留给操作系统做 Page Cache。这才是 Kafka 高吞吐的真正秘密。
2.3 零拷贝(Zero Copy):拒绝中间商赚差价
这是 Kafka 最核心的杀手锏。
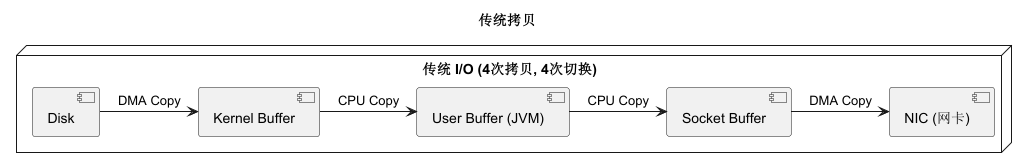
传统 I/O 的痛点: 假设你要把磁盘上的文件通过网络发送给消费者。
中间这两次 CPU 拷贝和上下文切换(Context Switch)是完全多余的。
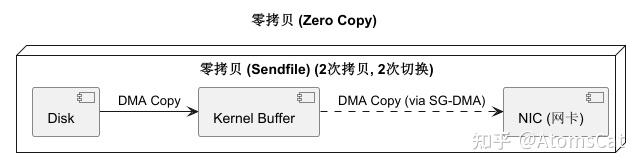
Sendfile (Zero Copy): 直接让内核把数据从 Kernel Buffer 传给 NIC Buffer(或者传递描述符),数据根本不经过用户态(User Space)。
👨💻 代码实战:Java 中的零拷贝
在 Java 中,FileChannel.transferTo 就是对应的系统调用 sendfile。
// 示例 3: 零拷贝传输 (Sendfile)
import java.io.IOException;
import java.net.InetSocketAddress;
import java.nio.channels.FileChannel;
import java.nio.channels.ServerSocketChannel;
import java.nio.channels.SocketChannel;
import java.nio.file.Path;
import java.nio.file.StandardOpenOption;
public class ZeroCopyServer {
public void startServer() throws IOException {
ServerSocketChannel serverSocket = ServerSocketChannel.open();
serverSocket.bind(new InetSocketAddress(8080));
while (true) {
SocketChannel client = serverSocket.accept();
// 模拟发送一个大文件
Path path = Path.of("large_movie.mkv");
try (FileChannel fileChannel = FileChannel.open(path, StandardOpenOption.READ)) {
long position = 0;
long count = fileChannel.size();
// 核心代码:transferTo 底层利用 sendfile
// 直接将文件通道的数据传输到网络通道,不经过 JVM 堆内存
fileChannel.transferTo(position, count, client);
}
client.close();
}
}
}
📊 架构图解:传统拷贝 vs 零拷贝
2.4 mmap(内存映射文件):索引的秘密武器
Kafka 的数据文件(Log)用的是 sendfile 做网络传输,但 Kafka 的索引文件(Index)用的是 mmap (Memory Mapped Files)。
为什么? 索引需要频繁的随机读写(二分查找消息位置),mmap 允许我们将文件直接映射到用户态的内存地址空间。对这块内存的读写,操作系统会自动同步到磁盘文件,速度极快。
👨💻 代码实战:Java 使用 mmap
Java 通过 MappedByteBuffer 实现 mmap。
// 示例 4: MappedByteBuffer 实现内存映射
import java.io.IOException;
import java.io.RandomAccessFile;
import java.nio.MappedByteBuffer;
import java.nio.channels.FileChannel;
public class MmapDemo {
public static void main(String[] args) throws IOException {
try (RandomAccessFile file = new RandomAccessFile("kafka_index.idx", "rw");
FileChannel channel = file.getChannel()) {
// 映射 1KB 的空间
// MapMode.READ_WRITE: 读写模式
MappedByteBuffer mmap = channel.map(FileChannel.MapMode.READ_WRITE, 0, 1024);
// 像操作内存数组一样操作文件
mmap.putLong(0, 123456L); // 写入 offset
mmap.putInt(8, 500); // 写入 position
// 强制刷盘 (通常由 OS 决定,但也可以手动)
mmap.force();
System.out.println("索引写入完成,无需系统调用 write()");
}
}
}
踩坑记录: MappedByteBuffer 在 Java 中释放非常麻烦(没有 unmap 方法),需要用反射调用 Cleaner,或者等待 GC。在 Java 19+ 引入了 Foreign Memory API 改善了这一点,但在 JDK 8/11/17 中需要注意内存泄漏风险。
3. 生产级实战:批量与微批处理
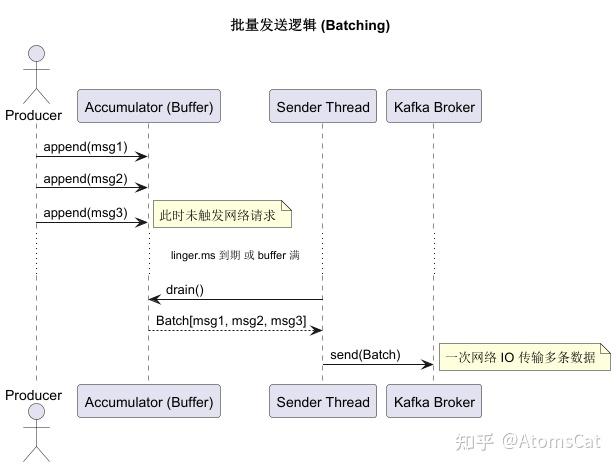
除了底层 I/O,Kafka 在应用层的优化也做到了极致,最典型的就是 Batching(批量)。
如果你一条一条消息发给 Kafka,网络 RTT(往返时延)会教你做人。Kafka 客户端会把消息积攒到一定大小(batch.size)或一定时间(linger.ms)再发送。
👨💻 代码实战:模拟简单的微批处理缓冲器
这是一个架构师必须掌握的模式:用延迟换吞吐。
// 示例 5: 简易的微批处理 (Micro-batching) 缓冲器
import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.*;
public class BatchProcessor<T> {
private final BlockingQueue<T> queue = new LinkedBlockingQueue<>(10000);
private final int batchSize;
private final long lingerMs;
public BatchProcessor(int batchSize, long lingerMs) {
this.batchSize = batchSize;
this.lingerMs = lingerMs;
startConsumer();
}
public void send(T item) {
if (!queue.offer(item)) {
// 生产环境需处理队列满的情况:拒绝策略 or 阻塞
System.out.println("队列已满,丢弃消息");
}
}
private void startConsumer() {
Thread.ofVirtual().start(() -> { // Java 21 虚拟线程
List<T> buffer = new ArrayList<>(batchSize);
while (true) {
try {
long deadline = System.currentTimeMillis() + lingerMs;
while (buffer.size() < batchSize) {
long remaining = deadline – System.currentTimeMillis();
if (remaining <= 0) break;
T item = queue.poll(remaining, TimeUnit.MILLISECONDS);
if (item != null) buffer.add(item);
}
if (!buffer.isEmpty()) {
flush(buffer);
buffer.clear();
}
} catch (InterruptedException e) {
Thread.currentThread().interrupt();
break;
}
}
});
}
private void flush(List<T> batch) {
// 模拟网络发送或磁盘写入
System.out.println("批量刷盘: " + batch.size() + " 条数据. Thread: " + Thread.currentThread());
}
public static void main(String[] args) throws InterruptedException {
var processor = new BatchProcessor<String>(10, 100); // 10条或100ms
// 模拟高并发写入
for (int i = 0; i < 55; i++) {
processor.send("Log-" + i);
if (i % 20 == 0) Thread.sleep(50);
}
Thread.sleep(1000); // 等待处理完毕
}
}
📊 架构图解:Batching 逻辑
4. 架构师的思维拓展:邪修版本与陷阱
作为架构师,我们不仅要学 Kafka,还要想:如果我来设计,能比 Kafka 更极端吗?
4.1 邪修架构:绕过 Page Cache (Direct I/O)
Kafka 极度依赖 Page Cache,这在某些场景下是缺点。比如 Page Cache 写入磁盘的时机由 OS 控制,如果机器断电,可能会丢失较多数据(虽然 Kafka 有副本机制兜底)。
有些数据库(如 ScyllaDB, Oracle)选择 Direct I/O(O_DIRECT),完全绕过 OS Cache,自己管理内存缓存。 好处:完全可控,GC 友好(Off-Heap)。 坏处:代码极度复杂,需要自己写缓存淘汰算法。
👨💻 代码实战:使用 Unsafe/Direct Memory (Java 邪修版)
这是 Java 中操作堆外内存的“黑魔法”,Netty 和 Kafka 底层大量使用。
// 示例 6: 堆外内存直接操作 (Unsafe/DirectMemory)
// 注意:这通常是框架层代码,业务层慎用
import sun.misc.Unsafe;
import java.lang.reflect.Field;
public class OffHeapMagic {
private static final Unsafe unsafe;
static {
try {
Field f = Unsafe.class.getDeclaredField("theUnsafe");
f.setAccessible(true);
unsafe = (Unsafe) f.get(null);
} catch (Exception e) {
throw new RuntimeException(e);
}
}
public static void main(String[] args) {
long size = 1024;
// 1. 分配堆外内存
long address = unsafe.allocateMemory(size);
System.out.println("分配堆外内存地址: " + address);
try {
// 2. 写入数据
unsafe.putLong(address, 88888888L);
unsafe.putByte(address + 8, (byte) 1);
// 3. 读取数据
long val = unsafe.getLong(address);
System.out.println("读取堆外数据: " + val);
} finally {
// 4. 必须手动释放!否则内存泄漏
unsafe.freeMemory(address);
}
}
}
4.2 生产环境踩坑记录
5. 总结
Kafka 之所以能达到千万级吞吐,不是因为它有什么魔法,而是因为它顺应了物理规律。
📌 Takeaway (划重点):
希望这篇文章能帮你打通任督二脉。如果你在生产环境遇到过诡异的 I/O 问题,欢迎在评论区留言,我们一起“排雷”。