文章目录
-
- 一、实验目的
- 二、实验要求
- 三、实验原理
- 四、实验环境
- 五、实验内容和步骤
-
- (一)验证Hadoop和ZooKeeper已启动
- (二)修改HBase配置文件
- (三)启动并验证HBase
- 六、实验结果
- 七、实验心得
一、实验目的
二、实验要求
三、实验原理
简介:HBase是基于Hadoop的开源分布式数据库,它以Google的BigTable为原型,设计并实现了具有高可靠性、高性能、列存储、可伸缩、实时读写的分布式数据库系统,它是基于列而不是基于行的模式,适合存储非结构化数据。
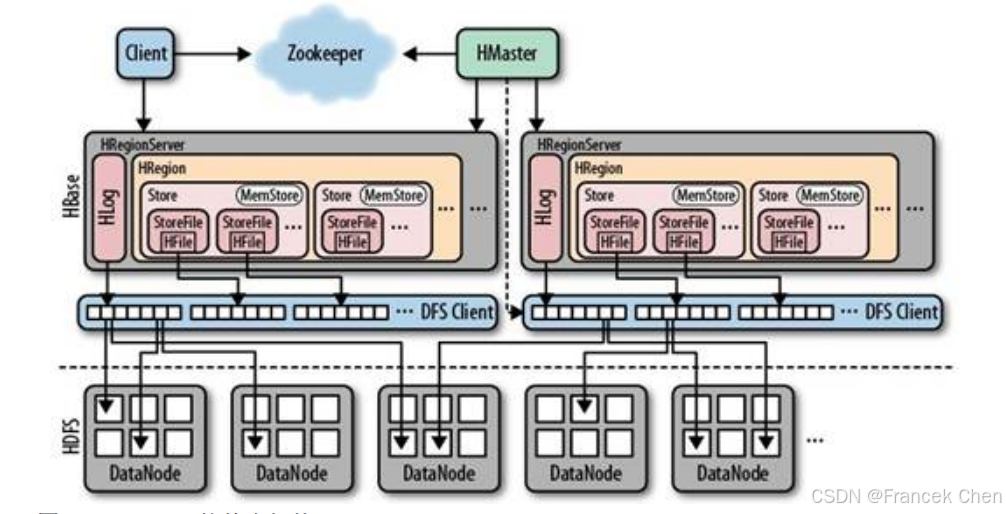
体系结构:HBase是一个分布式的数据库,使用Zookeeper管理集群,使用HDFS作为底层存储,它由HMaster和HRegionServer组成,遵从主从服务器架构。HBase将逻辑上的表划分成多个数据块即HRegion,存储在HRegionServer中。HMaster负责管理所有的HRegionServer,它本身并不存储任何数据,而只是存储数据到HRegionServer的映射关系(元数据)。HBase的基本架构如图所示:
四、实验环境
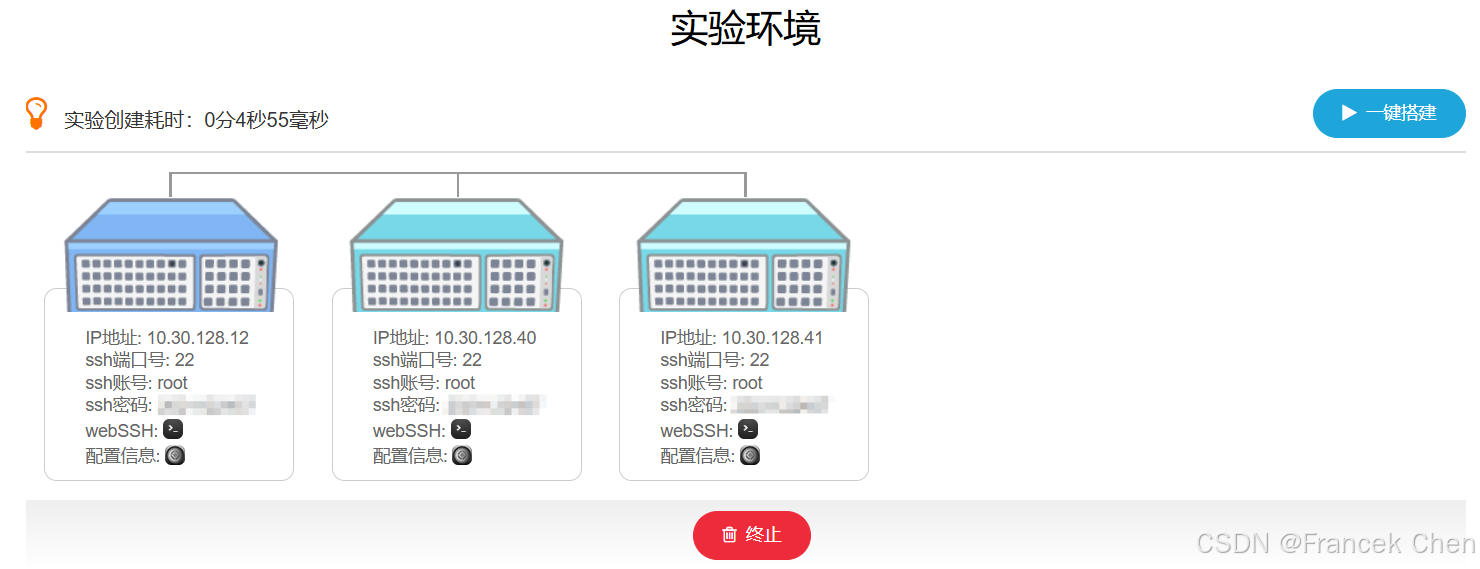
- 云创大数据实验平台:
- Java 版本:jdk1.7.0_79
- Hadoop 版本:hadoop-2.7.1
- ZooKeeper 版本:zookeeper-3.4.6
- HBase 版本:hbase-1.1.2
五、实验内容和步骤
本实验主要演示HBase的安装部署过程,因HBase依赖于HDFS和Zookeeper,所以该实验需要分为四个步骤。
首先,配置SSH无密钥登录(参考【大数据技术基础 | 实验一】配置SSH免密登录)。
其次,安装Hadoop集群(参考【大数据技术基础 | 实验三】HDFS实验:部署HDFS)。
然后,安装Zookeeper集群(参考【大数据技术基础 | 实验五】ZooKeeper实验:部署ZooKeeper)。
最后,修改HBase配置文件,具体内容如下:
(一)验证Hadoop和ZooKeeper已启动
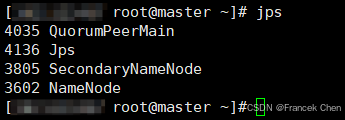
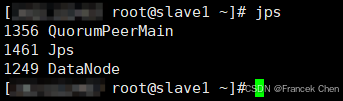
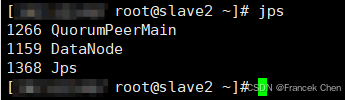
通过jps命令验证Hadoop和ZooKeeper已启动:
jps
(二)修改HBase配置文件
将HBase安装包hbase.1.1.2.tar.gz解压到/usr/cstor目录,并将hbase.1.1.2目录改名为hbase,且所属用户改成root:root。
tar -zxvf hbase.1.1.2.tar.gz -c /usr/cstor/hbase
mv /usr/cstor/hbase.1.1.2 /usr/cstor/hbase
chown -R root:root /usr/cstor/hbase
以上操作实验平台已经事先做好了。我们直接进入到hbase目录下:
cd /usr/cstor/hbase
ls

1. 配置hbase-env.sh文件
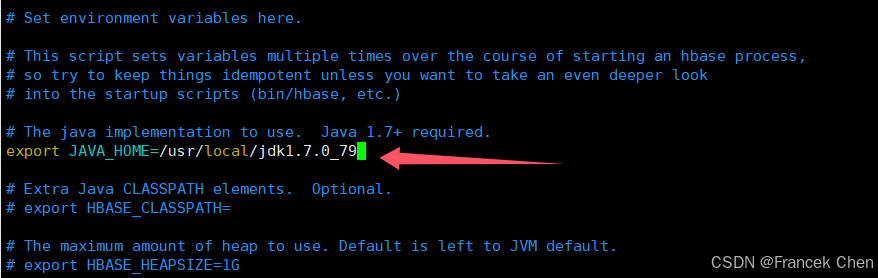
进入解压目录下,配置conf目录下的/usr/cstor/hbase/conf/hbase-env.sh文件,设置如下:
vim /usr/cstor/hbase/conf/hbase-env.sh
- Java安装路径: (需根据实际情况指定)
export JAVA_HOME=/usr/local/jdk1.7.0_79
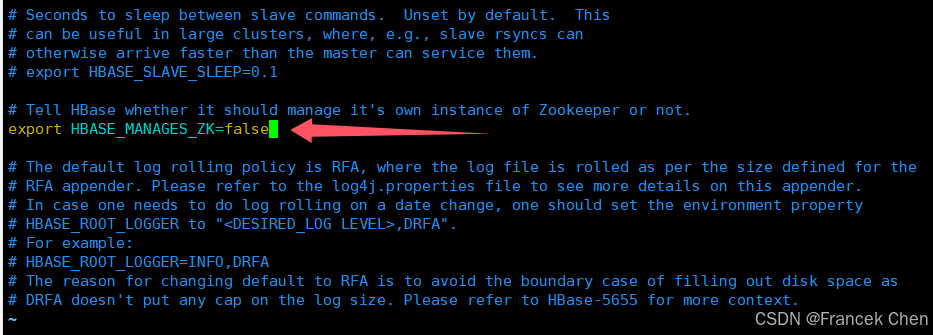
- 不使用HBase自带的Zookeeper:
export HBASE_MANAGES_ZK=false
2. 配置hbase-site.xml文件
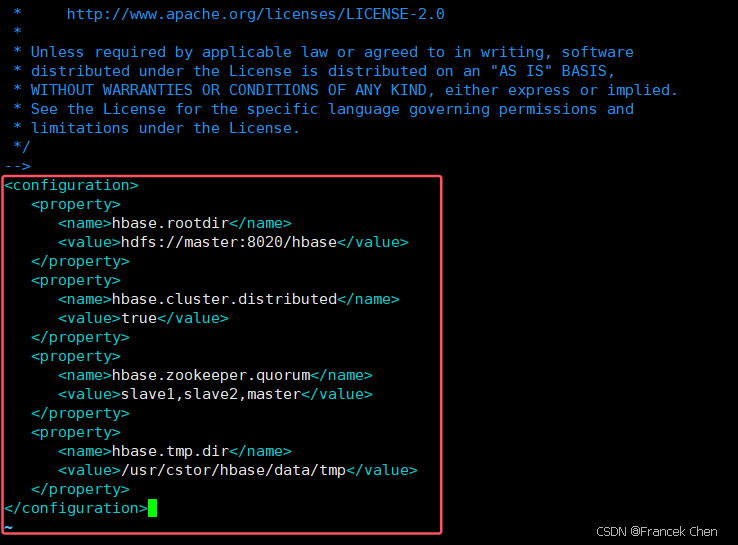
配置conf目录下的hbase-site.xml文件,设置如下:
vim /usr/cstor/hbase/conf/hbase-site.xml
<configuration>
<property>
<name>hbase.rootdir</name>
<value>hdfs://master:8020/hbase</value>
</property>
<property>
<name>hbase.cluster.distributed</name>
<value>true</value>
</property>
<property>
<name>hbase.zookeeper.quorum</name>
<value>slave1,slave2,master</value>
</property>
<property>
<name>hbase.tmp.dir</name>
<value>/usr/cstor/hbase/data/tmp</value>
</property>
</configuration>
3. 配置regionservers文件
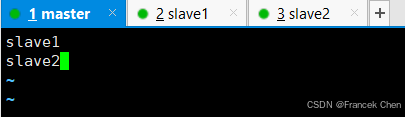
配置conf目录下的regionservers文件,设置如下:
vim /usr/cstor/hbase/conf/regionservers
slave1
slave2
配置完成后,将hbase目录传输到集群的其它节点:
scp -r /usr/cstor/hbase root@slave1:/usr/cstor
scp -r /usr/cstor/hbase root@slave2:/usr/cstor
(三)启动并验证HBase
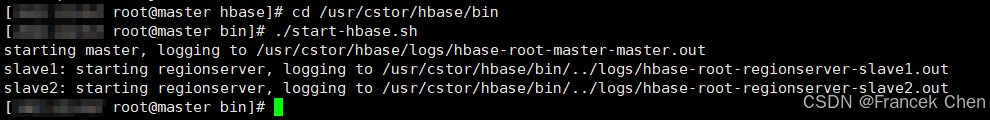
接着,启动HBase,并简单验证HBase,如下: 在主节点master进入hbase解压目录的bin目录,启动HBase服务进程(已启动Zookeeper):
cd /usr/cstor/hbase/bin
./start-hbase.sh
启动完HBase后,使用jps命令查看进程:
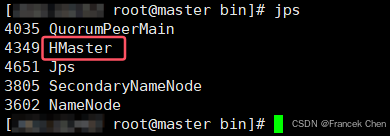
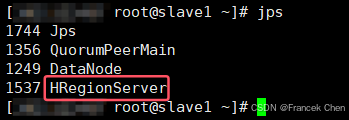
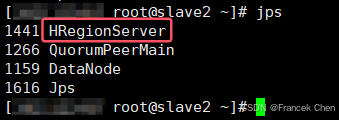
在master服务器上,可以看到HMaster进程;在slave1~2上,可以看到HRegionServer进程。这样,HBase就启动成功了。
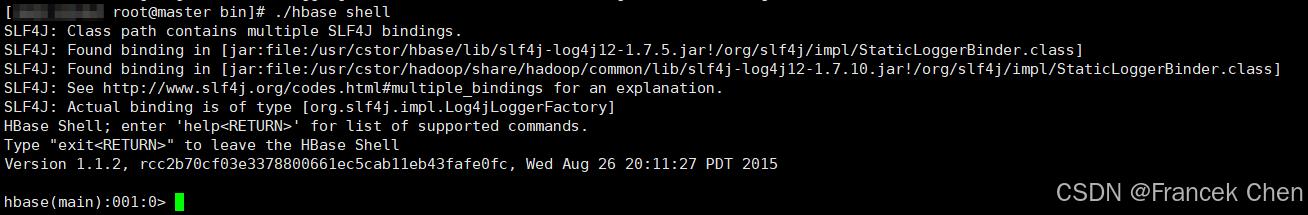
通过以下命令进入HBase shell界面:
./hbase shell
在shell里创建表:
create 'testhbase' , 'f1'
查询所有表名:
list
查看表结构信息:
describe 'testhbase'
在shell里插入数据:
put 'testhbase', '001', 'f1:name', 'aaa'
在shell里查询:
scan 'testhbase'
删除表,先disable再drop:
disable 'testhbase'
drop 'testhbase'
退出shell:
quit
六、实验结果
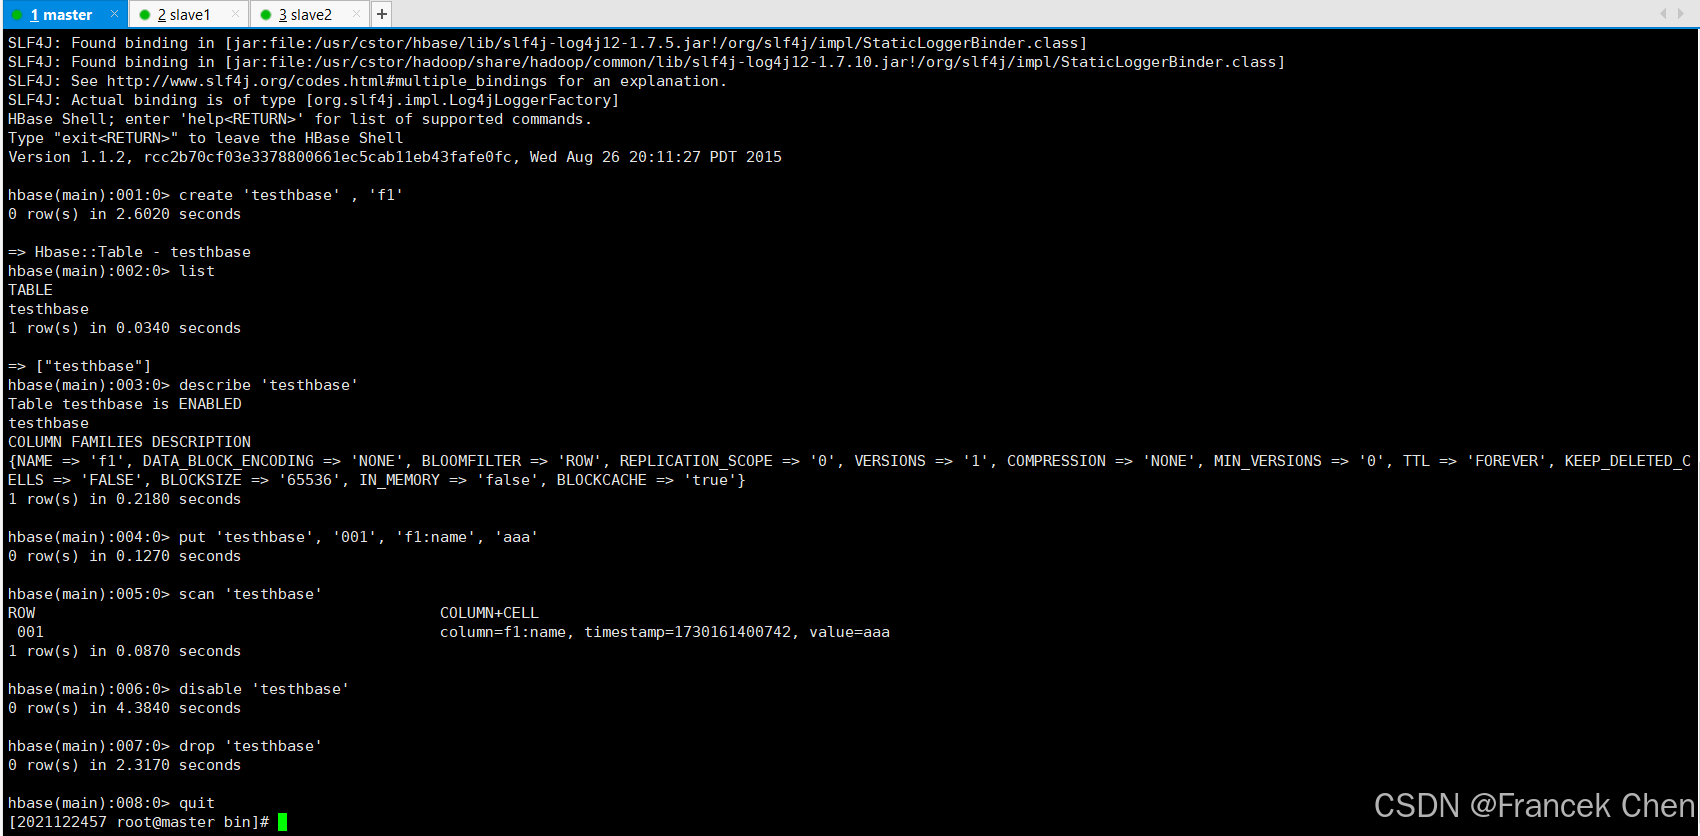
HBase启动成功后,进入shell界面,用shell命令简单操作HBase数据库验证HBase成功安装,验证结果如图所示。
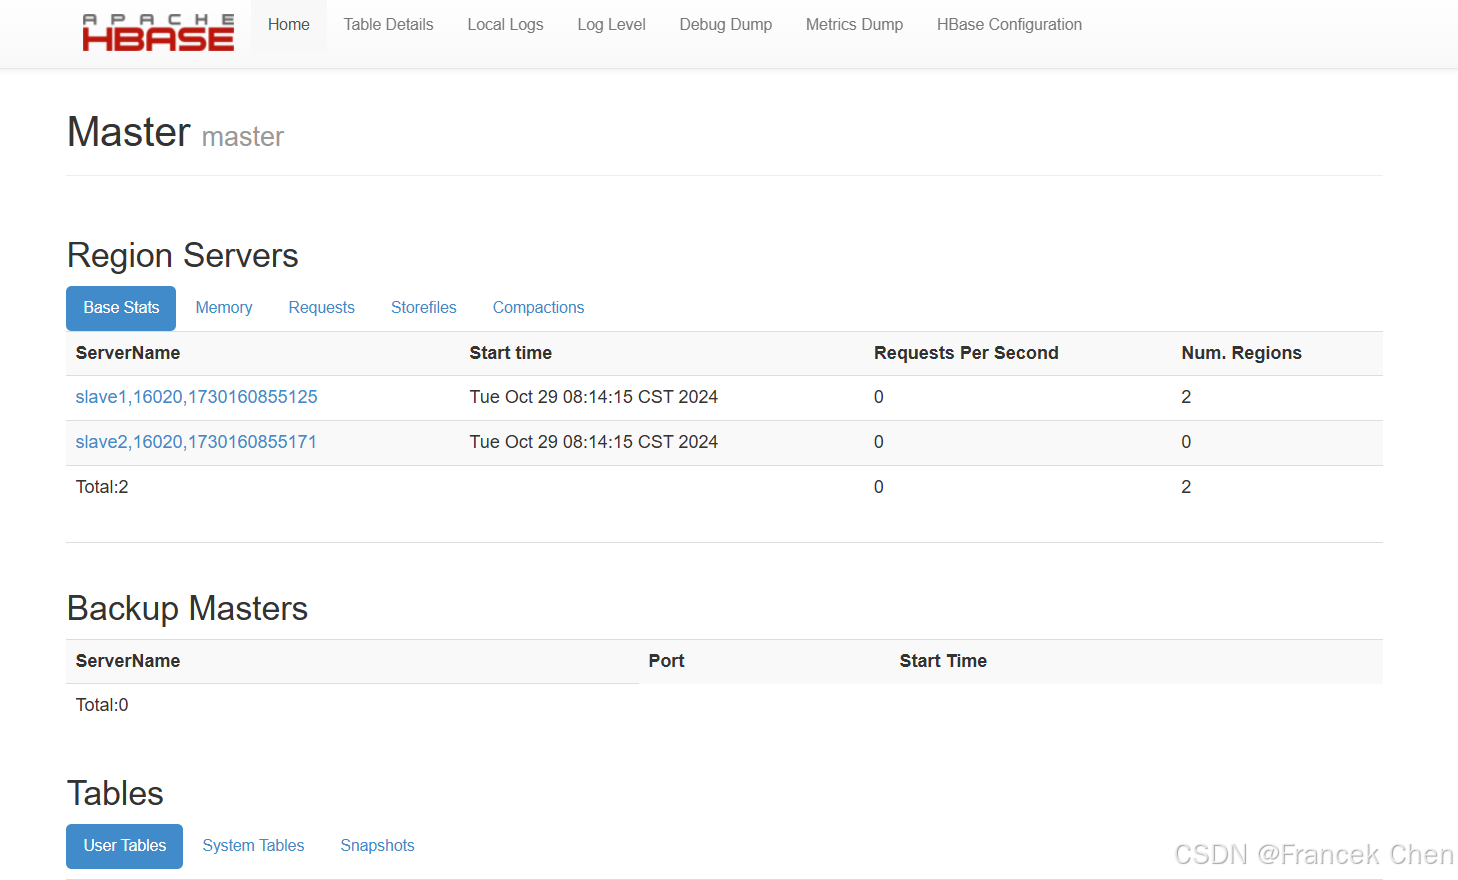
HBase安装成功后,可以通过访问HBase WEB页面(http://master:16010)来查看HBase集群的一些基本情况,如图所示。(这里的master要替换为对应的IP地址)
七、实验心得
在进行HBase实验的过程中,我深刻体会到了HBase作为一个分布式、可扩展的NoSQL数据库的独特优势。HBase的设计理念强调高吞吐量和低延迟,这使得它非常适合处理大规模数据存储和实时数据访问。
首先,我在实验中学习了HBase的基本架构。HBase是建立在Hadoop之上的,它利用Hadoop的HDFS作为底层存储。通过理解RegionServer、HMaster和Zookeeper的协作机制,我认识到HBase是如何实现高可用性和容错性的。尤其是Zookeeper在HBase中起到了关键的协调作用,确保了系统的一致性和稳定性。
在实际操作中,我体验到了HBase的表设计与传统关系型数据库的显著不同。在HBase中,表的设计更为灵活,允许动态列族的添加和删除。这种灵活性使得我们可以更方便地进行数据建模,尤其是在处理多样化和不断变化的数据时。此外,实验中我还实践了HBase的CRUD操作,通过Java API进行数据的插入、查询、更新和删除。尽管最初遇到了一些API使用上的困惑,但在查阅文档和反复试验后,我逐渐掌握了如何高效地进行数据操作。HBase的Scan和Get操作让我能够快速检索所需数据,极大提高了数据处理效率。
同时,我也注意到HBase在处理海量数据时的性能优势。在对大规模数据集进行测试时,HBase表现出色,能够迅速响应查询请求,显示出其高效的性能。这使我意识到,HBase非常适合大数据分析和实时数据处理的场景。在实验的最后阶段,我尝试对HBase进行一些基本的性能调优,了解了如预分区、缓存等优化策略。这些措施能够有效提升HBase的读写性能,为后续的应用提供了更好的支持。
总的来说,这次HBase实验让我对分布式数据库的架构和操作有了更加深入的理解。通过实践,我不仅学会了如何使用HBase,还认识到了在实际应用中如何根据需求进行设计和优化。这将对我未来的数据处理和分析工作产生积极的影响。
附:以上文中的数据文件及相关资源下载地址: 链接:https://pan.quark.cn/s/356a503ecf3e 提取码:khqu