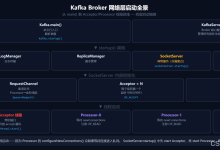
Apache Kafka 是一个分布式的、高吞吐量、低延迟的事件流处理平台。它的设计非常精妙,将传统的消息队列与日志存储系统的优势结合在了一起。
为了帮你理清 Kafka 的全貌,我将其关键的设计实现框架和核心内容整理为以下五个主要模块:
一、 核心架构框架 (Core Architecture) Kafka 的宏观架构主要由以下几个角色组成: Producer(生产者):负责将消息发送到 Kafka Broker。生产者可以根据指定的路由策略(如轮询、按 Key Hash 等)将消息发送到特定的 Partition。 Broker(代理节点):Kafka 集群中的服务节点。负责接收和处理客户端的请求,以及对消息进行持久化存储。 Consumer & Consumer Group(消费者与消费者组): Consumer:从 Broker 拉取(Pull)消息进行处理。 Consumer Group:Kafka 实现单播和广播的核心机制。**一个 Topic 可以被多个 Group 订阅(广播);在一个 Group 内,一条消息只能被一个 Consumer 消费(单播/负载均衡)。**
Zookeeper / KRaft(元数据管理): 传统架构(依赖 Zookeeper):负责集群元数据管理、Controller 选举、Broker 状态监控等。 新架构(KRaft 模式):Kafka 2.8 引入并在后续版本全面替代 Zookeeper。Kafka 内部实现了一个基于 Raft 协议的共识模块,彻底移除了对外部系统的依赖,提升了集群的扩展性和元数据同步性能。
Kafka zookeeper和KRaft架构
二、 数据模型与存储设计 (Storage Design) Kafka 的存储设计是其能够处理海量数据的基石:
Topic(主题)与 Partition(分区): Topic 是逻辑上的消息分类。 Partition 是物理上的概念,一个 Topic 包含一个或多个 Partition。Partition 是 Kafka 实现水平扩展和并发读写的基本单元。 Append-Only Log(追加日志): 每个 Partition 在物理上对应一个文件夹,数据以追加写(Append)的方式写入日志文件,保证了极高的写入速度(顺序写磁盘)。 Segment(日志分段): 为了防止单个日志文件过大导致检索缓慢,Kafka 将 Partition 切分为多个 Segment。 每个 Segment 包含三个核心文件: .log:实际存储消息数据的文件。 .index:偏移量(Offset)索引文件,采用稀疏索引,加速消息定位。 .timeindex:时间戳索引文件,支持按时间回溯消费。 Offset(偏移量): Partition 中的每条消息都会被分配一个单调递增的 ID,即 Offset。它是消息在 Partition 中的唯一标识。
三、 高可用与副本机制 (High Availability & Replication) Kafka 通过副本(Replica)机制保证数据不丢失和系统高可用:
Leader 与 Follower: 每个 Partition 都有多个副本。其中一个是 Leader,负责处理所有的读写请求;其余是 Follower,只负责从 Leader 异步拉取数据进行同步。 ISR 机制 (In-Sync Replicas): Kafka 维护了一个 ISR 集合,里面包含了所有与 Leader 保持同步的副本(包括 Leader 本身)。 如果 Follower 落后太多或宕机,会被踢出 ISR;如果恢复同步,会重新加入。 当 Leader 宕机时,Controller 会从 ISR 中选举出一个新的 Leader,保证数据不丢失。 HW 与 LEO: LEO (Log End Offset):每个副本底层日志中下一条要写入消息的 Offset。 HW (High Watermark):高水位线,取 ISR 集合中最小的 LEO。消费者只能拉取到 HW 之前的消息,保证了数据的一致性和安全性。
Kafka Epoch机制
四、 高性能实现核心 (High Performance Mechanics) Kafka 能够实现百万级 TPS 的核心技术点:
顺序 I/O (Sequential I/O): Kafka 放弃了随机读写,采用磁盘顺序追加写。现代操作系统的磁盘顺序写速度甚至可以媲美内存的随机写。 页缓存 (Page Cache): Kafka 不在 JVM 内存中缓存数据,而是直接利用操作系统的 Page Cache。这避免了 JVM GC 带来的停顿,同时即使 Kafka 进程重启,缓存依然有效。 零拷贝 (Zero Copy): 在消费者拉取数据时,Kafka 使用操作系统的 sendfile 系统调用。数据直接从 Page Cache 拷贝到网卡缓冲区,全程不经过用户态(User Space),极大降低了 CPU 负载和内存带宽消耗。 批处理与压缩 (Batching & Compression): Producer 发送消息时,会将多条消息打包成一个 Batch 发送;支持按批次进行数据压缩(如 Snappy、LZ4、Zstd),大幅减少网络 I/O 和磁盘占用。
五、 生产与消费语义 (Semantics & Advanced Features) 消息交付语义 (Delivery Guarantees): At most once(最多一次):消息可能丢失,但绝不重复。 At least once(最少一次):消息绝不丢失,但可能重复(Kafka 默认配置,通过 ACK 机制重试实现)。 Exactly once(精确一次):Kafka 通过幂等性(Idempotence)(保证单 Partition 单会话不重复)和事务(Transactions)(保证跨 Partition/Topic 的原子性写入)实现了端到端的 Exactly-once 语义。 Consumer Rebalance(消费者重平衡): 当 Consumer Group 中的消费者数量发生变化,或者 Topic 的 Partition 数量发生变化时,Kafka 会触发 Rebalance,重新分配 Partition 给存活的消费者。 现代 Kafka 引入了增量协作重平衡(Incremental Cooperative Rebalancing),减少了 Rebalance 过程中的“Stop-The-World”停顿时间。 总结: Kafka 的设计哲学在于**“做减法”**——它将复杂的消息状态管理交给消费者(通过维护 Offset),将数据缓存交给操作系统(Page Cache),采用最简单的追加写(Append-only Log)实现存储,从而在架构上保证了极致的吞吐量和极高的稳定性。