国内主流大模型
| 深度求索 | DeepSeek-V4 / R1 | ✅ 完全开源 | 极致性价比 & 推理之王。采用 MoE (混合专家) 架构,以极低训练成本实现顶级性能。R1系列在数学、逻辑推理上比肩甚至超越o1,且完全开源权重。 | 硬核逻辑推理、数学解题、代码生成、低成本高性能私有部署、学术基准测试。 |
| 智谱 AI | GLM-5 / GLM-4 | ✅ 全面开源 | 逻辑严谨、主权AI。中文理解极佳,生态完善,尺寸齐全。 | 私有化部署、微调研究、政府/国企项目。 |
| 阿里 (通义) | Qwen-3.5 / Qwen-3 | ✅ 全面开源 | 全能王者。代码、多语言、视觉理解全球领先,社区最活跃。 | 通用应用开发、多模态任务、企业级基座。 |
| 月之暗面 | Kimi K2.5 | ❌ 闭源 | 长文本 & Agent。百万级上下文,自主规划能力极强。 | 法律/金融分析、科研文献、复杂任务自动化。 |
| MiniMax | MiniMax M2.5 | ❌ 闭源 | 代码工程 & 多模态交互。拟人化交互、游戏/社交场景首选。 | 游戏NPC、社交应用、代码辅助。 |
| 百度 (文心) | 文心 5.0 | ❌ 闭源 | 知识图谱融合。依托搜索实时数据,事实性准确率高。 | 搜索增强、企业知识库、营销文案。 |
| 华为 (盘古) | 盘古 5.0 | ❌ 闭源 | 行业垂直 & 昇腾适配。专为B端行业设计,软硬一体。 | 工业互联网、气象、药物研发、政务。 |
| 字节 (豆包) | Doubao-Pro | ⚠️ 部分开源 | 性价比 & 端侧优化。极致成本控制,移动端响应快。 | 移动端App、高并发C端应用。 |
开源模型对比:
| 定位 | 全能型选手 | 稳健型专家 | 极致推理极客 |
| 最强项 | 综合能力强,多模态、多语言均衡,生态最大。 | 中文语境好,逻辑稳,B端落地经验丰富。 | 数学/逻辑推理、代码、极致性价比。 |
| 架构特点 | 稠密 + MoE 混合,尺寸最全。 | GLM 独特架构,注重长窗口和指令遵循。 | 纯 MoE 架构,激活参数少,推理效率极高。 |
| 社区热度 | ⭐⭐⭐⭐⭐ (全球最高) | ⭐⭐⭐⭐ (国内政企首选) | ⭐⭐⭐⭐⭐ (开发者/学术界最爱) |
| 一句话评价 | “不知道选谁时就选 Qwen,不会错。” | “国企和政府最放心的开源选择。” | “用最低的成本,跑最强的逻辑推理。” |
从何下载大模型
- Hugging Face = AI 界的 GitHub (全球通用):资源最全、国际标准、开发者首选,但在中国访问困难。
- 魔搭社区 (ModelScope) = AI 界的 Gitee (中国本土):阿里发起、国内访问极速、中文友好、针对国内合规优化。
核心区别:
| 归属/背景 | 美国公司 (全球最大 AI 社区) | 阿里巴巴达摩院 (中国最大 AI 社区) |
| 网络访问 | 🇨🇳 国内极慢/经常无法访问需梯子或镜像站 | 🇨🇳 国内极速阿里云骨干网支持,无需梯子 |
| 模型资源量 | 🌍 全球最全几乎所有首发模型都会上传 HF | 🇨🇳 国内最全 + 部分国际国产模型首发地,国际模型同步稍慢 |
| 下载速度 | 🐢 国内通常只有几十 KB/s (甚至超时) | 🚀 国内可达几十 MB/s (跑满带宽) |
| 主要语言 | 英语为主 (国际化) | 中文为主 (本土化) |
| 合规性 | 遵循国际法律,内容较自由 | 严格遵循中国法律法规敏感模型会被下架或审核 |
| 特色功能 | Spaces (在线 Demo), Datasets, Papers | ModelStudio (创空间), 灵积 (API 市场), 数据集 |
| 工具链兼容 | transformers, diffusers (原生支持) | modelscope (SDK), 兼容 transformers |
| 典型用户 | 全球研究者、海外开发者、前沿探索者 | 中国开发者、企业用户、高校学生 |
如果需要部署国内大模型,就选ModelScope,如果部署国外大模型就选Hugging Face
私有化部署开源大模型工具
- Ollama = “开箱即用”的极简体验(适合个人开发者、本地测试、快速上手)。
- vLLM = “极致性能”的生产引擎(适合企业部署、高并发服务、生产环境)。
两者核心区别如下:
| 定位 | 个人/开发者的本地运行工具 | 高性能推理服务框架 |
| 上手难度 | ⭐ (极低,一行命令启动) | ⭐⭐⭐ (需配置 Python 环境、参数调优) |
| 核心优势 | simplicity (简单)、跨平台、自动量化 | Throughput (吞吐量)、高并发、PagedAttention |
| 推理速度 | 中等 (适合单用户交互) | 极快 (适合多用户同时访问) |
| 并发能力 | 弱 (主要优化单路对话) | 极强 (支持连续批处理 Continuous Batching) |
| 量化支持 | 内置自动量化 (默认加载 4-bit/5-bit) | 需手动转换模型格式 (AWQ/GPTQ/FP8) |
| API 兼容 | 自有 API (兼容 OpenAI 部分接口) | 完全兼容 OpenAI API |
| 操作系统 | Windows, macOS, Linux | 主要 Linux (Windows 支持尚在完善中) |
| 显存管理 | 自动管理,简单粗暴 | 精细控制 (PagedAttention 技术) |
| 典型场景 | 本地写代码助手、个人知识库、快速测试模型 | 企业内部大模型服务、高流量 API 网关、SaaS 后端 |
基于vLLM本地私有化部署开源大模型
购买云算力服务器
因为我本地 mac m1 笔记本,并无显卡,所以就购买云算力服务器,至于需要购买多大显存、内存、存储的的服务器,可以把要部署的模型名称丢给千问,千问会帮我们估算需要什么配置的服务器,我们参考着购买即可。 我选择的 AutoDL算力云服务器,推荐选按量计费方式,晚上睡觉休息可以关机不扣费。 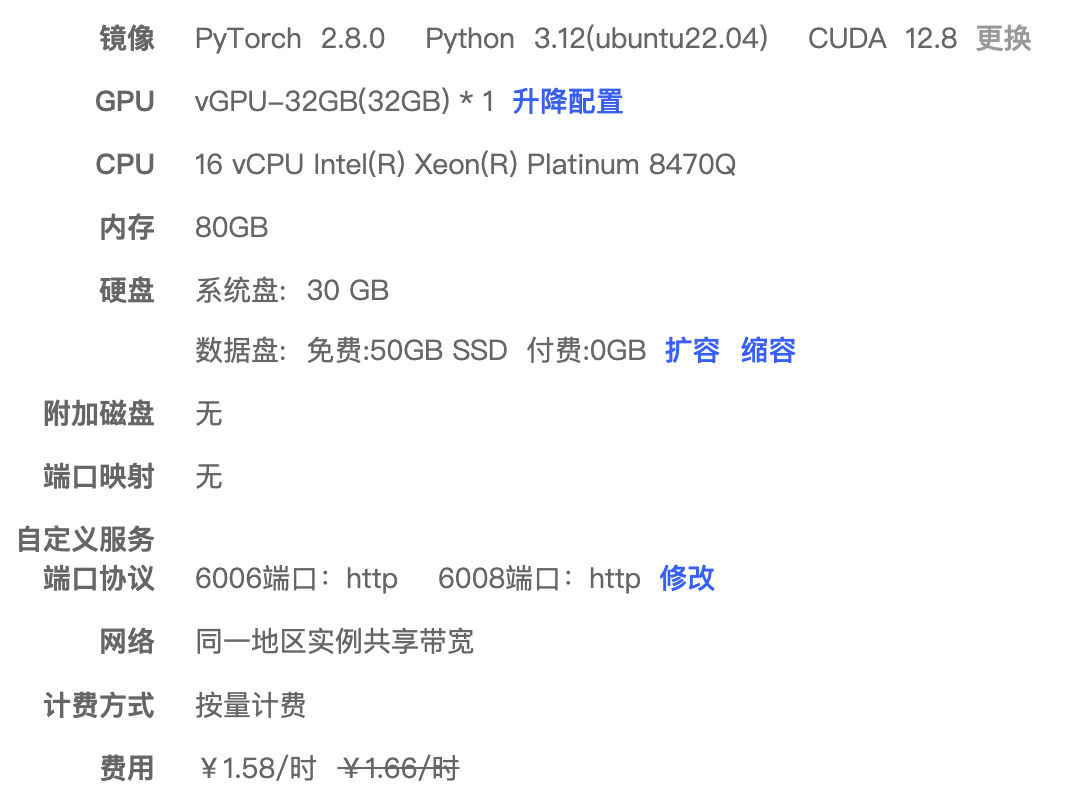
安装 vLLM部署工具
# 安装vllm
pip install vllm
# 查看安装的版本
vllm -v
0.17.0
下载Qwen/Qwen3.5-0.8B模型
魔塔模型详情页有下载方式介绍: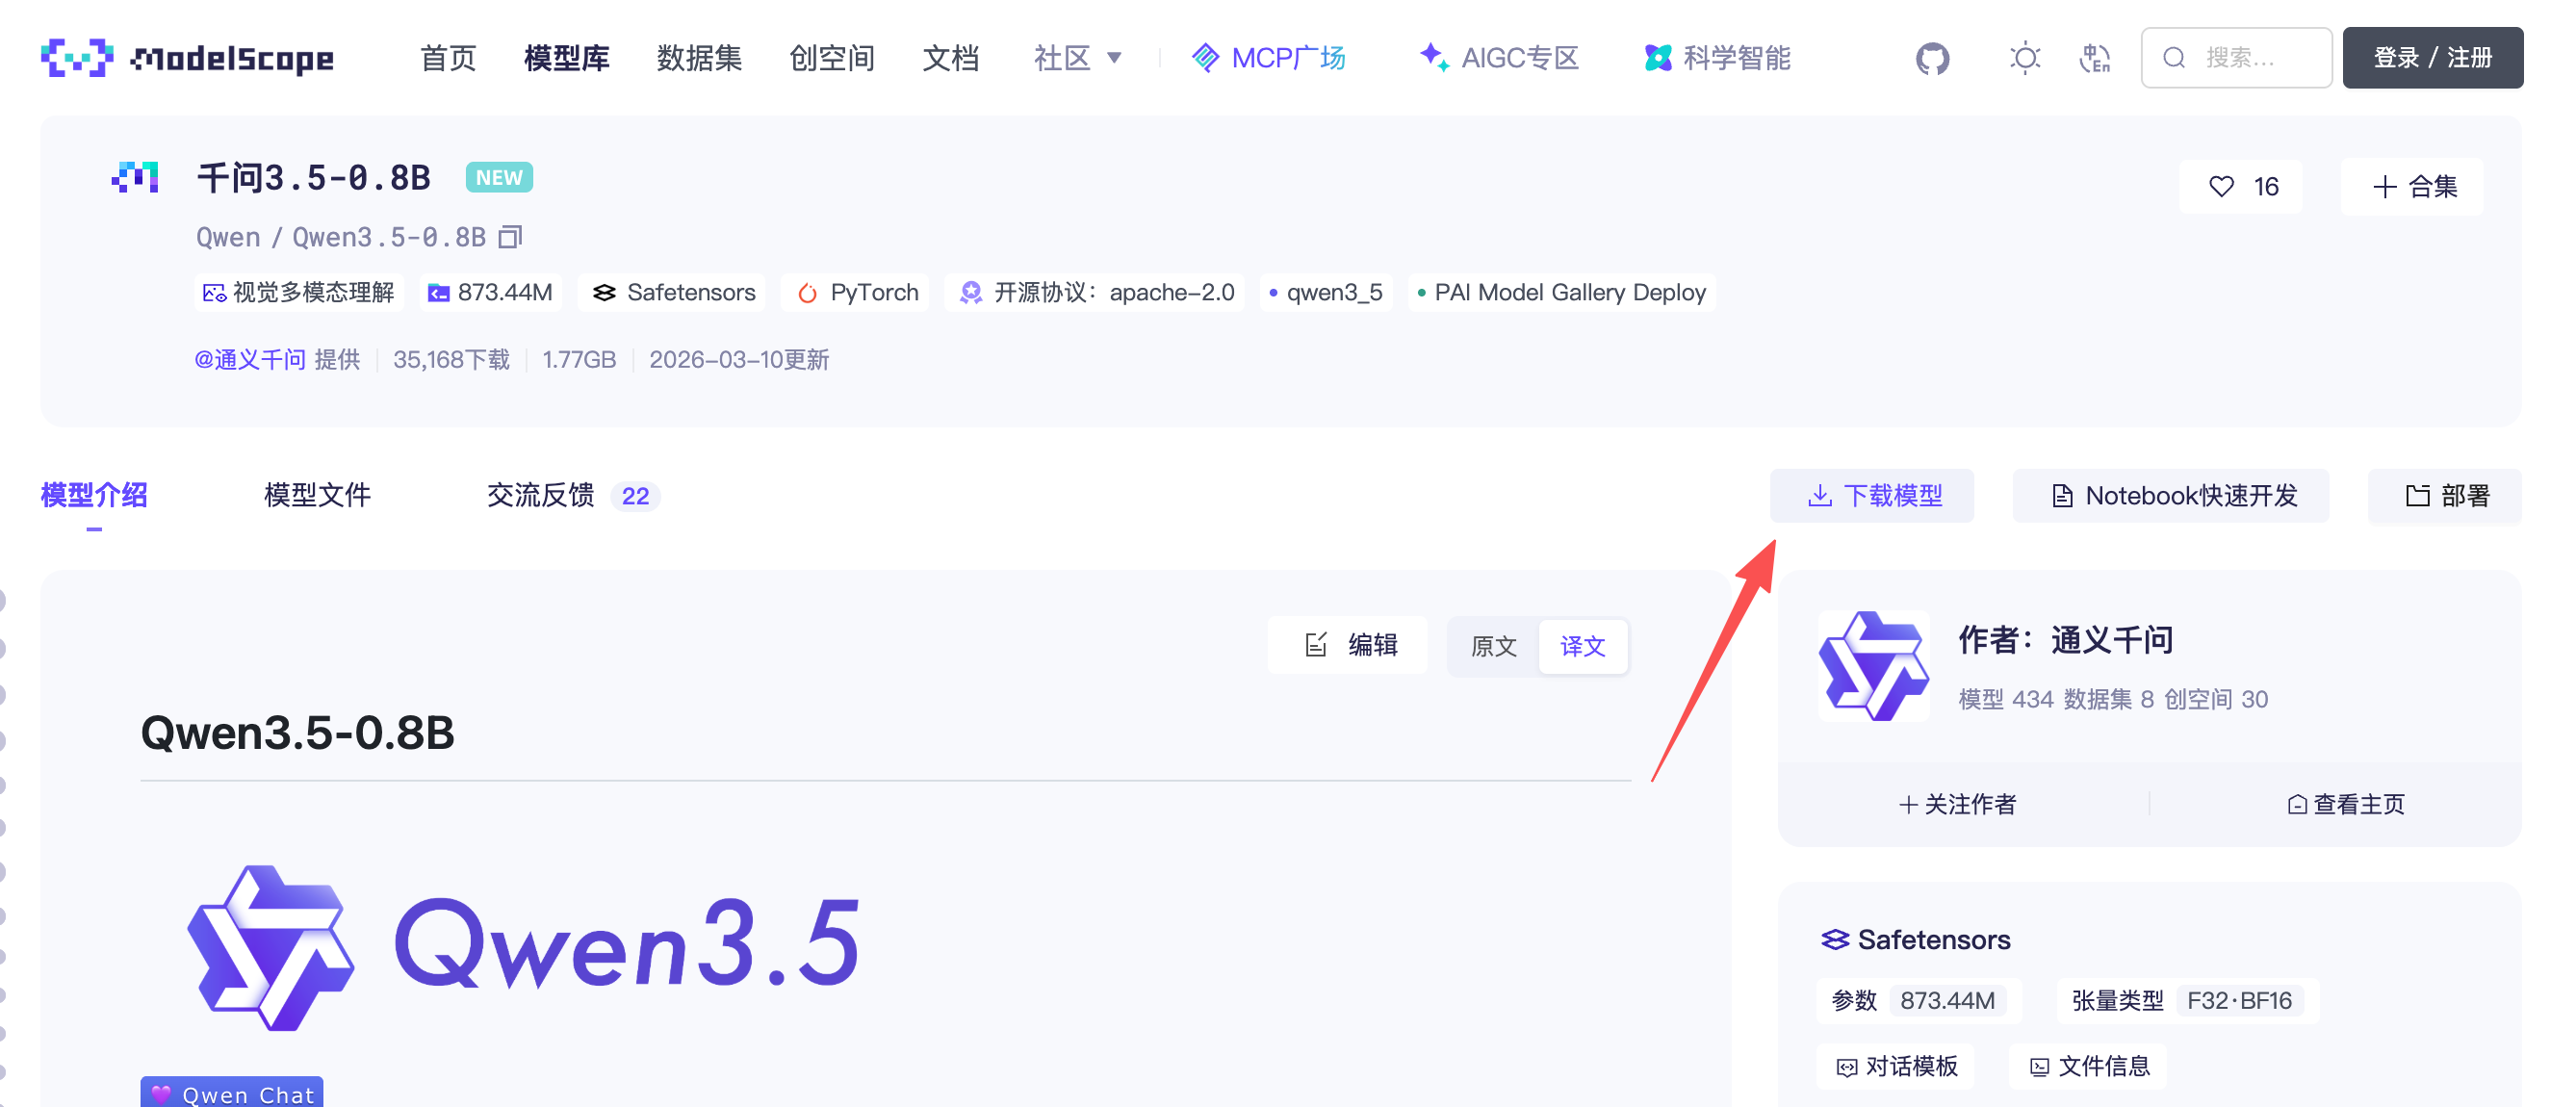
进入算力云服务器终端界面: 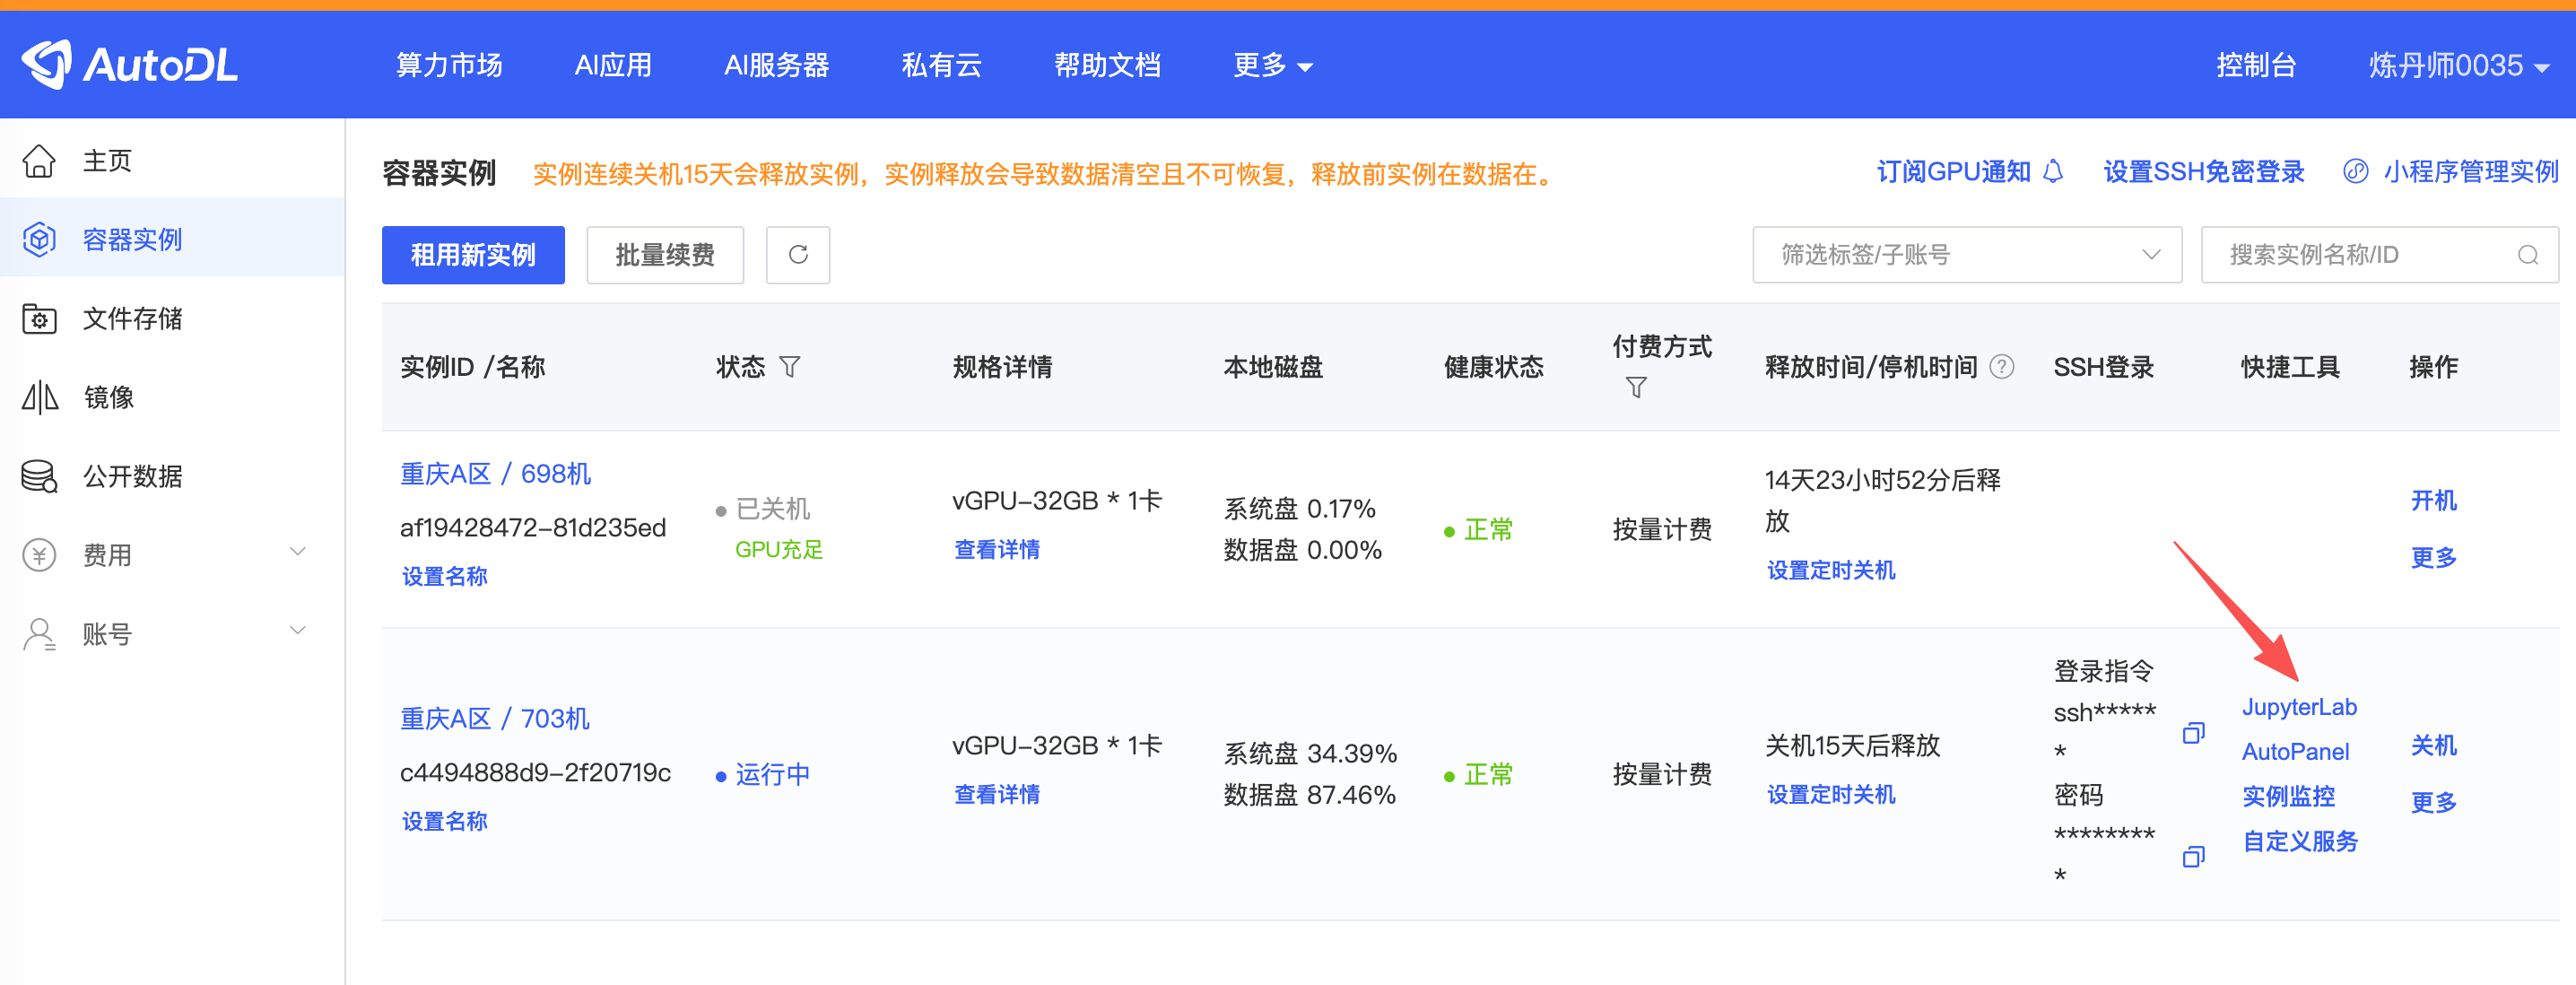
创建目录和代码文件: 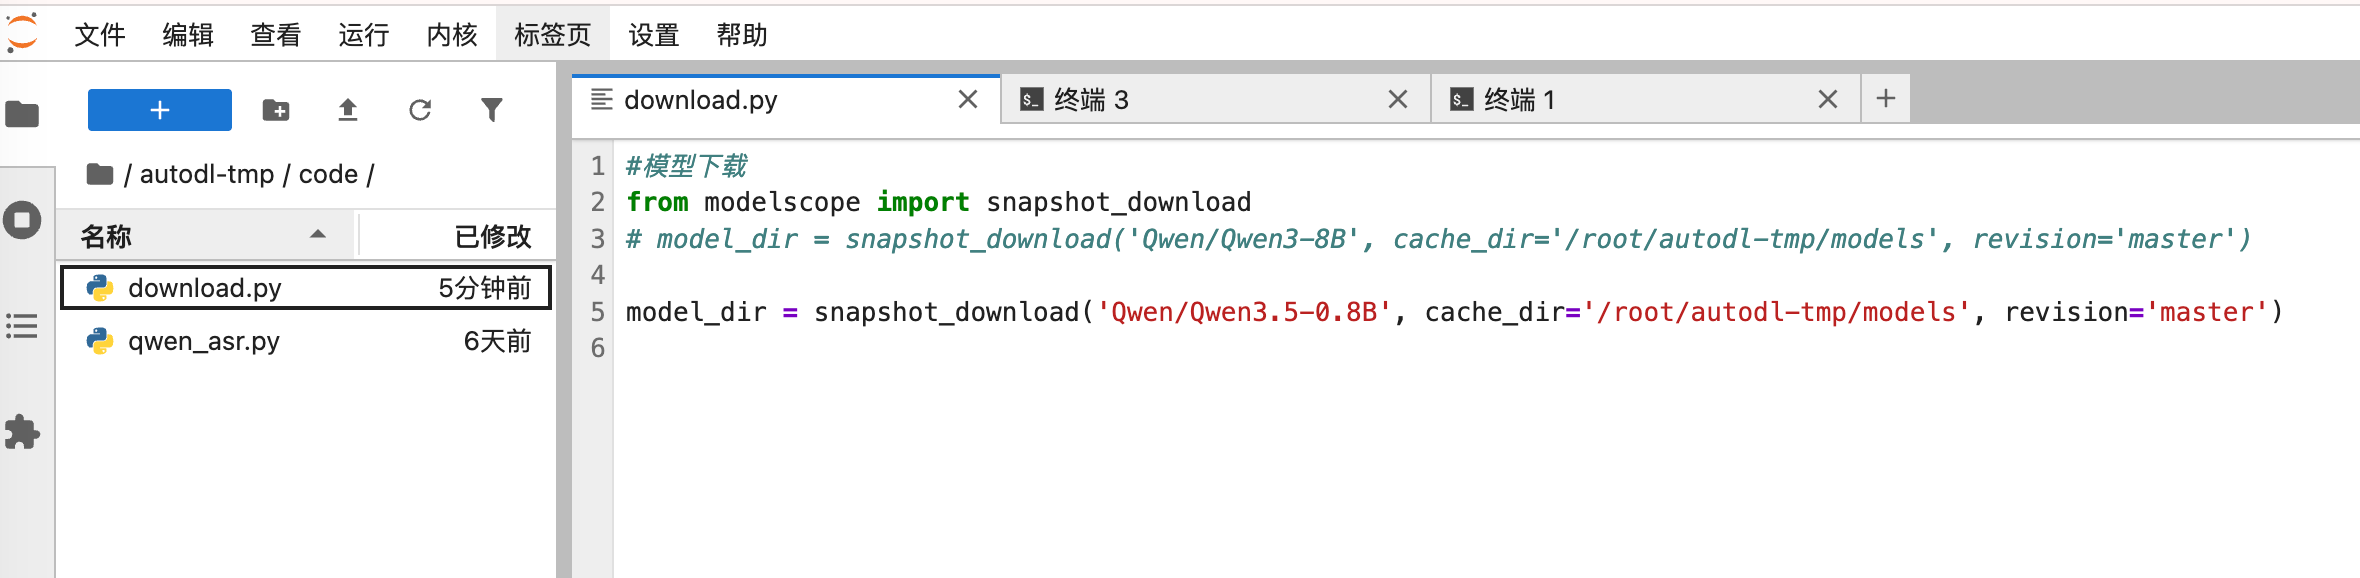
我选择 sdk 方式下载,在算力云服务器编写下载模型代码:
#模型下载
from modelscope import snapshot_download
# model_dir = snapshot_download('Qwen/Qwen3-8B', cache_dir='/root/autodl-tmp/models', revision='master')
model_dir = snapshot_download('Qwen/Qwen3.5-0.8B', cache_dir='/root/autodl-tmp/models', revision='master')
下载模型:
python autodl-tmp/code/download.py
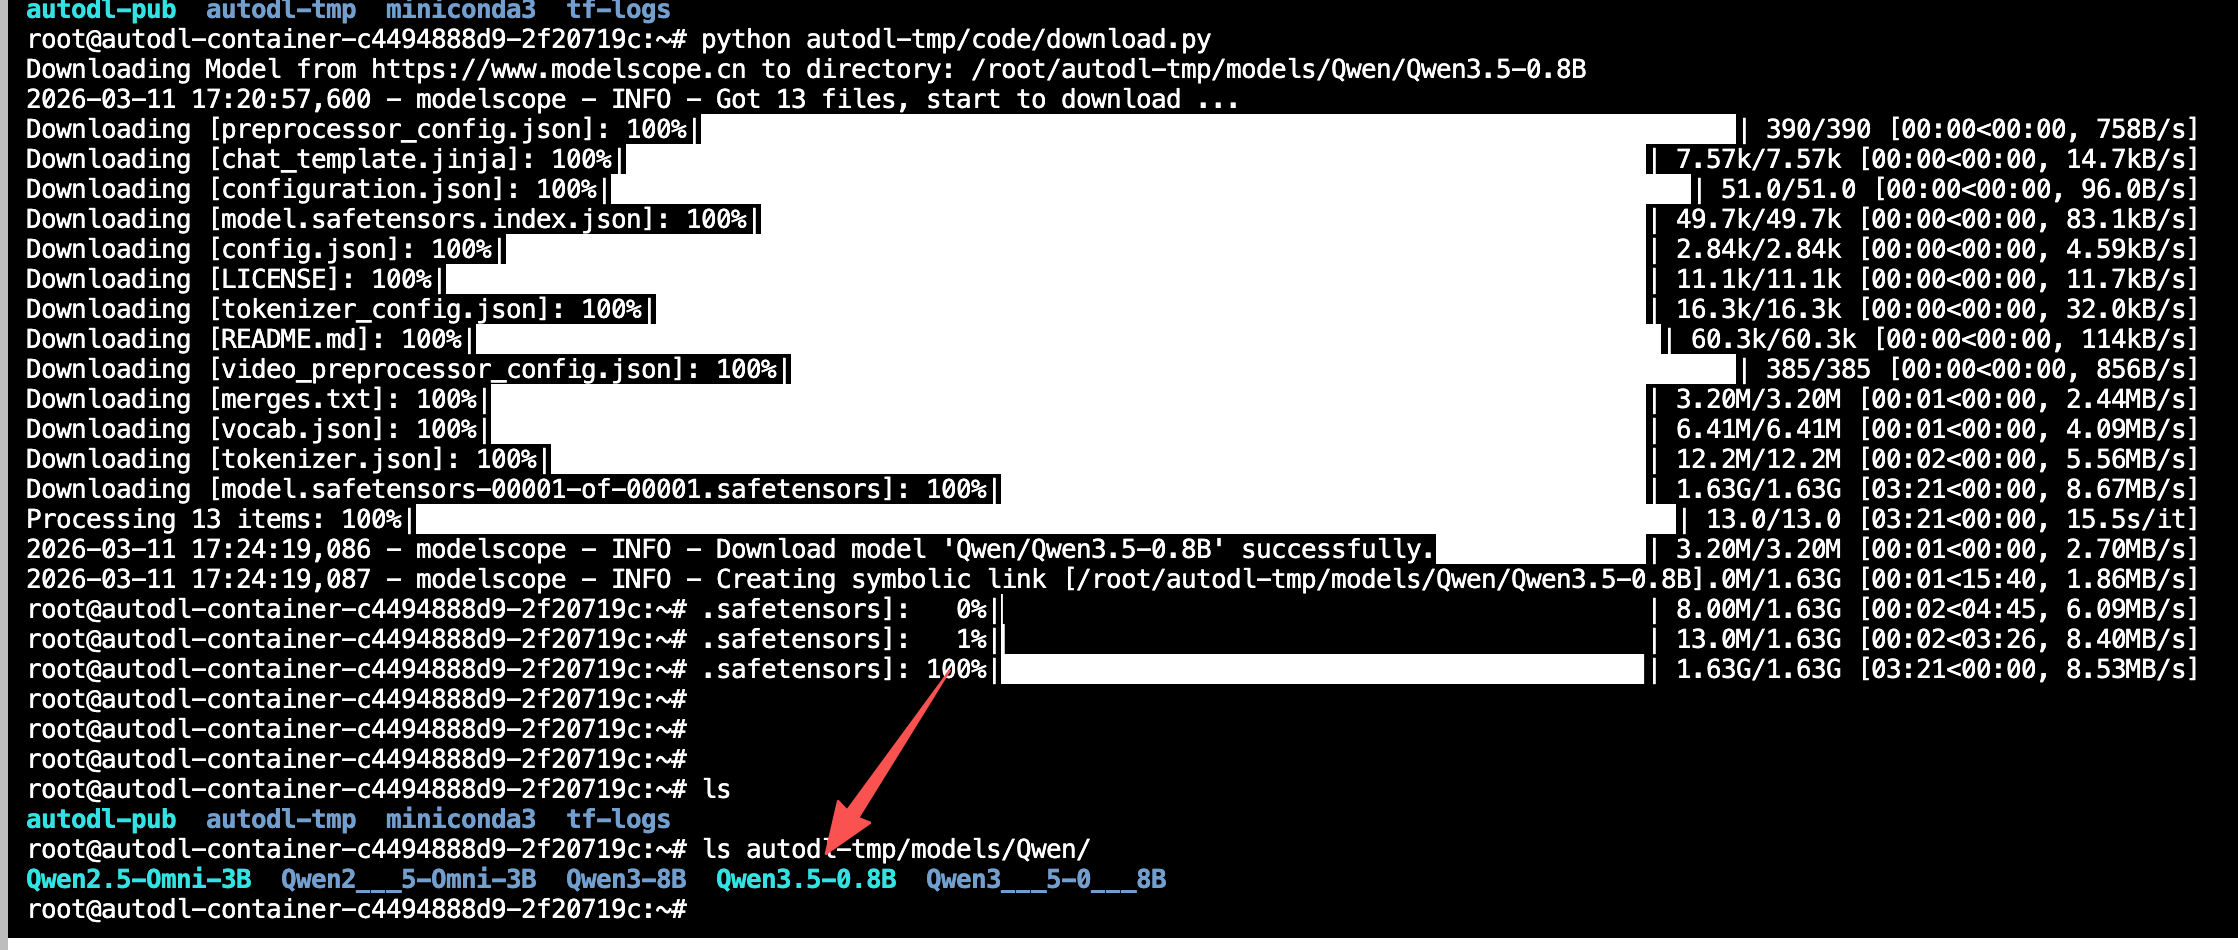
部署Qwen/Qwen3.5-0.8B模型
在服务器终端执行部署命令:
python -m vllm.entrypoints.openai.api_server \\
–model /root/autodl-tmp/models/Qwen/Qwen3.5-0.8B \\
–served-model-name qwen3.5-0.8b \\
–max-model-len 8192 \\
–host 0.0.0.0 \\
–port 6006 \\
–dtype float16 \\
–gpu-memory-utilization 0.8 \\
–enable-auto-tool-choice \\
–tool-call-parser hermes
由于我们购买算力云服务器是没有公网 ip 的,所以我们需要建立 ssh 隧道,使得本地网络可以访问服务器上部署的大模型服务。 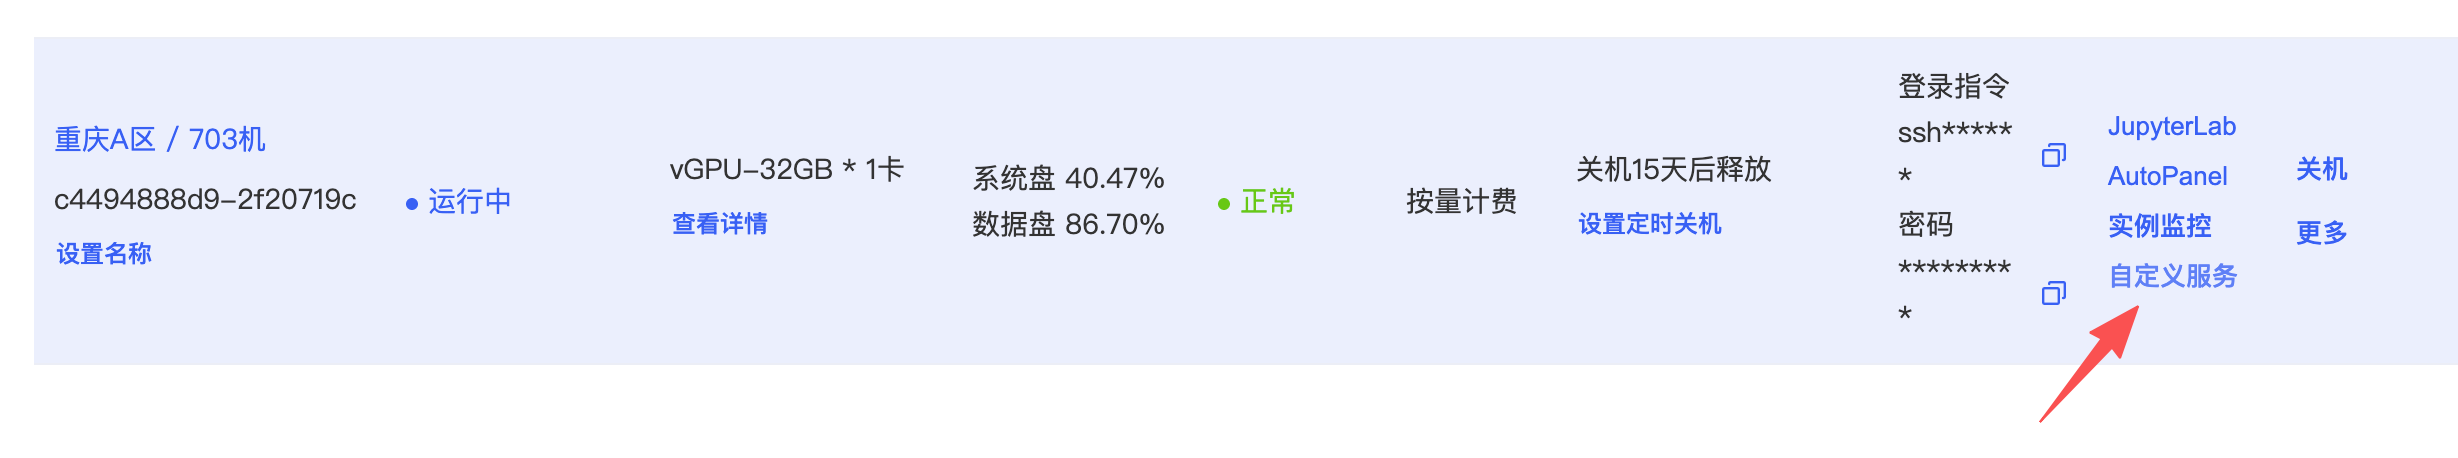
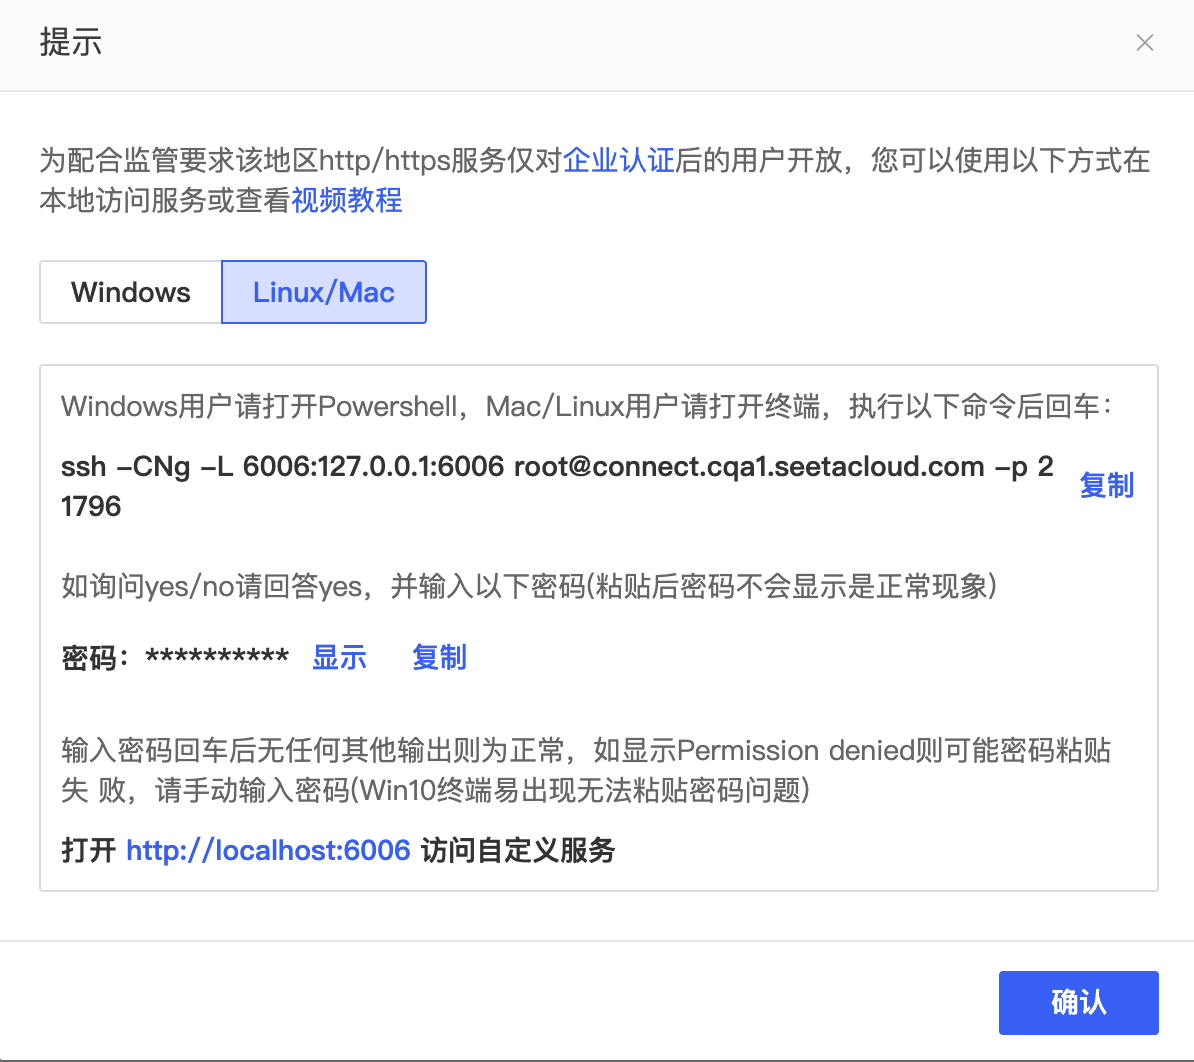
浏览器访问:http://localhost:6006/docs,就可以看到 vllm 部署大模型后fastapi 接口文档了: 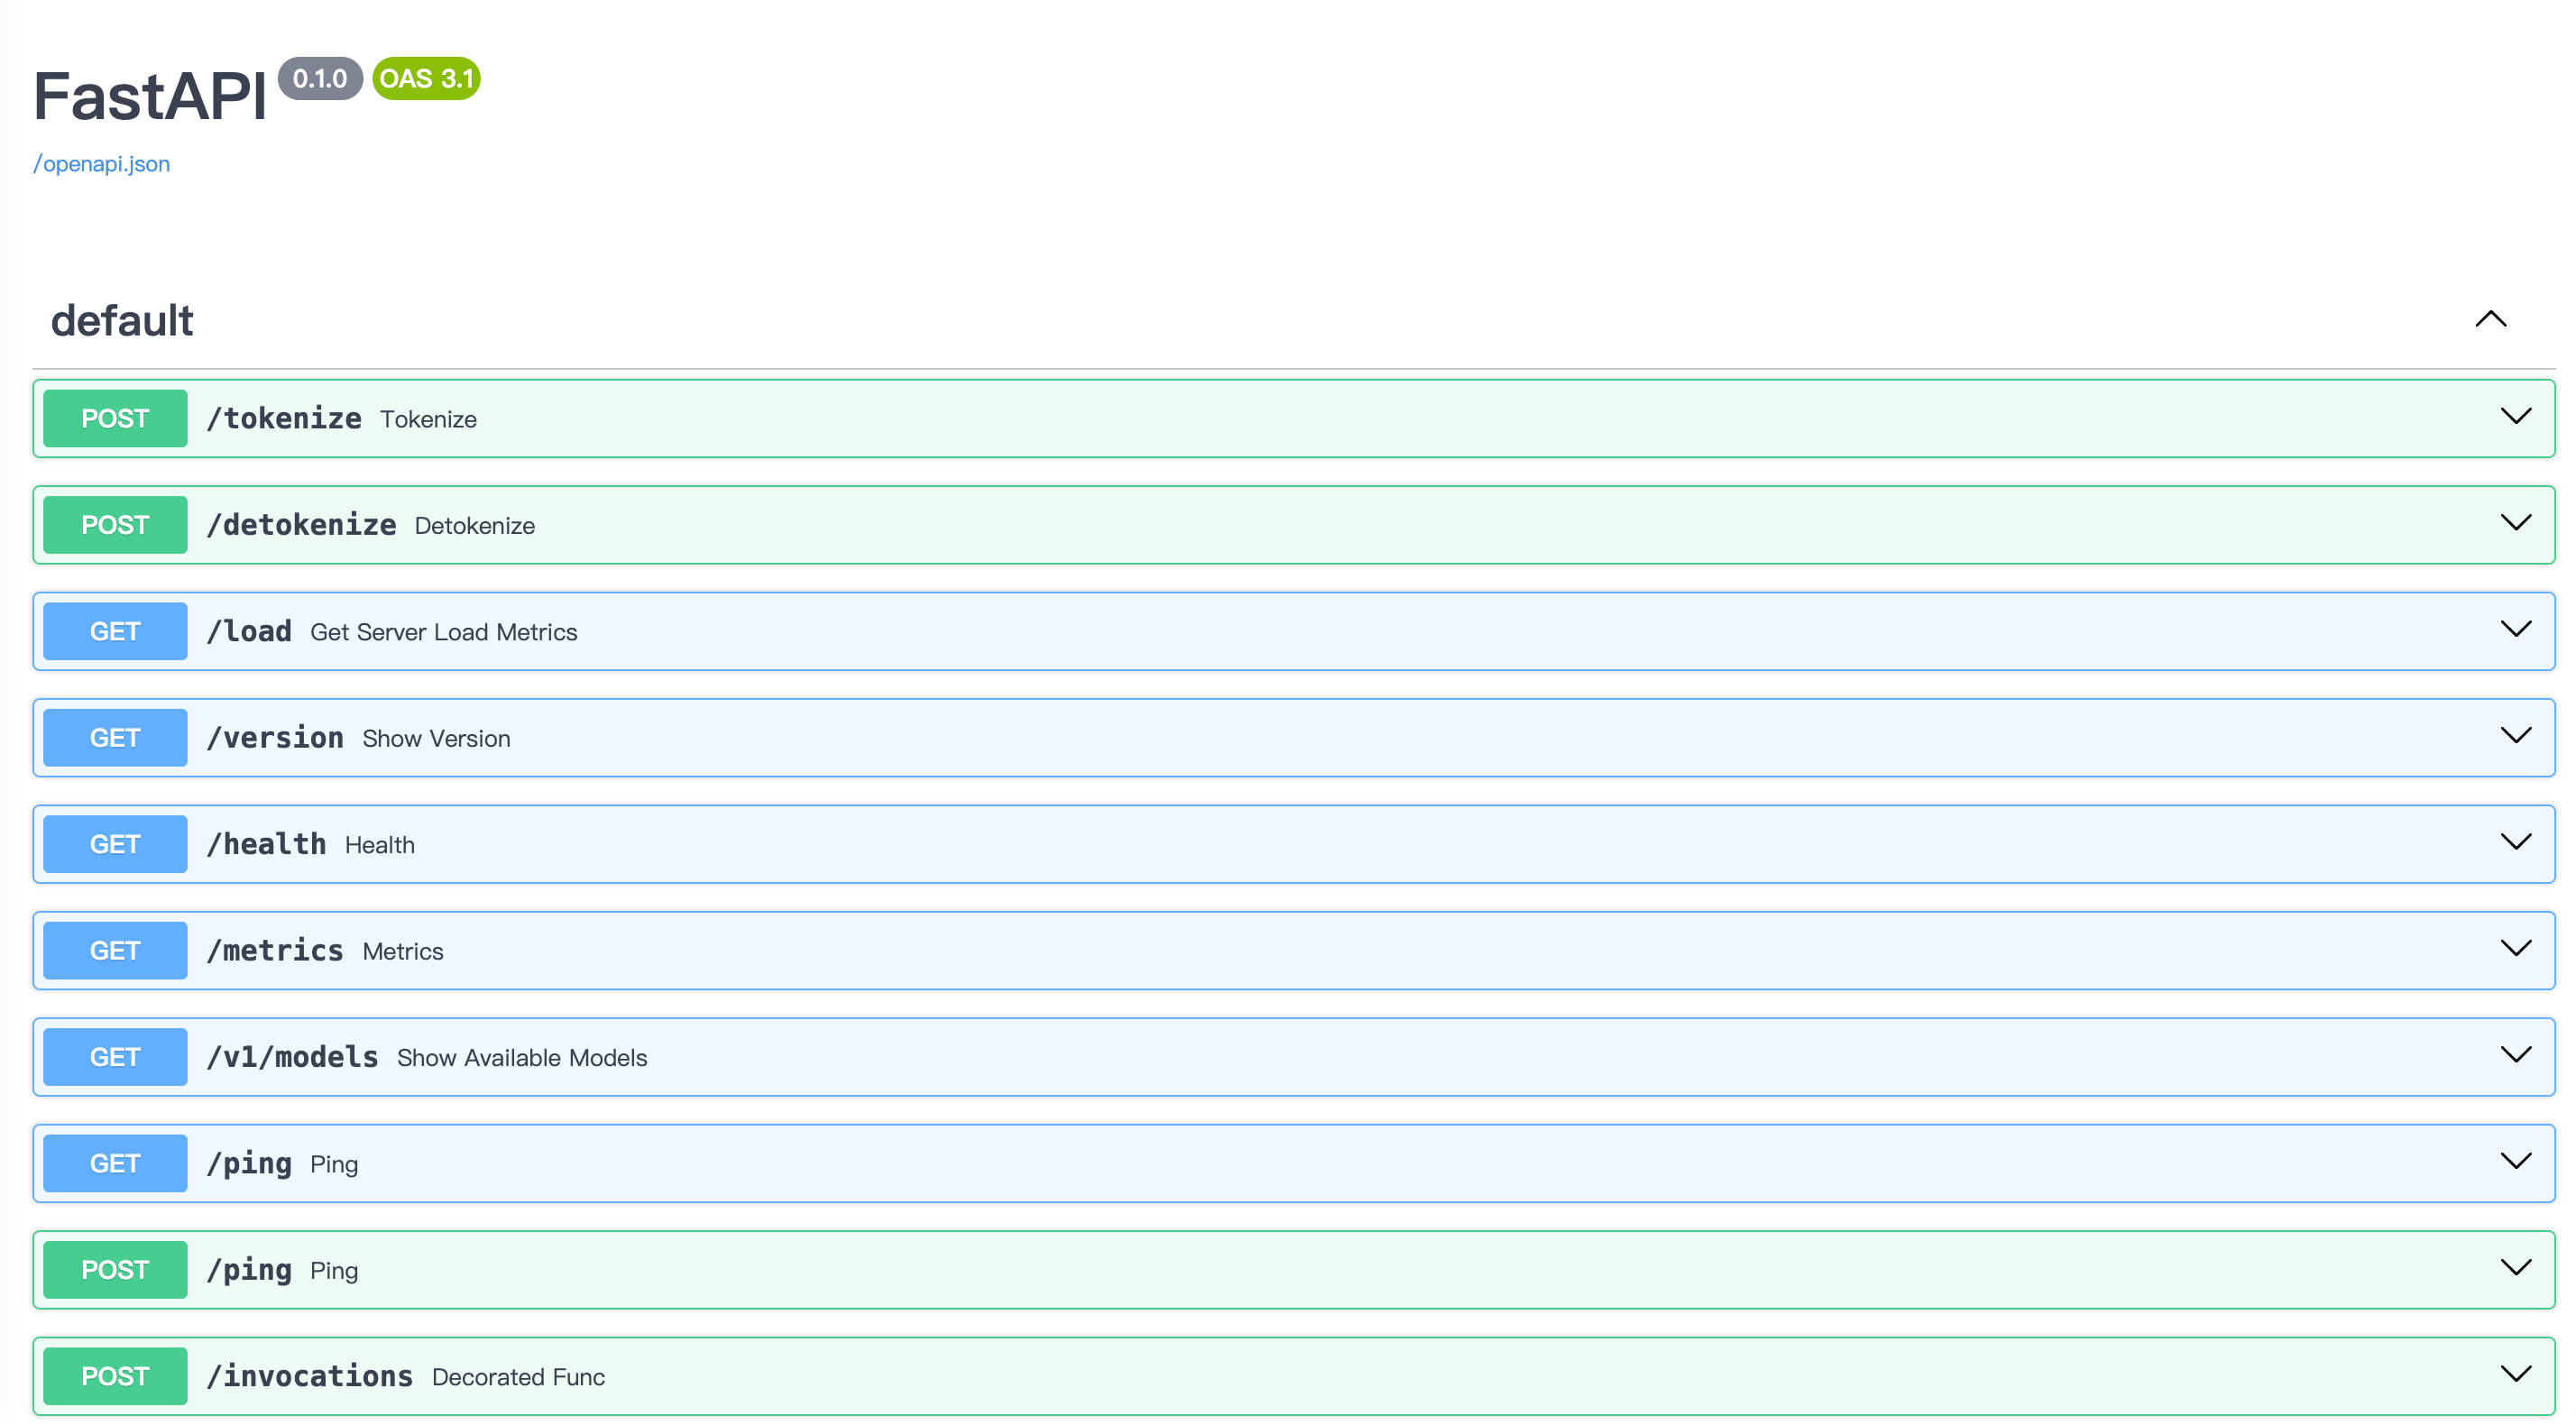
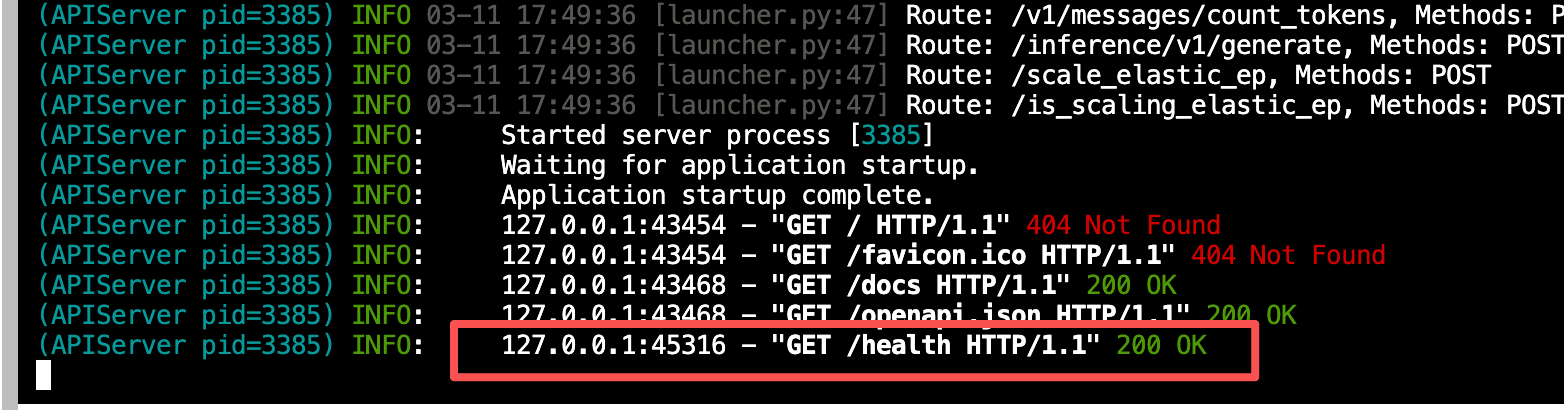
调下检查健康的接口,是能看到接口请求成功返回 200: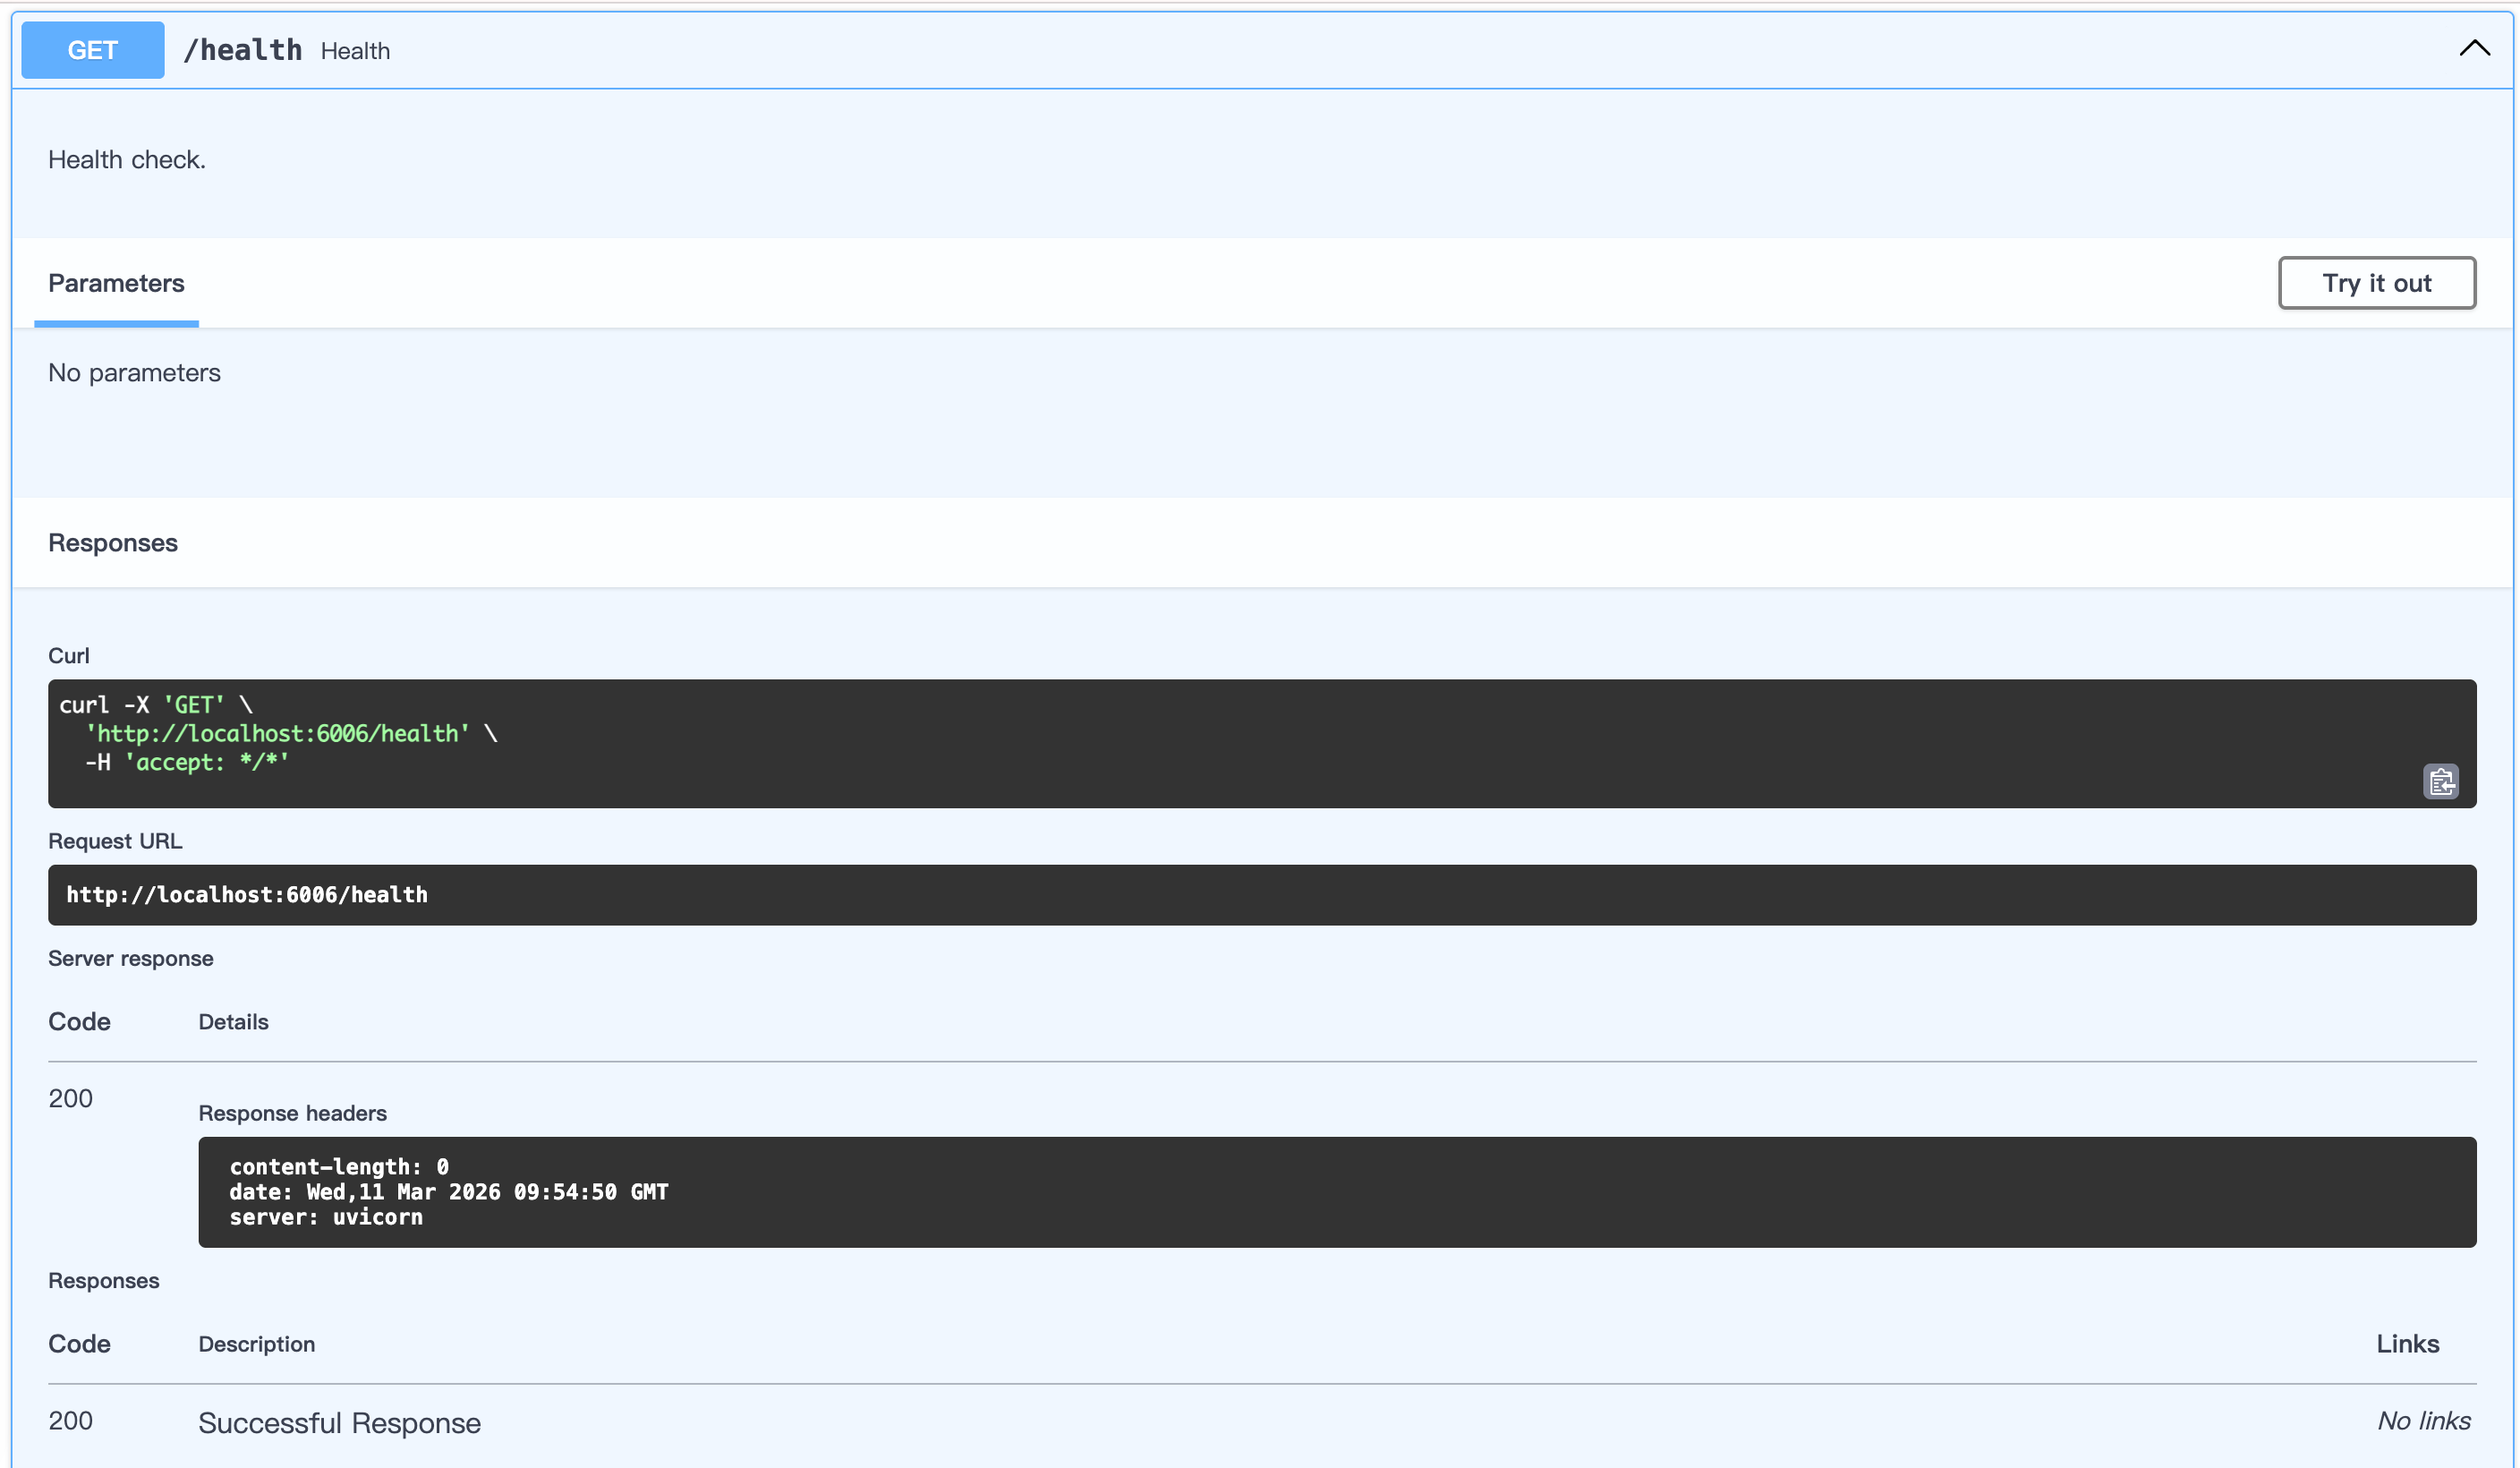
下载deepseek-ai/DeepSeek-R1-0528-Qwen3-8B模型
修改模型下载代码:
#模型下载
from modelscope import snapshot_download
# model_dir = snapshot_download('Qwen/Qwen3-8B', cache_dir='/root/autodl-tmp/models', revision='master')
model_dir = snapshot_download('deepseek-ai/DeepSeek-R1-0528-Qwen3-8B', cache_dir='/root/autodl-tmp/models', revision='master')
执行代码下载模型:
python autodl-tmp/code/download.py
部署deepseek-ai/DeepSeek-R1-0528-Qwen3-8B模型
python -m vllm.entrypoints.openai.api_server \\
–model /root/autodl-tmp/models/deepseek-ai/DeepSeek-R1-0528-Qwen3-8B \\
–served-model-name ds-qwen3-8b \\
–max-model-len 8192 \\
–host 0.0.0.0 \\
–port 6006 \\
–dtype float16 \\
–gpu-memory-utilization 0.8 \\
–enable-auto-tool-choice \\
–tool-call-parser hermes
本地私有化部署开源大模型比较简单,只要有服务器硬件条件满足能部署,下载模型–>安装 vllm–>部署。