目录
一、冒泡排序
(一)基本思想
(二)优化思路
(三)代码实现
(四)复杂度与稳定性
二、快速排序
(一)基本思想
(二)递归函数的实现
(三)分区的实现方法
(四)三路划分
(五)自省排序
(六)复杂度与稳定性
三、非递归版本快速排序
(一)操作步骤
(二)代码实现
一、冒泡排序
(一)基本思想
通过相邻元素的比较和交换,将值较大的元素逐步 “冒泡” 到数组末尾,值较小的元素逐步 “浮” 到数组前端。
(二)优化思路
添加 exchange 标记,若某一趟排序中未发生交换,说明数组已有序,直接跳出循环,减少不必要的比较。
(三)代码实现
void Swap(int* x, int* y)
{
int tmp = *x;
*x = *y;
*y = tmp;
}
// 冒泡排序
void BubbleSort(int* arr, int n)
{
int exchange = 0; // 标记是否发生交换
for (int i = 0; i < n; i++)
{
exchange = 0;
for (int j = 0; j < n – i – 1; j++)
{
if (arr[j] > arr[j + 1])
{
//最后j的极限值越来越小,因为每次最后一个元素都可以有序,
//即最大的元素到最后,
//所以最后一个元素就不用比较了。
Swap(&arr[j], &arr[j + 1]);
exchange = 1; // 发生交换,标记为1
}
}
if (exchange == 0)
break; // 无交换,数组有序,退出
}
}
(四)复杂度与稳定性
1、时间复杂度
(1)最坏情况:数组为降序,需 n(n-1)/2 次比较和交换,时间复杂度O(n²)。
(2)最好情况:数组为升序,仅需 n-1 次比较,时间复杂度O(n)。
(3)平均情况:时间复杂度O(n²)。
2、空间复杂度
仅使用常数个额外变量,空间复杂度O(1)。
3、稳定性
稳定。相邻元素交换仅在 arr[ j ] > arr[ j + 1] 时发生,相等元素不会交换,保持相对顺序。
二、快速排序
(一)基本思想
快速排序是 Hoare 于 1962 年提出的二叉树结构的交换排序方法,核心思想为 “分治法”:
1、选基准值:任取待排序区间中一个元素作为基准值(一般为区间首元素)。
2、分区操作:将区间分割为两部分,左部分所有元素 < 基准值,右部分所有元素 > 基准值,基准值放在最终位置(称为 “keyi”)。
3、递归处理:对左、右两部分重复步骤 1-2,直至所有区间长度为 1(有序)。
(二)递归函数的实现
该排序一般要通过两个函数完成,一个函数负责选基准值与分区,一个函数负责递归。
我们先完成实现分区的函数,然后在负责递归的函数中调用它。完成分区后,接收返回的基准值下标,然后进行递归。
此时会对基准值左边和右边的数据,完成相同的操作,直到分区只剩一个数据,这就是递归出口,此时就完成了所有数据的排序。
void QuickSort(int* arr, int left, int right)
{
//递归出口
//如果left>=right就说明只剩下一个结点了,此时无需操作了
if (left >= right)
return;
//实现分区、同时接收基准值下标
int keyi = _QuickSort1(arr, left, right);
//实现递归
//left keyi right
//左序列:[left,keyi-1] 右序列:[keyi+1,right]
QuickSort(arr, left, keyi – 1);
QuickSort(arr, keyi + 1, right);
}
(三)分区的实现方法
1、Hoare 版本
分区的操作思路是一个指针left在最左边往右遍历,一个指针right在最后边往左遍历。
right往左遍历找到比基准值要小的数据,left往右遍历找到比基准值要大的数据,找到之后如果 left <= right 就进行交换。重复上述步骤,直到 left 走到 right 右边为止,即 left <= right。
最后将首元素基准值与right位置的元素进行交换,即完成分区操作。
问题1:为什么循环条件是while (left <= right),不可以left < right吗?
一定要有left = right,而不能是left < right,比如数组[6,1,2,8,7,9],已经交换到最后一步了,left与right都指向8。
此时如果直接结束了循环,2与8交换位置,变成了[8,1,2,6,7,9],这样就直接乱套了。
只有此时,再进去判断,让right向左走一步,此时,此时交换变成[2,1,6,8,7,9],保证左边小于6,右边大于6才对。
这样也可以在全部数字都相同的数组中,减少递归次数。
问题2:为什么基准值是与right所在的位置换位?
因为 right 指针是往前找,找小的元素;left 指针是往后找,找大的元素。所以此时如果与 left指针所在位置交换,就把大的元素交换到前面去了;所以要与right指针指向的元素进行交换,将小的元素交换到前面。
#include"Sort.h"
void Swap(int* x, int* y)
{
int tmp = *x;
*x = *y;
*y = tmp;
}
// Hoare版本进行分区
int _QuickSort1(int* arr, int left, int right)
{
int keyi = left;
left++;
while (left <= right)
{
// 右指针找小,所以大的话就继续往前找
while (left <= right && arr[right] > arr[keyi])
right–;
// 左指针找大,所以小的话就继续往后找
while (left <= right && arr[left] < arr[keyi])
left++;
// 交换
if (left <= right)
Swap(&arr[left++], &arr[right–]);
}
// 基准值归位
Swap(&arr[keyi], &arr[right]);
return right;
}
2、挖坑法
挖坑法的思路就是:第一步,保存基准值。
然后,right指针向左移动,找一个小于基准值的数据,找到之后,填到 left 指针所在的位置,也就是坑里面。然后坑就变成了变成了 right 指针所在的位置。
此时 left 指针,向右移动,找一个大于基准值的数据,找到之后,填到 right 指针所在的位置, 也就是坑里面。然后坑就变成了left指针所在的位置。
一旦 left 与 right 相交了,结束分区,此时该位置再让基准值上去就可以了。
从头到尾,消失的只有基准值这一个数据,所以说相互覆盖是根本不会出现数据丢失的。而且基准值还使用 key 保存下来了,所以最后将基准值赋值到两个指针交汇的地方即可。
此时可能 left == hole,也有可能 right == hole,这都无所谓了,最后 arr[hole] = key 即可。
int PartitionHole(int* arr, int left, int right)
{
int hole = left;
int key = arr[hole]; // 基准值
while (left < right)
{
// 右找小,填左坑
while (left < right && arr[right] >= key)
right–;
//此时相遇了,避免自己赋值给自己,就不用交换数据了
if(left < right)
{
arr[hole] = arr[right];
hole = right;
//减少下一次遍历时,填入元素与基准值的比较;
//这个比较是没必要的,填入的一定是更小的值。
left++;
}
// 左找大,填右坑
while (left < right && arr[left] <= key)
left++;
//此时相遇了,避免自己赋值给自己,就不用交换数据了
if(left < right)
{
arr[hole] = arr[left];
hole = left;
//减少下一次遍历时,填入元素与基准值的比较;
//这个比较是没必要的,填入的一定是更大的值。
right–;
}
}
arr[hole] = key; // 基准值填坑
return hole;
}
3、 前后指针法
注:此处根据描述可画图辅助理解。
指针只是一个概念性的说法,实际上只是一个数字,创建两个前后遍历prev、cur.
cur探路,从左往右找比基准值要小的数据,找比基准值要小的数据。
① cur指向的数据比基准值要小,++prev,perv 和 cur交换,cur++,如果说在同一个位置,可以不交换,节省资源。
② cur指向的数据不比基准值要小,cur++,这个时候,prev与cur的身位就拉出来了。
身位拉开的原因是发现大的数据了,此时prev与cur之间的数据,就一定比基准值要大或者而等于基准值。
所以一旦 cur 发现了比基准值要小的数据,prev走前一步,将数据进行交换,就一定将大的移到了后面,小的移到了前面。
cur越界后,基准值与prev交换位置,因为prev位置指向的永远是交换过去的小数据。 总结一下就是,cur用来探路找小,prev用来占位置,最后在的位置一定是小的。
void Swap(int* x, int* y)
{
int tmp = *x;
*x = *y;
*y = tmp;
}
int _QuickSort2(int* arr, int left, int right)
{
int keyi = left;
int prev = left;
int cur = prev + 1;
while(cur <= right)
{
if (arr[cur] < arr[keyi] && ++prev != cur)
Swap(&arr[prev], &arr[cur]);
++cur;
}
Swap(&arr[prev], &arr[keyi]);
return prev;
}
(四)三路划分
1、什么是三路划分
三路划分是保证分区效率,解决重复元素妨碍划分的一个有效方法。
决定快排性能的关键点是每次单趟排序后,基准值keyi对数组的分割,如果每次选keyi基本二分居中,那么快排的递归树就是颗均匀的满二叉树,性能最佳。
此时递归形成的二叉树层数为 logn,所以快排的最佳时间复杂度是O(nlogn)。但是实践中虽然不可能每次都是二分居中,但是性能也还是可控的。
如果出数组中元素完全一样,那么此时一次只能分出一个元素,此时的的二叉树的层数就是 n,那么时间复杂度就是O(n²)。
所以为了程序中出现部分数字相同的问题,我们提出了三路划分的方法。将所有数据分成三个部分:比基准值小的放左边,比基准值大的放右边,与基准值相同的放中间。
三路划分通过一次性处理所有相同元素,避免无效递归和重复比较,大幅提升了含大量重复元素场景的排序效率。
三路划分仅需一次遍历,就将所有相同元素锁定在 “等于区间”,后续不再对其进行任何比较或交换操作,使得子问题规模大幅缩小。
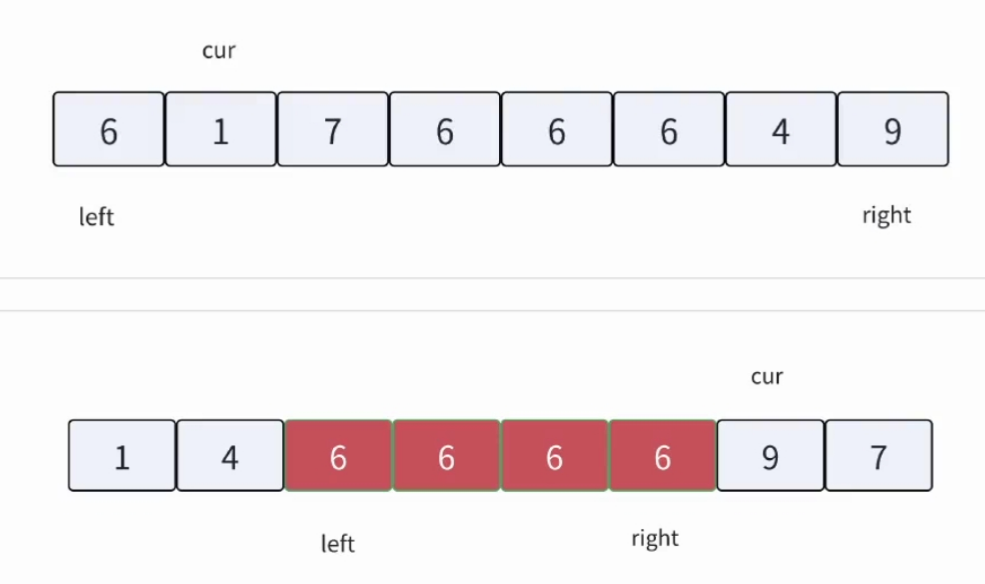
2、三路划分的算法步骤与思想
(1)基准值 key 默认取 left 位置的值,进行值的保存
(2)left 指向区间最左边,right 指向区间最右边,cur 指向 left + 1 位置。
(3)cur 遇到比 key 小的值后跟 left 位置交换,换到左边,left++,cur++。
因为最左边此时已经是比基准值要小的数据,所以 left++,该位置数据不需要再交换,继续指向基准值;然后此时 cur 因为交换又会指向基准值,但是基准值与基准值比较没有意义,所以cur++,继续比较下一个元素。
(4)cur 遇到比 key 大的值后跟 right 位置交换,换到右边,right–,cur 不变。
因为最右边此时已经是比基准值要大的数据,所以 right–,该位置数据不需要再交换,比较下一个元素。此时因为不确定 cur 指向位置数据的大小(right位置还过去的数据,大小不定),所以 cur 不动,继续与 key 进行比较,看看与 left 还是 right 进行交换。
(5)cur 遇到跟 key 相等的值后,cur++。
(6)直到 cur > right 结束。
★ 为什么等于基准值的区间为[ left , right ]?
划分结束你会发现,left 永远指向基准值区间的第一个的位置,right永远指向基准值区间的最后一个位置。
因为 cur 找到小的与 left 交换,此时都加1,left继续指向基准值;cur 遇到大的交换的了,是不会动的,所以保证了 left 继续指向基准值;cur遇到与基准值相等的,cur++,此时 left 指向的就是基准值区间的第一个数据,此时即使下次遇到小的交换了,那么 left 还是指向第一个基准值。
同时因为一旦前面发现的大于 key 的元素,就往右边去放,然后 right–。此时如果 cur 在遇到right之前,找不到大于 key 的元素了,那就证明此时right的前面没有大于 key 的元素了,并且前面一定是基准值。因为如果是小元素,那么基准值也会被换过来。
然后最后一个比较是,left 与 right 相交时。此时如果 right 所在元素大于基准值,那么相当于没有交换,right– 直接指向基准值。如果right所在元素是基准值,那么 cur++,right 自然指向基准值。如果 right 指向元素小于基准值,那么 cur 与 left 交换,基准值就会被换过来 保证 right 最后指向的还是基准值。比较完之后,cur > right ,划分结束。这样保证了 right 指向基准值区间的最后一个位置。
最后三路划分将数组分成三部分:小于基准值 [ low , left -1 ]、等于基准值 [ left , right ]、大于基准值[ right + 1 , high ] 。
3、三路划分的代码实现
因为单读写分区方法,独立为一个函数时,会涉及到传址调用,同时整体的递归函数也会被修改。所以我们把他单独拎出来,分区与递归一起,写为一个函数即可。
void QuickSortThree(int* arr, int left, int right)
{
//递归出口
if (left >= right)
return;
//保存初始值
int begin = left;
int end = right;
//随机选keyi
int randi = left + (rand() % (right – left + 1));
//printf("&d\\n", randi);
Swap(&arr[left], &arr[randi]);
int keyi = arr[left];
int cur = left + 1;
while (cur <= right)
{
// 发现比基准值小段数据时
if (arr[cur] < keyi)
{
Swap(&arr[cur], &arr[left]);
left++;
cur++;
}
//发现比基准值大的数据时
else if (arr[cur] > keyi)
{
Swap(&arr[cur], &arr[right]);
right–;
}
//与基准值相等时
else
cur++;
}
// 进行递归,每一个枝节递推到最底层时,完成排序
// 然后一层层回归,回到出口,结束代码
QuickSortThree(arr, begin, left – 1);
QuickSortThree(arr, right + 1, end);
}
(五)自省排序
1、快速排序的优化方法
前面我们使用随机值作为基准值,避免了在相对有序的数组中,每次都取到最值的情况;同时使用了三路排序解决了数组中有许多相同元素,导致无法均匀分组,使得递归层数变多的问题。
当然,我们还可以使用三数取中的方式,确定基准值,具体写法见于下面。
所以我们优化快速排序就是从两个方面下手:① 选出更恰当的基准值;②更好地分区。对这两方面的优化可以减少递归层数。
选出更恰当的基准值,避免相对有序数组中,取得数组首元素,容易获得最值,导致递归层数增加。此时我们可以使用随机数、三数取中的方式。
更好地分区,我们可以采取三路划分的方法。
虽然用三路划分进行分区是一定可以提高效率的,但是如果选择基准值的方式,只能说尽可能取提高效率,因为随机的东西,它本身就不稳定,所以它不一定可以很好得提升效率。
那么此时我们应该采取更合理的思路,即自省排序。
2、各种排序方法的用处
在解释什么是自省排序前,我们先了解为什么要有这么多排序方式,为什么不创造出一种最好的排序方式。
其实在排序算法的选择中,没有 “绝对最好” 的方法,只有最适配场景的方法。以下是不同场景下的优选策略:
① 若追求平均性能极致
使用快速排序。它的平均时间复杂度为O(nlog n),且常数因子极小,在随机数据、大规模数据场景下实际运行速度最快,是工程中最常用的排序算法之一。
② 若要求时间复杂度绝对稳定
使用堆排序:无论输入数据如何,时间复杂度始终是O(nlog n),能彻底避免 “最坏情况”。但实际运行速度通常慢于快速排序。因为堆的结构导致缓存不友好,且常数因子较大,在平均情况下,其运行速度远不如快速排序。
Tip1:常数因子小:算法的实际执行步骤少、内存访问更高效,即使时间复杂度相同,在具体运行时也会更快。例如快速排序的常数因子很小,因为它的交换、比较操作非常 “直接”,缓存友好性高。
Tip2:常数因子大:算法的实际执行步骤多、内存访问更零散,导致相同时间复杂度下,实际运行速度更慢。例如堆排序的常数因子较大,因为堆的结构会导致频繁的 “跨层” 内存访问,缓存不友好,且堆调整的操作步骤相对繁琐。
③ 若要求排序稳定性(相同元素相对位置不变)
归并排序:时间复杂度 O(nlog n),且是稳定的排序算法,常用于需要保持元素相对顺序的场景(如对象排序)。
冒泡排序、插入排序:虽然时间复杂度高O(n²),但实现简单且稳定,适合小规模数据或已近乎有序的数组。
④ 若处理小规模数据(如长度 < 20)
插入排序:时间复杂度看似 O(n²),但小数据量下常数因子极小,实际运行速度甚至超过快速排序、堆排序。
所以我们既然有这么多的排序方法,我们一开始是以快速排序为方案的,那么当我们发现快速排序好像不太适合这组数据时,我们就要及时止损,切换到其他的排序方法。
3、什么是自省排序
一旦排序的层数超过了某个限定的值,那么此时就更换排序方法。一般是当快速排序的递归深度超过阈值(通常为 2logn)时,立刻切换为堆排序。
而对于小规模子数组,如长度小于 16,直接切换为插入排序。
这种以快速排序为出发,遇到情况及时止损的方式,就是快速排序的自省优化。
4、代码思路
若要实现自省排序,需先完成直接插入排序和堆排序的基础实现(具体代码可参考前文排序专题,此处不重复展示)。
自省排序的函数分层设计:
我们首先要有一个自省排序主函数:在里面计算递归阈值与调用自省排序的主要逻辑思路,起到一个主函数调用入口的作用。
接下来就是书写“自省排序的主要逻辑思路”的函数: 当递归深度超过阈值时,自动切换为堆排序;对于长度小于 16 的子数组,直接采用插入排序。
然后就是一个三数取中的函数:从数组的 low、mid、high 三个位置中选取中间值作为基准值,三次判断之后,mid 位置的元素为中间级,避免了最大或最小的情况。
但是因为下面的分区使用了前后指针的方法,所以要把基准值因为到数组首元素的位置。
5、具体代码
// 三数取中法:选择中间值并移到 low 位置(适配前后指针分区)
int median_of_three(int arr[], int low, int high) {
int mid = low + (high – low) / 2;
// 调整三个位置,使 arr[mid] 成为数值上的中间值
if (arr[low] > arr[mid]) {
Swap(&arr[low], &arr[mid]);
}
if (arr[low] > arr[high]) {
Swap(&arr[low], &arr[high]);
}
if (arr[mid] > arr[high]) {
Swap(&arr[mid], &arr[high]);
}
// 将中间值(arr[mid])主动移到 low 位置,适配前后指针分区
Swap(&arr[low], &arr[mid]);
return low; // 此时 low 位置是真正的中间值
}
// 前后指针分区法(prev 和 cur 逻辑)
int partition(int arr[], int low, int high) {
int keyi = low; // 基准值索引(已通过三数取中确保为中间值)
int prev = low; // 前指针:跟踪小于基准值的边界
int cur = prev + 1; // 后指针:遍历数组
while (cur <= high) {
// 若当前元素小于基准值,且前指针移动后与后指针不重叠,则交换
if (arr[cur] < arr[keyi] && ++prev != cur) {
Swap(&arr[prev], &arr[cur]);
}
cur++;
}
// 将基准值交换到最终位置(prev 位置)
Swap(&arr[prev], &arr[keyi]);
return prev; // 返回基准值的最终索引
}
// 自省排序逻辑的具体实现
void introsort_helper(int arr[], int low, int high, int max_depth) {
int length = high – low + 1;
// 小规模数组用插入排序(阈值可调整)
if (length < 16) {
insertion_sort(arr, low, high);
return;
}
// 递归深度耗尽,切换为堆排序
if (max_depth == 0) {
heap_sort(arr, low, high);
return;
}
// 快速排序逻辑:三数取中 + 前后指针分区
int pivot_idx = median_of_three(arr, low, high);
int partition_idx = partition(arr, low, high);
// 递归排序左右子数组(深度减 1)
introsort_helper(arr, low, partition_idx – 1, max_depth – 1);
introsort_helper(arr, partition_idx + 1, high, max_depth – 1);
}
// 自省排序主函数
void introsort(int arr[], int n) {
if (n <= 1) return;
// 计算最大递归深度(通常为 2 * log2(n))
int max_depth = 2 * (int)log2(n);
introsort_helper(arr, 0, n – 1, max_depth);
}
(六)复杂度与稳定性
1、时间复杂度
(1)理想情况(基准值划分均匀):递归深度O(logn),每趟分区O(n),总时间O(nlogn)。
(2)最坏情况(数组有序,基准值选边界):递归深度O(n),总时间O(n²)
Tip:最坏情况可通过 “三数取中” 或 “随机值” 优化准值选取,避免最坏情况。
(3)平均情况:O(nlogn)。
2、空间复杂度
(1)递归版本:递归栈深度,理想O(logn),最坏O(n)。
(2)非递归版本:栈存储区间边界,理想O(logn),最坏O(n)。
3、稳定性
不稳定。基准值归位时的交换可能改变相同元素相对顺序,如数组 [5,3,3,4],基准值 5 与 3 交换后,两个 3 的顺序改变。这种也属于跳跃式的交换,而跳跃式的交换基本上都是不稳定的。
三、非递归版本快速排序
递归版本可能因递归深度过大导致栈溢出,非递归版本借助 “栈” 存储待排序区间的左右边界,模拟递归过程。
(一)操作步骤
1、初始化栈:将初始区间[ left , right ]的 right 和 left 依次入栈。
2、循环处理
(1)出栈获取当前区间[begin, end]。
(2)找基准值keyi,划分左区间[begin, keyi – 1]和右区间[keyi + 1, end]。
(3)若区间长度大于 1,将右区间、左区间的边界依次入栈(保证深度优先处理)。
3、销毁栈:排序完成后销毁栈。
通俗一点来说就是,先让右端入栈,再让左端入栈,进行分区的时候,再根据栈的性质,先取出左端,再取出右端,此时进行分区操作,得到左右两个分区。
那么此时该分区如果不是一个元素,就继续进栈,先右区间进栈,再左区间进栈,那么下次分区操作,操作的就是左区间。
当分区是一个元素的时候,就说明它有序,此时它就不会产生要进栈的元素了,直至栈的元素为空,就说明数组已经彻底有序,这样就通过循环与栈的方式,实现了排序。
其实,非递归快速排序和递归快速排序的思路完全相同 —— 都是通过选基准、分区,将数组分成左右子区间,再对各子区间重复此过程,直到子区间长度为 1。
只是实现手段不同:递归版依赖系统的 “递归调用栈” 隐式处理子问题的层级关系;非递归版则通过 “手动维护栈” 显式模拟这个过程,本质上是用 “迭代 + 栈” 替代了 “递归” 的语法形式,但分治的核心逻辑没有变化。
(二)代码实现
前提:需预先实现栈的结构。关于栈结构的具体实现方法,前文 “栈” 专题已有详细说明,此处仅阐述其在本方法中的具体用途。
#include"Sort.h"
#include"Stack.h"
void QuickSortNonR(int* arr, int left, int right)
{
ST st;
STInit(&st);
StackPush(&st, right);//右端点入栈
StackPush(&st, left);//左端点入栈
// 栈非空才能进去
// 既保证传入的不是空数组,也保证了可以作为排序完成的标志
while (!StackEmpty(&st))
{
// 取区间 [begin, end]
int begin = StackTop(&st); //取栈顶元素
StackPop(&st); //出栈
int end = StackTop(&st); //取栈顶元素
StackPop(&st); //出栈
// 前后指针法找基准值
// 对[begin, end]这个序列找基准值
int keyi = begin;
int prev = begin
int cur = prev + 1;
while (cur <= end)
{
if (arr[cur] < arr[keyi] && ++prev != cur)
{
Swap(&arr[prev], &arr[cur]);
}
cur++;
}
Swap(&arr[prev], &arr[keyi]);
keyi = prev;
// keyi begin end
// 左序列[begin, keyi-1] 右序列[keyi+1, end]
// 右区间入栈,如果进不去,则说明有序
if (keyi + 1 < end)
{
StackPush(&st, end);
StackPush(&st, keyi + 1);
}
// 左区间入栈,如果进不去,则说明有序
if (begin < keyi – 1)
{
StackPush(&st, keyi – 1);
StackPush(&st, begin);
}
}
STDestroy(&st);
}
以上即为 排序(三)“交换排序” 的全部内容,创作不易,麻烦三连支持一下呗~