论文系统梳理了智能体增强的检索增强生成(Agentic Retrieval-Augmented Generation, Agentic RAG)的核心理论、技术架构、应用场景与实践工具,首次构建了该领域的完整知识体系,为研究者与开发者提供了全面的参考框架。其核心价值在于揭示了 “检索增强生成(RAG)” 与 “自主智能体(Autonomous AI Agents)” 的融合范式,解决了传统 RAG 静态 workflows 的固有缺陷,推动 AI 系统向动态适应、复杂推理、多场景落地的方向演进。
一、研究背景与核心问题
1.1 大语言模型(LLMs)的固有局限
以 GPT-4、PaLM、LLaMA 为代表的 LLMs 虽在文本生成、自然语言理解等任务中表现卓越,甚至拓展至多模态生成领域,但受限于静态预训练数据,存在三大核心问题:
- 信息时效性不足:无法响应动态、实时场景的查询需求,输出易过时;
- 幻觉现象频发:缺乏外部事实校验机制,易生成虚假或不准确内容;
- 动态适应性缺失:难以应对复杂、多步骤的真实世界任务,无法根据场景变化调整推理路径。
1.2 传统 RAG 的改进与瓶颈
检索增强生成(RAG)通过 “实时检索外部数据 + LLM 生成” 的模式,有效弥补了 LLMs 静态数据的缺陷,其核心组件包括检索(Retrieval)、增强(Augmentation)、生成(Generation)三部分。但传统 RAG 仍存在显著局限:
- 工作流静态僵化:多为线性流程,无法根据查询复杂度动态调整检索策略;
- 复杂推理能力弱:难以支持多跳推理、跨源信息融合等复杂任务;
- 上下文整合不足:检索到的信息与 LLM 预训练知识难以无缝融合,易产生碎片化输出;
- 扩展性受限:面对大规模数据集或高并发查询时, latency 高、 scalability 差。
1.3 Agentic RAG 的核心定位
论文提出 “Agentic RAG” 范式,通过在 RAG 流水线中嵌入自主智能体,赋予系统动态决策、迭代优化、多智能体协作的能力,核心解决传统 RAG“静态、被动、弱推理” 的痛点。其本质是 “检索增强生成” 与 “智能体技术” 的深度融合,实现从 “被动响应查询” 到 “主动解决复杂任务” 的范式升级。
二、RAG 范式的演进历程
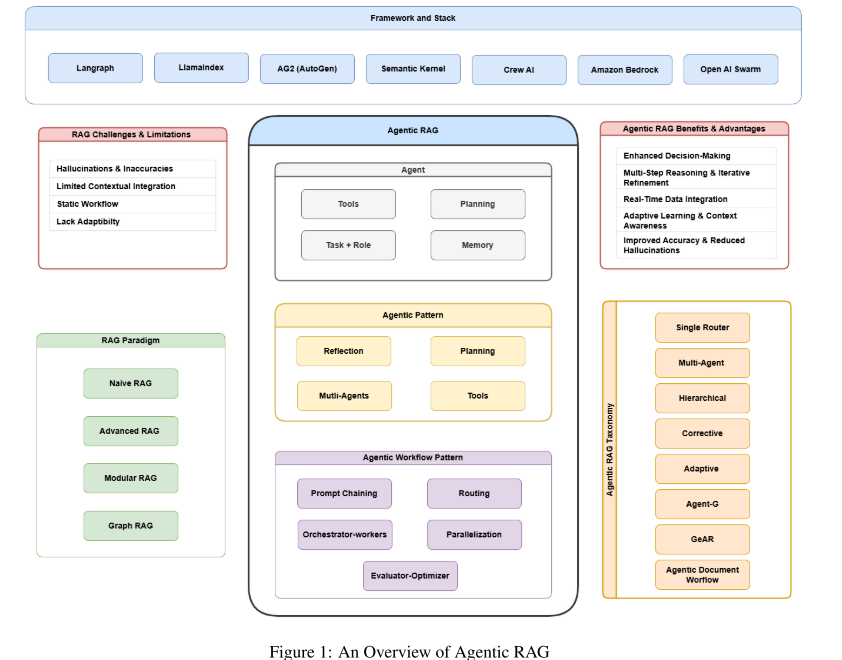
论文系统梳理了 RAG 从基础到高级的五阶段演进路径,明确了 Agentic RAG 的技术定位:
表格
| Naïve RAG(基础型) | 关键词驱动检索,静态数据集依赖 | TF-IDF、BM25 等传统检索算法 | 实现简单、部署快速,适用于基础事实查询 | 无语义理解能力,检索精度低;输出碎片化;大规模数据处理能力弱 |
| Advanced RAG(进阶型) | 语义检索增强,支持多跳推理 | 稠密检索(DPR)、神经重排、多跳检索机制 | 检索精度提升,上下文相关性增强;支持复杂查询的多文档推理 | 计算开销大;扩展性有限;仍为固定工作流,缺乏动态适应性 |
| Modular RAG(模块化型) | 组件解耦,支持定制化配置 | 混合检索(稀疏 + 稠密)、工具 / API 集成、可组合流水线 | 灵活性高,支持领域定制;可独立优化各组件 | 模块协作复杂度高;缺乏自主决策能力;依赖人工配置 |
| Graph RAG(图增强型) | 融合图结构数据,强化关系推理 | 知识图谱、节点连通性分析、层级化知识管理 | 提升多跳推理与关系理解能力;减少幻觉 | 依赖高质量图数据;扩展性受限;图与非结构化数据融合复杂 |
| Agentic RAG(智能体型) | 嵌入自主智能体,动态自适应 | 智能体协作、反射、规划、工具使用 | 支持动态检索策略;具备迭代优化能力;适配复杂多域任务 | 智能体协调复杂度高;计算开销增加;需解决多智能体通信问题 |
演进核心逻辑:从 “被动检索 – 生成” 到 “主动决策 – 检索 – 优化 – 生成”,Agentic RAG 继承了 Modular RAG 的灵活性与 Graph RAG 的推理能力,同时通过智能体赋予系统自主适应性,成为下一代 RAG 的核心范式。
三、智能体智能(Agentic Intelligence)的核心原理
Agentic RAG 的底层支撑是 “智能体智能”,论文明确了其核心组件与设计模式:
3.1 AI 智能体的核心构成
一个完整的 AI 智能体需包含四大组件,协同实现自主决策与任务执行:
- 推理引擎(LLM):定义智能体角色与任务,负责解析查询、生成响应、维持逻辑连贯性;
- 记忆模块(短期 + 长期):短期记忆跟踪当前对话状态,长期记忆存储累积知识与交互经验;
- 规划能力(反射与自我批判):将复杂任务分解为子任务,通过自我批判迭代优化执行路径;
- 工具集:包括向量检索、网页搜索、API 调用等,拓展智能体超出文本生成的能力边界。
3.2 四大核心智能体设计模式
论文提炼了支撑 Agentic RAG 的四大关键模式,是智能体实现自主协作与动态适应的基础:
四、智能体工作流模式(Agentic Workflow Patterns)
论文总结了 5 种适用于 Agentic RAG 的核心工作流模式,适配不同复杂度的任务场景:
表格
| Prompt Chaining(提示链) | 按固定步骤分解任务,前一步输出作为后一步输入 | 需逐步推理的任务 | 提升准确性,简化复杂任务 | 先生成营销文案大纲,再填充内容,最后翻译 |
| Routing(路由) | 分类查询类型,分配给对应专业化流程 | 多类型混合查询场景 | 优化资源分配,提升响应质量 | 客服查询分为技术支持、退款申请、一般咨询,分别处理 |
| Parallelization(并行化) | 将任务拆分为独立子任务,同时执行 | 需高效处理的批量任务 | 降低 latency,提升吞吐量 | 内容审核(一个模型筛查违规,一个生成回复) |
| Orchestrator-Workers(协调 – 工作者) | 中央协调智能体动态分解任务,分配给工作智能体 | 输入复杂度可变的任务 | 动态适应任务变化,支持灵活扩展 | 实时研究(协调智能体分配检索子任务,工作智能体分别从不同源获取数据) |
| Evaluator-Optimizer(评估 – 优化器) | 生成初始输出后,通过评估模型反馈迭代优化 | 需高精度输出的任务 | 持续提升响应质量,满足严格标准 | 文学翻译(多轮评估语法准确性与语义一致性,逐步优化) |
五、Agentic RAG 的系统架构分类(Taxonomy)
论文构建了 Agentic RAG 的完整架构分类体系,涵盖 7 种核心架构,每种架构适配不同场景需求:
5.1 单智能体 Agentic RAG(Router)
- 核心逻辑:单个中央智能体负责检索、路由、信息整合全流程,无需多智能体协作;
- 工作流:接收查询→分析查询类型→选择最优知识源(结构化数据库、语义检索、网页搜索等)→检索数据→LLM 合成响应;
- 优势:架构简单、部署维护成本低、资源消耗少;
- 适用场景:工具与数据源较少的场景,如简单文档检索、SQL 查询辅助;
- 案例:客户订单查询 —— 智能体从订单数据库获取跟踪信息,从物流 API 获取实时状态,整合后生成配送状态报告。
5.2 多智能体 Agentic RAG
- 核心逻辑:多个专业化智能体分工协作,中央协调智能体负责任务分配与结果整合;
- 工作流:接收查询→协调智能体分解任务→专业化智能体并行检索(如结构化数据检索、非结构化文档检索、实时信息检索)→汇总数据→LLM 合成响应;
- 优势:模块化强、可扩展性高、检索精度与效率提升;
- 挑战:智能体协调复杂、数据整合难度大、计算开销增加;
- 案例:多域研究助手 —— 经济数据智能体从 SQL 数据库获取统计数据,学术文献智能体检索相关论文,政策智能体获取最新政策,协同生成可再生能源经济与环境影响报告。
5.3 层级化 Agentic RAG
- 核心逻辑:智能体按层级组织,上层智能体负责战略决策与资源优先级排序,下层智能体负责具体检索执行;
- 工作流:接收查询→顶层智能体评估复杂度与数据源优先级→中层智能体分配检索任务→下层智能体执行具体检索→逐层汇总整合→生成响应;
- 优势:支持复杂多维度查询、战略决策能力强、结果准确性高;
- 适用场景:高复杂度、高可靠性要求的场景,如金融投资分析、医疗诊断辅助;
- 案例:可再生能源投资分析 —— 顶层智能体优先选择权威金融数据库,中层智能体获取实时市场数据与政策信息,下层智能体补充专家观点,整合生成投资建议。
5.4 纠错型 Agentic RAG(Agentic Corrective RAG)
- 核心逻辑:引入专门的纠错智能体,动态评估检索结果相关性,迭代优化检索与响应质量;
- 关键组件:上下文检索智能体、相关性评估智能体、查询优化智能体、外部知识检索智能体、响应合成智能体;
- 优势:减少无关检索干扰、提升响应准确性、降低幻觉风险;
- 适用场景:对事实准确性要求高的场景,如学术研究、专业咨询;
- 案例:生成式 AI 研究进展查询 —— 先检索初始文献,相关性评估智能体筛选高质量文献,查询优化智能体修正检索关键词,补充外部最新研究,最终合成综合进展报告。
5.5 自适应 Agentic RAG(Adaptive Agentic RAG)
- 核心逻辑:通过分类器动态评估查询复杂度,适配不同检索策略(无需检索、单步检索、多步检索);
- 工作流:接收查询→分类器评估复杂度→简单查询直接用 LLM 响应→中等复杂度单步检索→复杂查询多步迭代检索→合成响应;
- 优势:资源利用高效、响应 latency 优化、兼顾简单与复杂查询;
- 案例:包裹延迟查询 —— 分类器判定为复杂查询,启动多步检索(订单数据库、物流 API、天气与路况信息),整合后生成延迟原因与替代方案。
5.6 图增强型 Agentic RAG
(1)Agent-G 框架
- 核心逻辑:融合图知识库与非结构化文档检索,通过专门智能体处理不同类型数据,结合批判模块验证结果质量;
- 优势:强化关系推理与多跳推理能力,结合结构化与非结构化数据优势;
- 案例:糖尿病与心脏病关联查询 —— 图检索智能体提取疾病关联关系与共享风险因素,文档检索智能体获取症状描述,批判模块验证相关性,合成综合响应。
(2)GeAR 框架
- 核心逻辑:通过图扩展模块增强传统检索,智能体自主选择图扩展检索路径,提升多跳查询处理能力;
- 优势:优化多跳推理效率,提升实体关系检索准确性;
- 案例:文学影响链查询(如 “J.K. 罗琳导师的受影响作者”)—— 图扩展模块追踪文学关系,文档检索智能体补充细节,协同生成答案。
5.7 文档智能体工作流(Agentic Document Workflows, ADW)
- 核心逻辑:专注于文档 – centric 任务,整合文档解析、状态维护、知识检索、智能体协调全流程;
- 工作流:文档解析提取关键信息→维护文档处理状态→检索相关知识与规则→智能体应用业务规则与推理→生成结构化输出;
- 优势:支持端到端文档自动化处理、适配领域特定规则、提升文档处理效率;
- 适用场景:发票处理、合同审核、报告生成等文档密集型任务;
- 案例:发票支付推荐 —— 解析发票关键信息(金额、付款期限),检索供应商合同条款,应用折扣规则与预算约束,生成支付推荐报告。
六、框架对比分析
论文对传统 RAG、Agentic RAG、Agentic Document Workflows(ADW)进行了全面对比,明确各框架的适用边界:
表格
| 核心焦点 | 孤立的检索与生成任务 | 多智能体协作与推理 | 文档 centric 端到端工作流 |
| 上下文维护 | 有限 | 通过记忆模块支持 | 全程维护文档状态与处理进度 |
| 动态适应性 | 极低 | 高 | 适配文档处理特定场景 |
| 工作流编排 | 无 | 支持多智能体任务编排 | 整合多步骤文档处理流程 |
| 外部工具集成 | 基础检索工具 | 支持 API、数据库、网页搜索等多工具 | 深度集成领域业务规则与文档工具 |
| 扩展性 | 局限于小规模数据集 / 查询 | 支持多智能体系统扩展 | 适配多域企业级文档工作流 |
| 复杂推理能力 | 基础 Q&A 推理 | 多步骤推理与跨域融合 | 文档内 / 文档间结构化推理 |
| 核心应用 | 知识检索、简单 Q&A | 多域研究、金融分析、客户支持 | 合同审核、发票处理、报告生成 |
| 优势 | 实现简单、快速部署 | 高准确性、协作推理、动态适应 | 端到端自动化、领域定制化、提升生产力 |
| 挑战 | 上下文理解差、扩展性弱 | 资源开销大、协调复杂 | 领域标准化难、编排复杂度高 |
七、关键应用场景
Agentic RAG 凭借动态适应、复杂推理、多源整合的优势,已在多个行业展现 transformative 潜力:
7.1 客户支持与虚拟助手
- 核心价值:实时整合多源数据,提供个性化、上下文感知的响应,减少人工干预;
- 案例:Twitch 通过 Amazon Bedrock 上的 Agentic RAG 优化广告销售 —— 智能体动态检索广告主数据、历史 campaign 表现、受众 demographics,自动生成详细广告提案;
- 优势:提升响应质量、降低人工工作量、适配实时数据变化(如服务中断、价格更新)。
7.2 医疗与个性化医疗
- 核心价值:整合患者电子健康记录(EHR)、最新临床指南、医学文献,辅助临床决策;
- 案例:患者病例总结 —— 智能体从 EHR 提取患者数据,检索最新治疗研究,生成结构化病例摘要,帮助医生快速制定治疗方案;
- 优势:实现个性化护理、节省医疗人员文献检索时间、确保建议基于最新证据。
7.3 法律与合同分析
- 核心价值:自动化合同关键条款提取、风险识别、合规性检查,提升法律工作效率;
- 案例:合同审查 —— 智能体通过语义检索与法律知识图谱,提取合同中的责任条款、违约条件,识别偏离标准条款的风险点;
- 优势:降低合同审查时间、减少人为遗漏、支持大规模合同批量处理。
7.4 金融与风险分析
- 核心价值:整合实时市场数据、历史趋势、政策信息,提供投资决策与风险评估支持;
- 案例:汽车保险理赔处理 —— 智能体检索保单条款、事故数据,结合监管要求,自动生成理赔建议;
- 优势:实时数据分析、多维度风险识别、提升决策全面性。
7.5 教育与个性化学习
- 核心价值:适配学习者进度与偏好,生成定制化学习材料、解释与反馈;
- 案例:研究论文生成辅助 —— 智能体检索相关文献,合成核心发现,生成带参考文献的研究摘要;
- 优势:个性化学习路径、互动式解释、支持大规模教育部署。
7.6 图增强多模态工作流
- 核心价值:整合文本、图像、视频等多模态数据,支持复杂多域趋势分析;
- 案例:环保产品市场调研 —— 智能体检索客户偏好、竞争对手动态,生成包含文本分析与多媒体素材的市场趋势报告;
- 优势:多模态数据整合、提升创意输出、适配动态市场变化。
八、实现工具与框架
论文梳理了当前支持 Agentic RAG 开发的核心工具与框架,覆盖从基础组件到完整解决方案:
表格
| LangChain + LangGraph | LangChain AI | 模块化 RAG 组件、图基工作流、状态持久化、人机协作 | 组件丰富、灵活性高、支持复杂工作流编排 | 自定义 Agentic RAG 系统开发 |
| LlamaIndex | LlamaIndex | 文档智能体工作流、元智能体架构、子智能体协调 | 专注文档处理、支持大规模数据、领域适配性强 | 文档密集型 Agentic RAG 应用 |
| Hugging Face Transformers + Qdrant | Hugging Face + Qdrant | 预训练模型库、自适应向量检索、稀疏 / 稠密检索切换 | 模型资源丰富、检索效率高、轻量化部署 | 需自定义模型与检索策略的场景 |
| CrewAI | CrewAI Inc. | 多智能体层级化协作、记忆系统、工具集成 | 专注多智能体协作、易用性强 | 团队型 Agentic RAG 应用 |
| AutoGen(现 AG2) | Microsoft 等 | 多智能体对话框架、代码生成、工具执行 | 协作能力强、支持复杂任务分解 | 需多智能体交互的场景 |
| OpenAI Swarm | OpenAI | 轻量级多智能体编排、智能体自主协作 | 部署简单、适配 OpenAI 生态 | 快速原型开发、教育场景 |
| Google Vertex AI | 模型构建与部署、上下文感知检索、决策工作流 | scalability 强、企业级支持 | 企业级 Agentic RAG 部署 | |
| Microsoft Semantic Kernel | Microsoft | LLM 集成 SDK、智能体模式支持、任务自动化 | 适配 Microsoft 生态、支持企业级集成 | ServiceNow 等企业系统集成 |
| Amazon Bedrock | AWS | 多模型支持、Agentic 工作流、实时数据整合 | 云原生、高可用性、大规模扩展 | 云部署的 Agentic RAG 应用 |
| IBM watsonx.ai | IBM | Granite 模型支持、外部信息整合、高精度响应 | 企业级安全、领域适配性强 | 金融、医疗等合规要求高的场景 |
| Neo4j + 向量数据库(Weaviate/Pinecone) | Neo4j 等 | 图数据处理、高效相似性检索 | 强化关系推理、检索性能优 | 图增强型 Agentic RAG |
九、基准测试与数据集
论文总结了适用于 Agentic RAG 评估的核心基准与数据集,覆盖检索、推理、生成等多维度:
9.1 关键基准测试(Benchmarks)
- BEIR:多域信息检索评估,包含 17 个数据集,覆盖生物信息、金融、QA 等领域,适用于检索模块评估;
- MS MARCO:专注段落排序与 QA,是稠密检索的核心基准;
- TREC(深度学习赛道):文档与段落检索评估,强调排序模型质量;
- MuSiQue:多跳序列问答基准,测试多步骤推理能力;
- 2WikiMultihopQA:跨维基百科文章的多跳 QA,评估跨源推理能力;
- AgentG:专为 Agentic RAG 设计,评估多知识库动态整合能力;
- HotpotQA:多跳 QA 基准,需检索互联上下文,适配复杂推理场景;
- RAGBench:大规模可解释基准,包含 10 万行业案例,提供 TRACe 评估框架;
- GNN-RAG:图基 RAG 评估,测试节点 / 边预测与 KGQA 性能。
9.2 核心数据集(按任务类型分类)
表格
| 单跳 QA | Natural Questions、TriviaQA、SQuAD、MS MARCO | 基础检索与生成能力评估 |
| 多跳 QA | HotpotQA、2WikiMultihopQA、MuSiQue | 多步骤推理能力评估 |
| 长文本 QA | ELI5、NarrativeQA、ASQA、QMSum | 长文档信息整合能力评估 |
| 领域特定 QA | Qasper(学术)、COVID-QA(医疗)、CMB(中文医疗) | 领域适配性评估 |
| 图基 QA | GraphQA、WikiEvent、RAMS | 关系推理与图数据处理评估 |
| 对话系统 | Wizard of Wikipedia、KBP、CamRest | 多轮交互与上下文维护评估 |
| 推理任务 | HellaSwag、CommonsenseQA、CoT Reasoning | 常识推理与链式推理评估 |
| 事实核查 | FEVER、PubHealth、StrategyQA | 幻觉抑制与事实准确性评估 |
| 文本生成 | WikiASP、XSum、Biography Dataset | 生成质量与结构化输出评估 |
十、挑战与未来方向
10.1 当前核心挑战
- 多智能体协调复杂度:智能体间通信、任务分配、冲突解决需更高效的机制;
- 扩展性与 latency 平衡:多智能体并行处理增加资源消耗,需优化大规模部署性能;
- 伦理与可靠性:智能体自主决策可能带来偏见、隐私泄露风险,需建立合规框架;
- 评估方法缺失:缺乏专门针对智能体动态适应、协作能力的标准化评估体系;
- 领域标准化不足:不同行业的 Agentic RAG 部署缺乏统一规范,适配成本高。
10.2 未来研究方向
- 参考句子自动化获取:拓展不确定性参考句集的泛化性,覆盖更多 LLM 输出场景;
- 新型认知决策方法集成:融合 Reflexion、ToT(思维树)、MoT(记忆思维)等先进推理框架;
- 专用基准与数据集开发:构建针对智能体协作、动态适应的评估工具;
- 轻量化部署优化:降低 Agentic RAG 的计算开销,支持边缘设备部署;
- 伦理与安全机制强化:建立智能体决策的可追溯性、偏见检测与隐私保护机制;
- 跨模态 Agentic RAG 拓展:支持更多模态数据的检索与生成融合。