前言
随着大语言模型进入产业落地深水区,模型幻觉、知识滞后、无法使用私有数据、微调成本过高成为制约 AI 应用的四大核心痛点。传统大模型仅依靠预训练知识进行回答,无法实时对接企业内部文档、业务数据、专业知识库,且极易出现编造答案的情况;而模型微调需要大量数据、算力与时间,知识更新一次就要重新训练,难以满足实际业务的快速迭代需求。
在此背景下,RAG(检索增强生成) 技术凭借轻量化、低成本、高可控、易更新的特性,迅速成为大模型落地最主流、最实用的解决方案,广泛应用于智能客服、企业知识库、法律医疗、政务服务等场景,成为每一位 AI 开发者与工程人员必须掌握的核心技术。
一、什么是 RAG
RAG 全称 Retrieval-Augmented Generation,中文译为检索增强生成。
简单来说,RAG 是一种外挂式知识增强架构,它不修改大模型本身的参数,而是在模型生成答案之前,先从外部私有知识库中检索出与问题相关的真实资料,再将这些资料作为参考上下文,交给大模型进行精准回答。
可以理解为:让大模型实现 “开卷考试”,只依据给定资料作答,不再凭空想象。
RAG 的核心作用:连接大模型与私有数据、消除幻觉、更新知识、保障回答准确性。
二、RAG 的核心原理
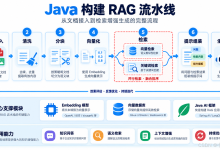
RAG 整体流程分为两大阶段:离线构建向量库、在线检索问答,下面结合《员工手册》实例,完整演示每一步细节。