在图像处理、文档数字化、发票识别等场景中,OCR(Optical Character Recognition,光学字符识别)技术应用广泛。而在 Python 中,借助开源工具 Tesseract,我们可以快速构建强大的文字识别系统。
本文将手把手带你了解如何使用 Python 与 Tesseract 配合进行 OCR 文字识别,从环境搭建、基本使用、识别优化,到多语言支持与图像预处理策略,全面覆盖开发所需知识点。
一、什么是 Tesseract?
Tesseract 是由 Google 维护的开源 OCR 引擎,具备如下特点:
-
支持 100 多种语言
-
支持垂直文本、右到左文字(如阿拉伯文、日文)
-
可训练自定义字体模型
-
在多种平台上表现优秀(Windows/Linux/Mac)
它本身是一个命令行工具,但通过 Python 的 pytesseract 包,我们可以非常方便地调用它。
二、环境准备
1. 安装 Tesseract
Windows
前往 https://github.com/UB-Mannheim/tesseract/wiki 下载对应版本
安装后记下安装路径(如:C:\\Program Files\\Tesseract-OCR\\tesseract.exe)
macOS
brew install tesseract
Linux (Debian/Ubuntu)
sudo apt update
sudo apt install tesseract-ocr
2. 安装 Python 依赖
pip install pytesseract pillow opencv-python
如果想要快速学习,我已经把本文的逻辑整理成了一个可直接运行的小工具,放在本文绑定资源中供需要的同学下载。
三、基本识别示例
以下是一个最基础的图像文字识别示例:
from PIL import Image
import pytesseract
# Windows 特别注意路径
pytesseract.pytesseract.tesseract_cmd = r'C:\\Program Files\\Tesseract-OCR\\tesseract.exe'
img = Image.open('example.png')
text = pytesseract.image_to_string(img, lang='eng')
print(text)
如果是 Linux/macOS 系统,可以省略 tesseract_cmd 设置。
四、支持中文 OCR
默认的 Tesseract 安装中可能未包含中文支持。你需要额外安装语言包:
# Ubuntu 系统
sudo apt install tesseract-ocr-chi-sim
# Windows 可通过官网下载 chi_sim.traineddata 文件放入 tessdata 目录
识别中文示例:
text = pytesseract.image_to_string(img, lang='chi_sim')
五、图像预处理优化识别效果
OCR 的识别效果很大程度依赖于图像质量,下面是常见预处理方法:
import cv2
# 加载图像
img = cv2.imread('example.png')
# 转为灰度图
gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
# 二值化处理
_, thresh = cv2.threshold(gray, 150, 255, cv2.THRESH_BINARY)
# 去噪(可选)
blur = cv2.medianBlur(thresh, 3)
# OCR 识别
text = pytesseract.image_to_string(blur, lang='chi_sim')
print(text)
六、识别区域与数据提取
有时候我们不需要整张图的文字,而是某个区域或字段(如身份证号码、发票编号)。
使用裁剪识别
box = (100, 200, 400, 250) # x1, y1, x2, y2
cropped = img.crop(box)
text = pytesseract.image_to_string(cropped, lang='eng')
获取位置信息
data = pytesseract.image_to_data(img, lang='eng', output_type=pytesseract.Output.DICT)
for i in range(len(data['text'])):
if int(data['conf'][i]) > 60: # 置信度过滤
print(f"Word: {data['text'][i]}, Pos: ({data['left'][i]}, {data['top'][i]})")
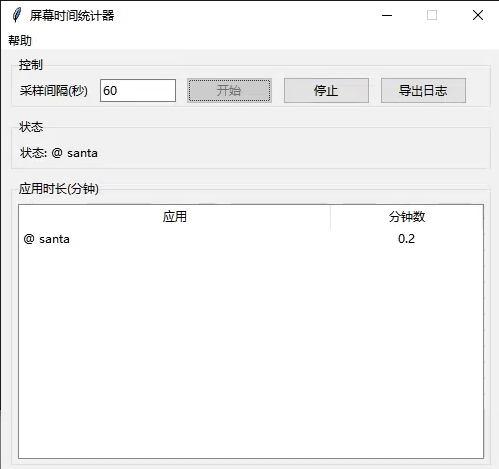
我直接做了一个OCR工具,如果想方便学习的同学可以前往绑定资源下载。识别目标是当前活动窗口的任务名称。
七、常见问题与优化建议
| 识别结果乱码 | 字体不清晰 / 语言包缺失 | 安装正确语言包,增强对比度 |
| 中文识别效果差 | 图像质量不高 | 灰度+二值化预处理 |
| 边框或水印干扰识别 | 噪声过多 | 尝试裁剪目标区域 |
八、进阶:批量识别、PDF、表格结构识别
批量识别文件夹图片
import os
for file in os.listdir('images'):
img_path = os.path.join('images', file)
text = pytesseract.image_to_string(Image.open(img_path), lang='eng')
print(f'{file}:\\n{text}\\n')
PDF OCR(需安装 pdf2image)
pip install pdf2image
sudo apt install poppler-utils # Linux
from pdf2image import convert_from_path
pages = convert_from_path('document.pdf')
for i, page in enumerate(pages):
text = pytesseract.image_to_string(page, lang='chi_sim')
print(f'Page {i+1}:\\n{text}\\n')
总结
通过 Python + Tesseract,我们可以构建出灵活、可扩展的 OCR 系统。掌握图像预处理、语言包配置、区域提取等技巧,将显著提升识别精度与实用性。
如果你在 Tesseract 使用中遇到实际问题,欢迎评论区交流或私信讨论。