1. 时空一致性:AI视频生成的“阿喀琉斯之踵”
如果你最近玩过一些AI视频生成工具,大概率会遇到这样的抓狂时刻:你让AI生成一个“女孩从客厅沙发走到餐桌”的短视频,结果第一帧女孩还好好地坐在沙发上,镜头一切,她人直接“瞬移”到了餐桌边,中间走路的动作完全消失;或者更离谱的是,沙发和餐桌的相对位置在镜头切换时突然对调了,仿佛空间本身发生了扭曲。这种在视频中物体位置、大小、遮挡关系前后矛盾的现象,就是业内常说的“时空不一致”问题,它几乎是当前所有主流AI视频模型的通病。
为什么这个问题如此棘手?根本原因在于,现在绝大多数AI视频模型,其底层训练和推理逻辑仍然是“二维”的。它们本质上是在处理一连串的2D图像帧,通过复杂的算法去预测和生成下一帧应该是什么样子。但问题在于,我们生活的世界是三维的。一个3D物体在2D图像上的投影,会随着相机视角的改变而发生巨大变化。AI模型如果没有对三维空间结构的“理解”能力,它就很难保证在不同视角、不同时间点下,同一个物体在画面中的表现是符合物理规律的。这就好比让一个只学过平面几何的人去设计一栋大楼,他画出的立面图可能很美,但各个立面之间很可能对不上,房子根本盖不起来。
我见过太多团队在这个问题上栽跟头。去年有个做电商短剧的朋友,想用AI批量生成产品展示视频,结果生成的视频里,同一个口红特写镜头,膏体长度忽长忽短;一个简单的360度展示,产品logo在瓶身上到处“漂移”。这种“穿帮”镜头对于追求品质的商用场景来说是致命的,最终他们不得不放弃,回归传统实拍和3D建模的老路,成本不降反增。这让我深刻意识到,不解决时空一致性,AI视频生成就永远只能停留在玩具阶段,无法真正进入影视、广告、电商等严肃的创作领域。
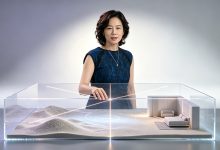
而群核科技推出的 SpatialGen,瞄准的正是这个核心痛点。它没有在2D视频生成的“修修补补”路线上继续内卷,而是选择了一条更根本的路径:既然问题出在缺乏3D理解,那我们就先生成一个物理正确的3D场景,再从这个3D场景里渲染出任意视角的视频。这个思路的转变,就像是从“画一连串会动的连环画”升级到了“先搭建一个真实的微缩模型,再用摄像机去拍它”。后者生成的内容,其时空一致性是天然得到保证的。
2. SpatialGen的核心武器:多视角扩散与3D高斯重建
那么,SpatialGen具体是怎么做到的呢?它的核心技术流程可以拆解为两个关键阶段,我把它比作“先拍照,后建模”。
2.1 第一阶段:多视角扩散模型——给空间拍一套“写真集”
想象一下,你要为一个房间建立3D档案。最直接的方法不是凭空想象,而是拿着相机,从房间的各个角度——正面、侧面、俯视、角落——拍下一系列照片。SpatialGen的第一步就类似于这个“拍照”过程,但它是由AI自动完成的。
首先,你需要给AI一个关于这个空间的“蓝图”。这个蓝图可以是多种形式:
- 一句文字描述:比如“一个现代风格的客厅,有一张灰色沙发和一个木质茶几。”
- 一张参考图:你手头有一张喜欢的室内设计图片。
- 一个3D布局草图:甚至可以直接用简单的3D框线图来定义墙、门、窗和主要家具的位置。
有了这个输入后,SpatialGen内部一个名为多视角扩散模型的组件就开始工作了。它会根据你提供的3D布局(哪怕只是个草图),智能地在虚拟空间中放置多个“虚拟相机”,确保覆盖到这个空间所有重要的视角。然后,对于每一个相机位置,AI会做两件事:
这个过程是同时、并行地考虑所有视角的。模型在训练时就被灌输了“多视角一致性”的强约束,所以它生成的这组照片(多视角图像),会天然地保证:沙发在不同照片里的大小比例是合理的;从左边看茶几在沙发右侧,从右边看它就在沙发左侧;吊灯在每张照片里的悬挂位置都是同一个点。这就得到了一套高度自洽的“空间写真集”。
2.2 第二阶段:3D高斯重建——从照片到可漫步的虚拟空间
拿到一套多视角照片后,第二步就是把这些2D信息“还原”成一个3D模