前言
上一篇我们用LangChain的map_reduce机制解决了超长文本摘要的效率难题。这种分而治之的思路,其实也能反向用于内容生成。把大任务拆成小块,逐段生成再整合,不仅能绕过模型上下文长度限制,还能在每一段注入更精细的控制参数。笔者在实践中发现,只要对每个子块设定明确的风格、语气和受众指向,最终拼接出的长文不仅连贯,还几乎看不出AI痕迹。这种结构化生成方式,正是当前高质量自动写作系统的核心逻辑之一。
1. MapReduce在文本生成中的底层逻辑
1.1 分而治之的生成策略
LangChain的MapReduce并非仅用于摘要,其核心思想是将一个大任务拆解为多个可独立处理的小单元。在爆文生成场景中,系统先根据目标字数与段落结构,自动划分若干子任务。每个子任务由语言模型独立生成,确保局部内容聚焦且风格可控。
1.2 合并阶段的一致性保障
所有子段落生成后,进入Reduce阶段。此阶段不简单拼接,而是通过语义对齐与过渡优化,消除段落间的割裂感。笔者认为,高质量长文生成的关键不在单段文采,而在整体逻辑流的自然延续。MapReduce通过两阶段分工,既释放了局部表达自由度,又守住全局一致性底线。
2. 为何这种结构能规避“AI味”
2.1 风格参数的精细化注入
传统端到端生成依赖单一提示词,难以兼顾全文多维要求。而MapReduce允许在每个Map步骤中动态调整口吻、受众、节奏等参数。例如,开头用平实语气建立信任,中间用数据增强说服力,结尾转为激励式收束——这种变化在统一框架下自然实现。
2.2 上下文窗口的智能绕过
当前主流模型仍受限于上下文长度。一次性生成万字长文易导致前后脱节或重复。分块生成则让每段都在模型“注意力舒适区”内完成。我的体会是,真正流畅的长文本,往往源于对认知负荷的尊重,而非盲目堆砌token。
| 端到端生成 | 高 | 粗 | 高 |
| MapReduce分块 | 低 | 细 | 低 |
技术的价值不在于炫技,而在于让复杂变得简单。当生成器能像人类作者一样分段构思、整体统稿,写出无AI痕迹的好文章,便不再是幻想。
下面就让我们一起进入开发吧!
3. 界面
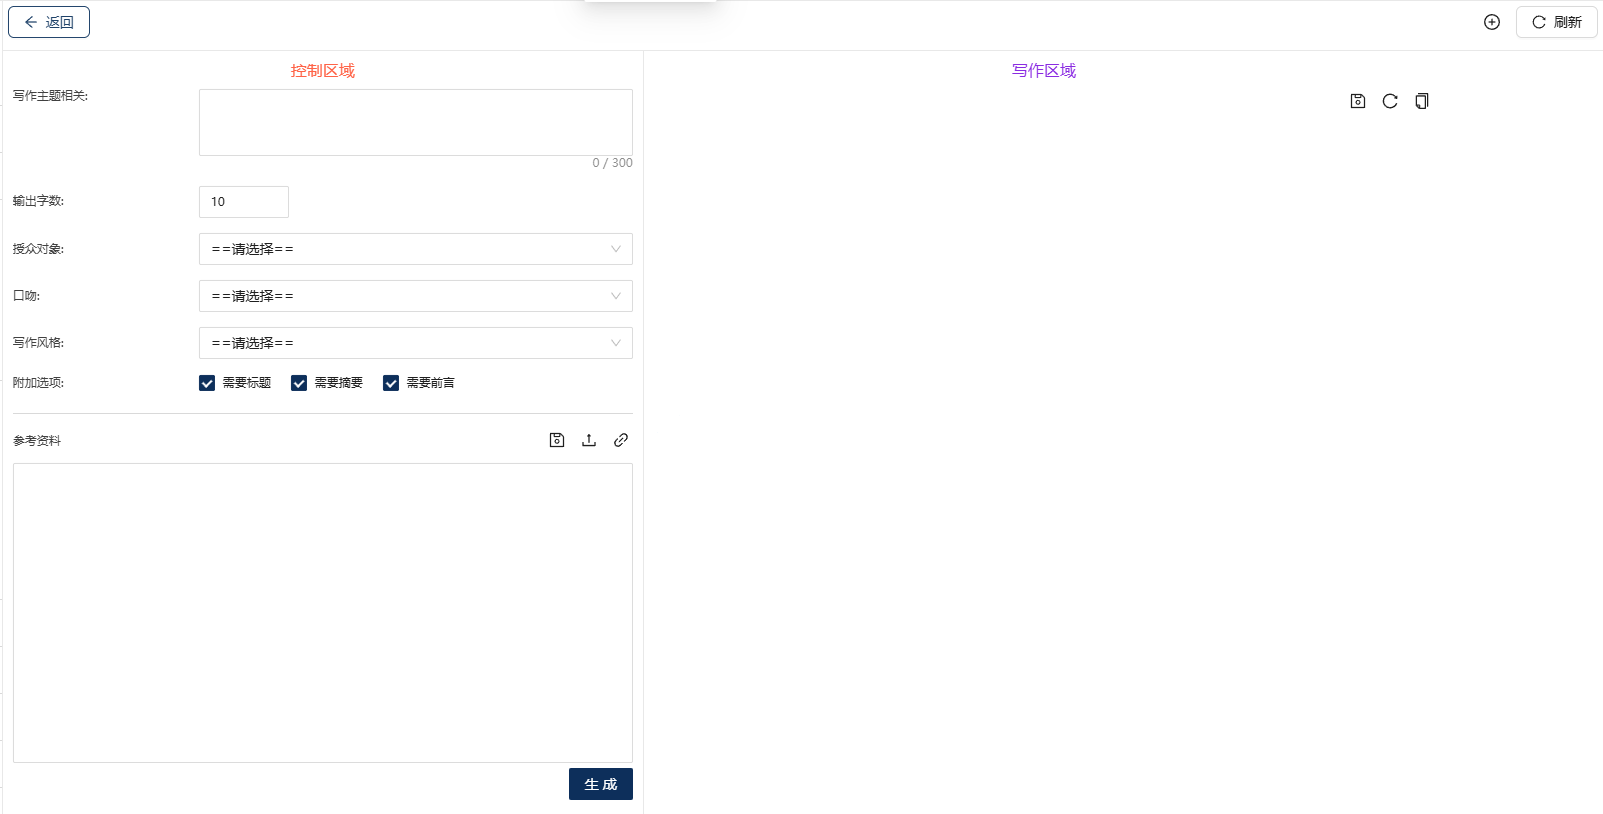
3.1 界面代码(我们使用了vue3, ant-designer, setup-script)
<template>
<div style="width: 100%; height: 100%; background: #fff; overflow: hidden; display: flex; flex-direction: column;">
<!– 头部区域 –>
<div style="flex-shrink: 0;">
<div style="display: flex; align-items: center; gap: 8px; justify-content: space-between;">
<a-button @click="handleBack" style="border-radius: 6px; margin-top: 5px; margin-left: 5px;">
<template #icon>
<arrow-left-outlined />
</template>
返回
</a-button>
<div style="display: flex; gap: 8px;">
<a-tooltip title="新建会话" placement="bottom">
<a-button type="text" @click="newSessions" style="margin-top: 5px;">
<template #icon>
<plus-circle-outlined />
</template>
</a-button>
</a-tooltip>
<a-button @click="handleRefresh" style="border-radius: 6px; margin-top: 5px; margin-right: 5px;">
<template #icon>
<reload-outlined />
</template>
刷新
</a-button>
</div>
</div>
<!– 分割线 –>
<div style="width: 100%; height: 1px; background: #e8e8e8; margin-top: 12px;"></div>
</div>
<!– 内容区域 –>
<div style="display: flex; width: 100%; flex: 1; overflow: hidden;">
<!– 左侧控制区域 –>
<div style="width: 40%; height: 100%; display: flex; flex-direction: column;">
<!– 控制区域标题 –>
<div
style="display: flex; font-size: 16px; color: tomato; margin-top: 10px; align-items: center; justify-content: center;">
控制区域
</div>
<div style="flex: 1; overflow-y: auto; margin: 10px;">
<!– 写作主题 –>
<div style="margin-bottom: 15px;">
<div style="display: flex;">
<div style="width: 30%; font-size: 12px; color: #404040;">写作主题相关:</div>
<div style="width: 70%;">
<a-textarea v-model:value="topic" :maxlength="300" :rows="3" :auto-size="false"
show-count style="font-size: 12px; color: #404040; resize: none; width: 100%;" />
</div>
</div>
</div>
<!– 输出字数 –>
<div style="margin-bottom: 15px;">
<div style="display: flex; align-items: center;">
<div style="width: 30%; font-size: 12px; color: #404040;">输出字数:</div>
<div style="width: 70%;">
<a-input-number v-model:value="maxWords" :min="1" :max="8000" :step="1"
style="font-size: 12px;" />
</div>
</div>
</div>
<!– 授众对象 –>
<div style="margin-bottom: 15px;">
<div style="display: flex; align-items: center;">
<div style="width: 30%; font-size: 12px; color: #404040;">授众对象:</div>
<div style="width: 70%;">
<a-select v-model:value="audience" style="width: 100%;">
<a-select-option value="大众读者" style="font-size: 12px;">==请选择==</a-select-option>
<a-select-option v-for="item in audienceOptions" :key="item.id"
:value="item.optionValue" style="font-size: 12px;">
{{ item.description }}
</a-select-option>
</a-select>
</div>
</div>
</div>
<!– 口吻 –>
<div style="margin-bottom: 15px;">
<div style="display: flex; align-items: center;">
<div style="width: 30%; font-size: 12px; color: #404040;">口吻:</div>
<div style="width: 70%;">
<a-select v-model:value="tone" style="width: 100%;">
<a-select-option value="中肯" style="font-size: 12px;">==请选择==</a-select-option>
<a-select-option v-for="item in toneOptions" :key="item.id"
:value="item.optionValue" style="font-size: 12px;">
{{ item.description }}
</a-select-option>
</a-select>
</div>
</div>
</div>
<!– 写作风格 –>
<div style="margin-bottom: 15px;">
<div style="display: flex; align-items: center;">
<div style="width: 30%; font-size: 12px; color: #404040;">写作风格:</div>
<div style="width: 70%;">
<a-select v-model:value="styleDescription" style="width: 100%;">
<a-select-option value="说明文" style="font-size: 12px;">==请选择==</a-select-option>
<a-select-option v-for="item in styleOptions" :key="item.id"
:value="item.optionValue" style="font-size: 12px;">
{{ item.description }}
</a-select-option>
</a-select>
</div>
</div>
</div>
<!– 附加选项 –>
<div style="margin-bottom: 15px;">
<div style="display: flex; align-items: center;">
<div style="width: 30%; font-size: 12px; color: #404040;">附加选项:</div>
<div style="width: 70%; display: flex; gap: 12px;">
<a-checkbox v-model:checked="needTitle" style="font-size: 12px;">需要标题</a-checkbox>
<a-checkbox v-model:checked="needAbstract" style="font-size: 12px;">需要摘要</a-checkbox>
<a-checkbox v-model:checked="needForeword" style="font-size: 12px;">需要前言</a-checkbox>
</div>
</div>
</div>
<!– 分割线 –>
<div style="width: 100%; height: 1px; background: #d9d9d9; margin-top: 20px; margin-bottom: 15px;">
</div>
<!– 参考资料标题栏 –>
<div
style="display: flex; align-items: center; justify-content: space-between; margin-bottom: 10px;">
<div style="font-size: 12px; color: #404040;">参考资料</div>
<div style="display: flex; align-items: center;">
<a-tooltip title="保存至我上传的文档" placement="bottom">
<a-button type="text" size="small" @click="handleSaveRefDoc" style="margin-left: 0;">
<template #icon>
<save-outlined />
</template>
</a-button>
</a-tooltip>
<a-tooltip title="上传文件" placement="bottom">
<a-button type="text" size="small" @click="handleUploadRefDoc"
style="margin-left: 8px;">
<template #icon>
<upload-outlined />
</template>
</a-button>
</a-tooltip>
<a-tooltip title="通过链接解析" placement="bottom">
<a-button type="text" size="small" @click="handleParseUrlToRefDoc"
style="margin-left: 8px;">
<template #icon>
<link-outlined />
</template>
</a-button>
</a-tooltip>
</div>
</div>
<!– 参考资料输入框 –>
<div style="flex: 1; display: flex; flex-direction: column; min-height: 200px;">
<a-textarea v-model:value="referenceDoc" :auto-size="false"
style="font-size: 11px; color: #404040; resize: none; flex: 1; min-height: 300px;" />
<!– 生成按钮 –>
<div style="margin-top: 5px; display: flex; justify-content: flex-end;">
<a-button type="primary" @click="handleGenerate">生成</a-button>
</div>
</div>
</div>
</div>
<!– 垂直分割线 –>
<div style="width: 1px; height: 100%; background: #e8e8e8;"></div>
<!– 右侧写作区域 –>
<div style="width: 50%; height: 100%; display: flex; flex-direction: column;">
<!– 写作区域标题 –>
<div
style="display: flex; font-size: 16px; color: blueviolet; margin-top: 10px; align-items: center; justify-content: center;">
写作区域
</div>
<div style="flex: 1; overflow-y: auto; margin: 10px; display: flex; flex-direction: column;">
<!– 操作按钮栏 –>
<div style="display: flex; align-items: center; justify-content: flex-end; margin-bottom: 10px;">
<a-tooltip title="保存我写过的文章" placement="bottom">
<a-button type="text" size="small" @click="handleSaveArticle" style="margin-left: 0;">
<template #icon>
<save-outlined />
</template>
</a-button>
</a-tooltip>
<a-tooltip title="重写" placement="bottom">
<a-button type="text" size="small" @click="handleRewrite" style="margin-left: 8px;">
<template #icon>
<reload-outlined />
</template>
</a-button>
</a-tooltip>
<a-tooltip title="复制至粘贴板" placement="bottom">
<a-button type="text" size="small" @click="handleCopyToClipboard" style="margin-left: 8px;">
<template #icon>
<copy-outlined />
</template>
</a-button>
</a-tooltip>
</div>
<!– 写作内容输入框 –>
<div ref="writingContentContainer"
style="flex: 1; display: flex; flex-direction: column; margin-bottom: 5px; overflow-y: auto;">
<smart-pen-answer v-if="writingContent" :message="writingContent" />
</div>
</div>
</div>
</div>
</div>
</template>
<script setup>
import { ref, onMounted, onUnmounted, defineEmits, nextTick, computed } from 'vue'
import { ArrowLeftOutlined, ReloadOutlined, SaveOutlined, UploadOutlined, LinkOutlined, CopyOutlined, PlusCircleOutlined } from '@ant-design/icons-vue'
import { message } from 'ant-design-vue'
import authorization from "@/toolkit/authorization.js";
import SmartPenApi from "@/api/SmartPenApi.js";
import SmartPenAnswer from "@/viewer/smartpen/SmartPenAnswer.vue";
const emits = defineEmits(['switchComponent']);
// 表单数据
const topic = ref('')
const maxWords = ref(10)
const audience = ref('大众读者')
const tone = ref('中肯')
const styleDescription = ref('说明文')
const referenceDoc = ref('')
const writingContent = ref('')
// 附加选项
const needTitle = ref(true)
const needAbstract = ref(true)
const needForeword = ref(true)
// 写作区域容器
const writingContentContainer = ref(null)
// 下拉选项数据
const audienceOptions = ref([])
const toneOptions = ref([])
const styleOptions = ref([])
// 系统消息设置
const sysMsgBasic = ref('')
const sysMsgTitle = ref('')
const sysMsgAbstract = ref('')
const sysMsgForeword = ref('')
// 计算属性:根据checkbox状态组合sysRoleMsg
const sysRoleMsg = computed(() => {
let msg = sysMsgBasic.value
if (needTitle.value && sysMsgTitle.value) {
msg += '\\n' + sysMsgTitle.value
}
if (needAbstract.value && sysMsgAbstract.value) {
msg += '\\n' + sysMsgAbstract.value
}
if (needForeword.value && sysMsgForeword.value) {
msg += '\\n' + sysMsgForeword.value
}
return msg
})
const handleBack = () => {
emits('switchComponent', {
component: 'SmartPenHome'
});
}
const handleRefresh = () => {
fetchSmartHomeData()
}
// 滚动到底部
const scrollToBottom = () => {
nextTick(() => {
if (writingContentContainer.value) {
writingContentContainer.value.scrollTop = writingContentContainer.value.scrollHeight;
}
});
};
// 参考资料操作
const handleSaveRefDoc = () => {
message.info('保存参考资料')
}
const handleUploadRefDoc = () => {
message.info('上传文件')
}
const handleParseUrlToRefDoc = () => {
message.info('通过链接解析')
}
// 写作区域操作
const handleSaveArticle = () => {
message.info('保存文章')
}
const handleRewrite = () => {
message.info('重写')
}
// 生成按钮点击事件
const handleGenerate = () => {
// 参数验证
if (!topic.value || !topic.value.trim()) {
message.error('请输入写作主题')
return
}
console.log('=== 控制区域数据 ===')
console.log('写作主题相关:', topic.value)
console.log('输出字数:', maxWords.value)
console.log('授众对象:', audience.value)
console.log('口吻:', tone.value)
console.log('写作风格:', styleDescription.value)
console.log('参考资料:', referenceDoc.value)
console.log('===================')
// 清空之前的内容
writingContent.value = ''
// 处理系统角色消息中的占位符
let processedSysRoleMsg = sysRoleMsg.value
if (processedSysRoleMsg) {
processedSysRoleMsg = processedSysRoleMsg.replace(/#{userAudience}/g, audience.value || '')
processedSysRoleMsg = processedSysRoleMsg.replace(/#{userStyleDescription}/g, styleDescription.value || '')
processedSysRoleMsg = processedSysRoleMsg.replace(/#{userTone}/g, tone.value || '')
processedSysRoleMsg = processedSysRoleMsg.replace(/#{userMaxWords}/g, maxWords.value || '')
}
// 准备请求参数
const params = {
topic: topic.value,
audience: audience.value,
tone: tone.value,
styleDescription: styleDescription.value,
referenceDoc: (referenceDoc.value || '').trim() ? referenceDoc.value : '无',
userMaxWords: maxWords.value,
systemRoleMsg: processedSysRoleMsg
}
// 获取token和username
const token = authorization.getToken()
const username = authorization.getUsername()
// 显示加载提示
const loadingMsg = message.loading('正在生成内容…', 0)
try {
// 调用SSE API
SmartPenApi.smartPenChat(params, {
onOpen: () => {
console.log('SSE连接已建立')
},
onMessage: (data) => {
console.log('收到SSE事件:', data)
if (!data || data === '') {
return
}
try {
// data 可能是字符串或对象
let parsedData
if (typeof data === 'string') {
parsedData = JSON.parse(data)
} else {
parsedData = data
}
// 检查parsedData的状态字段
const status = parsedData.status
if (status === 'summarizing') {
// 正在提炼上次对话内容
console.log('正在提炼历史对话:', parsedData.message)
// 更新加载提示
if (window._currentLoadingMsg) {
window._currentLoadingMsg()
} else {
loadingMsg()
}
const summarizingMsg = message.loading(parsedData.message || '正在提炼上次对话…', 0)
// 将新的 loading 保存到闭包中
window._currentLoadingMsg = summarizingMsg
} else if (status === 'summarize_done') {
// 提炼完成,开始生成
console.log('提炼完成:', parsedData.message)
if (window._currentLoadingMsg) {
window._currentLoadingMsg()
}
const generatingMsg = message.loading('正在生成内容…', 0)
window._currentLoadingMsg = generatingMsg
} else if (status === 'started') {
// 开始生成内容
console.log('开始生成:', parsedData.message)
writingContent.value = ''
} else if (status === 'streaming') {
// 流式接收内容
if (parsedData.content) {
writingContent.value += parsedData.content
scrollToBottom()
}
} else if (status === 'completed') {
// 生成完成
console.log('生成完成:', parsedData.message)
if (window._currentLoadingMsg) {
window._currentLoadingMsg()
delete window._currentLoadingMsg
} else {
loadingMsg()
}
message.success('内容生成完成')
} else if (status === 'error') {
// 错误处理
console.error('生成错误:', parsedData.error)
if (window._currentLoadingMsg) {
window._currentLoadingMsg()
delete window._currentLoadingMsg
} else {
loadingMsg()
}
message.error(parsedData.error?.message || '生成失败')
}
} catch (parseError) {
console.error('解析SSE数据失败:', parseError, '原始数据:', data)
}
},
onError: (error) => {
console.error('SSE连接错误:', error)
if (window._currentLoadingMsg) {
window._currentLoadingMsg()
delete window._currentLoadingMsg
} else {
loadingMsg()
}
message.error('连接失败,请重试')
},
onClose: () => {
console.log('SSE连接已关闭')
if (window._currentLoadingMsg) {
window._currentLoadingMsg()
delete window._currentLoadingMsg
} else {
loadingMsg()
}
}
}, token, username)
} catch (error) {
console.error('调用API失败:', error)
loadingMsg()
message.error('调用失败,请重试')
}
}
const handleCopyToClipboard = async () => {
try {
await navigator.clipboard.writeText(writingContent.value)
message.success('已复制到粘贴板')
} catch (error) {
message.error('复制失败')
}
}
const newSessions = () => {
// 新建会话逻辑,由用户自行填充
try {
let payload = {
}
SmartPenApi.newSession(payload).then(async res => {
console.log(">>>>>>得到后台数据->" + JSON.stringify(res));
message.success('新建会话成功');
}).catch(err => {
console.error(">>>>>>调用newSession后台api失败", err);
message.error('新建会话失败');
}).finally(() => {
// 恢复所有控制区域到初始值
// 1. 写作主题
topic.value = ''
// 2. 输出字数
maxWords.value = 10
// 3. 所有下拉框恢复默认值
audience.value = '大众读者'
tone.value = '中肯'
styleDescription.value = '说明文'
// 4. 附加选项恢复默认值
needTitle.value = true
needAbstract.value = true
needForeword.value = true
// 5. 参考资料清空
referenceDoc.value = ''
// 6. 右侧写作区域清空
writingContent.value = ''
console.log('已重置所有控制区域到初始值')
});
} catch (err) {
console.error(">>>>>>新建会话失败:", err);
message.error('新建会话失败');
}
}
const fetchSmartHomeData = async () => {
try {
let payload = {}
const res = await SmartPenApi.initSmartPenNormalWriteData(payload)
console.log("获取normal write data成功", res)
if (res) {
// 设置下拉选项数据
if (res.SmartPenAudience) {
audienceOptions.value = res.SmartPenAudience
}
if (res.SmartPenTone) {
toneOptions.value = res.SmartPenTone
}
if (res.SmartPenStyleDescription) {
styleOptions.value = res.SmartPenStyleDescription
}
// 设置系统消息数据
if (res.SmartPenSysMsgBasicSetting) {
sysMsgBasic.value = res.SmartPenSysMsgBasicSetting
}
if (res.SmartPenSysMsgTitleSetting) {
sysMsgTitle.value = res.SmartPenSysMsgTitleSetting
}
if (res.SmartPenSysMsgAbstractSetting) {
sysMsgAbstract.value = res.SmartPenSysMsgAbstractSetting
}
if (res.SmartPenSysMsgForewordSetting) {
sysMsgForeword.value = res.SmartPenSysMsgForewordSetting
}
}
} catch (error) {
console.log('获取normal write data失败', error)
}
}
onMounted(async () => {
// 先等待获取知识库列表
await fetchSmartHomeData()
})
</script>
这块界面没有什么难度。主要是:
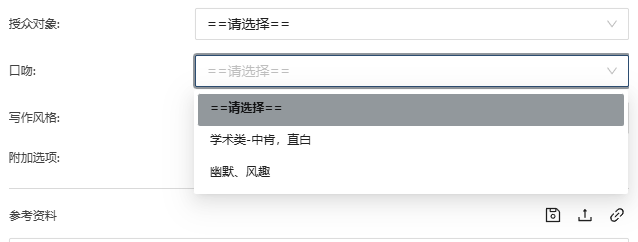
这儿的几个下拉框我们是通过后台取的,我们存于mongodb中。
我可以把mongodb中相关的选项全部给到大家。
4. mongodb内的数据
我们在mongodb存了这些内容:
- 授众对象
- 口吻
- 写作风格
- 附加选项
- 系统猫娘

还有这儿,每勾选一个都会往系统猫娘里增加一段“规则“。
4.1 下拉框选项
// 1
{
"_id": NumberInt("1"),
"optionValue": "技术工作者、程序员们。",
"description": "技术工作者,程序员"
}
// 1
{
"_id": NumberInt("1"),
"optionValue": "论文、说明文一类,需要系统性的说明因为、所以以及原理",
"description": "科技论文,说明文"
}
// 1
{
"_id": NumberInt("1"),
"optionValue": "以中肯、直白、但有科学的口吻输出,如科技报道、论述一类的普实、带有逻辑并且一定要严谨的语句输出, 输出时尽量普实无华,就像一个人一样在和读者说话那种亲切感和引人入甚的感觉。",
"description": "学术类-中肯,直白"
}
// 2
{
"_id": NumberInt("2"),
"description": "幽默、风趣",
"optionValue": "以幽默,风趣,搞笑但不带有嘲笑和贬低的口吻输出,, 输出时尽量多用网络上的顺口溜和搞笑的时髦的词,就像是在説相声一样。"
}
4.2 System Role Message设定
// 1
{
"_id": ObjectId("692d93fb979742cdf7fc3123"),
"msgValue": "# 你是一名互联网科技类博客专家,你写的文章款款为暴款\\n- 你的写作输出以平易近人,不得有华丽词藻以及太高大上的语气。\\n- 因为我们面向的对象是:#{userAudience}\\n- 保持全文语言逻辑贯通,上下连贯,一气呵成。\\n- 全文输出风格为:#{userStyleDescription}\\n- 全文输出口吻:#{userTone}\\n- 不得带有粗口、软色情、嘲讽人的词语\\n# 全文输出要求:\\n1. 字数严格控制控制在#{userMaxWords}字\\n2. 合理分段,段落层次尽量细化,至少每个子段落可以分成两层!各层子段落要有自己的子标题!\\n — 比如说:第一层段落为1. 段落标题\\n — 第二层段落为1.1 段落标题。\\n3. 文章结构不要使用公式化的、生硬的段落分隔,段落与段落间使用更自然平滑的过渡\\n4. 全文写作各段落间请保持叙事的逻辑要连贯要一致,不要有重复的点,要像科谱文学一样,通俗易懂。\\n5. 写作时加入更多的层次感和细节,逐步增加信息密度,让读者在阅读过程中逐渐深入理解。\\n6. 请在撰写文章时使用简练和直接的表达方式,避免不必要的过渡和衔接。\\n7. 严格避免使用任何形式的承接词和过渡词汇。\\n8. 这不仅包括常见的“综上所述”、“总而言之”、“首先”和“同时”,还包括“然而”、“但是”以及其他任何可能被用来引导或总结的词汇。\\n9. 请确保文章的每一段落都能直接进入讨论主题,而不是通过引入或过渡性短语来构建内容。尤其在文章的最后一部分,直接陈述您的观点或结论,避免使用可能导致总结或过渡的词汇和短语。示例:如下:\\n – 错误:首先,我们需要考虑……\\n – 正确:考虑到……\\n – 错误:这个观点很有趣,然而……\\n – 正确:尽管这个观点很有趣,……\\n – 错误:综上所述,我们可以得出结论……\\n – 正确:根据以上分析,我们可以得出结论……\\n10. 输出时要像讲故事一下前后逻辑贯通,段落与段落间过渡需要逻辑,构成因果上下文关系,不要只是报流水帐。\\n11. 一些对比如果可以用表格形式最好用表格来列以避免全文都是文字过于单调\\n12. 不要使用我参考资料里的例子、sample、案例名,而请你照样子写类似例子\\n13. 结尾请一定要有高度概要的总结,同时要能抒情感叹。\\n14. 不得有革命,民主这些网络敏感词汇出现,也不要有骂人、粗口、鄙视、歧视类字眼出现\\n15. 充分利用你的深度搜索扩展补充我的参考资料,因为这篇是属于个人博客来写作的,因此多写一点:我的体会,我认为,笔者是这么看的。。。我的感受是…我在实践中体会到。。。诸如这一类的口吻来述事,一定且必须要加入一些专业意见、看法,以专业的角度进行补充。\\n16. 在补充我的体会、我认为、笔者是这么看的、我的感受和体时一定要注意:谈自己的想法而要避免使用:我在x例,我在某例,我在某个项目。要使用:不举具体例子直白总结想法、推理的学术推断、推论或者是业界公认以及可以说服别人的学术依据这种表达。\\n# 注意点\\n- 全篇输出时要注意避免敏感词、容易引起反感、倒胃口、政治等敏感性用语。\\n- 不要只受限于我的参考资料而是要充分100%发挥你的深度思维、发掘你自身具备的资料对这两种场景进行说明。\\n- 由于这是技术性文档,因此在段落中请尽量要习惯于使用如实心圆,括号数字一类的项目符号以使得段落有层次化和结构化同时具备逻辑严密的作用。要注意了,在使用实心圆和括号数字时不可同时使用比如说:这一行已经用了实心圆那么同一行里不可出现括号数字这样的错误表达手法。\\n- 每个子段落需要注意格式是与正文不同的,你可以通过markdown格式的段落标记来标注它们。\\n"
}
4.3 生成标题、前言、摘要的选项
// 1
{
"_id": ObjectId("692d93fb979742cdf7fc3125"),
"msgValue": "- 请你给我起一个标题,标题要吸晴同时内容要靠近原文。\\n- 标题需要注意格式是与正文不同的,你可以通过markdown格式的段落标记来标注它们。\\n- 标题一定要突出观点\\n- 标题起名不能跑离中心,要让读者看上去就要表达的核心思想,不能因为仅仅高大上而让整个标题偏离主题\\n"
}
// 1
{
"_id": ObjectId("692d93fb979742cdf7fc3124"),
"msgValue": "- 前言需要注意格式是与正文不同的,你可以通过markdown格式的段落标记来标注它们。\\n- 你帮我写一篇 前言,前言需要400字左右,不算在整体文章的#{userMaxWords}字内。\\n"
}
// 1
{
"_id": ObjectId("692d93fa979742cdf7fc3122"),
"msgValue": "- 帮我写一篇摘要,摘要单独为一段并明确标注成标题:“摘要:XXXX具体摘要内容”。字数为100字内,摘要是用在文档展现在页面时,可以让读者一页看到这篇文章写什么以吸引读者的目的,你可以把摘要认为是一种“推销”词,推销自己的文章让大家来读,要起到这么一个目的。\\n- 摘要需要注意格式是与正文不同的,你可以通过markdown格式的段落标记来标注它们。\\n"
}
5. Langchain的制作
5.1 workflow的定义
我们先来看我们整个项目的调用链接。这是一个生产级的爆文生成系统也是一个典型的工业级的AI Agent调用链路即:fastapi/spring boot类业务系统->langchain+fastapi->llm gateway(企业大模型统一网关)。
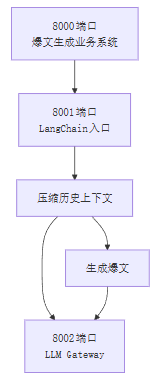
5.2 LangChain处项目结构
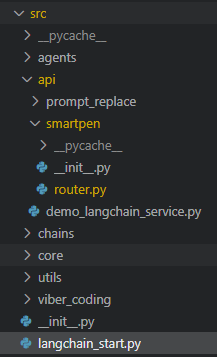
- langchain_start.py->这是整个langchain的启动入口,它启动后通过api内的子模块来路由不同的功能chain。
- /api/smartpen/router.py就是我们的智能写作暴文的“workflow"了。
5.3 langchain_start.py启动文件全代码
import sys
from pathlib import Path
# Add project root to path
project_root = Path(__file__).parent.parent
sys.path.insert(0, str(project_root))
from fastapi import FastAPI
from src.api.smartpen.router import router as smartpen_router
from src.utils.logger import log
app = FastAPI(title="QuickChain LangChain Service")
# 挂载子路由
# 将 smartpen_router 挂载到 /v1/chat 下
# 最终路径将是: POST /v1/chat/smartpen-generate
app.include_router(smartpen_router, prefix="/v1/chat")
@app.get("/")
async def root():
return {"message": "QuickChain LangChain Service is running", "version": "1.0.0"}
@app.get("/health")
async def health():
return {"status": "healthy", "service": "langchain_service"}
if __name__ == "__main__":
import uvicorn
log.info("Starting QuickChain LangChain Service on port 8001…")
uvicorn.run(app, host="0.0.0.0", port=8001)
它启动后会根据:
from src.api.smartpen.router import router as smartpen_router
app.include_router(smartpen_router, prefix="/v1/chat")
这一行代码挂裁子模块的api路径如我们langchain的访问路径就是:
http://localhost:8001/v1/chat/smartpen-generate
5.4 api/smartpen/router.py全代码
import json
from typing import List, Optional
from fastapi import APIRouter, HTTPException, Header
from fastapi.responses import StreamingResponse
from pydantic import BaseModel, Field, model_validator
from langchain_core.prompts import PromptTemplate
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_core.documents import Document
from langchain.chains.summarize import load_summarize_chain
from src.core.llm_factory import LLMFactory
from src.utils.logger import log
from config.settings import settings
# 创建子路由
router = APIRouter(prefix="/smartpen-generate", tags=["Smartpen Operations"])
# — 常量定义 —
HISTORY_SUMMARIZE_THRESHOLD = 8000 # 历史记录超过多少字符触发提炼
CHUNK_SIZE = 400
CHUNK_OVERLAP = 100
SUMMARY_MODEL = "alibailian/qwen-turbo"
# — 模型定义 —
class TemplateModel(BaseModel):
systemRoleMsg: str
userRoleMsg: str
class SmartpenRequest(BaseModel):
map_template: TemplateModel
reduct_template: TemplateModel
lastInput: str # 上次输入内容
lastAnswer: str # 上次回答内容
topic: str # 主题
audience: str # 受众
tone: str # 口吻
styleDescription: str # 风格描述
generateSystemRoleMsg: str # 生成文章的系统角色
generateUserRoleMsg: str # 生成文章的用户角色模板
generateRefDoc: str # 生成文章时的参考资料
model: str = "alibailian/qwen-turbo"
base_url: Optional[str] = None
@model_validator(mode='after')
def set_default_base_url(self) -> 'SmartpenRequest':
if self.base_url is None:
self.base_url = settings.llm_gateway_base_url
return self
class SummarizedText(BaseModel):
lastInput: str
lastAnswer: str
# — 服务类 —
class SmartpenService:
@staticmethod
def _extract_api_key(authorization: str) -> str:
if not authorization or not authorization.startswith("Bearer "):
raise ValueError("Invalid Authorization header")
return authorization[7:].strip()
@staticmethod
async def _execute_map_reduce_chain(docs: List[Document], map_prompt: PromptTemplate, reduce_prompt: PromptTemplate, model: str, base_url: str, api_key: str) -> str:
"""异步执行提炼链 (手动控制以支持精细日志)"""
log.info(f"[Smartpen] Starting Map-Reduce summarization with model: {SUMMARY_MODEL}")
llm = LLMFactory.create_openai(
model=SUMMARY_MODEL,
base_url=base_url,
api_key=api_key,
temperature=0.7,
streaming=False,
json_mode=True
)
# 1. Map 阶段
map_results = []
for i, doc in enumerate(docs):
# 这里的 map_prompt 已经包含了 {text}
res = await llm.ainvoke(map_prompt.format(text=doc.page_content))
content = res.content if hasattr(res, 'content') else str(res)
map_results.append(content)
if i == 0:
log.info("[Smartpen] First block mapped successfully")
# 2. Reduce 阶段
log.info("[Smartpen] Entering Reduce stage")
combined_text = "\\n\\n".join(map_results)
# 这里的 reduce_prompt 已经包含了 {text}
final_res = await llm.ainvoke(reduce_prompt.format(text=combined_text))
final_content = final_res.content if hasattr(final_res, 'content') else str(final_res)
log.info("[Smartpen] Reduce stage completed")
return final_content.strip()
@staticmethod
def _parse_json_summary(text: str) -> SummarizedText:
"""解析提炼出的JSON"""
try:
data = json.loads(text)
inner = data.get("summarizedText", data)
return SummarizedText(
lastInput=str(inner.get("lastInput", "")),
lastAnswer=str(inner.get("lastAnswer", ""))
)
except Exception:
# 容错:如果是纯文本,直接放进 lastAnswer
return SummarizedText(lastInput="", lastAnswer=text)
@staticmethod
def _build_prompts(request: SmartpenRequest):
"""构建Map/Reduce模板"""
# Map Prompt
map_content = f"{request.map_template.systemRoleMsg}\\n\\n{request.map_template.userRoleMsg}"
map_content = map_content.replace("{lastInput}", request.lastInput).replace("{lastAnswer}", request.lastAnswer)
if "{text}" not in map_content:
map_content += "\\n\\n# 当前处理片段:\\n{text}"
# Reduce Prompt
reduce_content = f"{request.reduct_template.systemRoleMsg}\\n\\n{request.reduct_template.userRoleMsg}"
reduce_content = reduce_content.replace("{topic}", request.topic).replace("{audience}", request.audience).replace("{tone}", request.tone).replace("{styleDescription}", request.styleDescription)
if "{text}" not in reduce_content:
reduce_content += "\\n\\n# 待提炼的内容列表:\\n{text}"
return PromptTemplate.from_template(map_content), PromptTemplate.from_template(reduce_content)
@staticmethod
def _build_article_prompt(request: SmartpenRequest, history_doc: str) -> str:
"""构建生成文章的最终Prompt"""
prompt = request.generateUserRoleMsg
prompt = prompt.replace("{topic}", request.topic)
prompt = prompt.replace("{refDoc}", request.generateRefDoc)
prompt = prompt.replace("{historyDoc}", history_doc)
return f"{request.generateSystemRoleMsg}\\n\\n{prompt}"
# — 路由入口 —
@router.post("")
async def smartpen_generate(
request: SmartpenRequest,
authorization: str = Header(None, alias="Authorization")
):
async def generate_stream():
try:
log.info("[Smartpen SSE] Request received")
log.debug(f"[Smartpen SSE] Headers – Authorization: {authorization[:20] if authorization else 'None'}…")
log.debug(f"[Smartpen SSE] Payload: {request.model_dump()}")
api_key = SmartpenService._extract_api_key(authorization)
full_history = f"# 用户输入\\n{request.lastInput}\\n\\n# 助手回答\\n{request.lastAnswer}"
history_length = len(full_history)
history_str = ""
if history_length > HISTORY_SUMMARIZE_THRESHOLD:
# 状态:提炼中
log.info(f"[Smartpen SSE] History length {history_length} > {HISTORY_SUMMARIZE_THRESHOLD}, starting summarization")
yield f"data: {json.dumps({'status': 'summarizing', 'message': '正在为您提炼历史上下文…'}, ensure_ascii=False)}\\n\\n"
map_p, red_p = SmartpenService._build_prompts(request)
docs = [Document(page_content=c) for chunk in [full_history] for c in RecursiveCharacterTextSplitter(chunk_size=CHUNK_SIZE, chunk_overlap=CHUNK_OVERLAP).split_text(chunk)]
log.info(f"[Smartpen SSE] History split into {len(docs)} chunks (Size: {CHUNK_SIZE}, Overlap: {CHUNK_OVERLAP})")
raw_summary = await SmartpenService._execute_map_reduce_chain(docs, map_p, red_p, request.model, request.base_url, api_key)
summary = SmartpenService._parse_json_summary(raw_summary)
history_str = f'\\"上次输入\\": \\"{summary.lastInput}\\", \\"上次回答内容\\": \\"{summary.lastAnswer}\\"'
# 状态:提炼完成
log.info("[Smartpen SSE] Summarization done")
yield f"data: {json.dumps({'status': 'summarize_done', 'message': '提炼完成,开始写作…'}, ensure_ascii=False)}\\n\\n"
else:
log.info(f"[Smartpen SSE] Skipping summarization (length {history_length} <= {HISTORY_SUMMARIZE_THRESHOLD})")
history_str = f'\\"上次输入\\": \\"{request.lastInput}\\", \\"上次回答内容\\": \\"{request.lastAnswer}\\"'
yield f"data: {json.dumps({'status': 'started', 'message': '准备写作中…'}, ensure_ascii=False)}\\n\\n"
# 写作阶段
log.info(f"[Smartpen SSE] Starting article generation with model: {request.model}")
final_prompt = SmartpenService._build_article_prompt(request, history_str)
llm = LLMFactory.create_openai(
model=request.model,
base_url=request.base_url,
api_key=api_key,
streaming=True
)
chunk_count = 0
log.info("[Smartpen SSE] Streaming chunks…")
async for chunk in llm.astream(final_prompt):
content = chunk.content if hasattr(chunk, 'content') else str(chunk)
if content:
chunk_count += 1
# 也可以根据需要开启详细log
# if chunk_count % 10 == 0:
# log.debug(f"[Smartpen SSE] Sent {chunk_count} chunks")
yield f"data: {json.dumps({'status': 'streaming', 'content': content}, ensure_ascii=False)}\\n\\n"
log.info(f"[Smartpen SSE] Generation completed. Chunks: {chunk_count}")
yield f"data: {json.dumps({'status': 'completed', 'message': '写作完成'}, ensure_ascii=False)}\\n\\n"
except Exception as e:
log.error("[Smartpen SSE] Global Error occurred")
# 使用更安全的方式记录异常,避免大括号导致的 KeyError
log.exception(e)
yield f"data: {json.dumps({'status': 'error', 'error': {'message': str(e)}}, ensure_ascii=False)}\\n\\n"
return StreamingResponse(
generate_stream(),
media_type="text/event-stream",
headers={
"Cache-Control": "no-cache",
"Connection": "keep-alive",
"X-Accel-Buffering": "no"
}
)
代码导读
接受参数
payload = {
"map_template": map_template,
"reduct_template": reduct_template,
"lastInput": last_input,
"lastAnswer": last_answer,
"topic": topic_value,
"audience": audience_value,
"tone": tone_value,
"styleDescription": style_value,
"generateSystemRoleMsg": system_role_value,
"generateUserRoleMsg": generate_user_role_msg,
"generateRefDoc": ref_doc_value,
"model": "alibailian/qwen3-max",
}
外置的参数
map_template和reduct_template
这是我们用界面自己做的langchain提示语外置模块来维护的。
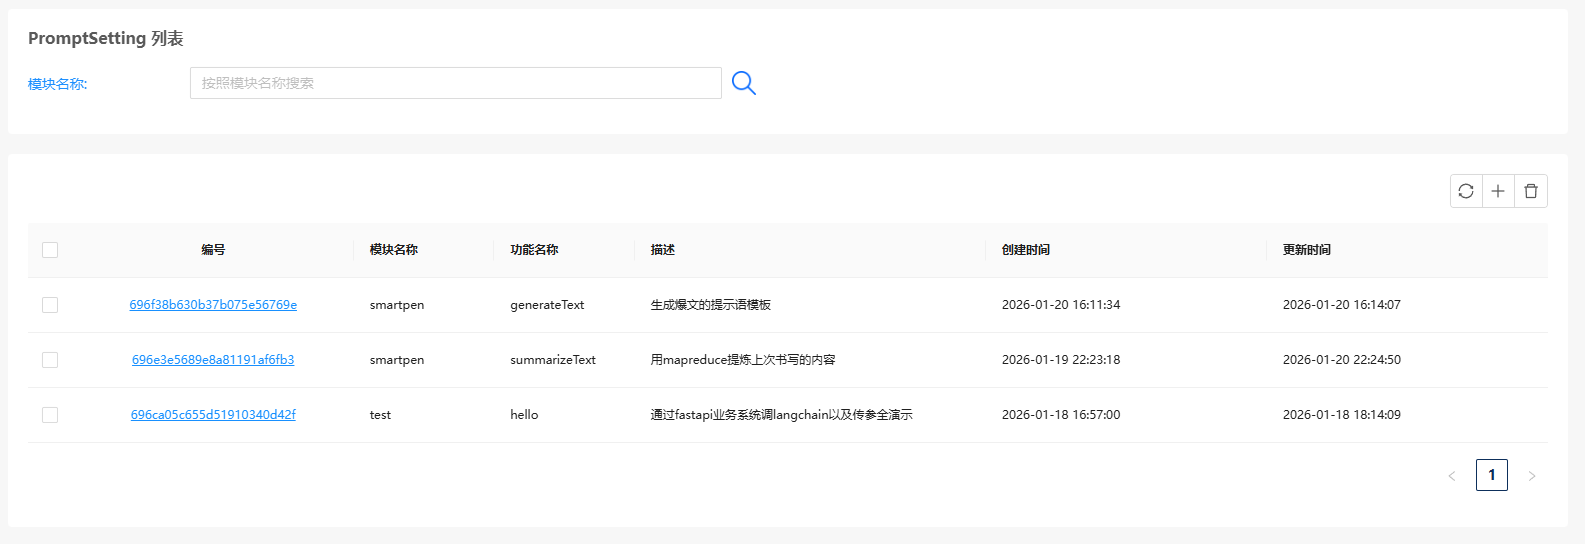
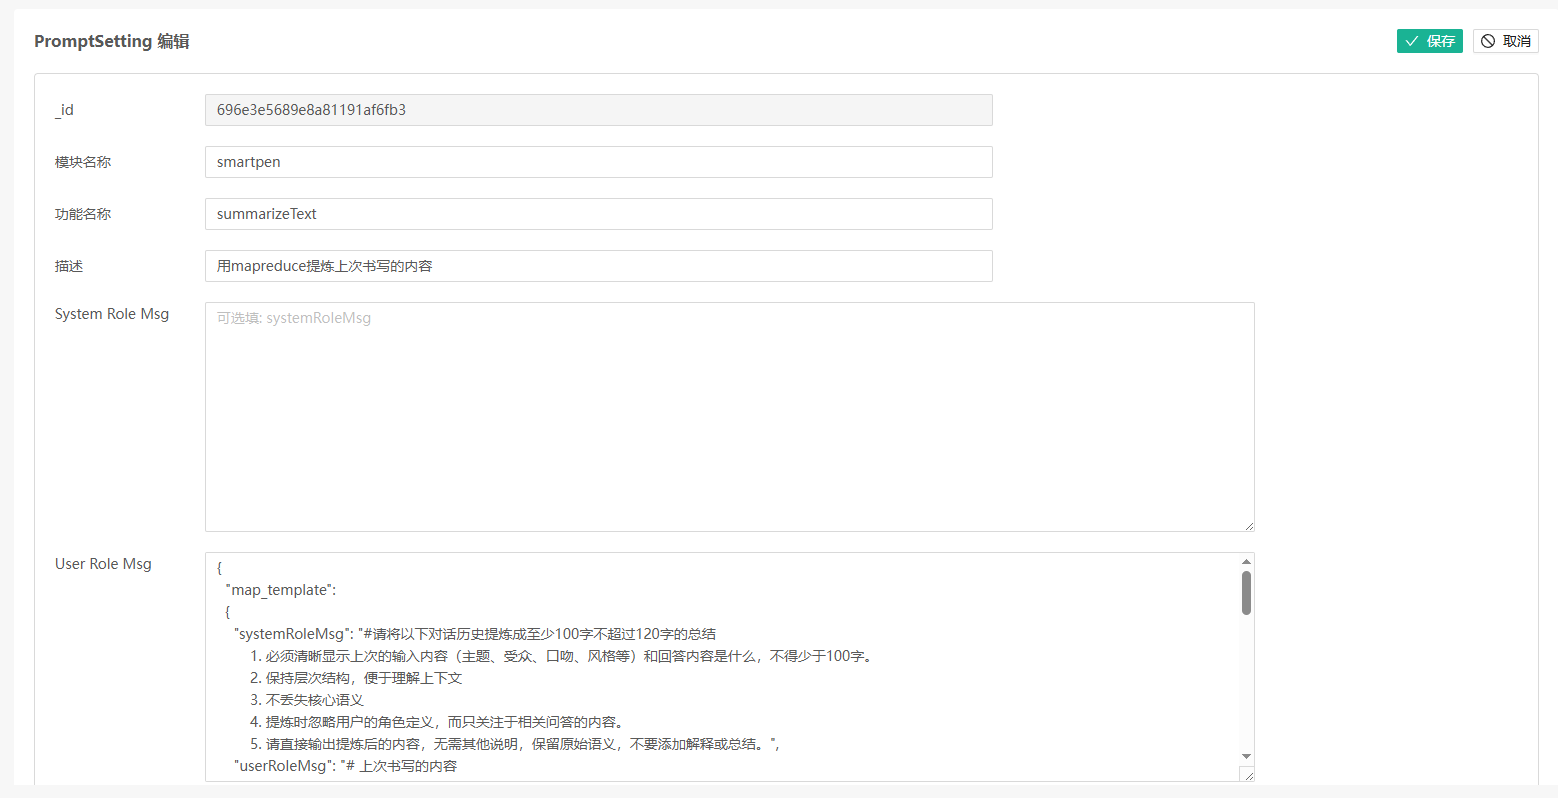
{
"map_template":
{
"systemRoleMsg": "#请将以下对话历史提炼成至少100字不超过120字的总结
1. 必须清晰显示上次的输入内容(主题、受众、口吻、风格等)和回答内容是什么,不得少于100字。
2. 保持层次结构,便于理解上下文
3. 不丢失核心语义
4. 提炼时忽略用户的角色定义,而只关注于相关问答的内容。
5. 请直接输出提炼后的内容,无需其他说明,保留原始语义,不要添加解释或总结。",
"userRoleMsg": "# 上次书写的内容
{userInput}
#上次的回答内容
{lastAnswer}
#输出要求
直接输出提炼后的内容,无需任何前缀、说明或标题。"
},
"reduct_template":{
"systemRoleMsg":"# 书写体裁供参考
主题:{topic}
受众:{audience}
口吻:{tone}
风格:{styleDescription}
# 你的提炼要求
请将以下多段对话历史信息整合成一段连贯的总结,严格遵守以下要求:
1. 必须清晰显示上次的输入内容(主题、受众、口吻、风格等)和回答内容是什么;
2. 总字数不得少于1500字,且不得超过2000字;
3. 保持层次结构,便于理解上下文;
4. 不丢失核心语义;
5. 忽略用户的角色定义,只关注问答内容;
6. 直接输出提炼后的内容,无需任何前缀、说明或标题。",
"userRoleMsg": "# 以下是各片段信息
{text}
# 请严格按照以下JSON格式输出
{{
"summarizedText": {{
"lastInput": "",
"lastAnswer": ""
}}
}}"
}
}
lastInput和lastAnswer的值
每次在业务系统即fastapi处用户输入的内容和AI生成的文章我们都用redis保存起来。
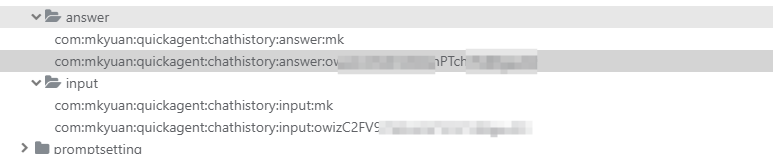
每次生成一篇文章时我们取出即可。
generateSystemRoleMsg和generateSystemUserMsg
generateSystemRoleMsg就是外置于mongodb里的->System Role Message的内容。
generateSystemUserMsg是外置提示词维护的如下截图:
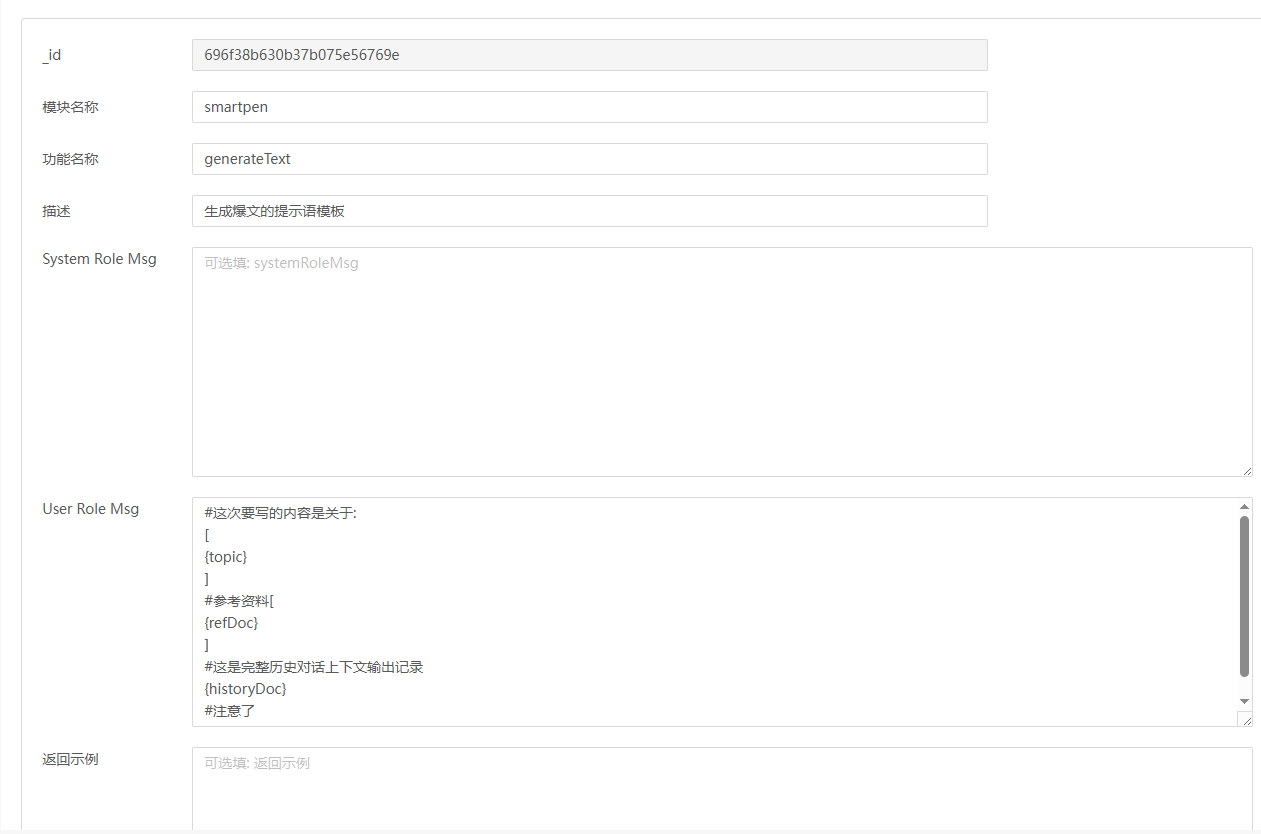
#这次要写的内容是关于:
[
{topic}
]
#参考资料[
{refDoc}
]
#这是完整历史对话上下文输出记录
{historyDoc}
#注意了
当有历史对话记录,你需要联系上下文并延续相关的话题来回答
工作原理
第1步
当代码发觉上次用户的历史对话(包括问+答)>了HISTORY_SUMMARIZE_THRESHOLD字数后会进行每CHUNK_SIZE切片,每次切片会使用滑动窗口CHUNK_OVERLAP个字。
第2步
然后进入mapReduce,每次map时使用的提示语也是外置用界面维护的
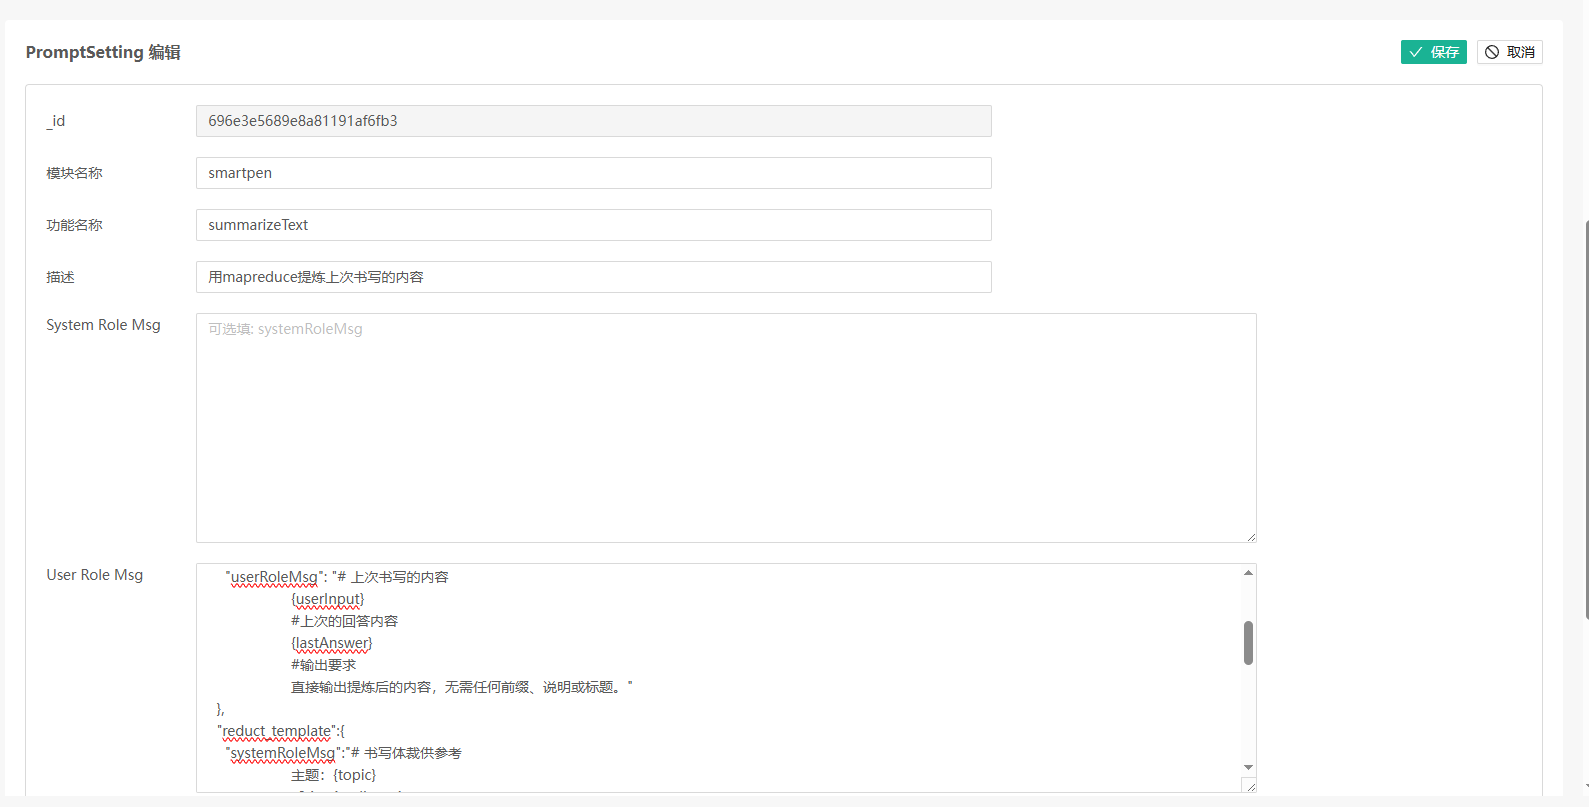
{
"map_template":
{
"systemRoleMsg": "#请将以下对话历史提炼成至少100字不超过120字的总结
1. 必须清晰显示上次的输入内容(主题、受众、口吻、风格等)和回答内容是什么,不得少于100字。
2. 保持层次结构,便于理解上下文
3. 不丢失核心语义
4. 提炼时忽略用户的角色定义,而只关注于相关问答的内容。
5. 请直接输出提炼后的内容,无需其他说明,保留原始语义,不要添加解释或总结。",
"userRoleMsg": "# 上次书写的内容
{userInput}
#上次的回答内容
{lastAnswer}
#输出要求
直接输出提炼后的内容,无需任何前缀、说明或标题。"
},
"reduct_template":{
"systemRoleMsg":"# 书写体裁供参考
主题:{topic}
受众:{audience}
口吻:{tone}
风格:{styleDescription}
# 你的提炼要求
请将以下多段对话历史信息整合成一段连贯的总结,严格遵守以下要求:
1. 必须清晰显示上次的输入内容(主题、受众、口吻、风格等)和回答内容是什么;
2. 总字数不得少于1500字,且不得超过2000字;
3. 保持层次结构,便于理解上下文;
4. 不丢失核心语义;
5. 忽略用户的角色定义,只关注问答内容;
6. 直接输出提炼后的内容,无需任何前缀、说明或标题。",
"userRoleMsg": "# 以下是各片段信息
{text}
# 请严格按照以下JSON格式输出
{{
"summarizedText": {{
"lastInput": "",
"lastAnswer": ""
}}
}}"
}
}
第3步
map全好了后聚合每个map后即每个片段成一整片连贯性的文章并以如下格式输出:
{
"summarizedText": {
"lastInput": "",
"lastAnswer": ""
}
}
此处用{{}}是因为我们的{}代表替换符,如果用两个{{}},langchain就会识别成“你要的是JSON格式”,要不然只有{}的话,langchain返回的内容是一个非结构化的text。
第4步
集齐了所有的参数后用sse(打字机那种流式)来输出爆文
5.5 llm_factory.py
"""
LLM Factory – Create and manage different LLM providers
支持本地/开源模型(Ollama)和阿里百炼云模型
"""
from typing import Optional
from langchain_ollama import ChatOllama
from langchain_community.llms import Tongyi
try:
from langchain_openai import ChatOpenAI
except ImportError:
ChatOpenAI = None
import os
from src.utils.logger import log
from config.settings import settings
class LLMFactory:
"""
Factory class for creating LLM instances
支持:
– Ollama 本地模型(免费)
– 阿里百炼/通义千问(需要 API Key)
"""
@staticmethod
def create_ollama(
model: str = "llama3.2",
temperature: float = 0.7,
base_url: Optional[str] = None,
**kwargs
) -> ChatOllama:
"""
Create Ollama Local LLM instance (完全免费,本地运行)
Args:
model: 模型名称 (llama3.2, llama2, llama3.1, mistral, qwen2.5 等)
temperature: 采样温度 (0.0-1.0)
base_url: Ollama 服务地址,如为 None 则从配置文件读取
**kwargs: 其他参数
Returns:
ChatOllama instance
Example:
>>> llm = LLMFactory.create_ollama(model="llama3.2", temperature=0.7)
>>> response = llm.invoke("你好")
"""
# 从配置文件获取 base_url
if base_url is None:
base_url = settings.ollama_base_url
log.info(f"[LLM Factory] Creating Ollama LLM")
log.info(f"[LLM Factory] Model: {model}")
log.info(f"[LLM Factory] Base URL: {base_url}")
log.info(f"[LLM Factory] Temperature: {temperature}")
return ChatOllama(
model=model,
temperature=temperature,
base_url=base_url,
**kwargs
)
@staticmethod
def create_tongyi(
model: str = "qwen-turbo",
temperature: float = 0.7,
api_key: Optional[str] = None,
**kwargs
) -> Tongyi:
"""
创建阿里百炼/通义千问 LLM 实例
Args:
model: 模型名称
– qwen-turbo: 通义千问增强版(性价比高)
– qwen-plus: 通义千问增强版(更强能力)
– qwen-max: 通义千问最强版本
– qwen-long: 长文本版本
temperature: 采样温度 (0.0-1.0)
api_key: DashScope API Key,如为 None 则从环境变量 DASHSCOPE_API_KEY 或 ALIBAILIAN_API_KEY 获取
**kwargs: 其他参数
Returns:
Tongyi LLM instance
Example:
>>> llm = LLMFactory.create_tongyi(model="qwen-turbo", temperature=0.7)
>>> response = llm.invoke("你好")
注意:
– 需要在 https://dashscope.console.aliyun.com/ 获取 API Key
– API Key 可通过环境变量 ALIBAILIAN_API_KEY 或 DASHSCOPE_API_KEY 设置
"""
# 获取 API Key:优先使用传入参数,其次从环境变量获取
if api_key is None:
api_key = os.getenv("ALIBAILIAN_API_KEY") or os.getenv("DASHSCOPE_API_KEY")
if not api_key:
raise ValueError(
"未找到 API Key。请通过以下方式之一设置:\\n"
"1. 传入 api_key 参数\\n"
"2. 设置环境变量 ALIBAILIAN_API_KEY\\n"
"3. 设置环境变量 DASHSCOPE_API_KEY\\n"
"4. 在 .env 文件中添加 ALIBAILIAN_API_KEY=your_api_key"
)
log.info(f"[LLM Factory] Creating Alibaba Tongyi LLM")
log.info(f"[LLM Factory] Model: {model}")
log.info(f"[LLM Factory] Temperature: {temperature}")
log.info(f"[LLM Factory] API Key: {api_key[:3]}{'*' * (len(api_key) – 3)}")
# 设置环境变量(Tongyi 会从环境变量读取)
os.environ["DASHSCOPE_API_KEY"] = api_key
return Tongyi(
model_name=model,
temperature=temperature,
dashscope_api_key=api_key,
**kwargs
)
@staticmethod
def create_alibailian(
model: str = "qwen-turbo",
temperature: float = 0.7,
api_key: Optional[str] = None,
**kwargs
) -> Tongyi:
"""
create_tongyi 的别名,更直观的名称
参数和用法与 create_tongyi 完全相同
"""
return LLMFactory.create_tongyi(model=model, temperature=temperature, api_key=api_key, **kwargs)
@staticmethod
def create_openai(
model: str,
base_url: str,
api_key: str,
temperature: float = 0.7,
streaming: bool = False,
json_mode: bool = False,
**kwargs
) -> ChatOpenAI:
"""
创建 OpenAI 兼容接口的 LLM 实例 (可用于本地网关、OpenAI、DeepSeek 等)
Args:
model: 模型名称 (如 alibailian/qwen3-max)
base_url: 接口地址 (如 http://localhost:8000/api/llmgateway/v1)
api_key: API Key (必传参数)
temperature: 采样温度 (0.0-1.0)
streaming: 是否启用流式输出 (SSE)
json_mode: 是否强制LLM输出JSON格式 (仅在非流式模式下生效)
当streaming=True时,此参数被忽略
**kwargs: 其他参数
Returns:
ChatOpenAI instance
Example:
>>> # 非流式 + JSON输出
>>> llm = LLMFactory.create_openai(
… model="qwen-turbo",
… base_url="http://localhost:8000/api/llmgateway/v1",
… api_key="your-key",
… streaming=False,
… json_mode=True
… )
>>>
>>> # 流式输出
>>> llm = LLMFactory.create_openai(
… model="qwen-turbo",
… base_url="http://localhost:8000/api/llmgateway/v1",
… api_key="your-key",
… streaming=True
… )
"""
if ChatOpenAI is None:
raise ImportError("请先安装 langchain-openai: pip install langchain-openai")
if not api_key:
raise ValueError("api_key is required for create_openai method")
log.info(f"[LLM Factory] Creating OpenAI Compatible LLM")
log.info(f"[LLM Factory] Model: {model}")
log.info(f"[LLM Factory] Base URL: {base_url}")
log.info(f"[LLM Factory] Temperature: {temperature}")
log.info(f"[LLM Factory] Streaming: {streaming}")
log.info(f"[LLM Factory] JSON Mode: {json_mode}")
log.info(f"[LLM Factory] API Key: {api_key[:3]}{'*' * (len(api_key) – 3) if api_key else '***'}")
# 构建 model_kwargs
model_kwargs = kwargs.get('model_kwargs', {})
# 只在非流式模式下启用JSON约束
if json_mode and not streaming:
model_kwargs['response_format'] = {'type': 'json_object'}
log.info(f"[LLM Factory] ✓ Enabled JSON output mode (response_format: json_object)")
elif json_mode and streaming:
log.warning(f"[LLM Factory] ⚠ JSON mode ignored in streaming mode (SSE does not support JSON constraint)")
# 从 kwargs 中移除 model_kwargs,避免重复传递
other_kwargs = {k: v for k, v in kwargs.items() if k != 'model_kwargs'}
return ChatOpenAI(
model=model,
api_key=api_key,
base_url=base_url,
temperature=temperature,
streaming=streaming,
model_kwargs=model_kwargs,
**other_kwargs
)
@staticmethod
def create_default(**kwargs):
"""
Create default LLM (使用 Ollama 本地模型)
Returns:
ChatOllama instance
Raises:
RuntimeError: 如果 Ollama 不可用
"""
log.info("[LLM Factory] Creating default LLM (Ollama)…")
try:
llm = LLMFactory.create_ollama(**kwargs)
log.info("[LLM Factory] ✓ Ollama LLM created successfully")
return llm
except Exception as e:
log.error(f"[LLM Factory] ✗ Failed to create Ollama LLM: {e}")
raise RuntimeError(
"Ollama 不可用。请按以下步骤安装:\\n"
"1. 下载 Ollama: https://ollama.com/download\\n"
"2. 安装后运行: ollama run llama3.2\\n"
"3. 等待模型下载完成\\n"
"4. 重新运行程序"
) from e
在llm_factory.py里我们定义了一个“create_openai”的方法,它就是以标准的openai sdk compatible的格式调用和返回流式或者是非流式(阻塞式)响应的。
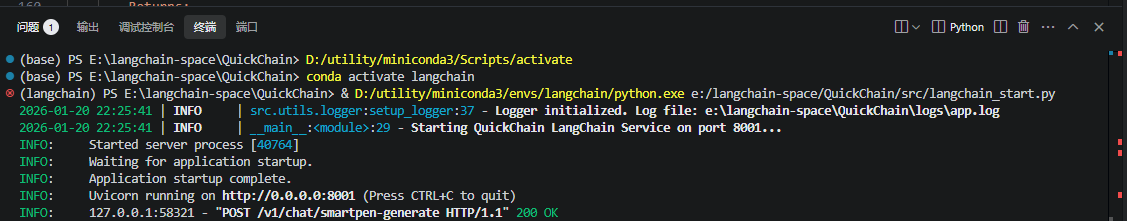
5.6 LangChain启动
直接启动langchain_start.py文件即可。
6. 业务系统smartpen处的代码
包括:
- 一个api->smartpen_chat_route.py
- 一个service->smartpen_service.py
- 一个tool->chat_tool_service.py
6.1 smartpen_chat_route.py全代码
from fastapi import APIRouter, Request
from typing import Optional
from pydantic import BaseModel, Field
from loguru import logger
from fastapi.responses import StreamingResponse
import json
import asyncio
from …services.smartpen_service import SmartPenService
from …services.chat_tool_service import ChatToolService
# 定义SmartPen聊天请求体模型
class SmartPenChatRequest(BaseModel):
topic: str = Field(…, description="写作主题")
audience: str = Field(…, description="受众对象")
tone: str = Field(…, description="输出口吻")
styleDescription: str = Field(…, description="写作风格")
referenceDoc: str = Field(…, description="参考资料")
userMaxWords: int = Field(default=30, description="最大字数", ge=1, le=10000)
systemRoleMsg: str = Field(…, description="角色设定")
router = APIRouter()
@router.post("/smartPenChat")
async def smart_pen_chat(request: Request, chat_request: SmartPenChatRequest):
"""SmartPen智能写作对话API – 基于Server-Sent Events
接收写作参数并通过SSE流式返回生成的内容
"""
# 从请求header中获取username
username = request.headers.get("username")
if not username:
logger.warning("Username not found in request headers")
username = "anonymous"
logger.info(f"Received SmartPen chat request for user: {username}")
logger.info(
"Request params – topic: %s, audience: %s, tone: %s, style: %s, maxWords: %s",
chat_request.topic,
chat_request.audience,
chat_request.tone,
chat_request.styleDescription,
chat_request.userMaxWords,
)
async def event_generator():
"""SSE事件生成器"""
# 用于收集完整的AI回答
full_answer = ""
try:
# 参数验证 – 检查所有必填字段
missing_params = []
if not chat_request.topic or not chat_request.topic.strip():
missing_params.append("topic")
if not chat_request.audience or not chat_request.audience.strip():
missing_params.append("audience")
if not chat_request.tone or not chat_request.tone.strip():
missing_params.append("tone")
if not chat_request.styleDescription or not chat_request.styleDescription.strip():
missing_params.append("styleDescription")
if not chat_request.referenceDoc or not chat_request.referenceDoc.strip():
missing_params.append("referenceDoc")
if not chat_request.systemRoleMsg or not chat_request.systemRoleMsg.strip():
missing_params.append("systemRoleMsg")
# 如果有缺失参数,发送错误事件并终止
if missing_params:
error_msg = f"缺少必填参数: {', '.join(missing_params)}"
logger.error(f"Parameter validation failed for user {username}: {error_msg}")
# 发送错误事件
error_event = {
"status": "error",
"error": {
"code": "MISSING_PARAMS",
"message": error_msg,
"missing_params": missing_params,
},
}
yield f"event: error\\ndata: {json.dumps(error_event, ensure_ascii=False)}\\n\\n"
return
# 调用 LangChain SmartPen 接口获取流式响应
logger.info(f"准备调用 SmartPen LangChain 服务,username={username}")
# 标记是否成功完成对话
conversation_completed = False
async for event in SmartPenService.stream_smartpen_response(
topic=chat_request.topic,
audience=chat_request.audience,
tone=chat_request.tone,
style_description=chat_request.styleDescription,
reference_doc=chat_request.referenceDoc,
max_words=chat_request.userMaxWords,
systemRoleMsg=chat_request.systemRoleMsg,
username=username, # 传入用户名,用于从 Redis 读取 lastInput/lastAnswer
):
if event:
event_type = event.get("event", "message")
data = event.get("data", {})
# 收集AI回答内容
if event_type == "message":
content = data.get("content", "")
if content:
full_answer += content
# 转发SSE事件给前端
yield f"event: {event_type}\\ndata: {json.dumps(data, ensure_ascii=False)}\\n\\n"
# 如果是错误或完成事件,记录日志
if event_type == "error":
logger.error(
"SmartPen service returned error for user %s: %s",
username,
data,
)
elif event_type == "message_end":
logger.info(
"SmartPen chat completed successfully for user %s",
username,
)
conversation_completed = True
# 对话成功完成后,异步保存聊天历史(不阻塞响应)
if conversation_completed and full_answer:
asyncio.create_task(
ChatToolService.storeUserChatHistory(
username=username,
topic=chat_request.topic,
audience=chat_request.audience,
tone=chat_request.tone,
style_description=chat_request.styleDescription,
reference_doc=chat_request.referenceDoc,
max_words=chat_request.userMaxWords,
system_role_msg=chat_request.systemRoleMsg,
answer=full_answer, # 保存完整的AI回答
)
)
logger.info(f"已触发用户 {username} 的对话历史异步保存任务")
except Exception as e:
# 捕获任何异常并通过SSE返回错误
error_msg = f"处理请求时发生错误: {str(e)}"
logger.error(
"Error in SmartPen chat for user %s: %s",
username,
error_msg,
exc_info=True,
)
error_event = {
"status": "error",
"error": {
"code": "INTERNAL_ERROR",
"message": error_msg,
},
}
yield f"event: error\\ndata: {json.dumps(error_event, ensure_ascii=False)}\\n\\n"
# 返回SSE响应
return StreamingResponse(
event_generator(),
media_type="text/event-stream",
headers={
"Cache-Control": "no-cache",
"Connection": "keep-alive",
"X-Accel-Buffering": "no",
"Access-Control-Allow-Origin": "*",
"Content-Type": "text/event-stream; charset=utf-8",
"X-Content-Type-Options": "nosniff",
},
)
其实很简单,只是一个单纯调用smartpen_service里执行逻辑以及返回前端需要用到的sse流格式的组装而己。
6.2 smartpen_service.py
import httpx
import httpx
import json
import asyncio
import os
from typing import Dict, Any, AsyncGenerator
from loguru import logger
from ..agenticflow.prompt_setting_helper import get_prompt_setting
from ..services.chat_tool_service import ChatToolService
class SmartPenService:
"""SmartPen智能写作服务 – 处理与第三方 LangChain API 的流式交互"""
# === 第三方API配置常量 ===
THIRD_PARTY_API_URL = "http://localhost:8001/v1/chat/smartpen-generate"
# LangChain 服务的 API Key,请根据实际环境配置
THIRD_PARTY_API_KEY = "sk-your-api-key"
THIRD_PARTY_USER = "mk"
THIRD_PARTY_RESPONSE_MODE = "streaming"
THIRD_PARTY_QUERY = "请开始写作吧"
@staticmethod
async def stream_smartpen_response(
topic: str,
audience: str,
tone: str,
style_description: str,
reference_doc: str,
max_words: int = 30,
systemRoleMsg: str = "",
username: str = "mk"
) -> AsyncGenerator[Dict[str, Any], None]:
"""流式获取SmartPen写作响应并转发(调用 LangChain smartpen-generate 接口)
Args:
topic: 写作主题
audience: 受众对象
tone: 输出口吻
style_description: 写作风格
reference_doc: 参考资料
max_words: 最大字数,默认30(仅用于日志和保存,不直接传给 LangChain)
systemRoleMsg: 系统角色消息(generateSystemRoleMsg)
username: 用户名,用于从 Redis 获取 lastInput/lastAnswer
Yields:
Dict[str, Any]: SSE事件数据
"""
# 基础字段做 strip 处理,避免出现多余空白
topic_value = topic.strip() if topic else ""
audience_value = audience.strip() if audience else ""
tone_value = tone.strip() if tone else ""
style_value = style_description.strip() if style_description else ""
ref_doc_value = reference_doc.strip() if reference_doc else ""
system_role_value = systemRoleMsg.strip() if systemRoleMsg else ""
# 从 Redis 获取 lastInput / lastAnswer(上一轮会话原始输入与回答)
try:
last_input = await ChatToolService._get_input_from_redis(username)
last_answer = await ChatToolService._get_answer_from_redis(username)
except Exception as e:
logger.error(f"获取 lastInput/lastAnswer 失败: {str(e)}", exc_info=True)
last_input = ""
last_answer = ""
# 从 PromptSetting 获取 map_template / reduct_template 配置
# 默认至少提供必须字段,避免 LangChain 校验 422
map_template: Dict[str, Any] = {
"systemRoleMsg": "",
"userRoleMsg": "",
}
reduct_template: Dict[str, Any] = {
"systemRoleMsg": "",
"userRoleMsg": "",
}
generate_user_role_msg: str = ""
try:
summarize_prompt = await get_prompt_setting("smartpen", "summarizeText")
if summarize_prompt:
user_role_msg = summarize_prompt.get("userRoleMsg", "")
try:
# userRoleMsg 是一个 JSON 字符串,内部包含 map_template / reduct_template
template_config = json.loads(user_role_msg) if isinstance(user_role_msg, str) else user_role_msg
map_config = template_config.get("map_template", {}) or {}
reduct_config = template_config.get("reduct_template", {}) or {}
# 按文档要求:将内部的 systemRoleMsg / userRoleMsg 转成 string 放到各自模板下
map_template = {
"systemRoleMsg": str(map_config.get("systemRoleMsg", "")),
"userRoleMsg": str(map_config.get("userRoleMsg", "")),
}
reduct_template = {
"systemRoleMsg": str(reduct_config.get("systemRoleMsg", "")),
"userRoleMsg": str(reduct_config.get("userRoleMsg", "")),
}
except Exception as e:
logger.error(f"解析 summarizeText.userRoleMsg 失败: {str(e)}", exc_info=True)
except Exception as e:
logger.error(f"获取 summarizeText PromptSetting 失败: {str(e)}", exc_info=True)
# 获取 generateText 的 userRoleMsg 作为 generateUserRoleMsg
try:
generate_prompt = await get_prompt_setting("smartpen", "generateText")
if generate_prompt:
generate_user_role_msg = str(generate_prompt.get("userRoleMsg", "") or "")
except Exception as e:
logger.error(f"获取 generateText PromptSetting 失败: {str(e)}", exc_info=True)
generate_user_role_msg = ""
# 构造请求头和请求体,调用 LangChain smartpen-generate 接口
# API Key 从环境变量 ALIBAILIAN_API_KEY 读取
api_key = os.getenv("ALIBAILIAN_API_KEY", "").strip()
if not api_key:
logger.error("ALIBAILIAN_API_KEY 未配置,无法调用 LangChain smartpen-generate 接口")
headers = {
"Authorization": f"Bearer {api_key}" if api_key else "",
"Content-Type": "application/json",
"Accept": "text/event-stream", # 期望流式返回
}
payload = {
"map_template": map_template,
"reduct_template": reduct_template,
"lastInput": last_input,
"lastAnswer": last_answer,
"topic": topic_value,
"audience": audience_value,
"tone": tone_value,
"styleDescription": style_value,
"generateSystemRoleMsg": system_role_value,
"generateUserRoleMsg": generate_user_role_msg,
"generateRefDoc": ref_doc_value,
"model": "alibailian/qwen3-max",
}
logger.info(f"Sending SmartPen request to LangChain API: {SmartPenService.THIRD_PARTY_API_URL}")
logger.debug(f"Request payload: {json.dumps(payload, ensure_ascii=False)}")
try:
async with httpx.AsyncClient(timeout=None) as client:
async with client.stream(
"POST",
SmartPenService.THIRD_PARTY_API_URL,
headers=headers,
json=payload,
timeout=None
) as response:
# 检查响应状态码
if response.status_code != 200:
# 尝试读取响应体以获取详细错误信息
try:
response_body = await response.aread()
response_text = response_body.decode('utf-8')
except Exception as e:
response_text = f"Unable to read response body: {str(e)}"
error_msg = f"LangChain API returned error status: {response.status_code}"
# 详细日志记录
logger.error(
f"{'='*60}\\n"
f"API Error Details:\\n"
f"{'='*60}\\n"
f"Error: {error_msg}\\n"
f"Request URL: {SmartPenService.THIRD_PARTY_API_URL}\\n"
f"Status Code: {response.status_code}\\n"
f"Response Headers: {dict(response.headers)}\\n"
f"Response Body:\\n{response_text}\\n"
f"{'='*60}"
)
# 根据状态码提供更友好的错误信息
if response.status_code == 502:
user_msg = "第三方服务暂时不可用(502 Bad Gateway),请检查 LangChain 服务是否正常运行"
elif response.status_code == 503:
user_msg = "第三方服务暂时不可用(503 Service Unavailable)"
elif response.status_code == 504:
user_msg = "第三方服务响应超时(504 Gateway Timeout)"
elif response.status_code == 401:
user_msg = "认证失败(401 Unauthorized),请检查API密钥"
elif response.status_code == 403:
user_msg = "访问被拒绝(403 Forbidden)"
elif response.status_code == 429:
user_msg = "请求过于频繁(429 Too Many Requests)"
else:
user_msg = f"第三方API返回错误状态码: {response.status_code}"
yield {
"event": "error",
"data": {
"status": "error",
"error": {
"code": "API_ERROR",
"message": user_msg,
"details": {
"status_code": response.status_code,
"response_body": response_text[:500] # 限制长度避免日志过大
}
}
}
}
return
# 处理流式响应
content_type = response.headers.get("content-type", "")
accumulated_answer = ""
# 如果是 SSE 流(text/event-stream),按 SSE 规范解析
if "text/event-stream" in content_type:
logger.info("检测到 LangChain 返回 text/event-stream,将按 SSE 解析")
buffer = ""
async for chunk in response.aiter_text():
if not chunk:
continue
buffer += chunk
# 一个 chunk 里可能包含多个 SSE 事件,用 \\n\\n 分隔
while "\\n\\n" in buffer:
event_data, buffer = buffer.split("\\n\\n", 1)
if not event_data.strip():
continue
lines = event_data.strip().split("\\n")
data_content = None
for line in lines:
if line.startswith("data:"):
data_content = line[5:].strip()
break
if not data_content:
continue
try:
json_data = json.loads(data_content)
except json.JSONDecodeError as e:
logger.error(f"解析 LangChain SSE data 失败: {data_content}, error: {str(e)}")
continue
status = json_data.get("status")
# 累加 streaming 内容,供上层保存历史
if status == "streaming":
accumulated_answer += json_data.get("content", "")
yield {
"event": "message",
"data": json_data,
}
elif status == "completed":
# 完成事件,映射成 message_end,方便上层触发保存逻辑
yield {
"event": "message_end",
"data": json_data,
}
else:
# started / summarizing 等事件原样透传
yield {
"event": "message",
"data": json_data,
}
# 处理缓冲区剩余数据(极端情况下最后一个事件没有以\\n\\n结尾)
if buffer.strip():
lines = buffer.strip().split("\\n")
for line in lines:
if line.startswith("data:"):
data_content = line[5:].strip()
try:
json_data = json.loads(data_content)
except json.JSONDecodeError:
continue
status = json_data.get("status")
if status == "streaming":
accumulated_answer += json_data.get("content", "")
yield {"event": "message", "data": json_data}
elif status == "completed":
yield {"event": "message_end", "data": json_data}
else:
yield {"event": "message", "data": json_data}
else:
# 非 SSE,按一次性 JSON 或纯文本处理
logger.info(f"LangChain 返回非 SSE 内容类型: {content_type},按一次性响应处理")
try:
raw_text = await response.aread()
text = raw_text.decode("utf-8")
except Exception as e:
logger.error(f"读取 LangChain 非 SSE 响应失败: {str(e)}")
text = ""
if not text:
return
try:
json_data = json.loads(text)
except json.JSONDecodeError:
# 不是 JSON,就当作整体内容
json_data = {"status": "streaming", "content": text}
status = json_data.get("status")
if status == "streaming" and isinstance(json_data.get("content"), str):
accumulated_answer += json_data["content"]
elif isinstance(json_data.get("content"), str):
accumulated_answer += json_data["content"]
# 先发一条 message
yield {
"event": "message",
"data": json_data,
}
# 再补一个 completed 结束事件,前端好收尾
if status != "completed":
yield {
"event": "message_end",
"data": {
"status": "completed",
"message": "内容生成完成",
},
}
except httpx.TimeoutException as e:
error_msg = f"Request to LangChain API timed out: {str(e)}"
logger.error(error_msg)
yield {
"event": "error",
"data": {
"status": "error",
"error": {
"code": "TIMEOUT_ERROR",
"message": error_msg
}
}
}
except httpx.RequestError as e:
error_msg = f"Error making request to LangChain API: {str(e)}"
logger.error(error_msg)
yield {
"event": "error",
"data": {
"status": "error",
"error": {
"code": "REQUEST_ERROR",
"message": error_msg
}
}
}
except Exception as e:
error_msg = f"Unexpected error when calling LangChain API: {str(e)}"
logger.error(error_msg, exc_info=True)
yield {
"event": "error",
"data": {
"status": "error",
"error": {
"code": "INTERNAL_ERROR",
"message": error_msg
}
}
}
由于我们脱离了dify(之前我们用dify做的)因此所有的llm处的循环、聚合、逻辑、甚至是连接状态的维护、http资源的关闭以及异常处理全部交给了langchain的底层,在service里只做一件事:拼调用langchain的爆文输出工作流需要的payload。
6.3 chat_tool_service.py
import httpx
import json
import asyncio
from typing import Dict, Any
from loguru import logger
from ..db.redis_client import get_redis_client
class ChatToolService:
"""对话工具服务 – 提供通用的对话历史管理功能"""
# === 内容提炼API配置常量 ===
SUMMARIZE_API_URL = "dify的工作流入口-己作废"
SUMMARIZE_API_KEY = "dify的工作流api_key-己作废"
SUMMARIZE_API_USER = "mk" # dify里的工作流调用用户名,己作废
SUMMARIZE_MAX_LENGTH = 1000 # 内容超过此长度需要提炼-dify里的参数,己作废
FALLBACK_TRUNCATE_LENGTH = 800 # 提炼失败时的兜底截断长度,dify里的截断长度,己作废
# Redis key格式(包含username)
CHAT_HISTORY_INPUT_KEY = "com:mkyuan:quickagent:chathistory:input:{username}"
CHAT_HISTORY_ANSWER_KEY = "com:mkyuan:quickagent:chathistory:answer:{username}"
CHAT_HISTORY_ABSTRACT_KEY = "com:mkyuan:quickagent:chathistory:abstract:{username}"
# 整个_summarize_lat_conversation方法己作废,因为改走langchain了。
@staticmethod
async def _summarize_last_conversation(
last_input: str,
last_answer: str
) -> str:
"""
提炼上次对话的输入和输出
Args:
last_input: 上次的输入内容(JSON格式)
last_answer: 上次的回答内容
Returns:
str: 提炼后的内容
"""
# 解析上次输入的JSON格式
try:
input_data = json.loads(last_input)
# 构建可读的输入内容
readable_input = f"""主题:{input_data.get('topic', '')}
受众:{input_data.get('audience', '')}
口吓:{input_data.get('tone', '')}
风格:{input_data.get('styleDescription', '')}
参考文档:{input_data.get('referenceDoc', '')}
最大字数:{input_data.get('maxWords', '')}
系统角色:{input_data.get('systemRoleMsg', '')}"""
except json.JSONDecodeError:
# 如果JSON解析失败,直接使用原始内容
logger.warning("解析上次输入JSON失败,使用原始内容")
readable_input = last_input
# 构建上次对话内容
full_content = f"""【上次对话】
输入:
{readable_input}
回答:
{last_answer}"""
content_length = len(full_content)
logger.info(f"="*60)
logger.info(f"上次对话原始内容长度: {content_length}字")
logger.info(f"提炼阈值: {ChatToolService.SUMMARIZE_MAX_LENGTH}字")
logger.info(f"上次输入内容预览:\\n{readable_input[:200]}…")
logger.info(f"上次回答内容预览:\\n{last_answer[:200]}…")
# 如果内容未超过阈值,直接返回
if content_length <= ChatToolService.SUMMARIZE_MAX_LENGTH:
logger.info(f"✓ 无需提炼({content_length} <= {ChatToolService.SUMMARIZE_MAX_LENGTH})")
logger.info(f"直接使用原始内容作为lastInput")
logger.info(f"="*60)
return full_content
# 需要提炼
logger.warning(f"✗ 需要提炼({content_length} > {ChatToolService.SUMMARIZE_MAX_LENGTH})")
logger.info(f"开始调用LLM进行内容提炼…")
headers = {
"Authorization": f"Bearer {ChatToolService.SUMMARIZE_API_KEY}",
"Content-Type": "application/json"
}
# 提炼要求(放在query字段)
query = f"""请将以下对话历史提炼成不超过{ChatToolService.SUMMARIZE_MAX_LENGTH}字的总结。
要求:
1. 必须清晰显示上次的输入内容(主题、受众、口吻、风格等)和回答内容是什么,不得少于1500字但不得大于{ChatToolService.SUMMARIZE_MAX_LENGTH}字。
2. 保持层次结构,便于理解上下文
3. 不丢失核心语义
4. 提炼时忽略用户的角色定义,而只关注于相关问答的内容。
请直接输出提炼后的内容,无需其他说明。"""
# 待提炼的内容(放在inputs.inputText字段)
payload = {
"inputs": {
"inputText": full_content # 原文放在inputs字段,避免超过query的4096限制
},
"query": query, # 提炼要求单独放在query字段
"response_mode": "blocking",
"user": ChatToolService.SUMMARIZE_API_USER
}
try:
async with httpx.AsyncClient(timeout=60.0) as client:
response = await client.post(
ChatToolService.SUMMARIZE_API_URL,
headers=headers,
json=payload
)
if response.status_code != 200:
logger.error(f"✗ 提炼失败: API返回错误状态码 {response.status_code}")
logger.error(f"响应内容: {response.text}")
# 使用兜底截断策略
summarized = ChatToolService._fallback_truncate(full_content, readable_input, last_answer)
logger.warning(f"使用兜底截断方式处理,截断后长度: {len(summarized)}字")
logger.info(f"="*60)
return summarized
result = response.json()
answer = result.get("answer", "")
# 尝试从answer中解析JSON格式的result
try:
answer_json = json.loads(answer)
summarized_content = answer_json.get("result", answer)
except json.JSONDecodeError:
summarized_content = answer
logger.info(f"✓ 提炼成功!")
logger.info(f"提炼后内容长度: {len(summarized_content)}字")
logger.info(f"提炼后内容预览: {summarized_content[:200]}…")
logger.info(f"="*60)
return summarized_content
except Exception as e:
logger.error(f"✗ 提炼过程发生异常: {str(e)}", exc_info=True)
# 使用兜底截断策略
summarized = ChatToolService._fallback_truncate(full_content, readable_input, last_answer)
logger.warning(f"使用兜底截断方式处理,截断后长度: {len(summarized)}字")
logger.info(f"="*60)
return summarized
# 整个_fallback_truncate方法己作废,因为改走langchain了。
@staticmethod
def _fallback_truncate(full_content: str, readable_input: str, last_answer: str) -> str:
"""
兜底截断策略 – 当提炼失败时使用智能截断
策略:
1. 保留完整的输入信息(主题、受众、口吓等)
2. 截断回答内容,确保总长度不超过 FALLBACK_TRUNCATE_LENGTH
3. 在截断处添加提示信息
Args:
full_content: 完整的对话内容
readable_input: 可读的输入内容
last_answer: 上次的回答内容
Returns:
str: 截断后的内容
"""
truncate_length = ChatToolService.FALLBACK_TRUNCATE_LENGTH
# 计算输入部分的长度
input_header = "【上次对话】\\n输入:\\n"
answer_header = "\\n\\n回答:\\n"
truncate_suffix = "\\n…(内容过长,已截断)"
input_part_length = len(input_header) + len(readable_input) + len(answer_header)
available_for_answer = truncate_length – input_part_length – len(truncate_suffix)
# 如果输入部分已经超过阈值,则只能简单截断全文
if available_for_answer <= 0:
logger.warning("输入部分已超过阈值,使用简单截断策略")
return full_content[:truncate_length] + truncate_suffix
# 智能截断:保留完整输入 + 部分回答
truncated_answer = last_answer[:available_for_answer]
# 尝试在句子边界截断(查找最后一个句号、问号、感叹号)
sentence_endings = ['。', '!', '?', '.', '!', '?', '\\n']
best_cut = available_for_answer
for i in range(len(truncated_answer) – 1, max(0, len(truncated_answer) – 50), -1):
if truncated_answer[i] in sentence_endings:
best_cut = i + 1
break
truncated_answer = truncated_answer[:best_cut]
result = f"{input_header}{readable_input}{answer_header}{truncated_answer}{truncate_suffix}"
logger.info(f"兜底截断详情:")
logger.info(f" – 原始内容长度: {len(full_content)}字")
logger.info(f" – 目标截断长度: {truncate_length}字")
logger.info(f" – 输入部分长度: {input_part_length}字")
logger.info(f" – 回答保留长度: {len(truncated_answer)}字")
logger.info(f" – 最终结果长度: {len(result)}字")
return result
# 整个_build_input_content方法己作废,因为改走langchain了。
@staticmethod
def _build_input_content(
topic: str,
audience: str,
tone: str,
style_description: str,
reference_doc: str,
max_words: int,
system_role_msg: str
) -> str:
"""
构建输入内容用于保存
Returns:
str: JSON格式的输入内容
"""
input_data = {
"topic": topic,
"audience": audience,
"tone": tone,
"styleDescription": style_description,
"referenceDoc": reference_doc,
"maxWords": max_words,
"systemRoleMsg": system_role_msg
}
return json.dumps(input_data, ensure_ascii=False, indent=2)
@staticmethod
async def _save_input_to_redis(username: str, content: str) -> bool:
"""
保存输入内容到Redis
Args:
username: 用户名
content: 要保存的输入内容
Returns:
bool: 保存是否成功
"""
try:
redis_client = get_redis_client()
key = ChatToolService.CHAT_HISTORY_INPUT_KEY.format(username=username)
# 设置内容到Redis,过期时间为7天
redis_client.setex(key, 7 * 24 * 60 * 60, content)
logger.info(f"成功保存用户 {username} 的输入历史到Redis")
return True
except Exception as e:
logger.error(f"保存输入历史到Redis失败: {str(e)}", exc_info=True)
return False
@staticmethod
async def _save_answer_to_redis(username: str, content: str) -> bool:
"""
保存回答内容到Redis
Args:
username: 用户名
content: 要保存的回答内容
Returns:
bool: 保存是否成功
"""
try:
redis_client = get_redis_client()
key = ChatToolService.CHAT_HISTORY_ANSWER_KEY.format(username=username)
# 设置内容到Redis,过期时间为7天
redis_client.setex(key, 7 * 24 * 60 * 60, content)
logger.info(f"成功保存用户 {username} 的回答历史到Redis")
return True
except Exception as e:
logger.error(f"保存回答历史到Redis失败: {str(e)}", exc_info=True)
return False
# 整个_summarize_single_chunk方法己作废,因为改走langchain了。
@staticmethod
async def _summarize_single_chunk(chunk: str, chunk_index: int, total_chunks: int) -> str:
"""
提炼单个分段内容
Args:
chunk: 要提炼的内容分段
chunk_index: 分段索引(从1开始)
total_chunks: 总分段数
Returns:
str: 提炼后的内容
"""
logger.info(f"[分段 {chunk_index}/{total_chunks}] 开始提炼,长度: {len(chunk)}字")
headers = {
"Authorization": f"Bearer {ChatToolService.SUMMARIZE_API_KEY}",
"Content-Type": "application/json"
}
# 提炼要求(放在query字段)
query = f"""请提炼以下内容(这是第{chunk_index}段,共{total_chunks}段)。
要求:
1. 保留核心要点和关键信息
2. 不丢失重要语义
3. 保持内容的连贯性
4. 提炼后不超过1000字
请直接输出提炼后的内容,无需其他说明。"""
# 待提炼的内容(放在inputs.inputText字段)
payload = {
"inputs": {
"inputText": chunk # 分段内容放在inputs字段
},
"query": query, # 提炼要求单独放在query字段
"response_mode": "blocking",
"user": ChatToolService.SUMMARIZE_API_USER
}
try:
async with httpx.AsyncClient(timeout=120.0) as client:
response = await client.post(
ChatToolService.SUMMARIZE_API_URL,
headers=headers,
json=payload
)
if response.status_code != 200:
logger.error(f"[分段 {chunk_index}/{total_chunks}] ✗ 提炼失败: {response.status_code}")
logger.error(f"响应内容: {response.text}")
# 失败时截断返回
return chunk[:1000]
result = response.json()
answer_text = result.get("answer", "")
# 尝试从answer中解析JSON格式的result
try:
answer_json = json.loads(answer_text)
summarized_content = answer_json.get("result", answer_text)
except json.JSONDecodeError:
summarized_content = answer_text
logger.info(f"[分段 {chunk_index}/{total_chunks}] ✓ 提炼成功,长度: {len(summarized_content)}字")
return summarized_content
except Exception as e:
logger.error(f"[分段 {chunk_index}/{total_chunks}] ✗ 提炼异常: {str(e)}")
return chunk[:1000] # 异常时截断返回
# 整个_summarize_answer_if_needed方法己作废,因为改走langchain了。
@staticmethod
async def _summarize_answer_if_needed(answer: str) -> str:
"""
如果回答内容超过阈值,则进行提炼
对于超长内容,会分段并发提炼后合并
Args:
answer: 回答内容
Returns:
str: 提炼后的内容(如果未超过阈值则返回原内容)
"""
content_length = len(answer)
logger.info(f"="*60)
logger.info(f"回答内容长度: {content_length}字")
logger.info(f"提炼阈值: {ChatToolService.SUMMARIZE_MAX_LENGTH}字")
logger.info(f"回答内容预览:\\n{answer[:200]}…")
# 如果内容未超过阈值,直接返回
if content_length <= ChatToolService.SUMMARIZE_MAX_LENGTH:
logger.info(f"✓ 无需提炼({content_length} <= {ChatToolService.SUMMARIZE_MAX_LENGTH})")
logger.info(f"直接使用原始内容")
logger.info(f"="*60)
return answer
# 需要提炼
logger.warning(f"✗ 需要提炼({content_length} > {ChatToolService.SUMMARIZE_MAX_LENGTH})")
# 分段大小:4000字一段
CHUNK_SIZE = 4000
chunks = []
# 将内容按4000字切分
for i in range(0, content_length, CHUNK_SIZE):
chunk = answer[i:i + CHUNK_SIZE]
chunks.append(chunk)
total_chunks = len(chunks)
logger.info(f"内容将被分为 {total_chunks} 段进行并发提炼(每段约{CHUNK_SIZE}字)")
# 并发调用提炼API
tasks = [
ChatToolService._summarize_single_chunk(chunk, idx + 1, total_chunks)
for idx, chunk in enumerate(chunks)
]
logger.info(f"开始并发提炼 {total_chunks} 个分段…")
summarized_chunks = await asyncio.gather(*tasks)
# 合并所有提炼后的分段
final_result = "\\n\\n".join(summarized_chunks)
logger.info(f"✓ 所有分段提炼完成!")
logger.info(f"提炼后总长度: {len(final_result)}字")
logger.info(f"提炼后内容预览: {final_result[:200]}…")
logger.info(f"="*60)
return final_result
@staticmethod
async def save_answer_with_summarization(username: str, answer: str) -> bool:
"""
保存回答内容到Redis(如果超过阈值则先提炼)
Args:
username: 用户名
answer: 回答内容
Returns:
bool: 保存是否成功
"""
try:
logger.info(f"开始为用户 {username} 保存回答内容")
# 如果需要,先提炼内容
processed_answer = await ChatToolService._summarize_answer_if_needed(answer)
# 保存到Redis
success = await ChatToolService._save_answer_to_redis(username, processed_answer)
if success:
logger.info(f"✓ 用户 {username} 的回答内容已成功保存")
else:
logger.error(f"✗ 用户 {username} 的回答内容保存失败")
return success
except Exception as e:
logger.error(f"保存回答内容时发生错误: {str(e)}", exc_info=True)
return False
@staticmethod
async def _save_abstract_to_redis(username: str, content: str) -> bool:
"""
保存提炼后的摘要内容到Redis(仅存储,不在代码中读取使用)
Args:
username: 用户名
content: 要保存的摘要内容
Returns:
bool: 保存是否成功
"""
try:
redis_client = get_redis_client()
key = ChatToolService.CHAT_HISTORY_ABSTRACT_KEY.format(username=username)
# 设置内容到Redis,过期时间为7天
redis_client.setex(key, 7 * 24 * 60 * 60, content)
logger.info(f"成功保存用户 {username} 的摘要内容到Redis (abstract)")
return True
except Exception as e:
logger.error(f"保存摘要内容到Redis失败: {str(e)}", exc_info=True)
return False
@staticmethod
async def _get_input_from_redis(username: str) -> str:
"""
从Redis获取上次的输入内容
Args:
username: 用户名
Returns:
str: 上次输入内容,如果不存在则返回空字符串
"""
try:
redis_client = get_redis_client()
key = ChatToolService.CHAT_HISTORY_INPUT_KEY.format(username=username)
content = redis_client.get(key)
if content:
return content.decode('utf-8') if isinstance(content, bytes) else content
return ""
except Exception as e:
logger.error(f"从Redis获取输入历史失败: {str(e)}", exc_info=True)
return ""
@staticmethod
async def _get_answer_from_redis(username: str) -> str:
"""
从Redis获取上次的回答内容
Args:
username: 用户名
Returns:
str: 上次回答内容,如果不存在则返回空字符串
"""
try:
redis_client = get_redis_client()
key = ChatToolService.CHAT_HISTORY_ANSWER_KEY.format(username=username)
content = redis_client.get(key)
if content:
return content.decode('utf-8') if isinstance(content, bytes) else content
return ""
except Exception as e:
logger.error(f"从Redis获取回答历史失败: {str(e)}", exc_info=True)
return ""
@staticmethod
async def get_last_input_summary(username: str) -> str:
"""
获取上次对话的提炼内容(用于lastInput参数)
Args:
username: 用户名
Returns:
str: 提炼后的上次对话内容,如果无历史或提炼失败则返回"无"
"""
try:
logger.info(f"\\n{'='*80}")
logger.info(f"开始获取用户 [{username}] 的上次对话历史")
logger.info(f"{'='*80}")
# 获取上次的输入和回答
last_input = await ChatToolService._get_input_from_redis(username)
last_answer = await ChatToolService._get_answer_from_redis(username)
# 如果没有历史记录,返回"无"
if not last_input and not last_answer:
logger.warning(f"用户 [{username}] 无历史记录")
logger.info(f"lastInput = '无'(默认值)")
logger.info(f"{'='*80}\\n")
await ChatToolService._save_abstract_to_redis(username, "无")
return "无"
logger.info(f"✓ 找到历史记录:")
logger.info(f" – 上次输入长度: {len(last_input)}字")
logger.info(f" – 上次回答长度: {len(last_answer)}字")
# 提炼上次对话
summarized = await ChatToolService._summarize_last_conversation(
last_input=last_input,
last_answer=last_answer
)
logger.info(f"\\n最终lastInput内容:")
logger.info(f"{'='*80}")
logger.info(f"{summarized}")
logger.info(f"{'='*80}\\n")
await ChatToolService._save_abstract_to_redis(username, summarized)
return summarized
except Exception as e:
logger.error(f"获取lastInput时发生严重错误: {str(e)}", exc_info=True)
logger.warning(f"返回默认值 lastInput = '无'")
logger.info(f"{'='*80}\\n")
await ChatToolService._save_abstract_to_redis(username, "无")
return "无"
@staticmethod
async def storeUserChatHistory(
username: str,
topic: str,
audience: str,
tone: str,
style_description: str,
reference_doc: str,
max_words: int,
system_role_msg: str,
answer: str
) -> None:
"""
异步保存用户对话历史(输入和回答分开保存)
这个方法会:
1. 将当前输入内容原样保存到 com:mkyuan:quickagent:chathistory:input:{username}
2. 将AI回答内容原样保存到 com:mkyuan:quickagent:chathistory:answer:{username}
Args:
username: 用户名
topic: 主题
audience: 受众
tone: 输出口吻
style_description: 书写风格说明
reference_doc: 参考文档
max_words: 最大字数
system_role_msg: 系统角色消息
answer: AI回答内容
"""
try:
logger.info(f"开始异步保存用户 {username} 的对话历史")
# 1. 构建输入内容
input_content = ChatToolService._build_input_content(
topic=topic,
audience=audience,
tone=tone,
style_description=style_description,
reference_doc=reference_doc,
max_words=max_words,
system_role_msg=system_role_msg
)
# 2. 保存输入到Redis
await ChatToolService._save_input_to_redis(username, input_content)
# 3. 保存回答到Redis
await ChatToolService._save_answer_to_redis(username, answer)
logger.info(f"用户 {username} 的对话历史保存完成")
except Exception as e:
logger.error(f"保存用户 {username} 的对话历史时发生错误: {str(e)}", exc_info=True)
@staticmethod
async def cleanHistorySession(username: str) -> bool:
"""
清除用户的历史会话记录
删除以下3个Redis键:
1. com:mkyuan:quickagent:chathistory:input:{username}
2. com:mkyuan:quickagent:chathistory:answer:{username}
3. com:mkyuan:quickagent:chathistory:abstract:{username}
Args:
username: 用户名
Returns:
bool: 清除是否成功
"""
try:
logger.info(f"开始清除用户 [{username}] 的历史会话记录")
redis_client = get_redis_client()
# 构建3个需要删除的key
input_key = ChatToolService.CHAT_HISTORY_INPUT_KEY.format(username=username)
answer_key = ChatToolService.CHAT_HISTORY_ANSWER_KEY.format(username=username)
abstract_key = ChatToolService.CHAT_HISTORY_ABSTRACT_KEY.format(username=username)
# 删除这3个键
deleted_count = 0
# 删除输入历史
if redis_client.delete(input_key) > 0:
deleted_count += 1
logger.info(f"✓ 已删除输入历史键: {input_key}")
else:
logger.info(f"○ 输入历史键不存在: {input_key}")
# 删除回答历史
if redis_client.delete(answer_key) > 0:
deleted_count += 1
logger.info(f"✓ 已删除回答历史键: {answer_key}")
else:
logger.info(f"○ 回答历史键不存在: {answer_key}")
# 删除摘要
if redis_client.delete(abstract_key) > 0:
deleted_count += 1
logger.info(f"✓ 已删除摘要键: {abstract_key}")
else:
logger.info(f"○ 摘要键不存在: {abstract_key}")
logger.info(f"清除完成!共删除 {deleted_count} 个键")
return True
except Exception as e:
logger.error(f"清除用户 {username} 的历史会话时发生错误: {str(e)}", exc_info=True)
return False
# 创建服务实例
chat_tool_service = ChatToolService()
- 标明己作废的方法就不需要看了。
- 主要是保存用户的输入,以及AI的回答进redis和获取的代码。
7. 来看运行效果
写一篇爆文
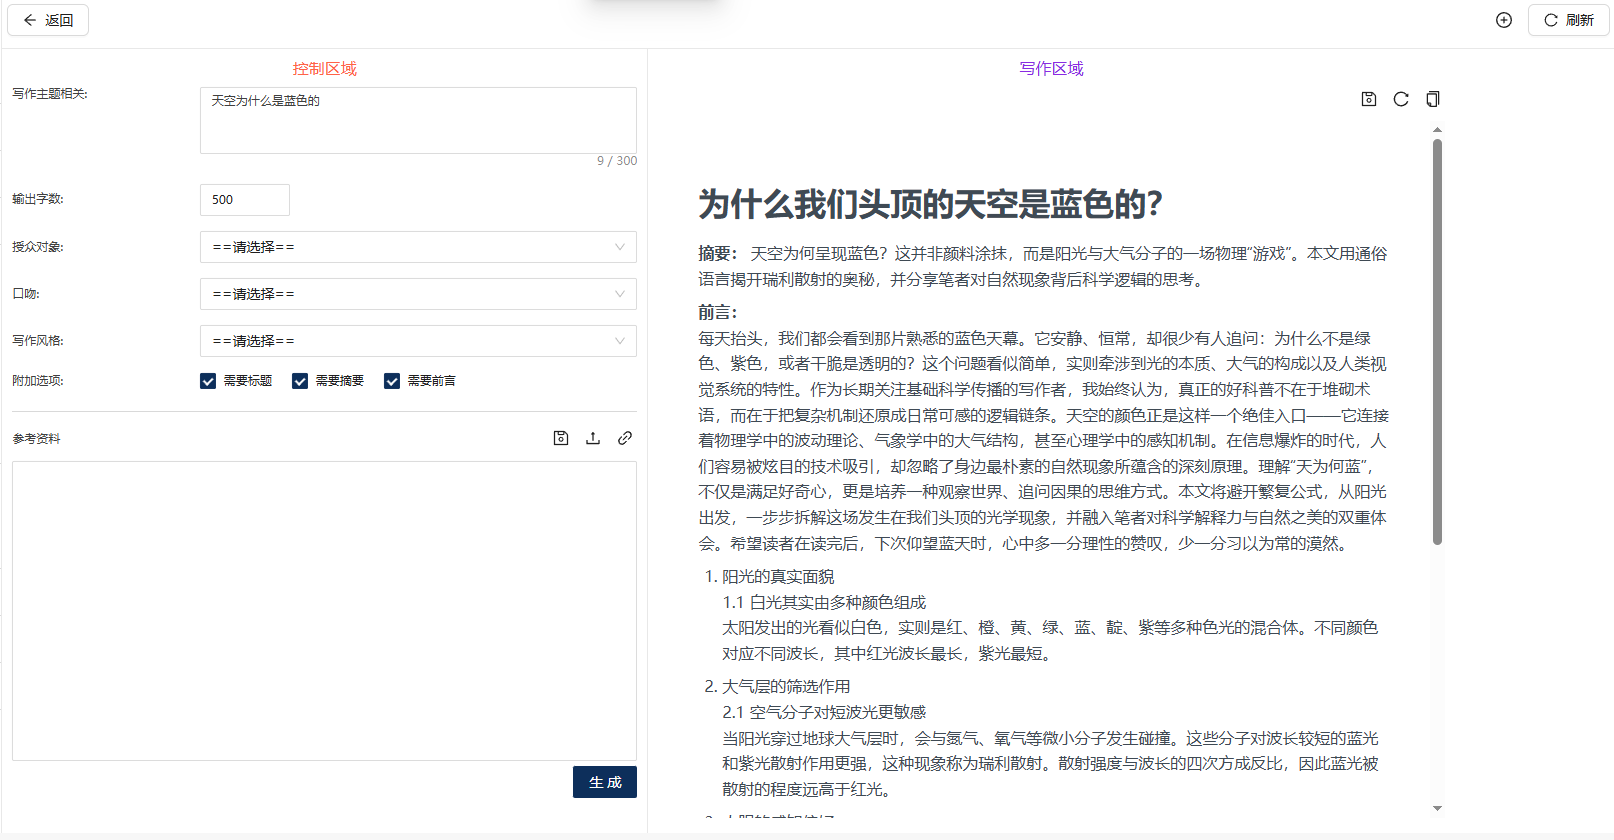
# 为什么我们头顶的天空是蓝色的?
**摘要:** 天空为何呈现蓝色?这并非颜料涂抹,而是阳光与大气分子的一场物理“游戏”。本文用通俗语言揭开瑞利散射的奥秘,并分享笔者对自然现象背后科学逻辑的思考。
**前言:**
每天抬头,我们都会看到那片熟悉的蓝色天幕。它安静、恒常,却很少有人追问:为什么不是绿色、紫色,或者干脆是透明的?这个问题看似简单,实则牵涉到光的本质、大气的构成以及人类视觉系统的特性。作为长期关注基础科学传播的写作者,我始终认为,真正的好科普不在于堆砌术语,而在于把复杂机制还原成日常可感的逻辑链条。天空的颜色正是这样一个绝佳入口——它连接着物理学中的波动理论、气象学中的大气结构,甚至心理学中的感知机制。在信息爆炸的时代,人们容易被炫目的技术吸引,却忽略了身边最朴素的自然现象所蕴含的深刻原理。理解“天为何蓝”,不仅是满足好奇心,更是培养一种观察世界、追问因果的思维方式。本文将避开繁复公式,从阳光出发,一步步拆解这场发生在我们头顶的光学现象,并融入笔者对科学解释力与自然之美的双重体会。希望读者在读完后,下次仰望蓝天时,心中多一分理性的赞叹,少一分习以为常的漠然。
1. 阳光的真实面貌
1.1 白光其实由多种颜色组成
太阳发出的光看似白色,实则是红、橙、黄、绿、蓝、靛、紫等多种色光的混合体。不同颜色对应不同波长,其中红光波长最长,紫光最短。
2. 大气层的筛选作用
2.1 空气分子对短波光更敏感
当阳光穿过地球大气层时,会与氮气、氧气等微小分子发生碰撞。这些分子对波长较短的蓝光和紫光散射作用更强,这种现象称为瑞利散射。散射强度与波长的四次方成反比,因此蓝光被散射的程度远高于红光。
3. 人眼的感知偏好
3.1 我们看到的不是全部散射光
尽管紫光波长更短、散射更强,但太阳光中紫光成分较少,且人眼对紫光敏感度较低。相比之下,蓝光既充足又容易被视网膜捕捉,最终主导了我们对天空颜色的感知。
| 光色 | 波长(纳米) | 散射强度(相对值) | 人眼敏感度 |
|——|————–|——————-|————|
| 紫 | 400 | 10.5 | 低 |
| 蓝 | 450 | 6.7 | 高 |
| 红 | 650 | 1.0 | 中 |
笔者认为,自然现象的解释往往需要多学科交叉验证。单一强调物理散射或仅谈视觉感知都不足以完整回答“天为何蓝”。真正的理解在于整合光的物理属性、大气介质特性与生物感知机制三者之间的协同关系。这种系统性思维,正是科学素养的核心。
天空的蓝,是宇宙规律与人类感官共同书写的日常诗篇。
续写一下
续写时我们的设置如下:
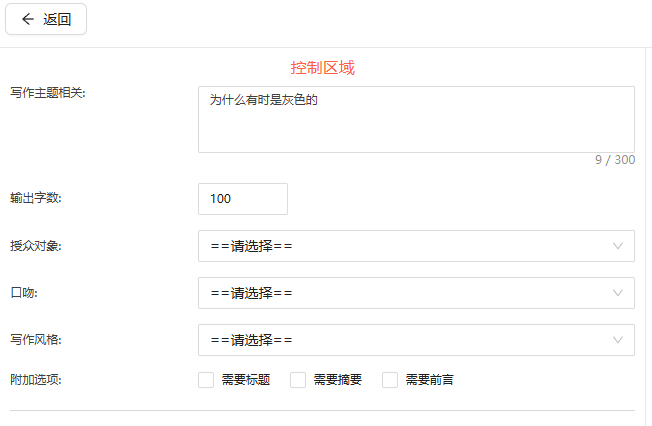
看,而把参考资料保持为空
来看输出
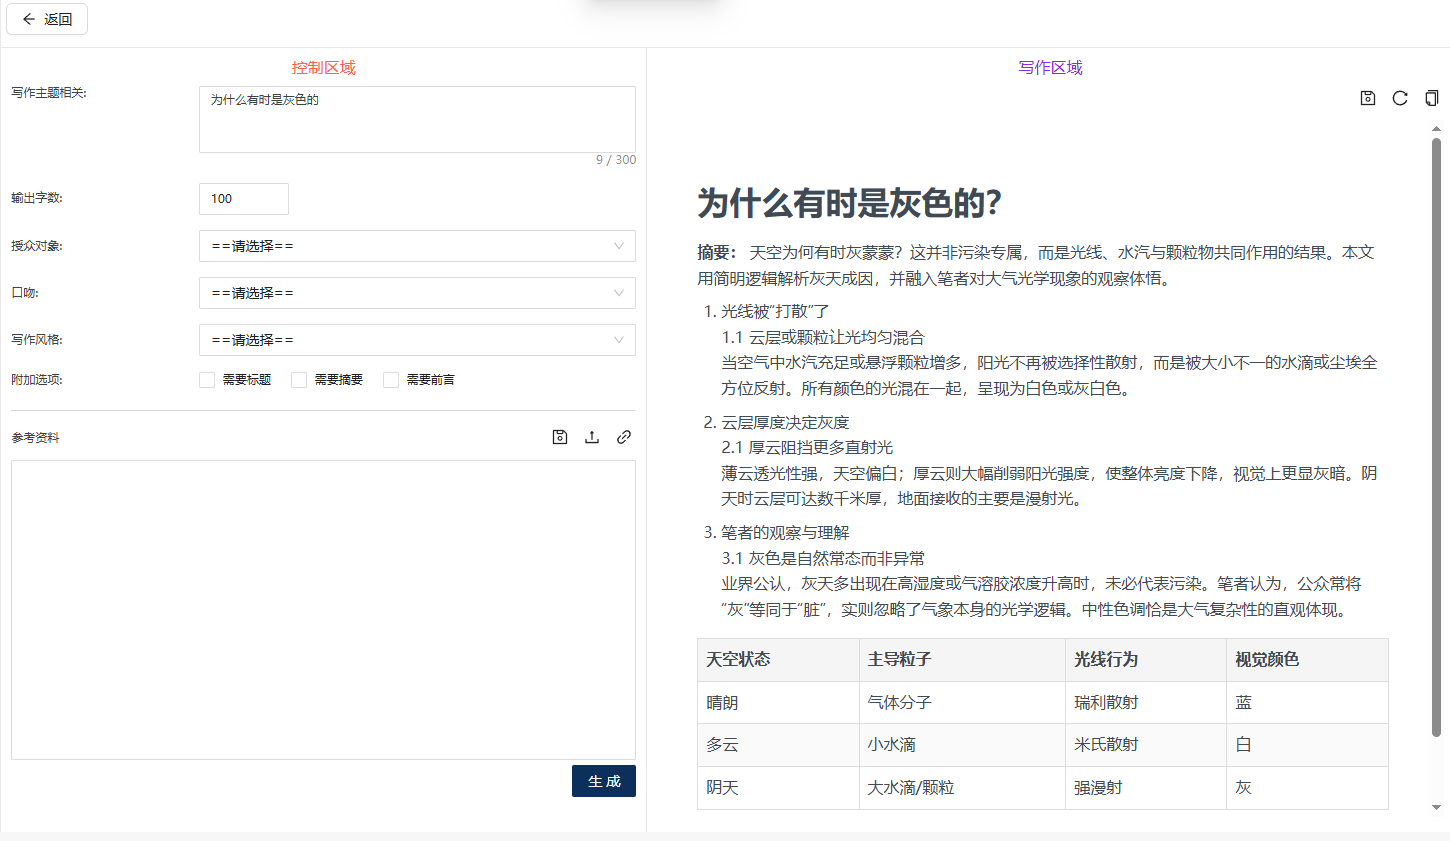
# 为什么有时是灰色的?
**摘要:** 天空为何有时灰蒙蒙?这并非污染专属,而是光线、水汽与颗粒物共同作用的结果。本文用简明逻辑解析灰天成因,并融入笔者对大气光学现象的观察体悟。
1. 光线被“打散”了
1.1 云层或颗粒让光均匀混合
当空气中水汽充足或悬浮颗粒增多,阳光不再被选择性散射,而是被大小不一的水滴或尘埃全方位反射。所有颜色的光混在一起,呈现为白色或灰白色。
2. 云层厚度决定灰度
2.1 厚云阻挡更多直射光
薄云透光性强,天空偏白;厚云则大幅削弱阳光强度,使整体亮度下降,视觉上更显灰暗。阴天时云层可达数千米厚,地面接收的主要是漫射光。
3. 笔者的观察与理解
3.1 灰色是自然常态而非异常
业界公认,灰天多出现在高湿度或气溶胶浓度升高时,未必代表污染。笔者认为,公众常将“灰”等同于“脏”,实则忽略了气象本身的光学逻辑。中性色调恰是大气复杂性的直观体现。
| 天空状态 | 主导粒子 | 光线行为 | 视觉颜色 |
|———-|———-|———-|———-|
| 晴朗 | 气体分子 | 瑞利散射 | 蓝 |
| 多云 | 小水滴 | 米氏散射 | 白 |
| 阴天 | 大水滴/颗粒 | 强漫射 | 灰 |
天空的灰,是光在混沌中寻求平衡的沉默表达。
无论是从行文风格,还是续写上一篇来説,太完美了!
8. 写在最后
在本次实现中,我们构建的爆文生成器不仅支持长文本分块生成,更关键的是具备了续写能力——系统能记住上一轮的用户输入与AI输出,作为下一次生成的上下文锚点。这种机制在短期会话中已足够有效。若要实现真正的永久记忆,即用户可随时调用任意历史生成片段继续创作,则需将当前基于Redis的临时缓存升级为向量数据库存储。
具体而言,将每次交互的lastInput与lastAnswer通过embedding模型转化为向量,存入持久化向量库,后续通过语义相似度检索召回上下文。该方案在工程上并无高深门槛,主流向量数据库如Chroma、Pinecone或Milvus均提供简洁API。
笔者认为,短期记忆适合快速迭代,长期记忆则赋予系统真正的“创作连续性”。这种从临时缓存到语义记忆的演进,正是智能写作工具从“响应式”迈向“伴随式”的关键一步。技术本身并不炫目,但当它默默支撑起创作者的思维延续时,才真正显现出价值。