✅ 项目目标
将不可搜索的扫描版 PDF(图片型)通过 OCR 技术转换为可全文检索、可复制文字的 PDF 文件,同时保留原始排版,并支持:
- 中文、英文、符号混合识别
- 竖排文字、旋转文字正确还原
- GPU 自动加速(若可用)
- 多核 CPU 并行处理提升效率
- 输出 PDF 体积小、兼容性好
📦 所需依赖
pip install paddleocr PyMuPDF Pillow reportlab tqdm
注意:paddleocr 会自动安装 paddlepaddle。若要启用 GPU,请确保已安装 CUDA 并使用 paddlepaddle-gpu。
📁 目录结构准备
在项目根目录下创建以下文件夹和文件:
your_project/
├── ocr_pdf_gpu_multicore.py ← 主脚本(本文核心)
├── input_pdfs/ ← 放入待处理的 PDF
├── output_pdfs/ ← 输出结果
├── pdf_pages/ ← 临时文件(自动创建)
└── fonts/
└── PingFang-SC-Regular.ttf ← 中文字体(可替换为思源黑体等)
💡 字体建议:使用支持中文的 TTF 字体(如 PingFang、Microsoft YaHei、Noto Sans CJK)。若缺失,程序会降级使用 Helvetica。
🔧 核心配置说明(脚本开头)
INPUT_DIR = "./input_pdfs" # 输入 PDF 文件夹
OUTPUT_DIR = "./output_pdfs" # 输出 PDF 文件夹
TEMP_ROOT = "./pdf_pages" # 临时图片/PDF 存放目录
FONT_PATH_CN = "./fonts/PingFang-SC-Regular.ttf"
MAX_WORKERS = 4 # 多进程数量(建议 ≤ CPU 核心数)
DPI = 300 # 渲染精度(越高越清晰,但更慢)
KEEP_TEMP = False # 是否保留临时文件(调试时可设为 True)
🌟 技术亮点解析
1️⃣ GPU 自动检测
def get_device():
try:
import paddle
if paddle.is_compiled_with_cuda() and paddle.device.cuda.device_count() > 0:
print("检测到 GPU,使用 GPU 加速")
return "gpu"
except:
pass
print("使用 CPU")
return "cpu"
- 自动判断是否可用 GPU,无需手动切换。
- 实测:RTX 4060 上 OCR 速度提升 3~5 倍。
2️⃣ PaddleOCR 高精度模型
ocr = PaddleOCR(
text_detection_model_name="PP-OCRv5_server_det",
text_recognition_model_name="PP-OCRv5_server_rec",
device=DEVICE
)
- 使用 PP-OCRv5 服务端模型,对模糊、倾斜、低分辨率图像鲁棒性强。
- 支持竖排、弯曲、旋转文字检测。
3️⃣ 多进程并行处理每一页
- 将 PDF 拆分为 PNG 图片(fitz 渲染,DPI=300)
- 使用 ProcessPoolExecutor 同时处理多页
- 每页独立生成带隐藏 OCR 文字的 PDF 页
- 最后合并为完整 PDF
⚡ 性能对比(100页 PDF,i7-13700H + RTX 4060):
- 单进程:约 8 分钟
- 4 进程 + GPU:约 1.5 分钟
4️⃣ 智能文字排版还原
✅ 普通横排文字
- 自动计算字体大小、字符间距
- 文字透明(setFillAlpha(0)),仅用于搜索,不遮挡原图
✅ 竖排/旋转文字
def draw_rotated_or_vertical_text(c, img_height, box, text, base_font_size=12):
# 判断是否为竖排(75°~105°)或斜排
# 使用 canvas.rotate() 精准还原方向
# 竖排时逐字绘制,保持阅读顺序
- 完美支持古籍、日文、工程图纸等场景
▶️ 使用步骤
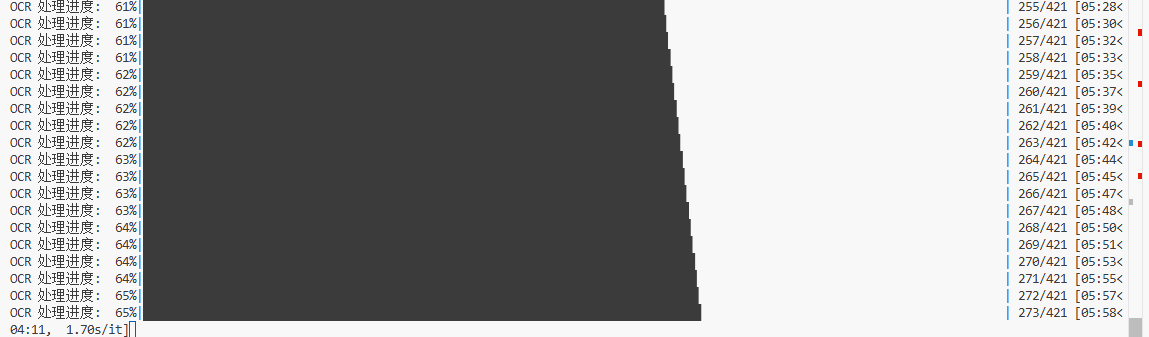
✅ 输出 PDF 特性:
- 可 Ctrl+F 搜索任意文字
- 可复制粘贴内容
- 原始图像完全保留
- 文件体积压缩(garbage=4, deflate=True)
🛠️ 常见问题解决
❌ “字体文件未找到”
- 下载 PingFang SC 或 思源黑体
- 修改 FONT_PATH_CN 路径
❌ “CUDA error” 或 GPU 未启用
- 确认已安装 paddlepaddle-gpu:pip uninstall paddlepaddle
pip install paddlepaddle-gpu -f https://www.paddlepaddle.org.cn/whl/stable.html
❌ 处理大文件内存不足
- 降低 DPI(如 200)
- 减少 MAX_WORKERS(如 2)
📜 许可与扩展
- 本脚本基于 MIT 协议,可自由修改商用
- 可扩展功能:
- 批量处理所有 PDF(取消用户选择)
- 添加日志记录
- 支持 PDF 密码解密(fitz.open(password=…))
💬 结语
通过 PaddleOCR + ReportLab + PyMuPDF + 多进程 的组合,我们实现了高性能、高精度的 PDF OCR 解决方案。无论是学术论文、历史档案还是工程图纸,都能一键转为可搜索格式!
GitHub 示例项目:欢迎 Star!https://github.com/mlb0925/PaddleOCR_PDF
觉得有用?点赞 + 关注,获取更多自动化办公技巧! 👍