引言
在工业物联网(IIoT)场景中,时序数据库Apache IoTDB凭借其高效的写入性能和灵活的查询能力,成为处理海量设备数据的首选方案。然而在实际业务中,数据缺失和分页查询的性能瓶颈常困扰着开发者。
Apache IoTDB 时序数据库【系列篇章】:
| 1 | Apache IoTDB(1):时序数据库介绍与单机版安装部署指南 |
| 2 | Apache IoTDB(2):时序数据库 IoTDB 集群安装部署的技术优势与适用场景分析 |
| 3 | Apache IoTDB(3):时序数据库 IoTDB Docker部署从单机到集群的全场景部署与实践指南 |
| 4 | Apache IoTDB(4):深度解析时序数据库 IoTDB 在Kubernetes 集群中的部署与实践指南 |
| 5 | Apache IoTDB(5):深度解析时序数据库 IoTDB 中 AINode 工具的部署与实践 |
| 6 | Apache IoTDB(6):深入解析数据库管理操作——增删改查与异构数据库实战指南 |
| 7 | Apache IoTDB(7):设备模板管理——工业物联网元数据标准化的破局之道 |
| 8 | Apache IoTDB(8):时间序列管理——从创建到分析的实战指南 |
| 9 | Apache IoTDB(9):数据库操作——数据写入从CLI到集群部署的六种实战 |
| 10 | Apache IoTDB(10):数据库操作——从查询到优化的全链路实践指南 |
| 11 | Apache IoTDB(11):分段聚合深度解析——从原理到实战的完整指南 |
| 12 | Apache IoTDB(12):深度解析时序数据聚合的GROUP BY与HAVING子句 |
本文将讲解IoTDB的FILL子句与LIMIT/SLIMIT子句两大核心特性,揭示其底层原理、使用技巧及性能优化策略。
一、结果集补空值—FILL子句的解构
1.1 功能介绍
当执行一些数据查询时,结果集的某行某列可能没有数据,则此位置结果为空,但这种空值不利于进行数据可视化展示和分析,需要对空值进行填充。
在 IoTDB 中,用户可以使用 FILL 子句指定数据缺失情况下的填充模式,允许用户按照特定的方法对任何查询的结果集填充空值,如取前一个不为空的值、线性插值等。
1.2 语法定义
FILL 子句的语法定义如下:
FILL '(' PREVIOUS | LINEAR | constant ')'
注意:
在 Fill 语句中只能指定一种填充方法,该方法作用于结果集的全部列。 空值填充不兼容 0.13 版本及以前的语法(即不支持 FILL((<data_type>[<fill_method>(, <before_range>, <after_range>)?])+))
1.3 填充方式
IoTDB 目前支持以下三种空值填充方式:
PREVIOUS 填充:使用该列前一个非空值进行填充。 LINEAR 填充:使用该列前一个非空值和下一个非空值的线性插值进行填充。 常量填充:使用指定常量填充。
各数据类型支持的填充方法如下表所示:
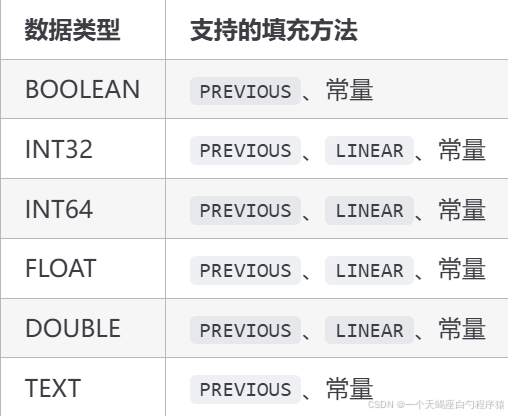 对于数据类型不支持指定填充方法的列,既不会填充它,也不会报错,只是让那一列保持原样
通过举例说明
如果我们不使用任何填充方式:
select temperature, status from root.sgcc.wf03.wt01 where time >= 2017–11–01T16:37:00.000 and time <= 2017–11–01T16:40:00.000;
结果如下: 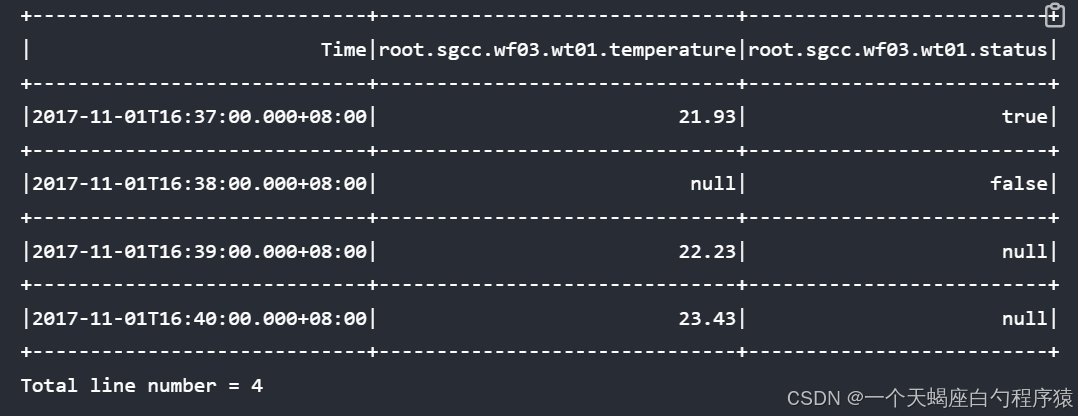 PREVIOUS 填充
对于查询结果集中的空值,使用该列前一个非空值进行填充。
注意: 如果结果集的某一列第一个值就为空,则不会填充该值,直到遇到该列第一个非空值为止。
例如,使用 PREVIOUS 填充,SQL 语句如下:
select temperature, status from root.sgcc.wf03.wt01 where time >= 2017–11–01T16:37:00.000 and time <= 2017–11–01T16:40:00.000 fill(previous);
PREVIOUS 填充后的结果如下: 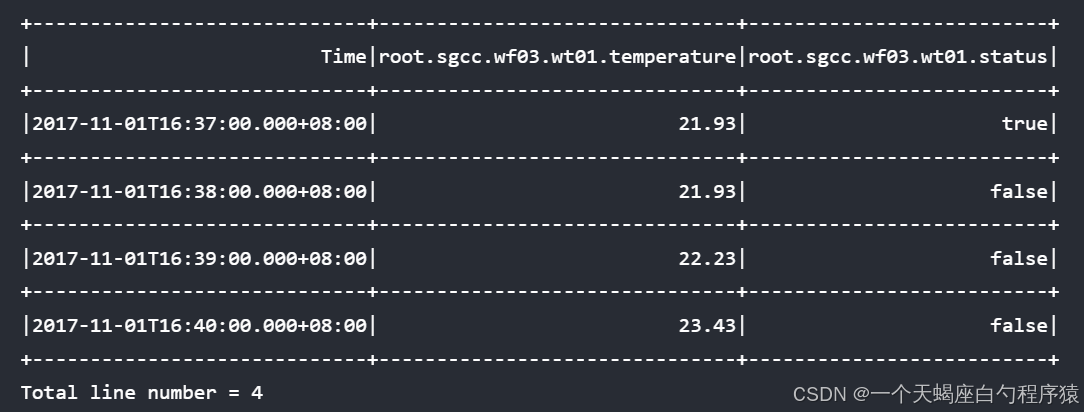 在前值填充时,能够支持指定一个时间间隔,如果当前null值的时间戳与前一个非null值的时间戳的间隔,超过指定的时间间隔,则不进行填充.
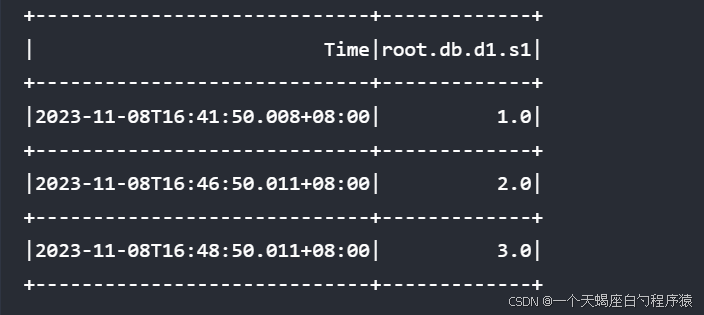
在线性填充和常量填充的情况下,如果指定了第二个参数,会抛出异常 时间超时参数仅支持整数 例如,原始数据如下:
select s1 from root.db.d1
 根据时间分组,每1分钟求一个平均值
select avg(s1)
from root.db.d1
group by([2023–11–08T16:40:00.008+08:00, 2023–11–08T16:50:00.008+08:00), 1m)
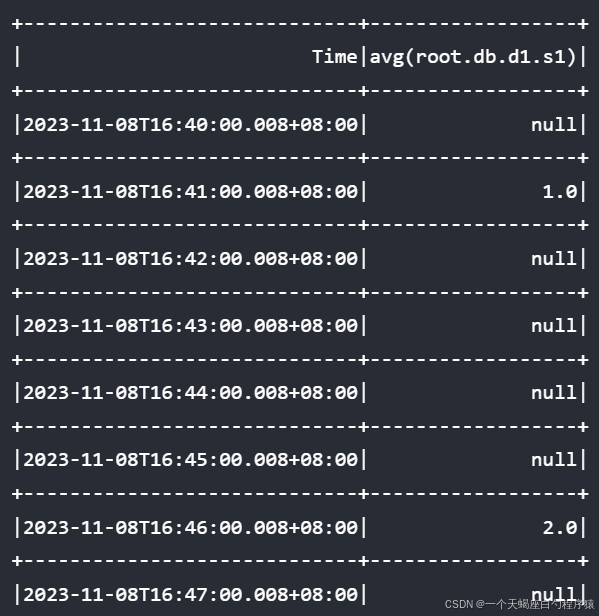 根据时间分组并用前值填充
select avg(s1)
from root.db.d1
group by([2023–11–08T16:40:00.008+08:00, 2023–11–08T16:50:00.008+08:00), 1m)
FILL(PREVIOUS);
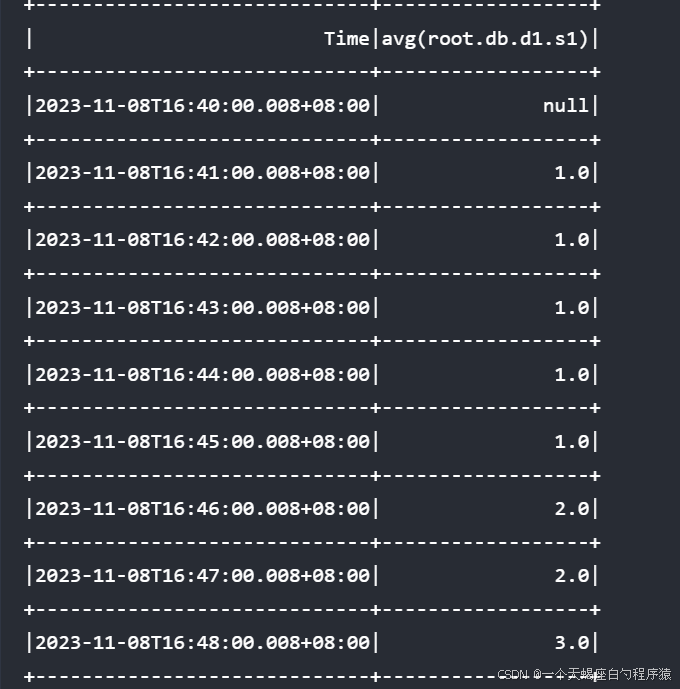 根据时间分组并用前值填充,并指定超过2分钟的就不填充
select avg(s1)
from root.db.d1
group by([2023–11–08T16:40:00.008+08:00, 2023–11–08T16:50:00.008+08:00), 1m)
FILL(PREVIOUS, 2m);
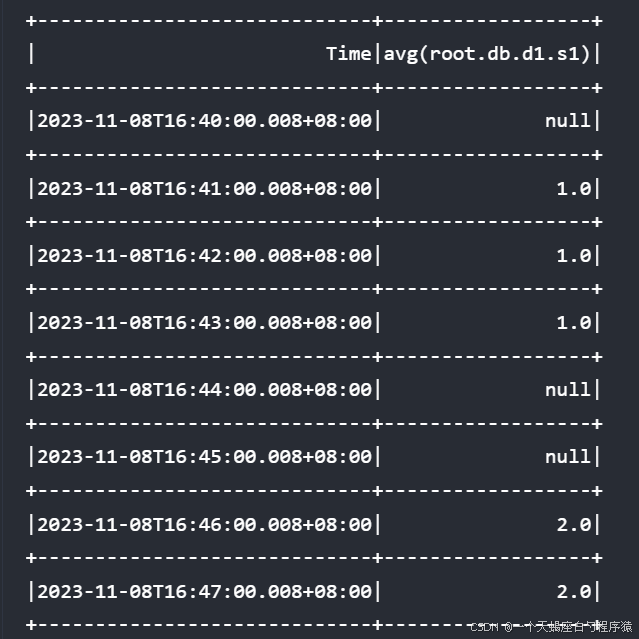 LINEAR 填充
对于查询结果集中的空值,使用该列前一个非空值和下一个非空值的线性插值进行填充。
注意:
如果某个值之前的所有值都为空,或者某个值之后的所有值都为空,则不会填充该值。 如果某列的数据类型为boolean/text,我们既不会填充它,也不会报错,只是让那一列保持原样。
例如,使用 LINEAR 填充,SQL 语句如下:
select temperature, status from root.sgcc.wf03.wt01 where time >= 2017–11–01T16:37:00.000 and time <= 2017–11–01T16:40:00.000 fill(linear);
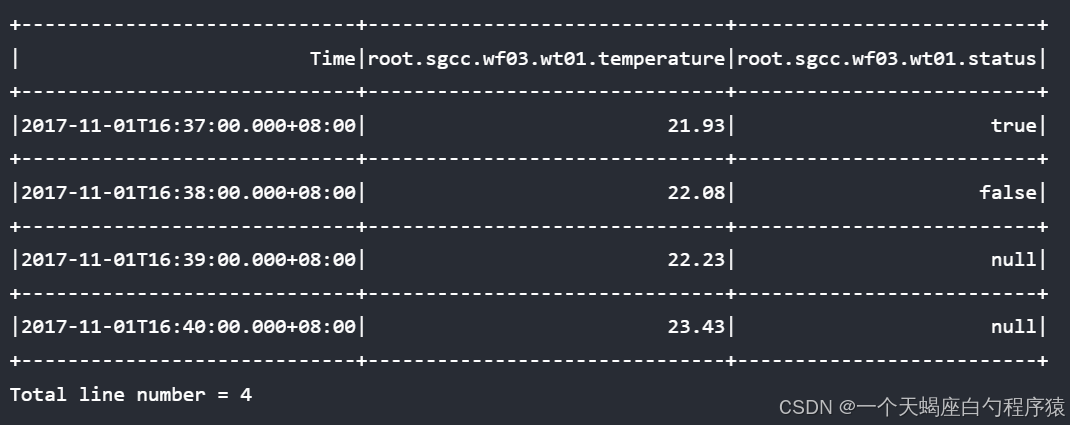 常量填充
对于查询结果集中的空值,使用指定常量填充。
注意:
如果某列数据类型与常量类型不兼容,既不填充该列,也不报错,将该列保持原样。对于常量兼容的数据类型,如下表所示:
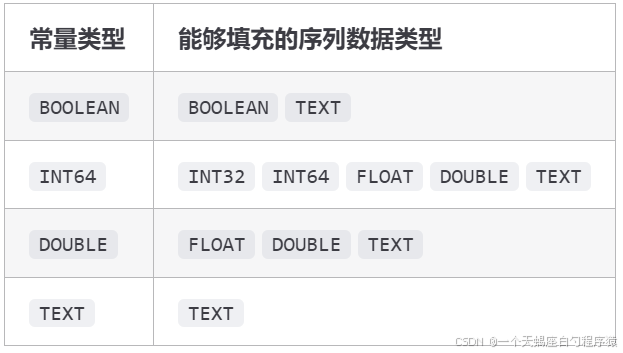
当常量值大于 INT32 所能表示的最大值时,对于 INT32 类型的列,既不填充该列,也不报错,将该列保持原样。
例如,使用 FLOAT 类型的常量填充,SQL 语句如下:
select temperature, status from root.sgcc.wf03.wt01 where time >= 2017–11–01T16:37:00.000 and time <= 2017–11–01T16:40:00.000 fill(2.0);
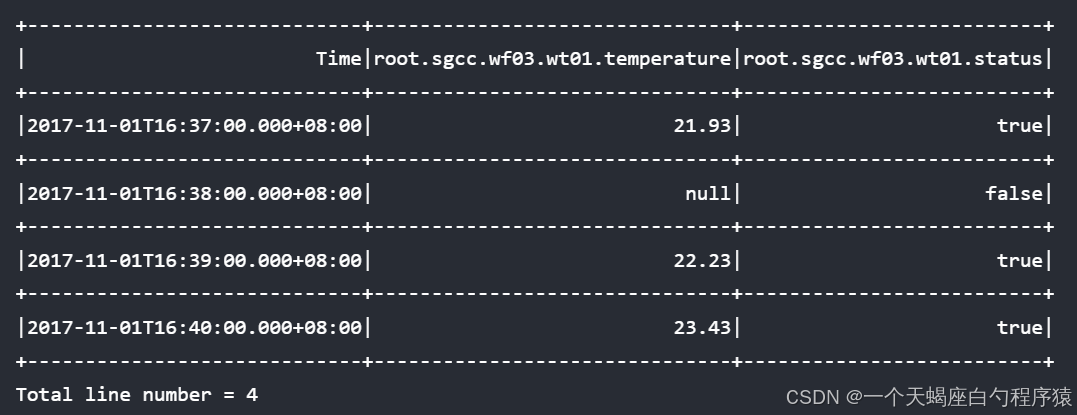
FLOAT 类型的常量填充后的结果如下: 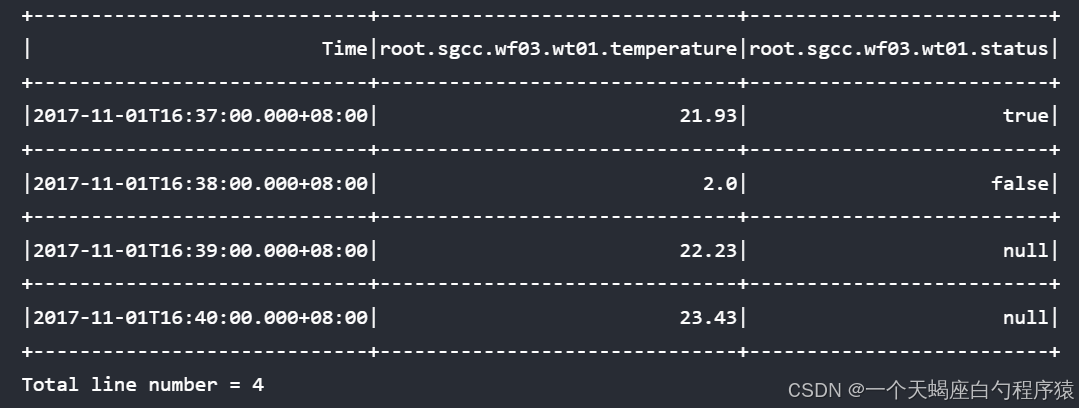 再比如,使用 BOOLEAN 类型的常量填充,SQL 语句如下:
select temperature, status from root.sgcc.wf03.wt01 where time >= 2017–11–01T16:37:00.000 and time <= 2017–11–01T16:40:00.000 fill(true);
二、查询结果分页:LIMIT/SLIMIT
当查询结果集数据量很大,放在一个页面不利于显示,可以使用 LIMIT/SLIMIT 子句和 OFFSET/SOFFSET 子句进行分页控制。
LIMIT 和 SLIMIT 子句用于控制查询结果的行数和列数。 OFFSET 和 SOFFSET 子句用于控制结果显示的起始位置。
2.1 按行分页
用户可以通过 LIMIT 和 OFFSET 子句控制查询结果的行数,LIMIT rowLimit 指定查询结果的行数,OFFSET rowOffset 指定查询结果显示的起始行位置。
注意:
当 rowOffset 超过结果集的大小时,返回空结果集。 当 rowLimit 超过结果集的大小时,返回所有查询结果。 当 rowLimit 和 rowOffset 不是正整数,或超过 INT64 允许的最大值时,系统将提示错误。
我们将通过以下示例如何使用 LIMIT 和 OFFSET 子句。
示例 1: 基本的 LIMIT 子句 SQL 语句:
select status, temperature from root.ln.wf01.wt01 limit 10
含义: 所选设备为 ln 组 wf01 工厂 wt01 设备; 选择的时间序列是“状态”和“温度”。 SQL 语句要求返回查询结果的前 10 行。
结果: 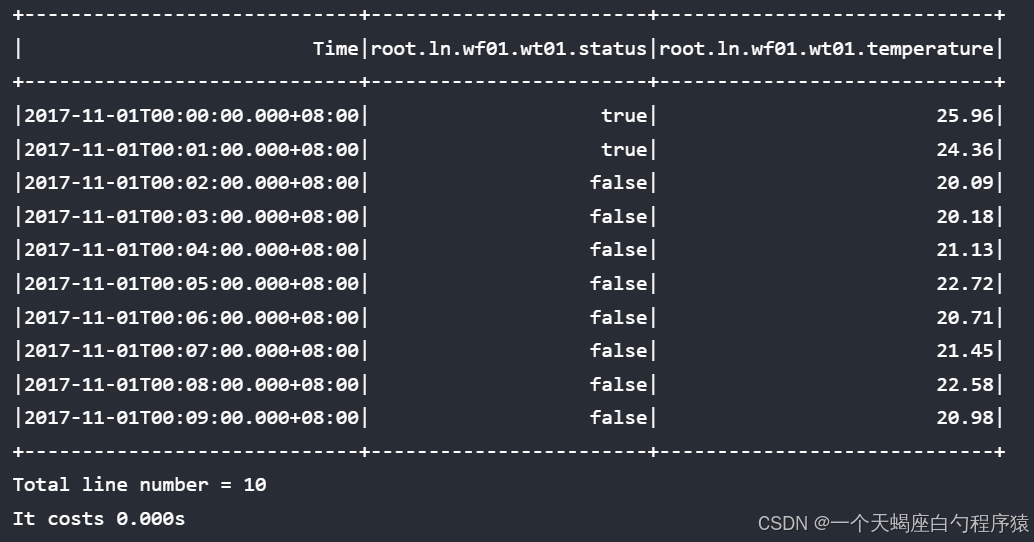 示例 2: 带 OFFSET 的 LIMIT 子句 SQL 语句:
select status, temperature from root.ln.wf01.wt01 limit 5 offset 3
含义: 所选设备为 ln 组 wf01 工厂 wt01 设备; 选择的时间序列是“状态”和“温度”。 SQL 语句要求返回查询结果的第 3 至 7 行(第一行编号为 0 行)。
结果: 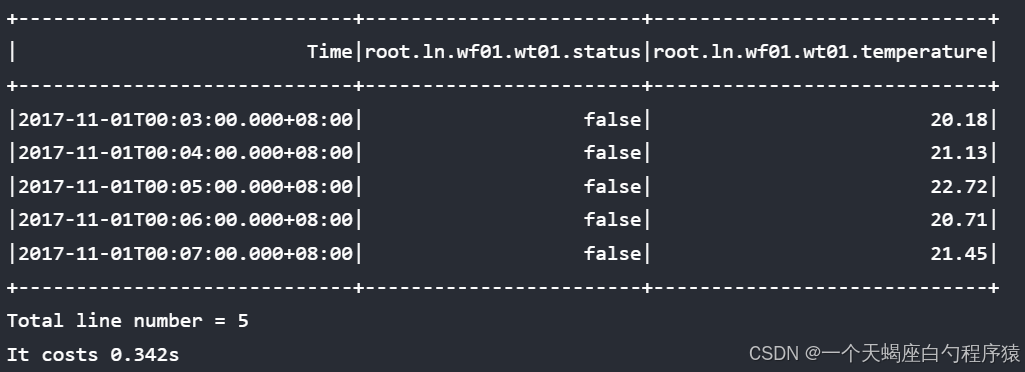
示例 3: LIMIT 子句与 WHERE 子句结合 SQL 语句:
select status,temperature from root.ln.wf01.wt01 where time > 2024–07–07T00:05:00.000 and time< 2024–07–12T00:12:00.000 limit 5 offset 3
含义: 所选设备为 ln 组 wf01 工厂 wt01 设备; 选择的时间序列是“状态”和“温度”。 SQL 语句要求返回时间“ 2024-07-07T00:05:00.000”和“ 2024-07-12T00:12:00.000”之间的状态和温度传感器值的第 3 至 7 行(第一行编号为第 0 行)。
结果:
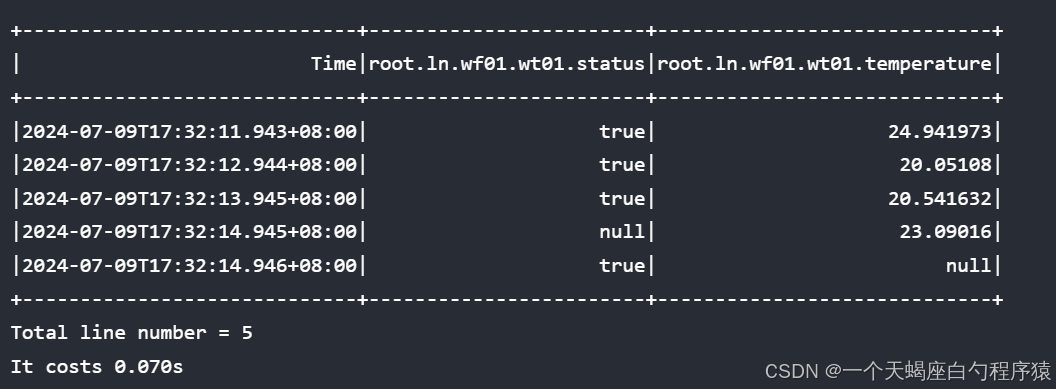
示例 4:LIMIT 子句与 GROUP BY 子句组合
SQL 语句:
select count(status), max_value(temperature) from root.ln.wf01.wt01 group by ([2017–11–01T00:00:00, 2017–11–07T23:00:00),1d) limit 4 offset 3
含义: SQL 语句子句要求返回查询结果的第 3 至 6 行(第一行编号为 0 行)。
结果:
+—————————–+——————————-+—————————————-+
| Time|count(root.ln.wf01.wt01.status)|max_value(root.ln.wf01.wt01.temperature)|
+—————————–+——————————-+—————————————-+
|2017-11-04T00:00:00.000+08:00| 1440| 26.0|
|2017-11-05T00:00:00.000+08:00| 1440| 26.0|
|2017-11-06T00:00:00.000+08:00| 1440| 25.99|
|2017-11-07T00:00:00.000+08:00| 1380| 26.0|
+—————————–+——————————-+—————————————-+
Total line number = 4
It costs 0.016s
2.2 按列分页
用户可以通过 SLIMIT 和 SOFFSET 子句控制查询结果的列数,SLIMIT seriesLimit 指定查询结果的列数,SOFFSET seriesOffset 指定查询结果显示的起始列位置。
注意:
仅用于控制值列,对时间列和设备列无效。 当 seriesOffset 超过结果集的大小时,返回空结果集。 当 seriesLimit 超过结果集的大小时,返回所有查询结果。 当 seriesLimit 和 seriesOffset 不是正整数,或超过 INT64 允许的最大值时,系统将提示错误。
我们将通过以下示例演示如何使用 SLIMIT 和 SOFFSET 子句。
示例 1: 基本的 SLIMIT 子句 SQL 语句:
select * from root.ln.wf01.wt01 where time > 2017–11–01T00:05:00.000 and time < 2017–11–01T00:12:00.000 slimit 1
含义: 所选设备为 ln 组 wf01 工厂 wt01 设备; 所选时间序列是该设备下的第二列,即温度。 SQL 语句要求在"2017-11-01T00:05:00.000"和"2017-11-01T00:12:00.000"的时间点之间选择温度传感器值。
结果: 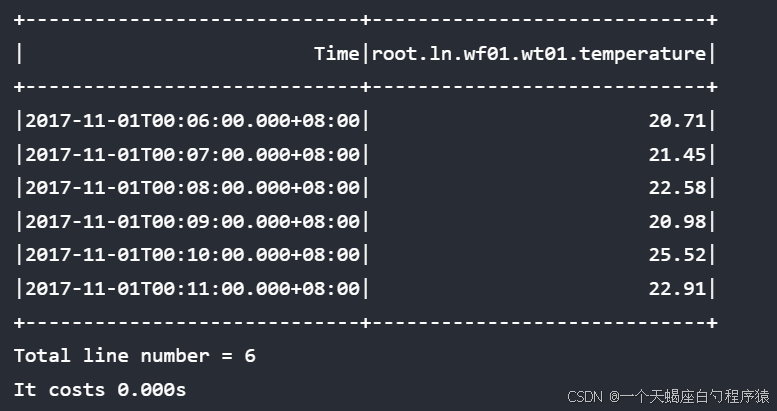 示例 2: 带 SOFFSET 的 SLIMIT 子句 SQL 语句:
select * from root.ln.wf01.wt01 where time > 2017–11–01T00:05:00.000 and time < 2017–11–01T00:12:00.000 slimit 1 soffset 1
含义: 所选设备为 ln 组 wf01 工厂 wt01 设备; 所选时间序列是该设备下的第一列,即电源状态。 SQL 语句要求在" 2017-11-01T00:05:00.000"和"2017-11-01T00:12:00.000"的时间点之间选择状态传感器值。
结果: 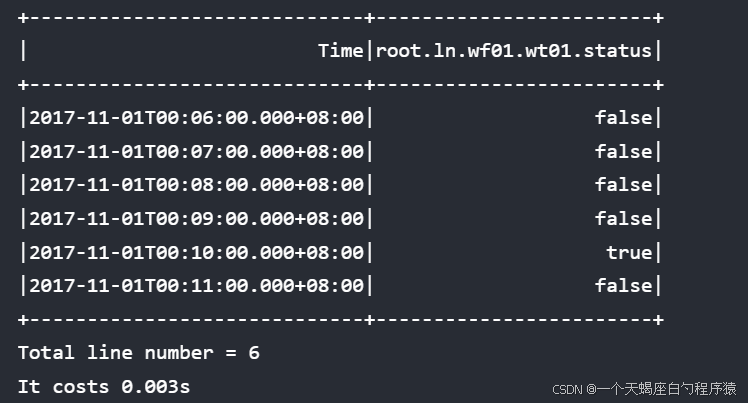 示例 3: SLIMIT 子句与 GROUP BY 子句结合 SQL 语句:
select max_value(*) from root.ln.wf01.wt01 group by ([2017–11–01T00:00:00, 2017–11–07T23:00:00),1d) slimit 1 soffset 1
结果: 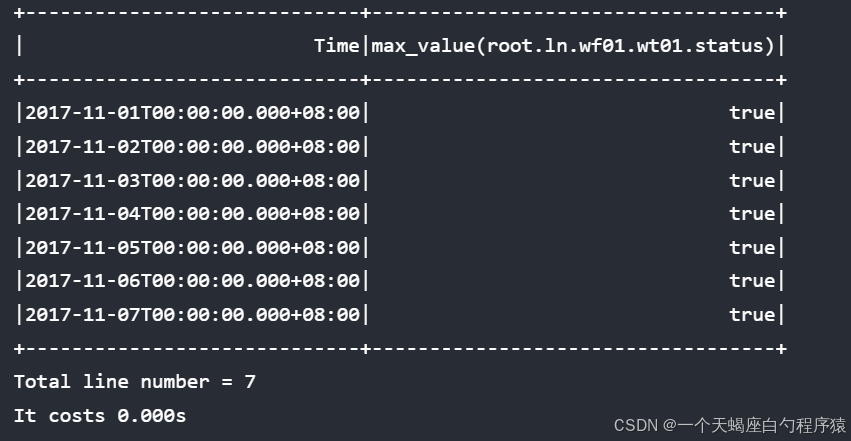 示例 4: SLIMIT 子句与 LIMIT 子句结合 SQL 语句:
select * from root.ln.wf01.wt01 limit 10 offset 100 slimit 2 soffset 0
含义: 所选设备为 ln 组 wf01 工厂 wt01 设备; 所选时间序列是此设备下的第 0 列至第 1 列(第一列编号为第 0 列)。 SQL 语句子句要求返回查询结果的第 100 至 109 行(第一行编号为 0 行)。
结果: 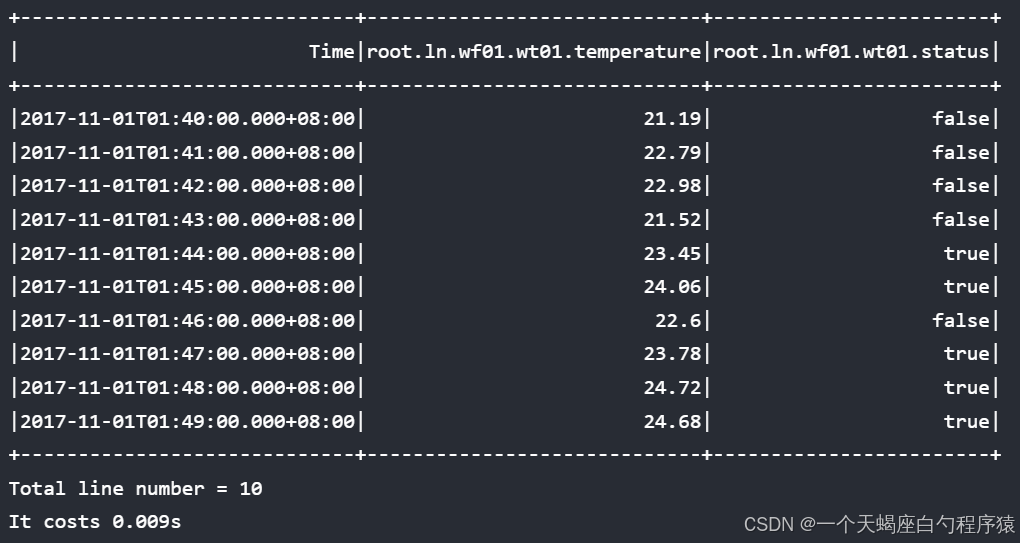
三、特性融合
3.1 FILL与分页的联合使用
在复杂查询场景中,可同时使用FILL与分页子句:
SELECT time, temperature, status
FROM root.ln.wf01.wt01
WHERE time > 2024–11–27T00:00:00
FILL(LINEAR)
LIMIT 100 OFFSET 500
这种组合特别适合大数据量下的趋势分析场景。
3.2 缓存机制
IoTDB内置智能缓存系统,通过LRU算法管理查询结果缓存。在分页查询中,通过cache_result_enabled参数可开启结果集缓存,显著提升重复查询性能。
3.3 问题诊断
博主实操总结:
QueryStats模块:实时监控查询性能指标 慢查询日志:自动记录执行时间超过阈值的查询 EXPLAIN命令:可视化展示查询执行计划
通过这些工具,可快速定位性能瓶颈,优化查询策略。
四、性能调优
分页查询优化
在分页查询场景下,IoTDB提供了专门的缓存优化方案:
— 启用分页查询结果缓存
SET cache_result_enabled = true
— 执行分页查询示例
SELECT * FROM root.device.* LIMIT 100 OFFSET 0
性能优势
重复查询加速:相同查询的第二次及后续执行可直接从缓存获取结果 并发查询优化:多个客户端请求相同数据时,只需计算一次 资源节约:减少重复计算和磁盘I/O操作
配置参数
| cache_result_enabled | false | 是否启用查询结果缓存 |
| cache_size_in_mb | 100 | 缓存大小(MB) |
| cache_eviction_algorithm | LRU | 缓存淘汰算法 |
通过合理配置这些参数,可以显著提升IoTDB在高并发查询场景下的性能表现。
五、总结与展望
本文全面揭示了Apache IoTDB的FILL空值填充与LIMIT/SLIMIT分页查询的核心原理、工业应用与性能优化策略。这两项特性如同数据处理的两把利剑,既解决了数据缺失的难题,又攻克了大数据量下的查询瓶颈。随着工业互联网的深入发展,IoTDB将继续在时序数据处理领域发挥重要作用。通过不断迭代优化的FILL与分页机制,配合智能缓存、索引优化等辅助特性,IoTDB将为工业物联网提供更强大、更智能的数据处理能力,助力企业实现真正的数字化转型。