TL;DR(30 秒速览)
- 6 个 Agent 组成编程团队(调研员、工程师、QA、审查员、UI 操作员、调试员),由 Leader 统一协调
- 核心机制:Channel 事件驱动 + 结构化 JSON 决策 + 成员状态机 + 暂停-协助模式
- 成员完成任务后通过 Channel 上报,Leader 收到结果后决定下一步——不是轮询,是事件驱动
- 成员卡住了可以调用 escalate 工具上报,Leader 暂停它并派另一个成员去协助
- 开源地址:github.com/haibingzhao/easyai
前情提要:在上一篇文章中,我们聊了 Deliberation——让 AI 像法庭一样对抗辩论。但 Deliberation 的参与者是平等对抗的,如果需要一个上下级协作的团队呢?答案是 TEAM Agent。
Deliberation 搞不定的事
Deliberation 适合"讨论出结论"的场景——多空辩论、方案评审。但编程团队协作不一样:
- 需要有人分配任务(“你去调研,他去实现”)
- 需要有人处理意外(“QA 发现 bug 了,派 Debug 去协助”)
- 需要有人判断完成(“所有目标都达到了,收工”)
这不是辩论,是管理。
核心矛盾: Deliberation 的 Judge 是中立裁判,不输出观点;TEAM 的 Leader 是主动管理者,要分配任务、处理上报、调整策略。
| 协调者 | Judge(中立,不输出观点) | Leader(主动,分配任务) |
| 参与者关系 | 平等对抗 | 上下级协作 |
| 通信模式 | 所有人看同一历史 | Leader 看所有结果,Member 只看自己的任务 |
| 收敛方式 | Judge 判断共识 | Leader 判断任务完成 |
Leader-Member 模型
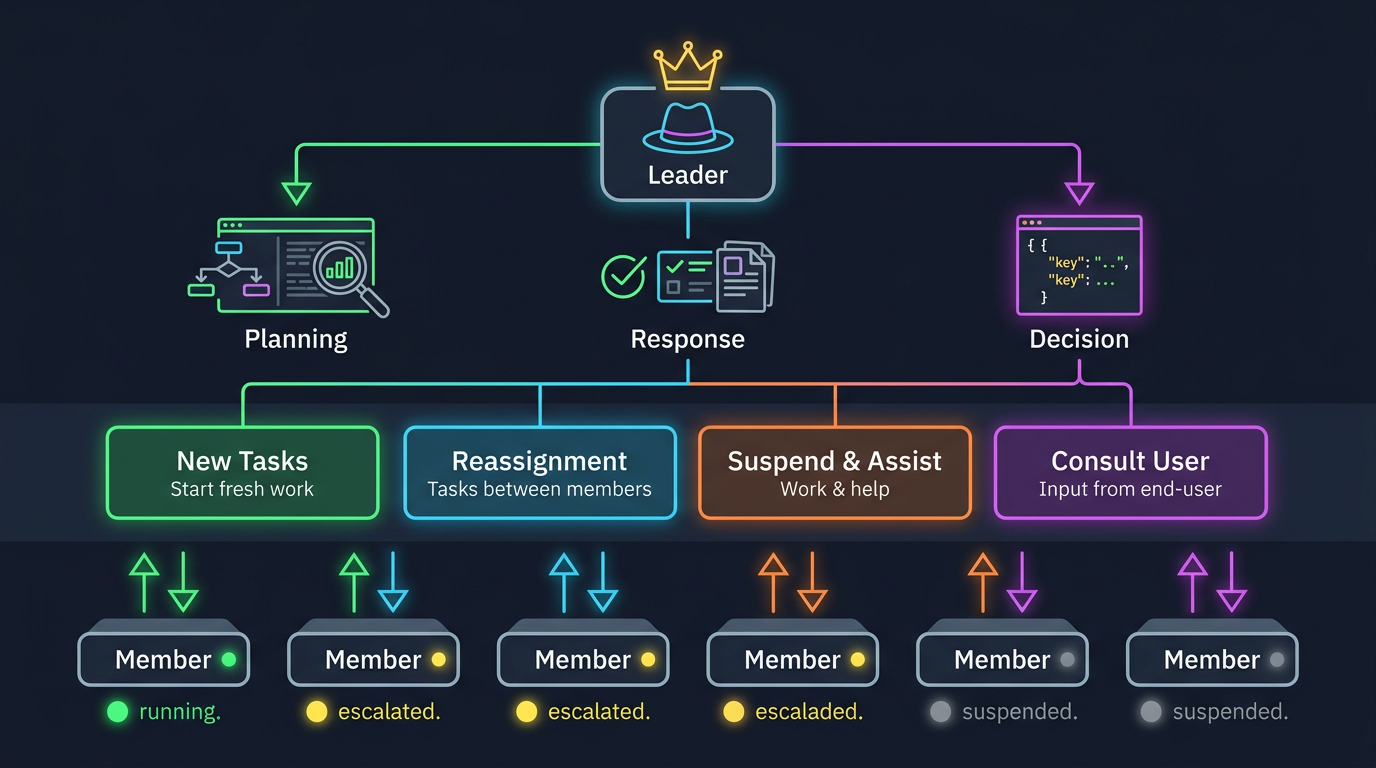
Leader(领导者)
├── 规划阶段:分析需求 → 分配工作 → 输出结构化决策
├── 响应阶段:接收成员结果 → 评估 → 调整策略
└── 决策类型:新任务 / 重新分配 / 暂停协助 / 上报用户
Member 1 ~ N(执行者)
├── 接收任务分配 → 独立执行
├── 完成后通过 Channel 上报结果
└── 遇到问题通过 escalate 工具上报
Leader 不写代码、不做测试、不审查——它只做决策。决策输出为严格的 JSON 结构:
{
"analysis": "Researcher 完成了代码定位,Engineer 需要实现分页查询",
"newTasks": [
{"memberId": "engineer", "assignment": "实现 UserService 分页查询"}
],
"reassignments": [],
"suspendAndAssist": [],
"isComplete": false
}
四种决策类型覆盖了所有管理场景:
| newTasks | 派新任务给空闲成员 | 有新工作需要分配 |
| reassignments | 把任务从 A 转给 B | A 不适合做这个 |
| suspendAndAssist | 暂停卡住的成员,派另一个去协助 | 成员 escalate 了 |
| suspendAndConsultUser | 暂停成员,向用户提问 | Leader 自己也拿不准 |
Channel 事件驱动:不是轮询,是推送
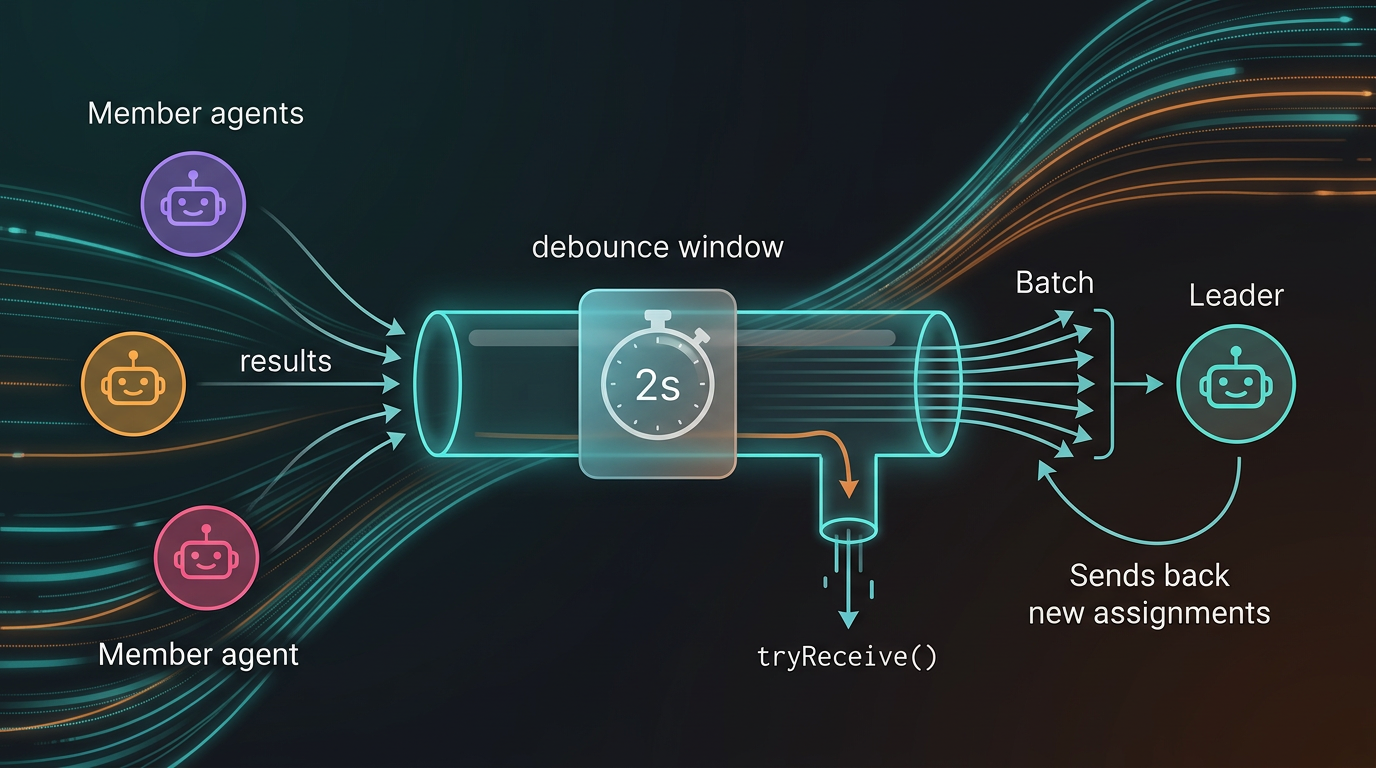
一句话概括: 成员完成任务后把结果推入 Channel,Leader 从 Channel 接收——像消息队列,不是定时器。
核心循环:
// TeamTaskExecutor.kt — 简化版
while (state.iterations < teamSpec.maxIterations && !abortSignal()) {
// 1. 等待第一个结果(带超时)
val first = withTimeoutOrNull(teamSpec.roundTimeoutSeconds * 1000L) {
resultChannel.receive()
}
if (first == null) { /* 超时处理 */ break }
// 2. Drain:短暂等待窗口聚合更多结果
val batch = TeamEventDrain.drain(resultChannel, first)
// 3. 处理批次:更新状态、发送事件
processResultBatch(batch, state, ...)
// 4. Leader 决策
val decision = invokeLeaderCoordination(batch, state, ...)
// 5. 持久化本轮记录
persistTeamHistorySafely(run, task, state)
if (decision.isComplete) break
// 6. 按决策分配新任务
launchMembers(decision, resultChannel, state, ...)
}
Drain 模式:为什么不等一个处理一个
如果 Researcher 和 Engineer 几乎同时完成,逐个处理意味着 Leader 要调用两次——每次只看到一个结果,做出不完整的决策。
Drain 模式:收到第一个结果后,等待 2 秒的 debounce 窗口,把窗口内到达的所有结果打包成一个批次交给 Leader。
// TeamEventDrain.kt — 完整实现(45 行)
object TeamEventDrain {
const val DEFAULT_DEBOUNCE_MS = 2000L
suspend fun <T> drain(
channel: Channel<T>,
first: T,
debounceMs: Long = DEFAULT_DEBOUNCE_MS,
): List<T> {
delay(debounceMs.milliseconds) // 等待窗口
val batch = mutableListOf(first)
while (true) {
val next = channel.tryReceive().getOrNull() ?: break // 非阻塞排空
batch.add(next)
}
return batch
}
}
2 秒窗口 + 非阻塞 tryReceive()——简单但有效。Leader 一次看到多个结果,决策质量更高。
成员状态机:7 种状态的精确控制
IDLE → RUNNING → COMPLETED
→ ERROR → (Leader 决策) → 重试 / 跳过
→ ESCALATED → (Leader 决策) → SUSPENDED → RESUMED → RUNNING
→ REASSIGNED → 任务转给另一个成员
| RUNNING | 正在执行任务 | 启动时 |
| COMPLETED | 成功完成 | 成员执行完毕 |
| ERROR | 执行失败 | 异常捕获 |
| ESCALATED | 主动上报被阻塞 | 成员调用 escalate 工具 |
| SUSPENDED | 被 Leader 暂停等待协助 | Leader 决策 |
| RESUMED | 协助完成后恢复 | 协助成员完成 |
| REASSIGNED | 任务被转给其他成员 | Leader 决策 |
escalate 工具:成员怎么告诉 Leader “我卡住了”
每个成员在执行时都会注入一个 escalate 工具:
// TeamTaskExecutor.kt — 注入 escalate 工具
val escalationTool = MemberSignalTool(
metadata = ToolMetadata(
name = "escalate",
description = "Signal that you are blocked and need help from the team leader",
),
onSignal = { reason, progress -> escalationRef.set(EscalationResult(reason, progress)) }
)
成员调用 escalate(reason="Cannot reproduce the bug without database access") 后:
暂停与协助:Leader 的"救人"机制
这是 TEAM 最精巧的部分。一个成员卡住了,Leader 不是简单地重试,而是:
// TeamTaskExecutor.resumeSuspendedMember() — 简化版
val resumeResult = workerExecutor.resumeWorker(
agentSpec = memberSpec,
sessionId = suspended.sessionId, // 复用同一个 session
resumeMessage = resolutionPrompt, // "你的问题已经被解决了:…"
additionalTools = listOf(escalationTool), // 还可以再次 escalate
)
关键: 复用 sessionId——被暂停的成员恢复后,能看到自己之前的完整对话历史,不会"失忆"。
超时控制:双层保护
| 轮次超时 | roundTimeoutSeconds | 600s | 整轮终止,Leader 收到超时事件 |
| 成员超时 | memberTimeoutSeconds | max(roundTimeout/2, 30s) | 该成员标记为超时,结果流入 Channel |
超时结果和普通结果一样流入 Channel——Leader 能看到"谁超时了",然后决策是重试还是跳过。
// 超时作为特殊结果流入 Channel
private fun timeoutMemberResult(memberId: String, ...): MemberExecutionResult {
return MemberExecutionResult(
memberId = memberId,
execution = TeamMemberExecution(
status = TeamMemberStatus.ERROR,
escalationReason = "Member timed out after ${memberTimeoutMs}ms",
),
)
}
增量持久化与崩溃恢复
每轮结束后立即持久化:
- TeamRoundRecord:Leader 的 Prompt、决策、成员执行结果
- TeamMemberExecution:每个成员的状态、摘要、token 用量
- EscalationEntry:上报历史
崩溃恢复时:
// 恢复时重建状态
if (isResume) {
rebuildStateFromHistory(state, task)
// 恢复已完成成员的摘要,供下游任务使用
for (exec in task.memberExecutions.filter { it.status == COMPLETED }) {
taskSummaries["${task.id}.${exec.memberId}"] = exec.summary!!
}
}
实战案例:6 Agent 编程团队
Round 1: Leader 分析需求
→ 派 Researcher 调研代码结构
→ 派 Engineer 准备开发环境
Round 2: Researcher 完成 → Leader 审查
→ 派 Engineer 实现分页查询
→ 派 QA 准备测试用例
Round 3: Engineer 完成 + QA 发现 bug
→ QA escalate: "测试失败,NPE at UserService.java:42"
→ Leader 决策:暂停 QA,派 Debug Engineer 协助
Round 4: Debug Engineer 定位根因 → 恢复 QA
→ Engineer 修复 bug
→ QA 重新测试通过
Round 5: Leader 判断完成
→ 派 Code Reviewer 最终审查
→ isComplete: true
整个过程 Leader 调用了 5 次决策,6 个成员按需参与,中间处理了 1 次 escalate 和 1 次暂停-协助。
踩坑记录
三个坑,每个都和协程并发有关。
坑 1:Channel 的 merge() 死锁。 最初用 merge() 聚合多个成员的 Flow,但 merge() 等待所有 Flow 完成才返回——而 goalChannel 只在外部 finally 中关闭。如果某个成员提前完成,merge() 还在等,整个循环卡死。修复:改为 Channel + tryReceive() 的 drain 模式,不依赖 Flow 的生命周期。
坑 2:Leader Prompt 膨胀。 多轮协作后,Leader 的 Prompt 包含了所有历史记录,越来越长。到第 10 轮,Prompt 已经超过 50K token。修复:限制历史记录的最大条数,只保留最近 N 轮的完整记录,更早的只保留摘要。
坑 3:成员超时后 Leader 不知道。 最初成员超时后直接取消,结果不流入 Channel——Leader 以为成员还在跑,一直在等。修复:超时作为特殊结果流入 Channel,Leader 能看到超时事件并做出决策。
写在最后
Deliberation 像法庭——各方平等对抗,裁判居中裁决。TEAM 像公司——Leader 分配任务,成员执行,遇到问题上报,Leader 调整策略。
| 适用场景 | 讨论出结论 | 协作完成任务 |
| 协调方式 | 裁判编排 + 自主收敛 | Leader 规划 + 响应式决策 |
| 通信模式 | 广播(所有人看同一历史) | 点对点(Leader 分配,成员上报) |
| 意外处理 | 无(辩论继续即可) | escalate → 暂停 → 协助 → 恢复 |
| 代码量 | 604 行 | 1285 行 |
EasyAI 的 TeamTaskExecutor 用 1285 行 Kotlin 代码实现了完整的 Leader-Member 协作系统——Channel 事件驱动、结构化决策、成员状态机、暂停-协助、断点恢复。
核心思想:好的团队协作不是靠轮询,而是靠事件。
下一篇:AI 创造 AI——一句话生成 14 个 Agent 的配置链路
用户说"我需要一个投资分析团队",AI 自己调用 list_resources 发现可用工具,逐块生成配置,validate_config 自校验,finalize_config 提交——全程不需要手写一行 YAML。
开源地址:https://github.com/haibingzhao/easyai
欢迎 Star、Issue 和 PR。