目录
一、单执行流服务器的弊端(单线程进程)
1、单线程服务器
2、为何客户端显示连接成功?
第一步:第一个客户端连接
第二步:第二个客户端连接
关键点
3、解决方案
二、多进程版TCP网络程序
1、多进程服务器基本原理
进程创建与服务分配
并发处理优势
2、文件描述符继承机制
描述符表特性
套接字继承示例
匿名管道通信案例
3、子进程管理策略
1. 僵尸进程问题
2. 阻塞式等待方案
3. 非阻塞式等待方案
4、优雅解决方案
1. 忽略SIGCHLD信号(捕捉SIGCHLD信号)
2. 双层进程模型(推荐)
5、补充知识
问题1:进程退出后,曾经打开的文件会怎么办?
问题2:父进程打开文件后创建子进程,子进程能使用父进程的fd吗?
以管道为例进行验证:像之前我们提到的“管道不就是吗?”完全正确!!!让我们拆解一下管道的创建和使用过程:
需要注意的地方:
总结表格
三、多线程版TCP网络程序设计
1、进程与线程创建成本对比
2、多线程服务器基本架构
2.1 连接处理流程
2.2 线程管理策略
3、文件描述符管理
3.1 共享文件描述符表
3.2 使用规范
4、参数结构体设计
5、文件描述符共享问题
6、将Service函数定义为静态成员函数的原因
静态成员函数要求
7、关键注意事项
8、扩展建议
9、代码测试
ps -aL 命令
ps -axj 命令
10、补充:问题分析
问题1:fd线程能看到吗?
问题2:线程敢不敢关闭自己不需要的fd?
popen/pclose 函数详解
函数原型
功能说明
执行流程
底层实现
关键知识点总结
四、线程池版的TCP网络程序
1、传统多线程模式的缺陷
线程创建与销毁开销大
高并发场景性能瓶颈
2、解决方案
线程池预创建机制
线程复用机制
资源管控机制
3、线程池的实现与应用
4、服务类新增线程池成员
5、任务类设计
6、设计Handler类
7、代码测试阶段
一、单执行流服务器的弊端(单线程进程)
正如之前所述,当单个客户端连接服务端时,该客户端可以正常接收服务端提供的服务。如下所示:

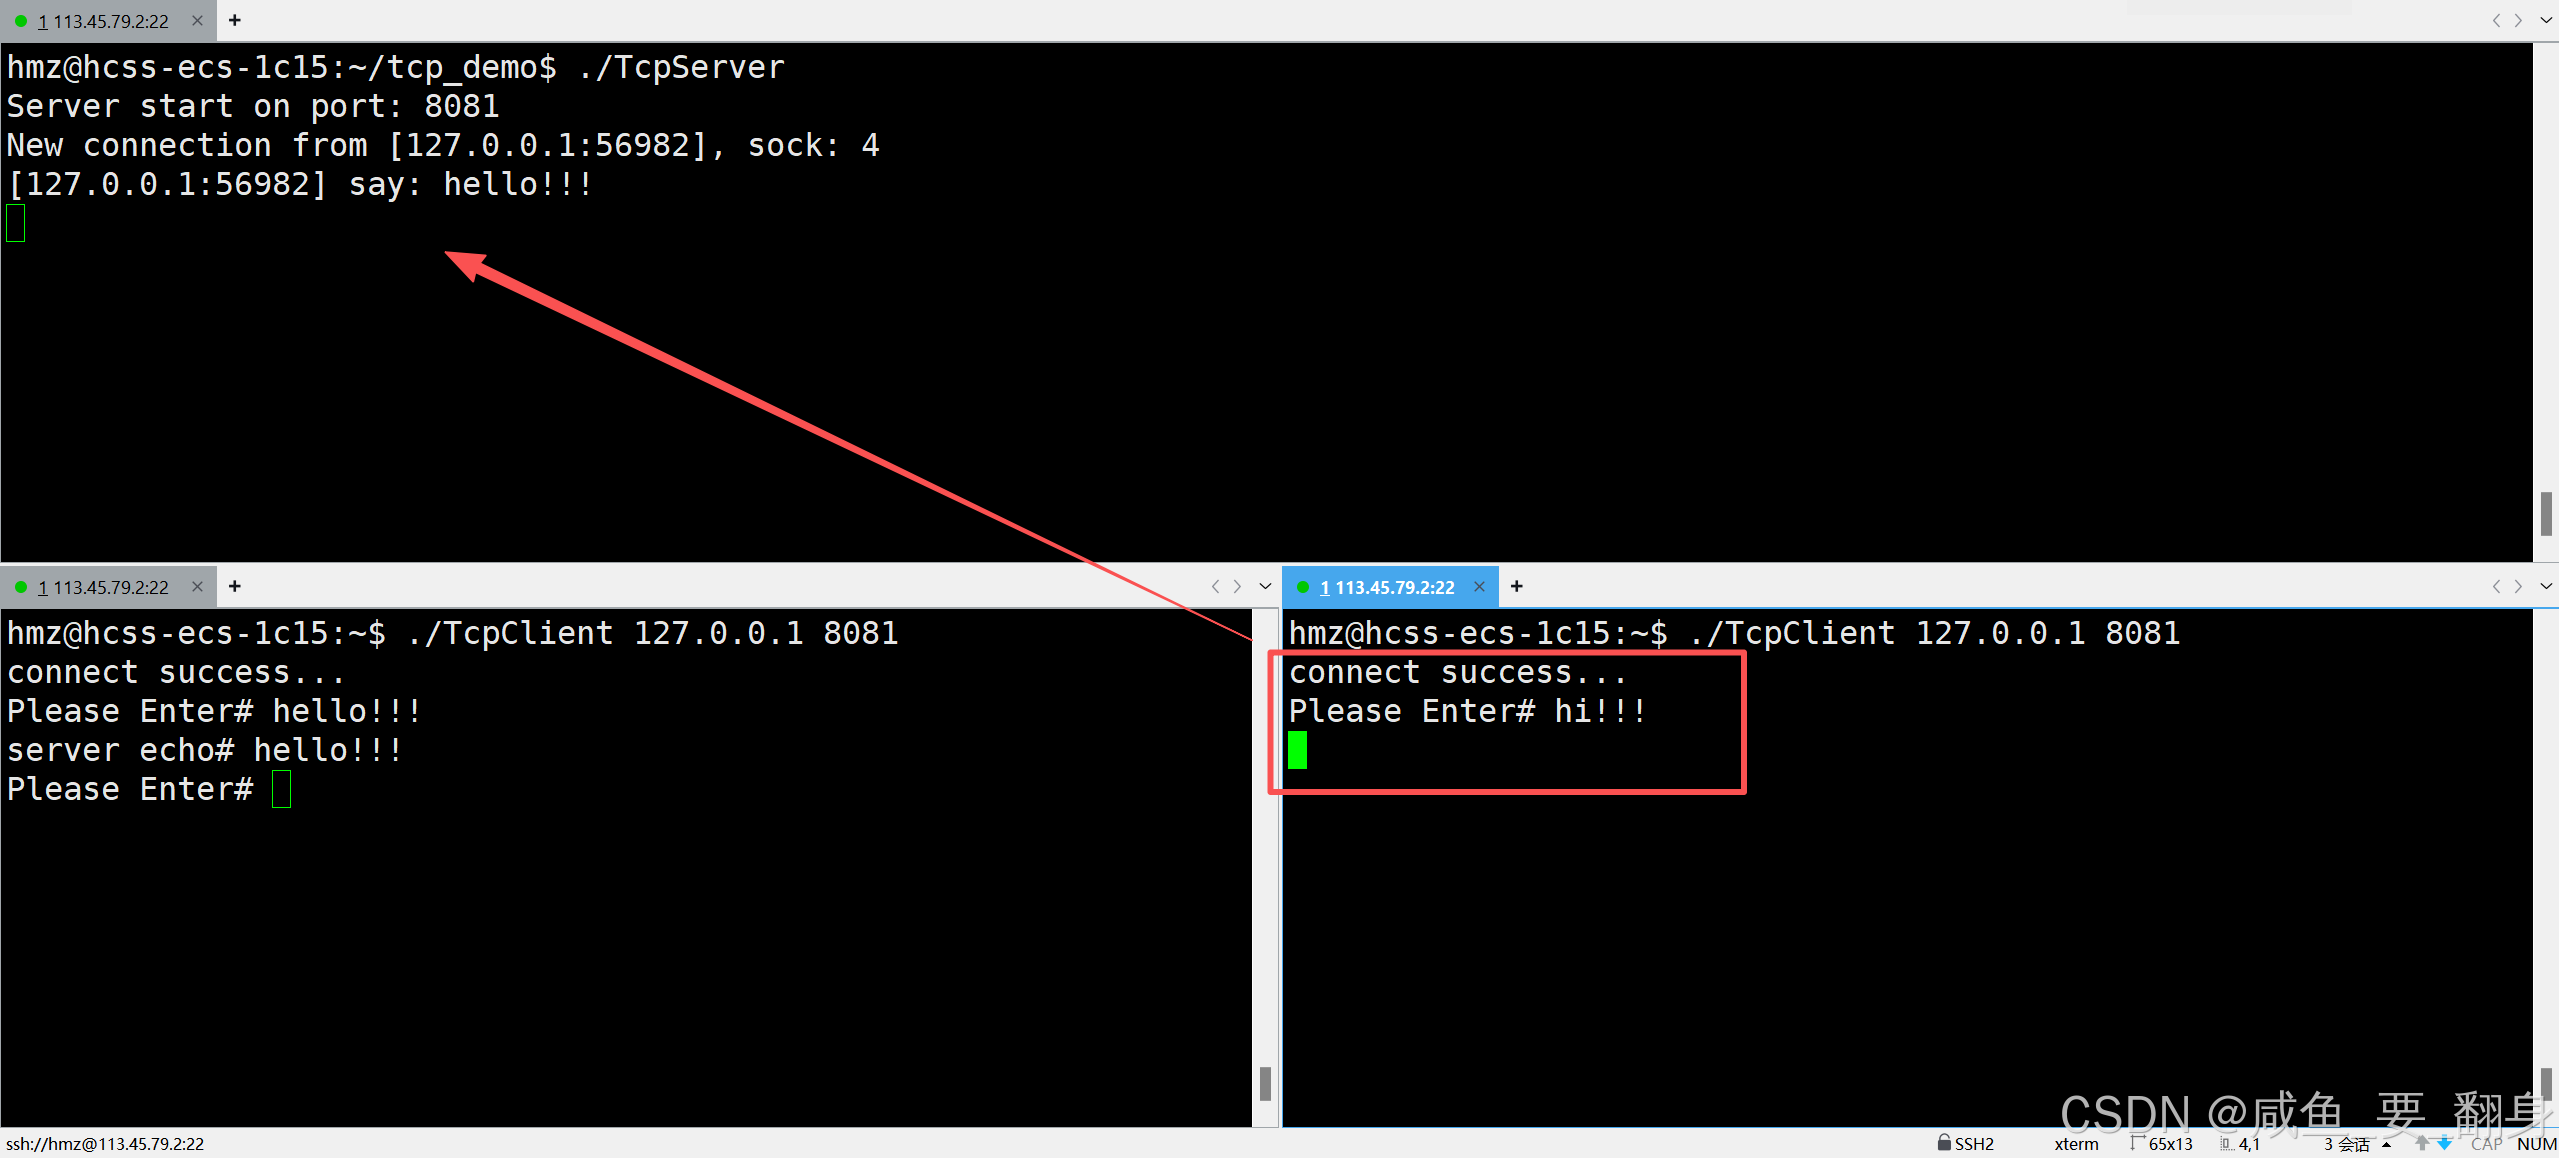
当第一个客户端正与服务端保持连接时,我们尝试让第二个客户端接入服务器,然后在客户端这边显示第二个客户端他自己连接成功,但是服务端那边却没有显示新加入的客户端:
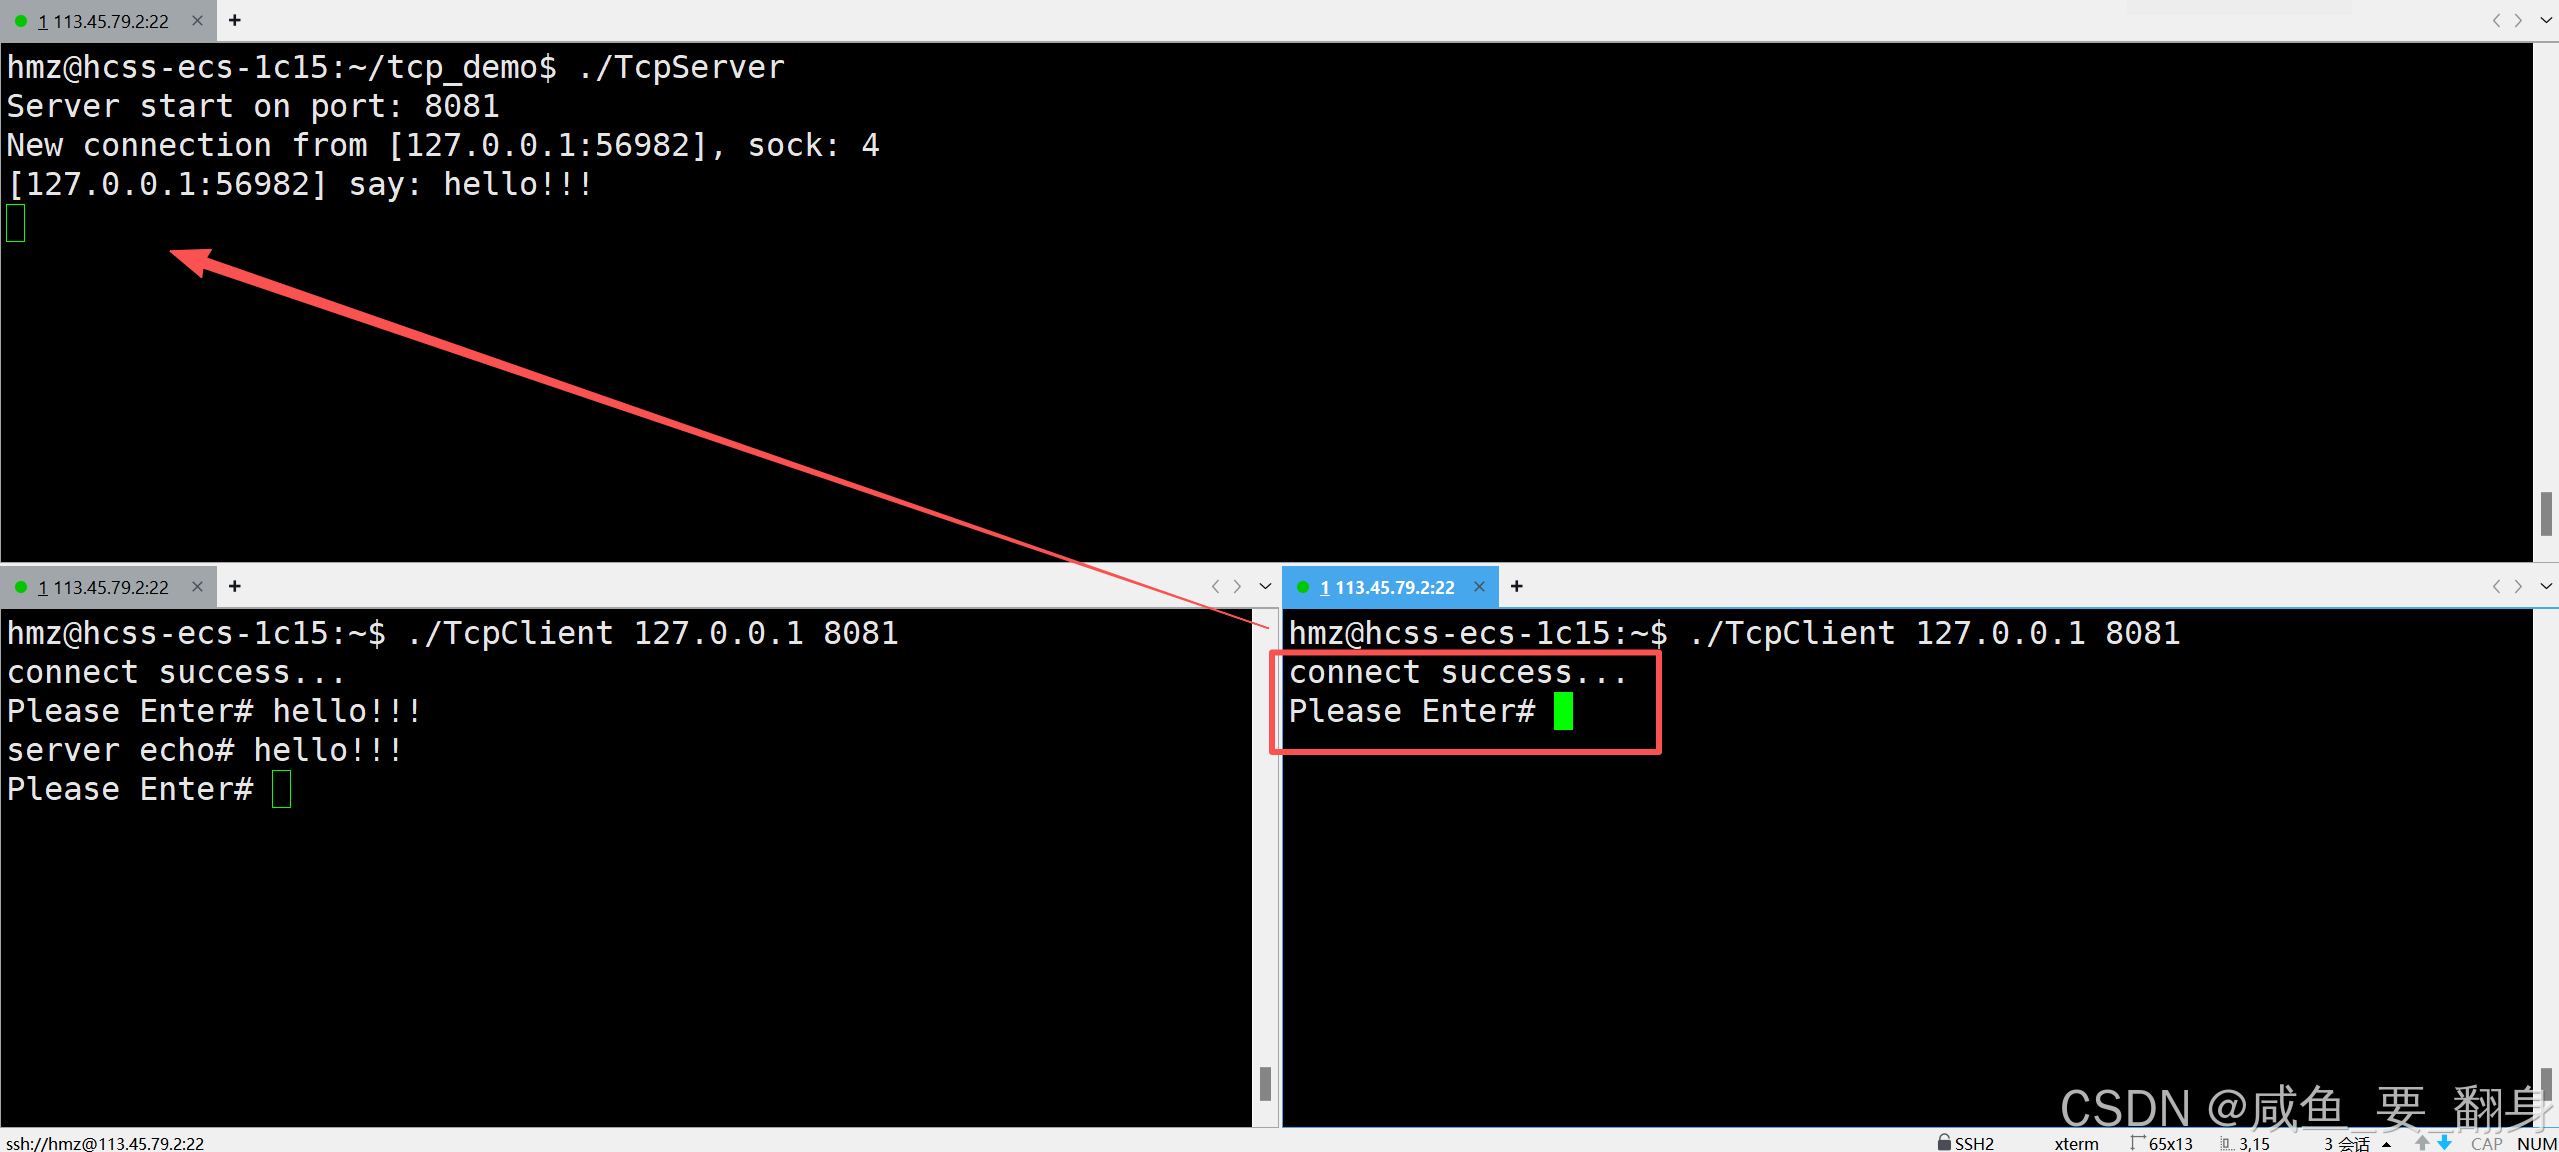
然后我们在第二个客户端输入要发送的信息,然后发送给服务端,我们看到发送给服务端的消息既未在服务端显示,服务端也未将该消息回显给该客户端。如下所示:
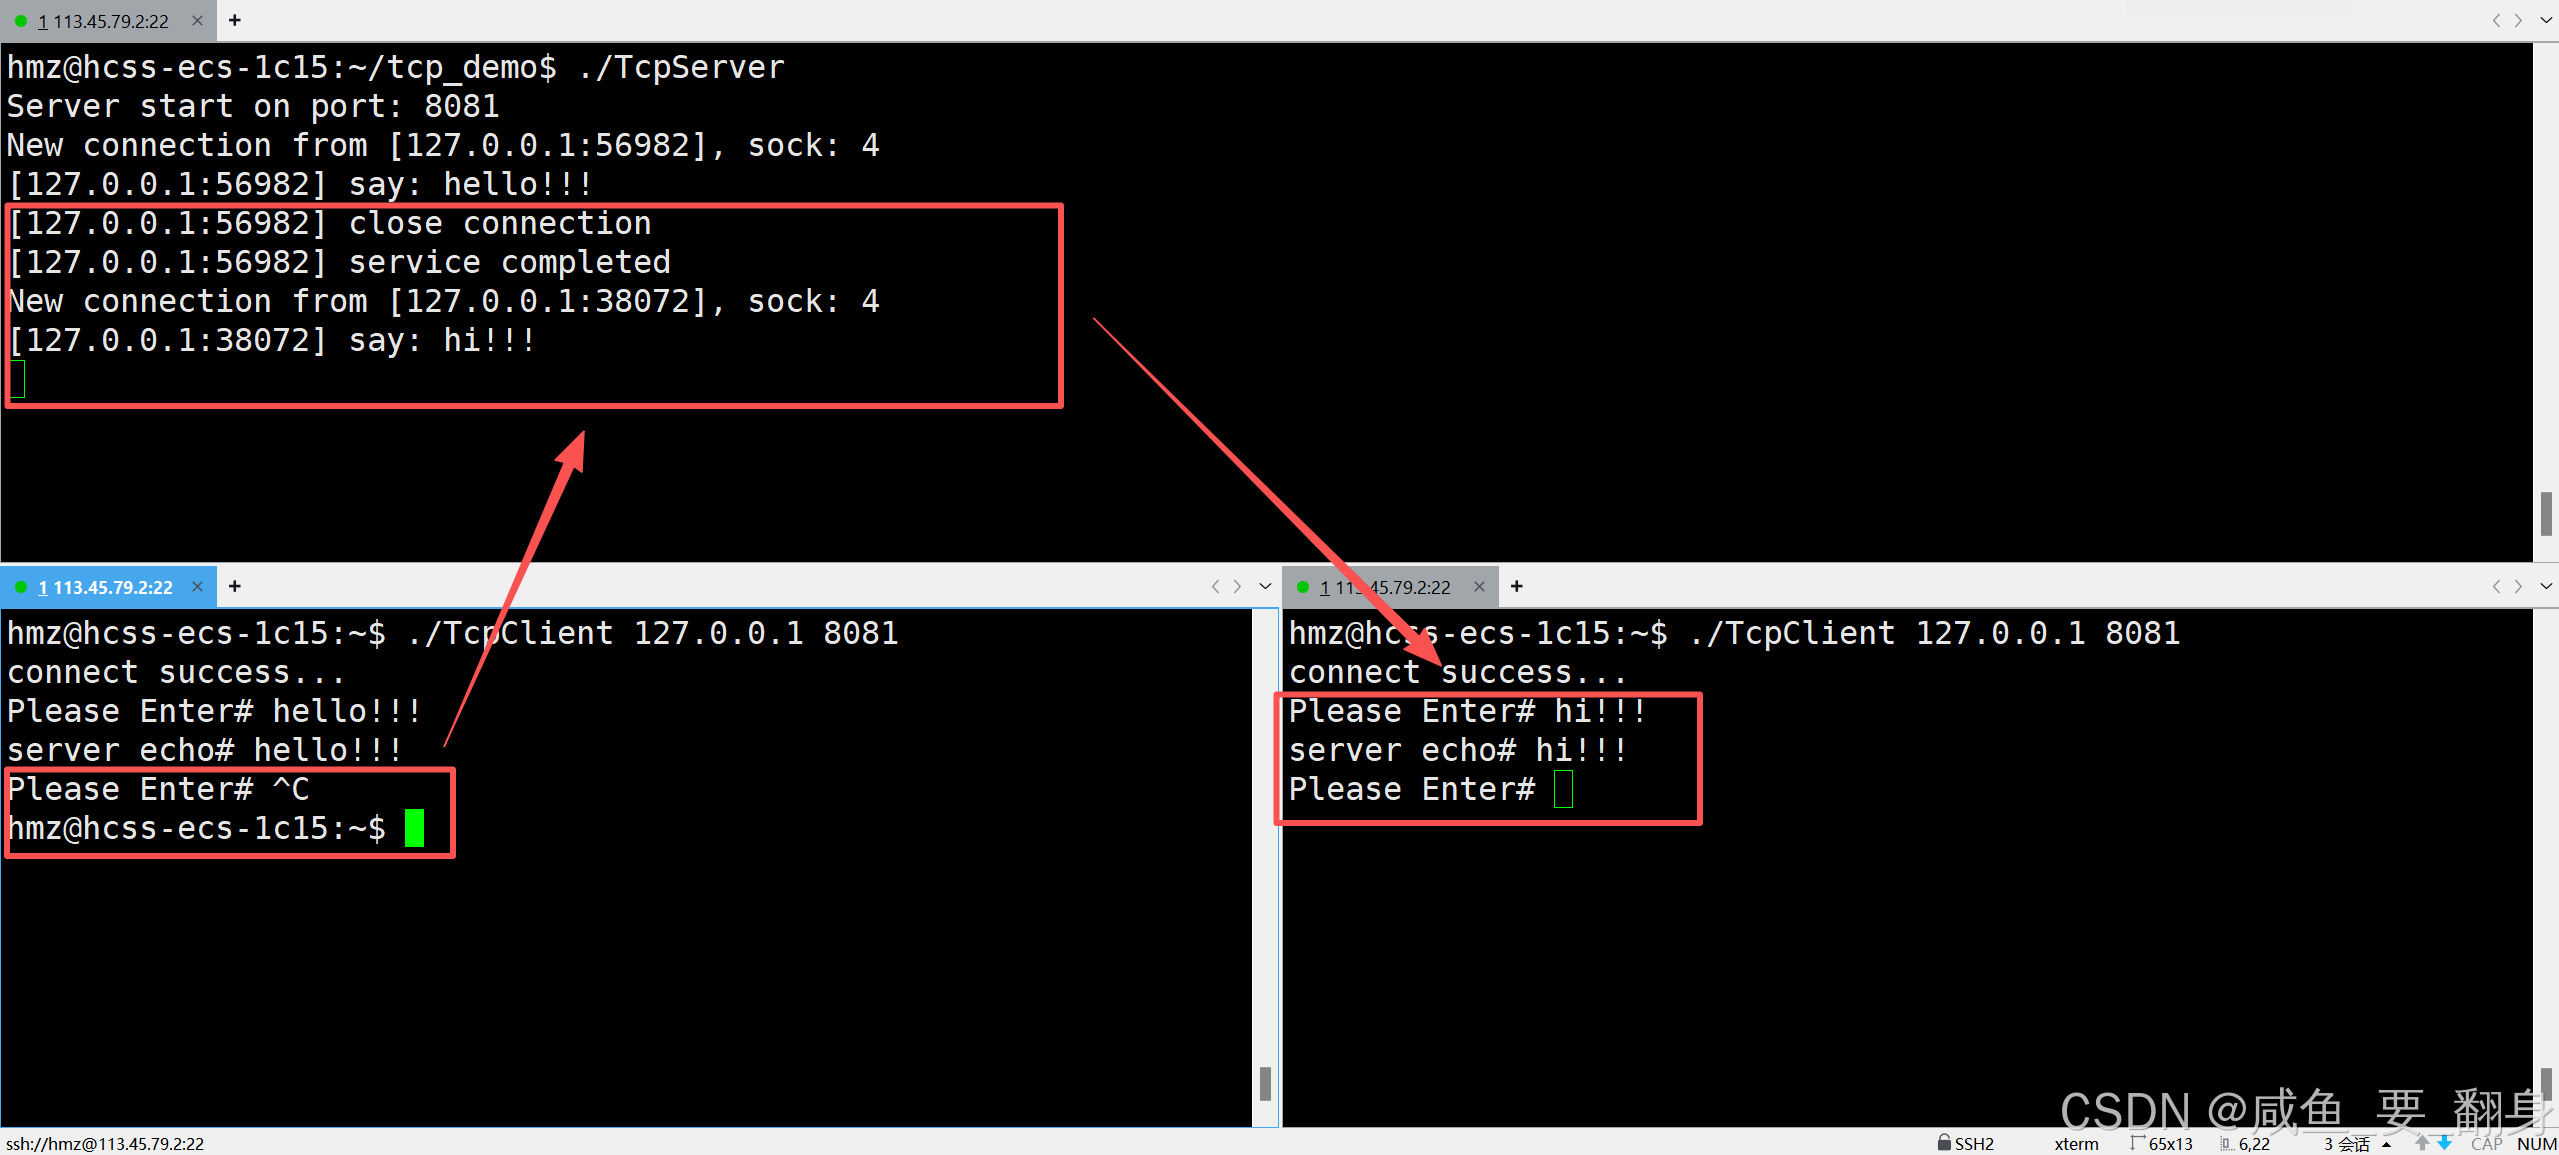
我们此时可以尝试关闭第一个客户端进程,然后我们可以看到服务端会等待第一个客户端断开连接后,才会处理并回显第二个客户端发送的数据:
1、单线程服务器
-
实验结果表明,该服务器只能依次处理客户端请求,必须完成当前客户端的服务(第一个客户端)后才能响应下一个连接(第二个客户端)。
-
这是因为我们实现的是单线程版本服务器(当前服务端进程只有一个线程),同一时间仅能为一个客户端提供服务。
-
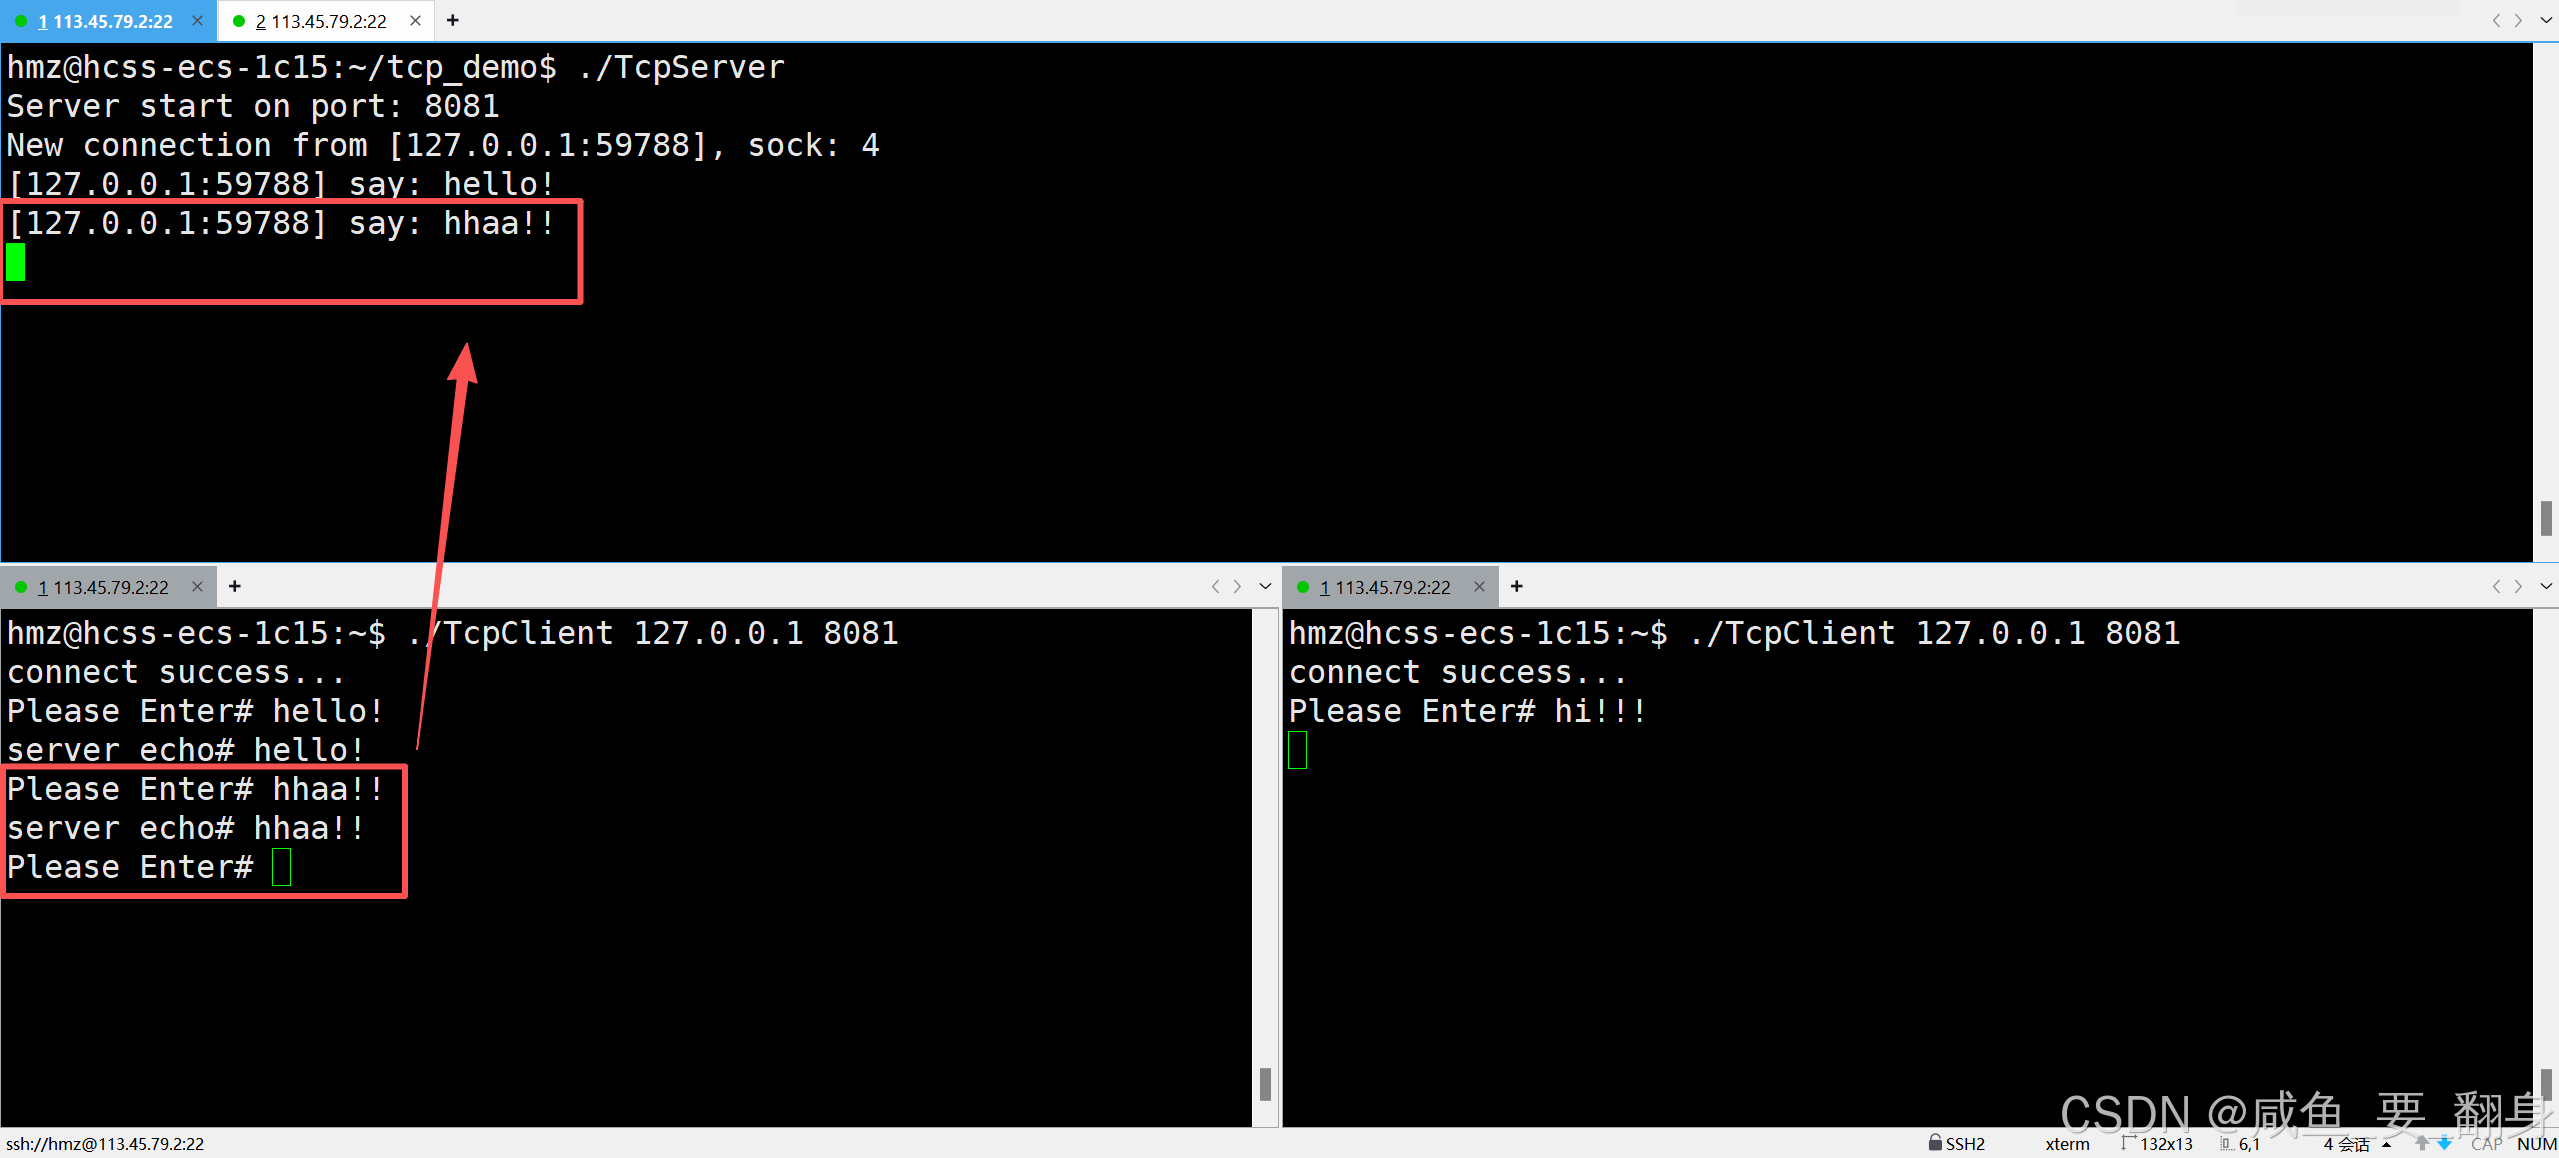
当服务器通过accept函数建立连接后,会专注于服务该客户端(第一个客户端)。如下,可以验证当前服务端还在为第一个客户端进行服务:
-
在此期间,虽然其他客户端可能发起连接请求,但由于服务器采用单线程架构,无法同时处理多个连接请求。
2、为何客户端显示连接成功?
-
当服务器处理第一个客户端的请求时,第二个客户端的连接请求实际上已被系统接收。
-
尽管服务器尚未调用accept函数获取该连接,但底层TCP协议会维护一个连接队列(回顾listen()函数将sockfd设置为监听状态,最多允许backlog个客户端处于连接等待队列。若超过该数量的连接请求将被自动忽略,通常建议将该值设置为较小的数值(如5)),未处理的连接会被暂存其中,而通过已建立的连接传输但未处理的连接,它的数据存放在内核接收缓冲区。
-
一旦服务器调用 accept() 接受连接,就可以立即读取已到达的数据!!!
-
这个队列的最大长度由listen函数的第二个参数决定,因此第二个客户端会立即收到连接成功的响应。(注意:意思是服务端监听listen完成三次握手之后,connect函数就相当于成功返回了,它不管是否完成accept函数操作!!!)
listen() 函数的第二个参数指的是「完整连接队列」的长度。TCP 连接的两种状态:
-
半连接队列(SYN Queue):收到 SYN,但未完成三次握手
-
完整连接队列(Accept Queue):已完成三次握手,等待 accept() 取出
在上面的这个场景中,第二个客户端会被阻塞在「完整连接队列」中。
第一步:第一个客户端连接
客户端A: SYN → 半连接队列 → 完成握手 → 完整连接队列 → accept()取出
-
连接建立成功,服务器开始处理客户端A的请求
第二步:第二个客户端连接
客户端B: SYN → 半连接队列 → 完成握手 → 完整连接队列 ⛔ 阻塞在这里!
-
三次握手快速完成
-
但服务器还在处理客户端A的请求,没有调用 accept()
-
客户端B的连接在完整连接队列中等待
关键点
半连接队列:只在三次握手期间短暂存在
完整连接队列:连接建立后,等待 accept() 的地方
单线程问题:由于服务器忙于处理第一个请求,无法及时 accept() 第二个连接
总结:第二个客户端阻塞在完整连接队列,等待服务器调用 accept() 来处理它!
3、解决方案
-
单线程服务器无法充分利用系统资源,实际应用中很少采用这种架构。
-
要解决这个问题,需要将服务器改造为多线程或多进程架构,实现并发处理能力。
二、多进程版TCP网络程序
在单进程TCP服务器模型中,服务器只能以串行方式依次处理客户端连接请求。当我们将单执行流服务器升级为多进程版本后,服务器可以同时处理多个客户端连接,显著提升并发处理能力。
1、多进程服务器基本原理
进程创建与服务分配
多进程TCP服务器的核心思想是:当服务端通过accept()函数获取到新客户端连接后,不是由当前主执行流直接处理该连接,而是调用fork()函数创建子进程,将服务任务分配给新创建的子进程。具体流程如下:
主进程(父进程)创建监听套接字并绑定端口
进入循环,持续调用accept()等待新连接
当有新连接到达时,调用fork()创建子进程
在子进程中关闭监听套接字,专注于服务当前客户端(因为子进程继承了父进程的文件描述符,所以要关闭掉)
在父进程中关闭已分配的连接套接字,继续等待新连接(让创建的子进程拿到了连接套接字文件描述符后,这个连接套接字对父进程已经没有用了,所以要关闭掉)
并发处理优势
这种模型利用了操作系统进程调度的特性:
-
父子进程作为独立的执行流,可以同时运行在不同CPU核心上
-
父进程无需等待子进程完成服务即可继续接受新连接
-
每个客户端连接由独立的子进程处理,避免相互干扰
2、文件描述符继承机制
描述符表特性
文件描述符表是进程级的资源,子进程创建时会继承父进程的所有打开文件描述符:
-
继承的描述符具有相同的文件偏移量
-
继承的描述符具有相同的文件状态标志(如O_NONBLOCK)
-
父子进程对描述符的操作相互独立(关闭操作除外)
文件描述符表是进程特有的资源。当父进程创建子进程时,子进程会继承父进程的文件描述符表。例如,若父进程打开了某个文件并获得描述符3,那么子进程的3号描述符也会指向同一个文件。这种继承关系会持续传递:子进程创建的新进程同样会继承这个文件描述符。
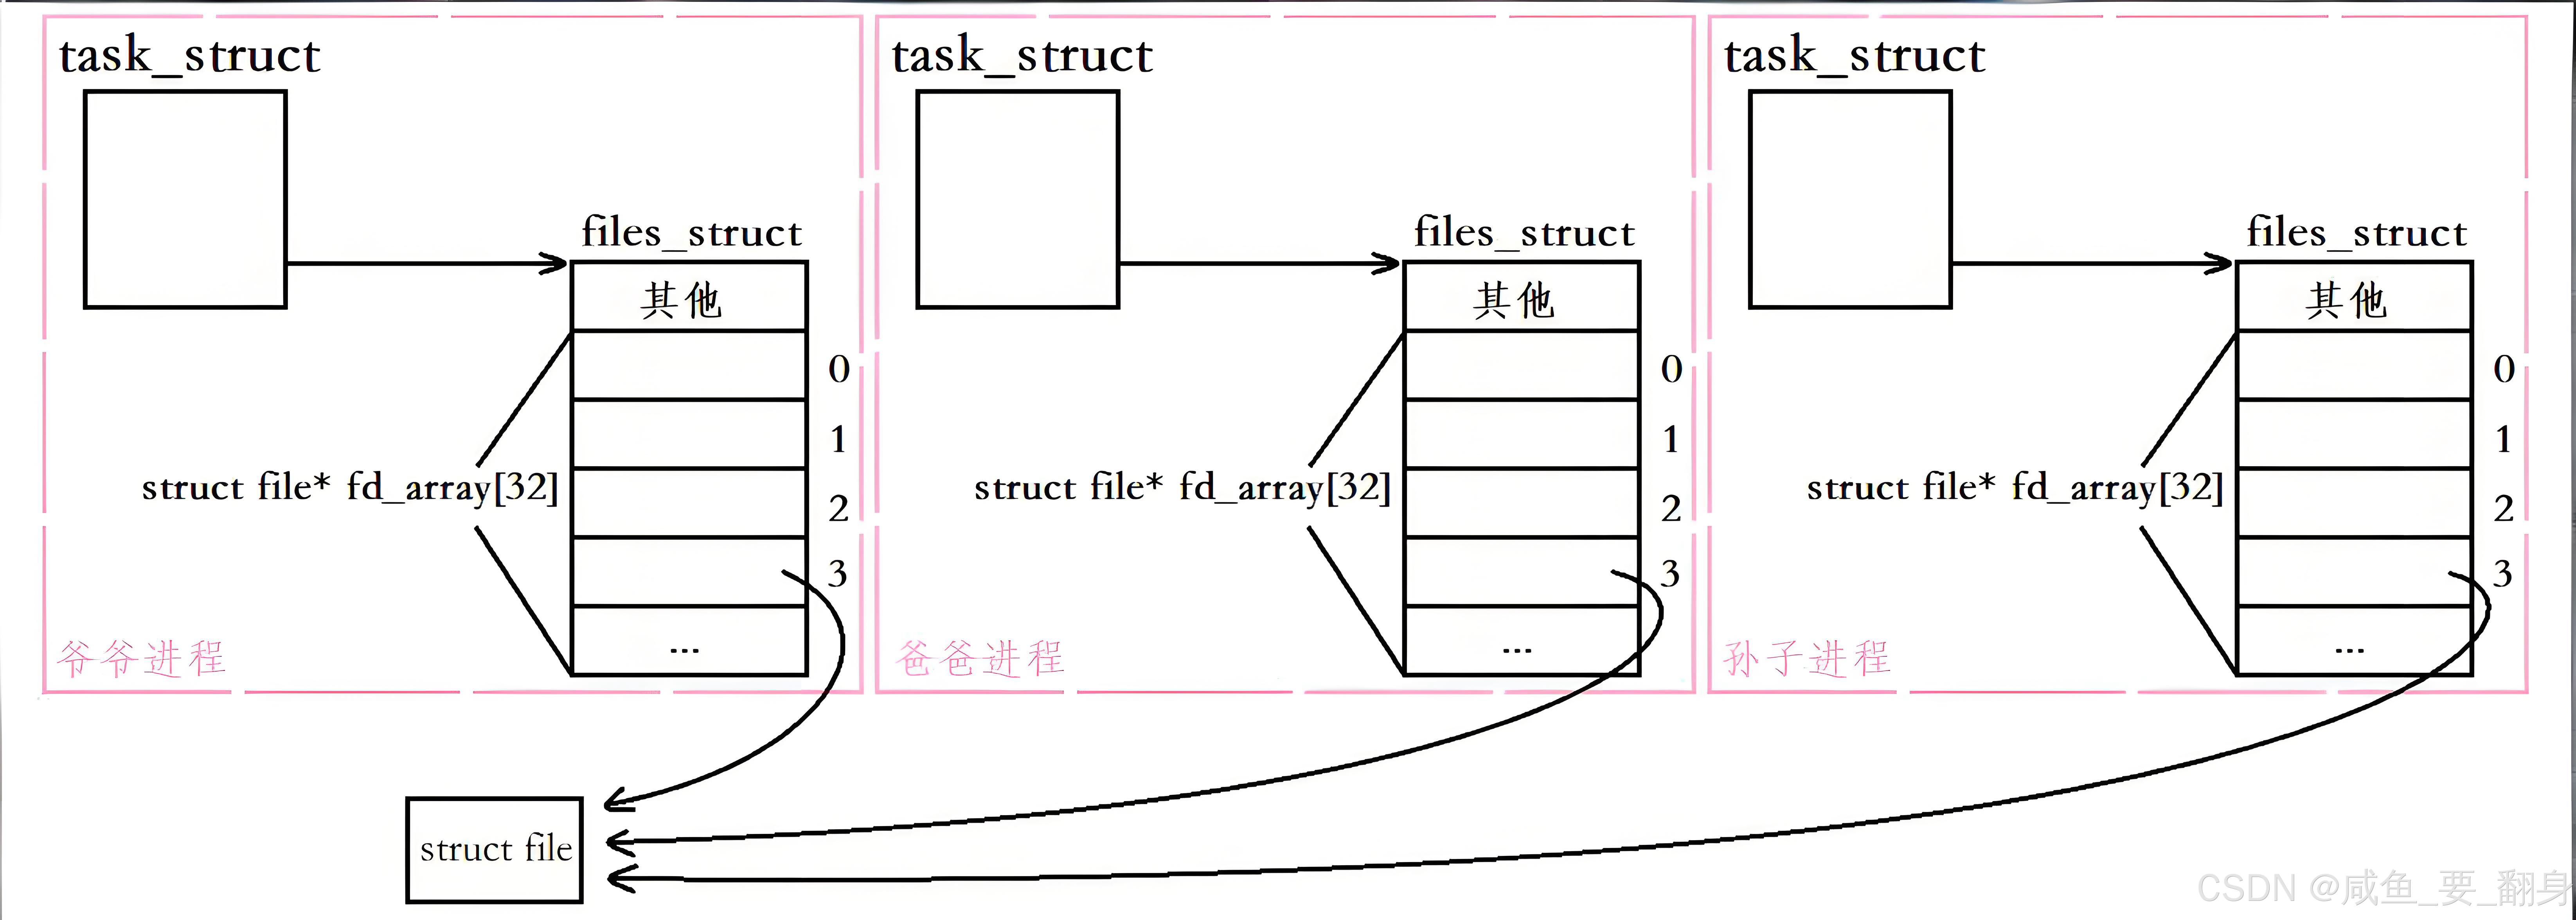
当父进程创建子进程后,父子进程各自保持独立性,父进程文件描述符表的变更不会影响子进程。匿名管道就是一个典型例子:父进程调用pipe函数获取两个文件描述符(分别对应管道的读写端),子进程会继承这两个文件描述符。随后,父子进程分别关闭管道的不同端(一个关闭读端,另一个关闭写端),此时各自文件描述符表的修改互不影响。这样,父子进程就能通过该管道实现单向通信。
同理,对于套接字文件,子进程也会继承父进程的套接字文件描述符。这使得子进程能够直接对特定套接字进行读写操作,从而为对应的客户端提供服务。
套接字继承示例
int listen_fd = socket(AF_INET, SOCK_STREAM, 0);
bind(listen_fd, …);
listen(listen_fd, 5);
int conn_fd = accept(listen_fd, …);
pid_t pid = fork();
if (pid == 0) { // 子进程
close(listen_fd); // 关闭监听套接字
// 使用conn_fd与客户端通信
} else { // 父进程
close(conn_fd); // 关闭已分配的连接套接字
// 继续accept新连接
}
匿名管道通信案例
int pipefd[2];
pipe(pipefd); // 创建管道
pid_t pid = fork();
if (pid == 0) { // 子进程
close(pipefd[1]); // 关闭写端
// 从pipefd[0]读取数据
} else { // 父进程
close(pipefd[0]); // 关闭读端
// 向pipefd[1]写入数据
}
这个例子展示了:
父子进程继承相同的管道描述符
各自关闭不需要的端后形成单向通信
后续的文件描述符操作互不影响
3、子进程管理策略
当父进程创建子进程后,必须等待子进程退出,否则子进程会变成僵尸进程并导致内存泄漏。因此,服务端在创建子进程后需要调用wait或waitpid函数进行等待。
关于等待方式的选择:
阻塞式等待
-
采用阻塞方式时,服务端必须等待当前客户端服务完成后才能处理下一个连接请求
-
这种方式本质上仍然是串行处理模式
非阻塞式等待
-
虽然可以在子进程服务期间继续接收新连接
-
但需要保存所有子进程的PID并持续检测其退出状态
-
会额外消耗系统资源
综上所述,无论是阻塞式还是非阻塞式等待,都存在明显缺陷。因此,更好的解决方案是让服务端不主动等待子进程退出。
实现父进程不等待子进程退出的方法
捕获SIGCHLD信号并将其处理方式设置为忽略
采用进程链的方式:父进程创建子进程后,子进程再创建孙子进程,最终由孙子进程处理实际服务
1. 僵尸进程问题
-
当子进程退出时,操作系统会保留其退出状态直到父进程通过wait()或waitpid()回收。
-
如果父进程未及时回收,子进程将成为僵尸进程,占用系统资源。
2. 阻塞式等待方案
while(1) {
int conn_fd = accept(…);
pid_t pid = fork();
if (pid == 0) {
// 子进程服务代码
exit(0);
} else {
waitpid(pid, NULL, 0); // 阻塞等待子进程
}
}
缺点:父进程必须等待当前子进程退出才能接受新连接,失去并发优势。
3. 非阻塞式等待方案
// 存储所有子进程PID
pid_t pids[MAX_CLIENTS];
int pid_count = 0;
while(1) {
int conn_fd = accept(…);
pid_t pid = fork();
if (pid == 0) {
// 子进程服务代码
exit(0);
} else {
pids[pid_count++] = pid;
// 定期检查子进程状态
for(int i=0; i<pid_count; i++) {
if(waitpid(pids[i], NULL, WNOHANG) > 0) {
// 子进程已退出,移除PID
pids[i] = pids[–pid_count];
}
}
}
}
缺点:
-
需要维护子进程列表
-
定期检查消耗CPU资源
-
实现复杂度较高
4、优雅解决方案
1. 忽略SIGCHLD信号(捕捉SIGCHLD信号)
#include <signal.h>
void sigchld_handler(int sig) {
while(waitpid(-1, NULL, WNOHANG) > 0); // 回收所有僵尸进程
}
int main() {
struct sigaction sa;
sa.sa_handler = sigchld_handler;
sigemptyset(&sa.sa_mask);
sa.sa_flags = SA_RESTART;
sigaction(SIGCHLD, &sa, NULL);
// 主服务器循环…
}
或更简单的忽略方式(但可能不完全可靠):
signal(SIGCHLD, SIG_IGN); // 设置忽略SIGCHLD
当子进程退出时,系统会向父进程发送SIGCHLD信号。使用 signal(SIGCHLD, SIG_IGN); 之后,父进程通常不需要等待子进程,可以立即继续执行,而且不会产生僵尸进程。但如果业务逻辑需要同步,父进程仍然可以选择等待子进程。
信号处理的三层次:(重点!!!)
// 层次1:默认处理 – 信号被传递,执行默认动作
signal(SIGCHLD, SIG_DFL); // 子进程结束会产生僵尸进程
// 层次2:忽略处理 – 信号根本不会被传递
signal(SIGCHLD, SIG_IGN); // 内核直接回收,进程不知情
// 层次3:捕获处理 – 信号被传递,执行自定义函数
signal(SIGCHLD, custom_handler); // 进程收到信号并处理
class TcpServer
{
public:
void Start()
{
std::cout << "Server start on port: " << _port << std::endl;
signal(SIGCHLD, SIG_IGN); //忽略SIGCHLD信号
for (;;){
//获取连接
struct sockaddr_in peer;
memset(&peer, '\\0', sizeof(peer));
socklen_t len = sizeof(peer);
int sock = accept(_listen_sock, (struct sockaddr*)&peer, &len);
if (sock < 0){
std::cerr << "accept error, continue next" << std::endl;
continue;
}
std::string client_ip = inet_ntoa(peer.sin_addr);
int client_port = ntohs(peer.sin_port);
std::cout << "get a new link->" << sock << " [" << client_ip << "]:" << client_port << std::endl;
pid_t id = fork();
if (id == 0){ //child
//处理请求
Service(sock, client_ip, client_port);
exit(0); //子进程提供完服务退出
}
}
}
private:
int _listen_sock; //监听套接字
int _port; //端口号
};
记得加上对应必要的头文件:
#include <csignal> // 用于 signal(), SIGCHLD, SIG_IGN
#include <cstdlib> // 可选,如果需要 exit() 等函数
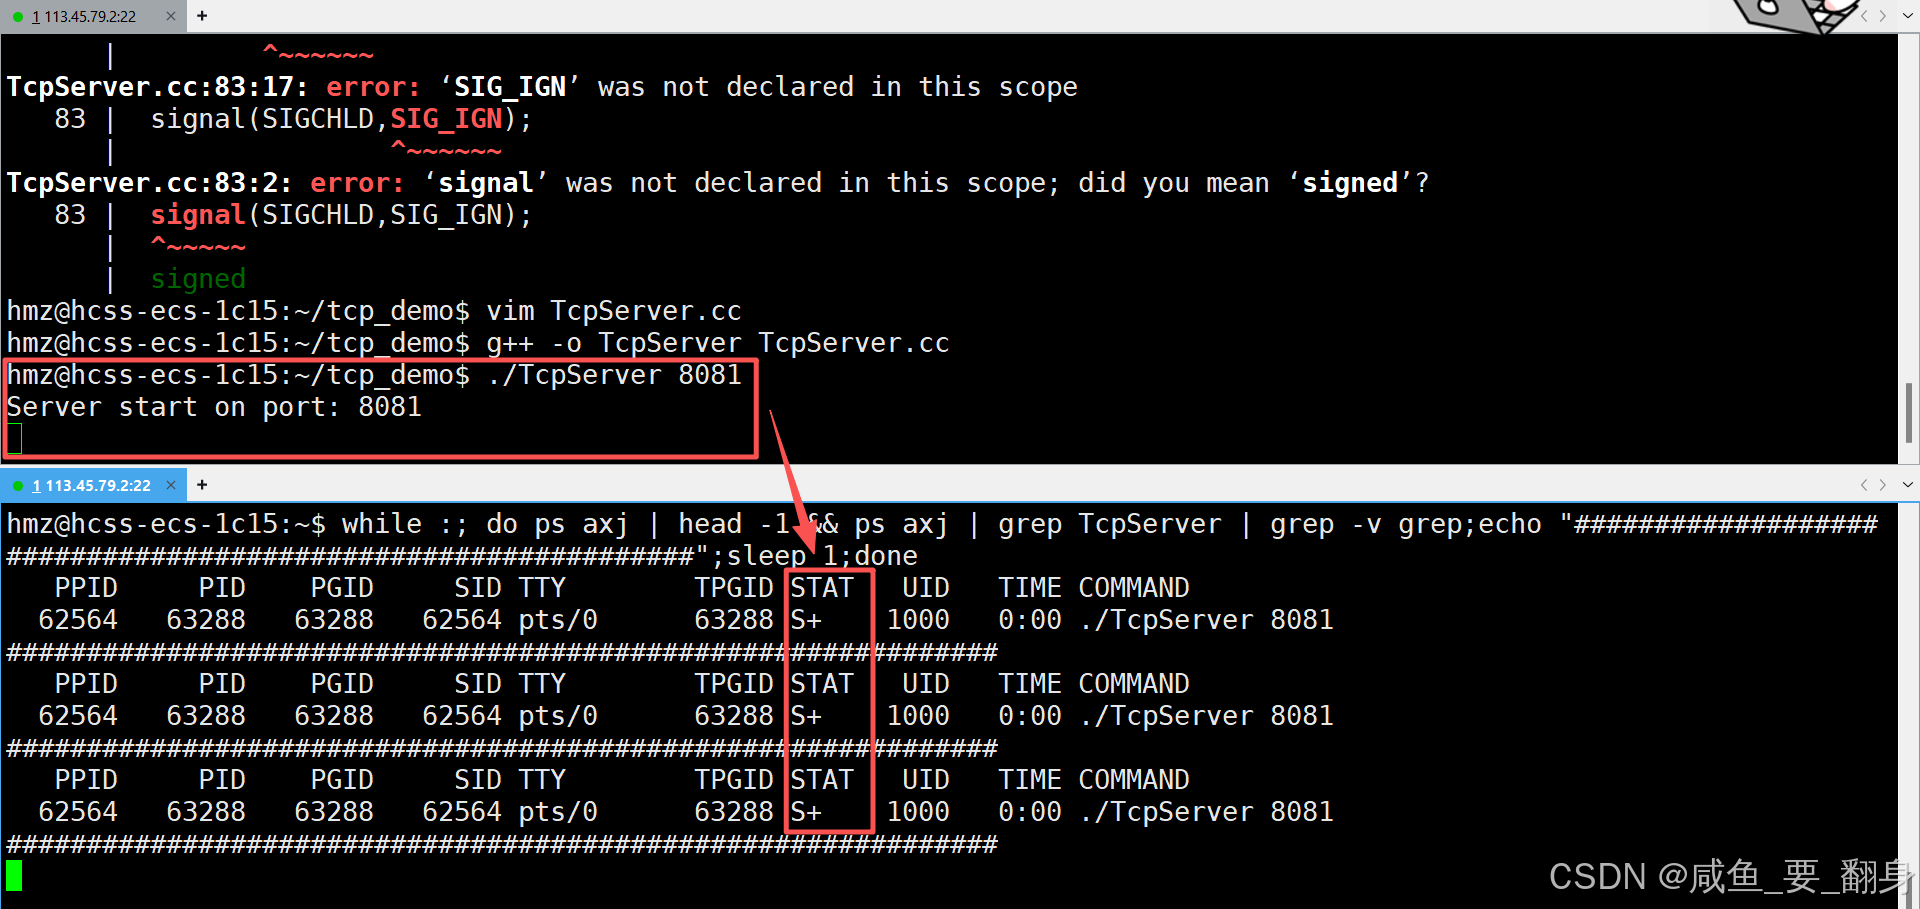
代码测试:完成程序重新编译并启动服务端后,可通过以下监控脚本实时跟踪服务进程状态。
while :; do ps axj | head -1 && ps axj | grep TcpServer | grep -v grep;echo "##############################################################";sleep 1;done
可以看到当前服务器状态显示尚无客户端连接,仅运行着一个主服务进程。该进程持续监听新连接请求,并在接收到连接后创建子进程为对应客户端提供服务。
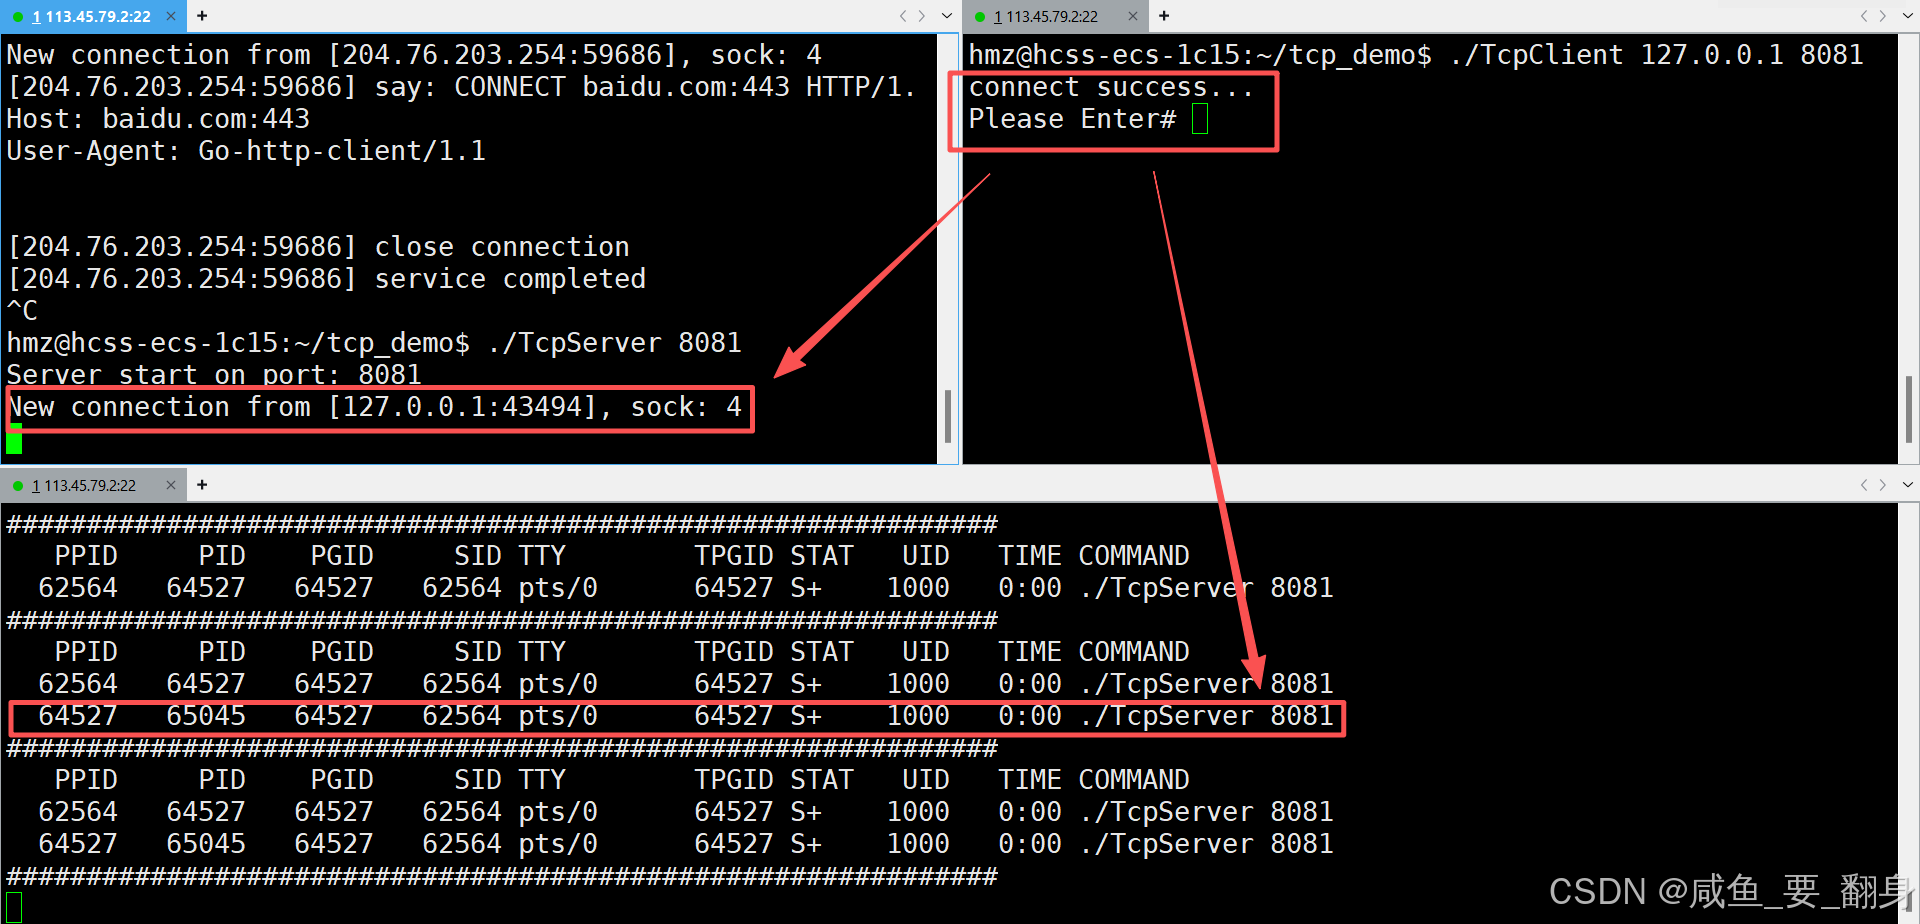
当客户端连接服务器时,服务进程会调用fork函数创建一个子进程,专门为该客户端提供服务。如下监控所示新加入了一个进程:
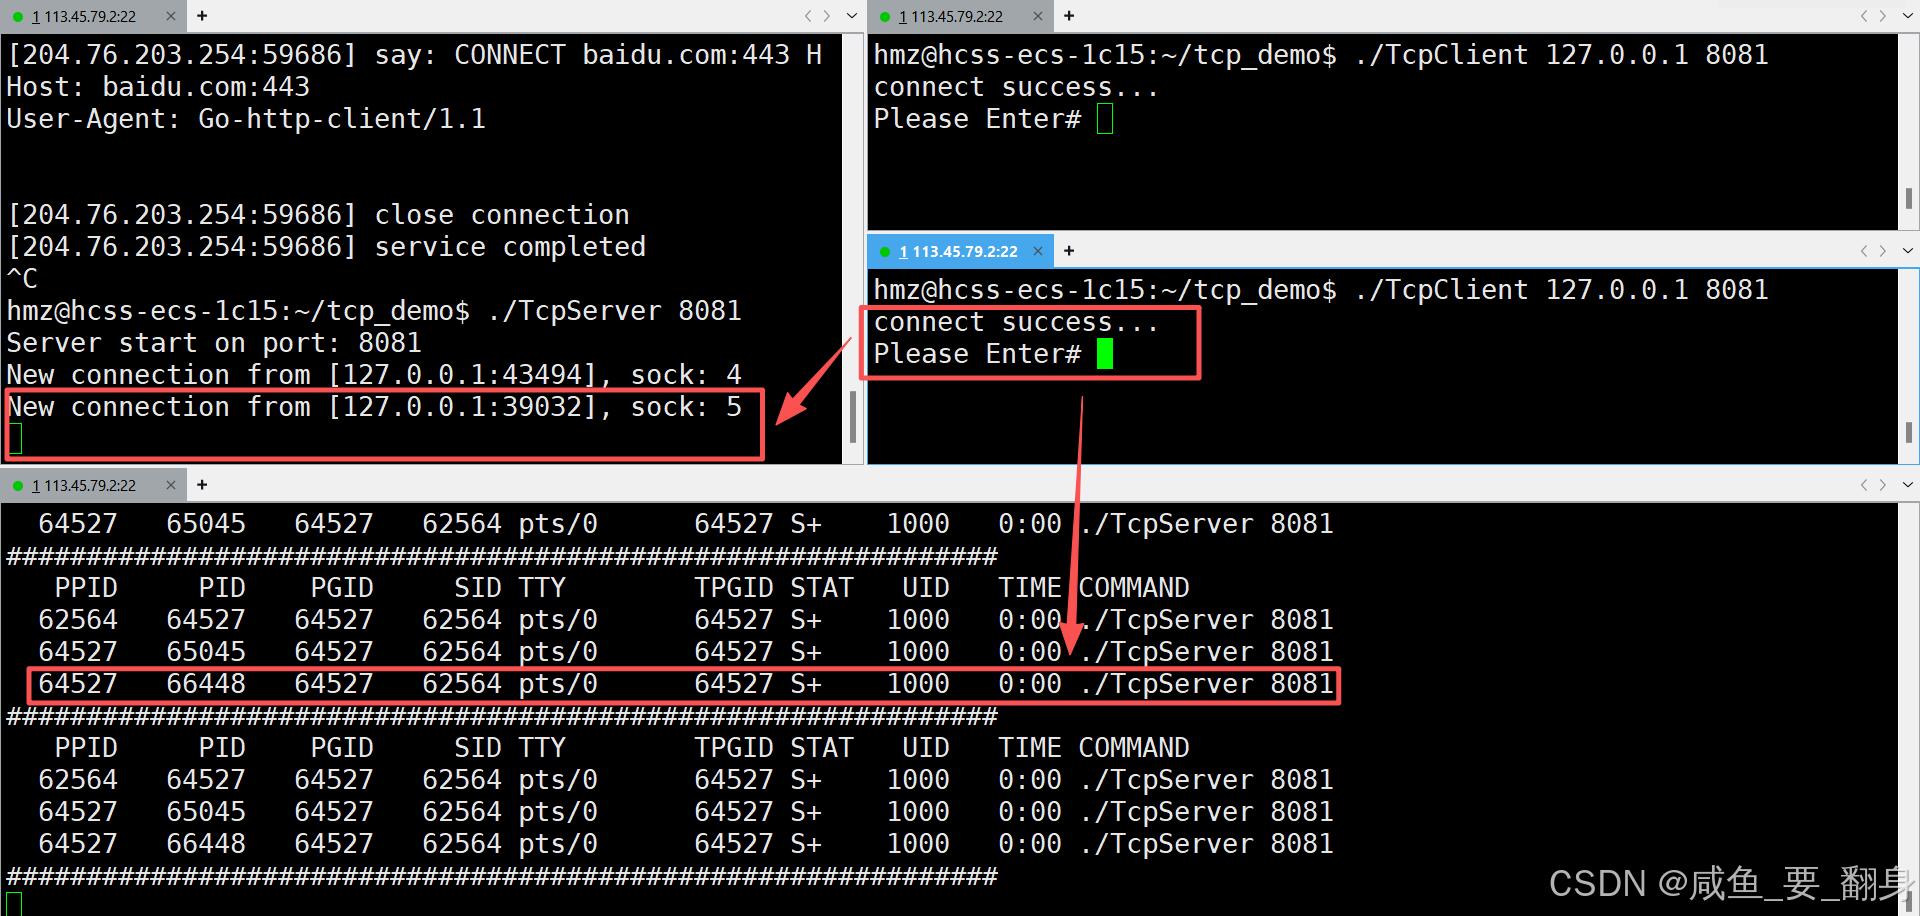
当又有一个新的客户端连接服务器时,服务进程会再创建一个新的子进程来专门处理该客户端的请求。如下监控所示又新加入一个进程:
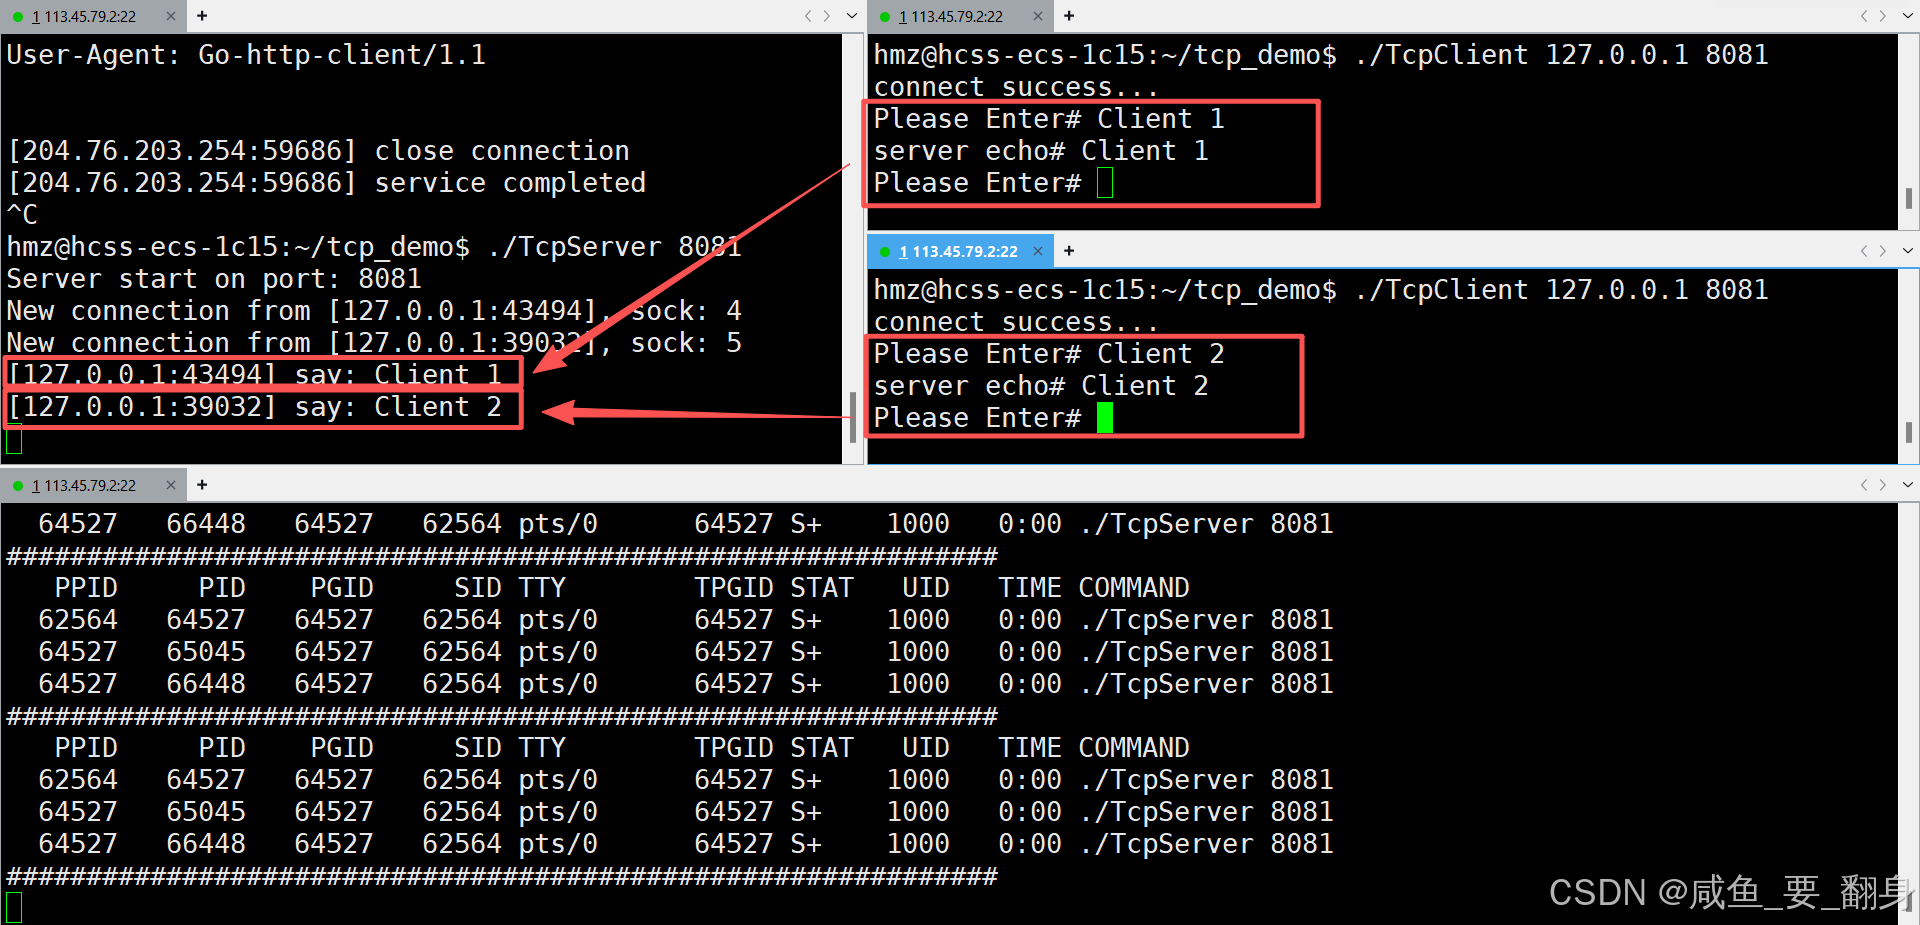
关键在于,这两个客户端由独立的执行流提供服务,因此能够同时获得响应。它们发送至服务端的数据都能被正常接收并处理,服务端也会及时作出反馈。
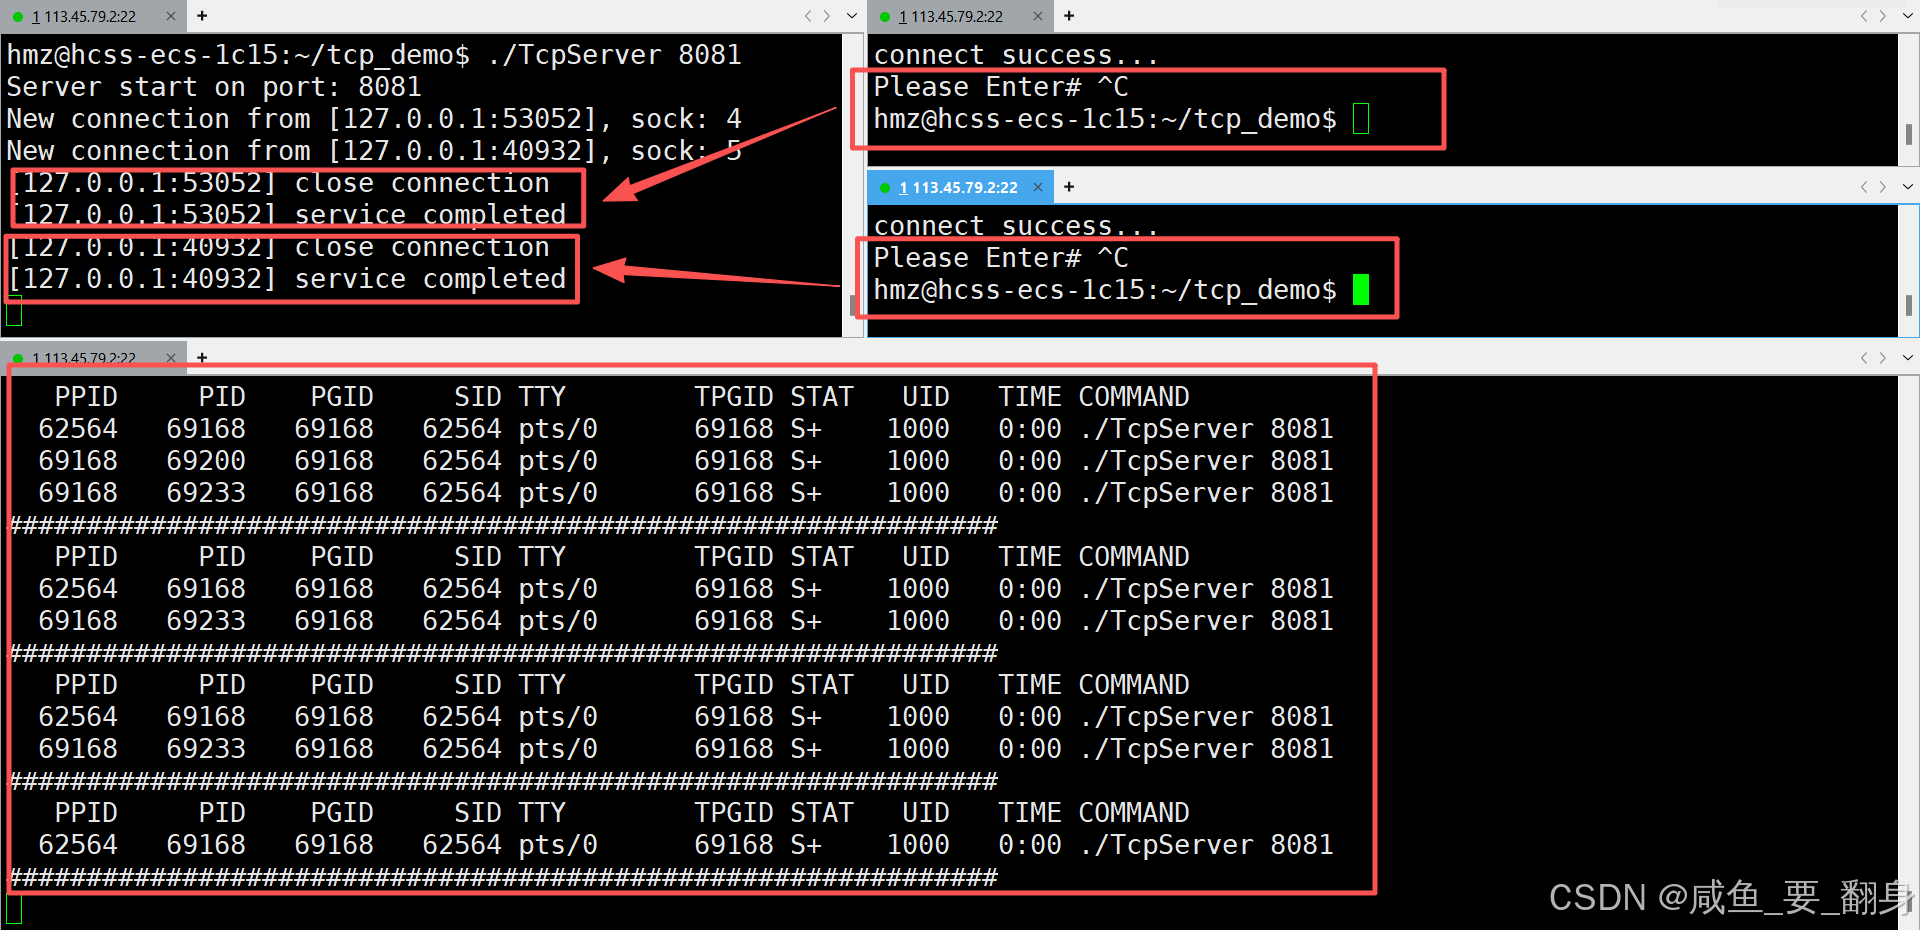
当客户端逐个断开连接时,服务端对应的子进程会随之终止。然而,服务端始终会保留至少一个主服务进程,其主要职责是持续监听并处理新的连接请求。
2. 双层进程模型(推荐)
我们也可以通过服务端创建的子进程再次fork,由孙子进程为客户端提供服务,这样就无需等待孙子进程退出。
进程命名说明:
-
爷爷进程:服务端调用listen监听客户端的进程
-
爸爸进程:由爷爷进程fork创建的子进程
-
孙子进程:由爸爸进程fork创建的进程,负责调用Service函数提供服务
实现机制:
爸爸进程创建孙子进程后立即退出,此时孙子进程成为孤儿进程,然后直接被1号进程给领养!!!由init进程帮忙等待和释放孙子进程!!!
也就是说,服务进程(爷爷进程)通过wait/waitpid能立即完成对爸爸进程的等待
此后服务进程可继续调用accept处理其他客户端请求
孤儿进程处理:
-
由于爸爸进程立即退出,孙子进程成为孤儿进程
-
系统会自动接管孤儿进程
-
服务进程无需等待孙子进程退出
文件描述符管理:
当服务进程(祖父进程)通过listen函数获取新连接后,会由孙子进程负责处理该连接。在此过程中,服务进程首先将文件描述符表传递给父进程,随后父进程通过fork创建孙子进程并再次传递文件描述符表。
由于fork创建的子进程拥有独立的文件描述符表,各进程间的操作互不影响。因此,服务进程在完成fork后可以安全地关闭通过listen获取的文件描述符。同理,父进程和孙子进程无需保留从服务进程继承的监听套接字,父进程可以将其关闭。
-
服务进程在调用fork函数后,应当及时关闭从accept函数获取的文件描述符。这是因为服务进程会持续调用accept函数创建新的服务套接字,若不及时释放不再使用的文件描述符,将导致可用文件描述符数量逐渐减少。
-
对于父进程和子进程,建议关闭从服务进程继承的监听套接字。虽然不关闭仅会造成单个文件描述符的泄漏,但关闭仍是更稳妥的做法。这可以避免子进程在提供服务时对监听套接字进行误操作,进而影响其中的数据。
优势:
-
中间进程无需处理子进程回收,而是直接退出,让1号进程成为子进程的父进程!!!也就是交给系统!!!
-
中间进程退出时自动清理工作进程
class TcpServer
{
public:
void Start()
{
std::cout << "Server start on port: " << _port << std::endl;
for (;;){
//获取连接
struct sockaddr_in peer;
memset(&peer, '\\0', sizeof(peer));
socklen_t len = sizeof(peer);
int sock = accept(_listen_sock, (struct sockaddr*)&peer, &len);
if (sock < 0){
std::cerr << "accept error, continue next" << std::endl;
continue;
}
std::string client_ip = inet_ntoa(peer.sin_addr);
int client_port = ntohs(peer.sin_port);
std::cout << "get a new link->" << sock << " [" << client_ip << "]:" << client_port << std::endl;
pid_t id = fork();
if (id == 0){ //child
close(_listen_sock); //child关闭监听套接字
if (fork() > 0){
exit(0); //爸爸进程直接退出
}
//处理请求
Service(sock, client_ip, client_port); //孙子进程提供服务
exit(0); //孙子进程提供完服务退出
}
close(sock); //father关闭为连接提供服务的套接字
waitpid(id, nullptr, 0); //等待爸爸进程(会立刻等待成功)
}
}
private:
int _listen_sock; //监听套接字
int _port; //端口号
};
这里也要记得加上对应的头文件!!!
#include <sys/wait.h>
服务器测试:重新编译并运行客户端程序后,继续通过监控脚本对服务进程进行实时状态监测。
while :; do ps axj | head -1 && ps axj | grep TcpServer | grep -v grep;echo "##############################################################";sleep 1;done
可以看到目前没有客户端连接到服务器,仅监测到一个服务进程正在等待客户端的连接请求。

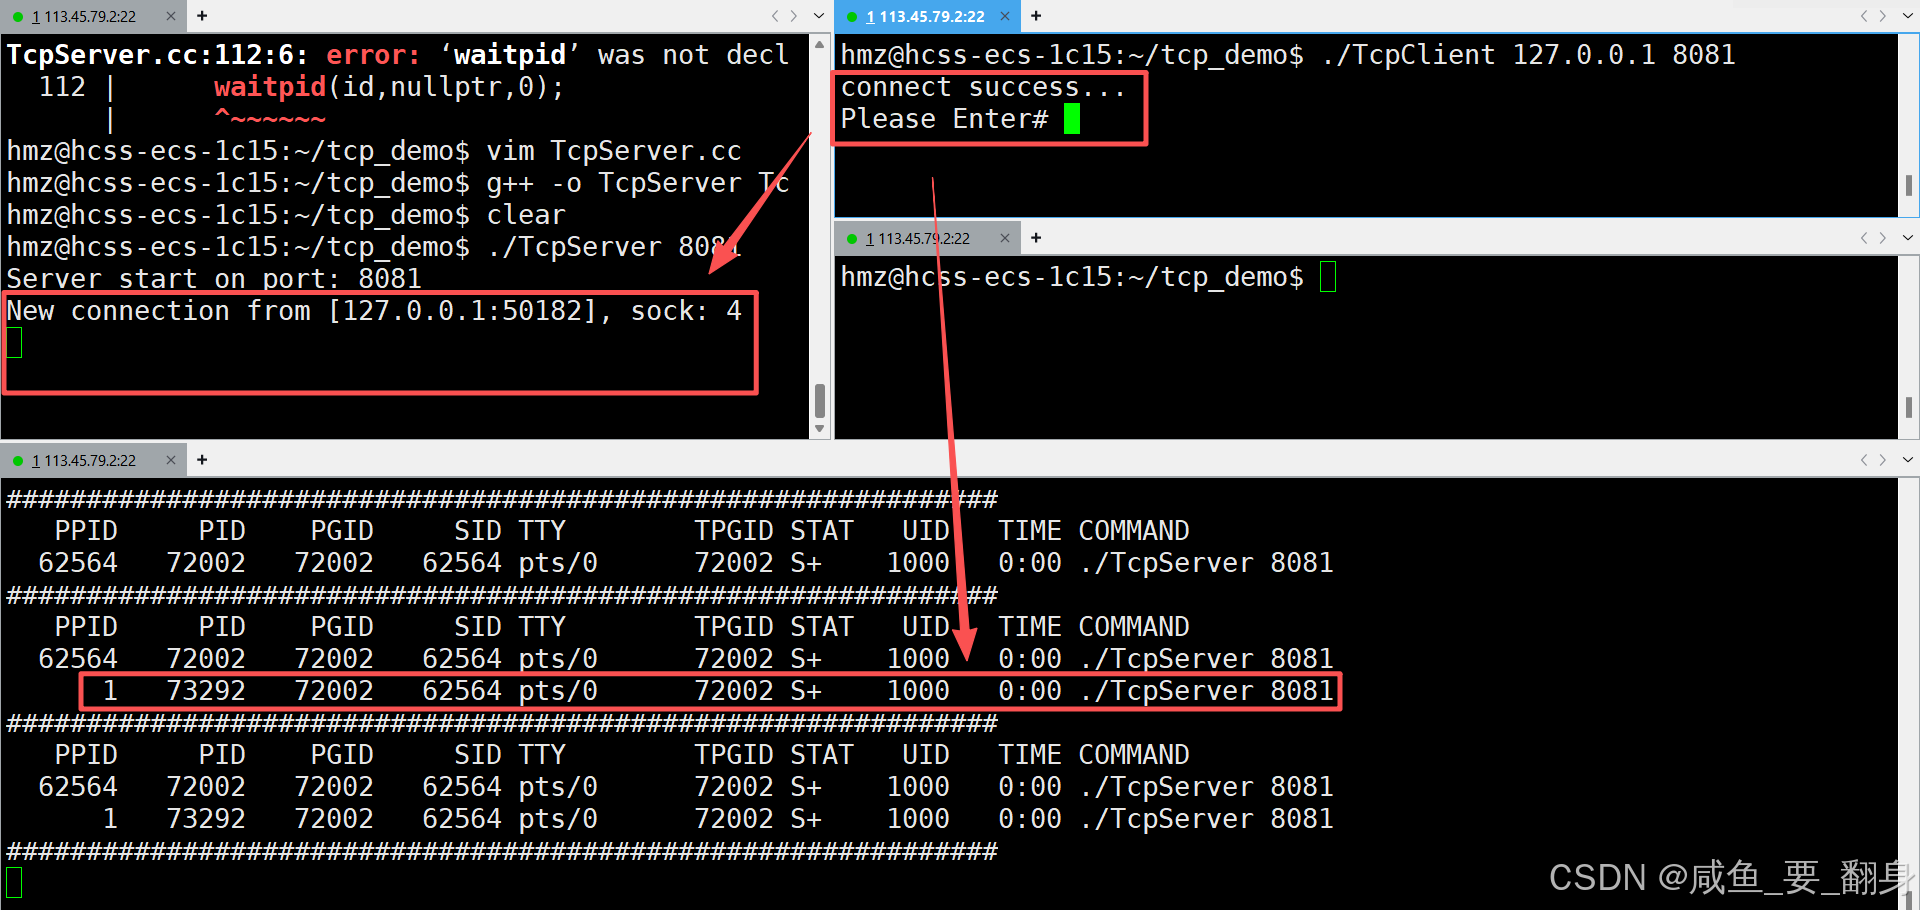
当我们启动一个客户端并连接到服务器时,服务进程会首先创建一个父进程。这个父进程随后会立即创建一个子进程(孙子进程)来为客户端提供服务,随后父进程会自动退出(这个退出速度很快,观察不到父进程的创建和退出过程)。此时系统中仅剩两个服务进程:最初用于接收连接的主服务进程,以及实际处理客户端请求的孙子进程。值得注意的是,孙子进程的PPID显示为1,这表明它已成为孤儿进程。
当第二个客户端连接服务器时,系统会再次创建一个孤儿进程来为其提供服务。
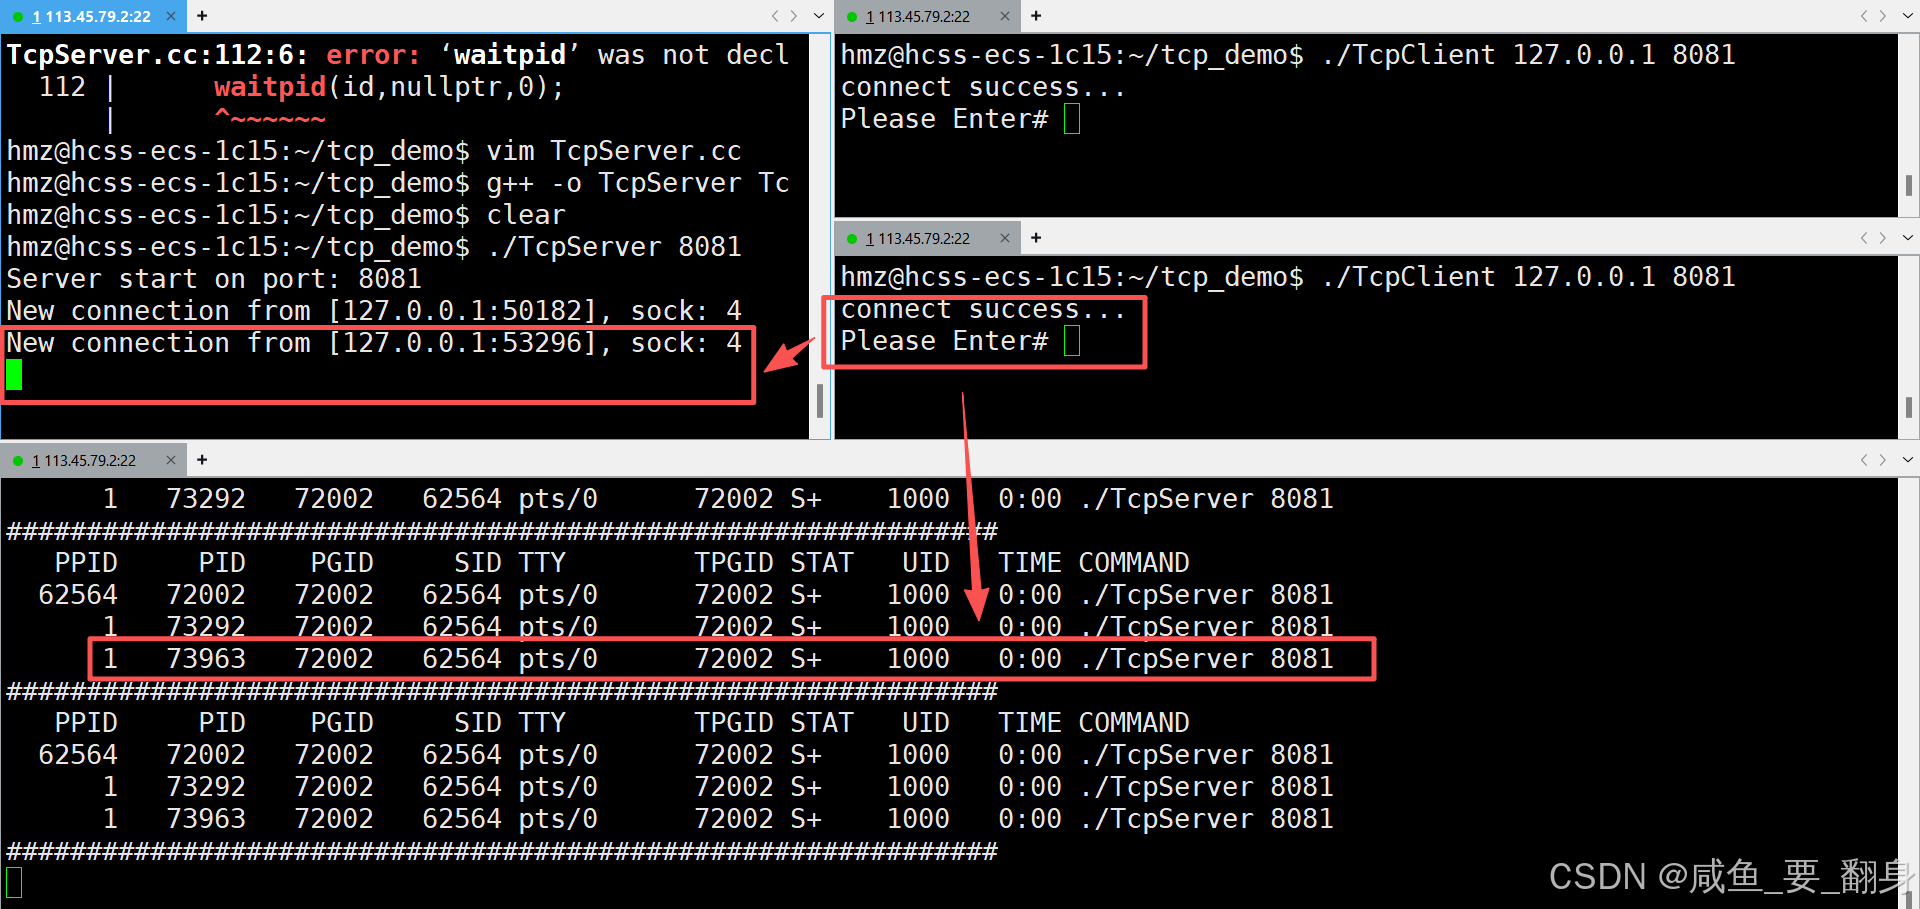
这里思考一下:为什么两个连接的客户端在服务端上输出显示的套接字都为4呢?(重点!!!)
| 主进程 | 保持打开 | 短暂拥有后关闭 | 持续监听 |
| 爸爸进程 | 关闭 | 保持打开 | 短暂存在 |
| 孙子进程 | 关闭 | 保持打开 | 处理具体请求 |
原因分析:文件描述符重用
关键机制
文件描述符是进程资源:每个进程有自己独立的文件描述符表
最小可用FD分配:Linux总是分配当前可用的最小文件描述符编号
描述符及时关闭:在fork过程中,父进程及时关闭了连接套接字
详细过程分析
第一个客户端连接
int sock = accept(_listen_sock, …); // sock = 4
// 主进程:sock=4
pid_t id = fork(); // 创建爸爸进程
// 爸爸进程中:
close(_listen_sock); // 关闭监听套接字
if (fork() > 0) { // 创建孙子进程
exit(0); // 爸爸进程退出
}
// 主进程中:
close(sock); // 关闭sock=4,现在FD 4变为可用状态
waitpid(id, nullptr, 0); // 回收爸爸进程
第二个客户端连接
// 此时FD 4已经可用(主进程关闭了上一个sock)
int sock = accept(_listen_sock, …); // 再次分配sock=4
进程间的文件描述符关系
主进程: _listen_sock=3 (始终打开)
↓
客户端A连接: sock=4 (创建) → fork() → 爸爸进程A → fork() → 孙子进程A(持有sock=4)
↓ 主进程关闭sock=4 (FD 4释放)
↓
客户端B连接: sock=4 (重新分配) → fork() → 爸爸进程B → fork() → 孙子进程B(持有sock=4)
为什么能看到相同的sock值?(这里超级重点!!!理解超级重要!!!)
主进程视角:sock=4被重复使用
孙子进程视角:每个孙子进程都认为自己持有"sock=4",但实际上:
-
孙子进程A:持有指向客户端A连接的描述符4
-
孙子进程B:持有指向客户端B连接的描述符4
-
它们在不同的进程空间中,描述符编号相同但指向不同的网络连接
可以这样理解:就是爷爷进程监听到的客户端对应的信息不同(但同一时刻只有一个监听进程,也就是只有一个监听套接字),然后得到不同的监听套接字,后面通过accept函数接收的到不同的接收套接字(套接字都是使用文件描述符来访问的),所以得到的接收套接字本质是不同的,虽然都是用4号来表示,但第一个4和第二个4是不一样的!!!
1. 监听套接字是同一个
// 整个过程中只有一个监听套接字
_listen_sock // 始终是同一个,比如fd=3
2. 接收套接字本质不同
// 第一个客户端连接
int sock = accept(_listen_sock, …); // 创建连接A → 内核对象A
// 此时 sock=4 指向客户端A的连接
// 第二个客户端连接
int sock = accept(_listen_sock, …); // 创建连接B → 内核对象B
// 此时 sock=4 指向客户端B的连接
3. 关键区别
-
第一个4号:指向客户端A的连接对象
-
第二个4号:指向客户端B的连接对象
-
虽然编号相同,但指向的内核对象完全不同
验证方法
我们可以在Service函数中添加进程信息来验证:
void Service(int sock, const std::string& client_ip, int client_port)
{
std::cout << "Process " << getpid() << " handling sock " << sock
<< " for client [" << client_ip << ":" << client_port << "]" << std::endl;
// … 处理请求
}
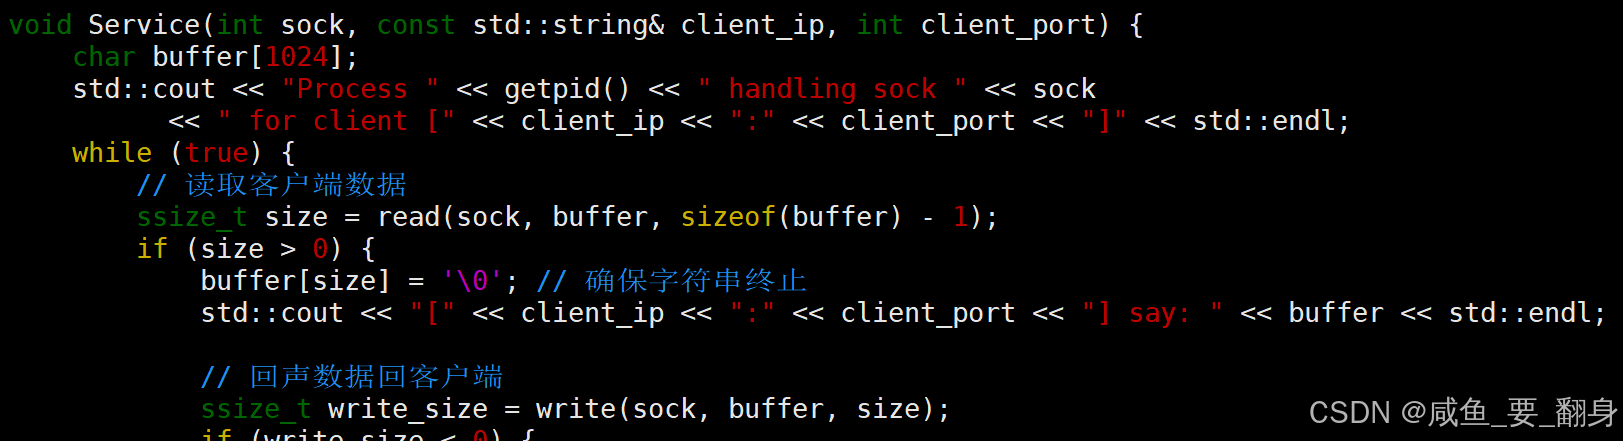
然后会看到这样的输出,通过输出我们可以更加直观的看到IP相同但是端口号不同!!!所以这就对应着不同的网络连接!!!虽然文件描述符一样!!!:
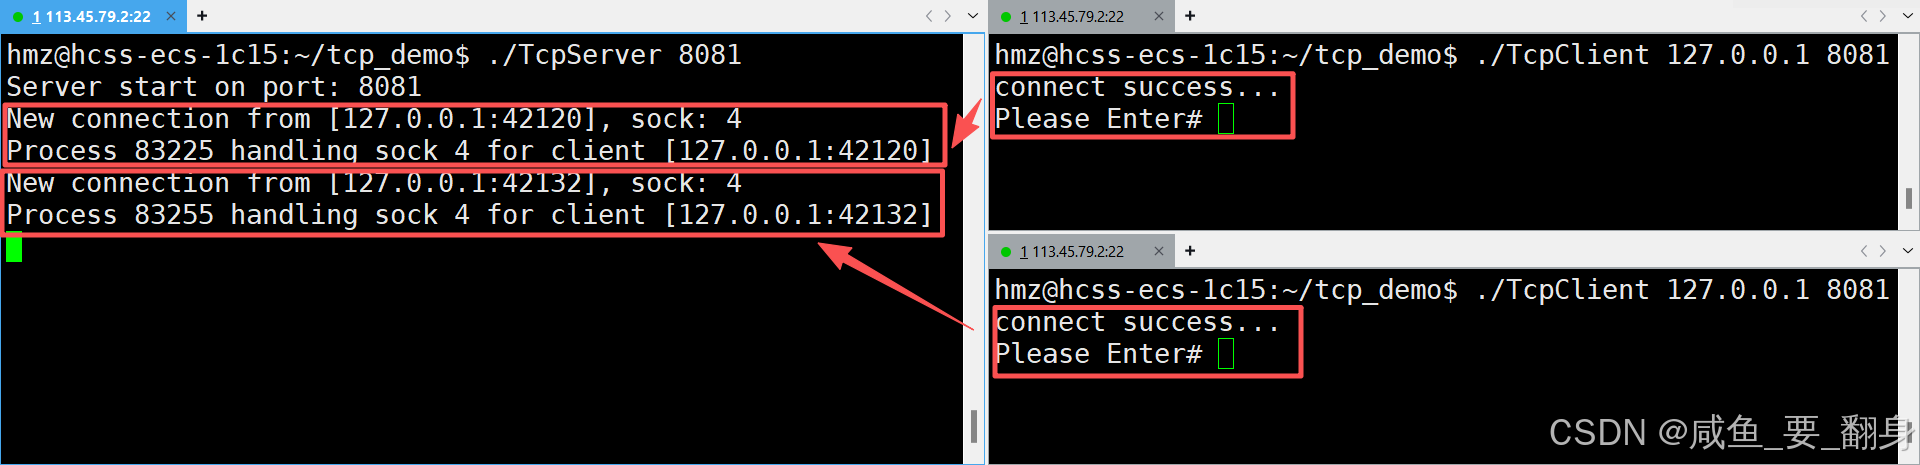
重要结论
这不是bug:这是Linux文件描述符管理的正常行为
不影响功能:每个进程独立维护自己的文件描述符表
资源管理良好:主进程及时关闭不需要的描述符,避免泄漏
并发安全:不同进程中的相同FD编号互不影响
这种现象正好证明了你的服务器代码在正确工作:主进程妥善管理资源,孤儿进程独立处理客户端请求。
关键概念:文件描述符是进程私有的,每个进程有独立的文件描述符表
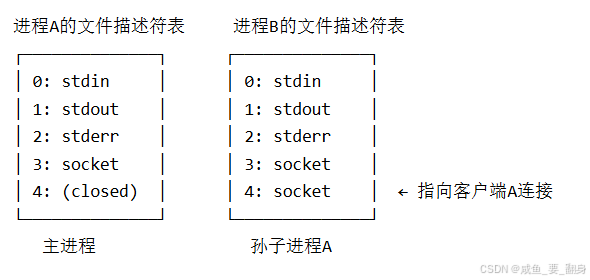
第一阶段:第一个客户端连接后
// 主进程
int sock = accept(_listen_sock, …); // 分配fd=4
pid_t id = fork(); // 创建爸爸进程
// 爸爸进程(复制了主进程的fd表)
close(_listen_sock);
if (fork() > 0) { // 创建孙子进程A
exit(0);
}
// 孙子进程A继续运行,持有fd=4
// 回到主进程
close(sock); // 主进程关闭自己的fd=4
此时的状态:
-
主进程:fd=4 被标记为"可用"
-
孙子进程A:在自己的进程空间中持有fd=4(指向客户端A的连接)
-
两个fd=4完全独立,互不影响
第二阶段:第二个客户端连接时
// 在主进程中
int sock = accept(_listen_sock, …); // 再次分配fd=4
为什么可以重复分配:
主进程只关心自己的文件描述符表
孙子进程A的文件描述符表对主进程不可见
内核为主进程分配fd时,只检查主进程自己的fd表
类比理解:想象每个进程有自己的"钥匙串":
-
主进程:有钥匙3(监听)、钥匙4(已归还)
-
孙子进程A:有钥匙4(指向客户端A的连接)
-
当主进程需要新钥匙时,它只看自己的钥匙串,发现4号位置空着,就再次使用
内核层面的实现
实际上,文件描述符只是进程文件描述符表的索引,真正重要的是背后的struct file结构:
主进程文件描述符表
fd[3] → struct file (监听socket)
fd[4] → struct file (客户端B连接) ← 重新分配
孙子进程A文件描述符表
fd[4] → struct file (客户端A连接) ← 完全独立的对象
总结根本原因:文件描述符编号是进程局部的,不是系统全局的。每个进程维护自己独立的文件描述符表,内核在分配fd时只考虑当前进程的可用情况,不考虑其他进程的使用情况。
诶???现在又疑惑了,为什么呢?因为你看这个总结的原因,如果是这样的话,我们之前使用的管道对应的文件描述符不是可以实现进程间通信吗?这不进一步说明是像全局那样可以访问的吗?为什么又是局部的呢?其实,更准确的说法应该是:文件描述符编号是进程局部的,但文件描述符指向的内核对象可以是系统全局共享的!!!
管道的情况分析
管道的创建和共享
int pipefd[2];
pipe(pipefd); // 创建管道
// pipefd[0]=3 (读端), pipefd[1]=4 (写端)
pid_t pid = fork();
if (pid == 0) {
// 子进程
// 继承了相同的文件描述符:3→读端, 4→写端
// 但这是在fork时复制的,每个进程有自己的fd表项
}
实际的内存结构
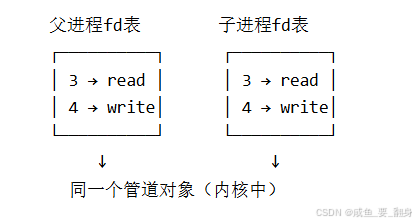
关键区别:继承 vs 独立分配
情况1:fork继承(管道、socketpair等)
// 父子进程共享相同的文件描述符编号
pipe(fd);
fork();
// 父子进程都有相同的fd[0]和fd[1]编号
// 指向同一个管道对象
情况2:独立分配(accept、open等)
// 主进程
int sock1 = accept(…); // fd=4
close(sock1);
// 子进程(通过fork创建)
int sock2 = accept(…); // 也可能得到fd=4
// 但指向不同的连接对象!
更精确的技术解释
1. 文件描述符表是进程私有的
struct task_struct {
struct files_struct *files; // 每个进程独有
};
struct files_struct {
struct file **fd_array; // 该进程的fd数组
};
2. 但struct file对象可以被共享
struct file {
atomic_t f_count; // 引用计数
struct inode *f_inode; // 指向实际的文件/管道/socket
};
内核层面的真实情况
// 内核数据结构示意
struct task_struct { // 进程控制块
struct files_struct *files; // 每个进程独有的文件表
};
struct files_struct {
struct file **fd_array; // 文件描述符指针数组
};
// 实际的内存对象
孙子进程A: fd_array[4] → struct file对象A → TCP连接A
孙子进程B: fd_array[4] → struct file对象B → TCP连接B
这代表什么?
进程隔离的成功体现:每个进程有独立的内存空间和资源视图
正确的并发处理:两个客户端请求被完全独立地处理
没有资源冲突:虽然fd编号相同,但指向不同的网络连接
正确的理解:
文件描述符编号分配是进程局部的:每个进程独立决定给新打开的文件什么编号
文件描述符可以指向共享的内核对象:通过fork继承或传递fd实现
相同编号不一定指向相同对象:不同进程中相同的fd编号可能指向完全不同的资源
相同对象可能有不同编号:通过dup2()可以让不同fd指向同一个对象
所以我的服务器代码中,两个孙子进程的fd=4指向不同的连接,这正是"文件描述符编号是进程局部"的体现!而管道的情况是"内核对象可以被多个进程共享"的体现。两者并不矛盾,只是展示了文件描述符系统的不同方面。
最后再思考一个问题:那像之前我们所说的套接字究竟是文件描述符还是文件描述符编号?
套接字不是文件描述符,也不是文件描述符编号;套接字是内核中的一种对象,而文件描述符是我们访问这个对象的句柄。(前面使用错误的术语,现在我们改正一下,以这个为基准,这个是标准的)
正确的术语使用
-
❌ 错误:"这个套接字是4号"
-
✅ 正确:"这个套接字通过4号文件描述符访问"
-
❌ 错误:"关闭套接字"
-
✅ 正确:"关闭套接字的文件描述符"
类比理解:就像酒店房间:
-
套接字 = 实际的客房(有床、卫生间、设施)
-
文件描述符 = 房卡(让你访问客房)
-
文件描述符编号 = 房卡上的房间号"401"
你可以:
-
有多张房卡指向同一个房间(dup2)
-
不同酒店的401房间完全不同(不同进程的相同fd编号)
-
退还房卡但房间还在(close fd但套接字可能还被其他进程使用)
总结
-
套接字是内核中的网络连接对象
-
文件描述符是进程访问该对象的句柄
-
文件描述符编号是句柄在进程内的标识符
在你的服务器代码中,当你说"sock=4"时,你指的是:使用编号为4的文件描述符来访问某个套接字对象。
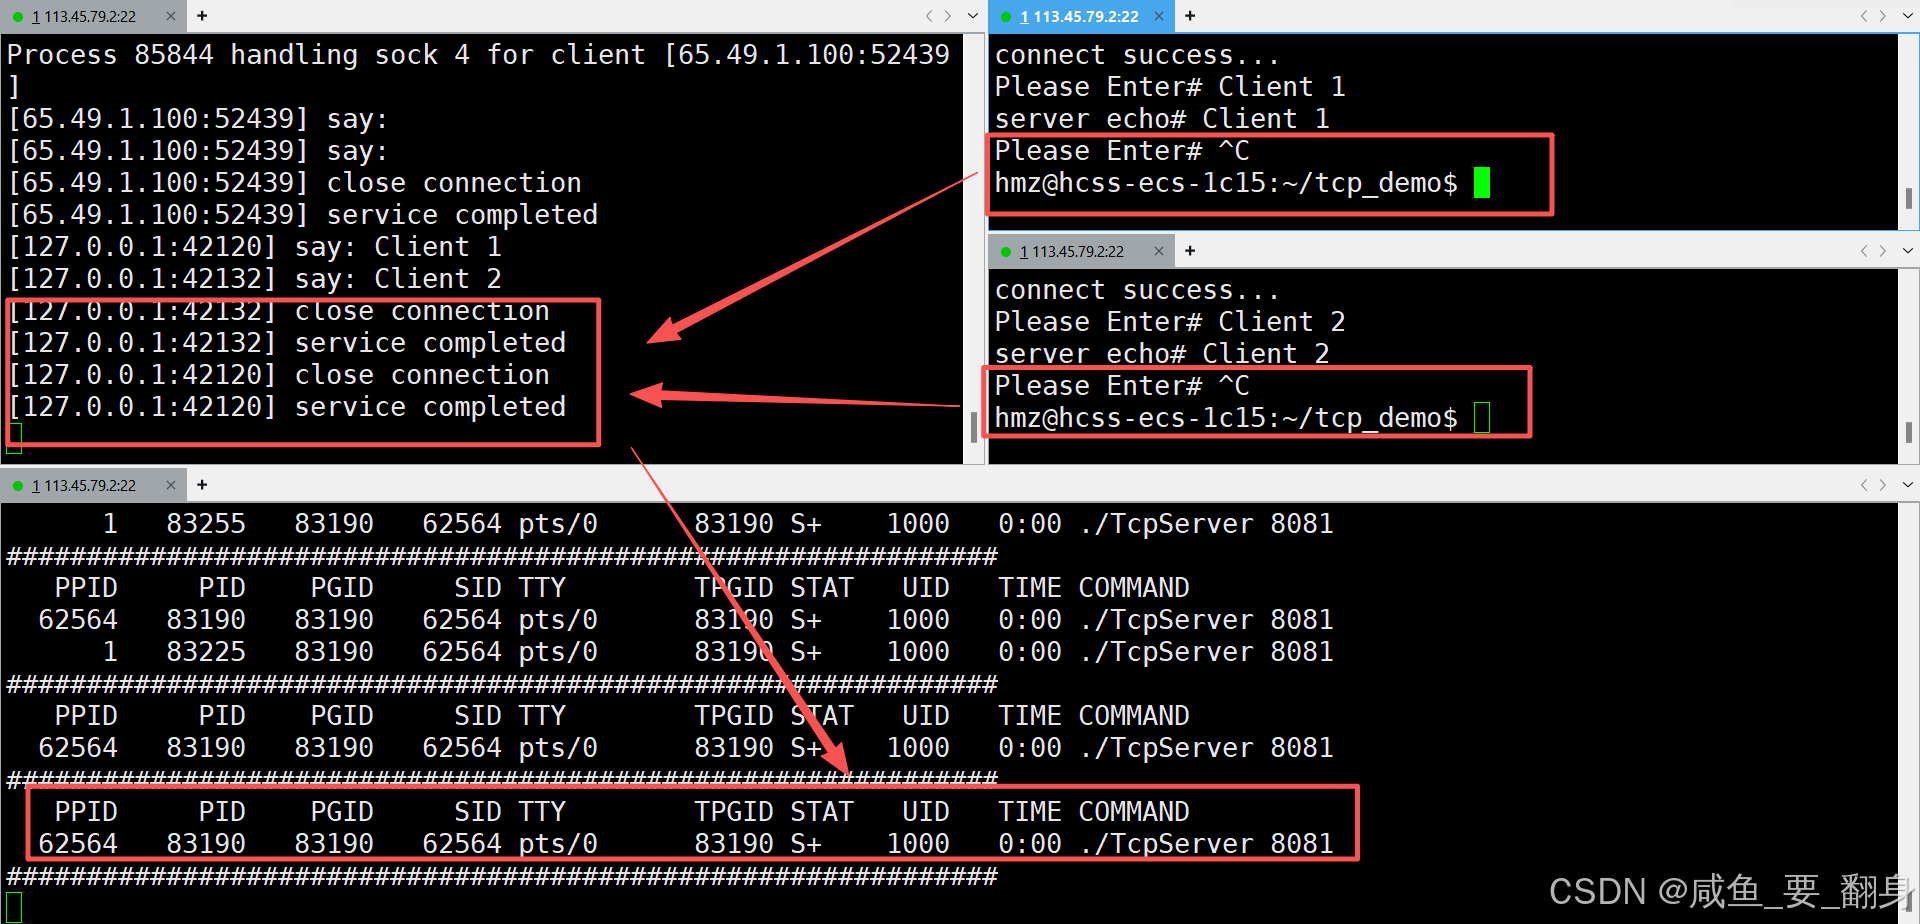
分析完上面的问题,我们接着回到刚刚的测试中,此时,两个客户端分别由独立的孤儿进程提供服务,因此能够同时处理请求。客户端发送的数据均能在服务端正常输出,服务端也会及时给予响应。
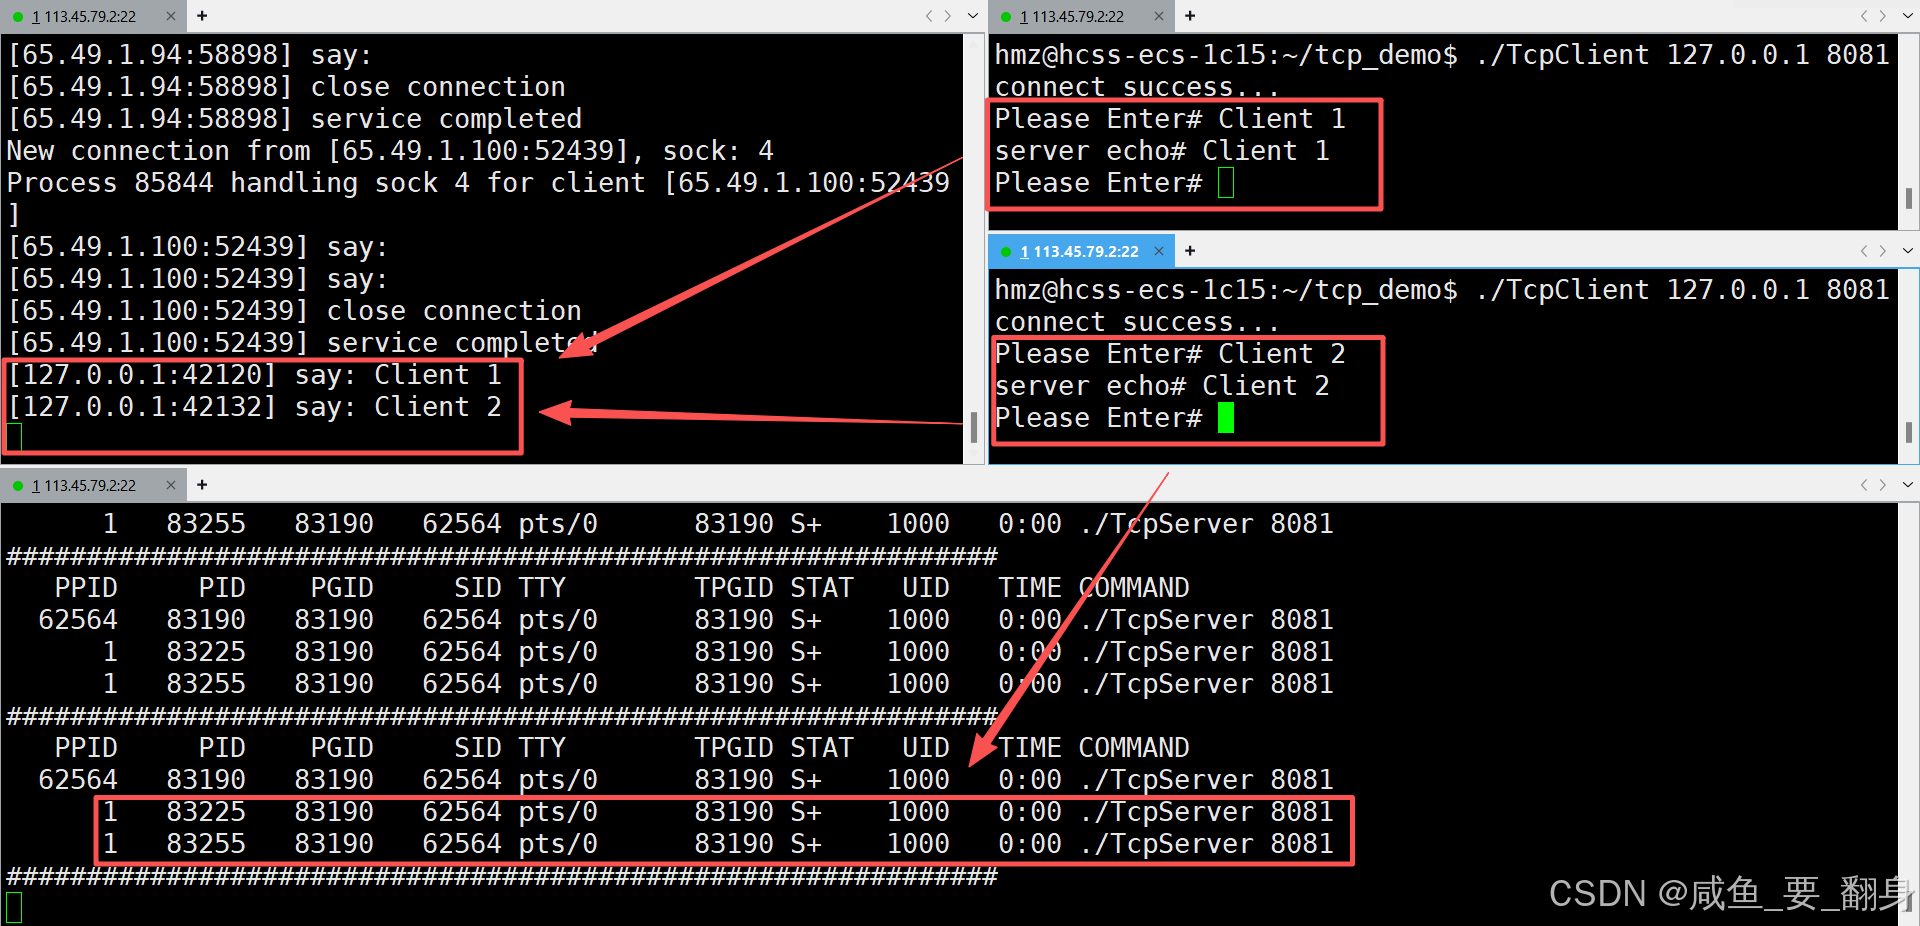
当所有客户端退出后,为其提供服务的孤儿进程也将随之终止。这些进程会被系统自动回收,最终仅保留最初建立连接的服务进程。
5、补充知识
问题1:进程退出后,曾经打开的文件会怎么办?
核心答案:当一个进程正常或异常退出时,内核会负责回收该进程所占用的几乎所有资源。这包括清理其内存空间、取消内存映射、以及最关键地——关闭所有该进程打开的文件描述符。
详细解释:
自动关闭机制:
-
进程控制块(PCB,在Linux中通常是 task_struct 结构体)中维护着一个“打开文件描述符表”。
-
当进程退出时,作为进程终止流程的一部分,内核会遍历这个表,对每一个有效的文件描述符(fd)执行 close() 系统调用。
-
这个操作是内核级别的,是强制性的,无论进程是以何种方式退出(main 函数返回、调用 exit()、接收到致命信号等)。
close() 操作的具体影响:
-
释放文件描述符:该进程的fd号码被标记为空闲,可以再次被该进程(如果它还活着)或其后代进程使用。
-
递减内核文件对象的引用计数:每个被打开的文件在内核中都有一个对应的 struct file 对象。close(fd) 会将这个对象的引用计数减1。
-
检查引用计数:如果引用计数减为0,意味着没有任何进程再需要这个文件对象了。此时,内核会执行最终的清理工作:
-
最终释放这个 struct file 对象,文件被真正关闭。
-
如果文件被修改过并且处于写缓存模式,会将最后的脏数据刷写到磁盘。
-
调用文件系统特定的 release(或 close)方法。
-
一个重要的推论:文件描述符是“每进程”的
-
进程A打开文件 test.txt,得到fd 3。
-
进程B打开同一个文件 test.txt,会得到它自己独立的fd(可能是3,也可能是其他数字)。
-
当进程A退出时,它只关闭自己的fd 3,这只会影响进程A自己的访问。进程B的fd仍然有效,可以继续读写文件。内核中该文件的 struct file 对象的引用计数只是从2减为了1,并未归零,所以文件不会被彻底关闭。
总结:进程退出 → 内核自动关闭其所有打开的文件描述符 → 内核文件对象引用计数减1 → 若引用计数归零,则执行最终的文件关闭和资源释放。
问题2:父进程打开文件后创建子进程,子进程能使用父进程的fd吗?
核心答案:能,绝对可以。 这正是许多进程间通信(IPC)机制,如管道、匿名FIFO等的工作原理基础。
详细解释:
继承机制:
-
当父进程调用 fork() 创建子进程时,子进程会获得一份父进程地址空间的副本。
-
这个“副本”不仅仅包括代码、数据、堆栈,还包括了进程的“打开文件描述符表”。
-
这意味着,父进程在 fork() 之前打开的每一个文件描述符,在子进程中都有一个完全相同的副本。它们指向内核中同一个 struct file 对象。
关键:共享同一个内核文件对象
-
父进程的fd 3 和 子进程的fd 3,指向的是内核中完全相同的 struct file 结构。
-
因此,它们共享:
-
同一个文件偏移量:如果父进程通过fd 3读取了100字节,文件偏移量前进了100。那么子进程再通过它的fd 3读取时,会从第100字节之后开始读。这个特性是管道、协同处理文件等能够正常工作的关键。
-
文件的打开状态和权限(读、写、追加等)。
-
对文件的访问权限。
-
引用计数的变化:
-
在 fork() 之前,假设父进程打开了一个文件,内核中该文件的 struct file 引用计数为1。
-
fork() 成功后,子进程也拥有了这个fd,引用计数变为2。
-
现在,需要父进程和子进程都关闭了这个fd,引用计数才会从2减到0,文件才会被最终关闭。
以管道为例进行验证:像之前我们提到的“管道不就是吗?”完全正确!!!让我们拆解一下管道的创建和使用过程:
#include <unistd.h>
#include <stdio.h>
int main() {
int pipefd[2];
pid_t pid;
char buf;
// 1. 父进程创建一个管道。pipefd[0]用于读,pipefd[1]用于写。
if (pipe(pipefd) == -1) {
perror("pipe");
exit(EXIT_FAILURE);
}
// 2. 父进程调用 fork()
pid = fork();
if (pid == -1) {
perror("fork");
exit(EXIT_FAILURE);
}
if (pid == 0) { /*** 子进程 ***/
close(pipefd[1]); // 子进程关闭不用的写端
// 子进程从 pipefd[0] (继承自父进程) 读取数据
while (read(pipefd[0], &buf, 1) > 0) {
write(STDOUT_FILENO, &buf, 1);
}
write(STDOUT_FILENO, "\\n", 1);
close(pipefd[0]); // 关闭读端
_exit(EXIT_SUCCESS);
} else { /*** 父进程 ***/
close(pipefd[0]); // 父进程关闭不用的读端
// 父进程向 pipefd[1] (自己打开的) 写入数据
const char *msg = "Hello from parent!";
write(pipefd[1], msg, strlen(msg));
close(pipefd[1]); // 关闭写端,发送EOF给子进程
wait(NULL); // 等待子进程退出
exit(EXIT_SUCCESS);
}
}
在这个例子中:
-
pipe() 在父进程上下文中创建了管道,打开了两个文件描述符 pipefd[0] 和 pipefd[1]。
-
fork() 后,子进程继承了这两个fd。
-
父子进程通过关闭不需要的fd来建立正确的单向数据流(父写子读)。
-
它们操作的是同一个管道对象,所以父进程写入的数据,子进程可以立即读到。
需要注意的地方:
-
竞态条件:由于文件偏移量是共享的,如果父子进程同时对一个普通文件进行写入(没有使用 O_APPEND 标志),输出内容可能会混杂在一起。需要使用同步机制(如文件锁)来避免。
-
正确的资源管理:正因为fd是共享的,所以必须由所有持有它的进程都关闭后,资源才会释放。在管道例子中,父进程关闭写端后,子进程的读端才能看到EOF。如果某个进程忘记关闭一个fd,即使其他进程都退出了,这个文件资源也可能一直无法释放。
总结表格
| 核心行为 | 内核自动关闭所有fd | 子进程继承父进程的所有fd |
| 对内核文件对象的影响 | 引用计数减1 | 引用计数加1 |
| 最终关闭条件 | 该进程的关闭操作使引用计数归零 | 需要父和子都关闭fd才能使引用计数归零 |
| 实际应用 | 确保进程不会永久占用文件资源 | 管道、FIFO、重定向等IPC和资源共享的基础 |
| 文件偏移量 | – | 共享,导致协同操作和竞态条件 |
三、多线程版TCP网络程序设计
1、进程与线程创建成本对比
在实现多执行流的服务器时,选择多线程而非多进程的主要原因在于资源开销的显著差异:
-
进程创建成本高:创建进程需要分配独立的进程控制块(task_struct)、进程地址空间(mm_struct)、页表等核心数据结构,这些操作涉及内核大量工作。
-
线程创建成本低:线程作为进程内的执行单元,共享进程的大部分资源(如地址空间、文件描述符表等),只需创建线程控制块(TCB)和少量私有资源,开销通常比进程小10-100倍。
因此,在需要处理大量并发连接的服务器程序中,多线程架构是更高效的选择。
2、多线程服务器基本架构
2.1 连接处理流程
主线程(服务进程)在监听套接字上调用accept()获取新连接
为每个新连接创建一个专用服务线程
新线程使用该连接的文件描述符与客户端通信
主线程继续监听新连接,实现并发处理
2.2 线程管理策略
当服务进程通过accept函数获取新连接时,可以立即创建新线程来处理客户端请求。需要注意的是,主线程(服务进程)需要等待新线程结束,否则可能产生类似僵尸进程的问题。若希望避免主线程等待,可通过pthread_detach函数将新线程设置为分离状态。这样当线程结束时,系统会自动回收其资源。如此一来,主线程就能继续调用accept获取新连接,而由分离线程独立处理客户端请求。
-
线程分离:通过pthread_detach()使线程退出时自动回收资源,避免僵尸线程问题
-
资源所有权:明确各线程对文件描述符的管理职责
3、文件描述符管理
3.1 共享文件描述符表
-
文件描述符表用于维护进程与文件之间的映射关系,每个进程都拥有自己独立的文件描述符表。
-
当主线程创建新线程时,由于这些线程同属一个进程,它们会共享该进程的文件描述符表,而不会为每个线程单独创建新的描述符表。
-
所有线程共享同一文件描述符表,这是POSIX线程的标准行为
-
表项包含:文件描述符编号、打开文件标志、文件偏移量指针、v节点指针(指向内核文件结构)

3.2 使用规范
当服务进程(主线程)通过accept函数获取文件描述符后,新创建的线程可以直接访问该描述符。需要注意的是,虽然新线程能够访问主线程获取的文件描述符,但它们无法自动识别各自服务的客户端对应的描述符。因此主线程在创建新线程时,必须明确告知每个线程需要操作的套接字文件描述符,以便新线程知道应该处理哪个客户端连接。
-
主线程职责:创建监听套接字、调用accept()接受新连接、将返回的已连接套接字传递给服务线程
-
服务线程职责:使用传入的套接字与客户端通信、通信完成后关闭套接字、绝对不要关闭监听套接字
4、参数结构体设计
在实际业务中,新线程通过调用Service函数为客户端提供服务,该函数需要接收三个参数:客户端套接字、IP地址和端口号。然而,pthread_create函数在创建新线程时仅支持传入单个void*类型的参数。
为此,我们设计了Param结构体来封装这三个必要参数。主线程创建新线程时,可实例化一个Param对象,将客户端套接字、IP地址和端口号存入其中,然后将该对象的地址作为参数传递给线程执行例程。
在线程执行例程中,只需将传入的void* 参数强制转换为Param* 类型,即可获取所需的客户端信息,进而调用Service函数完成服务处理。由于pthread_create()只能传递一个void*参数,需要设计参数封装结构:
class Param {
public:
Param(int sock, const std::string& ip, int port)
: _sock(sock), _ip(ip), _port(port) {}
~Param() = default;
// 禁止拷贝
Param(const Param&) = delete;
Param& operator=(const Param&) = delete;
public:
int _sock; // 已连接套接字
std::string _ip; // 客户端IP
int _port; // 客户端端口
};
参数传递流程
主线程创建Param对象(堆上分配)
将对象指针传递给pthread_create()
新线程获取指针并转换为Param*
使用参数后释放内存
5、文件描述符共享问题
由于所有线程共享同一份文件描述符表,因此在操作文件描述符时,必须考虑其对其他线程的影响。下面的注意事项全是基于这一点来进行的:
对于主线程通过accept获取的文件描述符:
-
主线程不应主动关闭该描述符
-
关闭操作应由服务线程执行
-
服务线程需在处理完客户端请求后才能关闭
对于监听套接字:
-
服务线程无需关注监听套接字
-
禁止服务线程关闭监听套接字描述符
-
否则将导致主线程无法接收新连接
6、将Service函数定义为静态成员函数的原因
-
pthread_create函数要求线程执行例程必须是一个接受void* 参数并返回void* 的函数。
-
当我们将执行例程定义在类内部时,必须将其声明为静态成员函数,否则编译器会自动添加隐藏的this指针作为第一个参数。
-
由于线程执行例程中需要调用Service函数,而静态成员函数不能直接调用非静态成员函数,因此必须将Service函数也声明为静态成员。
-
考虑到Service函数的实现本身并不依赖类的实例成员,只需简单地在函数声明前添加static修饰符即可满足需求。
静态成员函数要求
由于线程入口函数必须符合void* (*)(void*)的签名:
-
必须声明为static(消除this指针隐式传递)
-
不能直接访问非静态成员变量
-
通过参数传递所需数据
class TcpServer
{
public:
static void* HandlerRequest(void* arg)
{
pthread_detach(pthread_self()); //分离线程
//int sock = *(int*)arg;
Param* p = (Param*)arg;
Service(p->_sock, p->_ip, p->_port); //线程为客户端提供服务
delete p; //释放参数占用的堆空间
return nullptr;
}
void Start()
{
std::cout << "Server start on port: " << _port << std::endl;
for (;;){
//获取连接
struct sockaddr_in peer;
memset(&peer, '\\0', sizeof(peer));
socklen_t len = sizeof(peer);
int sock = accept(_listen_sock, (struct sockaddr*)&peer, &len);
if (sock < 0){
std::cerr << "accept error, continue next" << std::endl;
continue;
}
std::string client_ip = inet_ntoa(peer.sin_addr);
int client_port = ntohs(peer.sin_port);
std::cout << "get a new link->" << sock << " [" << client_ip << "]:" << client_port << std::endl;
Param* p = new Param(sock, client_ip, client_port);
pthread_t tid;
pthread_create(&tid, nullptr, HandlerRequest, p);
}
}
private:
int _listen_sock; //监听套接字
int _port; //端口号
};
7、关键注意事项
-
资源泄漏防护:确保线程参数内存被释放、确保文件描述符被正确关闭
-
错误处理:系统调用失败后的恢复策略、线程创建失败的处理
-
线程安全:避免多个线程同时操作共享资源、对于真正的共享数据,需要使用互斥锁等同步机制
-
性能考虑:线程创建/销毁开销、考虑使用线程池优化频繁创建线程的场景
8、扩展建议
-
线程池模式:对于高并发场景,预先创建一组线程比动态创建更高效
-
连接超时处理:添加定时器机制管理空闲连接
-
优雅退出:实现服务器的正常关闭流程
-
日志系统:完善的日志记录便于问题排查
这种多线程架构适合中等规模的并发连接(数百到数千),对于更高并发需求,可考虑I/O多路复用(如epoll)结合线程池的混合模式。
9、代码测试
我们客户端完全不用改变,只是改变了服务端的实现方式,使用多线程来实现!!!而不是使用进程了。现在重新编译服务端代码时需要注意:由于代码使用了多线程功能,编译时必须添加-lpthread选项。
#include <pthread.h>

另外,由于我们需要监控的是各个线程的运行状态,此时应该使用ps -aL命令而非之前的ps -axj命令来进行监控。
while :; do ps -aL|head -1&&ps -aL|grep TcpServer;echo "##########################################";sleep 1;done
ps -aL 命令
-
功能:显示当前用户的所有进程,并包含线程信息(LWP – Light Weight Process)
-
各字段含义:
-
PID:进程ID
-
LWP:轻量级进程ID(线程ID)
-
TTY:终端设备
-
TIME:CPU占用时间
-
CMD:命令名称
-
-
使用场景:查看一个进程包含哪些线程、分析多线程程序的线程情况、查找具体的线程ID
ps -axj 命令
-
功能:以作业格式显示所有进程的详细信息
-
各字段含义:PPID:父进程ID、PID:进程ID、PGID:进程组ID、SID:会话ID、TTY:控制终端、TPGID:前台进程组ID、STAT:进程状态、UID:用户ID、TIME:CPU时间、COMMAND:完整命令
-
进程状态(STAT)说明:S:睡眠状态、R:运行状态、D:不可中断睡眠、T:停止状态、Z:僵尸进程、s:会话领导者、<:高优先级、N:低优先级、L:有页面锁在内存中
-
使用场景:查看进程的父子关系、分析进程组和会话信息、排查僵尸进程、查看完整的进程树结构
-
启动服务端后,监控显示当前仅有一个服务线程运行,即主线程,此时该线程正处于等待客户端连接的状态。

当客户端与服务端建立连接后,主线程会执行以下操作:
为该客户端创建参数结构体
生成新线程
将参数结构体地址传递给新线程
新线程从参数结构体中获取必要参数
调用Service函数处理客户端请求
因此,监控系统会显示两个线程同时运行。如下所示:

当第二个客户端发起连接请求时,主线程会重复相同流程,创建新线程为该客户端提供服务。此时服务端已运行着三个线程。可以看到连接套接字4已经被第一个客户端占了,并且这是在一个进程中的线程资源,所以下一个客户端只能占连接套接字5了。

这两个客户端由独立的执行流提供服务,因此可以同时接收服务端响应。服务端能正常打印来自两个客户端的消息,并将回显数据准确返回给各自对应的客户端。

每当有客户端发起连接请求时,服务端都会创建对应的新线程来处理该客户端的请求。随着客户端逐个断开连接,这些服务线程也会依次终止运行。最终,服务端将仅保留最初的主线程,继续等待新的连接请求。

10、补充:问题分析
问题1:fd线程能看到吗?
答案:1(能)
原因:
-
在同一个进程内的所有线程共享文件描述符表
-
文件描述符是进程级别的资源,不是线程级别的
-
一个线程打开文件获得的fd,同一进程内的其他线程都可以使用
问题2:线程敢不敢关闭自己不需要的fd?
答案:0(不敢)
原因:
-
文件描述符是进程共享资源,关闭一个fd会影响整个进程
-
其他线程可能正在使用该fd,突然关闭会导致:
-
其他线程的读写操作失败
-
数据丢失或程序崩溃
-
-
正确的做法是通过线程间通信协调fd的使用
popen/pclose 函数详解
函数原型
#include <stdio.h>
FILE *popen(const char *command, const char *type);
int pclose(FILE *stream);

功能说明
popen():创建管道并执行命令
-
command:要执行的shell命令
-
type:
-
"r":从命令读取输出(父进程读,子进程写)
-
"w":向命令写入输入(父进程写,子进程读)
-
执行流程
// 示例:执行 "ls -a -l -n" 并读取输出
FILE *fp = popen("ls -a -l -n", "r");
if (fp != NULL) {
char buffer[1024];
while (fgets(buffer, sizeof(buffer), fp) != NULL) {
// 处理输出
}
pclose(fp);
}
底层实现
创建管道:建立父子进程间的通信通道
fork()创建子进程:
-
子进程重定向标准输入/输出到管道
-
子进程通过exec执行命令
父进程返回FILE指针用于读写
关键知识点总结
| 文件描述符共享 | 同一进程的所有线程共享fd表 |
| fd关闭风险 | 线程不应随意关闭fd,会影响其他线程 |
| popen原理 | 管道 + fork + exec + 标准流重定向 |
| 进程间通信 | popen使用管道实现进程间数据传递 |
这样的设计确保了进程内资源的统一管理,同时也要求线程在使用共享资源时要格外小心。
四、线程池版的TCP网络程序
1、传统多线程模式的缺陷
当前多线程服务器架构存在以下问题:
线程创建与销毁开销大
-
每当新客户端连接时,主线程都需要动态创建服务线程
-
服务结束后立即销毁该线程
-
这种频繁的线程创建/销毁操作效率低下
高并发场景性能瓶颈
-
面对大量并发请求时,需要为每个客户端创建独立线程
-
线程数量激增导致CPU调度压力骤增
-
线程切换开销显著增加系统负担
-
线程调度周期延长,直接影响客户端响应速度
2、解决方案
针对上述问题,我们采用以下优化策略:
线程池预创建机制
-
服务端预先初始化一组线程资源
-
客户端请求到达时立即分配空闲线程提供服务
-
避免临时创建线程带来的性能开销
线程复用机制
-
服务线程完成任务后保持活跃状态
-
无任务时线程进入休眠等待状态
-
新请求到达时唤醒休眠线程继续服务
资源管控机制
-
严格控制线程池大小,避免CPU过载
-
当所有线程繁忙时,新请求进入全连接队列等待
-
出现空闲线程时从队列获取待处理请求继续服务
该方案通过资源预分配、循环利用和智能调度,实现了服务能力与系统负载的平衡。
3、线程池的实现与应用
为了解决服务端的性能问题,我们引入了线程池机制(之前已经实现过)。线程池的核心价值在于:
避免频繁创建和销毁线程带来的性能损耗
提高CPU内核的利用率
防止系统资源的过度调度
线程池的工作机制包含以下关键组件:
-
任务队列:接收并存储待处理任务
-
工作线程:默认创建5个线程持续运行
-
任务处理流程:
-
线程持续轮询任务队列
-
发现任务后立即取出并执行其Run方法
-
队列为空时线程进入休眠状态
-
下面使用简易版线程池来实现,如下:
#define NUM 5
//线程池
template<class T>
class ThreadPool
{
private:
bool IsEmpty()
{
return _task_queue.size() == 0;
}
void LockQueue()
{
pthread_mutex_lock(&_mutex);
}
void UnLockQueue()
{
pthread_mutex_unlock(&_mutex);
}
void Wait()
{
pthread_cond_wait(&_cond, &_mutex);
}
void WakeUp()
{
pthread_cond_signal(&_cond);
}
public:
ThreadPool(int num = NUM)
: _thread_num(num)
{
pthread_mutex_init(&_mutex, nullptr);
pthread_cond_init(&_cond, nullptr);
}
~ThreadPool()
{
pthread_mutex_destroy(&_mutex);
pthread_cond_destroy(&_cond);
}
//线程池中线程的执行例程
static void* Routine(void* arg)
{
pthread_detach(pthread_self());
ThreadPool* self = (ThreadPool*)arg;
//不断从任务队列获取任务进行处理
while (true){
self->LockQueue();
while (self->IsEmpty()){
self->Wait();
}
T task;
self->Pop(task);
self->UnLockQueue();
task.Run(); //处理任务
}
}
void ThreadPoolInit()
{
pthread_t tid;
for (int i = 0; i < _thread_num; i++){
pthread_create(&tid, nullptr, Routine, this); //注意参数传入this指针
}
}
//往任务队列塞任务(主线程调用)
void Push(const T& task)
{
LockQueue();
_task_queue.push(task);
UnLockQueue();
WakeUp();
}
//从任务队列获取任务(线程池中的线程调用)
void Pop(T& task)
{
task = _task_queue.front();
_task_queue.pop();
}
private:
std::queue<T> _task_queue; //任务队列
int _thread_num; //线程池中线程的数量
pthread_mutex_t _mutex;
pthread_cond_t _cond;
};
4、服务类新增线程池成员
当前服务端引入了线程池机制,需要在服务类中添加一个线程池指针成员:
实例化服务器对象时,线程池指针初始化为空指针
服务器初始化完成后,构造实际的线程池对象
-
可指定线程数量参数
-
若不指定,默认创建5个工作线程
服务器启动前初始化线程池
-
创建工作线程
-
线程持续监听任务队列并执行任务
工作流程:
-
服务进程通过accept获取连接请求后
-
根据客户端套接字、IP和端口构建任务
-
调用线程池的Push接口将任务加入队列
这是一个典型的生产者-消费者模型:
-
生产者:服务进程(生成任务)
-
消费者:线程池工作线程(处理任务)
-
交易场所:线程池的任务队列
class TcpServer
{
public:
TcpServer(int port)
: _listen_sock(-1)
, _port(port)
, _tp(nullptr)
{}
void InitServer()
{
//创建套接字
_listen_sock = socket(AF_INET, SOCK_STREAM, 0);
if (_listen_sock < 0){
std::cerr << "socket error" << std::endl;
exit(2);
}
//绑定
struct sockaddr_in local;
memset(&local, '\\0', sizeof(local));
local.sin_family = AF_INET;
local.sin_port = htons(_port);
local.sin_addr.s_addr = INADDR_ANY;
if (bind(_listen_sock, (struct sockaddr*)&local, sizeof(local)) < 0){
std::cerr << "bind error" << std::endl;
exit(3);
}
//监听
if (listen(_listen_sock, BACKLOG) < 0){
std::cerr << "listen error" << std::endl;
exit(4);
}
_tp = new ThreadPool<Task>(); //构造线程池对象
}
void Start()
{
_tp->ThreadPoolInit(); //初始化线程池
for (;;){
//获取连接
struct sockaddr_in peer;
memset(&peer, '\\0', sizeof(peer));
socklen_t len = sizeof(peer);
int sock = accept(_listen_sock, (struct sockaddr*)&peer, &len);
if (sock < 0){
std::cerr << "accept error, continue next" << std::endl;
continue;
}
std::string client_ip = inet_ntoa(peer.sin_addr);
int client_port = ntohs(peer.sin_port);
std::cout << "get a new link->" << sock << " [" << client_ip << "]:" << client_port << std::endl;
Task task(sock, client_ip, client_port); //构造任务
_tp->Push(task); //将任务Push进任务队列
}
}
private:
int _listen_sock; //监听套接字
int _port; //端口号
ThreadPool<Task>* _tp; //线程池
};
5、任务类设计
任务类需要包含以下核心属性:客户端套接字、客户端IP地址、客户端端口号。这些属性用于标识任务对应的客户端连接信息。任务类需实现Run方法,该方法将被线程池中的线程调用以执行任务处理。实际业务逻辑通过服务类的Service函数实现。
实现方案建议:
直接将Service函数移植到任务类中作为Run方法(简单但不推荐,破坏分层架构)
更优方案:在任务类中添加仿函数成员,通过回调机制执行任务处理,既保持架构清晰性,又能灵活调用Service函数。
class Task
{
public:
Task()
{}
Task(int sock, std::string client_ip, int client_port)
: _sock(sock)
, _client_ip(client_ip)
, _client_port(client_port)
{}
~Task()
{}
//任务处理函数
void Run()
{
_handler(_sock, _client_ip, _client_port); //调用仿函数
}
private:
int _sock; //套接字
std::string _client_ip; //IP地址
int _client_port; //端口号
Handler _handler; //处理方法
};
注意:当任务队列中存在任务时,线程池中的线程会先创建一个Task对象,然后将该对象作为输出参数传递给任务队列的Pop函数来获取任务。因此,Task类除了需要提供带参数的构造函数外,还必须包含无参构造函数,以便创建空对象。
6、设计Handler类
接下来需要设计Handler类,在该类中重载()运算符,使其执行逻辑等同于Service函数的代码。
class Handler
{
public:
Handler()
{}
~Handler()
{}
void operator()(int sock, std::string client_ip, int client_port)
{
char buffer[1024];
while (true){
ssize_t size = read(sock, buffer, sizeof(buffer)-1);
if (size > 0){ //读取成功
buffer[size] = '\\0';
std::cout << client_ip << ":" << client_port << "# " << buffer << std::endl;
write(sock, buffer, size);
}
else if (size == 0){ //对端关闭连接
std::cout << client_ip << ":" << client_port << " close!" << std::endl;
break;
}
else{ //读取失败
std::cerr << sock << " read error!" << std::endl;
break;
}
}
close(sock); //归还文件描述符
std::cout << client_ip << ":" << client_port << " service done!" << std::endl;
}
};
我们可以让服务器处理多种任务,当前它仅执行字符串回显功能。实际的任务处理逻辑完全由任务类中的handler成员决定。要扩展服务器功能,只需修改Handler类中的运算符重载函数即可。服务器的初始化、启动和线程池管理代码都无需改动,这种设计实现了通信功能与业务逻辑的软件解耦。
7、代码测试阶段
整理一下服务端的代码,下面是完整TcpServer.cc代码(服务端):
#include <iostream>
#include <pthread.h>
#include <sys/wait.h>
#include <csignal> // 用于 signal(), SIGCHLD, SIG_IGN
#include <cstdlib> // 可选,如果需要 exit() 等函数
#include <string>
#include <cstring>
#include <unistd.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
#include <queue>
#define BACKLOG 5
#define NUM 5
// 前向声明
class Handler;
class Task;
//线程池
template<class T>
class ThreadPool
{
private:
bool IsEmpty()
{
return _task_queue.size() == 0;
}
void LockQueue()
{
pthread_mutex_lock(&_mutex);
}
void UnLockQueue()
{
pthread_mutex_unlock(&_mutex);
}
void Wait()
{
pthread_cond_wait(&_cond, &_mutex);
}
void WakeUp()
{
pthread_cond_signal(&_cond);
}
public:
ThreadPool(int num = NUM)
: _thread_num(num)
{
pthread_mutex_init(&_mutex, nullptr);
pthread_cond_init(&_cond, nullptr);
}
~ThreadPool()
{
pthread_mutex_destroy(&_mutex);
pthread_cond_destroy(&_cond);
}
//线程池中线程的执行例程
static void* Routine(void* arg)
{
pthread_detach(pthread_self());
ThreadPool* self = (ThreadPool*)arg;
//不断从任务队列获取任务进行处理
while (true){
self->LockQueue();
while (self->IsEmpty()){
self->Wait();
}
T task;
self->Pop(task);
self->UnLockQueue();
task.Run(); //处理任务
}
}
void ThreadPoolInit()
{
pthread_t tid;
for (int i = 0; i < _thread_num; i++){
pthread_create(&tid, nullptr, Routine, this); //注意参数传入this指针
}
}
//往任务队列塞任务(主线程调用)
void Push(const T& task)
{
LockQueue();
_task_queue.push(task);
UnLockQueue();
WakeUp();
}
//从任务队列获取任务(线程池中的线程调用)
void Pop(T& task)
{
task = _task_queue.front();
_task_queue.pop();
}
private:
std::queue<T> _task_queue; //任务队列
int _thread_num; //线程池中线程的数量
pthread_mutex_t _mutex;
pthread_cond_t _cond;
};
class Handler
{
public:
Handler()
{}
~Handler()
{}
void operator()(int sock, std::string client_ip, int client_port)
{
char buffer[1024];
while (true){
ssize_t size = read(sock, buffer, sizeof(buffer)-1);
if (size > 0){ //读取成功
buffer[size] = '\\0';
std::cout << client_ip << ":" << client_port << "# " << buffer << std::endl;
write(sock, buffer, size);
}
else if (size == 0){ //对端关闭连接
std::cout << client_ip << ":" << client_port << " close!" << std::endl;
break;
}
else{ //读取失败
std::cerr << sock << " read error!" << std::endl;
break;
}
}
close(sock); //归还文件描述符
std::cout << client_ip << ":" << client_port << " service done!" << std::endl;
}
};
class Task
{
public:
Task()
{}
Task(int sock, std::string client_ip, int client_port)
: _sock(sock)
, _client_ip(client_ip)
, _client_port(client_port)
{}
~Task()
{}
//任务处理函数
void Run()
{
_handler(_sock, _client_ip, _client_port); //调用仿函数
}
private:
int _sock; //套接字
std::string _client_ip; //IP地址
int _client_port; //端口号
Handler _handler; //处理方法
};
class TcpServer
{
public:
TcpServer(int port)
: _listen_sock(-1)
, _port(port)
, _tp(nullptr)
{}
void InitServer()
{
//创建套接字
_listen_sock = socket(AF_INET, SOCK_STREAM, 0);
if (_listen_sock < 0){
std::cerr << "socket error" << std::endl;
exit(2);
}
//绑定
struct sockaddr_in local;
memset(&local, '\\0', sizeof(local));
local.sin_family = AF_INET;
local.sin_port = htons(_port);
local.sin_addr.s_addr = INADDR_ANY;
if (bind(_listen_sock, (struct sockaddr*)&local, sizeof(local)) < 0){
std::cerr << "bind error" << std::endl;
exit(3);
}
//监听
if (listen(_listen_sock, BACKLOG) < 0){
std::cerr << "listen error" << std::endl;
exit(4);
}
_tp = new ThreadPool<Task>(); //构造线程池对象
}
void Start()
{
_tp->ThreadPoolInit(); //初始化线程池
for (;;){
//获取连接
struct sockaddr_in peer;
memset(&peer, '\\0', sizeof(peer));
socklen_t len = sizeof(peer);
int sock = accept(_listen_sock, (struct sockaddr*)&peer, &len);
if (sock < 0){
std::cerr << "accept error, continue next" << std::endl;
continue;
}
std::string client_ip = inet_ntoa(peer.sin_addr);
int client_port = ntohs(peer.sin_port);
std::cout << "get a new link->" << sock << " [" << client_ip << "]:" << client_port << std::endl;
Task task(sock, client_ip, client_port); //构造任务
_tp->Push(task); //将任务Push进任务队列
}
}
private:
int _listen_sock; //监听套接字
int _port; //端口号
ThreadPool<Task>* _tp; //线程池
};
int main() {
TcpServer server(8081); // 创建服务器实例,监听8081端口
server.InitServer(); // 初始化服务器
server.Start(); // 启动服务器
return 0;
}
现在,我们重新编译服务端代码后,可以通过以下监控脚本来查看服务端各个线程的运行状态。
while :; do ps -aL|head -1&&ps -aL|grep TcpServer;echo "##########################################";sleep 1;done

服务端启动后,即使没有客户端连接请求,系统默认会创建6个线程。其中1个线程(第一个)负责监听新连接,其余5个(后面五个)是线程池中预分配的服务线程,用于处理后续的客户端请求。

当客户端连接到服务器时,主线程会接收连接请求,将其封装为任务对象并放入任务队列。随后,线程池中的5个工作线程之一会从队列中取出该任务,执行对应的处理函数为客户端提供服务。

当第二个客户端发起连接请求时,服务端会将其封装为任务并加入队列。线程池中的线程随后从队列中获取并处理该任务。由于两个客户端分别由不同的执行流提供服务,因此可以同时享受服务。

不同于之前的情况,现在无论有多少客户端请求,服务端始终仅由线程池中的5个线程提供服务。线程数量不会随客户端连接数增加而变化,这些线程也不会因客户端断开而终止。