一、引文
我们上一篇定时计算热点文章使用的是XXL-JOB,这个方案有几个明显的不足。第一个不足就是每一次计算评分都是把最近5天全部文章拉出来一起评分,这种全量扫描在很多情况下是没必要的,比如说那些评分数据不变的就没必要拉出来再算复用之前的评分即可。第二个不足就是用户只有在隔天才能感受到热点文章的变化,无法实时感知,时效性差。因此我们在本篇文章决定采用Kafka Stream的流式计算功能,通过事件驱动 + 增量流式实现实时计算热点文章。
二、流式计算
1.简介
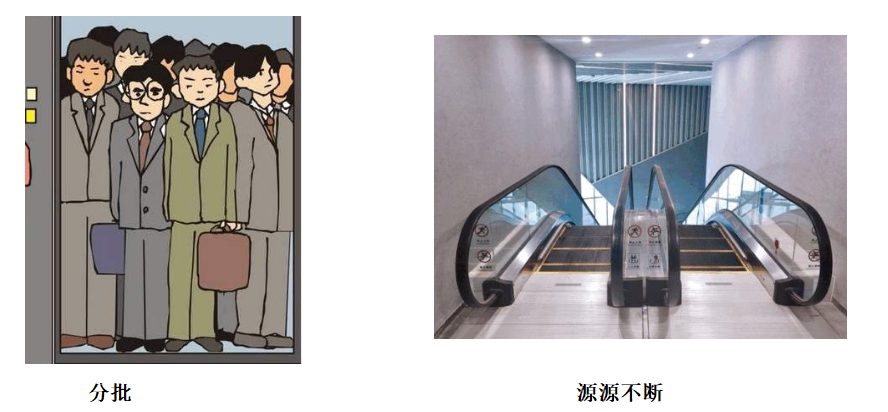
一般流式计算会与批量计算相比较。在流式计算模型中,输入是持续的,可以认为在时间上是无界的,也就意味着,永远拿不到全量数据去做计算。同时,计算结果是持续输出的,也即计算结果在时间上也是无界的。流式计算一般对实时性要求较高,同时一般是先定义目标计算,然后数据到来之后将计算逻辑应用于数据。同时为了提高计算效率,往往尽可能采用增量计算代替全量计算。
流式计算就相当于上图的右侧扶梯,是可以源源不断的产生数据,源源不断的接收数据,没有边界。
2.应用场景
– 日志分析
网站的用户访问日志进行实时的分析,计算访问量,用户画像,留存率等等,实时的进行数据分析,帮助企业进行决策
– 大屏看板统计
可以实时的查看网站注册数量,订单数量,购买数量,金额等。
– 公交实时数据
可以随时更新公交车方位,计算多久到达站牌等
– 实时文章分值计算
头条类文章的分值计算,通过用户的行为实时文章的分值,分值越高就越被推荐。
3.技术选型
1.Hadoop:
2.Apche Storm:
Storm 是一个分布式实时大数据处理系统,可以帮助我们方便地处理海量数据,具有高可靠、高容错、高扩展的特点。是流式框架,有很高的数据吞吐能力。
3.Kafka Stream:
可以轻松地将其嵌入任何Java应用程序中,并与用户为其流应用程序所拥有的任何现有打包,部署和操作工具集成。
4. Flink
对于热点计算这种典型场景,Flink 是很多大厂的选择:
-
优势:毫秒级延迟、强大的 Window API 和状态后端(RockDB)、丰富的 Connectors(Kafka→Flink→Redis/Phoenix)、CEP 复杂事件处理
-
劣势:集群运维成本高(JobManager HA、TaskManager 资源分配、Checkpoint 调优)
5. Redis Sorted Set 纯缓存方案
另一种思路:不在数据库层做热点计算,而是在 Redis 中维护实时评分:
-
用户行为事件直接 ZINCRBY article:hot:score {delta} {articleId}
-
查询时 ZREVRANGE article:hot:score:{channelId} 0 29
-
用 定时任务+Redis Lua 脚本 定时将 Top 文章快照到 hot_article_first_page_*
优势:O(log N) 时间复杂度、无数据库压力、天然支持增量更新
三、Kafka Stream
Kafka Stream是Apache Kafka从0.10版本引入的一个新Feature。它是提供了对存储于Kafka内的数据进行流式处理和分析的功能。
Kafka Stream的特点如下:
– Kafka Stream提供了一个非常简单而轻量的Library,它可以非常方便地嵌入任意Java应用中,也可以任意方式打包和部署
– 除了Kafka外,无任何外部依赖
– 充分利用Kafka分区机制实现水平扩展和顺序性保证
– 通过可容错的state store实现高效的状态操作(如windowed join和aggregation)
– 支持正好一次处理语义
– 提供记录级的处理能力,从而实现毫秒级的低延迟
– 支持基于事件时间的窗口操作,并且可处理晚到的数据(late arrival of records)
– 同时提供底层的处理原语Processor(类似于Storm的spout和bolt),以及高层抽象的DSL(类似于Spark的map/group/reduce)
1.关键概念
– 源处理器(Source Processor):源处理器是一个没有任何上游处理器的特殊类型的流处理器。它从一个或多个Kafka主题生成输入流。通过消费这些主题的消息并将它们转发到下游处理器。
– Sink处理器:sink处理器是一个没有下游流处理器的特殊类型的流处理器。它接收上游流处理器的消息发送到一个指定的Kafka主题。

两种处理器就类似于流式处理的入口和出口
2.KStream

KStream数据流(data stream),即是一段顺序的,可以无限长,不断更新的数据集。数据结构类似于map,key-value键值对。数据流中比较常记录的是事件,这些事件可以是一次鼠标点击(click),一次交易,或是传感器记录的位置数据。
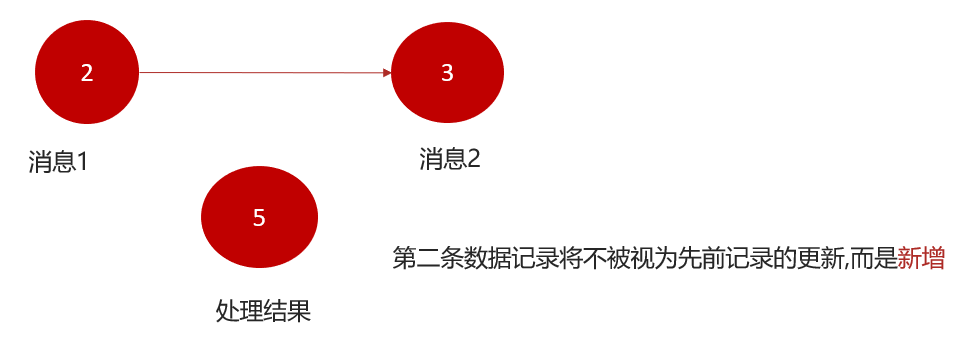
KStream负责抽象的,就是数据流。与Kafka自身topic中的数据一样,类似日志,每一次操作都是向其中插入(insert)新数据。
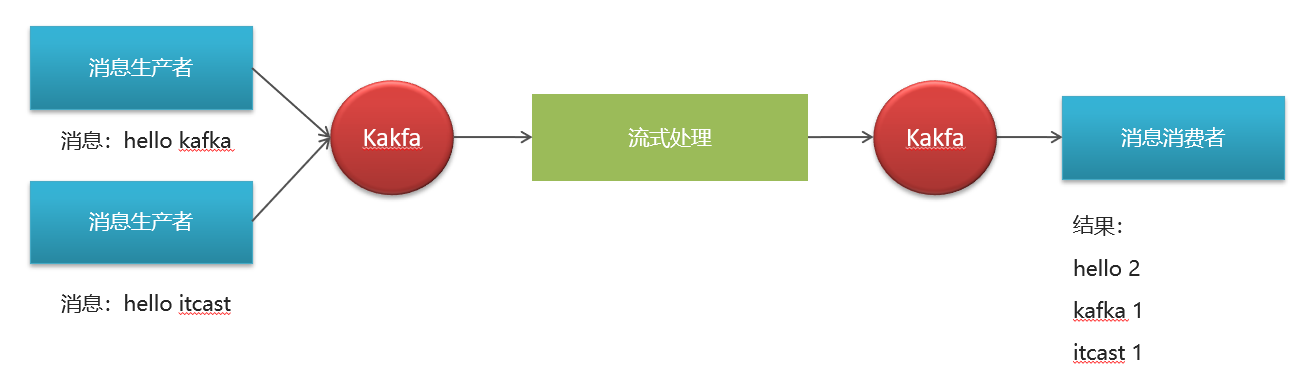
3.案例流程图
四、实时计算热点文章
1.完整链路
┌─────────────────────────────────────────────────────────────────────────────┐
│ Kafka Streams 实时计算完整链路 │
└─────────────────────────────────────────────────────────────────────────────┘
Step 1 Step 2 Step 3 Step 4
用户行为 Kafka Topic Kafka Streams Kafka Topic
事件触发 原始消息 窗口聚合 聚合结果
┌──────┐ hot.article. ┌─────────────┐ hot.article.
│ 点赞 │────┐ score.topic │ 10秒滚动窗口 │ incr.handle.
│ 阅读 │ │ ┌─────────────────┐ │ groupByKey │ topic
│ 评论 │────┼──▶ │ articleId:A │ │ aggregate() │───▶┌──────────┐
│ 收藏 │ │ │ likes:1 │ │ │ │ articleId │
└──────┘ │ │ articleId:B │ │ 初始化: │ │ COLLECTION│
│ │ views:1 │ │ 0,0,0,0 │ │ COMMENT │
┌───────┐ │ └─────────────────┘ │ │ │ LIKES │
│行为服务 │──┘ │ 累加聚合: │ │ VIEWS │
│Service │ │ 窗口内增量 │ └────┬─────┘
└───────┘ │ 叠加 │ │
└─────────────┘ │ Step 5
┌────▼─────────┐
Step 6 │ KafkaListener│
Redis缓存更新 │ 消费聚合结果 │
┌──────────────────────────────────────────────────────────────┴───────────┐
│ replaceDataToRedis() — 增量更新热点文章缓存列表 (Top30) │
└────────────────────────────────────────────────────────────────────────┘
┌──────────────────────┐
│ Redis │
│ hot_article_ │
│ first_page_{chId} │
│ [HotArticleVo, …] │
└──────────────────────┘
2.用户行为事件触发
用户产生行为(点赞、收藏、阅读、评论)后,对应的 Behavior 服务构建 UpdateArticleMess 并发送到 Kafka。
以点赞行为为例:
@Service
public class ApLikesBehaviorServiceImpl implements ApLikesBehaviorService {
@Autowired
private KafkaTemplate<String,String> kafkaTemplate;
@Override
public ResponseResult like(LikesBehaviorDto dto) {
// operation=0 表示点赞(新增), operation=1 表示取消点赞
UpdateArticleMess mess = new UpdateArticleMess();
mess.setArticleId(dto.getArticleId());
mess.setType(UpdateArticleMess.UpdateArticleType.LIKES);
if (dto.getOperation() == 0) {
// 保存点赞记录到 Redis
cacheService.hPut("LIKE-BEHAVIOR-" + …, …);
mess.setAdd(1);
} else {
// 取消点赞
cacheService.hDelete("LIKE-BEHAVIOR-" + …, …);
mess.setAdd(-1);
}
// 发送消息到 Kafka 进行聚合
kafkaTemplate.send(HotArticleConstants.HOT_ARTICLE_SCORE_TOPIC,
JSON.toJSONString(mess));
return ResponseResult.okResult(AppHttpCodeEnum.SUCCESS);
}
}
3.消息进入 Topic
消息进入 hot.article.score.topic,每条消息的结构是:(依旧是以点赞为例,add > 0是点赞, add < 0是取消赞)
Key: (未指定,使用默认分区策略)
Value: {"articleId": 12345, "type": "LIKES", "add": 1}
4.Kafka Streams 窗口聚合
HotArticleStreamHandler 中的流处理拓扑:
@Configuration
public class HotArticleStreamHandler {
@Bean
public KStream<String,String> kStream(StreamsBuilder streamsBuilder){
KStream<String,String> stream = streamsBuilder
.stream(HotArticleConstants.HOT_ARTICLE_SCORE_TOPIC);
stream
// ====== ① Map 转换:提取 articleId 作为 Key ======
.map((key, value) -> {
UpdateArticleMess mess = JSON.parseObject(value, UpdateArticleMess.class);
// 重置 key 为 articleId,value 转为 "LIKES:1" 格式
return new KeyValue<>(mess.getArticleId().toString(),
mess.getType().name() + ":" + mess.getAdd());
})
// ====== ② GroupBy 按文章ID分组 ======
.groupBy((key, value) -> key)
// ====== ③ 时间窗口:10秒滚动窗口 ======
.windowedBy(TimeWindows.of(Duration.ofSeconds(10)))
// ====== ④ 聚合:初始化 + 增量累加 ======
.aggregate(
() -> "COLLECTION:0,COMMENT:0,LIKES:0,VIEWS:0", // 初始状态
(key, value, aggValue) -> {
// value = "LIKES:1" aggValue = "COLLECTION:0,COMMENT:0,LIKES:0,VIEWS:0"
// 解析当前窗口聚合值,按类型累加
// 最终返回 "COLLECTION:0,COMMENT:0,LIKES:1,VIEWS:0"
},
Materialized.as("hot-atricle-stream-count-001")
)
// ====== ⑤ 窗口结束后输出 ======
.toStream()
.map((key, value) -> new KeyValue<>(key.key().toString(),
formatObj(key.key().toString(), value)))
// ====== ⑥ 发送到增量处理 Topic ======
.to(HotArticleConstants.HOT_ARTICLE_INCR_HANDLE_TOPIC);
return stream;
}
}
时间窗口机制说明:每 10 秒为一个窗口,窗口结束后输出该窗口内所有文章的聚合结果(点赞增量 + 阅读增量 + 评论增量 + 收藏增量)。窗口是滚动窗口( Tumbling Window),不重叠。

5.Topic 聚合结果消息
流式处理结束再次进入Topic,数据结构如下:
Key: articleId (字符串)
Value: {"articleId":12345, "view":5, "collect":2, "comment":1, "like":3}
这是 10 秒时间窗口内该文章所有行为增量数据的聚合结果。
6.KafkaListener 消费聚合结果
@Component
public class ArticleIncrHandleListener {
@Autowired
private ApArticleService apArticleService;
@KafkaListener(topics = HotArticleConstants.HOT_ARTICLE_INCR_HANDLE_TOPIC)
public void onMessage(String mess){
ArticleVisitStreamMess articleVisitStreamMess = JSON.parseObject(mess,
ArticleVisitStreamMess.class);
apArticleService.updateScore(articleVisitStreamMess);
}
}
监听Topic消息,直接调用apArticleService方法消费结果。
7.增量更新 Redis 热点缓存
具体消费逻辑除了更新数据库行为数据,再就是增量更新Redis热点缓存了。
public void updateScore(ArticleVisitStreamMess mess) {
// 1. 增量更新文章行为数据(阅读/点赞/收藏/评论的绝对值)
ApArticle apArticle = updateArticle(mess);
// 2. 计算分值(与 HotArticleServiceImpl 相同的权重公式)
Integer score = computeScore(apArticle);
score = score * 3; // 注:此处 ×3,与批量重算略有差异(批量重算未乘系数)
// 3. 替换更新 Redis 中该频道的热点列表
replaceDataToRedis(apArticle, score,
ArticleConstants.HOT_ARTICLE_FIRST_PAGE + apArticle.getChannelId());
// 4. 替换更新 Redis 中全局推荐的热点列表
replaceDataToRedis(apArticle, score,
ArticleConstants.HOT_ARTICLE_FIRST_PAGE + ArticleConstants.DEFAULT_TAG);
}
replaceDataToRedis() 的更新策略:
-
若文章已在缓存中 → 仅更新其分值
-
若文章不在缓存中:
-
缓存不足 30 条 → 直接加入
-
缓存已满 30 条 → 比较与第 30 名(分值最低)的分值,大于则替换,否则丢弃
-