🚀 MQ问题体系化总结(终极版)
在现代分布式系统中,消息队列(MQ)扮演着核心角色,它不仅用于解耦服务,还能提高系统的吞吐量和稳定性。然而,消息队列在带来便利的同时,也引入了可靠性、一致性、稳定性等方面的复杂问题。
为了保证系统在高并发、跨服务调用以及网络波动情况下的稳定运行,我们在经过对比多个消息中间件后,选择了 RabbitMQ 作为核心队列系统,并设计了一套完整的消息可靠性与容错方案。本方案旨在从消息丢失、数据不一致、系统稳定性等方面提升可靠性,实现用户体验良好的目标。
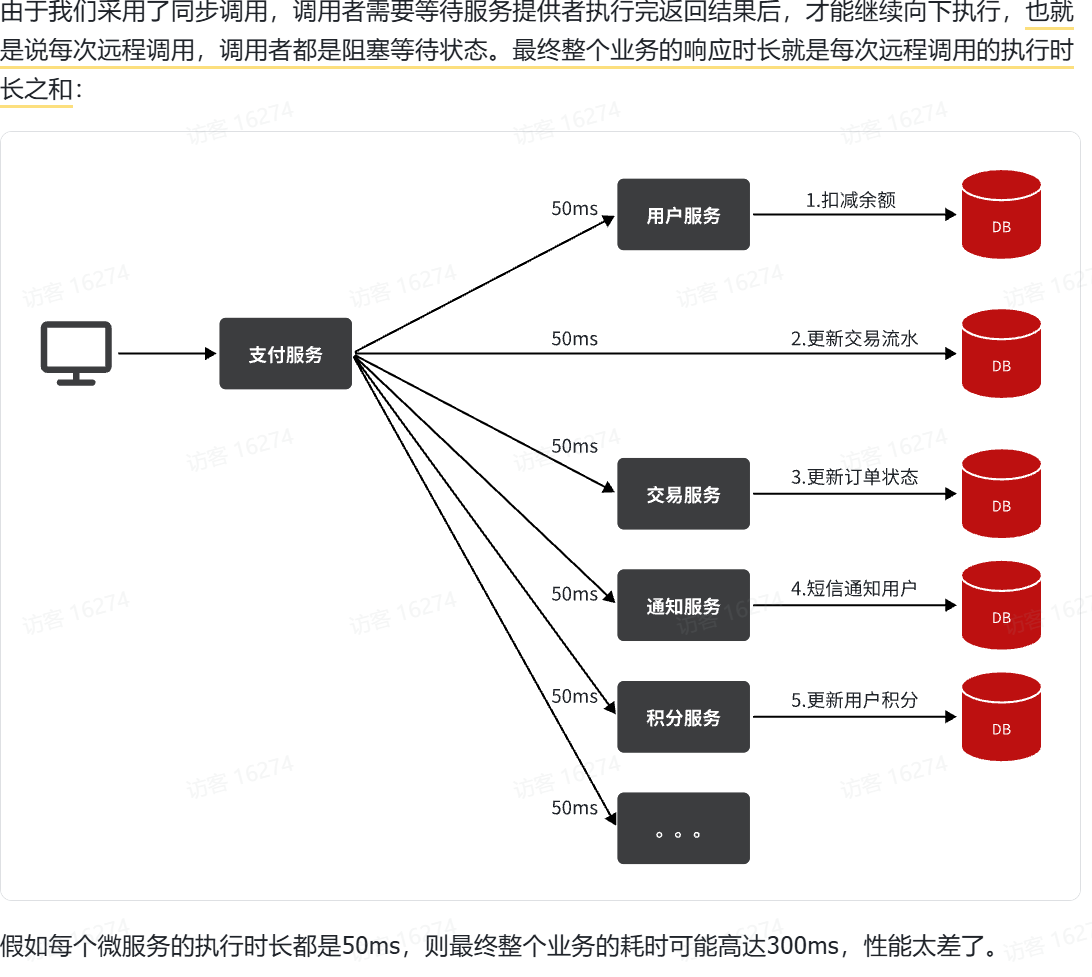
所以这里选用了队列进行优化(这里经过多个队列进行对比后,选择了RabbitMQ)
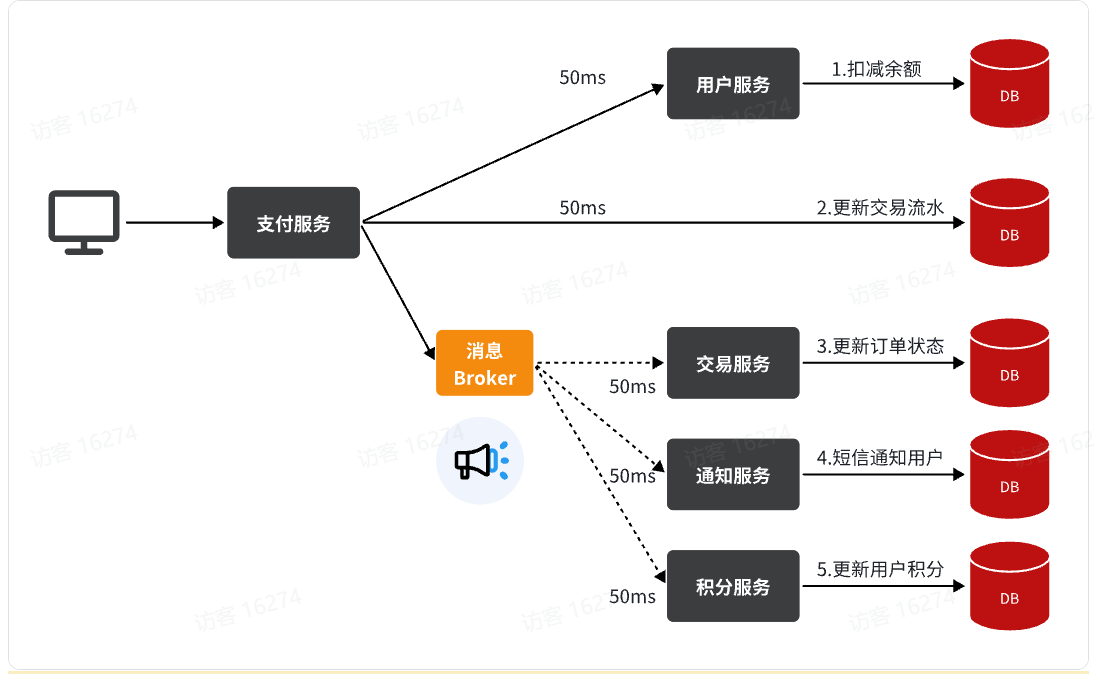
一、核心思路总结(总纲)
MQ本质解决三件事:
解耦、削峰、异步(同步:需要其他服务返回结果时使用,若不需要,则异步:线程发消息给队列,就离开了)
但引入了四大问题:
一致性、可靠性、系统稳定性、业务体验
最终通过:
重试 + 确认机制 + 持久化 + 幂等 + 补偿机制 + 延迟处理
实现:
高可靠系统 , 提升了用户体验
二.各个问题与应对思路
问题一:消息丢失(可靠性)
📌 问题
消息可能在任意环节丢失
📌 场景
1️⃣ 生产者阶段
- 连接MQ失败
- 未找到 Exchange(交换机)
- RoutingKey 错误 → 未找到 Queue(队列)
- 消息到达MQ但处理异常(如转换失败)
2️⃣ MQ阶段
- 消息已入队但MQ宕机
- 内存未持久化数据丢失
3️⃣ 消费者阶段
- 消费者宕机
- 业务处理异常
❗ 本质原因
生产者 → 网络 → MQ → 消费者
💡 思路
全链路保障消息不丢
🛠 解决方案
1️⃣ 生产者可靠性
(1)发送重试机制
- 网络失败自动重试
(2)生产者确认机制(核心)
一般我们推荐使用correlated,回调机制
RabbitMQ 消息发送回调情况表(按顺序)
| 1 | 消息发送成功 | ✅ | ✅ | 队列有空间 | ack = true | 不触发 | Confirm: ack=true, cause=null | 消息成功到达 Exchange 并成功路由到队列 |
| 2 | 交换机不存在 | ❌ | 任意 | 任意 | ack = false | 不触发 | Confirm: ack=false, cause="NO_EXCHANGE" | 消息未到 Exchange,无法路由 |
| 3 | 路由失败(RoutingKey 错误或无匹配队列) | ✅ | ❌ | 任意 | ack = true | 触发 | Confirm: ack=true, cause=nullReturn: replyCode=312, replyText=NO_ROUTE, message=原消息, exchange, routingKey | 消息到达 Exchange,但无法路由到队列 |
| 4 | 队列已满(reject-publish) | ✅ | ✅ | 队列满 | ack = true | 触发 | Confirm: ack=true, cause=nullReturn: replyCode≈312, replyText="QUEUE_FULL", message=原消息, exchange, routingKey | 消息到达 Exchange,但队列已满无法入队,触发 ReturnCallback |
| ConfirmCallback | 是否到达 MQ |
| ReturnCallback | 是否路由成功 |
2️⃣ MQ可靠性
数据持久化(三件套)
- Exchange:durable
- Queue:durable
- Message:persistent
1.缺一不可,否则MQ重启会丢数据
2.消息发送 → Broker 内存队列 → 写入磁盘(队列元数据 + 消息内容) → 返回 ack
Broker 宕机重启后消息依然存在
3️⃣ 消费者可靠性
(1)ACK机制(核心)
| none | ❌ | 直接丢 |
| auto | ✅ | 自动处理 |
| manual | ⚠️ | 灵活但复杂 |
auto模式:
| 正常执行 | ack |
| 业务异常 | nack(可重试) |
| 转换异常 | reject(丢弃) |
(2)消费者失败重试
- 本地重试,避免频繁打MQ(只在消费者端尝试几次,不立即打回 MQ)
(3)失败处理策略(高级)
| Reject | 丢弃 |
| Requeue | 重新入队 |
| Republish | 投递异常队列 |
推荐:
✅ RepublishMessageRecoverer → error.queue(传给人工处理)
4️⃣ 系统级兜底
补偿机制(最终保障)
- 定时任务查询
- 修复数据
✅ 结论
👉消息不丢 = 系统可靠性基础
问题二:数据不一致(核心问题)
📌 问题1
👉 多服务数据不一致
📌 场景
在支付服务中远程调用用户服务,和在本地(支付服务)更新流水(更新本地数据库)后,通过队列进行交易服务的过程中
- 用户支付成功 ✅
- MQ发送失败 ❌
- 订单仍显示未支付 ❗
❗ 本质原因
消息丢失 / 异步通信失败
💡 思路
不追求强一致 → 追求:
最终一致性
🛠 解决方案
1️⃣ MQ可靠性(基础)
- 保证消息尽量成功送达
2️⃣ 补偿机制(兜底)
- 定时任务校验数据
- 主动修复
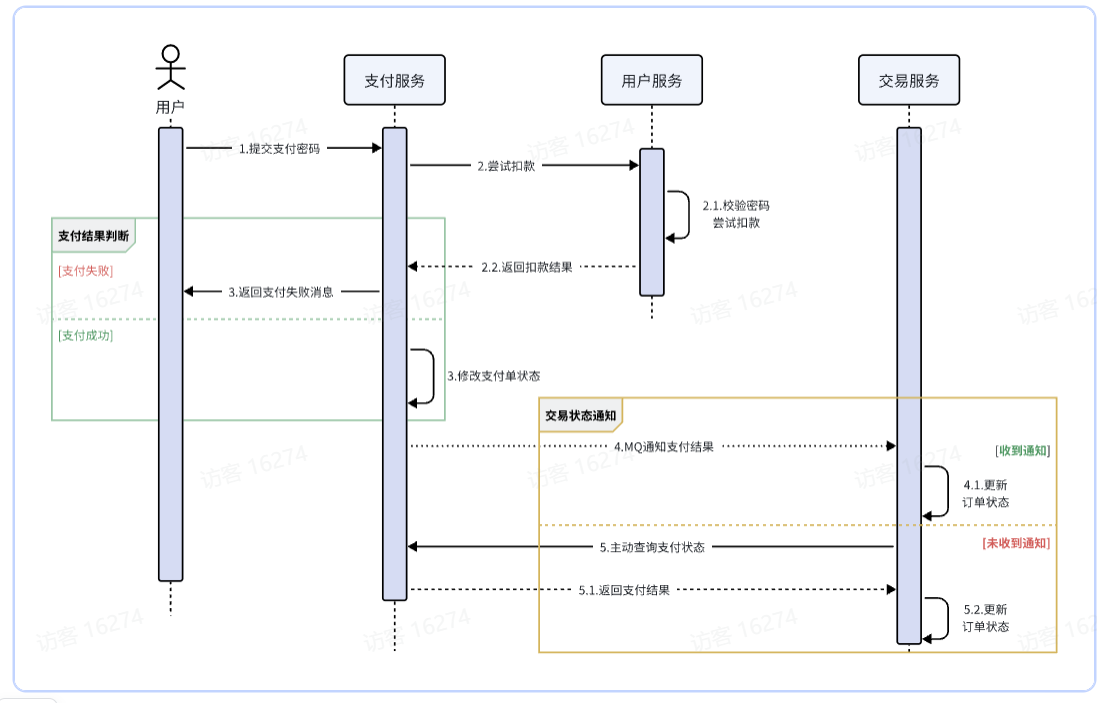
图中黄色线圈起来的部分就是MQ通知失败后的兜底处理方案,由交易服务自己主动去查询支付状态。
不过需要注意的是,交易服务并不知道用户会在什么时候支付,如果查询的时机不正确(比如查询的时候用户正在支付中),可能查询到的支付状态也不正确。
那么问题来了,我们到底该在什么时间主动查询支付状态呢?
这个时间是无法确定的,因此,通常我们采取的措施就是利用定时任务定期查询,例如在我们发起支付成功的消息到队列后,每隔20秒就查询一次,并判断支付状态。如果发现订单已经支付,则立刻更新订单状态为已支付即可。
📌 问题2
多服务数据不一致
📌 场景
- 由于队列因网络抖动没有收到返回消息则自动再一次消费
-
具体举例:
- 假如用户刚刚支付完成,并且投递消息到交易服务,交易服务更改订单为已支付状态。
- 由于某种原因,例如网络故障导致MQ和生产者没有得到确认,隔了一段时间后MQ重新将消息投递给交易服务。
- 但是,在新投递的消息被消费之前,用户选择了退款,将订单状态改为了已退款状态。
- 退款完成后,新投递的消息才被消费,那么订单状态会被再次改为已支付。业务异常。
❗ 本质原因
MQ保证:
At-Least-Once(至少一次)
不保证“只执行一次”
重复消费造成的
💡 思路
允许重复,但结果必须一致
🛠 解决方案
1️⃣ 业务幂等(推荐)
1️。唯一消息ID
- 去重处理
- 思路:
- 每一条消息都生成一个唯一的id,与消息一起投递给消费者。
- 消费者接收到消息后处理自己的业务,业务处理成功后将消息ID保存到数据库
- 如果下次又收到相同消息,去数据库查询判断是否存在,存在则为重复消息放弃处理。
2.利用状态控制执行
1. 例如我们当前案例中,处理消息的业务逻辑是把订单状态从未支付修改为已支付。因此我们就可以在执行业务时判断订单状态是否是未支付,如果不是则证明订单已经被处理过,无需重复处理。(也就是说只要不是未支付(如支付,退款),都无需处理)
2.相比较而言,消息ID的方案需要改造原有的数据库,所以我更推荐使用业务判断的方案。
update order
set status = 2
where id = ? and status = 1
2️⃣补偿机制(兜底)
- 定时任务校验数据
- 主动修复
✅ 结论
一致性 = 可靠性 + 幂等性 + 补偿机制
问题三:系统稳定性(抗压能力)
📌 问题
系统被压垮 / MQ内存爆
📌 场景
- 秒杀流量
- 消费速度慢
- 消息堆积
❗ 本质原因
生产速度 > 消费速度
💡 思路
控制资源 + 防堆积
🛠 解决方案
1️⃣ Lazy Queue(核心)
- 消息直接落磁盘
- 避免内存爆炸
2️⃣ 扩容消费者
- 提高处理能力
3️⃣ 限流 / 削峰
- 控制生产速度
✅ 结论
👉 稳定性 = 系统在高压下不崩
问题四:业务体验问题(延迟处理)
📌 问题
用户占资源但不释放,感觉也属于不一致问题
📌 场景
- 下单不支付
- 库存被锁死
❗ 本质原因
资源未及时释放,特别是在秒杀订单中,如果一个人订单扣除,但未支付,会影响其他用户的体验
💡 思路
延迟处理
🛠 解决方案
补偿机制
1️⃣ 延迟消息
- TTL + 死信队列
- 延迟插件(推荐)
2️⃣ 超时取消订单
- 查询支付状态
- 未支付 → 关闭订单 + 恢复库存
在我们发起下单成功的消息到队列后,每隔15分钟就查询一次,并判断支付状态。如果发现订单未支付,则关闭订单,恢复缓存
✅ 结论
👉 延迟机制 = 提升用户体验关键
八、终极关系图(理解本质)
用户体验
|
可靠性
|
消息不丢性 一致性 稳定性
(数据不丢) (数据正确) (系统不崩)
│ |
│ │
│ ┌──────────┐
│ │ │
│ 幂等性 补偿机制
│ (防重复) (兜底修复
│ |
│───────——→
│ (有利于作为一致性的基础)
│
└──────────异常处理能力──────────┘
│
业务性(业务约束)
(状态判断 / 业务规则)
这些属性的关系是:
- 可靠性(用户体验好) = 总目标
- 一致性 = 结果正确
- 消息不丢 = 基础保障
-
稳定性 = 系统不挂
- 异常处理能力 = 支撑手段