✅ 博主简介:擅长数据搜集与处理、建模仿真、程序设计、仿真代码、论文写作与指导,毕业论文、期刊论文经验交流。
✅成品或者定制,扫描文章底部微信二维码。
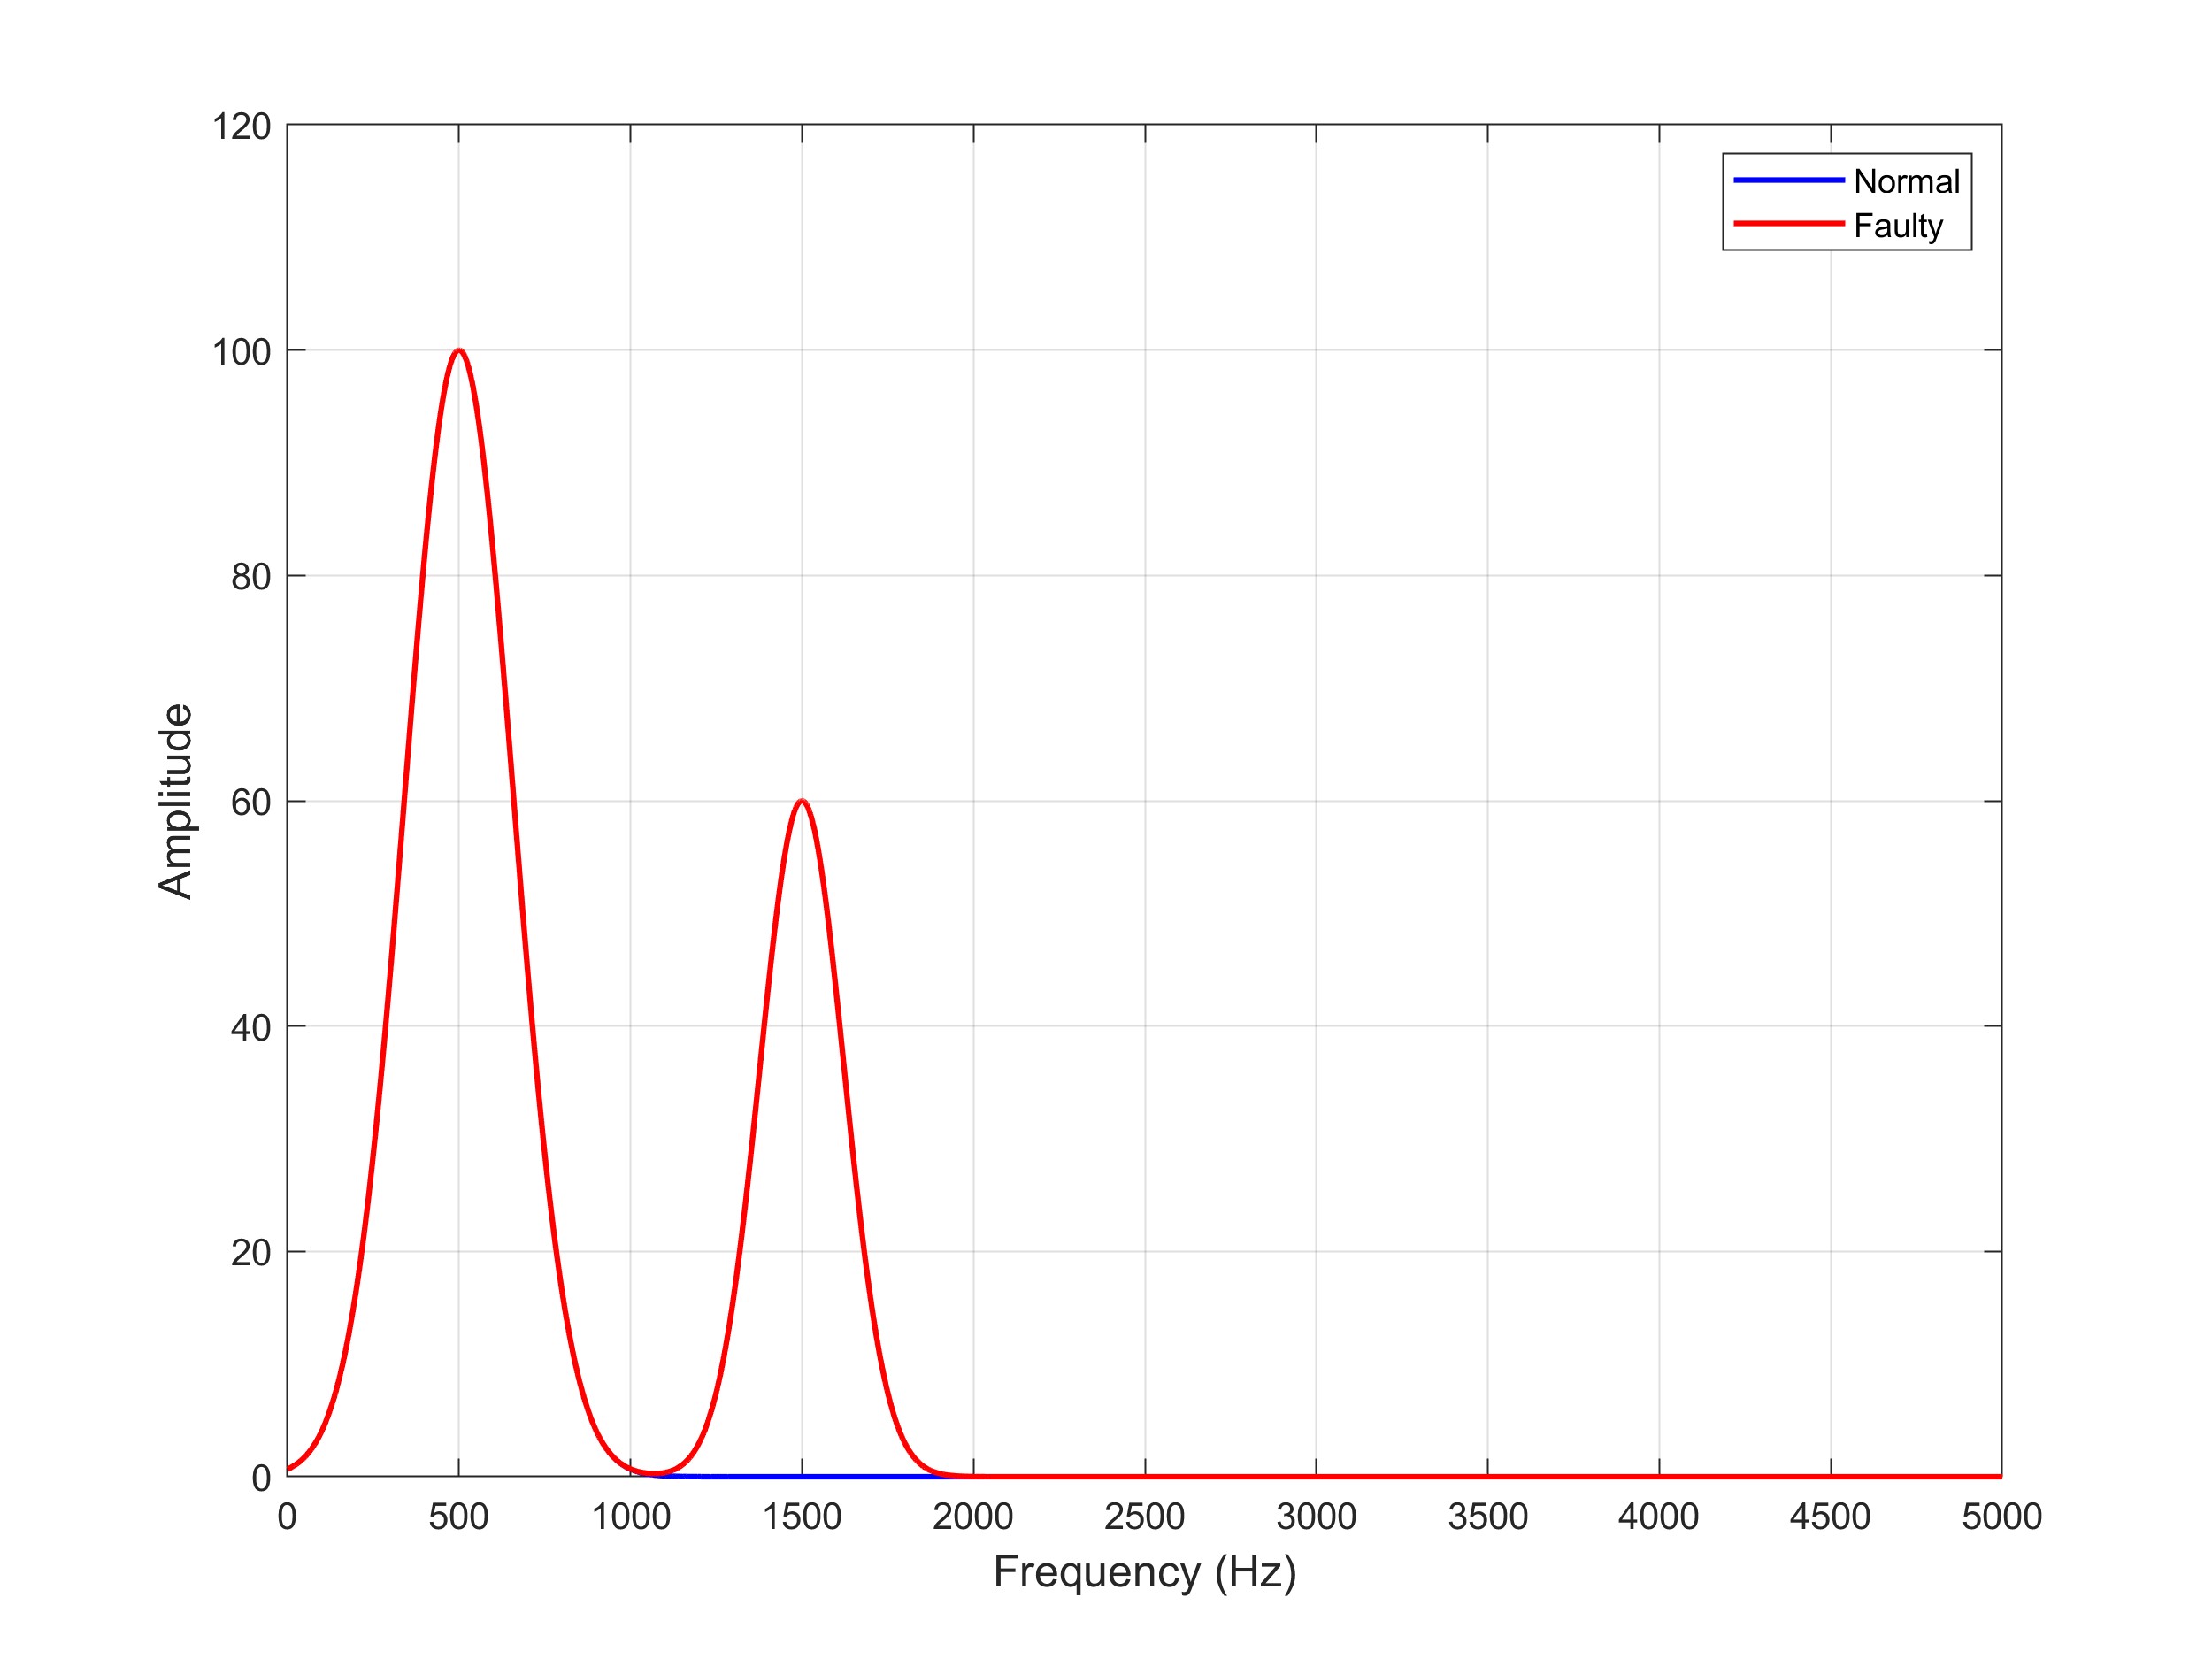
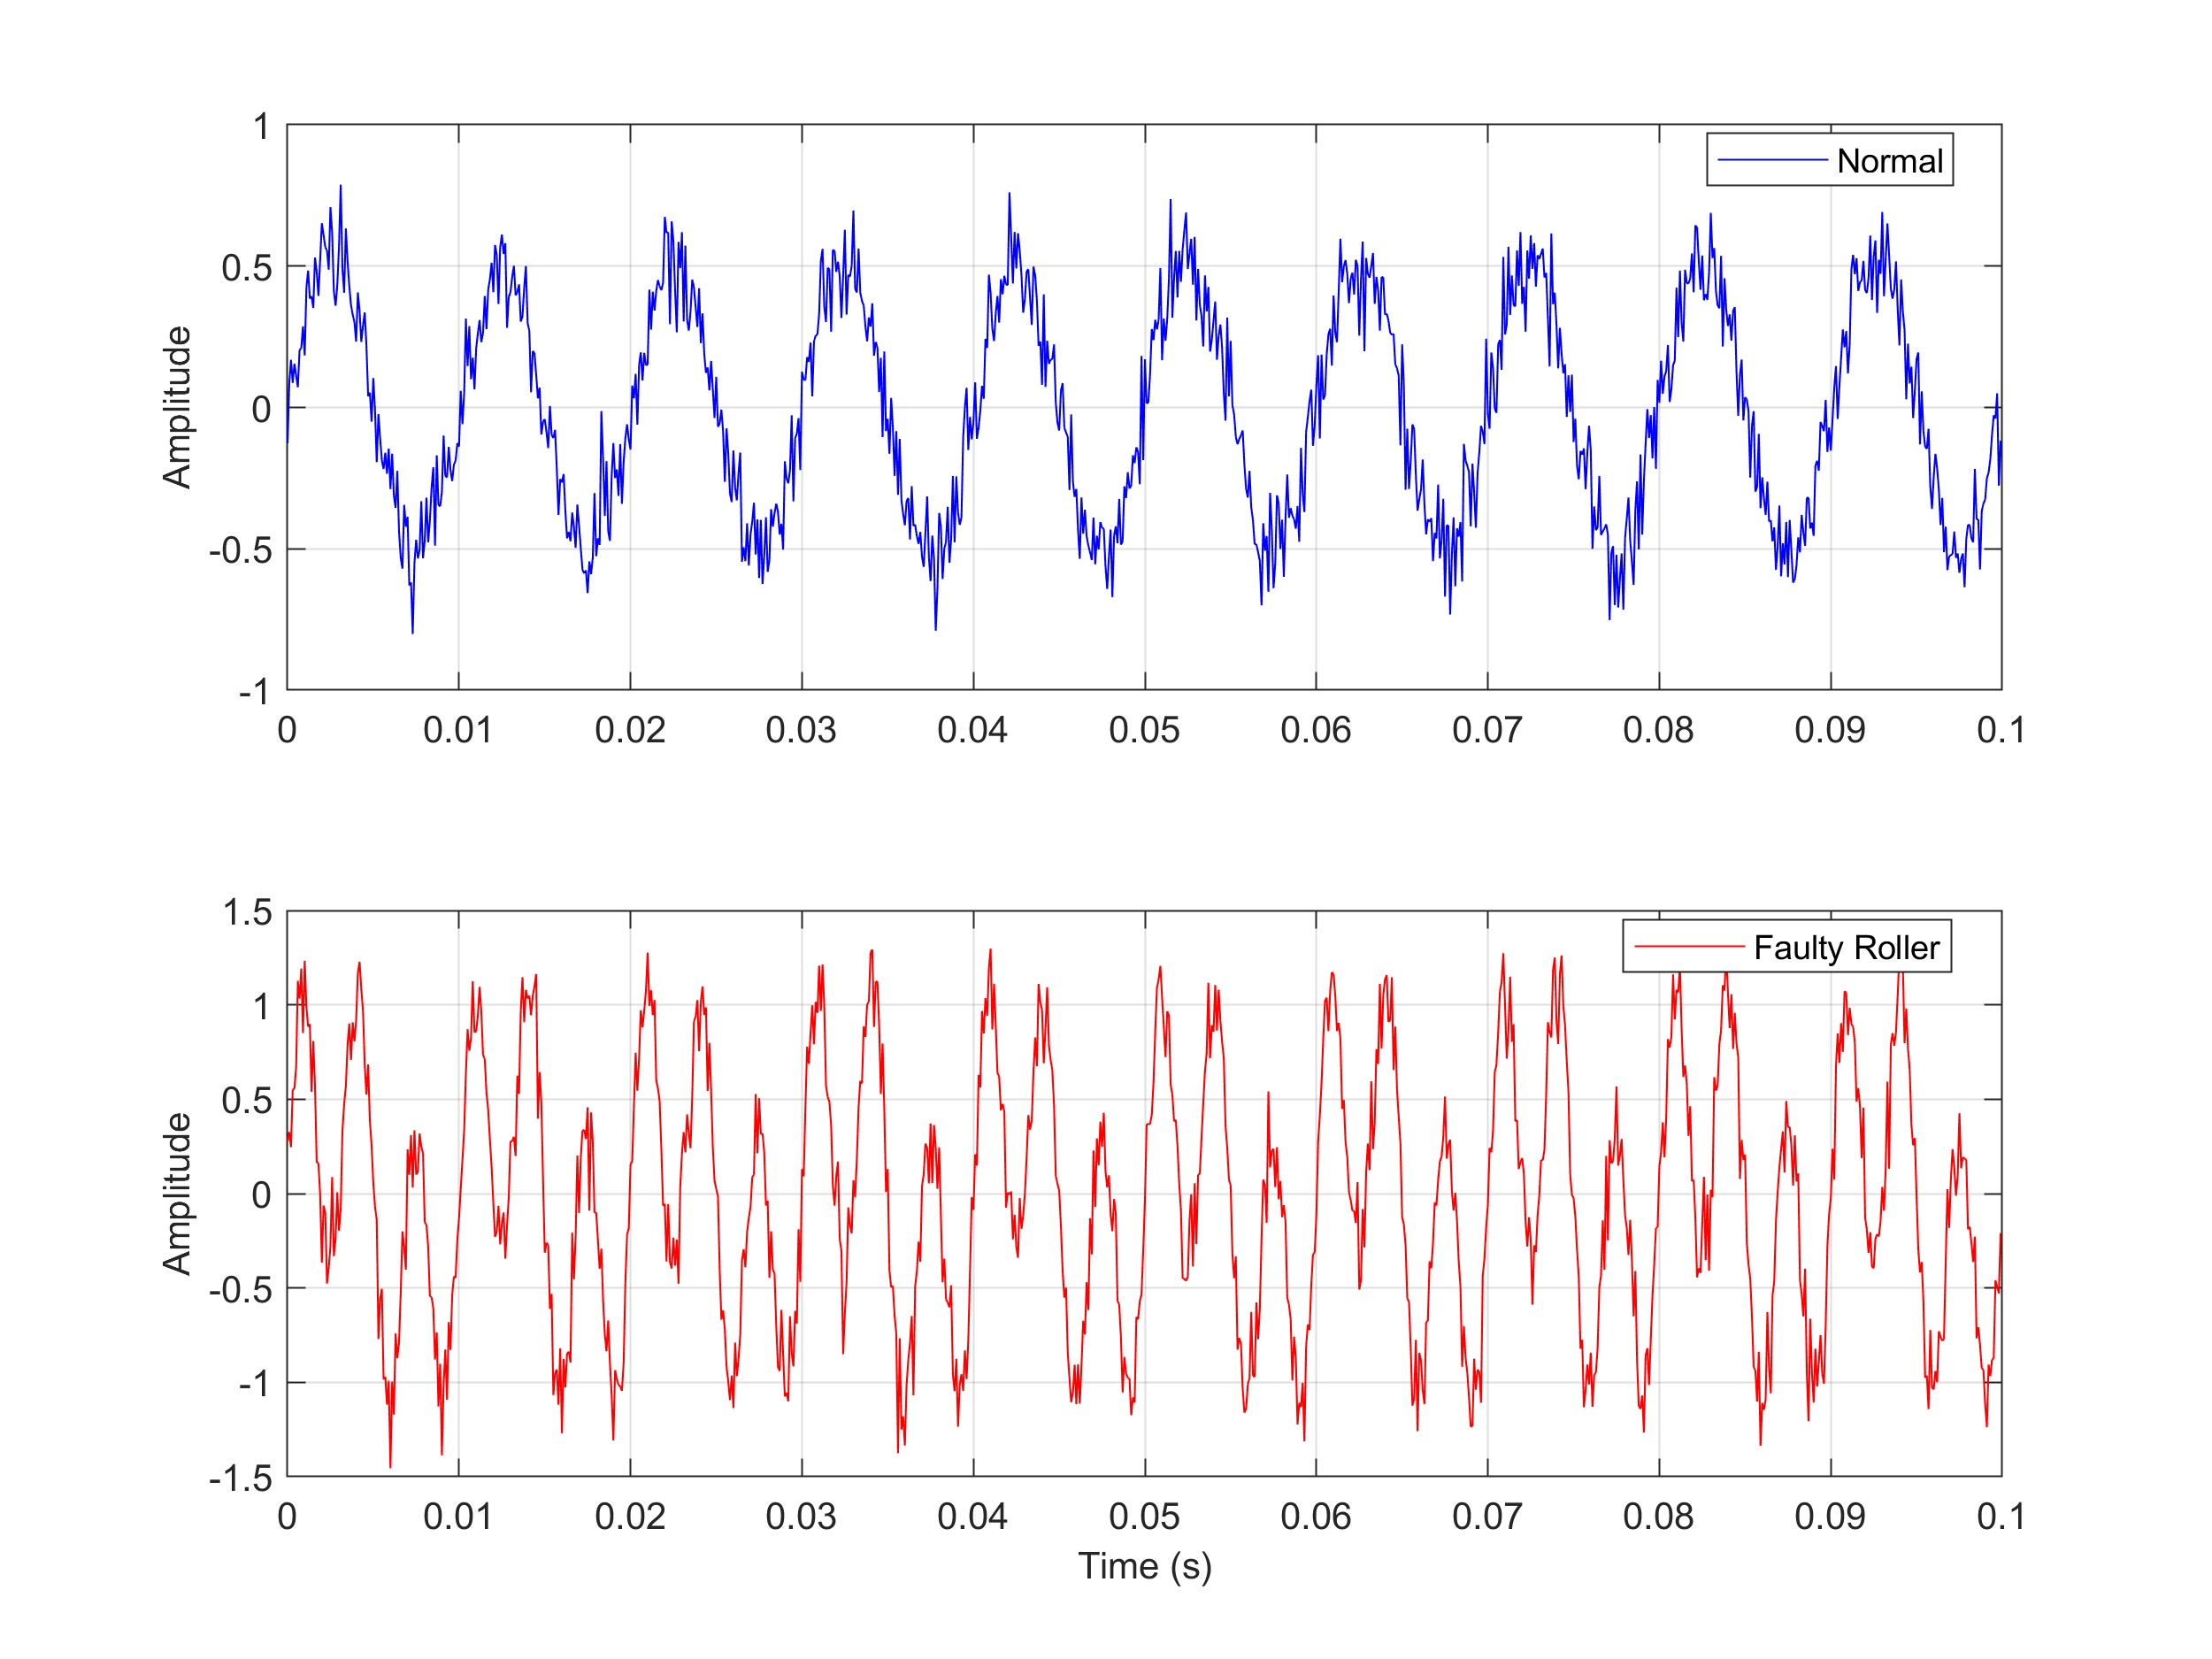
(1) 探究滚轮失效特征与声波传播原理并构建实验平台 煤矿运输带系统中的滚轮是支撑输送带并减少摩擦的关键元件,在恶劣的地下环境中容易受到尖锐物体撞击和高负荷运转的影响,导致频繁出现轴承磨损、密封失效或变形等问题。这些故障不仅会增加系统阻力,还可能引发链式反应影响整体运输效率。为了有效捕捉这些问题,本研究首先深入分析滚轮的典型失效模式,包括内部轴承的振动异常和外部壳体的裂纹扩展,通过时域信号的峰值波动和频域谱的谐波分布来表征故障特征。同时,考察声波在运输带结构中的传播路径,考虑到金属框架的反射和煤尘介质的吸收衰减,建立了一个完整的声波故障诊断框架。这个框架强调从信号采集到特征提取的连续流程,为后续精准识别提供坚实基础。在此基础上,设计并搭建了一个模拟煤矿环境的实验平台,使用麦克风阵列和振动传感器采集多组滚轮正常与故障状态下的声波数据。实验数据分析显示,故障滚轮的声波信号在低频段表现出明显的能量集中,而高频段则出现杂散峰值,这为区分不同失效类型奠定了数据支撑。通过多次迭代实验,优化了传感器布置位置,确保在噪声干扰下的信号纯度,提高了诊断的可靠性。这一方法的优势在于其非侵入性,能够在不拆卸设备的情况下实时监测,适用于地下狭窄空间的操作需求。在实际应用中,这种特征探究有助于提前预警潜在故障,避免突发停机带来的经济损失。进一步扩展,该平台还整合了温度监测模块,以辅助验证声波信号与热异常的相关性,确保诊断的多模态融合。总体而言,这一阶段的研究为滚轮故障的声学表征提供了理论指导,并通过实验验证了其可行性,推动了从被动维修向主动预测的转变。 (2) 基于多层信息融合的声波数据降维策略以提升故障分类精度 面对声波监测产生的大量高维数据,传统处理方法往往因维度灾难而导致分类准确率下降,本研究提出一种创新的降维技术,通过融合多种维度信息来优化数据结构。首先,引入距离度量和分布统计的双重融合机制,更精确地捕捉样本间的内在关联,避免单一指标的偏差。其次,采用自适应邻域调整算法,根据数据密度动态定义局部范围,确保在稀疏或密集区域的均衡处理。然后,通过权重优化过程细化降维矩阵的重构参数,提升算法对原始信号的保真度。这种方法应用于运输带滚轮的声波信号后,能有效压缩冗余特征,同时保留故障相关的关键模式,如周期性冲击的频谱签名。在比较实验中,与传统主成分分析和局部线性嵌入等方法对照,所提策略在降维后的分类任务中表现出色,故障识别率提升了显著百分比。这不仅缓解了数据冲击对计算资源的压力,还增强了在实时诊断中的实用性。进一步,该降维技术可扩展到其他机械故障监测领域,如齿轮箱振动分析,提供了一个通用框架。在煤矿场景下,考虑到粉尘和湿度干扰,该方法加入了预滤波步骤,以增强鲁棒性。实验结果证实,在模拟高负载工况下,降维后数据能更好地支持支持向量机或神经网络的分类,实现轴承断裂、润滑不足等典型滚轮故障的精准区分。这一创新显著降低了误报率,为安全运输提供了技术保障。通过多次数据集验证,该策略的稳定性得到确认,适用于变速运转的复杂环境。 (3) 自适应异步采样结合动态神经网络的滚轮位置定位方案 滚轮数量庞大且分布在长距离运输带上,复杂环境下的移动检测往往面临噪声和同步难题,本研究开发了一种新型定位方法,以提升故障源的精确锁定。首先,构建自适应异步测量模型,利用动态截断范数处理声波矩阵,强化故障信号的时空分辨率,减少采集移动性和回响干扰的影响。随后,设计了一个多分支动态卷积神经网络架构,能够自适应提取深层特征,如声波传播延迟和幅度衰减,建立从声场数据到故障位置的映射关系。这种网络通过并行分支处理不同尺度信息,确保在噪声背景下的特征鲁棒性。模拟数据测试显示,该方法能准确定位虚拟故障点,误差控制在厘米级。实际实验平台验证进一步证明,在引入人工噪声后,定位精度仍保持高水平,最大偏差不超过合理阈值。这一方案的优势在于其灵活性,可适应不同运输带长度和滚轮间距的配置。在煤矿应用中,集成GPS辅助模块可增强户外段的定位准确性,避免手动巡检的危险。总体,该定位技术不仅提高了响应速度,还降低了维护成本,通过实时反馈指导维修团队直达问题区域。扩展而言,它可与其他传感器融合,如红外成像,形成多模态定位系统。实验迭代中,优化了网络训练参数,确保在有限样本下的泛化能力。这一方法的实施标志着从粗略区域检测向精确点位诊断的进步,为大规模机械系统的健康管理提供了新路径。
import numpy as np
import scipy.signal as signal
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.manifold import LocallyLinearEmbedding
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
def generate_fault_signal(length=1000, fault_freq=50, noise_level=0.5):
t = np.linspace(0, 1, length)
signal_clean = np.sin(2 * np.pi * 10 * t) + 0.5 * np.sin(2 * np.pi * fault_freq * t)
noise = noise_level * np.random.randn(length)
return signal_clean + noise
def multi_fusion_metric(data, alpha=0.5):
dist = np.linalg.norm(data[:, None] – data[None, :], axis=-1)
dist_distrib = np.std(dist, axis=1)
fused = alpha * dist + (1 – alpha) * dist_distrib[:, None]
return fused
def adaptive_neighbor_selection(data, min_k=5, max_k=20):
densities = np.mean(np.linalg.norm(data[:, None] – data[None, :], axis=-1), axis=1)
k_values = np.clip(min_k + (max_k – min_k) * (densities – densities.min()) / (densities.max() – densities.min()), min_k, max_k).astype(int)
neighbors = [np.argsort(np.linalg.norm(data – data[i], axis=1))[1:k+1] for i, k in enumerate(k_values)]
return neighbors
def weight_optimization(recon_weights, data):
for i in range(len(data)):
recon_weights[i] = recon_weights[i] / np.sum(recon_weights[i])
return recon_weights
def custom_dimensionality_reduction(data, n_components=2):
fused_dist = multi_fusion_metric(data)
neighbors = adaptive_neighbor_selection(data)
recon_weights = np.zeros((len(data), len(data)))
for i, nbrs in enumerate(neighbors):
Z = data[nbrs] – data[i]
C = Z @ Z.T
recon_weights[i, nbrs] = np.linalg.solve(C + 1e-6 * np.eye(len(nbrs)), np.ones(len(nbrs)))
recon_weights = weight_optimization(recon_weights, data)
M = np.eye(len(data))
for i in range(len(data)):
w = recon_weights[i]
M -= w[:, None] @ w[None, :]
eigvals, eigvecs = np.linalg.eig(M)
idx = np.argsort(eigvals)[1:n_components+1]
reduced = eigvecs[:, idx].T @ data.T
return reduced.T
class DynamicConvBlock(nn.Module):
def __init__(self, in_channels, out_channels):
super().__init__()
self.conv1 = nn.Conv1d(in_channels, out_channels, kernel_size=3, padding=1)
self.conv2 = nn.Conv1d(out_channels, out_channels, kernel_size=5, padding=2)
self.bn = nn.BatchNorm1d(out_channels)
self.relu = nn.ReLU()
def forward(self, x):
out1 = self.conv1(x)
out2 = self.conv2(x)
return self.relu(self.bn(out1 + out2))
class DynamicCNN(nn.Module):
def __init__(self, input_size, num_classes):
super().__init__()
self.block1 = DynamicConvBlock(1, 32)
self.block2 = DynamicConvBlock(32, 64)
self.pool = nn.MaxPool1d(2)
self.fc = nn.Linear(64 * (input_size // 4), num_classes)
def forward(self, x):
x = x.unsqueeze(1)
x = self.block1(x)
x = self.pool(x)
x = self.block2(x)
x = self.pool(x)
x = x.view(x.size(0), -1)
return self.fc(x)
def train_model(model, train_loader, epochs=10):
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)
for epoch in range(epochs):
for data, labels in train_loader:
optimizer.zero_grad()
outputs = model(data)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()
def generate_dataset(num_samples=100, length=1000):
data = np.array([generate_fault_signal(length, fault_freq=np.random.choice([20,50,100]), noise_level=0.3) for _ in range(num_samples)])
labels = np.random.randint(0, 3, num_samples)
return data, labels
data, labels = generate_dataset(200)
reduced_data = custom_dimensionality_reduction(data, 10)
X_train, X_test, y_train, y_test = train_test_split(reduced_data, labels, test_size=0.2)
model = DynamicCNN(10, 3)
train_dataset = TensorDataset(torch.tensor(X_train, dtype=torch.float32), torch.tensor(y_train, dtype=torch.long))
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
train_model(model, train_loader)
test_outputs = model(torch.tensor(X_test, dtype=torch.float32))
preds = torch.argmax(test_outputs, dim=1).numpy()
acc = accuracy_score(y_test, preds)
print(f'Accuracy: {acc}')
pca = PCA(n_components=2)
reduced_pca = pca.fit_transform(data)
lle = LocallyLinearEmbedding(n_components=2)
reduced_lle = lle.fit_transform(data)
clf_svc = SVC()
clf_svc.fit(X_train, y_train)
svc_preds = clf_svc.predict(X_test)
svc_acc = accuracy_score(y_test, svc_preds)
plt.figure()
plt.plot(data[0])
plt.title('Sample Fault Signal')
plt.show()
如有问题,可以直接沟通
👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇