IF-09 AURIX TC3xx DMA直接内存访问 – 从原理到实战
【IF-09】AURIX TC3xx DMA直接内存访问 – 从原理到实战
📋 本文思维导图

一、DMA概述:为什么汽车MCU需要DMA?
1.1 DMA的定义与核心价值
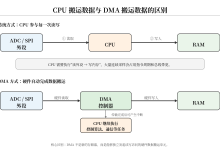
直接内存访问(Direct Memory Access,DMA) 是一种允许外设设备直接与系统内存进行数据交换的技术,无需CPU的介入。在传统的数据传输模式中,CPU需要亲自参与每一个字节的读写操作:
// 传统CPU轮询方式读取ADC数据
while (!(ADC->SR & ADC_EOC)) {} // 等待转换完成
uint32_t data = ADC->RESULT; // CPU读取数据
buffer[i++] = data; // CPU存储到缓冲区
这种方式最大的问题在于:CPU被大量琐碎的数据搬运工作所占据,无法专注于高价值的计算和控制任务。对于AURIX TC3xx这样的高性能汽车MCU而言,CPU的每一个时钟周期都非常宝贵,特别是在实时性要求极高的动力总成控制和ADAS系统中。
DMA的核心价值体现在三个方面:
| CPU占用 | 100%(数据传输期间) | 0%(仅配置和中断处理) | 释放CPU资源 |
| 传输效率 | 受CPU频率限制 | 独立总线并行传输 | 吞吐量提升3-10倍 |
| 实时响应 | 中断频繁,延迟不确定 | 可配置双缓冲流水线 | 确定性延迟 |
| 功耗 | CPU持续活跃 | CPU可进入低功耗模式 | 降低30-50% |
1.2 AURIX TC3xx DMA特性概览
英飞凌AURIX TC3xx系列微控制器的DMA控制器是一个高速、灵活的多通道直接内存访问引擎,专门为汽车电子的严苛需求设计:
AURIX TC3xx DMA关键特性
├── 通道数量:最多128个独立DMA通道(TC39X)
├── 交易控制集(TCS):每通道8×32位寄存器
├── 移动引擎(ME):多个并行执行引擎
├── 总线接口:SRI高速总线 + SPB外设总线
├── 传输宽度:8/16/32/64/128/256位可选
├── 寻址模式:线性递增、循环缓冲、地址回绕
├── 触发方式:软件、硬件、菊花链、自动启动
├── 链表模式:常规链表、累积链表、安全链表、条件链表
├── 资源分区:支持多RP隔离,符合功能安全
└── 数据校验:可选SDCRC/RDCRC校验
1.3 DMA在汽车电子中的应用场景
在AURIX TC3xx的实际应用中,DMA主要服务于以下场景:
1. 高速传感器数据采集
– EVADC转换结果传输:雷达/摄像头传感器的原始数据需要高速连续采集
– EDSADC音频数据流:麦克风阵列的实时音频数据采集
– 角度传感器数据:旋转变压器、解码器位置反馈
2. 通信协议数据吞吐
– UART/LIN串口数据收发:GPS、蓝牙、诊断接口的大容量缓冲
– SPI/QSPI高速数据传输:TFT显示屏刷新、大容量存储器访问
– CAN/CAN-FD报文缓冲:车载网络诊断数据的高速缓存
3. 实时数据处理流水线
– GTM定时器数据记录:发动机曲轴/凸轮轴角度事件捕获
– DMA链表实现环形缓冲:连续数据流的无缝处理
– 双缓冲实现Ping-Pong:实时系统的生产者-消费者模式
二、DMA体系架构深度解析
2.1 DMA控制器整体架构
AURIX TC3xx的DMA控制器采用层次化架构设计,从宏观视角可以划分为以下几个核心组件:
┌─────────────────────────────────────────────────────────────────┐
│ DMA Controller │
├─────────────────────────────────────────────────────────────────┤
│ ┌─────────────────────────────────────────────────────────┐ │
│ │ DMARAM (DMA RAM) │ │
│ │ ┌─────┐ ┌─────┐ ┌─────┐ ┌─────┐ │ │
│ │ │ CH0 │ │ CH1 │ │ CH2 │ … │ CHn │ │ │
│ │ │ TCS │ │ TCS │ │ TCS │ │ TCS │ │ │
│ │ └─────┘ └─────┘ └─────┘ └─────┘ │ │
│ └─────────────────────────────────────────────────────────┘ │
│ │ │
│ ▼ │
│ ┌─────────────────────────────────────────────────────────┐ │
│ │ Request & Arbitration Logic │ │
│ │ (硬件请求/软件请求/菊花链请求 仲裁) │ │
│ └─────────────────────────────────────────────────────────┘ │
│ │ │
│ ▼ │
│ ┌─────────────────────────────────────────────────────────┐ │
│ │ Move Engines (ME) │ │
│ │ ┌─────┐ ┌─────┐ ┌─────┐ ┌─────┐ │ │
│ │ │ ME1 │ │ ME2 │ │ ME3 │ │ MEn │ │ │
│ │ └─────┘ └─────┘ └─────┘ └─────┘ │ │
│ └─────────────────────────────────────────────────────────┘ │
│ │ │
│ ▼ │
│ ┌─────────────────────────────────────────────────────────┐ │
│ │ Bus Switch │ │
│ │ (根据地址路由到SRI或SPB总线) │ │
│ └─────────────────────────────────────────────────────────┘ │
│ │ │ │
│ ▼ ▼ │
│ ┌──────────────┐ ┌──────────────┐ │
│ │ SRI_MIF │ │ FPI_MIF │ │
│ │ (高速总线) │ │ (外设总线) │ │
│ └──────────────┘ └──────────────┘ │
└─────────────────────────────────────────────────────────────────┘
2.2 核心组件详解
2.2.1 DMARAM与交易控制集(TCS)
DMARAM(DMA Random Access Memory) 是DMA控制器内部的一块专用存储区域,用于保存各通道的交易控制集(Transaction Control Set,TCS)。
每个DMA通道在DMARAM中占用8×32位 = 256位 = 32字节的连续空间,这8个32位寄存器共同定义了DMA交易的所有参数:
| SADR | Source Address | 源地址指针,32位,指向DMA读操作的起始地址 |
| DADR | Destination Address | 目的地址指针,32位,指向DMA写操作的目标地址 |
| ADICR | Address Mode & Interrupt Control | 地址模式、链表配置、中断控制 |
| CHCFGR | Channel Configuration | 通道模式、触发类型、优先级配置 |
| SHADR | Shadow/Link Address | 阴影地址或链表下一TCS指针 |
| SMCR | Source Address Modification & Control | 源地址修改模式、循环缓冲配置 |
| DMCR | Destination Address Modification & Control | 目的地址修改模式、循环缓冲配置 |
| RDCR | Read/Write CRC Control | 读写数据校验配置 |
2.2.2 请求与仲裁逻辑
DMA通道的请求来源有三种:
1. 软件请求(Software Request)
// CPU直接写入CHCSR触发DMA
DMA_CH->CHCSR |= DMA_CHCSR_SETR_Msk; // 写入SETR位触发请求
2. 硬件请求(Hardware Request)
– 外设通过中断路由器(Interrupt Router) 发送请求信号
– 典型的硬件触发源包括:
– ADC转换完成标志
– UART接收FIFO半满
– SPI传输完成中断
– GTM定时器溢出
3. 菊花链请求(Daisy Chain Request)
– 当前通道传输完成后自动触发优先级更高的下一通道
– 实现多通道协同工作的自动流水线
仲裁原则:
– 通道号越高,优先级越高(Channel 127 > Channel 126 > … > Channel 0)
– 仲裁在每个Transfer结束后进行,而非每个Transaction结束后
– 高优先级通道可抢占低优先级通道的当前Transfer
2.2.3 移动引擎(Move Engine)
Move Engine是DMA的执行核心,负责:
1. 从源地址执行DMA Read Move(读取数据)
2. 将数据写入目的地址执行DMA Write Move(写入数据)
AURIX TC3xx配备多个并行Move Engine,支持真正的并行传输:
– 任意ME可以为任意DMA通道服务
– 通道127的请求优先被服务
– 多个ME可以同时处理不同通道的请求
2.2.4 总线开关与地址路由
Bus Switch 是DMA与系统总线的桥梁,它根据目标地址自动路由:
| DSPR(数据RAM) | SRI | <8MB/transaction |
| PSPR(程序RAM) | SRI | <8MB/transaction |
| PFLASH(程序Flash) | SRI | <8MB/transaction |
| LMU(本地存储单元) | SRI | <8MB/transaction |
| 外设寄存器(EVADC/UART/SPI等) | SPB | <1MB/transaction |
重要提示:跨总线传输(如SPB源 → SRI目的)会增加延迟,建议优先选择同总线数据传输以获得最佳性能。
三、DMA交易结构:Move/Transfer/Transaction三层模型
3.1 三层结构的本质

AURIX TC3xx的DMA数据传输采用分层结构,这是一个理解DMA行为的关键概念:
DMA Transaction (交易)
│
├── Transfer 1
│ ├── Move 1 (Read + Write)
│ ├── Move 2 (Read + Write)
│ ├── …
│ └── Move BLKM (Read + Write)
│
├── Transfer 2
│ ├── Move 1
│ ├── …
│ └── Move BLKM
│
└── Transfer N
├── Move 1
├── …
└── Move BLKM
3.1.1 DMA Move(移动)
定义:一个DMA Move由一次Read操作和一次Write操作组成,是最小的不可分割单元。
数据宽度:Move支持多种数据宽度,由TCS.CHCFGR.CHWD配置:
| 000 | 8-bit | 字节数据、字符流 |
| 001 | 16-bit | 半字数据、短整数 |
| 010 | 32-bit | 字数据、常规使用 |
| 011 | 64-bit | 双字、长整数 |
| 100 | 128-bit | 四字、SIMD优化 |
| 101 | 256-bit | 最大宽度高速传输 |
地址对齐要求:地址必须按照数据宽度对齐,否则可能导致传输错误或性能下降。
3.1.2 DMA Transfer(传输)
定义:若干个DMA Move组成一个Transfer,由BLKM(Block Move Count) 参数控制每个Transfer包含的Move数量。
可抢占性:Transfer执行期间可以被更高优先级的DMA通道抢占,这是实现实时系统公平调度的关键机制。
3.1.3 DMA Transaction(交易)
定义:完整的DMA传输任务,包含一个或多个Transfer,由TREL(Transfer Length) 参数控制总传输字节数。
3.2 关键参数计算公式
// 核心参数定义
uint16_t TREL; // 传输总长度(字节)
uint8_t BLKM; // 每个Transfer的Move数
uint8_t CHDW; // 数据宽度(字节数)
// 计算公式
uint32_t total_bytes = TREL; // 总字节数
uint32_t bytes_per_transfer = BLKM * CHDW; // 每Transfer字节数
uint32_t num_transfers = TREL / (BLKM * CHDW); // Transfer数量
uint32_t total_moves = num_transfers * BLKM; // Move总数
实际示例:
配置:TREL = 1024字节, BLKM = 4, CHDW = 32-bit (4字节)
结果:
– 每Transfer字节数 = 4 × 4 = 16字节
– Transfer数量 = 1024 / 16 = 64个
– Move总数 = 64 × 4 = 256个
3.3 仲裁时机与抢占机制
核心规则:DMA仲裁发生在每个Transfer结束后,而非每个Move或整个Transaction结束后。
时间轴:
Channel 127 (高优先级) ──┬──[Transfer1]──[Transfer2]──
│ ↑
│ 被Channel 64抢占
Channel 64 (低优先级) ──┴──────[Transfer1]─────────────
这种设计确保:
1. 低优先级通道不会完全饿死:每个Transfer后都有机会仲裁
2. 高优先级响应足够快:最多等待一个Transfer时间即可抢占
3. 系统整体吞吐最优:平衡了响应速度与公平性
四、TCS寄存器详解:从配置到实战
4.1 SADR与DADR:地址指针

SADR(Source Address Register) 和 DADR(Destination Address Register) 是DMA传输的地址基础:
typedef struct {
volatile uint32_t SADR; // 源地址 [31:0]
volatile uint32_t DADR; // 目的地址 [31:0]
// …
} DMA_Channel_t;
关键约束:
– 两个地址都是32位物理地址
– 必须按照CHDW配置的数据宽度对齐
– 地址在传输过程中会根据SMCR/DMCR配置自动修改
4.2 CHCFGR:通道配置寄存器
CHCFGR(Channel Configuration Register) 控制DMA通道的核心行为:
// CHCFGR字段定义
struct CHCFGR {
uint32_t CHMODE : 1; // [0] 通道模式:0=正常, 1=影子模式
uint32_t RROAT : 1; // [1] 读-读触发/自动触发
uint32_t : 2; // [2:3] 保留
uint32_t PR : 4; // [4:7] 触发源优先级
uint32_t : 24; // [8:31] 保留
};
CHMODE(通道模式):
– 正常模式(0):单次交易,传输完成后通道进入空闲状态
– 影子模式(1):利用影子TCS实现无缝重配置
RROAT(触发类型):
– 读-读触发(0):触发后等待读操作完成才处理下一次触发
– 自动触发(1):触发后自动连续执行,适用于链表模式
4.3 ADICR:地址模式与中断控制
ADICR(Address Mode and Interrupt Control Register) 是功能最丰富的寄存器之一:
struct ADICR {
uint32_t SHCT : 4; // [0:3] 阴影/链表模式选择
uint32_t INCS : 1; // [4] 源地址递增使能
uint32_t INCD : 1; // [5] 目的地址递增使能
uint32_t DM : 1; // [6] 目的地址修改使能
uint32_t ST : 1; // [7] 源地址递增类型
uint32_t DT : 1; // [8] 目的地址递增类型
uint32_t SWAP : 1; // [9] 字节序交换
uint32_t : 4; // [10:13] 保留
uint32_t CRCEN : 1; // [14] CRC校验使能
uint32_t WUP : 1; // [15] 唤醒使能
uint32_t SUP : 1; // [16] 源地址用户/特权
uint32_t DUP : 1; // [17] 目的地址用户/特权
uint32_t : 14; // [18:31] 保留
};
SHCT(阴影/链表模式) 是DMA链表功能的核心:
| 0x0-0x3 | 普通模式 | 正常传输,无链表 |
| 0x4-0xB | 保留 | – |
| 0xC | 常规链表(DMALL) | 顺序执行多个TCS,SDCRC/RDCRC覆盖 |
| 0xD | 累积链表(ACCLL) | CRC跨TCS累积 |
| 0xE | 安全链表(SAFLL) | 地址校验 + 累积CRC |
| 0xF | 条件链表(CONLL) | 基于数据模式的条件分支 |
4.4 SMCR与DMCR:地址修改控制
SMCR(Source Modification Control Register) 和 DMCR(Destination Modification Control Register) 控制地址在传输过程中的变化方式:
struct SMCR {
uint32_t INCD : 2; // [0:1] 源地址增量模式
uint32_t DEC : 1; // [2] 地址递减使能
uint32_t SM : 1; // [3] 源地址修改使能
uint32_t : 2; // [4:5] 保留
uint32_t circular : 2; // [6:7] 循环缓冲模式
uint32_t : 1; // [8] 保留
uint32_t WRAP : 2; // [9:10] wrap点配置
uint32_t : 21; // [11:31] 保留
};
INCD(增量模式):
| 值 | 含义 |
|—-|——|
| 00 | 保持不变 |
| 01 | +1(字节) |
| 10 | +2(半字) |
| 11 | +4(字) |
Circular(循环缓冲):
– 启用后,地址会在配置的循环缓冲大小内循环
– 循环缓冲大小必须是2的幂
– 非常适合ADC连续采样和通信FIFO场景
4.5 RDCR:CRC校验控制
RDCR(Read/Write CRC Control Register) 支持数据传输的完整性校验:
struct RDCR {
uint32_t SDCRC : 16; // [0:15] 源数据DMA地址校验
uint32_t RDCRC : 16; // [16:31] 读数据校验值
};
- SDCRC:在链表模式中存储期望的DMA地址校验值
- RDCRC:存储读数据的CRC校验结果
- 安全链表(SAFLL) 会比较SDCRC与实际计算值,不匹配则报错
五、DMA触发方式:灵活的事件驱动
5.1 软件触发
软件触发是最直接的DMA启动方式:
// 方法1:直接写入SETR位
DMA_CH0->CHCSR |= DMA_CHCSR_SETR_Msk;
// 方法2:使用iLLD API
IfxDma_startChannelTransaction(&dmaCh0Handle);
适用场景:
– 内存到内存的大数据块搬移
– 测试和调试
– 需要精确控制传输时机的场景
5.2 硬件触发
硬件触发通过中断路由器连接外设事件:
┌─────────┐ 请求线 ┌────────────┐
│ EVADC │ ───────────→ │ Interrupt │
└─────────┘ │ Router │
│ (IR) │
┌─────────┐ 请求线 │ │
│ UART │ ───────────→ │ │
└─────────┘ └─────┬──────┘
│
▼
┌───────────────┐
│ DMA Request │
│ Arbitration │
└───────────────┘
配置步骤:
// 1. 配置ADC触发DMA请求
ADC->G_QMR0 |= ADC_QMR0_EN0_Msk; // 使能队列
ADC->QCTRL0 |= ADC_QCTRL0_TRIG0_Msk; // DMA请求使能
// 2. 配置DMA通道触发源
DMA_CH->CHCFGR |= (triggerLine << PR_Pos); // 设置触发源优先级
// 3. 等待硬件触发
// ADC转换完成后自动触发DMA传输
5.3 菊花链触发(Daisy Chain)
菊花链允许一个DMA通道完成后自动触发下一个通道:
// 配置通道0完成后触发通道1
DMA_CH1->CHCFGR |= DMA_CHCFGR_ECH_Msk; // 使能通道1的触发使能
// 当DMA_CH0传输完成时,会自动触发DMA_CH1
典型应用:多缓冲区顺序填充
Channel 0 ──→ Channel 1 ──→ Channel 2 ──→ Channel 3
[Buffer0] [Buffer1] [Buffer2] [Buffer3]
5.4 自动触发(Auto Start)
在链表模式中,Auto Start允许DMA自动加载并执行下一个TCS:
// 配置TCS自动启动
TCS0->CHCFGR |= DMA_CHCFGR_RROAT_Msk; // RROAT=1 自动触发
TCS0->ADICR = (0xC << ADICR_SHCT_Pos); // 常规链表模式
// 启动链表
DMA_CH0->CHCSR = TCS0; // 写入第一个TCS
// DMA会自动按链表顺序执行,无需软件干预
六、DMA链表模式:复杂传输的利器
6.1 常规链表(DMALL, SHCT=0xC)

常规链表是最基本的链表模式:
链表执行流程:
TCS0 (配置) ──→ 执行交易1 ──→ 从SHADR加载TCS1 ──→ 执行交易2 ──→ …
│
最后一个TCS
(非链表模式)
特点:
– 每个TCS的SDCRC/RDCRC被下一个TCS覆盖
– 链表最后一个TCS应为非链表模式(SHCT≠0xC)
– 适用于顺序执行多个不同配置的交易
6.2 累积链表(ACCLL, SHCT=0xD)
累积链表将CRC值跨所有交易累积:
应用场景:大文件分块传输 + 端到端校验
// 配置累积链表
configure_acll_auto();
// 计算累积CRC
for (int i = 0; i < num_tcs; i++) {
accumulate_crc(&tcs[i], &expected_sdcrc, &expected_rdcrc);
}
// 传输完成后比较累积CRC
if (channel->RDCR == expected_rdcrc) {
// 数据完整性验证通过
}
6.3 安全链表(SAFLL, SHCT=0xE)
安全链表在累积基础上增加了地址校验:
关键机制:
1. 每个TCS的SDCRC字段存储期望的DMA地址校验值
2. 加载新TCS前,DMA计算当前交易的地址校验
3. 与新TCS的SDCRC比较,匹配则继续,否则报错停止
执行流程:
交易0 ──→ 计算CRC0 ──→ 加载TCS1 ──→ 比较CRC0 vs SDCRC(TCS1)
│
├─ 匹配 ──→ 执行交易1
│
└─ 不匹配 ──→ 触发SLLER错误中断
安全优势:防止链表数据被篡改或传输错误导致的错误执行流。
6.4 条件链表(CONLL, SHCT=0xF)
条件链表实现了基于数据值的动态分支选择:
模式匹配机制:
– PAT[0]/PAT[2]:模式0配置
– PAT[1]/PAT[3]:模式1配置
– 传输过程中,DMA检查每个Move的数据
– 匹配模式0 → 从SHADR加载下一TCS
– 匹配模式1 → 从SDCRC地址加载下一TCS
应用场景:
– 数据解析器:识别特定帧头后切换处理逻辑
– 协议处理器:根据包类型选择不同解析流程
– 状态机驱动:根据接收数据触发不同状态转换
七、双缓冲操作:实时数据流处理
7.1 双缓冲原理

双缓冲(Double Buffering)是实时系统的核心模式:
时间 ──────────────────────────────────────────────────────→
Buffer A: [填充中…] [填充完成] [软件处理] [等待中…]
Buffer B: [软件处理] [等待中…] [填充中…] [填充完成]
↑ ↑ ↑
Buffer A满 Buffer B满 Buffer A满
DMA切换 软件切换 DMA切换
核心优势:
– DMA填充缓冲区的同时,CPU可以处理已满的缓冲区
– 实现生产者和消费者的并行运行
– 消除数据处理的等待时间
7.2 AURIX TC3xx双缓冲配置
// 配置双缓冲模式
void configure_double_buffer(DMA_Channel *ch,
uint32_t buf0_addr,
uint32_t buf1_addr,
uint32_t buf_size) {
// 配置源/目的切换控制
ch->ADICR |= DMA_ADICR_DECS_Msk; // 目的地址切换使能
// 配置双缓冲模式
ch->CHCFGR |= DMA_CHCFGR_CHM_Msk; // 通道影子模式
// 交替使用两个缓冲区
ch->SMCR |= DMA_SMCR_WRAP_Msk; // 启用wrap
ch->SMCR = (buf_size << SMCR_SMOC_Pos); // wrap点 = buf_size
}
7.3 应用案例:高速ADC数据采集
// ADC双缓冲DMA采集示例
#define BUF_SIZE 1024
uint32_t adc_buf0[BUF_SIZE];
uint32_t adc_buf1[BUF_SIZE];
volatile uint8_t active_buffer = 0;
volatile uint32_t sample_count = 0;
// DMA中断处理
void DMA_CH0_IRQHandler(void) {
if (DMA_CH0->CHISR & DMA_CHISR_TC_Msk) {
// 半传输完成
if (active_buffer == 0) {
process_adc_data(adc_buf0, BUF_SIZE/2);
} else {
process_adc_data(adc_buf1, BUF_SIZE/2);
}
sample_count += BUF_SIZE/2;
}
// 清除中断标志
DMA_CH0->CHISR = DMA_CHISR_TC_Msk;
}
八、资源分区(Resource Partition):功能安全的保障
8.1 RP隔离机制

AURIX TC3xx的DMA支持资源分区(Resource Partition),实现不同应用间的硬件隔离:
┌──────────────────────────────────────────────────────────┐
│ DMA Controller │
├────────────────┬────────────────┬────────────────────────┤
│ RP 0 │ RP 1 │ RP N │
├────────────────┼────────────────┼────────────────────────┤
│ Channel 0-31 │ Channel 32-63 │ Channel 96-127 │
│ Master Tag A │ Master Tag B │ Master Tag C │
│ 独立访问控制 │ 独立访问控制 │ 独立访问控制 │
│ 独立错误中断 │ 独立错误中断 │ 独立错误中断 │
└────────────────┴────────────────┴────────────────────────┘
8.2 安全特性
1. 访问权限隔离
– 每个RP有独立的Access Enable寄存器
– 只有授权的Master才能访问特定RP的DMA通道
– 防止恶意或错误的应用干扰关键数据传输
2. 错误隔离
– RP错误不会传播到其他RP
– 各RP有独立的错误中断向量
– 支持精确的错误定位和恢复
3. 多OS支持
– 不同操作系统可以安全共享DMA硬件
– 每个OS管理自己的RP,互不干扰
– 符合ISO 26262功能安全要求
九、典型应用案例
9.1 案例一:EVADC高速采样

// 配置ADC + DMA连续采样
void adc_dma_init(void) {
// 1. 配置ADC模块
IfxEvadc_Adc_initModule(&adcModuleConfig);
IfxEvadc_Adc_initGroup(&adcGroupConfig);
// 2. 配置DMA通道
IfxDma_Dma_initChannel(&dmaChannelConfig);
// 3. 设置DMA源(ADC结果寄存器)和目的(内存缓冲区)
dmaChannelConfig.sourceAddress = (uint32)&ADC->RES[0];
dmaChannelConfig.destinationAddress = (uint32)adc_buffer;
dmaChannelConfig.transferCount = BUFFER_SIZE – 1;
// 4. 配置循环缓冲模式
dmaChannelConfig.circularMode = IfxDma_CircularMode_enabled;
// 5. 配置硬件触发(ADC转换完成触发DMA)
dmaChannelConfig.requestSource = IfxDma_RequestSource_peripheral;
dmaChannelConfig.peripheralTrigger = IfxEvadc_TRIG_15;
// 6. 启动DMA
IfxDma_startChannelTransaction(&dmaChannelHandle);
}
9.2 案例二:UART大数据接收
// UART接收FIFO到内存缓冲区
void uart_dma_rx_init(void) {
// 1. 配置UART接收FIFO半满触发
UART->FCR |= UART_FCR_RXFIFO_HALF;
// 2. 配置DMA从UART RX FIFO到内存
DMA_CH->SADR = (uint32)&UART->RXDATA; // 源:UART数据寄存器
DMA_CH->DADR = (uint32)rx_buffer; // 目的:内存缓冲区
DMA_CH->TREL = RX_BUFFER_SIZE; // 传输长度
DMA_CH->CHCFGR = DMA_CHCFGR_RROAT_Msk; // 自动触发
// 3. 启用循环缓冲(覆盖旧数据)
DMA_CH->DMCR |= DMA_DMCR_CIRCULAR_Msk;
// 4. 配置UART触发DMA请求
UART->DMACR |= UART_DMACR_RX DMAE_Msk;
}
9.3 案例三:内存数据块搬移
// 内存到内存的DMA搬移
void mem_to_mem_dma(uint32_t src, uint32_t dest, uint32_t len) {
// 选择空闲DMA通道
DMA_Channel *ch = allocate_dma_channel();
// 配置源和目的
ch->SADR = src;
ch->DADR = dest;
ch->TREL = len;
// 配置地址递增
ch->SMCR = (0x2 << SMCR_INCD_Pos); // 源地址+4
ch->DMCR = (0x2 << DMCR_INCD_Pos); // 目的地址+4
// 配置32位传输
ch->CHCFGR = (0x2 << CHCFGR_CHDW_Pos);
// 软件触发启动
ch->CHCSR |= DMA_CHCSR_SETR_Msk;
// 等待完成或使用中断
while (!(ch->CHISR & DMA_CHISR_TC_Msk));
}
十、编程最佳实践与性能优化
10.1 初始化流程
标准的DMA通道初始化应该遵循以下流程:
void dma_channel_init(DMA_Channel *ch, dma_config_t *config) {
// 1. 停止通道(安全操作)
ch->CHCSR = 0;
// 2. 清除待处理请求
ch->CHCSR |= DMA_CHCSR_CLRR_Msk | DMA_CHCSR_CLRT_Msk;
// 3. 配置RP分配(功能安全)
ch->RP = config->resource_partition;
// 4. 配置源地址
ch->SADR = config->source_address;
// 5. 配置目的地址
ch->DADR = config->destination_address;
// 6. 配置传输参数
ch->TREL = config->transfer_length;
ch->CHCFGR = (config->data_width << CHCFGR_CHDW_Pos) |
(config->trigger_mode << CHCFGR_RROAT_Pos);
// 7. 配置地址修改模式
ch->SMCR = config->source_mod;
ch->DMCR = config->dest_mod;
// 8. 配置中断(可选)
if (config->enable_interrupt) {
ch->ADICR |= DMA_ADICR_IREN_Msk;
DMA->INTSEL = config->interrupt_line;
}
// 9. 使能通道
ch->CHCSR |= DMA_CHCSR_CHE_Msk;
}
10.2 性能优化建议
1. 地址对齐优化
// ❌ 低效:未对齐的缓冲区
uint8_t unaligned_buffer[1000]; // 可能跨越缓存行
// ✅ 高效:Cache对齐的缓冲区
ALIGNED(32) uint32_t aligned_buffer[256]; // 32字节对齐
2. 减少跨总线传输
// ❌ 低效:SPB → SRI 跨总线
DMA_CH->SADR = SPI_BASE + DATA_REG; // SPB总线
DMA_CH->DADR = DSPR_BASE + buffer; // SRI总线
// ✅ 高效:同总线传输
DMA_CH->SADR = LMU_BASE + spi_buffer; // 先拷贝到LMU
DMA_CH->DADR = DSPR_BASE + buffer;
3. 合理利用链表减少中断
// ❌ 低效:每个数据包一次中断
for (int i = 0; i < 100; i++) {
configure_dma_channel(data[i]);
wait_interrupt();
}
// ✅ 高效:链表一次配置,100个包自动传输
configure_dma_linked_list(100, data);
wait_single_interrupt();
4. 双缓冲消除等待
// 使用双缓冲实现ADC和处理的流水线
// ADC DMA → Buffer A → [处理] ─┐
// │ 循环
// ADC DMA → Buffer B → [处理] ─┘
10.3 常见错误与排查
| DMA不触发 | 触发源未使能 | 检查外设DMA请求使能位 |
| 数据错乱 | 地址对齐错误 | 按数据宽度对齐地址 |
| 传输长度不对 | TREL配置错误 | 确保TREL是BLKM×CHDW的整数倍 |
| 中断不触发 | 中断未使能/通道错误 | 检查ADICR.IREN和INTSEL |
| 链表不执行 | SHADR未32字节对齐 | 确保链表指针按32字节对齐 |
| 优先级不生效 | 仲裁发生在Transfer后 | 理解仲裁机制,重新设计传输 |
十一、总结与展望
11.1 核心要点回顾
本文深入探讨了AURIX TC3xx DMA控制器的架构与编程:
11.2 DMA在现代汽车电子中的演进
随着汽车电子电气架构的演进,DMA的角色也在发生变化:
- 软件定义汽车:更高带宽需求推动DMA性能提升
- 区域控制器:DMA用于区域间高速数据交换
- 自动驾驶:大量传感器数据需要零拷贝DMA传输
- 车联网:高速CAN-FD/以太网数据缓冲
11.3 延伸学习路径
- IF-10:SCU系统控制单元(复位、看门狗、ERU)
- IF-12:外设桥与端口(GPIO、多路复用)
- IF-13:GTM通用定时器(与DMA协同工作)
- IF-SAFE系列:功能安全视角的DMA设计考量
📚 参考资料
– AURIX TC3xx User's Manual v2.0 (Infineon)
– AP32467: DMA linked list modes (Infineon)
– AURIX TC3xx DMA Training (Infineon)
– iLLD Driver Documentation (Infineon)