一、引言
KMS 知识管理平台是我负责了两年的项目,服务公司内部 2000+ 员工,沉淀了约 15 万篇文档。
但它的搜索功能一直是个痛点。
用户输入"去年合规审查的通过标准是什么",传统搜索引擎返回一堆包含"合规"“审查”"标准"关键词的文档列表。用户需要逐篇点开、阅读、筛选——很多时候翻了 10 分钟还找不到想要的答案。
这不是搜索算法的问题,而是关键字匹配的天花板。用户的真实意图是"帮我找到答案",而关键字搜索只能做到"帮你找到可能包含答案的文档"。
2025 年初,我开始探索 RAG(Retrieval-Augmented Generation,检索增强生成)。三个月后,第一个版本在 KMS 内部上线。这篇文章记录我从 0 到 1 的完整实践过程——从架构设计、技术选型、到踩坑与优化。
二、RAG 是什么?一张图讲清楚
先用一句话概括 RAG 的核心思想:
不让 LLM 凭记忆回答,而是先检索相关文档,把文档内容和问题一起喂给 LLM,让它基于"参考资料"来回答。
这样做的好处显而易见:
- 知识可更新:文档变了,检索结果就变了,不需要重新训练模型
- 减少幻觉:LLM 被约束在检索到的文档范围内回答,不太会凭空编造
- 来源可追溯:每个答案都能指向具体的源文档,方便核实

RAG 流程分为两个阶段:
离线阶段(文档入库):
在线阶段(用户提问):
三、系统架构设计
KMS RAG 系统的整体架构分为四层:

文档层
负责文档的接入与预处理。KMS 中 90% 的文档是 Markdown 格式(Tiptap 编辑器产出),剩下 10% 是以附件形式上传的 PDF 和 Word。
# 文档解析器 —— 统一不同格式
from langchain_community.document_loaders import (
UnstructuredMarkdownLoader,
PyPDFLoader,
Docx2txtLoader,
)
def load_document(file_path: str, file_type: str) –> list[Document]:
loader_map = {
'md': UnstructuredMarkdownLoader,
'pdf': PyPDFLoader,
'docx': Docx2txtLoader,
}
loader_class = loader_map.get(file_type)
if not loader_class:
raise ValueError(f"Unsupported file type: {file_type}")
loader = loader_class(file_path)
return loader.load()
向量化层
负责文本块的 Embedding 生成。我选择了 text-embedding-3-small 模型,在成本和效果之间取得了较好的平衡。
from openai import OpenAI
client = OpenAI()
def create_embeddings(texts: list[str], model: str = "text-embedding-3-small") –> list[list[float]]:
"""批量生成文本的向量表示"""
response = client.embeddings.create(
model=model,
input=texts,
)
return [item.embedding for item in response.data]
检索层
负责根据用户问题召回最相关的文档片段。这里采用了混合检索策略——向量检索 + 关键字检索,两者互补。
from langchain_community.vectorstores import PGVector
from langchain.retrievers import BM25Retriever
class HybridRetriever:
"""混合检索器:向量检索 + BM25 关键字检索"""
def __init__(self, vector_store: PGVector, bm25_retriever: BM25Retriever):
self.vector_store = vector_store
self.bm25_retriever = bm25_retriever
def retrieve(self, query: str, top_k: int = 5) –> list[Document]:
# 向量检索(语义相似)
vector_docs = self.vector_store.similarity_search(query, k=top_k)
# BM25 关键字检索
keyword_docs = self.bm25_retriever.get_relevant_documents(query)[:top_k]
# 合并去重 + RRF (Reciprocal Rank Fusion) 重排序
return self._rrf_fusion(vector_docs, keyword_docs)
生成层
负责组装 Prompt 并调用 LLM 生成最终答案。
def build_rag_prompt(query: str, retrieved_docs: list[Document]) –> str:
"""组装 RAG Prompt"""
context = "\\n\\n—\\n\\n".join(
f"【来源:{doc.metadata.get('source', '未知')}】\\n{doc.page_content}"
for doc in retrieved_docs
)
return f"""你是一个专业的 KMS 知识库助���。请基于以下参考资料回答用户的问题。
## 参考资料
{context}
## 回答要求
1. 如果参考资料中包含答案,请直接引用并标注来源
2. 如果参考资料不足以回答问题,请明确说明
3. 不要编造参考资料中没有的信息
## 用户问题
{query}
## 回答"""
四、Chunking 策略:被低估的关键环节
Chunking 决定了检索的"颗粒度"。切太大——检索精度下降,噪声多;切太小——上下文不足,答案片段化。
我在 KMS 上实验了三组参数:
| 固定长度 | 512 tokens | 10% | 78% | 通用基线 |
| 固定长度 | 1024 tokens | 10% | 81% | 长文档 |
| 语义切分 | 不固定 | 句子级 | 87% | Markdown 文档 |
最终选择语义切分——基于 Markdown 的标题层级(##、###)作为天然的分界点:
from langchain.text_splitter import MarkdownHeaderTextSplitter
headers_to_split_on = [
("##", "h2_section"),
("###", "h3_section"),
("####", "h4_section"),
]
splitter = MarkdownHeaderTextSplitter(
headers_to_split_on=headers_to_split_on,
strip_headers=False,
)
# 按 Markdown 标题层级切分,每个 section 自带层级元数据
splits = splitter.split_text(markdown_content)
这种做法让每个 Chunk 自带标题上下文(元数据中的 h2_section、h3_section),在检索时 LLM 能理解这个片段属于哪个章节,生成的答案更有条理。
五、向量数据库选型
KMS 的技术栈是 Python + PostgreSQL,所以向量数据库的候选范围很明确:
| Milvus | 性能最强,千万级向量不虚 | 需要独立部署和维护 | 太重,小团队不合适 |
| Pinecone | 免运维,开箱即用 | 数据出境(合规问题)、成本随规模上升 | 金融科技不适合 |
| PGVector | 复用 PostgreSQL,零额外运维 | 百万级后性能下降 | ✅ 当前最优解 |
PGVector 最大的优势是零额外运维成本——KMS 本来就用 PostgreSQL,开启 PGVector 插件只需要一行 SQL:
CREATE EXTENSION vector;
— 创建向量存储表
CREATE TABLE document_embeddings (
id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
doc_id UUID REFERENCES documents(id),
chunk_index INT,
content TEXT,
embedding VECTOR(1536), — text-embedding-3-small 的维度
metadata JSONB,
created_at TIMESTAMP DEFAULT NOW()
);
— 创建索引(IVFFlat 适合 10 万级数据)
CREATE INDEX ON document_embeddings
USING ivfflat (embedding vector_cosine_ops)
WITH (lists = 100);
15 万文档切分后约 60 万个 Chunk,PGVector 的 IVFFlat 索引在 Recall@5 = 85% 的条件下查询延迟约 120ms,完全够用。
六、踩坑与优化清单
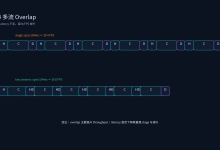
坑一:Overlap 设置过小导致答案断层
现象:用户问"KMS 权限模型有哪三种角色",检索召回了三段分别讲 admin、editor、viewer 的内容——但没召回讲"权限模型概述"的段落,导致 LLM 不理解这三种角色之间的关系。
根因:Chunk 之间的 Overlap 只有 50 个字符,而"概述段落"和"详细描述"之间隔了 200+ 字符,没有被相邻 Chunk 覆盖。
解决:将 Overlap 提升到 Chunk 大小的 15%(约 150 tokens),同时在检索策略上增加父文档召回——检索到某个 Chunk 后,连带召回它所属的整个 Section。
坑二:向量检索的"语义漂移"
现象:用户搜索"财务报表模板",结果中出现了大量"季度报告模板"。从向量角度看,它们的语义确实很接近,但对用户来说是两种不同的文档。
根因:纯向量检索对同义词和近义概念区分度不够。
解决:引入混合检索——BM25 关键字检索 + 向量检索,用 RRF 算法融合排序:
def rrf_fusion(rankings: list[list[Document]], k: int = 60) –> list[Document]:
"""
Reciprocal Rank Fusion: 多路检索结果融合
RRF_score(d) = Σ 1 / (k + rank_i(d))
"""
scores = {}
for ranking in rankings:
for rank, doc in enumerate(ranking):
doc_id = doc.metadata.get('chunk_id', doc.page_content[:50])
scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)
# 按融合分数排序
sorted_scores = sorted(scores.items(), key=lambda x: x[1], reverse=True)
return [self._get_doc_by_id(doc_id) for doc_id, _ in sorted_scores]
坑三:Prompt Template 设计不当,LLM 放飞自我
现象:早期版本的 Prompt 没有明确约束"如果不知道就说不知道",导致 LLM 在检索不到相关资料时,用自己训练数据中的知识"填补"——产生了幻觉答案。
解决:在 Prompt 中明确加入"边界指令"——“如果参考资料不足以回答问题,请明确说明,不要编造”。这一点在生成层代码中已经体现。
坑四:成本控制被忽略
账单惊魂:第一个月测试阶段,Embedding API 和 GPT-4o 的调用费用接近 $200。排查发现两个问题:
优化后:
- 热门查询的 Embedding 结果用 Redis 缓存(TTL 1 小时)
- top_k 降到 5,配合 Rerank 精排
- 月成本降到约 $45
七、总结
三个月时间,RAG 从概念到上线,最深的体会是:
RAG 的工程难点不是模型,而是文档处理、检索策略和 Prompt 工程。 模型是别人的,但你的文档结构、Chunking 策略、检索调优是别人替代不了的。
当前版本还远不完美。下一步计划:
- Rerank 模型引入:在粗排后用 Cross-Encoder 做精排,进一步提升检索精度
- 多轮对话支持:让用户能追问,而不仅仅是单轮问答
- 用户反馈闭环:收集用户对答案的点赞/点踩,用于持续优化检索策略
如果你也在做类似的事情,建议先从最小可行方案开始:PGVector + 语义切分 + 混合检索,三个组件搭好,基本能满足 80% 的企业知识库场景。剩下的 20% 留给持续迭代。
这篇文章记录了我将 RAG 落地到 KMS 企业知识管理平台的完整过程。项目还在持续迭代中,欢迎交流。