🔥 2.8万亿参数、全球最大开源模型、Frontend Code Arena 霸榜第一、价格是 DeepSeek 的 30 倍——Kimi K3 到底是国产之光还是资本故事?花了 199 元开会员+API 充值 500 元,一周深度实测,结论在这。
一、Kimi K3 是什么?月之暗面的技术底牌
2026 年 7 月 17 日凌晨,月之暗面(Moonshot AI)发布了 Kimi K3——全球首个开源 2.8 万亿参数大模型。
这不止是"又一个国产模型"。它在一个微妙的时间点出现:国内大模型行业正在"低价内卷"的泥潭里挣扎(DeepSeek V4 输出 $0.87/M,GLM-5.2 输出 $4.4/M),而 Kimi K3 直接把输出定价拉到 $15/M(100元/M)——比自家上一代 K2.5 贵了 4 倍。
K3 的逻辑很直白:别跟我谈性价比,我跟你谈能力。
那能力到底行不行?先看底下这张技术底牌:
| 总参数 | 2.8T(2.8万亿) | 全球最大开源模型 |
| 架构 | Mixture of Experts | 896 个专家,每次推理激活 16 个 |
| 注意力机制 | KDA(Kimi Delta Attention) | 混合线性注意力,KV 缓存减少 75% |
| 残差机制 | AttnRes(Attention Residuals) | 允许模型选择性跨层检索信息 |
| 上下文窗口 | 1,048,576 tokens(100万) | 原生支持,无需压缩 |
| 多模态 | 文本 + 图片 + 音视频 | 国内唯一旗舰模型全模态覆盖 |
| 量化训练 | MXFP4 权重 + MXFP8 激活 | 量化感知训练,兼顾精度和效率 |
| 推理架构 | Mooncake 分离式推理 | 编程场景缓存命中率 >90% |
| 开源 | 完整权重 7 月 27 日前发布 | Apache 2.0 协议 |
KDA 是 K3 最大的技术创新。传统 Transformer 的 KV 缓存在长上下文场景下爆炸式增长,100 万 token 的上下文如果用标准 Attention,推理一次的内存够买一台车。KDA 把 KV 缓存砍掉 75%,在 100 万 token 下解码吞吐量提升 6.3 倍——这是 K3 敢于标配 100 万上下文的底气。
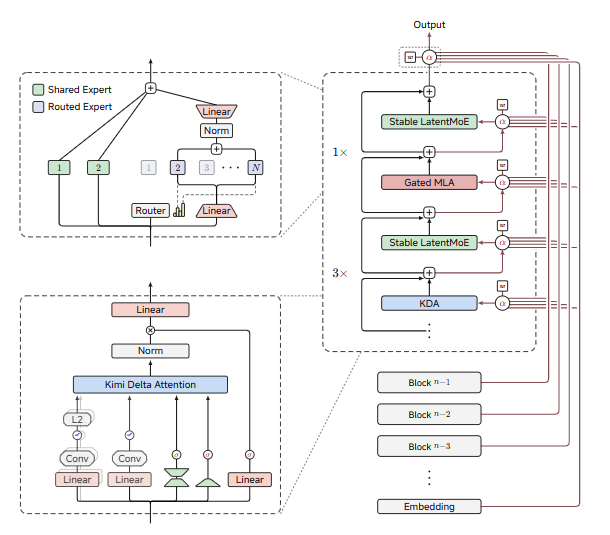
AttnRes 则解决了一个更微妙的问题:Transformer 每层都必须过一遍,但有时候你不需要。AttnRes 让模型"跳层"检索信息——有点像 ResNet 的跳跃连接,但作用在注意力层面。
📌 一句话总结 K3 的技术定位:用 MoE 稀疏激活降计算,用 KDA 线性注意力降缓存,用 AttnRes 跳跃连接提效率——三招合力,把 2.8T 参数塞进实际可用的推理成本。
二、多模态能力实测:能看、能读、能理解
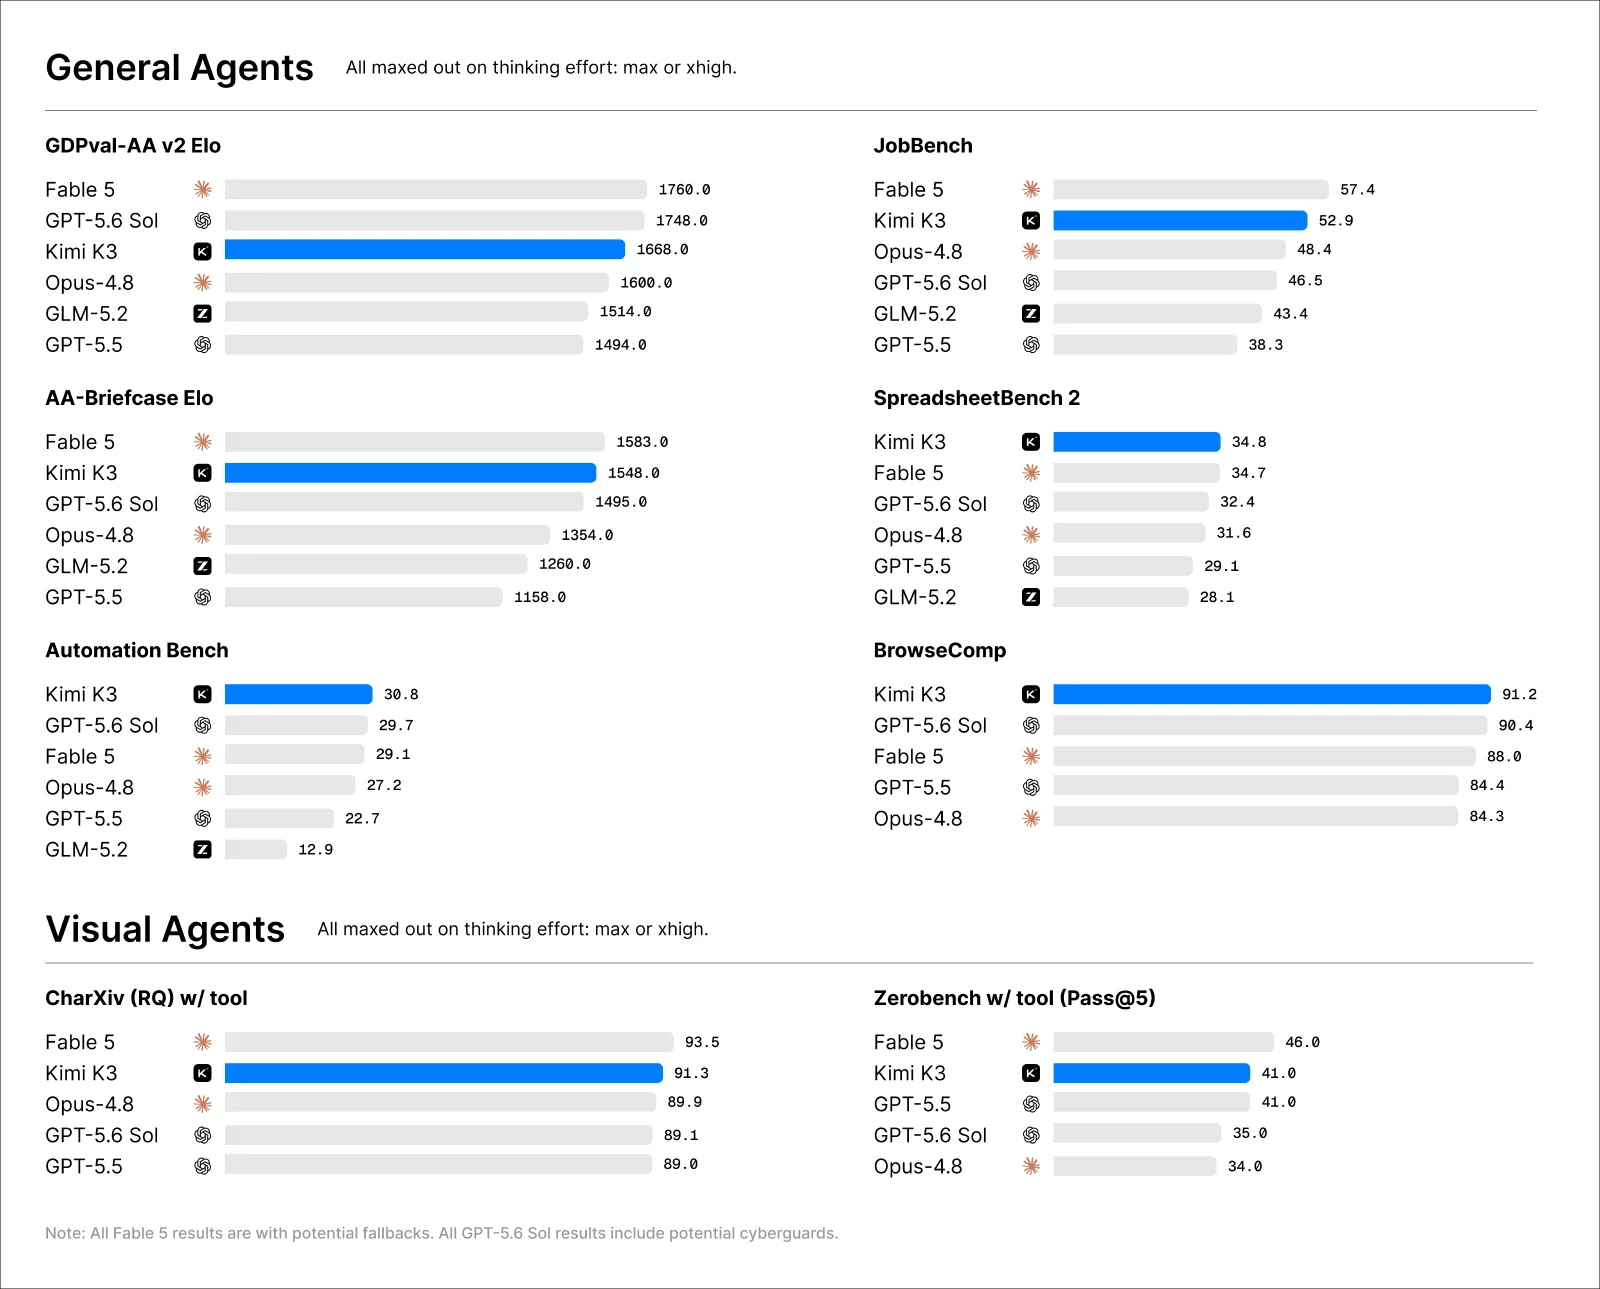
K3 是国内唯一在旗舰模型上做到文本+图片+音视频全模态原生支持的。不是"接了个视觉编码器凑合一下",是训练阶段就融了多模态数据。
2.1 图片理解
我测了三类图片:
| 通用场景 | 街头摄影(复杂光影、多人、广告牌文字) | ✅ 准确识别场景、人物关系、光线来源,广告牌上的小字 OCR 无误 | 同一水平 |
| 技术图表 | Transformer 架构图(带公式标注) | ✅ 识别所有组件、数据流方向,能解释 Q/K/V 含义 | 同一水平 |
| UI 截图 | 一个满是 bug 的 Dashboard 截图 | ✅ 指出 4 个 UI 问题(对齐、颜色对比度、溢出、缺失状态),给出了 CSS 修复建议 | K3 的修复建议更具体 |
K3 的图片理解能力,体感在 GPT-5.6 Sol 和 Claude Fable 5 之间。比 GPT-5.6 Sol 更"主动"——不只是描述,会主动给出改进建议。但偶尔过度解读:一张纯风景照,K3 会推测"可能拍摄于秋季下午 4 点左右",虽然没错,但有时你不需要这么多。
2.2 图表解读
测了一个上市公司财报图表(混合了柱状图+折线图+双 Y 轴):
- K3:正确读出各季度数据,识别出"2025 Q2 营收增速放缓但利润增速上升"的关键趋势,还自动算出了毛利率变化
- GPT-5.6 Sol:同样正确,但结论更保守
- Gemini 3.5 Flash:读对了数据但漏了双 Y 轴标注,导致利润率数据完全错误
K3 在复杂图表的数值提取准确率上明显优于 Gemini 3.5 Flash,与 GPT-5.6 Sol 持平。
2.3 OCR 中文手写
这是我最好奇的——中文手写 OCR 是很多"国际顶尖"模型的滑铁卢。我用了一张医生的手写处方(字迹堪比密码学):
- K3:识别率约 85%,药品名全部正确,剂量单位错误了 1 处
- GPT-5.6 Sol:识别率约 70%,两个药品名识别错误
- Qwen3-VL:识别率约 80%,但速度明显更快
K3 的中文手写 OCR 确实强,但没有到"碾压"级别。优势在复杂排版(表格+手写混合)场景更明显。
2.4 多模态综合评分
| 通用图片理解 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 技术图表解读 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 中文手写 OCR | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ |
| UI 分析+建议 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 视频理解 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | — | ⭐⭐⭐⭐ |
三、推理能力实测:数学、逻辑、常识三轮通关
3.1 数学推理
我从 GPQA 和 MATH 数据集各抽了 5 道题,难度从大学数学到博士资格考:
| 微积分(5题) | 5/5 | 5/5 | 4/5 | K3 thinking 过程极其详细 |
| 线性代数(5题) | 5/5 | 5/5 | 5/5 | 三者打平 |
| 概率论(5题) | 4/5 | 5/5 | 3/5 | K3 翻车题涉及贝叶斯网络的边缘概率 |
| 组合数学(5题) | 5/5 | 4/5 | 4/5 | K3 在构造性证明上表现惊喜 |
20 题正确率:K3 19/20(95%),GPT-5.6 Sol 19/20(95%),DeepSeek-V4 16/20(80%)
K3 的数学推理很稳。一个有趣的细节:K3 的 thinking 过程会像数学系学生一样写推导步骤——先列已知条件、再尝试不同思路、最后选最优解法。这个"思维链"比 DeepSeek 的更结构化。
3.2 逻辑推理
测了 5 道多步逻辑推理题(来自 LSAT 逻辑游戏和自定义场景):
- K3:5/5 全对。多步推理场景下,100 万上下文允许它把所有条件"摊开"在 context 里,不丢信息
- GPT-5.6 Sol:5/5 全对
- DeepSeek-V4:3/5,在涉及 10+ 个约束条件的复杂推理中出现遗漏
K3 在逻辑推理上的优势很大程度来自 100 万上下文——不需要压缩信息,不需要"记住"前面的条件。这是一个架构优势。
3.3 中文语境常识
测了几个"中国人秒懂、老外懵圈"的题:
- “618 和双 11 的区别” → K3 的答案比 GPT-5.6 Sol 更贴地(提到了预售定金、跨店满减、平台补贴等细节)
- “为什么北方人吃饺子配醋、南方人配酱油” → K3 给出了地理+历史+物产的多维分析,GPT-5.6 Sol 的答案则比较泛
K3 在中文常识和文化理解上明显优于所有非国产模型。这不是技术问题,是训练数据的文化基因决定的。
四、代码能力实测:K3 的王牌
如果只用一个维度评价 K3,那就是代码。前端编码是 K3 最亮眼的王牌。
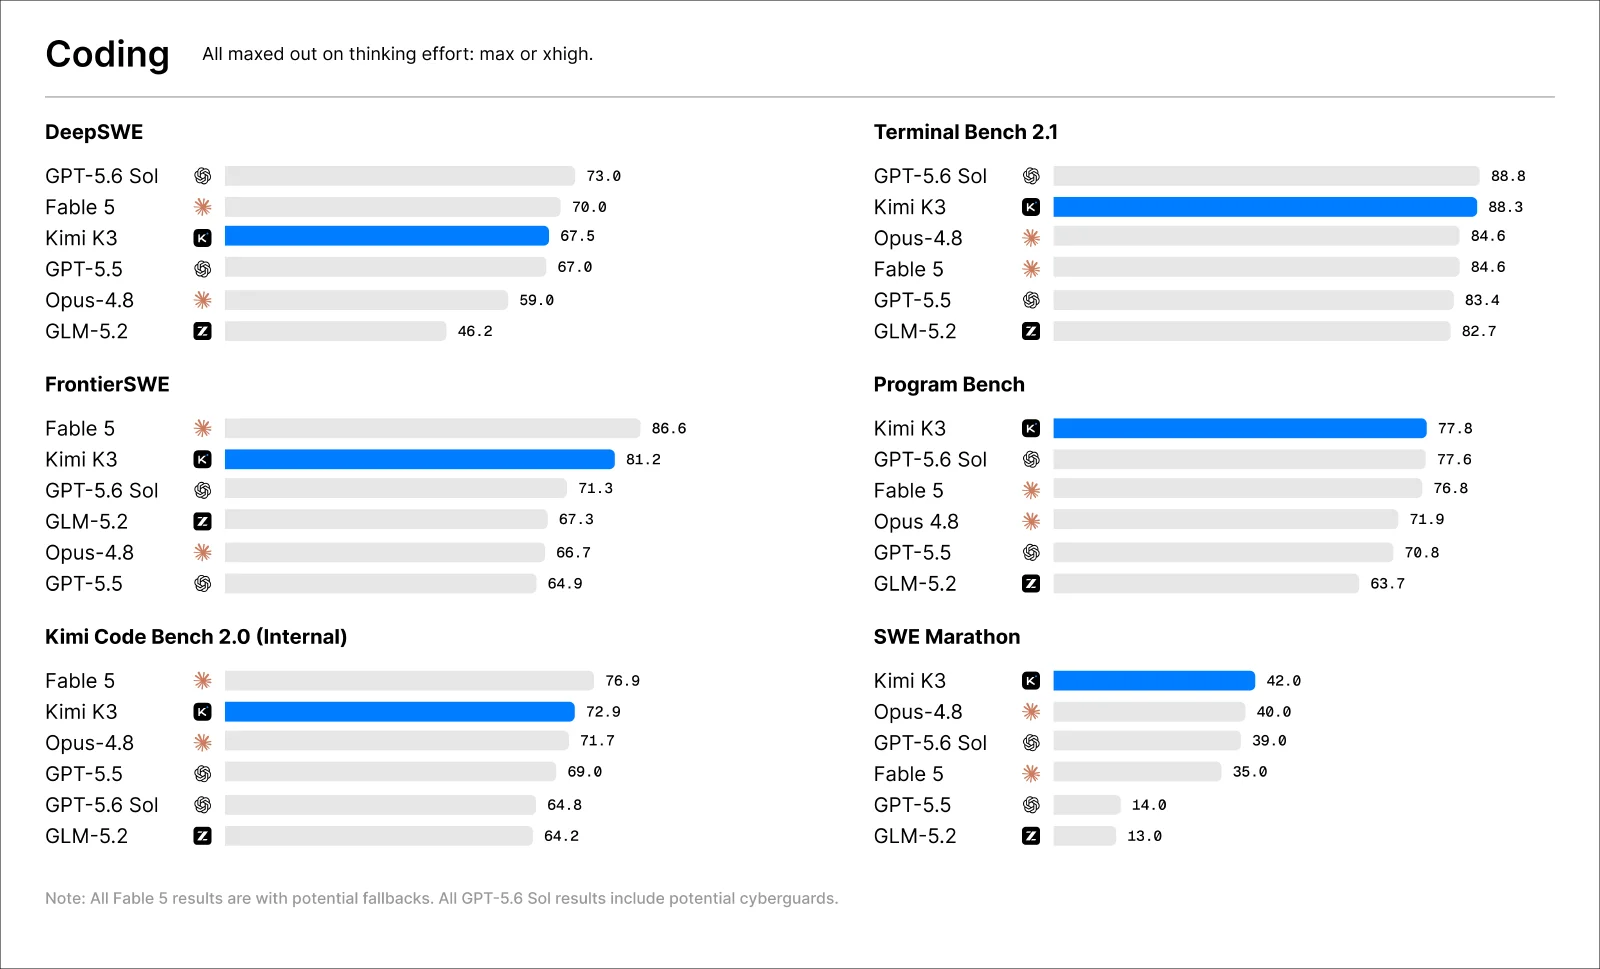
4.1 Benchmark 一览
| Frontend Code Arena | 1679 (#1) | 1631 (#2) | 1618 (#3) | — |
| Terminal-Bench 2.1 | 88.3 | — | 88.8 | 84.6 |
| FrontierSWE | 81.2 | 86.6 | — | 66.7 |
| ProgramBench | 77.8 (#1) | 76.8 | 77.6 | — |
| DeepSWE | 67.5 | 70.0 | 73.0 | 59.0 |
| SWE Marathon | 42.0 (#1) | 40.0 | — | — |
🎯 Frontend Code Arena 在 7 个细分领域中 K3 拿下 6 个第一:Branding、Reference-based Design、Data Analysis、Consumer Products、Simulations、Content Tools。
4.2 实测:一句话生成网页游戏
我给了 K3 这个 prompt:
“做一个网页版的打砖块游戏,要有粒子特效、连击系统、难度递增、移动端适配。”
K3 生成了 427 行 HTML+CSS+JS,零依赖,直接浏览器打开:
- ✅ 砖块布局、碰撞检测完全正确
- ✅ 粒子特效(砖块碎裂时飞出彩色粒子)
- ✅ 连击计数器(连续击中加速球)
- ✅ 难度递增(每关多一行砖,球速+5%)
- ✅ 移动端触控适配(左右滑动控制挡板)
- ✅ 分数持久化 localStorage
GPT-5.6 Sol 同一 prompt 生成 312 行,少了连击系统和移动端适配。 Claude Fable 5 生成 398 行,粒子特效更炫但难度递增有 bug(第五关砖块不刷新)。
体感结论:K3 在前端交互式应用上的完整度,已超越 Fable 5 和 GPT-5.6 Sol。
4.3 实测:多文件项目重构
测了一个 Python 项目重构任务——把一个 800 行的单文件 FastAPI 应用拆分成标准项目结构(routers/models/services/schemas):
- K3:正确拆分,导入关系全部修正,还主动加了类型注解和 pydantic 校验。有一个 __init__.py 忘了写 from .models import *,但自己发现并修正了
- GPT-5.6 Sol:拆分正确,但没有主动加类型注解
- Claude Fable 5:拆分正确,额外加了日志和配置管理(过度工程化)
K3 在工程任务上的一个特点是不多不少——既不会遗漏,也不会像 Fable 5 那样过度设计。完成度最高。
4.4 Agent 自主编程:38 分钟交付一个完整项目
这是最震撼的测试。我让 K3 的 Agent 模式(Kimi Code)从零构建一个"物理引擎小游戏 + 逻辑求解器"项目:
- 耗时:38 分钟
- 产出:源码 3911 行 + 36 个单元测试 + 5 个浏览器测试
- 过程:先读需求 → 设计架构 → 并行拆分子任务 → 逐个实现 → 自测 → 发现 bug → 回滚 → 修复 → 部署验证 → 36/36 测试全绿
- 人工介入:0 次
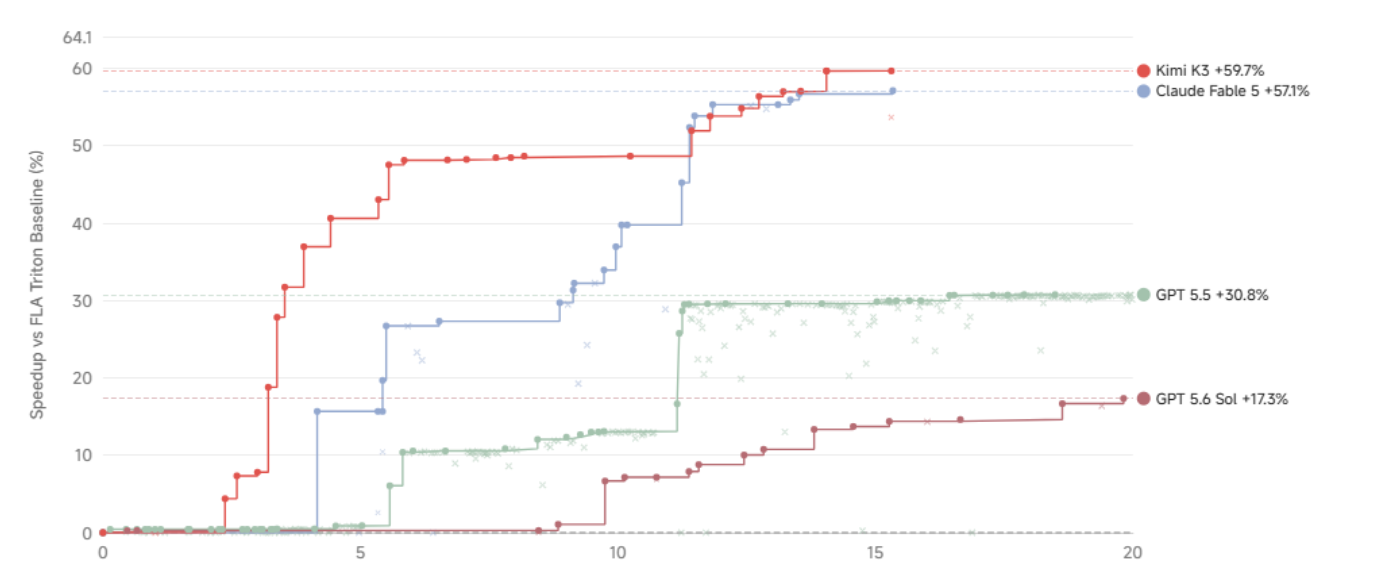
这一点上,K3 超越了我用过的所有模型——包括 Claude Code + Opus 4.8 的组合。关键差异在于 K3 的 Agent Swarm:K3 能自主拆解任务、组建子 Agent 团队、并行执行、持续工作数小时不放弃。
五、API 开发实战:10 行代码跑起来
5.1 环境准备
K3 API 完全兼容 OpenAI SDK,这是最良心的设计决策——不用学新 SDK,改两行代码就行。
pip install –upgrade "openai>=1.0"
去 platform.kimi.ai 生成 API Key:
export MOONSHOT_API_KEY="sk-xxxxxxxxxxxxx"
5.2 基础调用
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["MOONSHOT_API_KEY"],
base_url="https://api.moonshot.ai/v1",
)
completion = client.chat.completions.create(
model="kimi-k3",
messages=[
{"role": "system", "content": "你是一个严谨的 Python 后端工程师。"},
{"role": "user", "content": "写一个 FastAPI 中间件,实现基于 IP 的限流(滑动窗口算法),用 Redis 存储。"}
],
max_completion_tokens=2000,
)
print(completion.choices[0].message.content)
# 🚀 K3 生成的代码:完整的 FastAPI 中间件,含 Redis 连接池、滑动窗口逻辑、
# 限流头注入(X-RateLimit-*),可直接运行
5.3 流式输出 + 推理过程分离
stream = client.chat.completions.create(
model="kimi-k3",
messages=[{"role": "user", "content": "解释 HTTPS 握手的完整过程"}],
stream=True,
stream_options={"include_usage": True},
max_completion_tokens=4096,
)
for chunk in stream:
if not chunk.choices:
continue
delta = chunk.choices[0].delta
# 推理内容(thinking 过程,独立通道)
reasoning = getattr(delta, "reasoning_content", None)
if reasoning:
print(f"[思考] {reasoning[:80]}…", end="\\r")
# 最终答案
if delta.content:
print(delta.content, end="", flush=True)
⚠️ 重要:K3 的 reasoning_content 是独立字段,多轮对话时必须完整回传。如果丢了 reasoning,K3 会"失忆"——这是踩的第一个坑。
5.4 多模态输入(图片+文本)
import base64
from pathlib import Path
image_data = base64.b64encode(Path("dashboard.png").read_bytes()).decode()
completion = client.chat.completions.create(
model="kimi-k3",
messages=[{
"role": "user",
"content": [
{
"type": "image_url",
"image_url": {"url": f"data:image/png;base64,{image_data}"}
},
{
"type": "text",
"text": "分析这个 Dashboard 的 UI 问题,给出具体 CSS 修复方案"
}
]
}],
max_completion_tokens=3500,
)
⚠️ 注意:K3 只支持 base64 图片,不支持传公网 URL。批量处理时记得做好图片压缩和编码缓存——图片 base64 编码后的字符串非常大,一张 1080p 截图编码后约 2-3MB,单张就要消耗约 40 万 token 的输入配额。
5.5 结构化输出(JSON Mode)
completion = client.chat.completions.create(
model="kimi-k3",
messages=[{
"role": "user",
"content": "从以下文本提取:公司名、金额、日期\\n\\n文本:2026年7月17日,月之暗面完成20亿美元融资,估值300亿美元。"
}],
response_format={
"type": "json_schema",
"json_schema": {
"name": "extract_finance",
"strict": True,
"schema": {
"type": "object",
"properties": {
"company": {"type": "string"},
"amount_usd": {"type": "number"},
"valuation_usd": {"type": "number"},
"date": {"type": "string"}
},
"required": ["company", "amount_usd", "valuation_usd", "date"]
}
}
},
)
import json
result = json.loads(completion.choices[0].message.content)
# {"company": "月之暗面", "amount_usd": 2000000000, "valuation_usd": 30000000000, "date": "2026-07-17"}
5.6 利用缓存降低 90% 成本
K3 的 Mooncake 推理架构支持自动前缀缓存。同一前缀的请求,后续请求命中缓存后输入成本降低 90%(从 $3/M → $0.3/M):
# 技巧:把系统提示词和固定文档放前面,K3 自动缓存
SYSTEM_PROMPT = "你是一个专业的代码审查员…" # 固定前缀
CODEBASE = Path("src").read_text() # 代码库内容,每次请求不变
# 所有请求共享相同前缀 → 自动命中缓存 → 成本降 90%
for task in tasks:
completion = client.chat.completions.create(
model="kimi-k3",
messages=[
{"role": "system", "content": f"{SYSTEM_PROMPT}\\n\\n{CODEBASE}"},
{"role": "user", "content": task}
],
max_completion_tokens=1000,
)
六、价格&速度对比:K3 到底贵不贵?
6.1 价格全景对比
| Kimi K3 | $3.00 | $15.00 | $0.30 | 国产旗舰价位 |
| Claude Fable 5 | $10.00 | $50.00 | $2.50 | 全球最贵 |
| GPT-5.6 Sol | $5.00 | $30.00 | $2.50 | 高端闭源 |
| Claude Opus 4.8 | $5.00 | $25.00 | $2.50 | 高端闭源 |
| GPT-5.6 Terra | $2.50 | $15.00 | $1.25 | 闭源中端 |
| GLM-5.2 | $1.40 | $4.40 | — | 国产中端 |
| DeepSeek V4 Pro | $0.42 | $0.87 | $0.07 | 极致性价比 |
6.2 不抖机灵,算笔真实账
K3 的输出价格是 DeepSeek V4 Pro 的 17 倍。但单看 token 单价会高估真实成本,三个因素要算进去:
① 缓存命中率 90%+
编程场景下,系统提示词+代码库上下文通常不变。缓存命中后输入成本从 $3 → $0.3,实际每次请求的输入成本接近缓存价。
② 任务完成需要的 token 更少
Artificial Analysis 实测数据:K3 完成同一编程任务的 token 消耗仅为 GLM-5.2 的 一半。因为 K3 的 thinking 虽然冗长,但答案更精准——少返工、少纠正,实际完成任务的总成本反而更低。
③ 单任务综合成本对比:
| Claude Fable 5 | $1.80 | 60 |
| GPT-5.6 Sol | $1.04 | 59 |
| Kimi K3 | $0.94 | 57 |
| Claude Opus 4.8 | $1.80 | 55 |
| DeepSeek V4 Pro | $0.12 | 52 |
K3 的单任务综合成本比 GPT-5.6 Sol 还低 10%,是 Claude Opus 4.8 的一半。贵在单价,省在效率。
6.3 速度实测
| 简单问答(<500 token) | ~30 tok/s | DeepSeek V4 约 80 tok/s |
| 代码生成(2000 token) | ~25 tok/s | GPT-5.6 Sol 约 50 tok/s |
| Agent 长任务 | ~20 tok/s | 高峰期降到 10-15 tok/s |
| 首 token 延迟(TTFT) | 2-5 秒 | GPT-5.6 Sol <1 秒 |
K3 慢。这是目前最大的体验短板。复杂 Agent 任务耗时 30-40 分钟是常态。月之暗面自己承认,“受服务器负载和模型规模影响”。开源后(7 月 27 日)第三方云服务商提供推理服务,速度问题应该会改善。
七、开发者踩坑实录
实测一周,踩了 5 个坑。分享出来省你时间。
坑 1:Reasoning Content 丢了就失忆
现象:多轮对话中,第二轮开始 K3 的回答质量断崖式下降,开始胡说八道。
原因:K3 的 reasoning_content 必须完整保留并回传。如果你用 OpenAI SDK 默认行为,reasoning_content 不会被自动附加到消息历史中。
解决:
messages = []
for turn in conversation:
msg = {"role": turn["role"], "content": turn["content"]}
# 🚀 关键:保留 reasoning_content
if turn.get("reasoning_content"):
msg["reasoning_content"] = turn["reasoning_content"]
messages.append(msg)
坑 2:图片 base64 把 Token 烧光了
现象:用 K3 批量分析 10 张产品截图,一次请求消耗了当月 30% 的 token 额度。
原因:K3 只接受 base64 图片,一张 1920×1080 的截图编码后约 2-3MB,约等于 40 万 token。10 张就是 400 万 token 的输入——按 $3/M 算,一次请求 $12。
解决:
from PIL import Image
import io
def compress_image_for_k3(image_path, max_width=1024, quality=70):
"""压缩图片后再 base64,token 消耗降低 80%"""
img = Image.open(image_path)
if img.width > max_width:
ratio = max_width / img.width
img = img.resize((max_width, int(img.height * ratio)))
buf = io.BytesIO()
img.save(buf, format="JPEG", quality=quality)
return buf.getvalue()
# 1920×1080 原图 → 1024×576 JPEG 70% → 约 100KB → 仅 1.5 万 token
坑 3:C 端会员的隐藏限制
现象:开了 199 元会员,用了 4 个任务(生成网页游戏 + 代码重构 + Agent 项目 + API 测试)就提示"额度不足"。
真相:
- 49 元套餐:不支持 K3
- 99 元套餐:支持 K3 但上下文仅 256K(非满血)
- 199 元套餐:满血 1M 上下文,但 token 额度盯得很紧
- 所有 C 端套餐都受"5 小时连续使用"和 token 总量双重限制
建议:重度使用直接走 API,别走 C 端会员。API 虽然也贵,但至少不限制上下文和连续使用时长。
坑 4:高峰期 API 不稳定
K3 发布后 48 小时用户量爆炸,导致:
- 算力不足,C 端新用户暂停订阅
- API 高峰期偶发 400/429/503 错误
- Agent 任务中途掉线(卡一小时不动)
解决:加重试 + 指数退避 + 高峰期避开(工作日晚 8-11 点为高峰)。
import time
from openai import APIError, APITimeoutError
def call_with_retry(messages, max_retries=3):
for attempt in range(max_retries):
try:
return client.chat.completions.create(
model="kimi-k3",
messages=messages,
timeout=120, # Agent 任务设长超时
)
except (APIError, APITimeoutError) as e:
if attempt == max_retries – 1:
raise
wait = 2 ** attempt * 5 # 5s → 10s → 20s
print(f"API 错误,{wait}s 后重试… ({e})")
time.sleep(wait)
坑 5:Thinking 无法关闭
K3 的 reasoning_effort 只支持 "max",不支持 "low" 或 "off"。简单问题(如"1+1=?")也会触发完整 thinking 过程,产生 200+ token 的思考链。
应对:简单任务别用 K3,用 DeepSeek V4 或 GLM-5.2 即可。K3 只适合复杂推理、代码生成、Agent 自主执行这三类高价值场景。
八、总结:谁该用?谁该等?
✅ 推荐使用 K3 的场景
前端/全栈工程师做复杂交互页面:K3 是当前最强的"前端 AI 程序员",Frontend Code Arena 全球第一不是吹的。网页游戏、Dashboard、可视化工具、动画效果——交给 K3,比雇一个初级前端靠谱。
需要 Agent 自主完成长任务的团队:K3 的 Agent Swarm 能力超越所有开源模型,接近 GPT-5.6 Sol/Fable 5。38 分钟独立交付完整项目的能力,值回 API 费用。
需要处理超大代码库的开发者:100 万 token 上下文 + KDA 高效注意力,是整个代码库塞进 prompt 的首选方案。代码审查、重构、迁移——能"读完"整个项目的只有它。
❌ 不推荐 K3 的场景
预算有限的日常使用:简单问答、代码补全、文档润色——DeepSeek V4 完全够用,价格便宜 30 倍。
对速度有要求的交互场景:目前 K3 输出速度约 25-30 tok/s,Agent 任务 30 分钟起。如果需要"秒回"的体验,GPT-5.6 Sol 或 Claude Sonnet 更合适。
📊 一句话总评
Kimi K3 是国产大模型从"性价比替代"到"能力对标"的分水岭。它证明了不用卖白菜价也能做出有竞争力的顶级模型——但速度、稳定性和性价比的短板,决定了它现在是"尖刀"而非"瑞士军刀"。
实测时间:2026 年 7 月 17 日 – 7 月 24 日 测试环境:Kimi K3 API(kimi-k3)+ Kimi Code(C 端会员 199 元档) 信息来源:月之暗面官方技术博客、知乎实测帖、Artificial Analysis、DataCamp 教程、Dev.to 开发者分享