日志审计别再人肉搬砖:RPA+AI 让 GXP 合规从"天"缩到"分钟"
Windows 日志导出保姆级教学(事件查看器 + wevtutil + 影刀 RPA)
上篇我们讲了怎么把 Windows 日志导出成 TXT(就放在 C:\\日志审计\\审计报告_缓存\\系统日志.txt)。 但 TXT 是"给人看的",Excel 和 AI 要的是"表"。今天这篇只干一件事:把那坨 TXT 变成"一行一事件、一列一字段"的 Excel——这正是六步框架里的第二步"格式转换与结构化"。 全文都是能直接抄的代码和正则,踩过的坑也都标出来了。建议配合上篇一起看。
公众号标题建议(填在标题栏,不在正文):
日志别再人肉填表:正则 + Python + 影刀,TXT 一键变 Excel
一、为什么必须结构化?不能直接丢给 AI 吗?
很多人第一反应是:TXT 直接丢给 AI 不就行了?
能,但不划算、不可控、不可复现:
所以正确姿势是:先结构化成 Excel(确定性、可复现),再把 Excel 喂给 AI 做研判(需要认知判断的部分)。RPA 干确定的活,AI 干判断的活——这套分工从第一篇就定了。
二、我们要解析出哪些字段?
拿一条真实的系统日志为例:
Event[0]: Log Name: System Source: Service Control Manager Date: 2025-07-17T10:30:00.000 Event ID: 7036 Task: N/A Level: Information Opcode: N/A Keyword: Classic User: N/A User Name: N/A Computer: PC-NAME Description:The Workstation service entered the running state.
审计里真正用得上的字段,这张表一次说清:
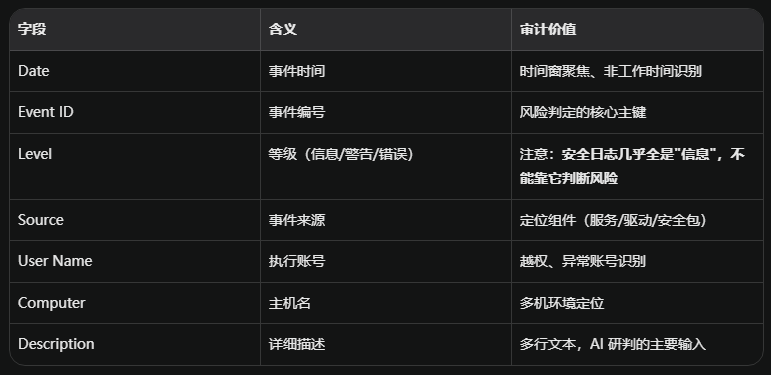
Excel 就按这 7 列建表头,每条事件占一行。
💡 我们聚焦最常用、审计价值最高的 7 个字段;Keyword、Task 等辅助字段对风险判定帮助有限,暂不单列(需要时可按同样的 字段名: 值 正则补列,不影响下游)。
三、核心武器:正则表达式
结构化本质就是"从固定格式的文本里抠字段"。Windows 事件日志的格式非常规律,正则是最省事的工具。
1. 单字段提取
逐字段的正则(每条都验证过可直接用):
import re EventID = r'Event ID:\\s*(\\d+)'Date = r'Date:\\s*([^\\r\\n]+)'Level = r'Level:\\s*([^\\r\\n]+)'Source = r'Source:\\s*([^\\r\\n]+)'Computer = r'Computer:\\s*([^\\r\\n]+)'UserName = r'User Name:\\s*([^\\r\\n]+)'
[^\\r\\n]+ 表示"匹配到行尾为止",避免跨行。
2. 重头戏:Description 多行提取
Description: 后面是一段可能换行的文本,直到下一个事件的空行才结束。这是最容易写错的地方。
正确写法(非贪婪 + 前瞻边界):
Description = r'Description:\\s+([\\s\\S]*?)(?=\\n\\s*$|\\Z)'

拆解:
- ([\\s\\S]*?)
:非贪婪匹配任意字符(含换行),? 很关键,否则会一直吃到文件末尾
- (?=\\n\\s*$|\\Z)
:前瞻断言,匹配"后面是空行"或"文件结尾"才停
⚠️ 曾经踩过的坑:早期用 Description:\\s+([\\s\\S]?)\\n\\s使用者: 来收尾,安全日志能用,但系统日志没有"使用者:"这个子字段,直接失效。改成上面的"空行/结尾"边界,安全日志、系统日志通吃。
3. 完整提取:先切块,再抠字段
最稳的做法是先把整份 TXT 按 Event[N]: 切成一条条事件块,再在每块里抠字段:
import re path = r”C:\\日志审计\\审计报告_缓存\\系统日志.txt”text = open(path, encoding=”utf-8”).read() # 按事件块切分(前瞻断言,不消耗分隔符)pattern_block = re.compile(r'Event\\[\\d+\\]:(.*?)(?=Event\\[\\d+\\]:|\\Z)', re.S)blocks = pattern_block.findall(text) def get_field(block, pat): m = re.search(pat, block) return m.group(1).strip() if m else ”” rows = []for b in blocks: desc = get_field(b, r'Description:\\s+([\\s\\S]*?)(?=\\n\\s*$|\\Z)')
# 去掉 Description 尾部固定空行(见第六节坑 1) desc = re.sub(r'(?:\\r?\\n[ \\t]*)+$', '', desc) rows.append({ ”Date”: get_field(b, r'Date:\\s*([^\\r\\n]+)'), ”EventID”: get_field(b, r'Event ID:\\s*(\\d+)'), ”Level”: get_field(b, r'Level:\\s*([^\\r\\n]+)'), ”Source”: get_field(b, r'Source:\\s*([^\\r\\n]+)'), ”UserName”: get_field(b, r'User Name:\\s*([^\\r\\n]+)'), ”Computer”: get_field(b, r'Computer:\\s*([^\\r\\n]+)'), ”Description”: desc, })
rows 就是结构化后的数据,可以直接写 Excel。
四、影刀 RPA 里怎么落地
如果你不想碰 Python,纯影刀也能做。核心是两个组件:"从文本中提取内容"+"写入 Excel"。
步骤
-
Event ID → Event ID:\\s*(\\d+)
-
Date → Date:\\s*([^\\r\\n]+)
-
Description → Description:\\s+([\\s\\S]?)(?=\\n\\s$|\\Z)
-
……其余同理
⚠️ 影刀正则框的隐藏坑:直接在组件里粘贴正则时,影刀 UI 可能把 \\d 之类的转义字符自动转义成 Event$$\\d+$$: 这种乱码,导致匹配失败。解法:把正则框清空,手动重新打一遍,不要从别处整段粘贴。这是血泪教训。
💡 Description 尾部空行:影刀写 Excel 时,Description 单元格里经常会多出一串空行(wevtutil 导出时固定的)。在写入前加一个"去除文本首尾空白"组件(等价于 strip()),或者在正则里用上面的前瞻边界,基本能消掉。
五、Python 版:一次生成完整 Excel
如果你用影刀的"Python"脚本步骤,下面这段能一条龙把 TXT 变成 .xlsx,比逐个组件拼更稳:
import refrom openpyxl import Workbook path = r”C:\\日志审计\\审计报告_缓存\\系统日志.txt”out = r”C:\\日志审计\\审计报告_缓存\\系统日志_结构化.xlsx” text = open(path, encoding=”utf-8”).read() pattern_block = re.compile(r'Event\\[\\d+\\]:(.*?)(?=Event\\[\\d+\\]:|\\Z)', re.S)blocks = pattern_block.findall(text) def get_field(block, pat): m = re.search(pat, block) return m.group(1).strip() if m else ”” wb = Workbook()ws = wb.activews.append([”Date”, ”EventID”, ”Level”, ”Source”, ”UserName”, ”Computer”, ”Description”]) for b in blocks: desc = get_field(b, r'Description:\\s+([\\s\\S]*?)(?=\\n\\s*$|\\Z)') desc = re.sub(r'(?:\\r?\\n[ \\t]*)+$', '', desc) # 去尾部空行 ws.append([ get_field(b, r'Date:\\s*([^\\r\\n]+)'), get_field(b, r'Event ID:\\s*(\\d+)'), get_field(b, r'Level:\\s*([^\\r\\n]+)'), get_field(b, r'Source:\\s*([^\\r\\n]+)'), get_field(b, r'User Name:\\s*([^\\r\\n]+)'), get_field(b, r'Computer:\\s*([^\\r\\n]+)'), desc, ]) wb.save(out)print(f”已生成结构化 Excel:{out},共 {len(blocks)} 条事件”)
跑完,你就得到一份标准 Excel:每行一条事件,每列一个字段。后续无论筛选、统计、还是整列喂给 AI,都顺了。
💡 没装 openpyxl?pip install openpyxl 即可。如果影刀环境装不了,也可以先写成 .csv(Python 内置 csv 模块,无需额外依赖),影刀再读取。
六、几个关键坑,提前帮你踩了
wevtutil 导出的 TXT,每条事件描述后面都跟着固定空行。直接写 Excel,单元格里就多一串空行。 → 用 re.sub(r'(?:\\r?\\n[ \\t]*)+$', '', desc) 只去尾部空行;或影刀加"去除首尾空白"。
别指望靠 Level: 错误 来抓风险——安全日志里登录失败(4625)、账号创建(4720) 通通是"信息"级别。 → 风险判定靠 Event ID,不靠 Level。这是 GXP 审计的铁律。
同一个 Event ID 在不同"来源(Source)"下含义可能不同;而且 Windows 版本升级时,少数 ID 会变。 → 在 Excel 里同时保留 Event ID 和 Source 两列,做判定时双键匹配,跨版本更稳。
你导出的 System 和 Security 日志,字段结构几乎一样,上面这套正则可通吃。但 ForwardedEvents(转发事件)等特例结构可能不同,解析前先抽一条看看格式。
命令行 wevtutil 默认编码可能是 GBK,不是 UTF-8。Python 读文件时如果乱码,把 encoding="utf-8" 改成 encoding="gbk"(或 "utf-8-sig")试试。 → 影刀"读取文本文件"组件也有编码选项,导出的 TXT 是 GBK 就选 GBK。
提取多行 Description 时,忘了写 ?(非贪婪),会一直匹配到文件最后。 → 永远用 (.*?) / ([\\s\\S]*?) 的非贪婪形式,配合前瞻边界收尾。
七、写在最后:下一篇写什么,评论区你说了算
这篇把"TXT → Excel 结构化"彻底打通了。下一步二选一,你点哪个我就写哪个:
- A. AI 怎么研判一条日志
:把结构化后的 Excel 喂给大模型,事件定性 + 风险分级(高/中/低/可忽略)+ 法规关联(21 CFR Part 11 / Annex 11 / ALCOA+),Prompt 模板直接给你。
- B. 异常检测从"规则"到"模型"
:用历史日志训练你的专属异常基线,减少误报,比单纯规则初筛更聪明。
你最想看哪块?评论区点单,下篇就写你点的那块。 做合规、做 CSV、做 IT 运维的朋友,码住这套流程,转发给需要的同事 👇
附:本文正则速查表
# 按事件块切分re.compile(r'Event\\[\\d+\\]:(.*?)(?=Event\\[\\d+\\]:|\\Z)', re.S) # 单字段EventID = r'Event ID:\\s*(\\d+)'Date = r'Date:\\s*([^\\r\\n]+)'Level = r'Level:\\s*([^\\r\\n]+)'Source = r'Source:\\s*([^\\r\\n]+)'Computer = r'Computer:\\s*([^\\r\\n]+)'UserName = r'User Name:\\s*([^\\r\\n]+)' # Description 多行(核心)Description = r'Description:\\s+([\\s\\S]*?)(?=\\n\\s*$|\\Z)' # 去 Description 尾部空行re.sub(r'(?:\\r?\\n[ \\t]*)+$', '', desc)