前言
你花了 3 天搭好一个爬虫,跑了一个星期,然后目标网站改版了。是不是很熟悉的感觉?
布局变了,CSS 选择器失效;反爬升级,IP 被封;前端框架一换,Playwright 脚本直接报错。你又开始翻 DOM、改 XPath、调代理池——循环往复,维护成本比写第一版还高。
如果你正在评估可扩展爬虫方案 vs 自建 Scrapy/Playwright,这篇文章演示 Bright Data Scraper Studio 如何把写爬虫 → 跑爬虫 → 修爬虫压缩成一条无需自行维护服务器的数据管道。
🚀 免费体验 Scraper Studio,用自然语言生成你的第一个 AI 爬虫(每月提供免费页面加载额度,无需信用卡)。
一、Scraper Studio 是什么?
Bright Data Scraper Studio 是一个 AI 驱动的网页数据管道构建平台:用自然语言描述你要什么数据,AI 生成生产就绪的爬虫代码;代理轮换、CAPTCHA 解决、JS 渲染全部内置,运行在 Bright Data 云端——你不需要买服务器、搭代理池、维护 Docker。
适合谁?
| Python / JS 开发者 | 不想再为网站小改版手动修选择器 |
| 数据工程师 | 需要可定时、可交付的结构化数据管道 |
| 电商 / 业务分析师 | 要商品、价格、评论等字段,但没时间写爬虫 |
| 技术负责人 | 评估托管方案 vs 自建系统的 TCO |
| 低代码用户 | 用提示词构建爬虫,而非从零写代码 |
Scraper Studio 适合哪些网站?
例如:电商、新闻、招聘、房地产、企业目录、博客
四大核心支柱:
- AI 代码生成 — 提示词 → 完整爬虫 + 输出 Schema
- 一键自愈(Self-Healing) — 网站改版时 AI 自动修复,Collector ID 不变
- 托管基础设施 — 400M+ 代理 IP、反封禁、浏览器渲染、自动重试
- 定时调度 + 多端交付 — 每日/每周/自定义间隔 → JSON / CSV / Parquet → S3、GCS、BigQuery、Snowflake、Webhook
免费额度: 每月 5,000 次页面加载,注册无需信用卡。首次充值还有 1:1 匹配奖励,最高 $500。
合规提醒: Scraper Studio 仅支持公开可访问的数据抓取,不支持登录后内容。使用前请确认目标数据符合当地法规与网站服务条款。
二、三步工作流:从需求到数据
1、定义数据需求
首先登陆到Bright Data控制面板,选择爬取器
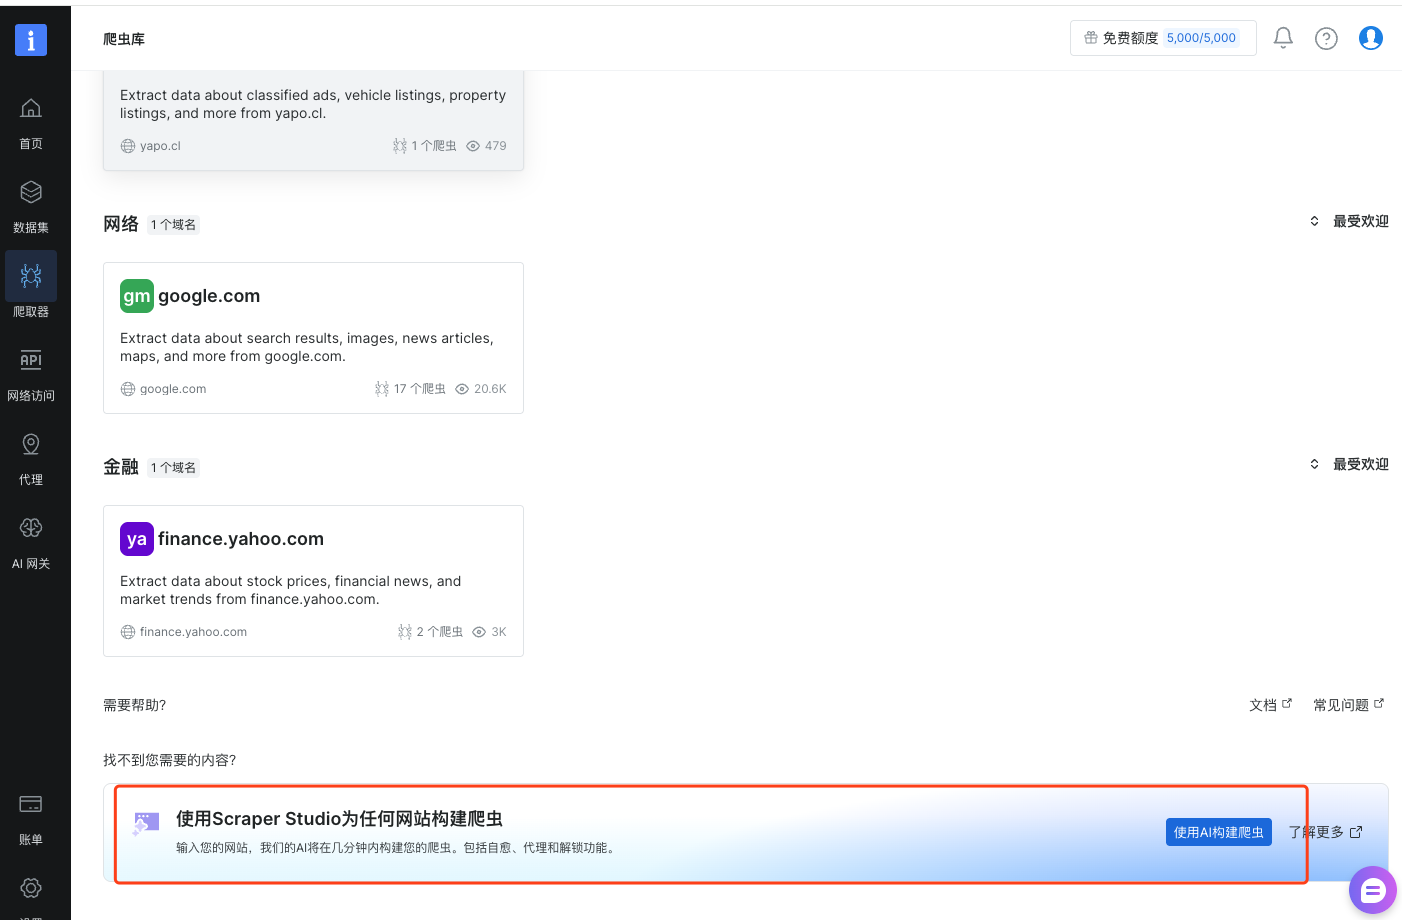
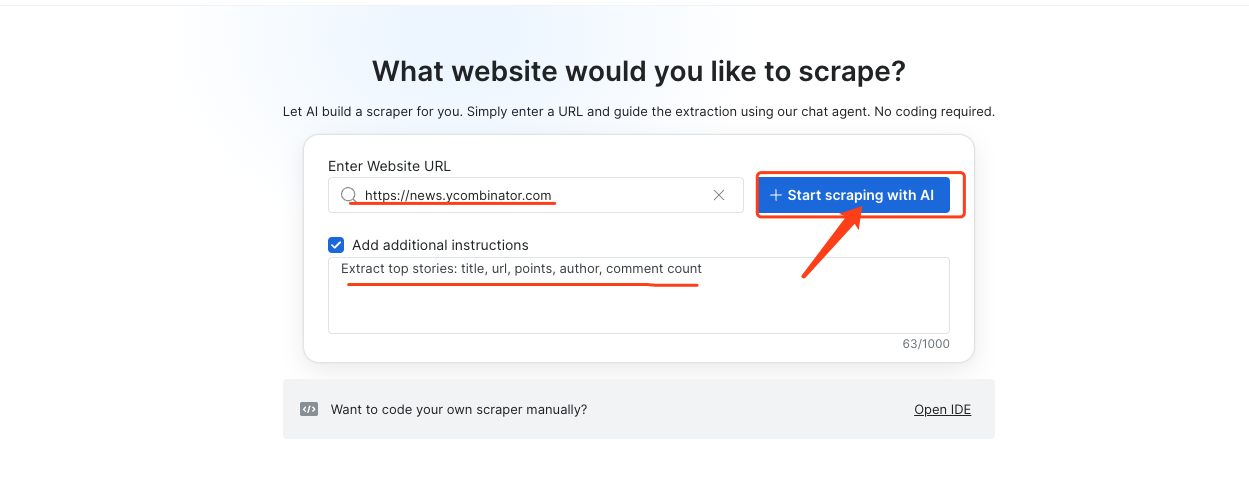
选择“使用AI构建爬虫”,在控制台选择目标网站,用自然语言描述字段。例如:
提取 Hacker News 首页 Top Stories:标题、链接、得分、作者、评论数。
2、AI 生成爬虫 API
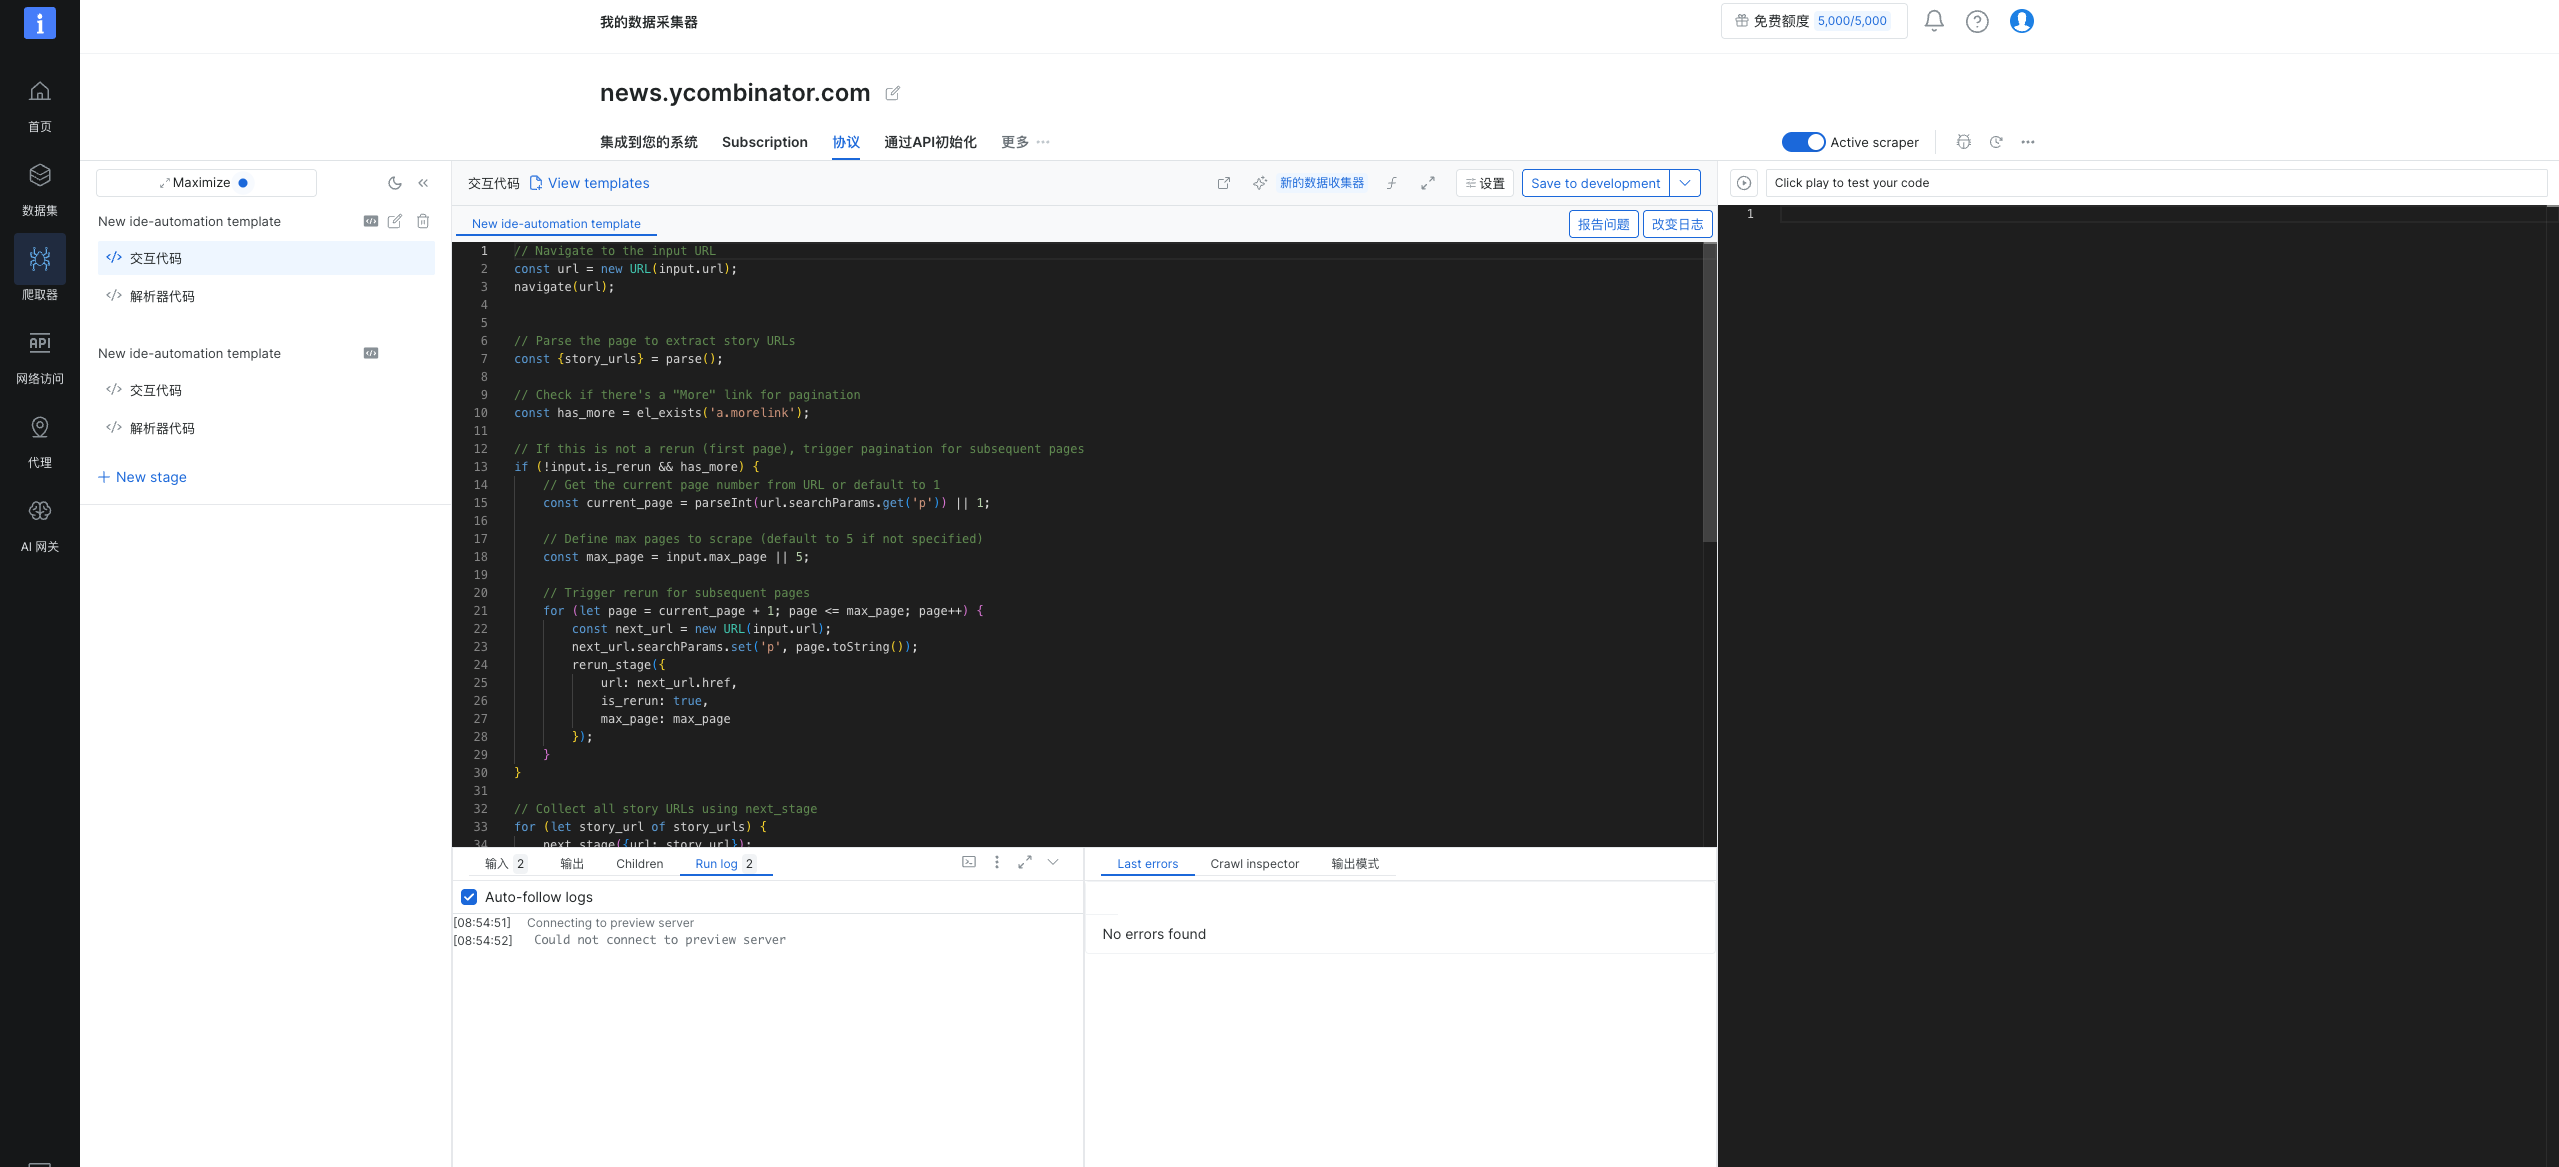
提交后,AI 流水线依次执行意图分析、Schema 生成、代码生成、预览运行等阶段,通常 5–15 分钟(复杂站点可达 25 分钟)。生成完成后,爬虫出现在云端托管 IDE 中——你可以查看代码、在线调试、手动微调,代理已自动配置好。
3、调度运行 & 数据交付
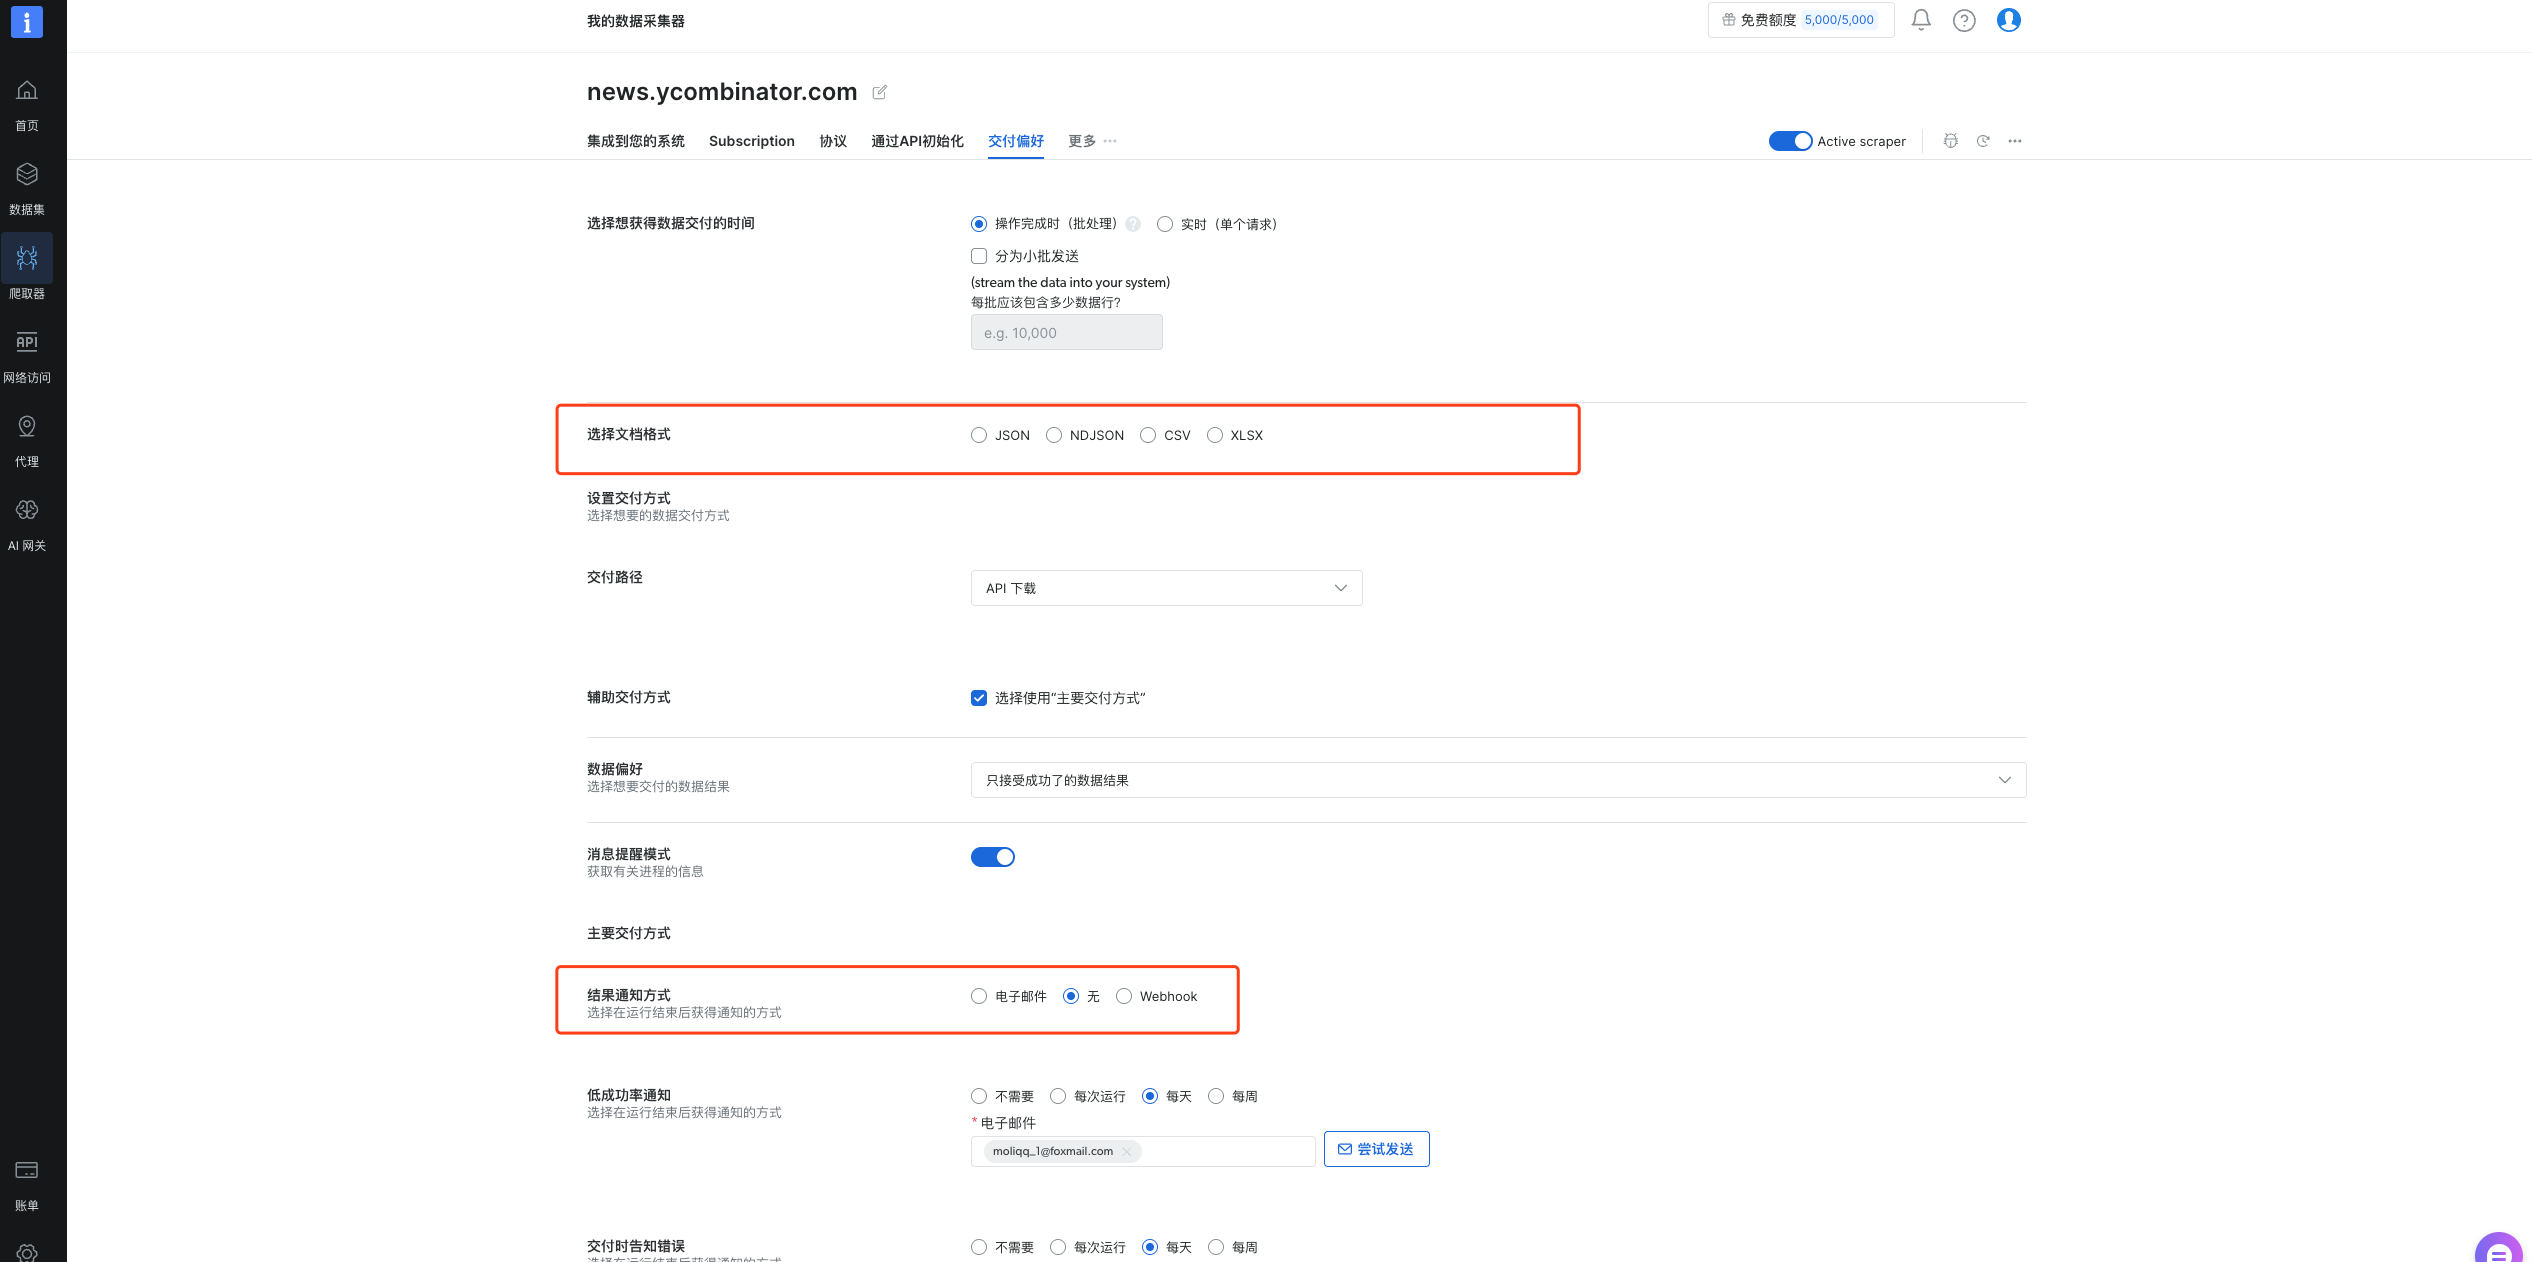
测试通过后,在 Subscription 标签设置调度周期(每日 / 每周 / 自定义间隔),并配置交付目的地。
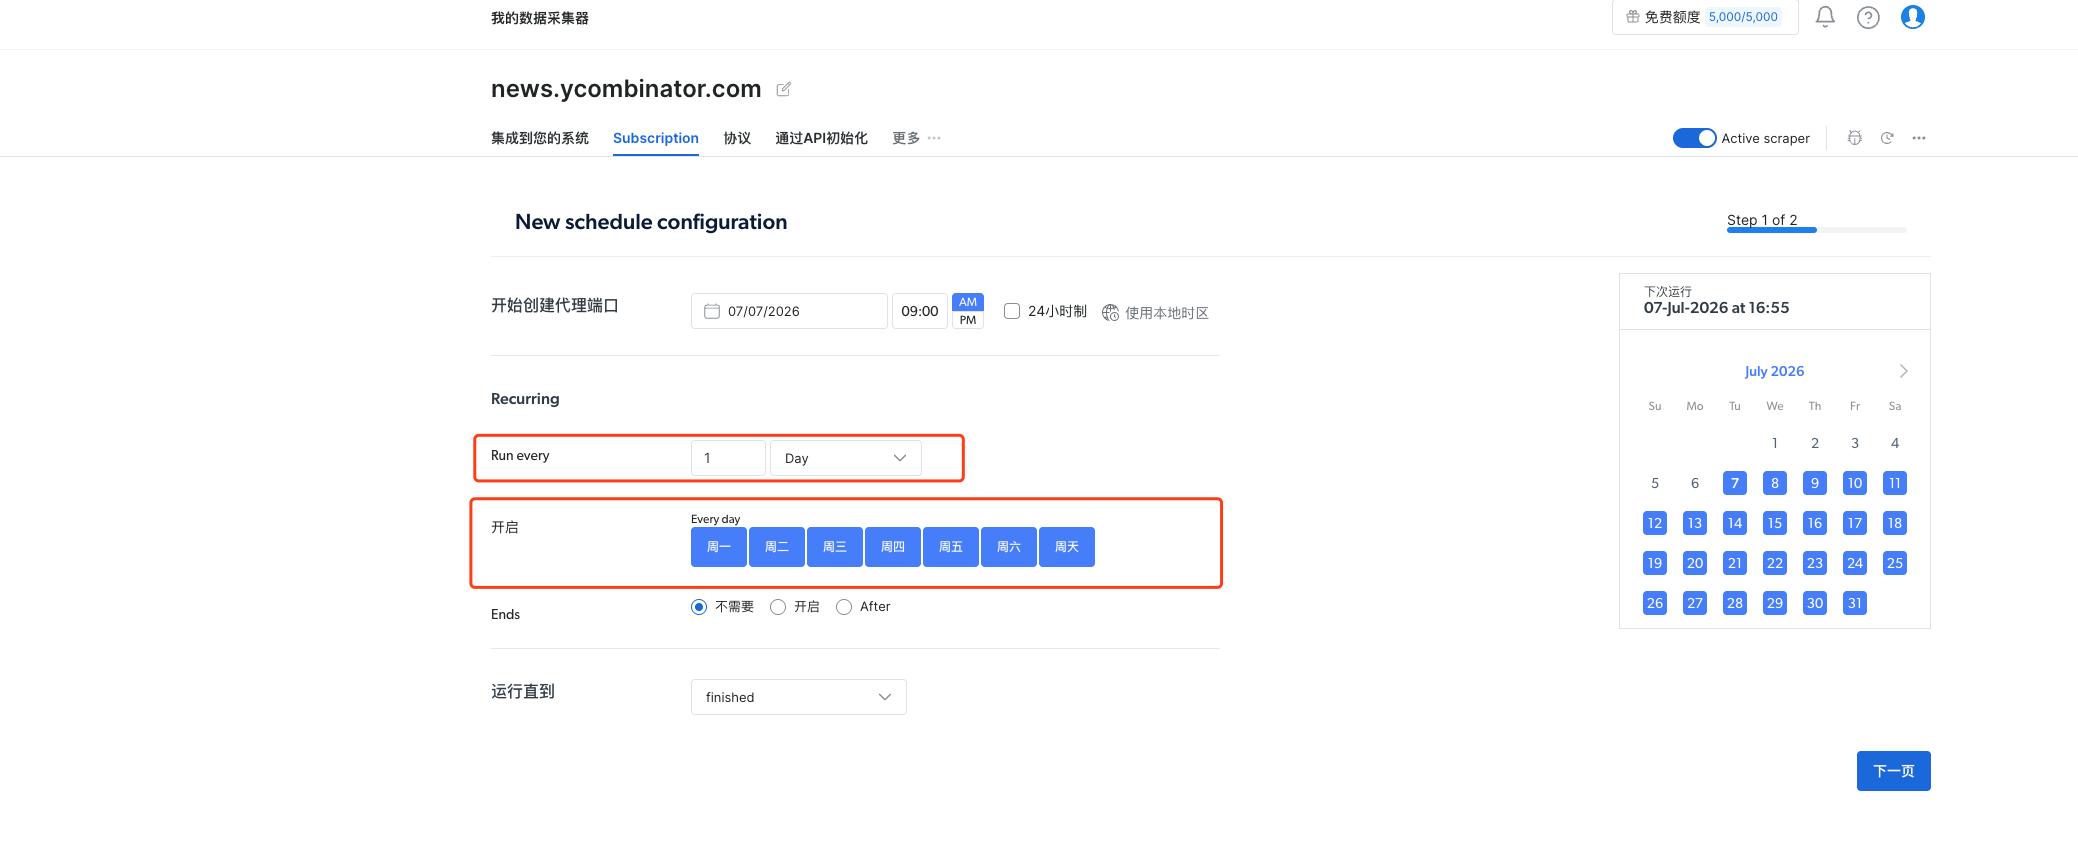
数据默认以 JSON 输出,也可选 CSV、Parquet,或直接写入云存储与数据仓库。
三、实战演示:10 分钟搭一个 Hacker News Top Stories 爬虫
我选 Hacker News 做 Demo——结构清晰、公开可访问,也是 Bright Data 官方 CLI 教程的示例站点。完整流程:提示词 → 生成 → 运行 → JSON 输出。
1、Bright Data控制面板
在 Scraper Studio 输入:
目标 URL:https://news.ycombinator.com
提示词:Extract top stories: title, url, points, author, comment count
AI 生成完成后点 Run,即可在 IDE 右侧看到结构化结果。
2、CLI 方式(同样走 Scraper Studio 后端)
在终端输入下面命令,一次性登录(OAuth,无需手动复制 API Key)
npx -p @brightdata/cli bdata login
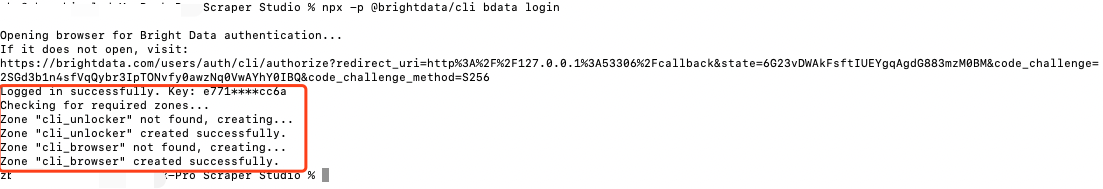
用自然语言创建爬虫,返回 Collector ID
bdata scraper create https://news.ycombinator.com \\
"Extract top stories: title, url, points, author, comment count"
# 运行爬虫,格式化 JSON 输出
bdata scraper run c_mpohus372o5tmid1jk https://news.ycombinator.com –pretty
可以看到正在进行数据抓取
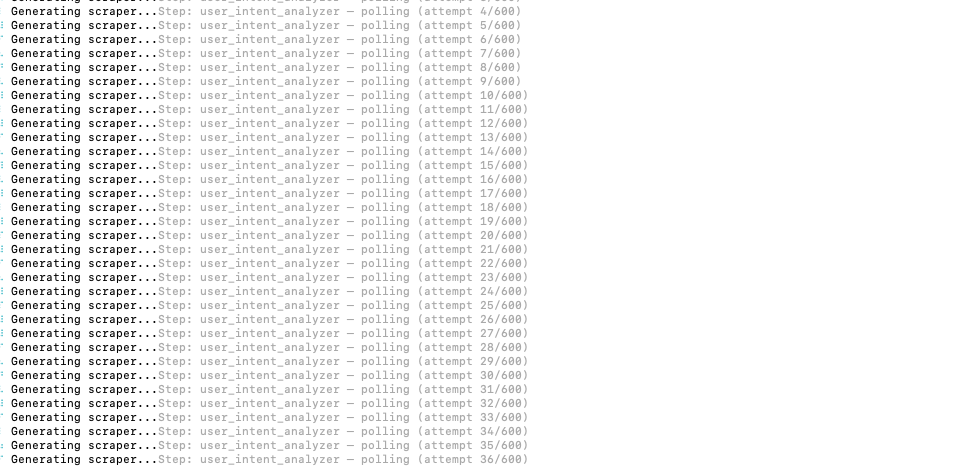
爬取结束之后,可以看到返回了
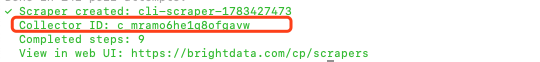
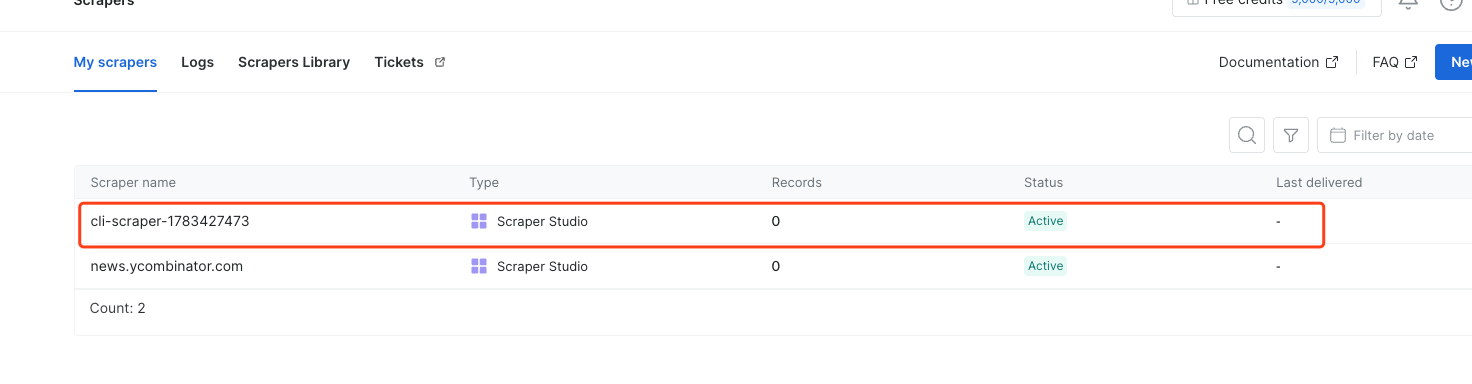
在浏览器输入: https://brightdata.com/cp/scrapers ,查看最终的抓取结果,下面的cli-scraper-1783427473 就是刚刚通过CLI生成的
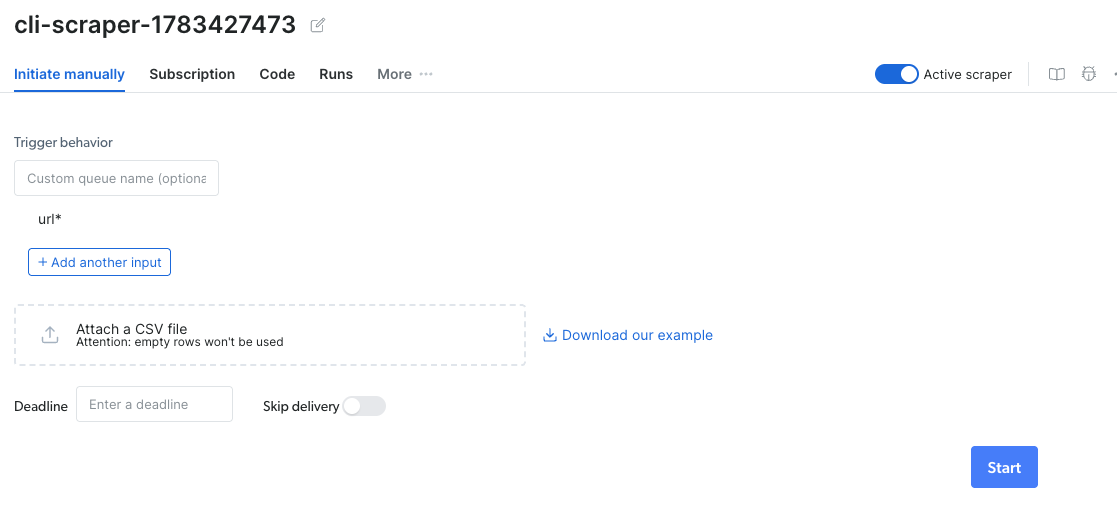
点击“start”
随后最终输出结果
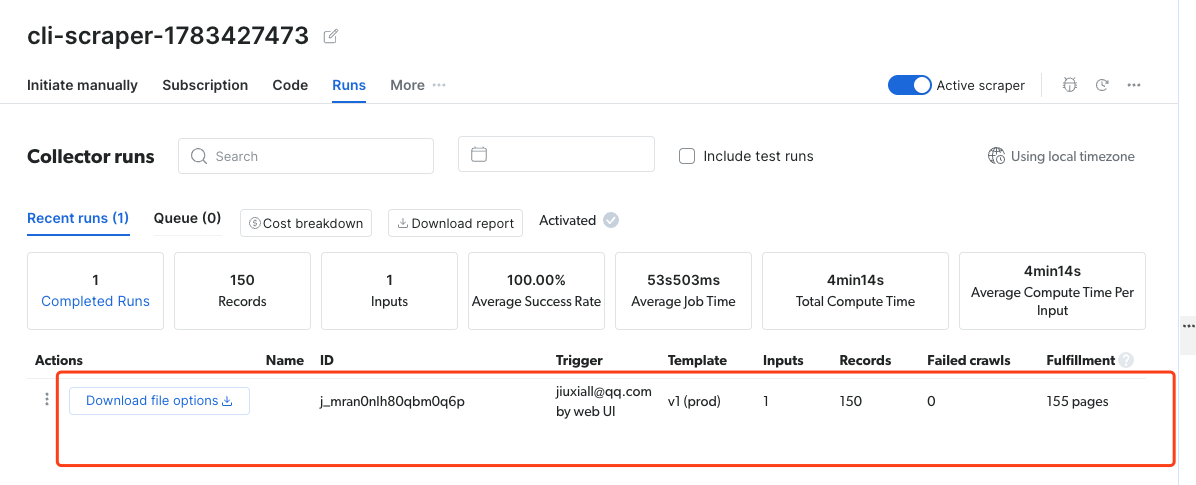
点击下载按钮,输出样本(节选):
{
"title": "Ternlight – 7 MB embedding model that runs in browser (WASM)",
"url": "https://ternlight-demo.vercel.app/",
"points": 269,
"author": "soycaporal",
"comment_count": 1358,
"input": {
"url": "https://news.ycombinator.com"
}
},
{
"title": "Resetting Xbox",
"url": "https://news.xbox.com/en-us/2026/07/06/resetting-xbox/",
"points": 666,
"author": "dijksterhuis",
"comment_count": 22739,
"input": {
"url": "https://news.ycombinator.com"
}
}
已经完成第一个爬虫?接下来可以尝试开启定时调度和 Self-Healing,让采集流程自动持续运行。👉 创建自己的 Scraper Studio 项目
四、自愈功能:维护成本的终结者
Scraper Studio 与 Apify、自建 Scrapy 最大的分水岭,是 Self-Healing(一键自愈) 。
1、自愈解决什么问题?
网站改版后,最常见的事故是:选择器失效 → 字段变 null → 下游 ETL 静默出错。传统做法是人工排查 DOM、改代码、重新部署。Scraper Studio 让 AI 检测 Schema 漂移,在原 Collector 上修复代码,ID 不变——你的定时任务、Webhook、CI 脚本全部不用改引用。
2、控制台操作
在 IDE 中打开 Self-Healing 工具
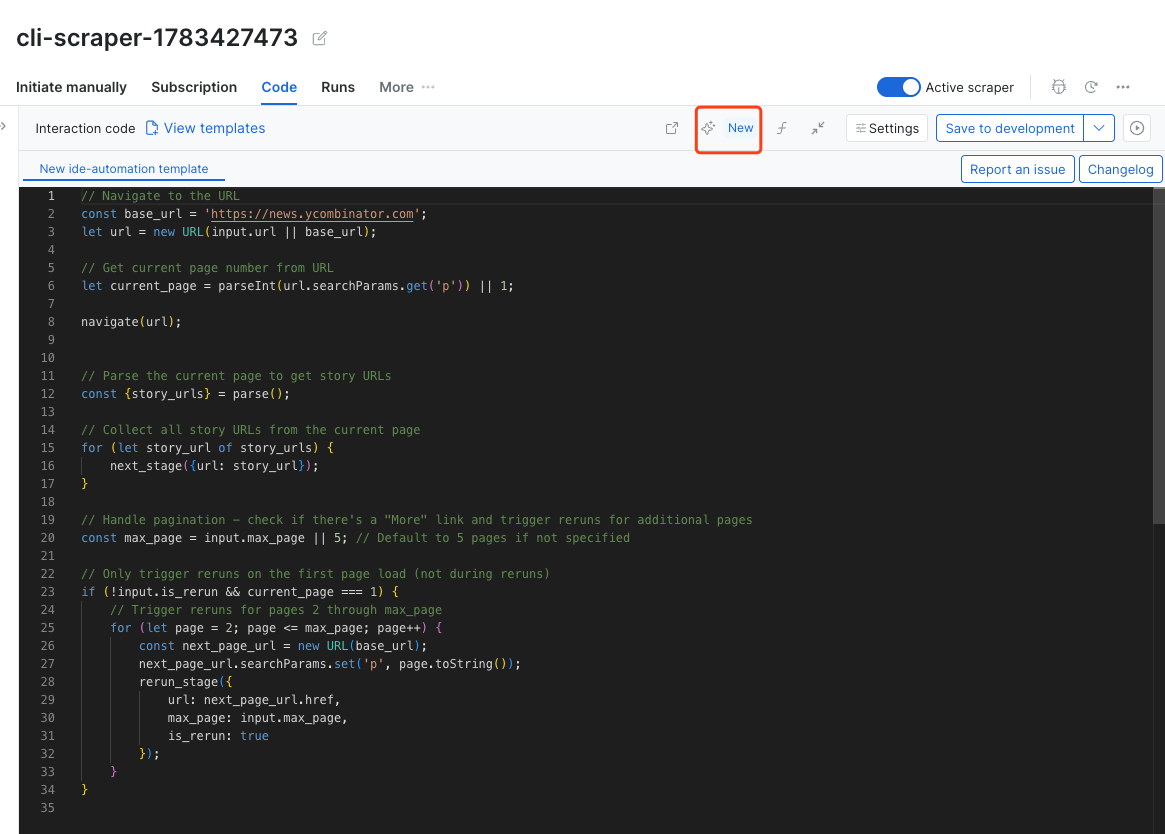
用自然语言描述问题,比如:
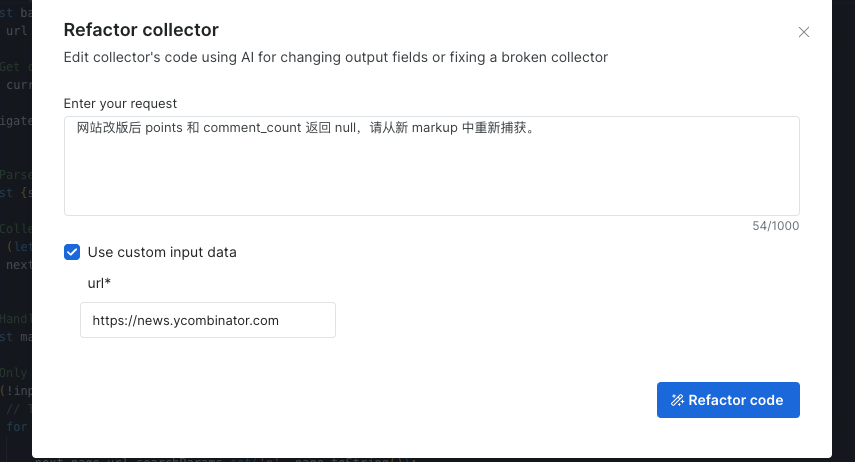
AI 生成修复方案后,先展示 preview_result 供你审核,确认无误再提交——不会 silent deploy 一个你没看过的补丁。
3、CLI 一键修复
# 1. 运行并检查输出
bdata scraper run c_mpohus372o5tmid1jk https://news.ycombinator.com -o run.json
# 2. 发现字段缺失 → 触发自愈(默认停在审批关卡)
bdata scraper heal c_mpohus372o5tmid1jk \\
"The points and comment_count fields return null since the site redesign. Re-capture them from the new markup." \\
–url https://news.ycombinator.com
# 3. 审核 preview 后批准
bdata scraper approve c_mpohus372o5tmid1jk
# 4. 重新运行验证
bdata scraper run c_mpohus372o5tmid1jk https://news.ycombinator.com –pretty
信任自动化流水线时,可加 –auto-approve 跳过人工关卡——适合已充分验证的批量运维场景。
业务价值: 对多站点、多爬虫的团队,日常「修选择器 + 重部署」的工时通常占维护总成本的大头。自愈把这部分从每次改版都要人工介入变成「跑 → 看 → heal → approve → 再跑」,可显著减少因网站改版带来的维护工作。
五、定时调度与数据交付
在 Scraper Studio 控制台的 Subscription 标签,可以为任意 Collector 设置:
| 每日 | 价格监控、新闻聚合 |
| 每周 | 竞品目录快照 |
| 自定义间隔 | 高频库存/库存变动追踪 |
输出格式: JSON(默认)、CSV、Parquet
交付集成: Amazon S3、Google Cloud Storage、Azure Blob、BigQuery、Snowflake、Webhook
典型链路: 每晚 02:00 触发 Amazon 品类页爬虫 → Parquet 写入 S3 → Athena / DuckDB 查询 → Grafana 价格趋势看板。全程无需部署和维护爬虫基础设施。
六、进阶:CLI 与 REST API 触发
Scraper Studio 与 Bright Data CLI 互为补充——Studio 负责可视化构建与调试,CLI / API 负责 CI/CD 与 Agent 集成。
| 创建爬虫 | bdata scraper create “提示词” | POST /dca/collector + automate |
| 运行爬虫 | bdata scraper run <collector_id> [url] | POST /dca/trigger_immediate |
| 自愈修复 | bdata scraper heal <collector_id> “描述” | POST …/refactor_template |
| 批准修复 | bdata scraper approve <collector_id> | POST …/resume_automation_job |
CI/CD 链式调用示例:
# 创建并提取 Collector ID
bdata scraper create https://example.com/products "Extract name, price, rating" \\
–json -o create.json
COLLECTOR_ID=$(jq -r '.collector_id' create.json)
# 触发运行并保存结果
bdata scraper run "$COLLECTOR_ID" https://example.com/products \\
–json -o result.json
Headless 环境(GitHub Actions 等)可设置 BRIGHTDATA_API_KEY 跳过浏览器登录。完整 API 参考见 Scraper Studio 文档。
七、竞品对比:Scraper Studio vs Apify vs 自建
| AI 爬虫自动生成 | ✅ 是 | ⚠️ 基础 | ❌ 否 |
| 一键自愈 | ✅ 是 | ❌ 否 | ❌ 手动修复 |
| 内置代理(400M+ IP) | ✅ 是 | ⚠️ 需额外付费 | ❌ 需单独采购 |
| CAPTCHA 自动解决 | ✅ 内置 | ⚠️ 需额外付费 | ❌ 手动处理 |
| 云端托管 IDE | ✅ 是 | ✅ 是 | ❌ 本地环境 |
| 云存储交付集成 | ✅ S3/GCS/BQ 等 | ⚠️ 部分支持 | ❌ 需自行对接 |
| 免费额度 | ✅ 每月 5K 次 | ✅ 有 | N/A |
| 无需自建服务器 | ✅ 是 | ✅ 是 | ❌ 需自建 |
如果你总是遇到网站一改版爬虫就崩,Scraper Studio 的自愈 + 全托管基础设施是差异化最强的组合;Apify 生态成熟但缺少原生自愈;自建方案灵活度最高,但 TCO 和维护人力也最高。如果团队希望把精力放在数据本身,而不是持续维护爬虫基础设施,Scraper Studio 更适合作为长期的数据采集方案。
👉 免费开始使用Scraper Studio
八、定价说明
| Free | $0 | 5,000 次页面加载/月,无需信用卡 |
| Pay as you go | $1.5 / 1K 次 | 按成功计费,可设月度上限 |
| Scale | $499 / 月 | 383K 次加载 + $1.3/1K 超额 |
| Enterprise | 定制 | 专属客户经理、SSO、Premium SLA |
注册福利:首次充值 1:1 匹配,最高 $500。
👉 点击并输入 mao20 码,直接赠送20$
九、常见问题 FAQ
Q:使用 Scraper Studio 需要有编程基础吗?
不需要写代码即可生成爬虫,但理解「URL、字段、分页、Schema」等抓取概念会帮你写出更好的提示词。进阶用户可在 IDE 中直接改代码。
Q:目标网站屏蔽了我的爬虫怎么办?
Scraper Studio 内置 400M+ 代理 IP、浏览器指纹模拟、CAPTCHA 解决和自动重试。你不需要单独采购代理或 Unlocker 服务。Scraper Studio 已内置代理、浏览器渲染和自动解锁能力,无需单独配置代理网络。
Q:可以抓取需要登录的页面吗?
不可以。平台仅支持公开数据,不支持登录后内容。
Q:定时任务的调度频率有限制吗?
支持每日、每周和自定义间隔。具体上限取决于套餐与页面加载配额,可在控制台 Subscription 中配置。
Q:网站改版导致爬虫崩了,怎么修复?
控制台用 Self-Healing 工具,或 CLI 执行 bdata scraper heal → 审核 preview → bdata scraper approve → 重新 run 验证。Collector ID 保持不变。
总结
网页爬虫的痛点从来不是第一版能不能写出来,而是能不能稳定跑下去。Bright Data Scraper Studio 把这条链路做成了:AI 提示词生成 → 云端托管运行 → 一键自愈维护 → 定时调度交付。对正在评估 AI 网页爬虫工具 2026、无服务器爬虫 或 Scraper Studio vs Apify 的团队,值得用免费额度跑一个真实站点验证。
准备体验 AI 驱动的数据采集?
• 免费创建 Bright Data 账号
• 使用免费额度生成第一个 Scraper
• 再根据项目规模选择按量付费或团队方案按钮:
👉 开始使用Scraper Studio
如果需要大规模部署或企业方案?可联系 Bright Data 团队获取定制支持。