目录
-
- 引言
- 一、哈希表的基础概念
-
- 1. 哈希映射
- 2. 哈希函数设计
-
- 直接定址法
- 除留余数法
- 数字分析法
- 平方取中法
- 二、哈希冲突及其解决方案
-
- 1. 闭散列(开放定址法)
-
- 线性探测
- 二次探测
- 伪删除与载荷因子
- 2. 开散列(链地址法 / 哈希桶)
-
- 结构优势
- 扩容机制
- 三、实战:算法与海量数据处理中的应用
-
- 1. 频次统计与查重
- 2. 海量数据切割(Hash Partition)
- 总结
引言
C++98 提供的关联式容器 std::map 与 std::set 底层均采用红黑树实现,保证元素有序的同时,查找、插入、删除操作的平均时间复杂度为
O
(
log
N
)
O(\\log N)
O(logN)。随着数据规模不断膨胀,即使
O
(
log
N
)
O(\\log N)
O(logN) 也会因为树深度增加而带来不可忽视的比较次数。 理想中的查找是不经过任何比较,直接由关键码(Key)映射到存储位置。C++11 中引入的 unordered_map、unordered_set 等无序关联容器,正是基于这一思想,通过哈希表将平均时间复杂度降至
O
(
1
)
O(1)
O(1)。
一、哈希表的基础概念
1. 哈希映射
哈希表的核心在于哈希函数
f
f
f,它接受任意类型的关键码
K
K
K,输出一个非负整数
f
(
K
)
f(K)
f(K),该整数即为元素在底层数组中的下标。理想情况下,每个关键码都对应唯一的下标,插入与查找只需一次计算即可定位。
例如,假设一个哈希表底层数组长度为 10,定义哈希函数
f
(
x
)
=
x
f(x) = x \\ % \\ 10
f(x)=x ,则关键码 15 映射到下标 5,关键码 23 映射到下标 3。查找时直接计算下标,无需遍历比较。 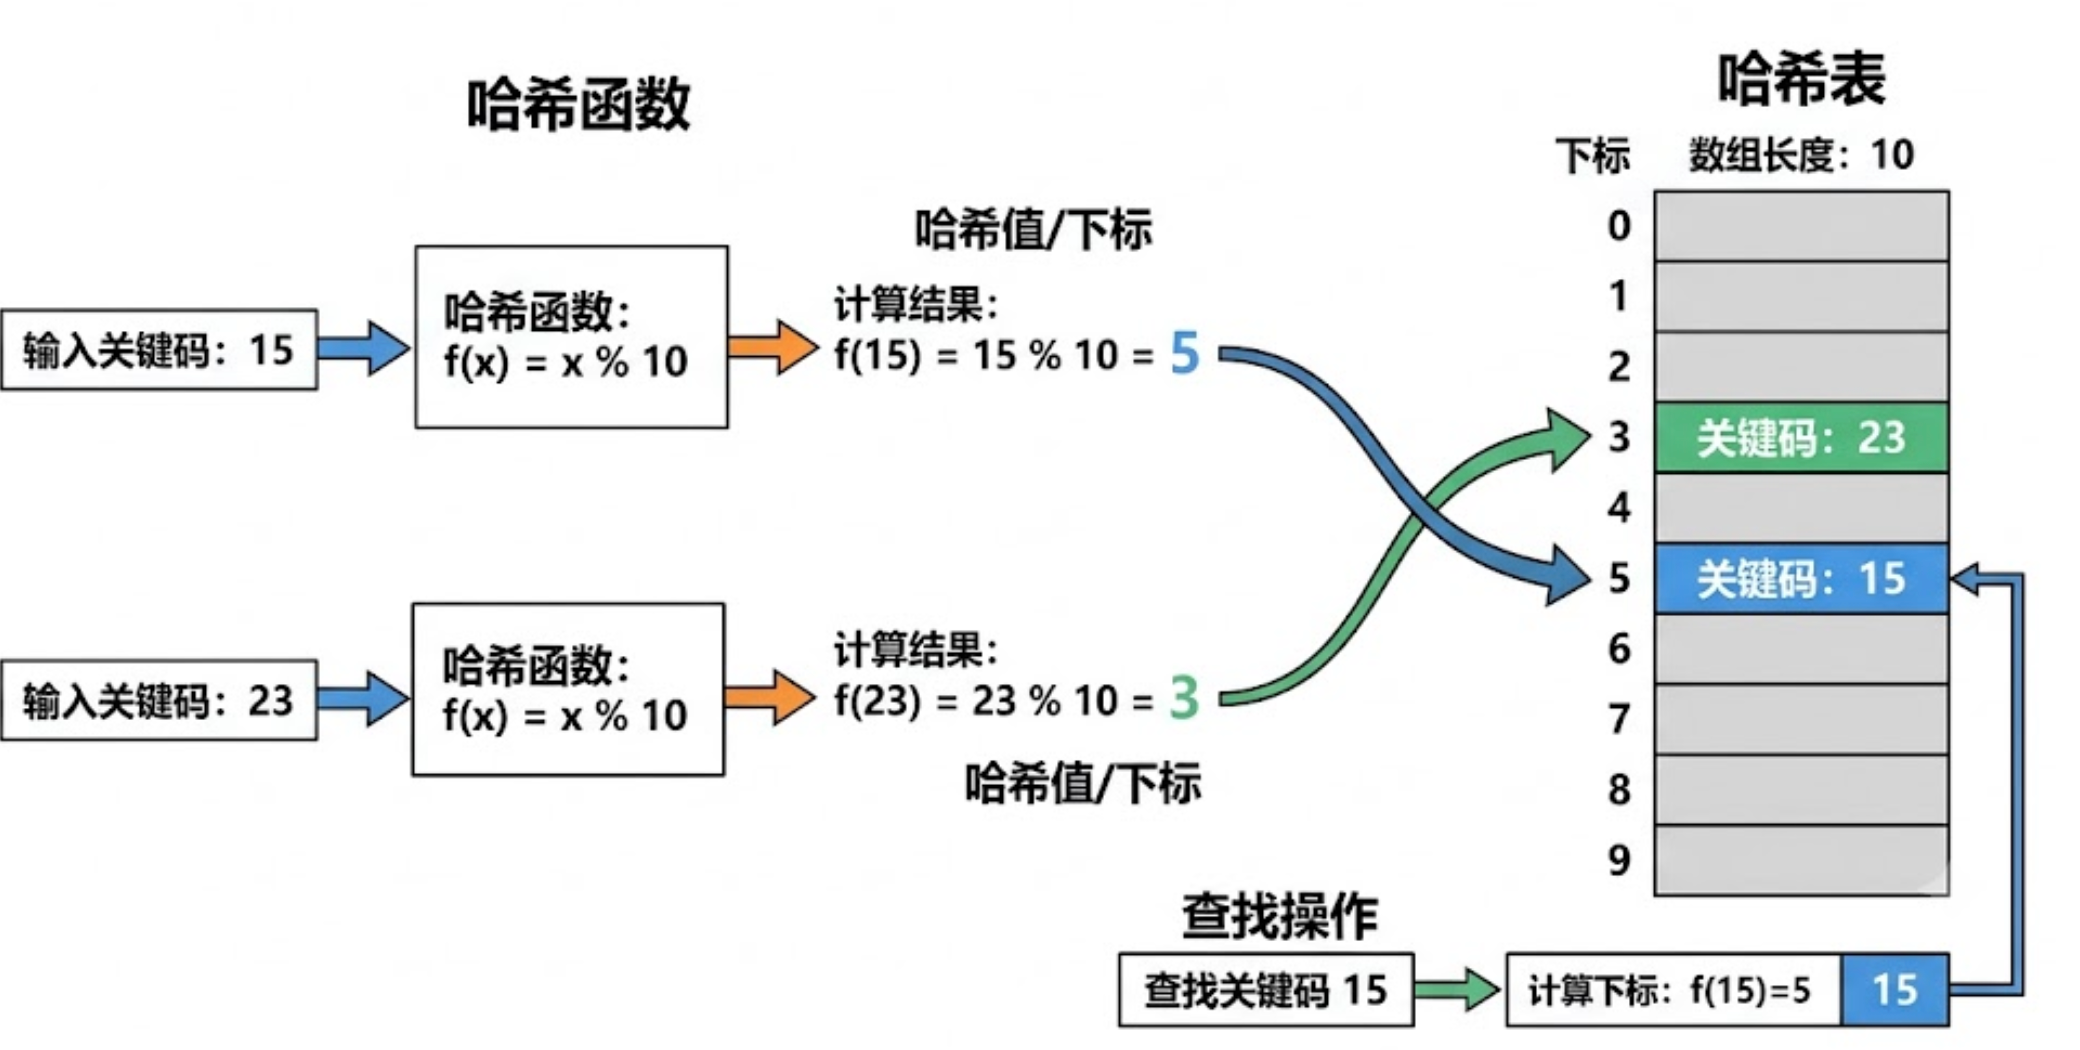
2. 哈希函数设计
哈希函数的好坏直接影响哈希表的性能。设计的三个基本原则:
- 定义域必须覆盖所有可能的关键码。
- 计算结果在值域中分布尽量均匀,避免聚集。
- 计算过程简单,避免成为性能瓶颈。
直接定址法
取关键码的某个线性函数值为下标,如
H
a
s
h
(
K
e
y
)
=
A
×
K
e
y
+
B
Hash(Key) = A \\times Key + B
Hash(Key)=A×Key+B。 适用场景:关键码集合连续且范围较小。例如,用学生学号(连续整数)作为键存储学生信息,可直接用学号作为数组下标。 缺点:若关键码分布稀疏,会浪费大量数组空间。例如,关键码只有 1 和 10000,直接定址需要数组长度 10001,中间位置全部闲置。 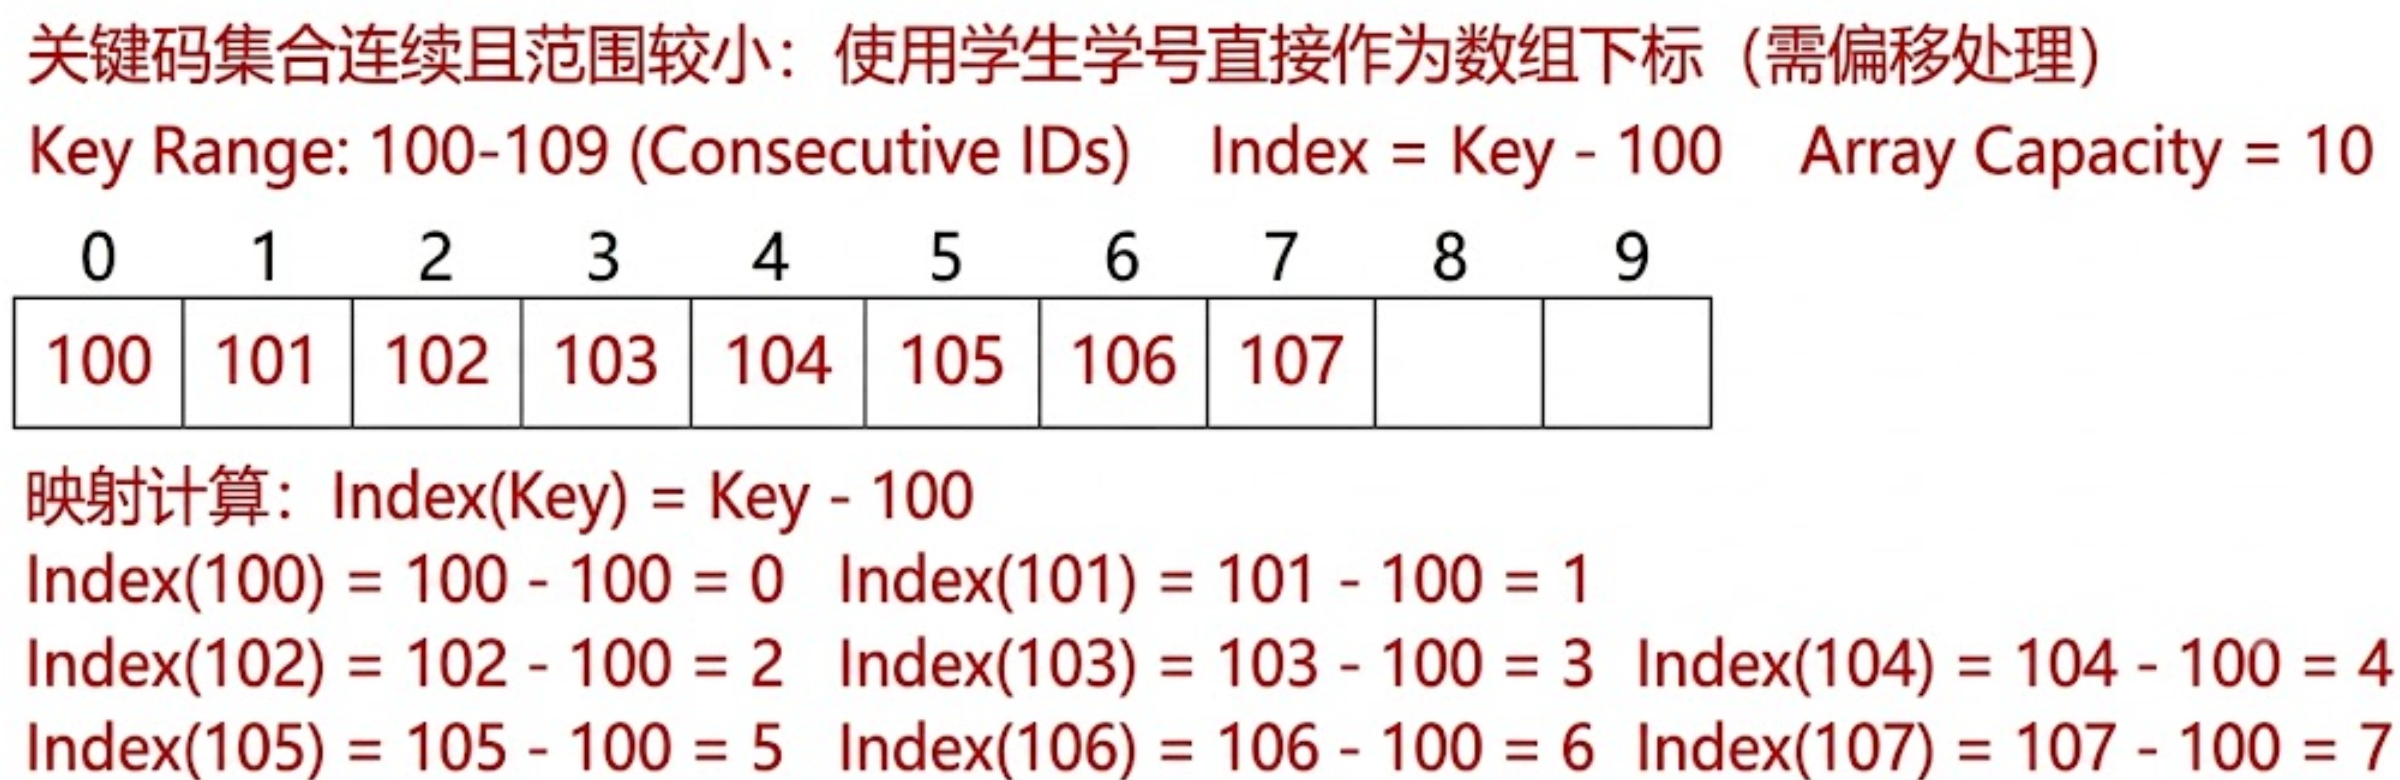
除留余数法
这是最常用的哈希函数,公式为
H
a
s
h
(
K
e
y
)
=
K
e
y
Hash(Key) = Key \\ % \\ p
Hash(Key)=Key 。
- p 的选择:通常取一个不大于哈希表长度
m
m
m 的质数,且尽量远离 2 的幂次方。因为如果p
p
p 是偶数,奇偶性相同的 key 会集中映射;若p
p
p 接近2
n
2^n
2n,则哈希值只与 key 的低n
n
n 位有关,高位信息被丢弃,分布性差。 - C++ STL 中 unordered_map 的默认桶数便是一组经过精心挑选的质数序列,如 53、97、193、389、769……当负载因子超过阈值时,会自动扩容到下一个更大的质数桶数。
示例:哈希表长度
m
=
10
m = 10
m=10,取
p
=
7
p = 7
p=7(质数且小于 10)。
- Key = 15 →
15
15 \\ % \\ 7 = 1
15 - Key = 22 →
22
22 \\ % \\ 7 = 1
22 // 冲突
数字分析法
设关键字是r进制数,其各位上的数码(共r种)出现的频率可能不同:某些数位上数码分 布较为均匀,各种数码出现的机会接近均等;而另一些数位上分布不均,仅有少数几种数码频繁出现。此时应选取那些数码分布较为均匀的数位,以其组合构成散列地址。该方法适用于已知且固定的关键字集合,若关键字集合发生变化,则需重新构造新的散列函数。
平方取中法
顾名思义,该方法取关键字平方值的中间几位作为散列地址。具体取多少位根据散列表大小 和关键字范围确定。由于平方运算与关键字的每位都有关系,因此使得散列地址的分布较为均匀。该方法适用于关键字的各位取值分布不均或关键字本身位数较少的情形。
二、哈希冲突及其解决方案
不同的关键码通过同一个哈希函数计算出相同地址的现象,称为哈希冲突。冲突不可避免,必须通过机制解决。解决方案分为两大类:闭散列(开放定址法)和开散列(链地址法)。
1. 闭散列(开放定址法)
当发生冲突时,若哈希表尚未填满,则按某种探测序列在表中寻找下一个空闲位置存放元素。闭散列中的“闭”是指所有元素都存储在哈希表数组内部,不借助外部结构。
线性探测
从冲突位置开始,依次向后检查紧邻的下一个位置,直到找到空位:
H
i
=
(
H
0
+
i
)
H_i = (H_0 + i) % m,\\quad i = 0, 1, 2, \\dots
Hi=(H0+i)
缺点:容易产生聚集(Primary Clustering)。一旦某个区域出现连续被占用的位置,后续插入的元素不论其初始哈希值落在何处,只要探测到该区域前部,就会被迫沿着聚集区向后延伸,使聚集区进一步增长,最终导致平均探测长度急剧增加。
二次探测
为缓解线性探测的聚集,采用二次探测(平方探测):
H
i
=
(
H
0
+
i
2
)
H_i = (H_0 + i^2) % m \\quad
Hi=(H0+i2) 或
H
i
=
(
H
0
−
i
2
)
\\quad H_i = (H_0 – i^2) % m
Hi=(H0−i2) 探测步长随冲突次数增加而平方增长,有效避免相邻位置的连续堆积。但要求表长
m
m
m 必须是质数,否则某些位置可能永不被探测到。 (此处插入图片:线性探测与二次探测对比图示)
伪删除与载荷因子
闭散列中不能直接物理删除元素,否则会切断冲突元素的探测路径(例如,若直接清空某位置,后续元素按照探测序列查找时会因遇到空位而提前终止,导致误判“不存在”)。 通用做法是采用标记删除:为每个位置设置三种状态 EMPTY、EXIST、DELETE。查找时遇到 DELETE 继续向后探测;插入时,可以覆盖第一个遇到的状态为 EMPTY 或 DELETE 的位置。
载荷因子
α
\\alpha
α = 表中元素个数 / 表长。 当
α
\\alpha
α 超过 0.7~0.8 时,冲突概率和探测长度会呈指数级上升,必须进行扩容并进行重新散列(将旧表所有元素重新计算哈希值插入新表)。闭散列必须严格控制载荷因子。
例题:
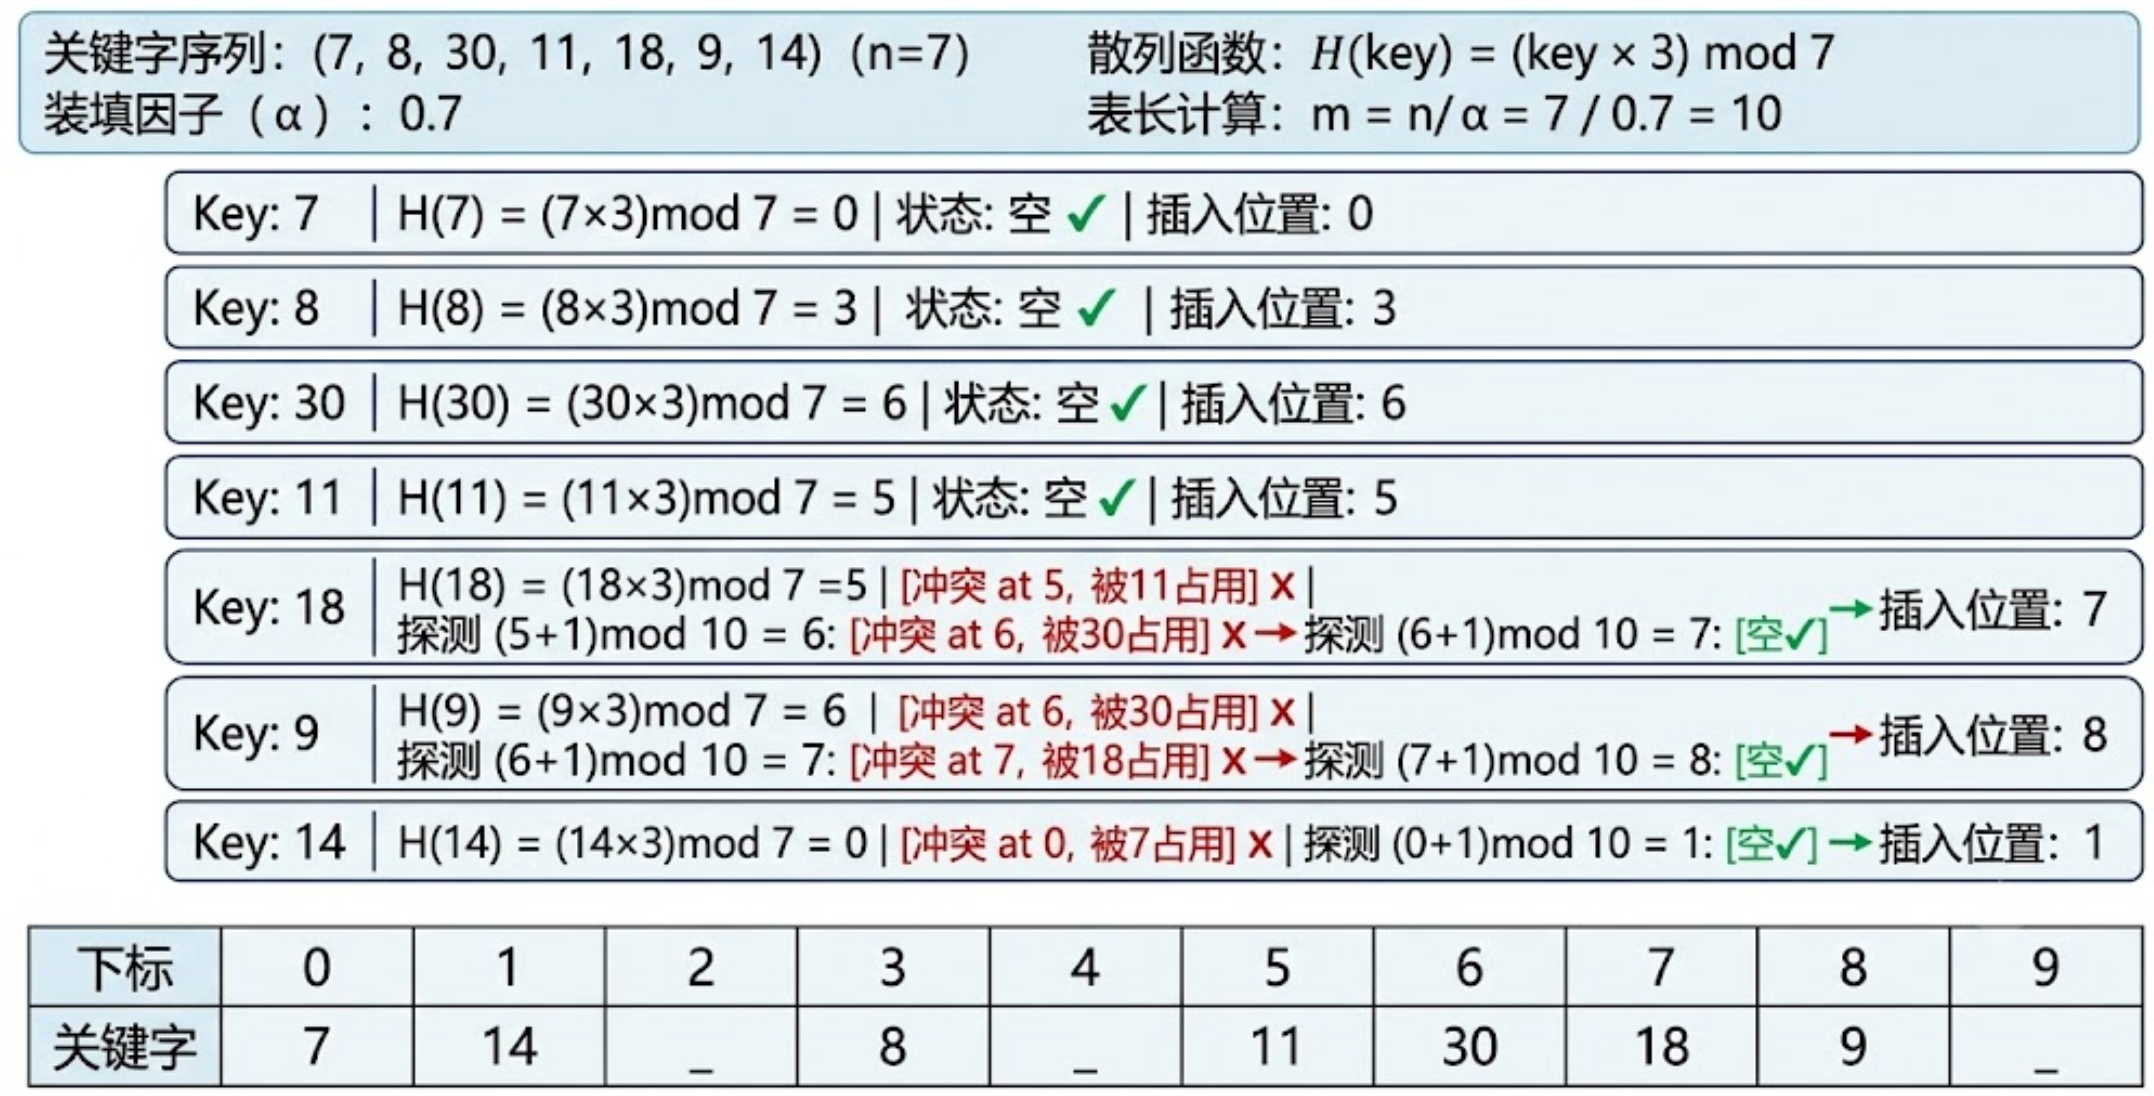
将关键字序列(7,8,30,11,18,9,14)散列存储到散列表中。散列表的存储空间是一个下标从 0 开始的一维数组,散列函数为 H(key)=(keyx3)mod 7,处理冲突采用线性探测再散列法,要求装填(载)因子为0.7。请画出所构造的散列表。
2. 开散列(链地址法 / 哈希桶)
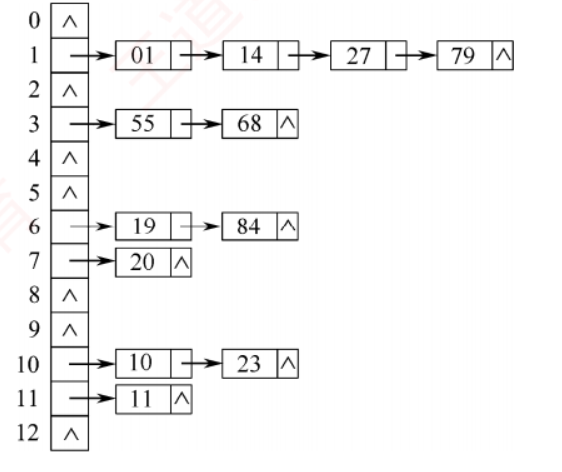
开散列是 C++ STL 中 unordered_map 采用的方案。哈希表本身是一个指针数组,每个数组元素是一个“桶”(Bucket)的头指针,哈希值相同的元素被链接到同一个桶下的单链表中。
例如,关键字序列 19, 14, 23, 01, 68, 20, 84, 27, 55, 11, 10, 79 , 散列函数 H(key)=key%13
结构优势
- 闭散列必须预留大量空位以保证低探测长度,空间利用率低;开散列允许载荷因子大于 1,桶链表增长只会线性影响该桶查找,不会干扰其他桶。
- 冲突被限制在桶内,不会引发全局性聚集。
- 虽然链表指针会带来额外内存开销,但整体空间效率优于闭散列。
扩容机制
随着元素增加,单个桶链表可能变长,查找效率退化向链表
O
(
K
)
O(K)
O(K)。现代实现通常在载荷因子等于 1 (元素总数等于桶数)时触发扩容:
h
=
h
a
s
h
(
k
e
y
)
h = hash(key) % new_bucket_count
h=hash(key),将其转移到新表对应桶的头部(头插法,
O
(
1
)
O(1)
O(1),不需要重新申请节点内存)。
因为只是指针移动,避免了大规模对象拷贝,扩容效率较高。
三、实战:算法与海量数据处理中的应用
1. 频次统计与查重
利用 unordered_map 和 unordered_set 可在
O
(
N
)
O(N)
O(N) 时间内解决经典问题。
统计重复元素:找出数组中出现次数超过
⌊
N
/
2
⌋
\\lfloor N/2 \\rfloor
⌊N/2⌋ 的多数元素。
int majorityElement(vector<int>& nums) {
unordered_map<int, int> cnt;
for (int v : nums) {
if (++cnt[v] > nums.size()/2)
return v;
}
return –1;
}
求两个数组的交集:
vector<int> intersect(vector<int>& nums1, vector<int>& nums2) {
unordered_set<int> set(nums1.begin(), nums1.end());
vector<int> res;
for (int v : nums2) {
if (set.erase(v)) { // 查找并删除,避免重复
res.push_back(v);
}
}
return res;
}
2. 海量数据切割(Hash Partition)
当数据文件远超内存时,利用哈希切割实现“分而治之”。
场景:100GB 日志文件,每条记录含 IP 地址,统计出现次数最多的 IP。 步骤:
N
N
N(如 1000)。
H
a
s
h
(
I
P
)
Hash(IP)\\ %\\ N
Hash(IP) ,将该行追加到对应编号的小文件中。
哈希切割保证了相同记录聚合在一起,使得内存中完成精确统计成为可能,是解决大数据经典面试题的基石。
总结
- 哈希表以空间换时间,通过精心设计的哈希函数和冲突解决机制,达到平均
O
(
1
)
O(1)
O(1) 的查找性能。 - 除留余数法 + 链地址法是工业级实现(如 C++ STL)的主流组合。
- 闭散列需控制载荷因子并使用伪删除;开散列允许负载因子大于 1,扩容时通过移动指针高效转移。
- 位图和布隆过滤器是在内存受限场景下的强大概率型工具,适用于去重、存在性检查及缓存穿透防御。
- 处理海量数据时,哈希切割提供了一种可并行的分治策略,将大问题转化为小规模精确统计。