文章目录
- 一、前言:为什么要自建知识库考试系统?
- 二、项目架构总览
-
- 2.1 技术选型
- 2.2 项目结构
- 2.3 核心数据流
- 三、后端服务器详解(server.py)
-
- 3.1 功能设计
- 3.2 核心代码解析
- 3.3 启动方式
- 四、前端核心实现(index.html)
-
- 4.1 全局状态管理
- 4.2 知识库选择与内容注入
- 4.3 核心出题逻辑
- 4.4 答案均衡算法
- 4.5 逐题模式渲染
- 4.6 错题本机制
- 4.7 直连模式 vs 代理模式
- 五、UI/UX 设计亮点
-
- 5.1 三种视觉状态
- 5.2 进度与统计联动
- 六、知识库文件的制作技巧
-
- 6.1 格式建议
- 6.2 出题数量建议
- 6.3 温度参数
- 七、模型兼容性
- 八、完整使用流程
- 九、实战效果演示
- 十、总结与展望
-
- 10.1 这套系统的优势
- 10.2 可扩展方向
- 10.3 写在最后
本文完整项目详见https://download.csdn.net/download/nmdbbzcl/93119959
一、前言:为什么要自建知识库考试系统?
在日常学习和备考过程中,我们经常会遇到这样的痛点:
这套系统就是为解决以上痛点而生:把你的 txt 知识库文件丢进去,AI 严格基于知识库内容生成题目,逐题作答、即时显示解析,手动控制进度。
核心思路:System Prompt 中直接注入完整知识库文本,约束 AI 只能在知识库范围内出题,从根本上杜绝超纲问题。
二、项目架构总览
2.1 技术选型
| Python 标准库 http.server | 轻量后端服务器,无任何第三方依赖 |
| 纯 HTML + CSS + JavaScript | 前端单页应用,零框架,打开即用 |
| OpenAI 兼容 API | 对接大语言模型(支持所有兼容接口的模型) |
| localStorage | 浏览器本地持久化存储 API 密钥、错题本 |
2.2 项目结构
quiz_system/
├── index.html # 前端单页应用(全部逻辑在此)
├── server.py # 后端服务器(API代理 + 知识库文件管理)
└── knowledge_base/ # 知识库文件夹,放你的 .txt 文件
├── 数据结构与算法.txt
└── 计算机网络.txt
设计原则:极简、零依赖。 后端只用 Python 标准库,前端不引入任何框架或 CDN,整个项目就是一个 HTML + 一个 Python 文件。
2.3 核心数据流
用户选择知识库 → 点击开始考试
↓
前端读取知识库内容 → 构建 System Prompt(注入完整知识库文本)
↓
调用 AI API → 流式/一次性获取 JSON 格式题目
↓
解析 JSON → 验证字段 → 答案均衡算法
↓
逐题渲染 → 用户作答 → 即时显示解析 → 点"下一题"
↓
考试完成 → 统计正确率 → 错题自动入错题本
三、后端服务器详解(server.py)
3.1 功能设计
这个后端虽然只有 173 行代码,但承担了三个重要职责:
3.2 核心代码解析
1. API 代理实现(解决 CORS 痛点)
浏览器直接调用第三方 API 会遇到跨域限制,通过同源代理完美解决:
def _proxy_api(self, body):
"""将请求转发到AI API"""
data = json.loads(body)
api_key = data.get("api_key", "")
path = data.get("path", "chat/completions")
api_body = data.get("body", {})
url = f"{API_BASE}/{path}"
headers = {
"Content-Type": "application/json",
"Authorization": f"Bearer {api_key}",
}
req = urllib.request.Request(url, data=json.dumps(api_body).encode("utf-8"),
headers=headers, method="POST")
response = urllib.request.urlopen(req, timeout=120)
self.wfile.write(response.read())
关键设计点:
- 120 秒超时——大模型生成题目耗时较长
- 完整的错误处理链——HTTPError、URLError、JSONDecodeError、timeout 全覆盖
- 前端传什么就透传什么,不对模型名做任何限制,灵活适配任何 API
2. 知识库安全读取(防止路径穿越)
def _read_knowledge_file(self, filename):
# 安全校验:防止路径穿越
filename = os.path.basename(filename)
filepath = os.path.join(KNOWLEDGE_DIR, filename)
if not filepath.startswith(KNOWLEDGE_DIR):
self._send_json({"error": "非法路径"}, 403)
return
为什么需要 basename?防止恶意请求 /api/knowledge/read/../../etc/passwd 读取敏感文件。
3.3 启动方式
cd quiz_system
python server.py
启动后在浏览器访问 http://localhost:8080 即可。
如果不想启动服务器,也可以直接双击打开 index.html 使用直连模式——前端将直接调用 AI API,内置了两个默认知识库。
四、前端核心实现(index.html)
前端是整个系统的精华所在,虽然只有一个 HTML 文件,但包含了完整的交互逻辑。
4.1 全局状态管理
var STATE = {
questions: [], // 所有题目
answers: [], // 正确答案
userAnswers: [], // 用户选择
answeredStatus: [], // true/false 是否已作答
currentIndex: 0, // 当前题目索引
examGenerated: false, // 是否已生成试题
quizFinished: false, // 是否完成了所有题目
wrongBook: JSON.parse(localStorage.getItem('quiz_wrong_book') || '[]'),
};
所有状态集中管理,不分散在 DOM 中,逻辑清晰易维护。
4.2 知识库选择与内容注入
function selectKB(name) {
// 高亮选中
var items = document.querySelectorAll('#kbList .kb-item');
for (var i = 0; i < items.length; i++) items[i].classList.remove('active');
var target = document.querySelector('#kbList .kb-item[data-name="…"]');
if (target) target.classList.add('active');
// 通过API获取文件内容
fetch('/api/knowledge/read/' + encodeURIComponent(name))
.then(function(r){ return r.json(); })
.then(function(data){
// 保存到 dataset 供后续出题使用
var active = document.querySelector('#kbList .kb-item.active');
if (active) active.dataset.content = data.content;
});
}
知识点: 使用 dataset 属性将文件内容缓存在 DOM 元素上,避免重复请求。出题时直接从 dataset.content 读取。
4.3 核心出题逻辑
这是最关键的部分——如何基于知识库让 AI 出题?
var systemPrompt = '你是一个专业的考试出题专家。' +
'请根据以下知识库内容,生成 ' + qcount + ' 道单项选择题。\\n\\n' +
'=== 知识库内容 ===\\n' + kbContent + '\\n\\n' +
'=== 出题要求 ===\\n' +
'1. 每道题必须严格基于知识库内容出题,不得超出知识库范围\\n' +
'2. 每道题包含题干和 A、B、C、D 四个选项,以及正确答案和详细解析\\n' +
'3. 正确答案必须在 A/B/C/D 中均匀分布\\n' +
'4. 解析必须详细,解释为什么选这个答案以及每个选项为什么对/错\\n' +
'5. 输出格式必须是严格的 JSON 数组';
Prompt 工程的核心技巧:
4.4 答案均衡算法
AI 在出题时天然倾向于让正确答案出现在特定位置,因此需要后处理均衡:
function balanceAnswers(questions, targetCount) {
// 洗牌打乱
for (var i = questions.length – 1; i > 0; i—) {
var j = Math.floor(Math.random() * (i + 1));
var tmp = questions[i]; questions[i] = questions[j]; questions[j] = tmp;
}
var result = [];
var counts = {A: 0, B: 0, C: 0, D: 0};
var limit = Math.floor(targetCount / 4) + 1;
// 两轮筛选确保每个选项出现次数接近 targetCount/4
for (var i = 0; i < questions.length; i++) {
var ans = questions[i].answer;
if (counts[ans] < limit) {
result.push(questions[i]);
counts[ans]++;
if (result.length >= targetCount) break;
}
}
// 如果题目不够,复制并修改答案来填充
while (result.length < targetCount) {
// … 均衡填充逻辑
}
return result;
}
这个算法在不改变题目本身质量的前提下,通过选择 + 补充两轮策略,确保 A/B/C/D 四个选项的分布尽可能均匀。
4.5 逐题模式渲染
function showQuestion(idx) {
// …更新进度条和统计
var html = '<div class="question-card">';
html += '<div class="q-number">';
html += '<span>📝 第 ' + (idx + 1) + ' 题</span>';
html += '<span class="q-progress">' + (answered ? '✅/❌' : '请选择答案') + '</span>';
html += '</div>';
html += '<div class="q-text">' + escHtml(q.question) + '</div>';
html += '<div class="q-options">';
// 渲染 A/B/C/D 四个选项
for (var li = 0; li < 4; li++) {
var cls = 'q-option';
// 已作答时标记正确/错误状态和正确答案
if (answered) {
if (letter === q.answer) cls += ' show-correct';
if (userAns === letter) cls += userAns === q.answer ? ' correct' : ' wrong';
}
html += '<div class="' + cls + '" onclick="selectOption(…)">…</div>';
}
// 解析区域
if (answered) {
html += '<div class="explanation-box show">';
html += '<div class="exp-answer">正确答案:' + q.answer + '</div>';
html += '<div class="exp-text">' + escHtml(q.explanation) + '</div>';
html += '</div>';
}
}
交互流程:
4.6 错题本机制
错题自动收录,使用 localStorage 持久化:
function addToWrongBook(q, userAnswer) {
// 检查是否已存在(同题合并,增加错误次数)
for (var i = 0; i < STATE.wrongBook.length; i++) {
if (STATE.wrongBook[i].question === q.question) {
STATE.wrongBook[i].wrong_count++;
STATE.wrongBook[i].last_wrong = new Date().toLocaleString();
saveWrongBook();
return;
}
}
// 新错题
STATE.wrongBook.push({
question: q.question,
option_a: q.option_a, option_b: q.option_b,
option_c: q.option_c, option_d: q.option_d,
answer: q.answer,
explanation: q.explanation,
user_answer: userAnswer,
wrong_count: 1,
last_wrong: new Date().toLocaleString(),
});
saveWrongBook();
}
设计亮点:
- 同题合并——同一道题错多次只累加 wrong_count,不重复存储
- 记录用户错误答案——复习时可针对性看自己错在哪
4.7 直连模式 vs 代理模式
前端在初始化时自动判断运行环境:
var useProxy = (window.location.port === '8080' || window.location.port === '8000') &&
window.location.hostname === 'localhost';
if (useProxy) {
refreshKnowledgeList(); // 通过服务器API获取知识库文件
} else {
loadBuiltinKnowledge(); // 使用内置默认知识库
}
这个设计让系统有两种运行模式:
- 服务器模式(推荐):python server.py 启动,支持自定义知识库文件
- 直连模式:直接双击 index.html 打开,不需要服务器,使用内置知识库
五、UI/UX 设计亮点
5.1 三种视觉状态
每个选项卡片有清晰的视觉反馈:
- 待作答:灰色边框,鼠标悬停变蓝色
- 选中:蓝边 + 蓝色背景
- 正确答案:绿边 + 绿色背景(无论用户选没选对)
- 错误答案:红边 + 红色背景(用户选错的选项)
这样设计的好处是:一屏就能看清"正确答案是什么"和"我选错了什么"。
5.2 进度与统计联动
顶部进度条实时反映答题进度,左侧面板实时更新正确率。用户随时可以查看自己的整体表现。
六、知识库文件的制作技巧
6.1 格式建议
知识库文件是 txt 格式,建议以下结构:
一、章节标题
1. 知识点1:详细描述
2. 知识点2:详细描述
3. 涉及公式、定义、概念
二、章节标题
1. 知识点…
几个原则:
- 结构化分层——AI 更容易理解知识体系
- 关键点明确——概念定义、公式、特点、区别等要写清楚
- 中长度段落——太短缺乏上下文,太长超出 token 限制
6.2 出题数量建议
出题数建议控制在 5~20 题之间。过少达不到练习效果,过多会给 AI 产出质量带来压力。
6.3 温度参数
推荐温度设置在 0.7 左右(系统默认值)。温度太高 AI 可能胡编乱造,太低则题目过于死板。
七、模型兼容性
系统使用 OpenAI 兼容 API,支持市面上几乎所有大模型 API。目前已内置:
- GPT-5.6-Luna(默认)
- GLM-5.2
- DeepSeek-V4-Flash
- DeepSeek-V4
- Gemma-4-26B-A4B-IT
- Kimi-K2.6
如果要使用其他模型,在 index.html 的 <select> 中新增选项即可,无需修改其他代码。
八、完整使用流程
Step 1:准备知识库文件
cd quiz_system/knowledge_base/
# 放入你的 .txt 文件,如:高等数学.txt、考研政治.txt、Java面试题.txt
Step 2:启动服务
cd quiz_system
python server.py
# 输出: [OK] 考试系统服务器已启动
# 本地访问: http://localhost:8080
Step 3:浏览器打开
- 打开 http://localhost:8080
- 左侧选择知识库文件
- 填入 API 密钥
- 点击「开始考试」
Step 4:逐题作答
- 每道题做完立即显示解析
- 点击「下一题」继续
- 全部完成后查看成绩和错题本
Step 5:巩固复习
- 错题自动收录到错题本
- 可导出试卷为 txt 文件
九、实战效果演示
以一个「数据结构与算法」知识库为例,AI 生成的典型题目:
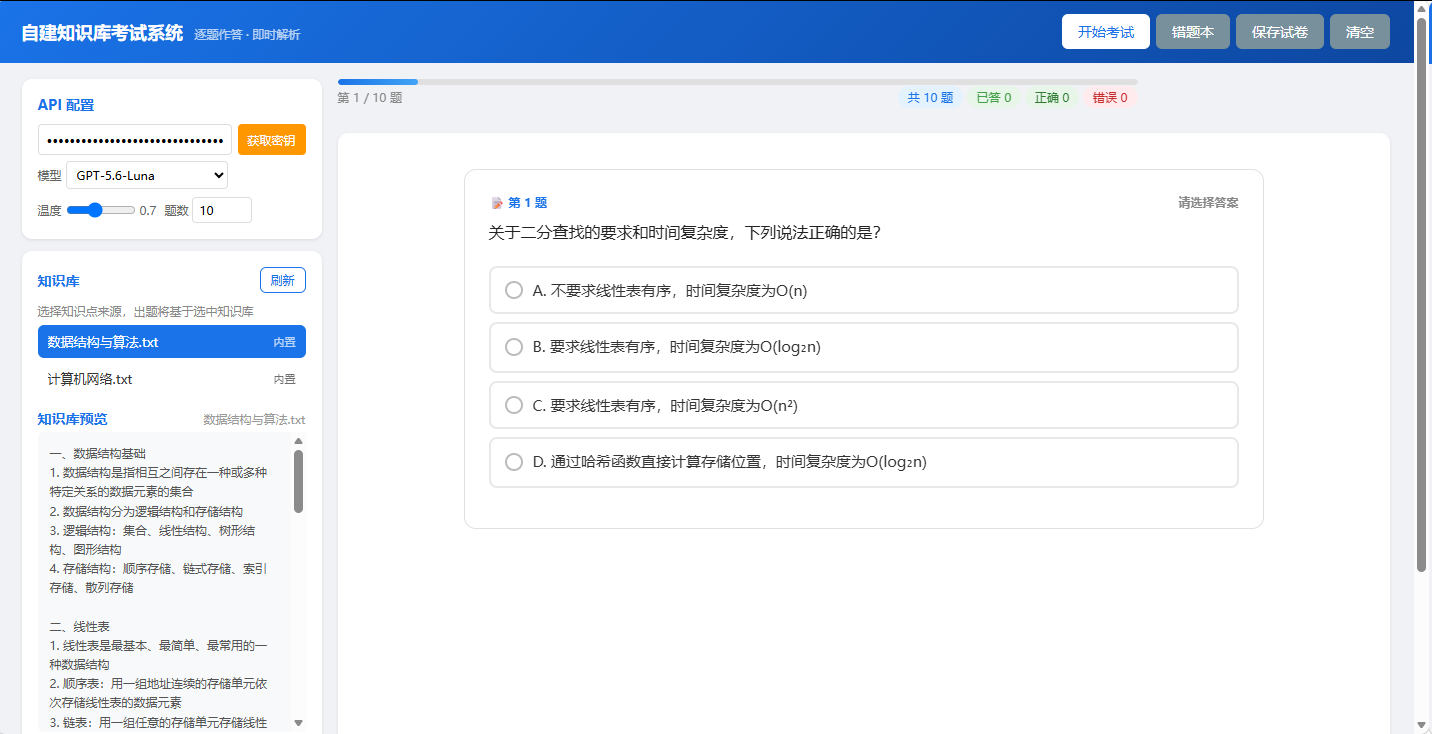
可以看到题目完全基于知识库内容,解析详尽且覆盖了考点推导过程。
十、总结与展望
10.1 这套系统的优势
10.2 可扩展方向
10.3 写在最后
这个项目的核心思想是:用 AI 作为出题引擎,用知识库作为数据源,用逐题模式提升学习体验。
不是为了做一个"花哨"的系统,而是真正解决"我想基于自己的学习资料做练习"这个实际问题。代码虽然不多,但每个模块都经过实战检验。
如果你也在备考某个考试,或者想基于自己的笔记生成练习题,不妨试试这套系统。所有代码都在 GitHub 开源,欢迎 star 和 PR。
项目地址: quiz_system/ 技术栈: Python + HTML/CSS/JavaScript 依赖: 零外部依赖 运行方式: python server.py → 浏览器访问 http://localhost:8080