城市河道是城市水生态体系的核心载体,更是保障城市环境卫生、防范内涝灾害、维系生态平衡的关键基础设施。整洁通畅的河道能够有效提升城市市容风貌,保障水系正常循环,降低暴雨汛期城市内涝风险。但在城市常态化运维过程中,河道水面漂浮物、生活垃圾、杂物堆积等问题频发,不仅破坏河道景观、影响城市人居环境,还会堵塞水道、阻碍水体流通,大幅降低河道行洪排涝能力,给城市防汛安全埋下隐患。因此,高效、精准、常态化的河道治理管护工作,是城市精细化治理的重要组成部分。
长期以来,我国城市河道治理普遍依赖传统人工巡检处置模式。各地水务、城管部门通过配置专职河道巡查人员,采用人工徒步巡查的方式排查河道垃圾、淤积、排污等问题,发现隐患后人工上报、现场处置。这种传统运维模式依托人力落地,流程直观、基础保障性强,但在现代化城市治理体系下,短板与局限性日益凸显。人工巡检需要投入大量人力物力,运营成本居高不下,且受人员体能、精力、工作时间限制,无法实现全天候、全覆盖、无间断的河道监测管控。
同时,当前基层河道巡查队伍普遍存在人员年龄结构偏大的问题,传统巡查方式效率偏低、响应速度滞后。在日常管护中,人工巡查易出现盲区、漏查、迟查等问题,难以精准捕捉零散漂浮物、隐蔽垃圾堆积等细微问题;在汛期、暴雨等灾害来临前夕,河道水位、淤积、杂物堵塞情况变化迅速,人工巡检无法快速完成全域排查,难以及时预判风险、处置隐患,极大制约了城市河道应急防汛能力,难以适配新时代城市精细化、智慧化治理的发展需求。
随着人工智能、大数据、视频感知、无人机巡检等数字技术的快速迭代与普及,各行业数字化、智能化转型持续深化,为传统河道治理模式革新提供了全新路径。依托AI智能化技术赋能,构建空陆一体、全域感知、智能预警、闭环处置的智慧河道治理体系,能够彻底破解传统人工巡检的痛点难题,推动城市河道治理从“人工被动巡查”向“智能主动防控”转型升级。
智慧河道治理体系构建以立体化感知网络为基础,整合城市现有河道监控资源与无人机机动巡检能力,形成全方位、无死角的监测格局。一方面,利用河道两岸布设的高清监控摄像头,实时采集河道视频流数据,实现24小时不间断定点监测;另一方面,通过无人机按照预设航线开展机动巡检,快速覆盖河道全域,弥补固定监控点位的视野盲区,适配复杂河段、偏远河段的巡查需求,大幅提升巡检覆盖范围与机动灵活性。
在数据感知基础上,通过搭建专业化河道治理数据集,依托人工精准标注、场景化训练,研发适配河道管护场景的AI智能检测识别模型,并部署于端侧智能设备。该模型可对无人机航拍图像、河道实时视频画面进行自动化、智能化分析,精准识别水面漂浮物、生活垃圾、杂物堆积、河道淤积等各类问题,具备识别精度高、响应速度快、全天候运行的优势,彻底摆脱对人工肉眼巡查的依赖。
基于AI智能识别技术,整套治理体系形成“智能识别-实时预警-平台调度-精准处置-闭环复盘”的全流程工作机制。当系统监测到河道异常问题时,可自动触发预警,将问题位置、隐患类型、现场画面实时推送至中央管控平台。平台依托智能化调度机制,精准匹配就近巡查运维人员,快速派发处置工单,实现问题精准定位、高效处置,有效缩短隐患处理时长,杜绝人工巡查滞后、处置低效等问题。
相较于传统人工治理模式,AI智能化河道治理模式具备全方位、全天候、高效率、低成本、精准化的核心优势。通过数字技术赋能,彻底解决了人工巡检覆盖不全、响应滞后、人力成本高、汛期应急能力弱等痛点,实现河道隐患早发现、早预警、早处置。在日常管护中,能够持续保持河道水体整洁、水道通畅,美化城市水环境;在防汛关键时期,可快速排查河道堵塞隐患,保障水系行洪通畅,有效防范城市内涝风险。
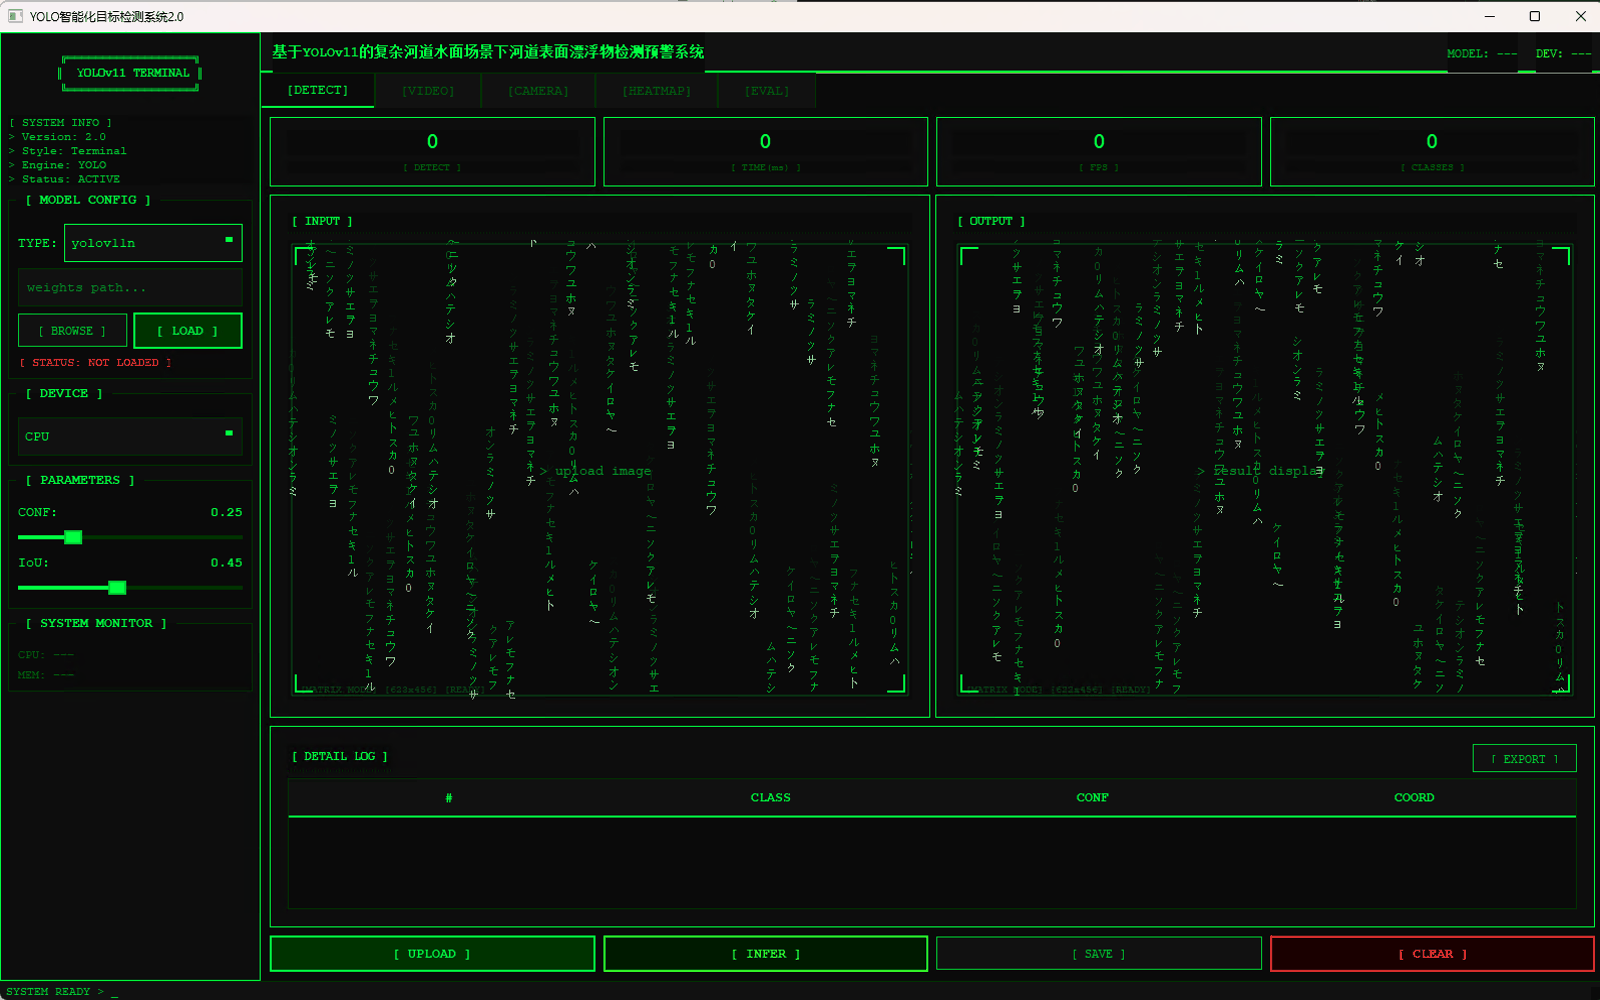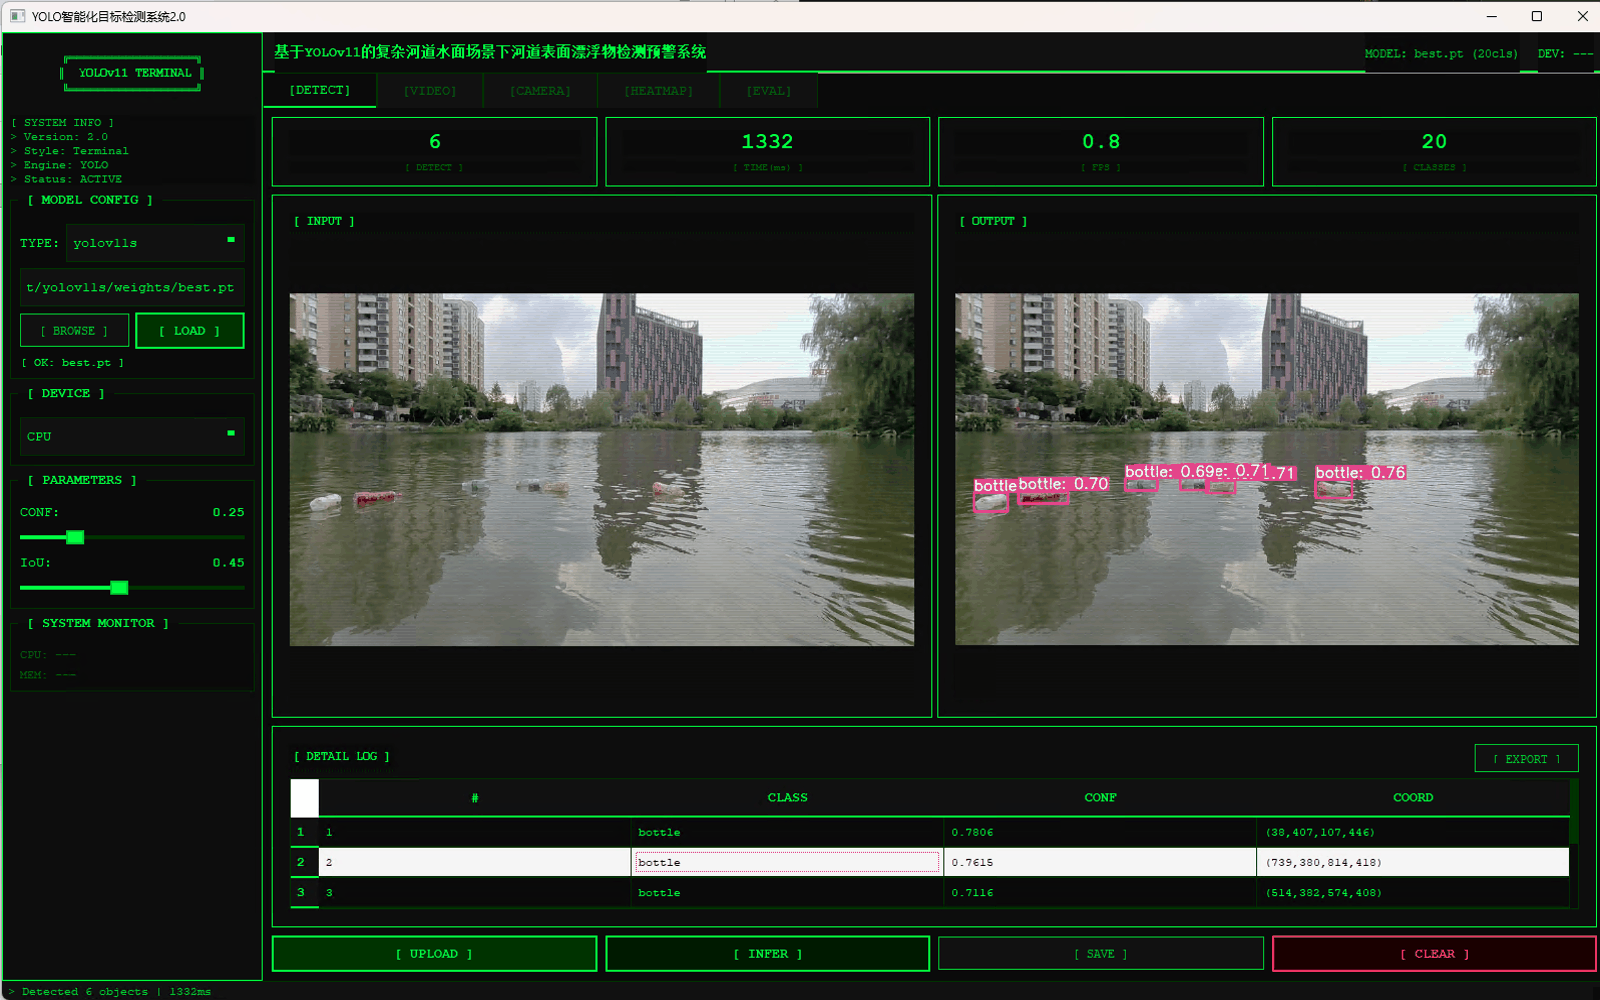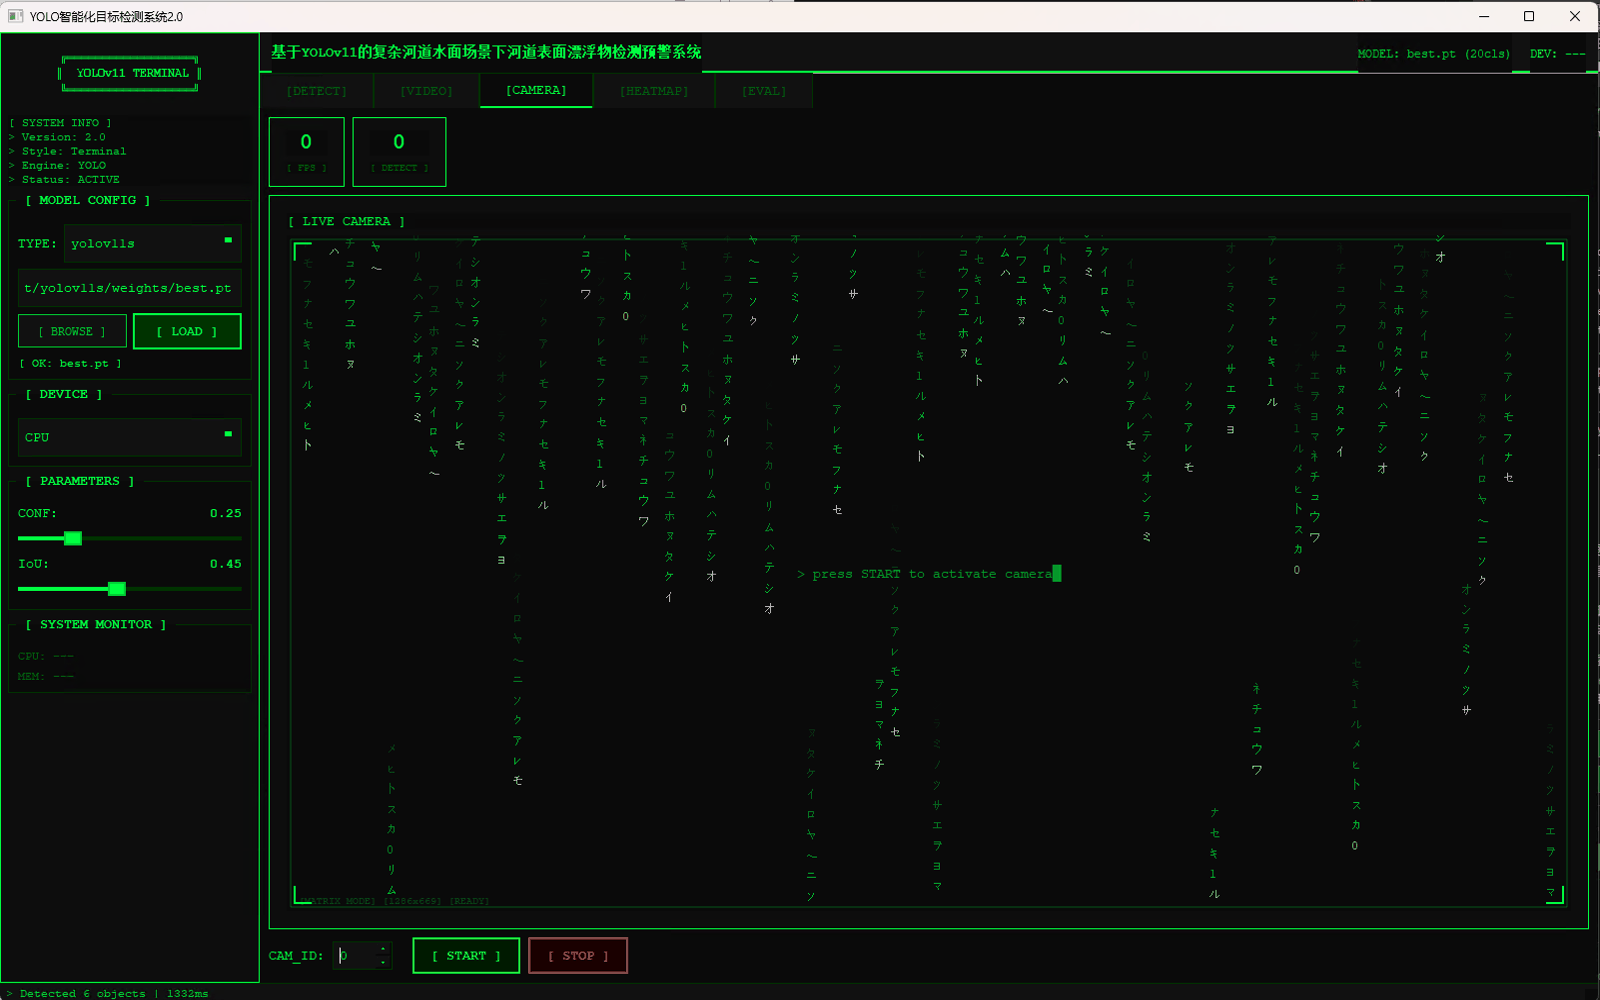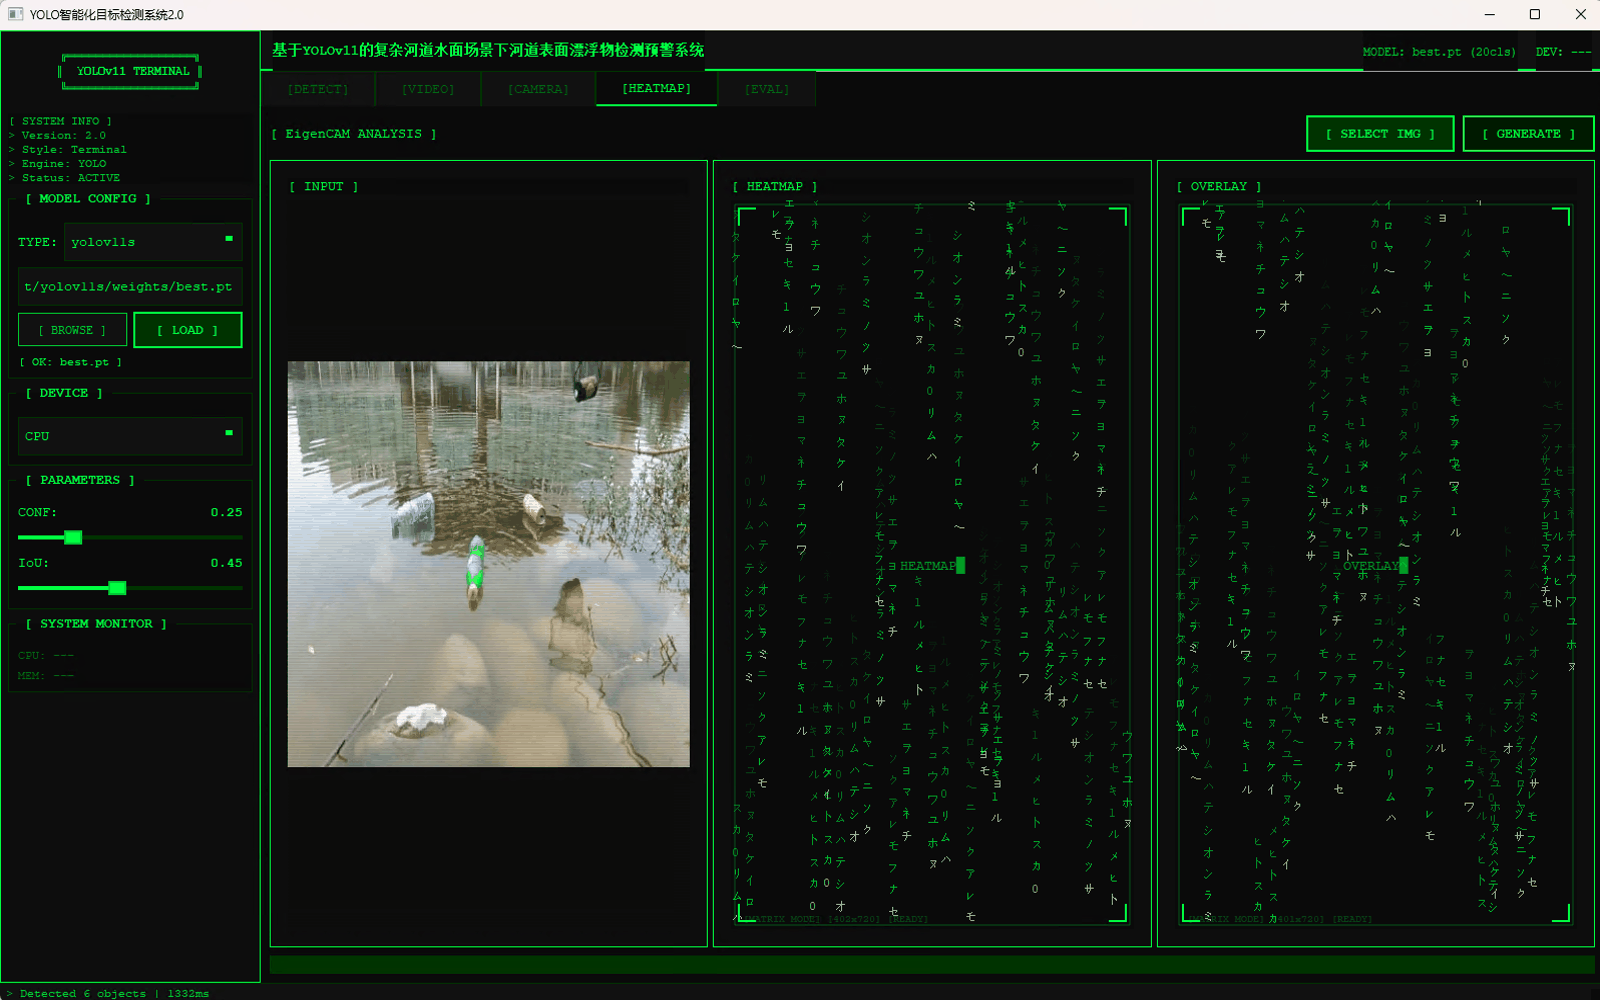
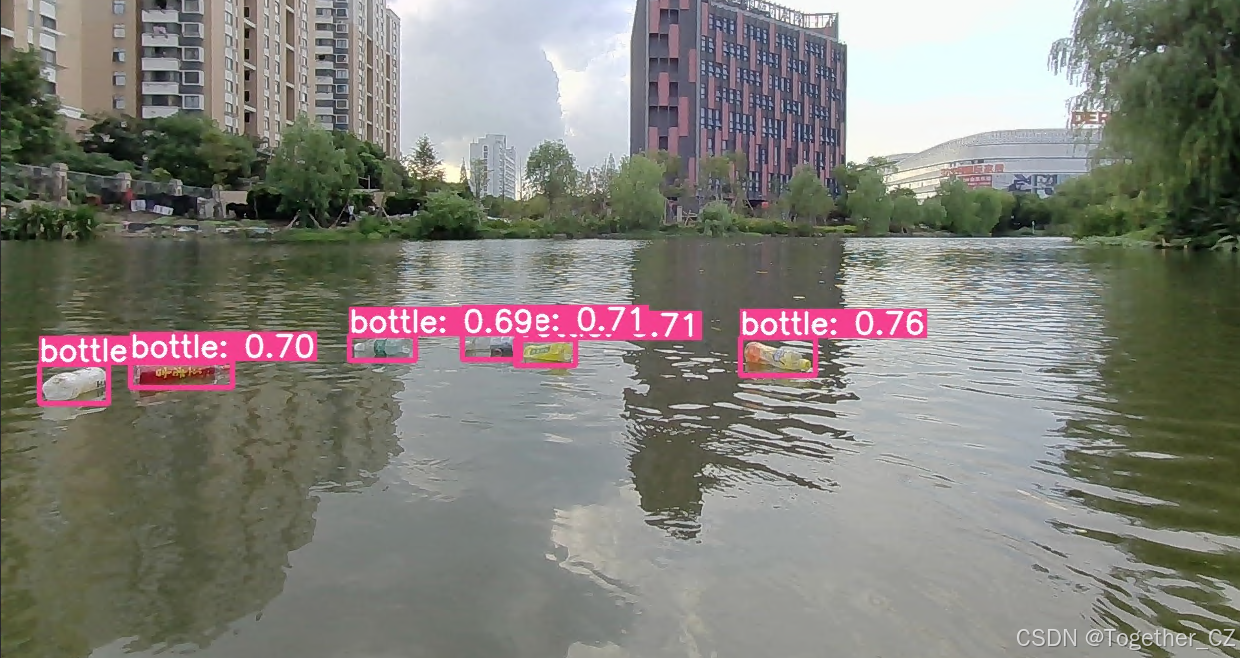
本文正是在这样的思考背景下,想要基于最新发布的目标检测 模型YOLOv11全系列的参数模型来开发构建水流河道场景下的河道漂浮物智能化检测识别系统,首先看下实例效果:
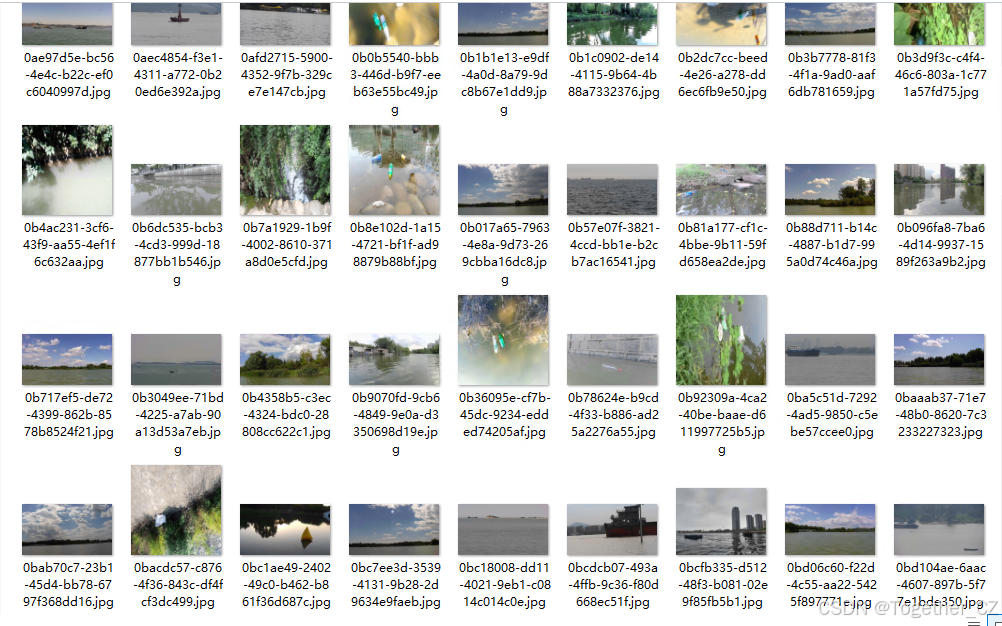
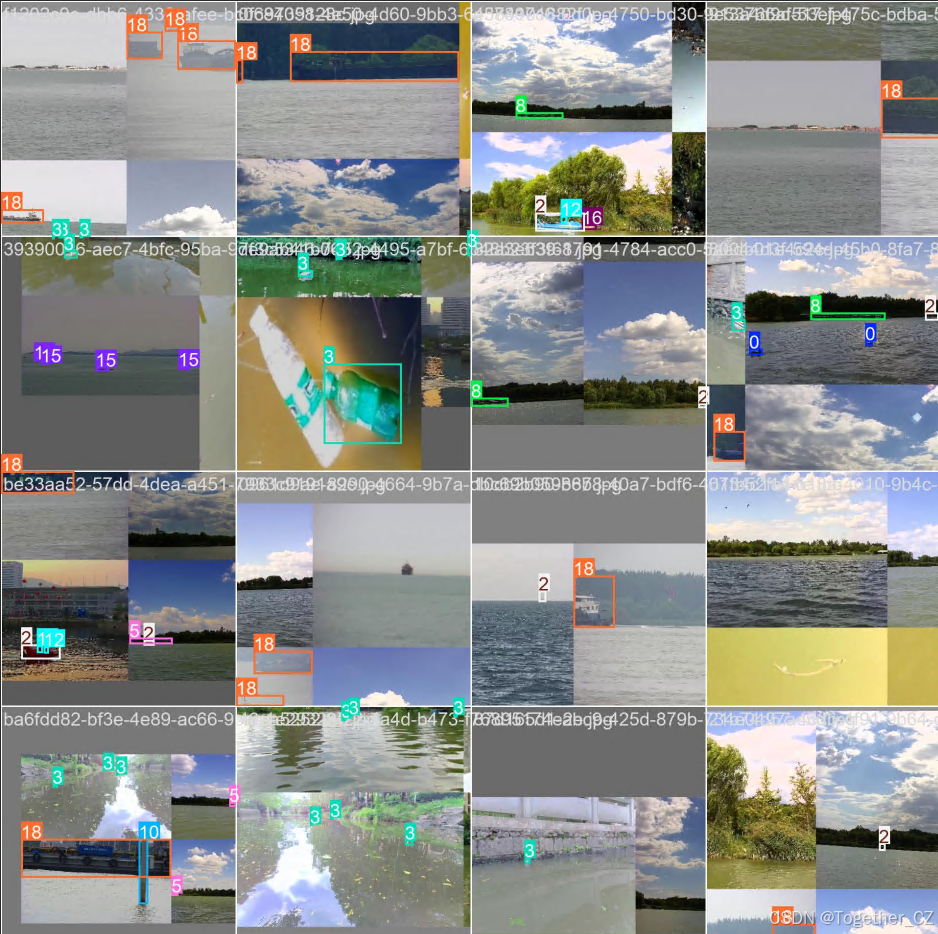
接下来简单看下实例数据集 :
ultralytics项目 自发布以来目前已经逐步迭代至YOLOv11了,不可谓不快速,官方的项目在这里,如下所示:
YOLO11是Ultralytics YOLO系列实时目标检测器的最新版本,以其尖端的准确性、速度和效率重新定义了可能性。基于之前YOLO版本的显著进步,YOLO11在架构 和训练方法上引入了重大改进,使其成为广泛计算机视觉任务的多功能选择。
【主要特点】
增强的特征提取:YOLO11采用了改进的骨干和颈部架构,增强了特征提取能力,以实现更精确的目标检测和复杂任务的性能。 优化的效率和速度:YOLO11引入了精炼的架构设计和优化的训练管道,提供更快的处理速度,并在准确性和性能之间保持最佳平衡。 更少的参数实现更高的准确性:通过模型设计的进步,YOLO11m在COCO数据集上实现了更高的平均精度(mAP),同时比YOLOv8m减少了22%的参数,使其在不影响准确性的情况下计算效率更高。 跨环境的适应性:YOLO11可以无缝部署在各种环境中,包括边缘设备、云平台和支持NVIDIA GPU的系统,确保最大的灵活性。 广泛支持的任务:无论是目标检测、实例分割、图像分类、姿态估计还是定向目标检测(OBB),YOLO11都设计用于应对多样化的计算机视觉挑战。
Ultralytics YOLO11在其前身的基础上引入了多项重大进步。关键改进包括:
增强的特征提取:YOLO11采用了改进的骨干和颈部架构,增强了特征提取能力,以实现更精确的目标检测。 优化的效率和速度:精炼的架构设计和优化的训练管道提供了更快的处理速度,同时在准确性和性能之间保持平衡。 更少的参数实现更高的准确性:YOLO11m在COCO数据集上实现了更高的平均精度(mAP),同时比YOLOv8m减少了22%的参数,使其在不影响准确性的情况下计算效率更高。 跨环境的适应性:YOLO11可以部署在各种环境中,包括边缘设备、云平台和支持NVIDIA GPU的系统。 广泛支持的任务:YOLO11支持多样化的计算机视觉任务,如目标检测、实例分割、图像分类、姿态估计和定向目标检测(OBB)。
YOLO11模型具有多功能性,支持广泛的计算机视觉任务,包括:
目标检测:识别和定位图像中的物体。 实例分割:检测物体并描绘其边界。 图像分类:将图像分类为预定义的类别。 姿态估计:检测和跟踪人体上的关键点。 定向目标检测(OBB):检测具有旋转的物体以提高精度。
YOLO11通过模型设计和优化技术的进步,实现了更少的参数实现更高的准确性。改进的架构允许高效的特征提取和处理,从而在COCO等数据集上实现更高的平均精度(mAP),同时比YOLOv8m减少了22%的参数。这使得YOLO11在不影响准确性的情况下计算效率更高,适合部署在资源受限的设备上,YOLO11设计用于适应各种环境,包括边缘设备。其优化的架构和高效的处理能力使其适合部署在边缘设备、云平台和支持NVIDIA GPU的系统上。这种灵活性确保了YOLO11可以在多样化的应用中使用,从移动设备上的实时检测到云环境中的复杂分割任务。
基础实例实现如下:
from ultralytics import YOLO
#n
model = YOLO("weights/yolo11n.pt")
results = model.train(data='data/self.yaml', epochs=100, device=0,batch=32,workers=0,name="yolov11n")
print("results: ", results)
#s
model = YOLO("weights/yolo11s.pt")
results = model.train(data='data/self.yaml', epochs=100, device=0,batch=32,workers=0,name="yolov11s")
print("results: ", results)
#m
model = YOLO("weights/yolo11m.pt")
results = model.train(data='data/self.yaml', epochs=100, device=0,batch=32,workers=0,name="yolov11m")
print("results: ", results)
#l
model = YOLO("weights/yolo11l.pt")
results = model.train(data='data/self.yaml', epochs=100, device=0,batch=32,workers=0,name="yolov11l")
print("results: ", results)
#x
model = YOLO("weights/yolo11x.pt")
results = model.train(data='data/self.yaml', epochs=100, device=0,batch=32,workers=0,name="yolov11x")
print("results: ", results)
这里我们依次选择n、s、m、l和x五款不同参数量级的模型来进行开发。
这里给出yolov11的模型文件如下:
# Parameters
nc: 20 # number of classes
scales: # model compound scaling constants, i.e. 'model=yolo11n.yaml' will call yolo11.yaml with scale 'n'
# [depth, width, max_channels]
n: [0.50, 0.25, 1024] # summary: 319 layers, 2624080 parameters, 2624064 gradients, 6.6 GFLOPs
s: [0.50, 0.50, 1024] # summary: 319 layers, 9458752 parameters, 9458736 gradients, 21.7 GFLOPs
m: [0.50, 1.00, 512] # summary: 409 layers, 20114688 parameters, 20114672 gradients, 68.5 GFLOPs
l: [1.00, 1.00, 512] # summary: 631 layers, 25372160 parameters, 25372144 gradients, 87.6 GFLOPs
x: [1.00, 1.50, 512] # summary: 631 layers, 56966176 parameters, 56966160 gradients, 196.0 GFLOPs
# YOLO11n backbone
backbone:
# [from, repeats, module, args]
– [-1, 1, Conv, [64, 3, 2]] # 0-P1/2
– [-1, 1, Conv, [128, 3, 2]] # 1-P2/4
– [-1, 2, C3k2, [256, False, 0.25]]
– [-1, 1, Conv, [256, 3, 2]] # 3-P3/8
– [-1, 2, C3k2, [512, False, 0.25]]
– [-1, 1, Conv, [512, 3, 2]] # 5-P4/16
– [-1, 2, C3k2, [512, True]]
– [-1, 1, Conv, [1024, 3, 2]] # 7-P5/32
– [-1, 2, C3k2, [1024, True]]
– [-1, 1, SPPF, [1024, 5]] # 9
– [-1, 2, C2PSA, [1024]] # 10
# YOLO11n head
head:
– [-1, 1, nn.Upsample, [None, 2, "nearest"]]
– [[-1, 6], 1, Concat, [1]] # cat backbone P4
– [-1, 2, C3k2, [512, False]] # 13
– [-1, 1, nn.Upsample, [None, 2, "nearest"]]
– [[-1, 4], 1, Concat, [1]] # cat backbone P3
– [-1, 2, C3k2, [256, False]] # 16 (P3/8-small)
– [-1, 1, Conv, [256, 3, 2]]
– [[-1, 13], 1, Concat, [1]] # cat head P4
– [-1, 2, C3k2, [512, False]] # 19 (P4/16-medium)
– [-1, 1, Conv, [512, 3, 2]]
– [[-1, 10], 1, Concat, [1]] # cat head P5
– [-1, 2, C3k2, [1024, True]] # 22 (P5/32-large)
– [[16, 19, 22], 1, Detect, [nc]] # Detect(P3, P4, P5)
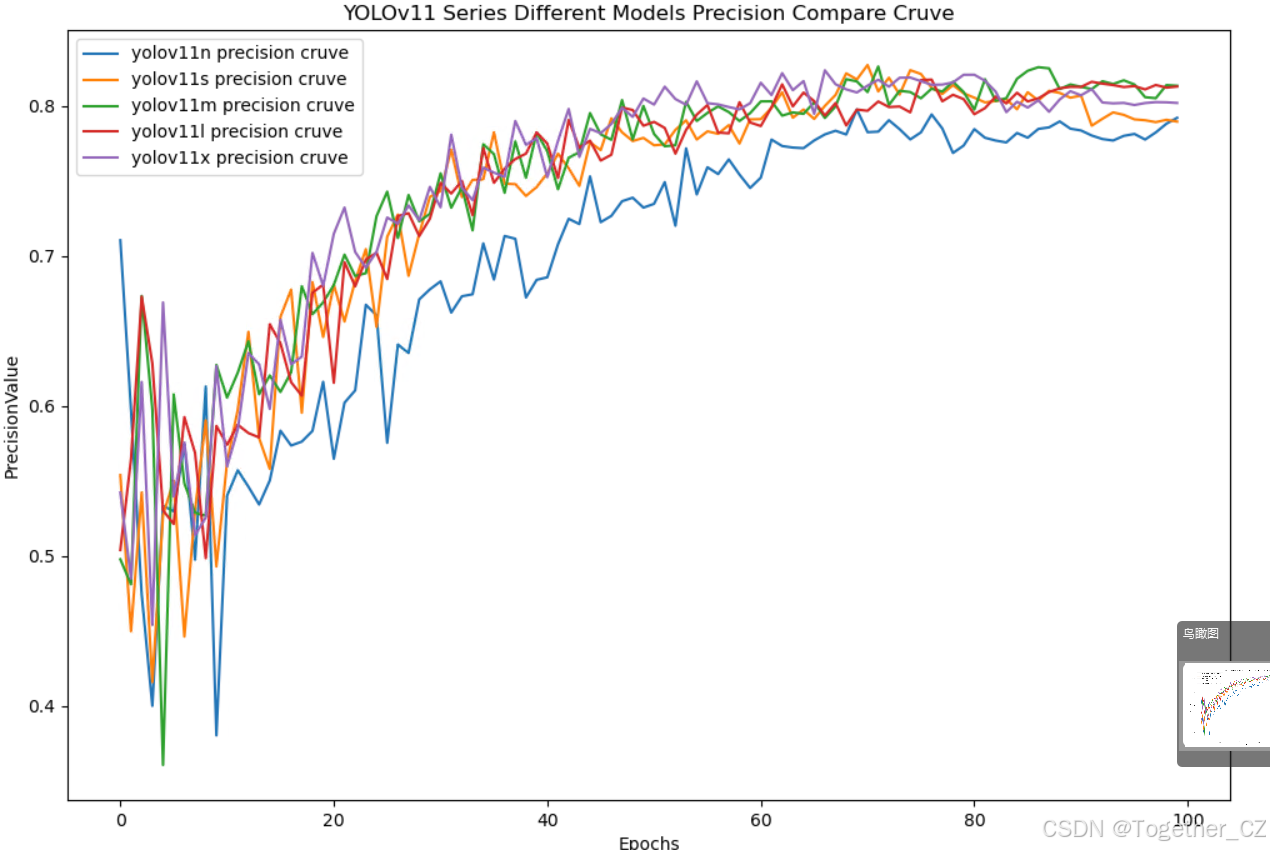
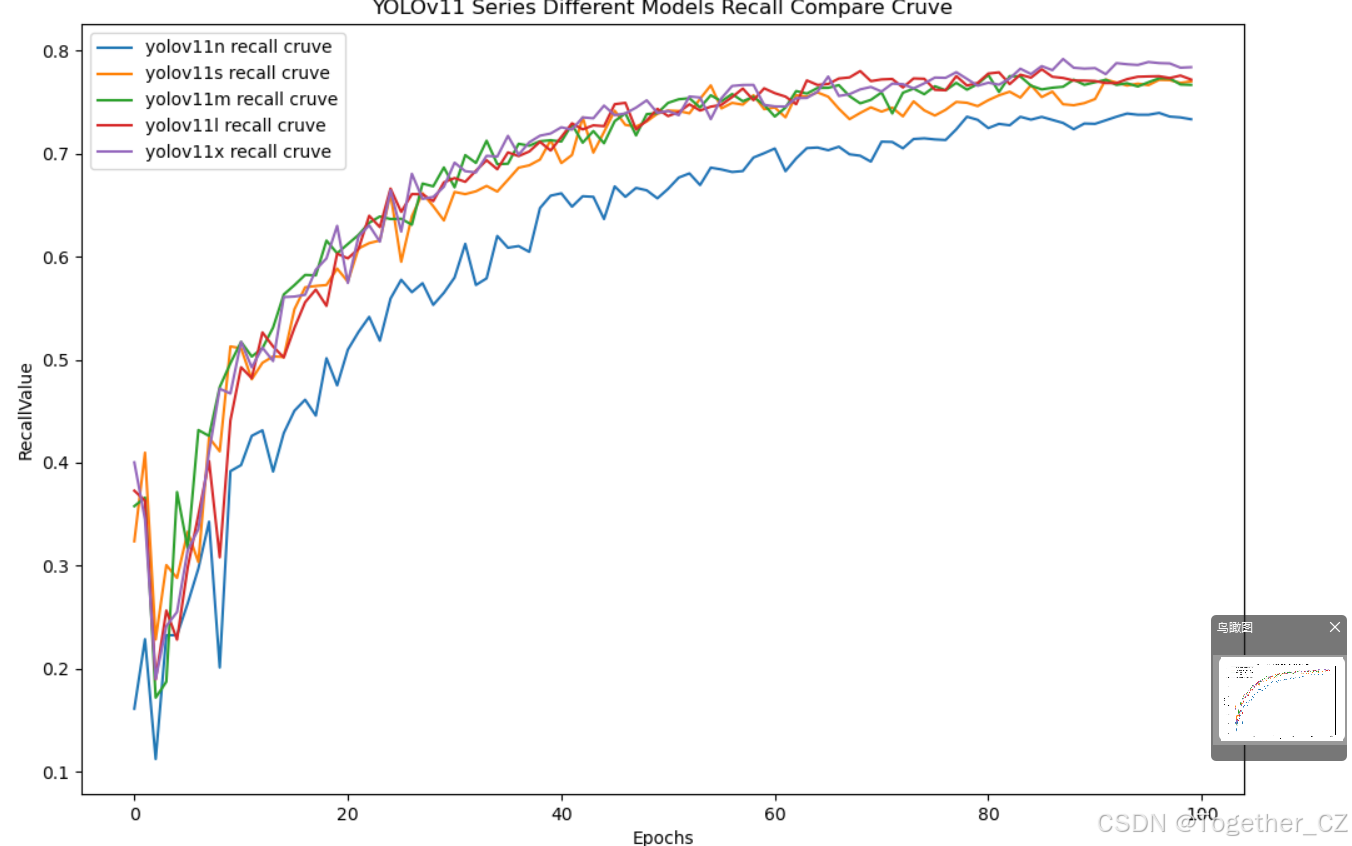
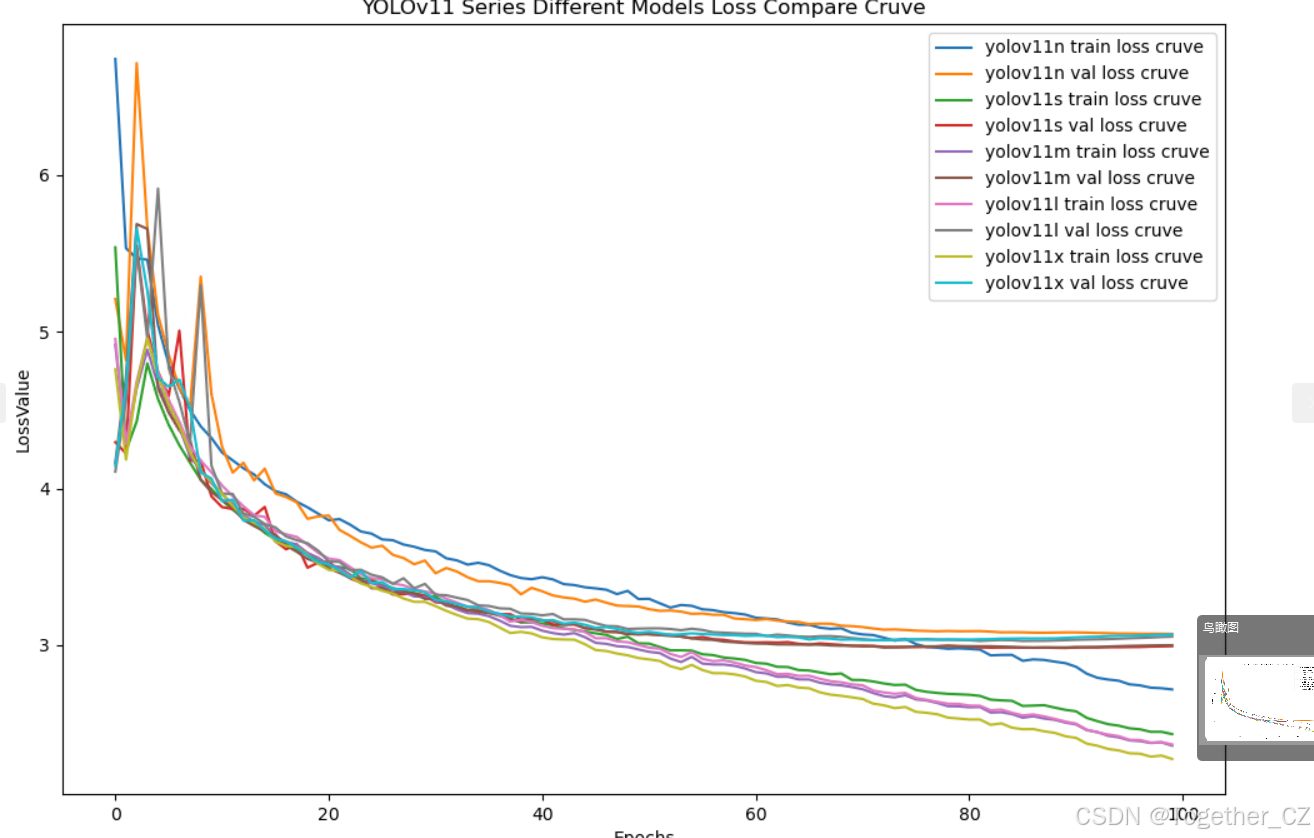
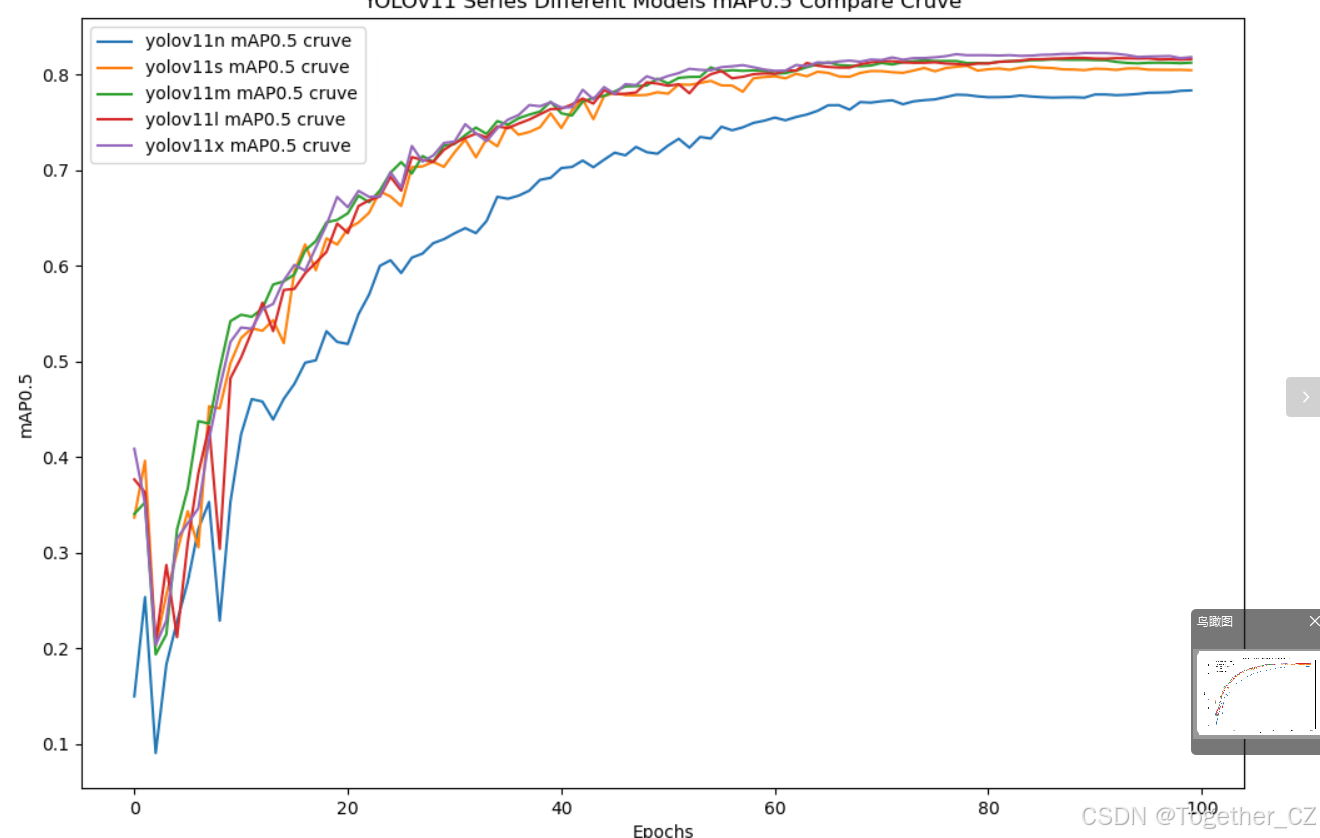
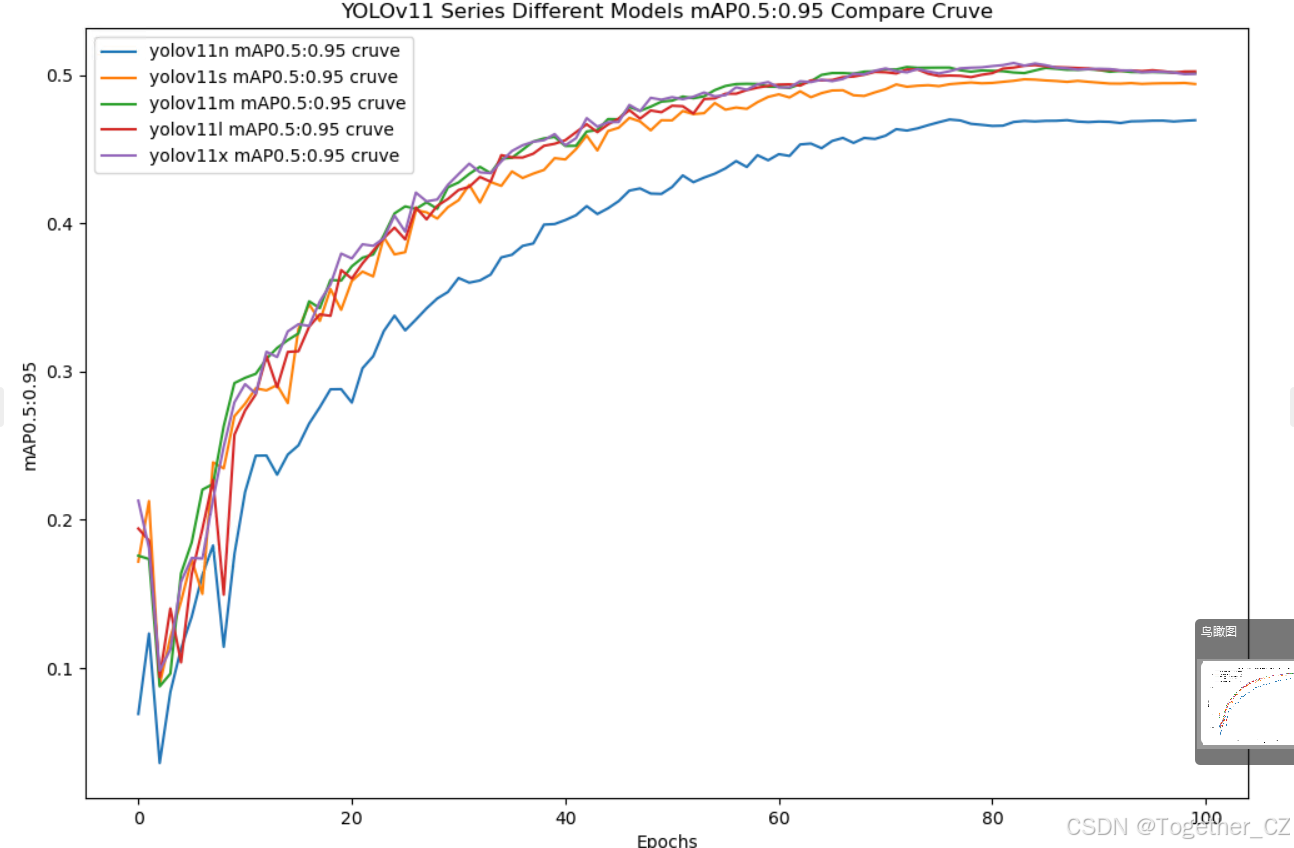
实验阶段我们保持了相同的参数设置,等待长时期的训练过程结束之后我们来对以上六款不同参数量级的模型进行纵向的对比分析,如下:
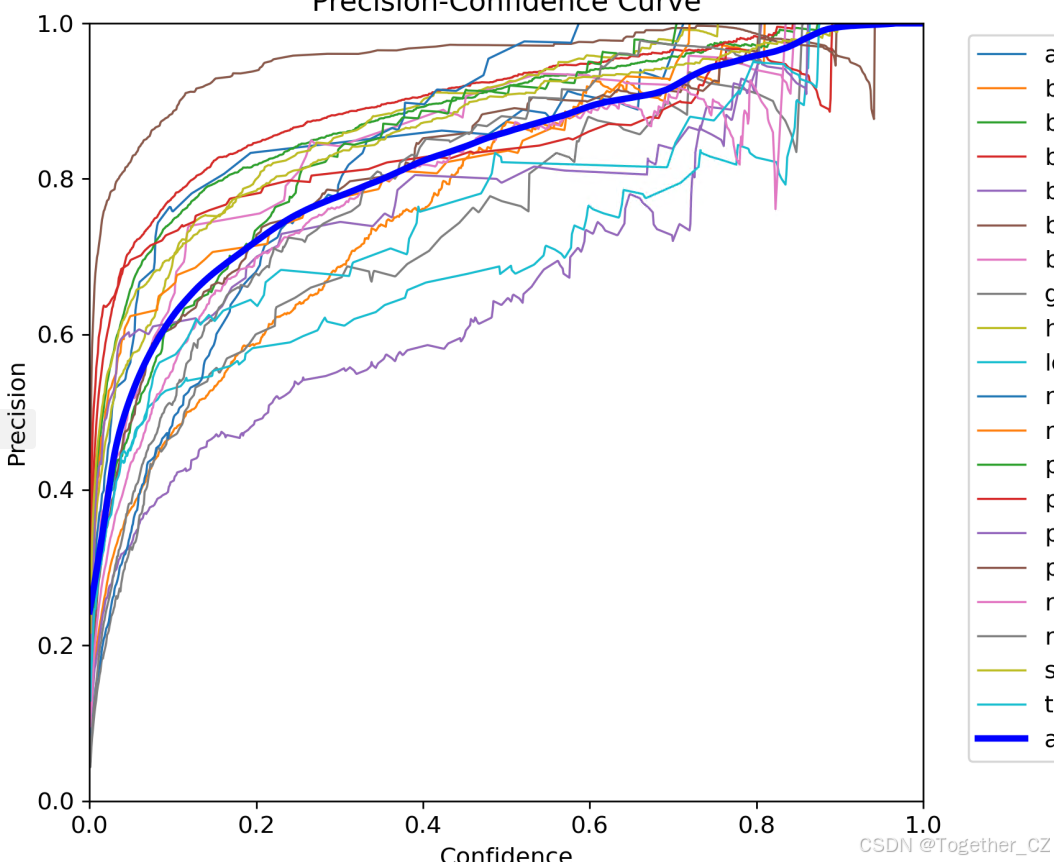
【Precision曲线】 精确率曲线(Precision Curve)是一种用于评估二分类模型在不同阈值下的精确率性能的可视化工具。它通过绘制不同阈值下的精确率和召回率之间的关系图来帮助我们了解模型在不同阈值下的表现。 精确率(Precision)是指被正确预测为正例的样本数占所有预测为正例的样本数的比例。召回率(Recall)是指被正确预测为正例的样本数占所有实际为正例的样本数的比例。 绘制精确率曲线的步骤如下: 使用不同的阈值将预测概率转换为二进制类别标签。通常,当预测概率大于阈值时,样本被分类为正例,否则分类为负例。 对于每个阈值,计算相应的精确率和召回率。 将每个阈值下的精确率和召回率绘制在同一个图表上,形成精确率曲线。 根据精确率曲线的形状和变化趋势,可以选择适当的阈值以达到所需的性能要求。 通过观察精确率曲线,我们可以根据需求确定最佳的阈值,以平衡精确率和召回率。较高的精确率意味着较少的误报,而较高的召回率则表示较少的漏报。根据具体的业务需求和成本权衡,可以在曲线上选择合适的操作点或阈值。 精确率曲线通常与召回率曲线(Recall Curve)一起使用,以提供更全面的分类器性能分析,并帮助评估和比较不同模型的性能。
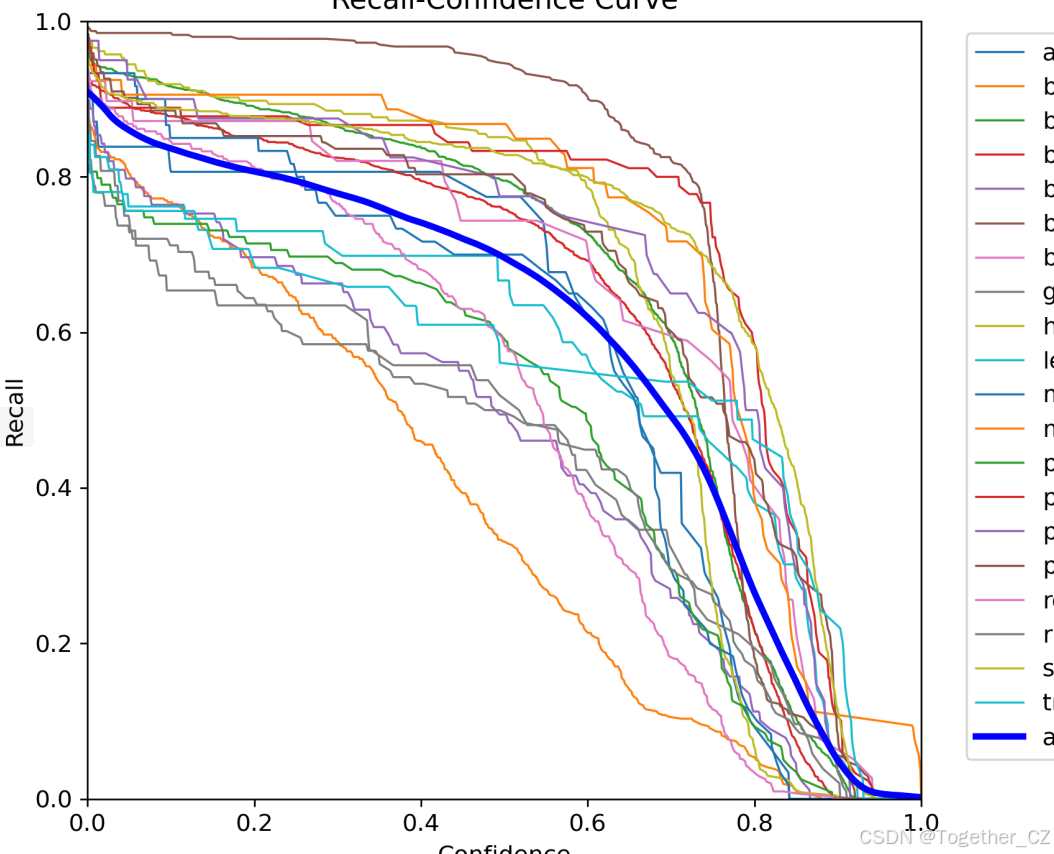
【Recall曲线】 召回率曲线(Recall Curve)是一种用于评估二分类模型在不同阈值下的召回率性能的可视化工具。它通过绘制不同阈值下的召回率和对应的精确率之间的关系图来帮助我们了解模型在不同阈值下的表现。 召回率(Recall)是指被正确预测为正例的样本数占所有实际为正例的样本数的比例。召回率也被称为灵敏度(Sensitivity)或真正例率(True Positive Rate)。 绘制召回率曲线的步骤如下: 使用不同的阈值将预测概率转换为二进制类别标签。通常,当预测概率大于阈值时,样本被分类为正例,否则分类为负例。 对于每个阈值,计算相应的召回率和对应的精确率。 将每个阈值下的召回率和精确率绘制在同一个图表上,形成召回率曲线。 根据召回率曲线的形状和变化趋势,可以选择适当的阈值以达到所需的性能要求。 通过观察召回率曲线,我们可以根据需求确定最佳的阈值,以平衡召回率和精确率。较高的召回率表示较少的漏报,而较高的精确率意味着较少的误报。根据具体的业务需求和成本权衡,可以在曲线上选择合适的操作点或阈值。 召回率曲线通常与精确率曲线(Precision Curve)一起使用,以提供更全面的分类器性能分析,并帮助评估和比较不同模型的性能。
【loss曲线】
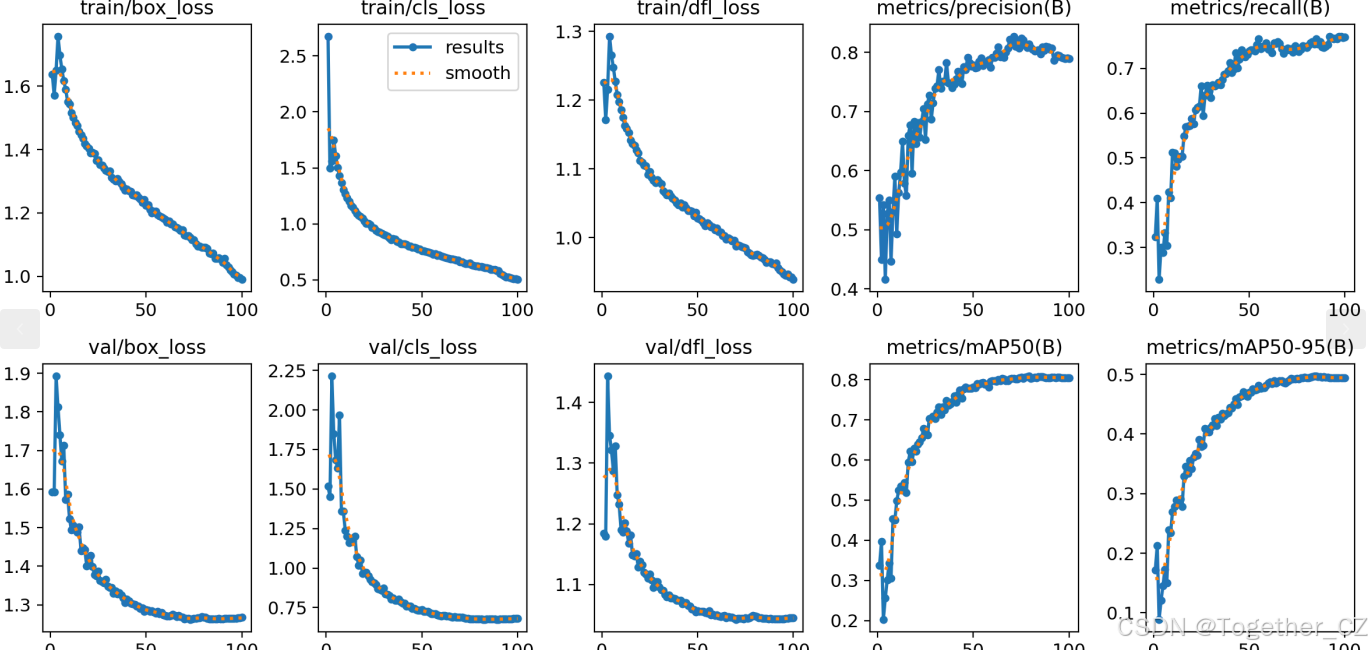
在深度学习的训练过程中,loss函数用于衡量模型预测结果与实际标签之间的差异。loss曲线则是通过记录每个epoch(或者迭代步数)的loss值,并将其以图形化的方式展现出来,以便我们更好地理解和分析模型的训练过程。
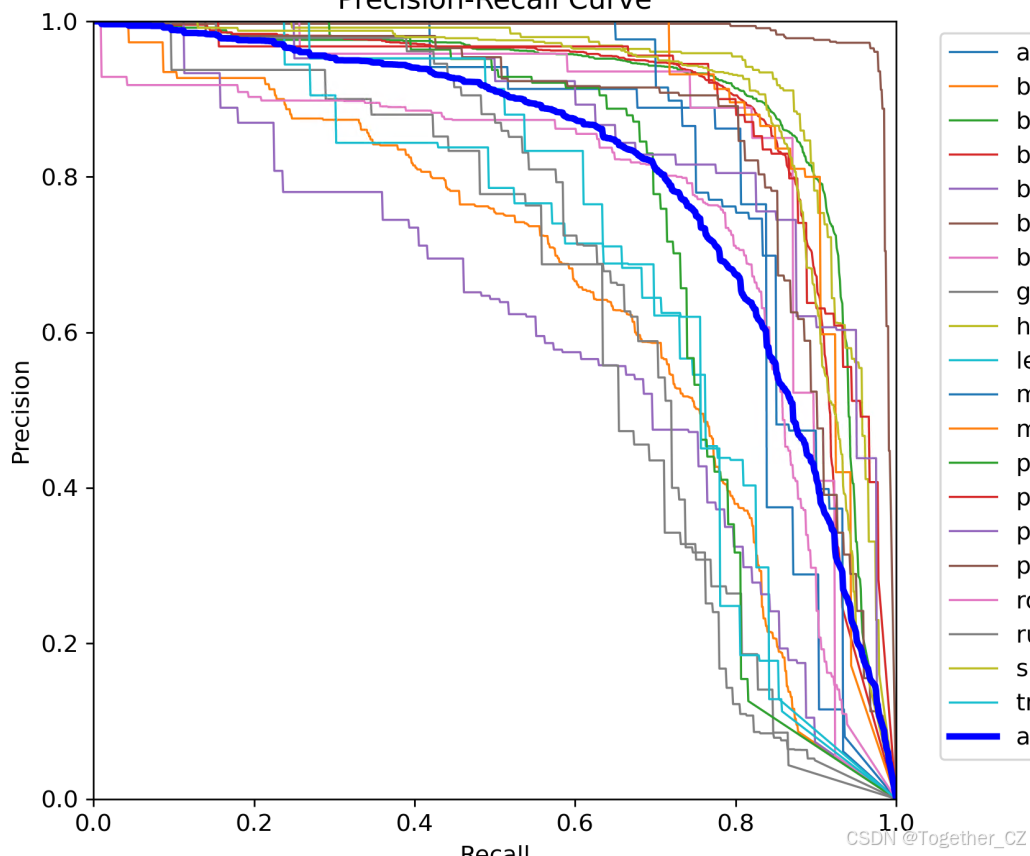
【mAP0.5】 mAP0.5,也被称为mAP@0.5或AP50,指的是当Intersection over Union(IoU)阈值为0.5时的平均精度(mean Average Precision)。IoU是一个用于衡量预测边界框与真实边界框之间重叠程度的指标,其值范围在0到1之间。当IoU值为0.5时,意味着预测框与真实框至少有50%的重叠部分。 在计算mAP0.5时,首先会为每个类别计算所有图片的AP(Average Precision),然后将所有类别的AP值求平均,得到mAP0.5。AP是Precision-Recall Curve曲线下面的面积,这个面积越大,说明AP的值越大,类别的检测精度就越高。 mAP0.5主要关注模型在IoU阈值为0.5时的性能,当mAP0.5的值很高时,说明算法能够准确检测到物体的位置,并且将其与真实标注框的IoU值超过了阈值0.5。
【mAP0.5:0.95】 mAP0.5:0.95,也被称为mAP@[0.5:0.95]或AP@[0.5:0.95],表示在IoU阈值从0.5到0.95变化时,取各个阈值对应的mAP的平均值。具体来说,它会在IoU阈值从0.5开始,以0.05为步长,逐步增加到0.95,并在每个阈值下计算mAP,然后将这些mAP值求平均。 这个指标考虑了多个IoU阈值下的平均精度,从而更全面、更准确地评估模型性能。当mAP0.5:0.95的值很高时,说明算法在不同阈值下的检测结果均非常准确,覆盖面广,可以适应不同的场景和应用需求。 对于一些需求比较高的场合,比如安全监控等领域,需要保证高的准确率和召回率,这时mAP0.5:0.95可能更适合作为模型的评价标准。 综上所述,mAP0.5和mAP0.5:0.95都是用于评估目标检测模型性能的重要指标,但它们的关注点有所不同。mAP0.5主要关注模型在IoU阈值为0.5时的性能,而mAP0.5:0.95则考虑了多个IoU阈值下的平均精度,从而更全面、更准确地评估模型性能。
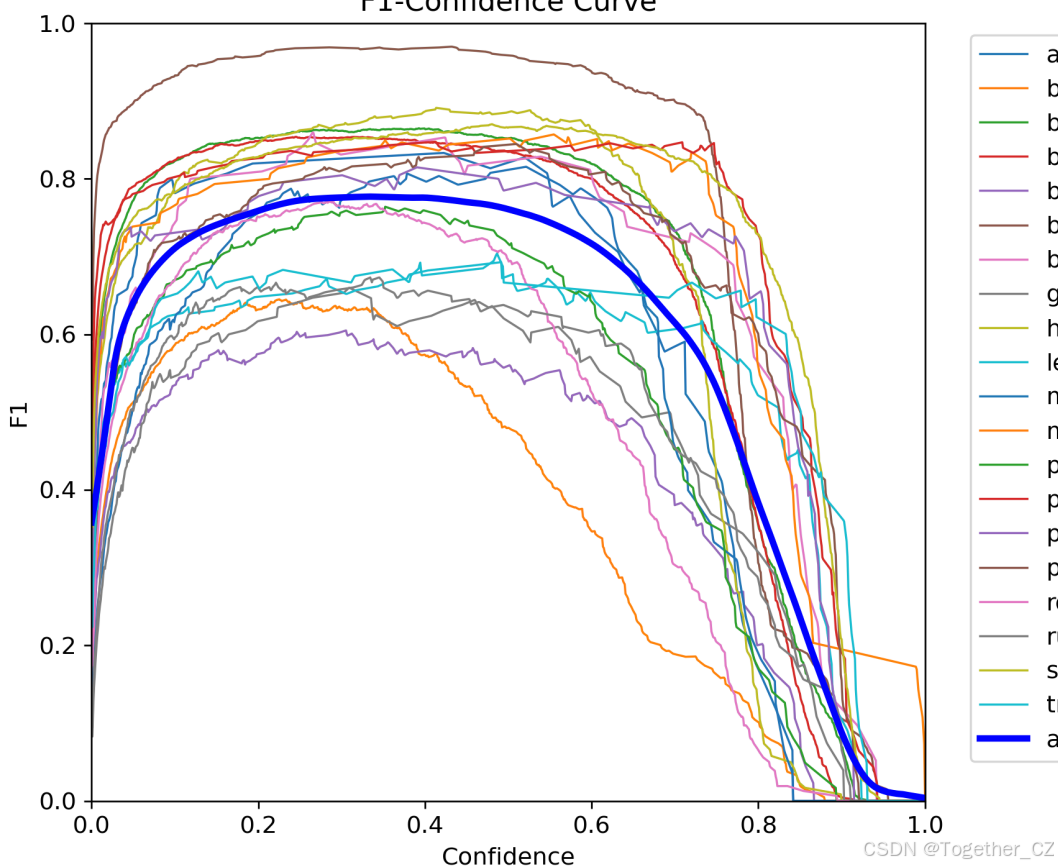
【F1值曲线】 F1值曲线是一种用于评估二分类模型在不同阈值下的性能的可视化工具。它通过绘制不同阈值下的精确率(Precision)、召回率(Recall)和F1分数的关系图来帮助我们理解模型的整体性能。 F1分数是精确率和召回率的调和平均值,它综合考虑了两者的性能指标。F1值曲线可以帮助我们确定在不同精确率和召回率之间找到一个平衡点,以选择最佳的阈值。 绘制F1值曲线的步骤如下: 使用不同的阈值将预测概率转换为二进制类别标签。通常,当预测概率大于阈值时,样本被分类为正例,否则分类为负例。 对于每个阈值,计算相应的精确率、召回率和F1分数。 将每个阈值下的精确率、召回率和F1分数绘制在同一个图表上,形成F1值曲线。 根据F1值曲线的形状和变化趋势,可以选择适当的阈值以达到所需的性能要求。 F1值曲线通常与接收者操作特征曲线(ROC曲线)一起使用,以帮助评估和比较不同模型的性能。它们提供了更全面的分类器性能分析,可以根据具体应用场景来选择合适的模型和阈值设置。
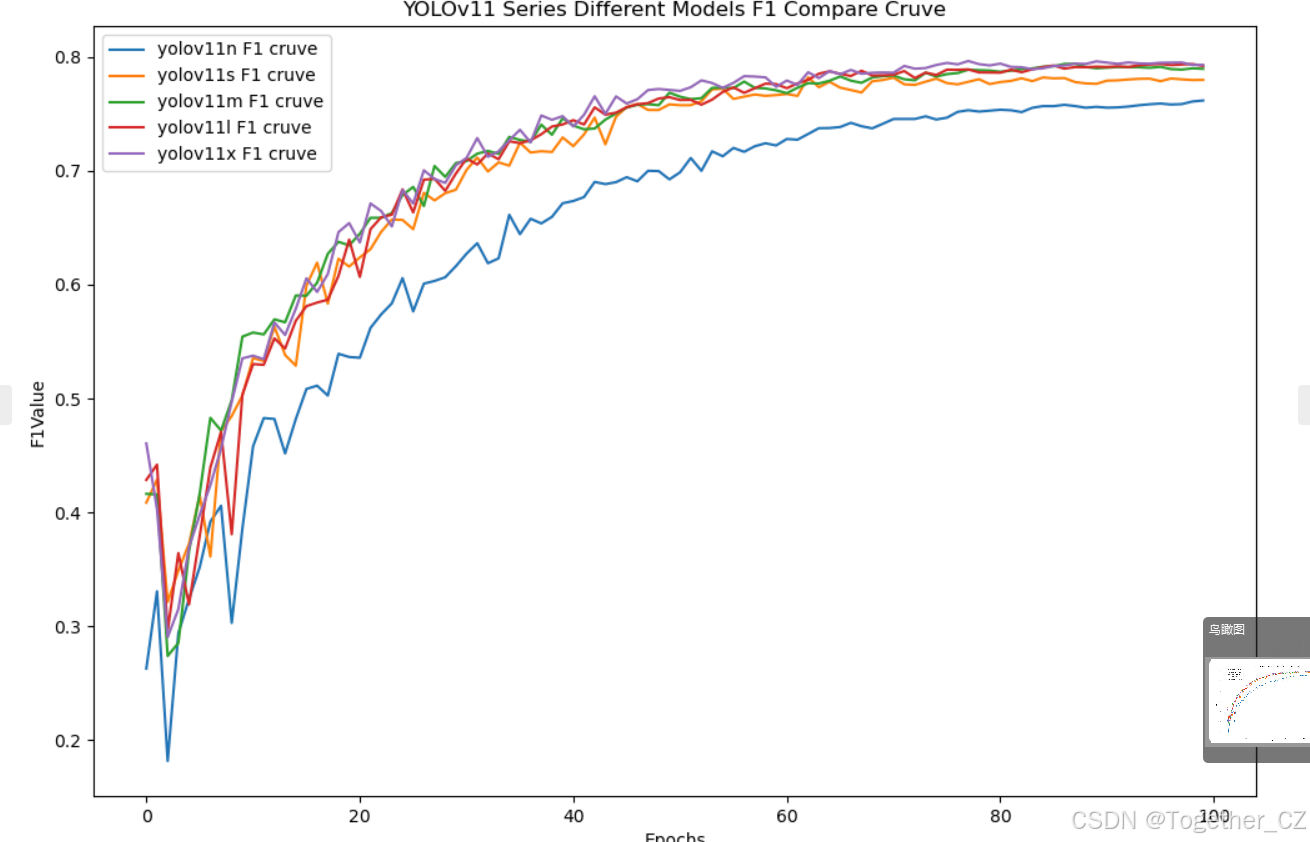
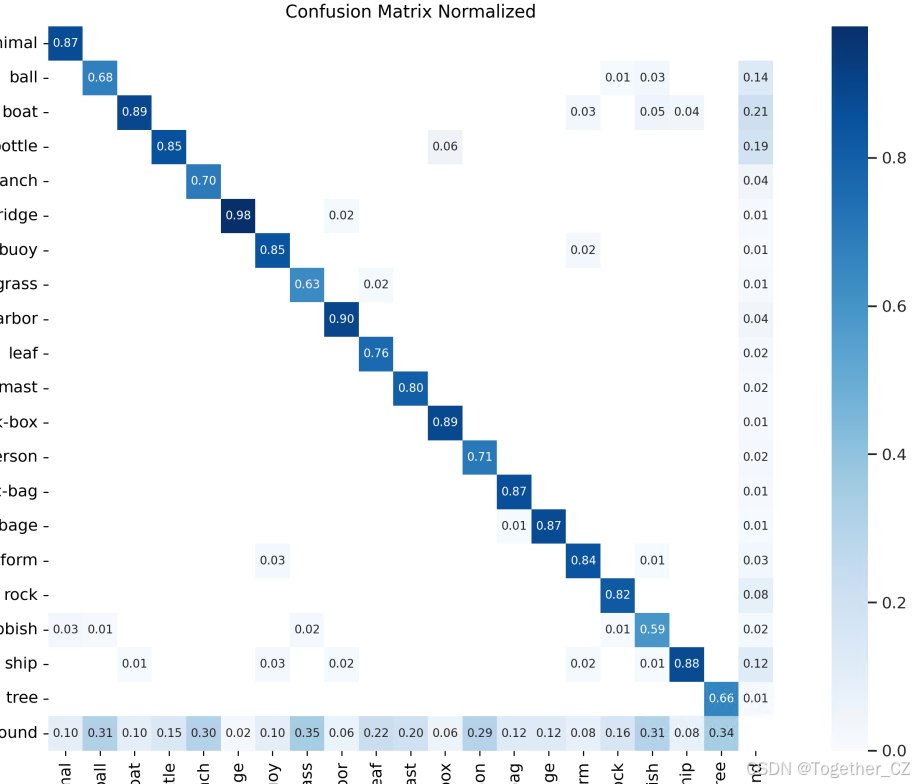
综合五款不同参数量级模型的开发实验对比结果来看:5款模型并没有拉开较为明显的差距,n系列模效果最差,s、m、l和x系列模型效果接近,综合对比考虑最终选择使用yolov11s来作为线上推理模型。
接下来看下yolov11s模型的详细情况。
【离线推理实例】
【Batch实例】
【混淆矩阵】
【F1值曲线】
【Precision曲线】
【PR曲线】
【Recall曲线】
【训练可视化】
数字化、智慧化是城市水环境治理的必然趋势。AI技术与河道治理场景的深度融合,重构了城市河道管护工作流程,优化了治理资源配置,大幅提升了河道治理的精细化、智能化、现代化水平。未来,随着人工智能、数字孪生、大数据分析等技术的持续升级,智慧河道治理体系将不断完善,进一步实现河道风险预判、水质动态监测、治理成效智能分析等功能,持续夯实城市水生态安全屏障,为城市高质量发展、人居环境提质、防汛安全保障提供坚实支撑。