NLP分词与Word2Vec词向量深度解析
- 一、英文分词
-
- 1. 词级分词
- 2. 字符级分词
- 3. 子词级分词
- 二、中文分词
-
- 1. 字符级分词
- 2. 词级分词
- 3. 子词级分词
- 三、分词工具
-
- 1. jieba 分词器
- 2. One-hot 编码
- 3. Word2Vec 词嵌入
-
- 3.1 Word2Vec 概述
- 3.2 Word2Vec 原理
-
- Skip-Gram
- CBOW
- 3.3 获取 Word2Vec 词向量
-
- 使用公开词向量
- 自行训练词向量
-
- 1. 准备语料
- 2. 训练模型
- 3. 保存词向量
- 4. 加载词向量
- 3.4 应用 Word2Vec 词向量
一、英文分词
按照分词粒度的不同,可将英文分词划分为三种类型:词级分词(Word-Level)、字符级分词(Character-Level) 和 子词级分词(Subword-Level)。下面逐一展开介绍。
1. 词级分词
词级分词是指将文本按照完整的词语进行切分,是最传统、最直观的分词方式。在英文中,空格和标点通常充当天然的分隔符。
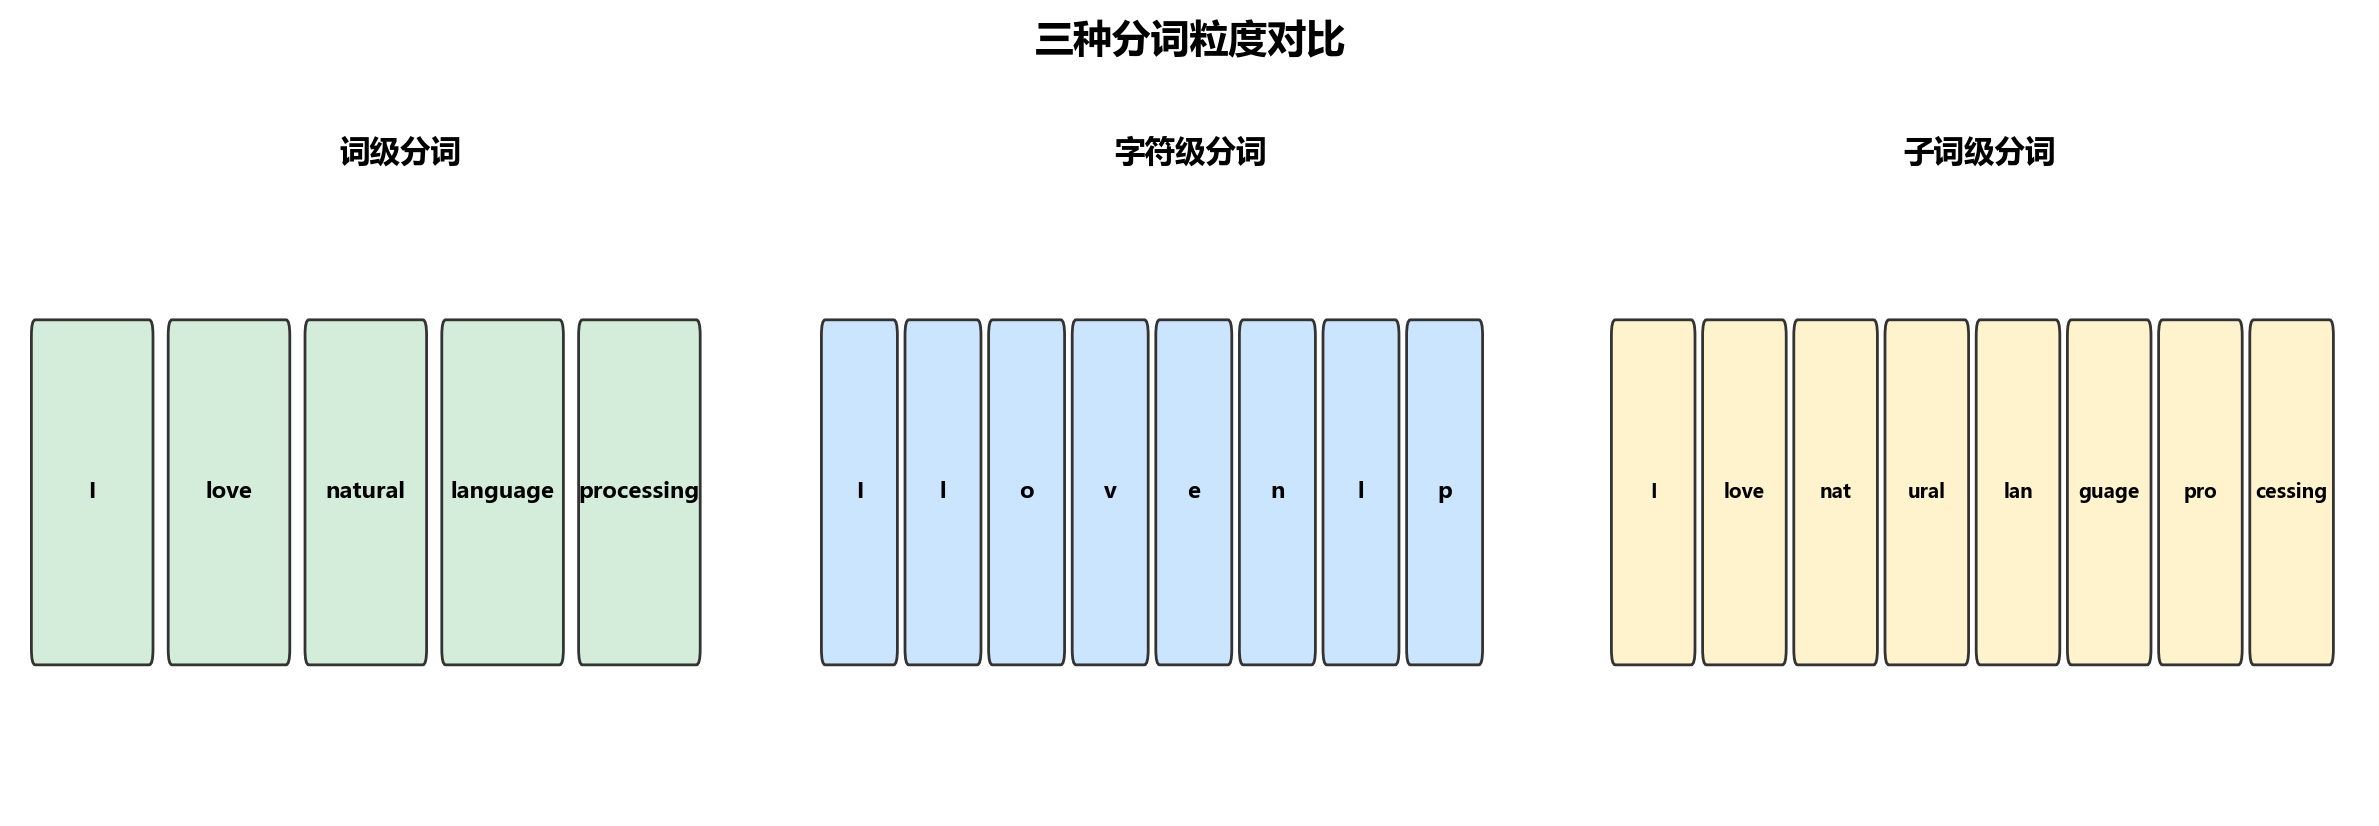
词级分词虽然便于理解和实现,但在实际应用中容易遭遇 OOV(Out-of-Vocabulary,未登录词) 问题。所谓OOV,是指在模型使用阶段,输入文本中出现了不在预先构建词表中的词语,例如网络热词、专有名词、复合词及拼写变体等。由于模型无法识别这些词,通常会将它们统一替换为特殊标记(如 <UNK>),从而导致语义信息丢失,影响模型的理解与预测能力。
2. 字符级分词
字符级分词(Character-level Tokenization)是以单个字符为最小单位进行切分的方法。文本中的每一个字母、数字、标点乃至空格,都会被视作一个独立的 token。
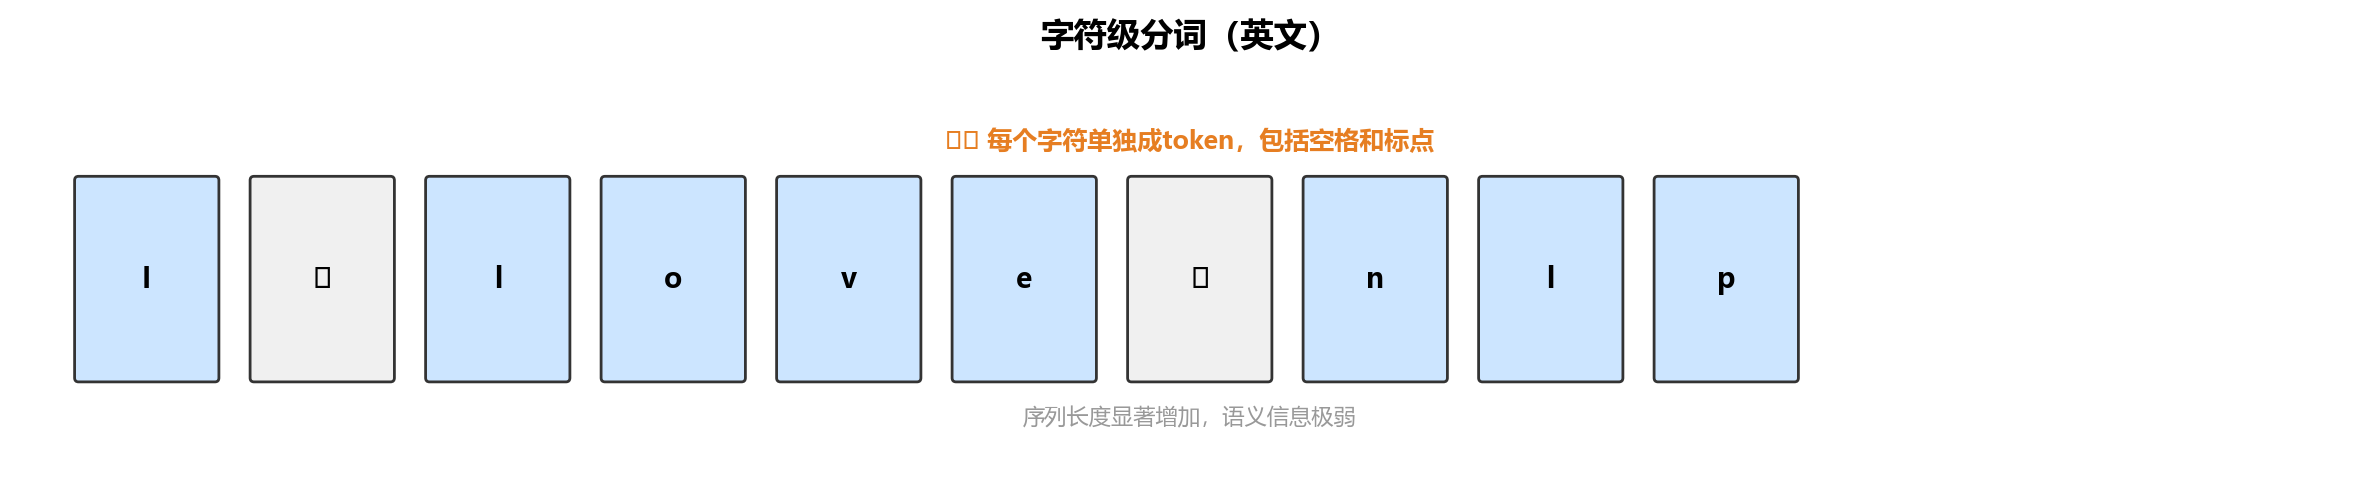
在这种分词方式下,词表仅由所有可能出现的字符组成,因此词表规模极小,覆盖率极高,几乎不存在 OOV 问题。无论输入中出现什么新词或拼写变体,只要字符在词表中,都能被正常表示。
然而,单个字符本身所承载的语义信息极弱,模型必须依赖更长的上下文来推断词义和结构,这显著增加了建模难度和训练成本。同时,输入序列也会变得更长,影响模型效率。
3. 子词级分词
子词级分词是一种介于词级与字符级之间的分词方法,它将词语切分为更小的语义单元——子词(subword),例如词根、前缀、后缀或常见的词片段。
与词级分词相比,子词分词能显著缓解 OOV 问题;与字符级分词相比,它又能更好地保留语义结构。
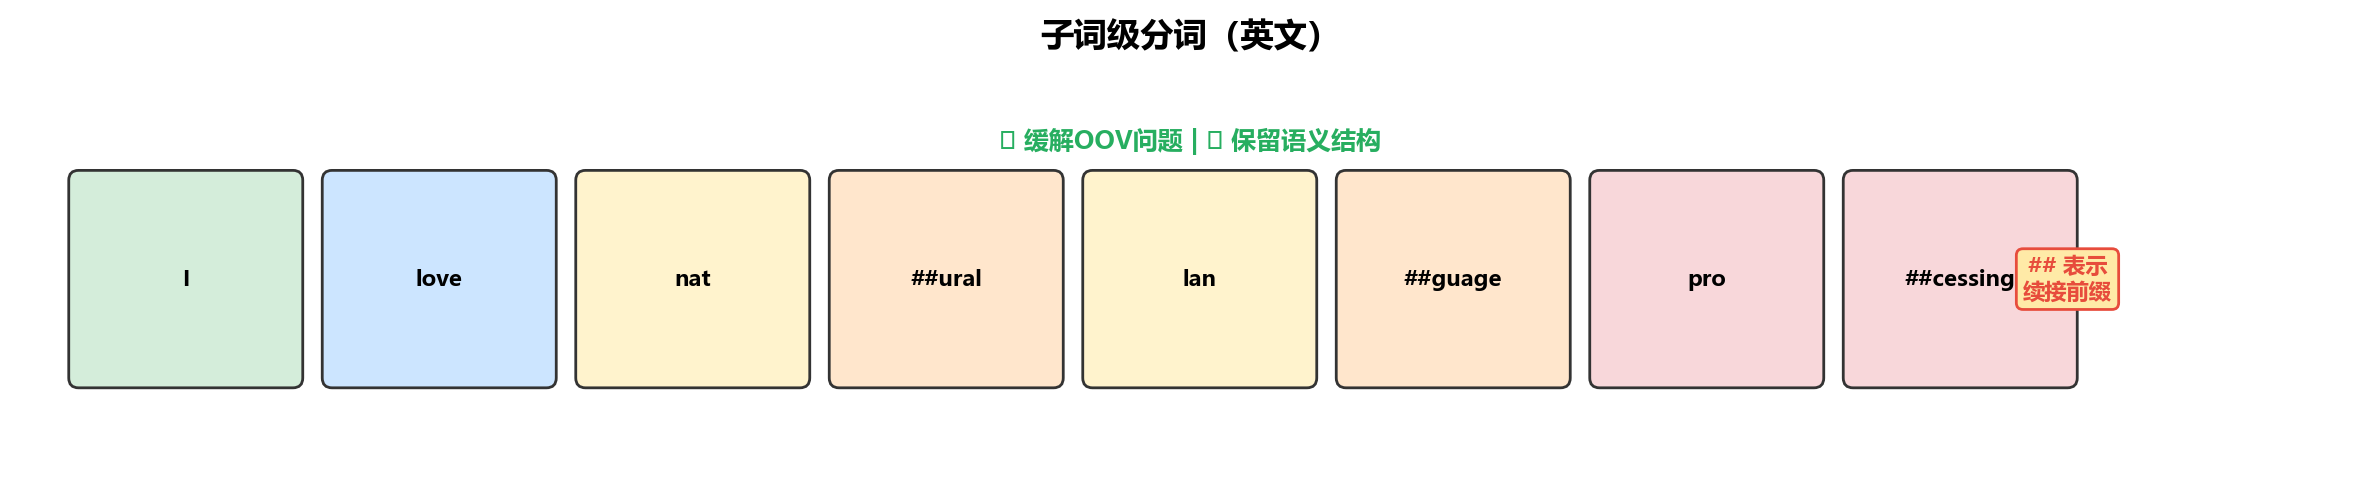
子词分词的核心思想是:即使一个完整的词没有出现在词表中,只要它可以被拆分为词表中已有的子词单元,模型就能识别和表示它,从而避免整体被替换为 <UNK>。
常见的子词分词算法包括 BPE(Byte Pair Encoding)、WordPiece 和 Unigram Language Model。
其中,BPE 是最早被广泛应用的子词分词方法。其基本思想是:
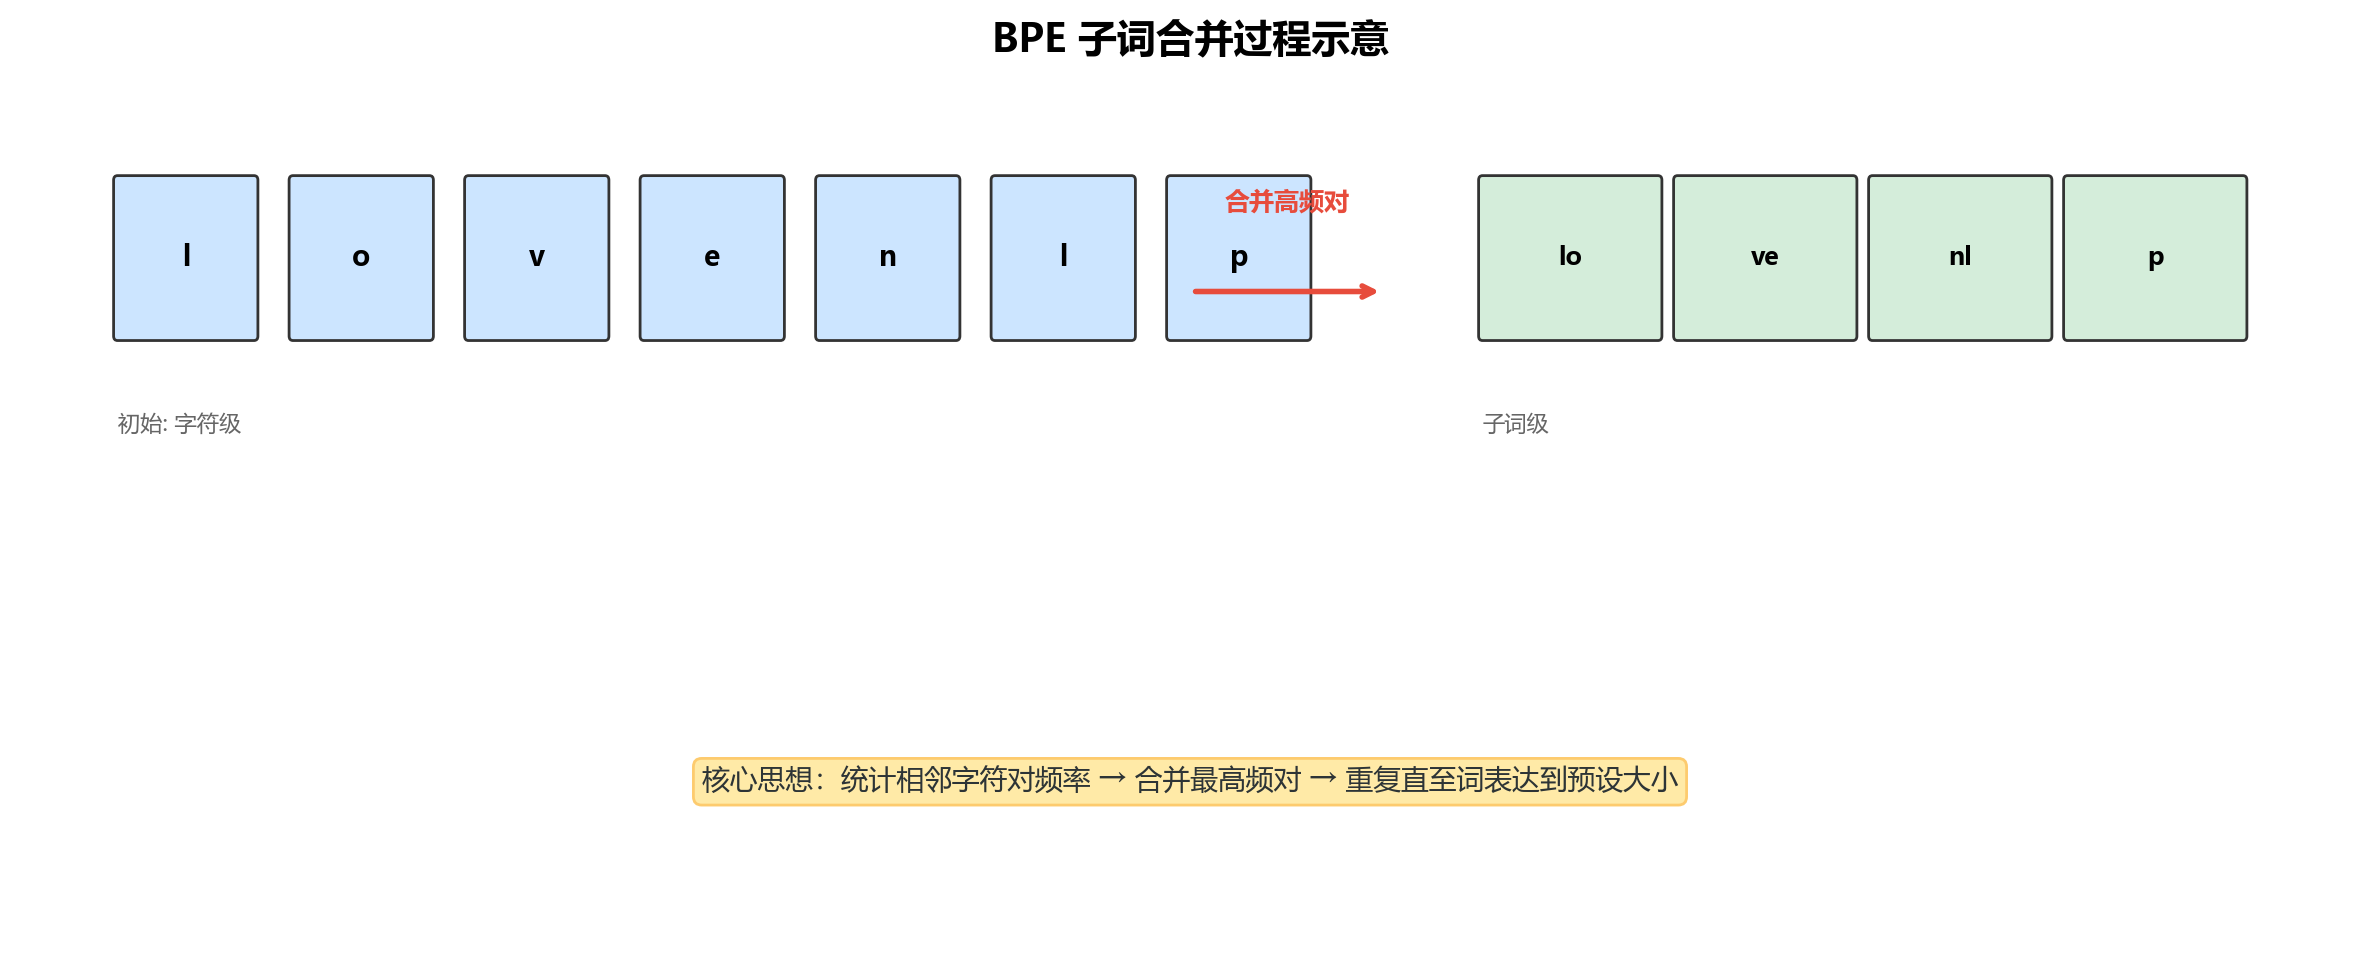
子词级分词已成为现代英文 NLP 模型中的主流方法,如 BERT、GPT 等模型均采用了基于子词的分词机制。
二、中文分词
1. 字符级分词
字符级分词是中文处理中最简单的一种方式,即按照单个汉字进行切分。文本中的每一个汉字都被视为一个独立的 token。
由于汉字本身通常具有独立的语义,因此字符级分词在中文中具备天然的可行性。相比英文中的字符分词,中文的字符分词更加"语义友好"。
2. 词级分词
词级分词是将中文文本按照完整词语进行切分的传统方法,切分结果更贴近人类的阅读习惯。
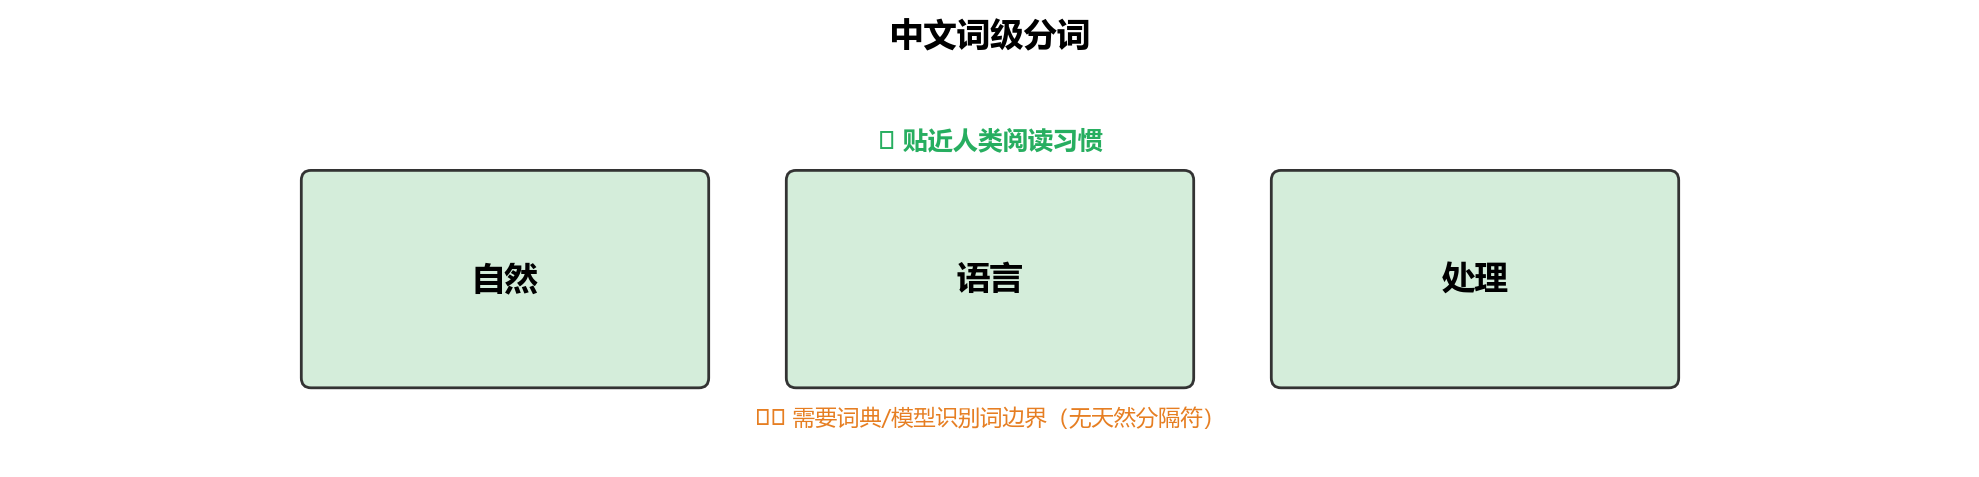
由于中文没有空格等天然词边界,词级分词通常依赖词典、规则或模型来识别词语边界。
3. 子词级分词
虽然中文没有英文中典型的前缀、后缀、词根等子词结构,但子词分词算法(如 BPE)仍可直接应用于中文。它们以汉字为基本单位,通过学习语料中高频出现的字组合(如"自然"、“语言”、“处理”),自动构建子词词表。这种方式无需人工词典,具有较强的适应能力。
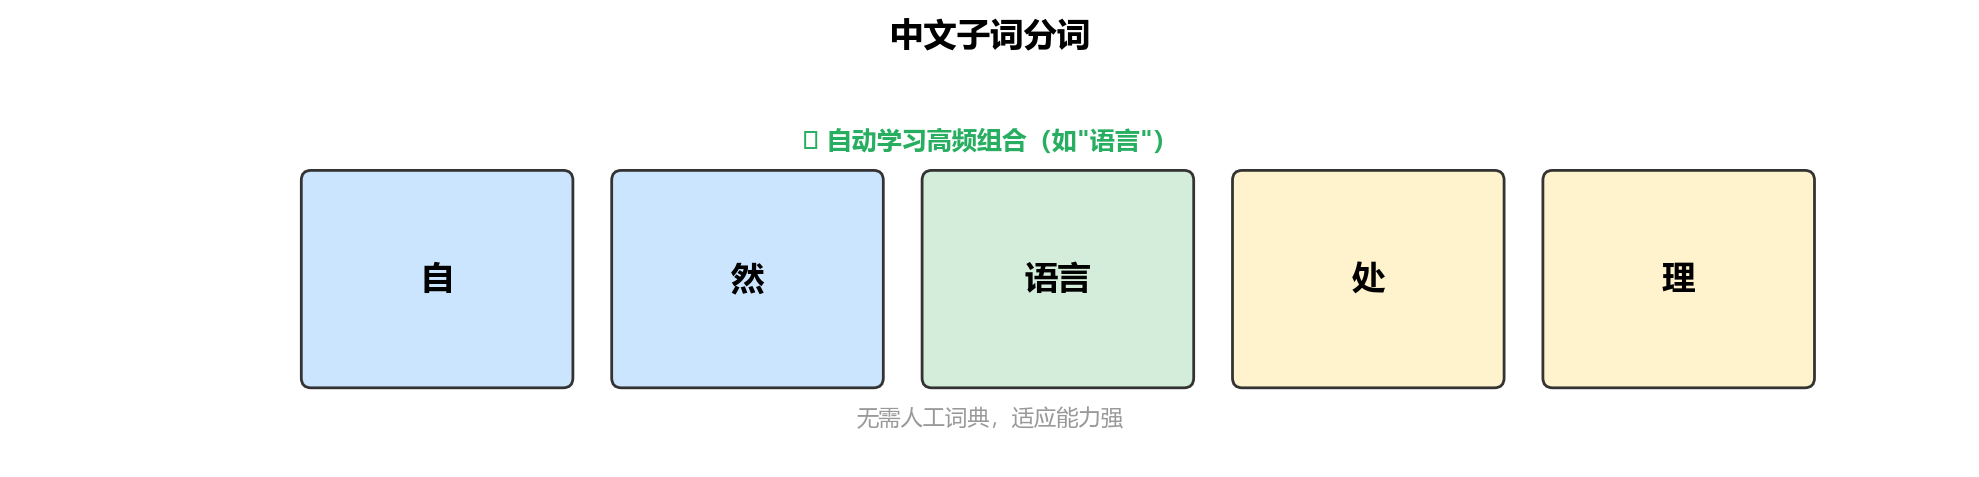
在当前主流的中文大模型(如通义千问、DeepSeek)中,子词分词已成为广泛采用的文本切分策略。
三、分词工具
目前市面上可用于中文分词的工具种类繁多,按实现方式可分为两大类:
- 基于词典或规则的传统方法:以"词"为单位进行切分,代表工具包括 jieba、HanLP 等
- 基于子词建模算法(如BPE):从数据中自动学习高频组合,构建子词词表,代表工具包括 Hugging Face Tokenizer、SentencePiece、tiktoken 等
1. jieba 分词器
关于 jieba 库的详细介绍,可参考:
一文快速上手 Python 中文分词神器 —— jieba 库
2. One-hot 编码
关于 One-hot 编码的详细介绍,可参考:
机器学习:数据预处理之独热编码(One-Hot)详解
3. Word2Vec 词嵌入
3.1 Word2Vec 概述
Word2Vec 的设计理念源自分布假设(Distributional Hypothesis)——即一个词的含义由它周围的词决定。
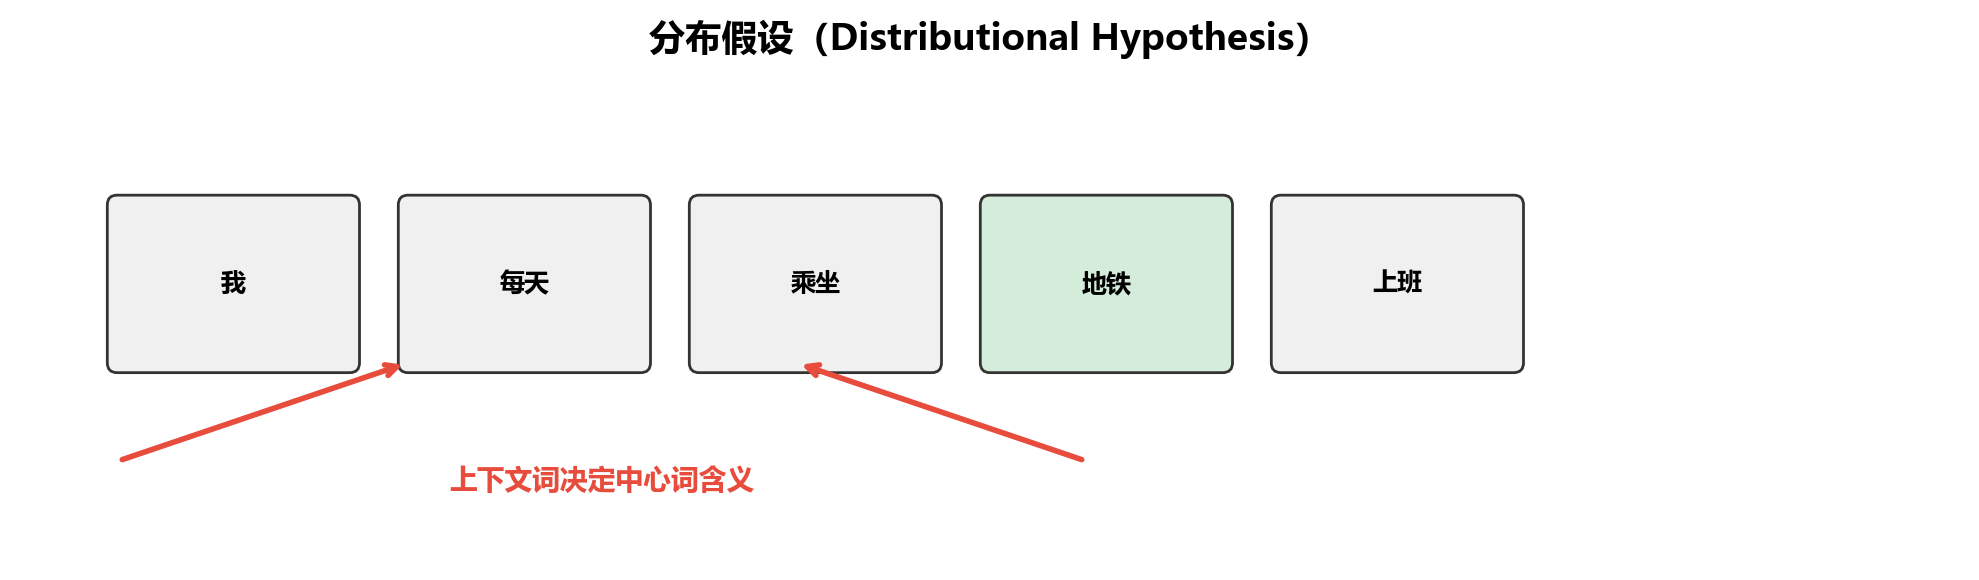
基于这一假设,Word2Vec 构建了一个简洁的神经网络模型,通过学习词与上下文之间的关系,自动为每个词生成一个能反映语义特征的稠密向量表示。
Word2Vec 提供了两种典型的模型结构:
| CBOW(Continuous Bag-of-Words) | 上下文词(前后若干个词) | 预测目标中心词 |
| Skip-gram | 中心词 | 预测上下文词(前后若干个词) |
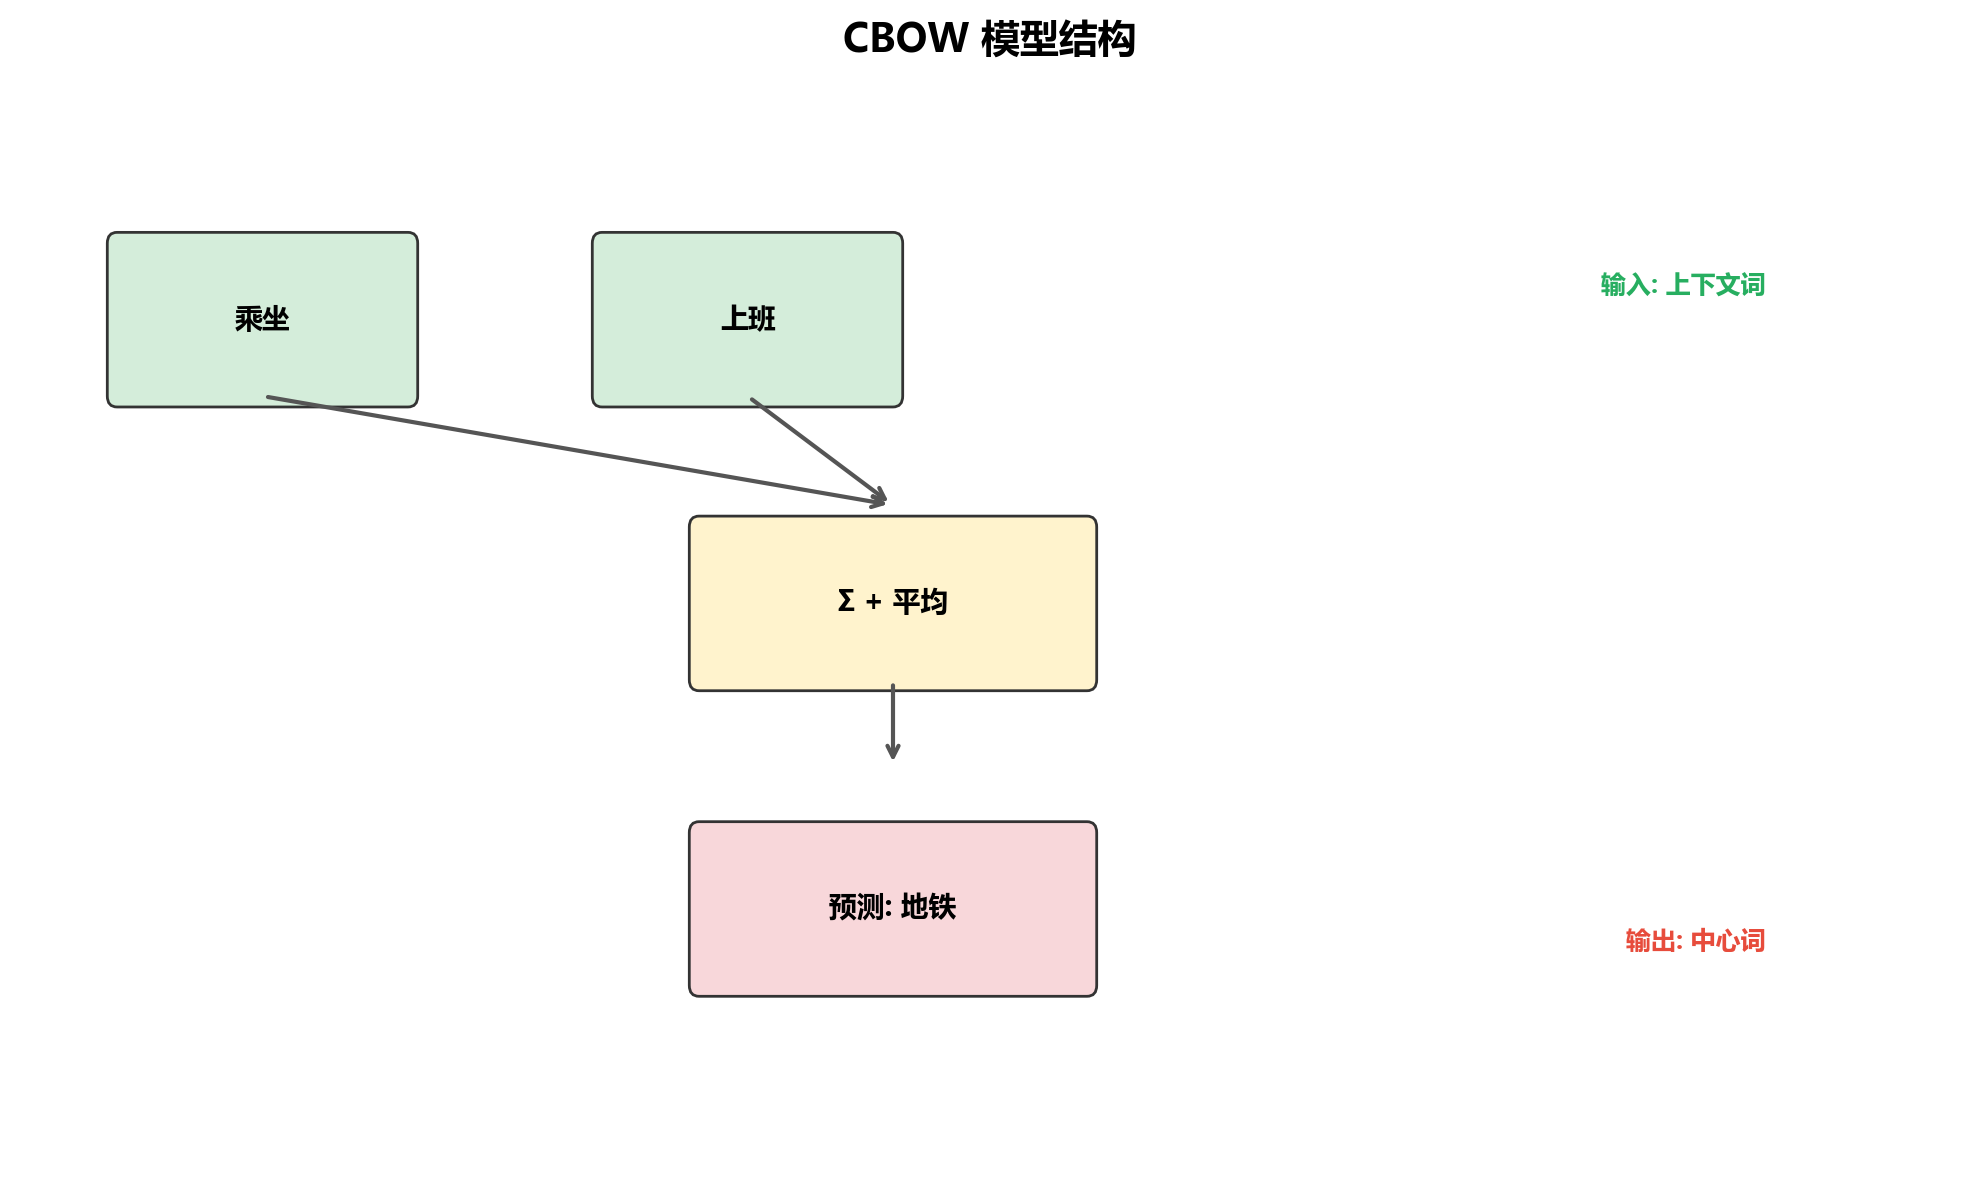
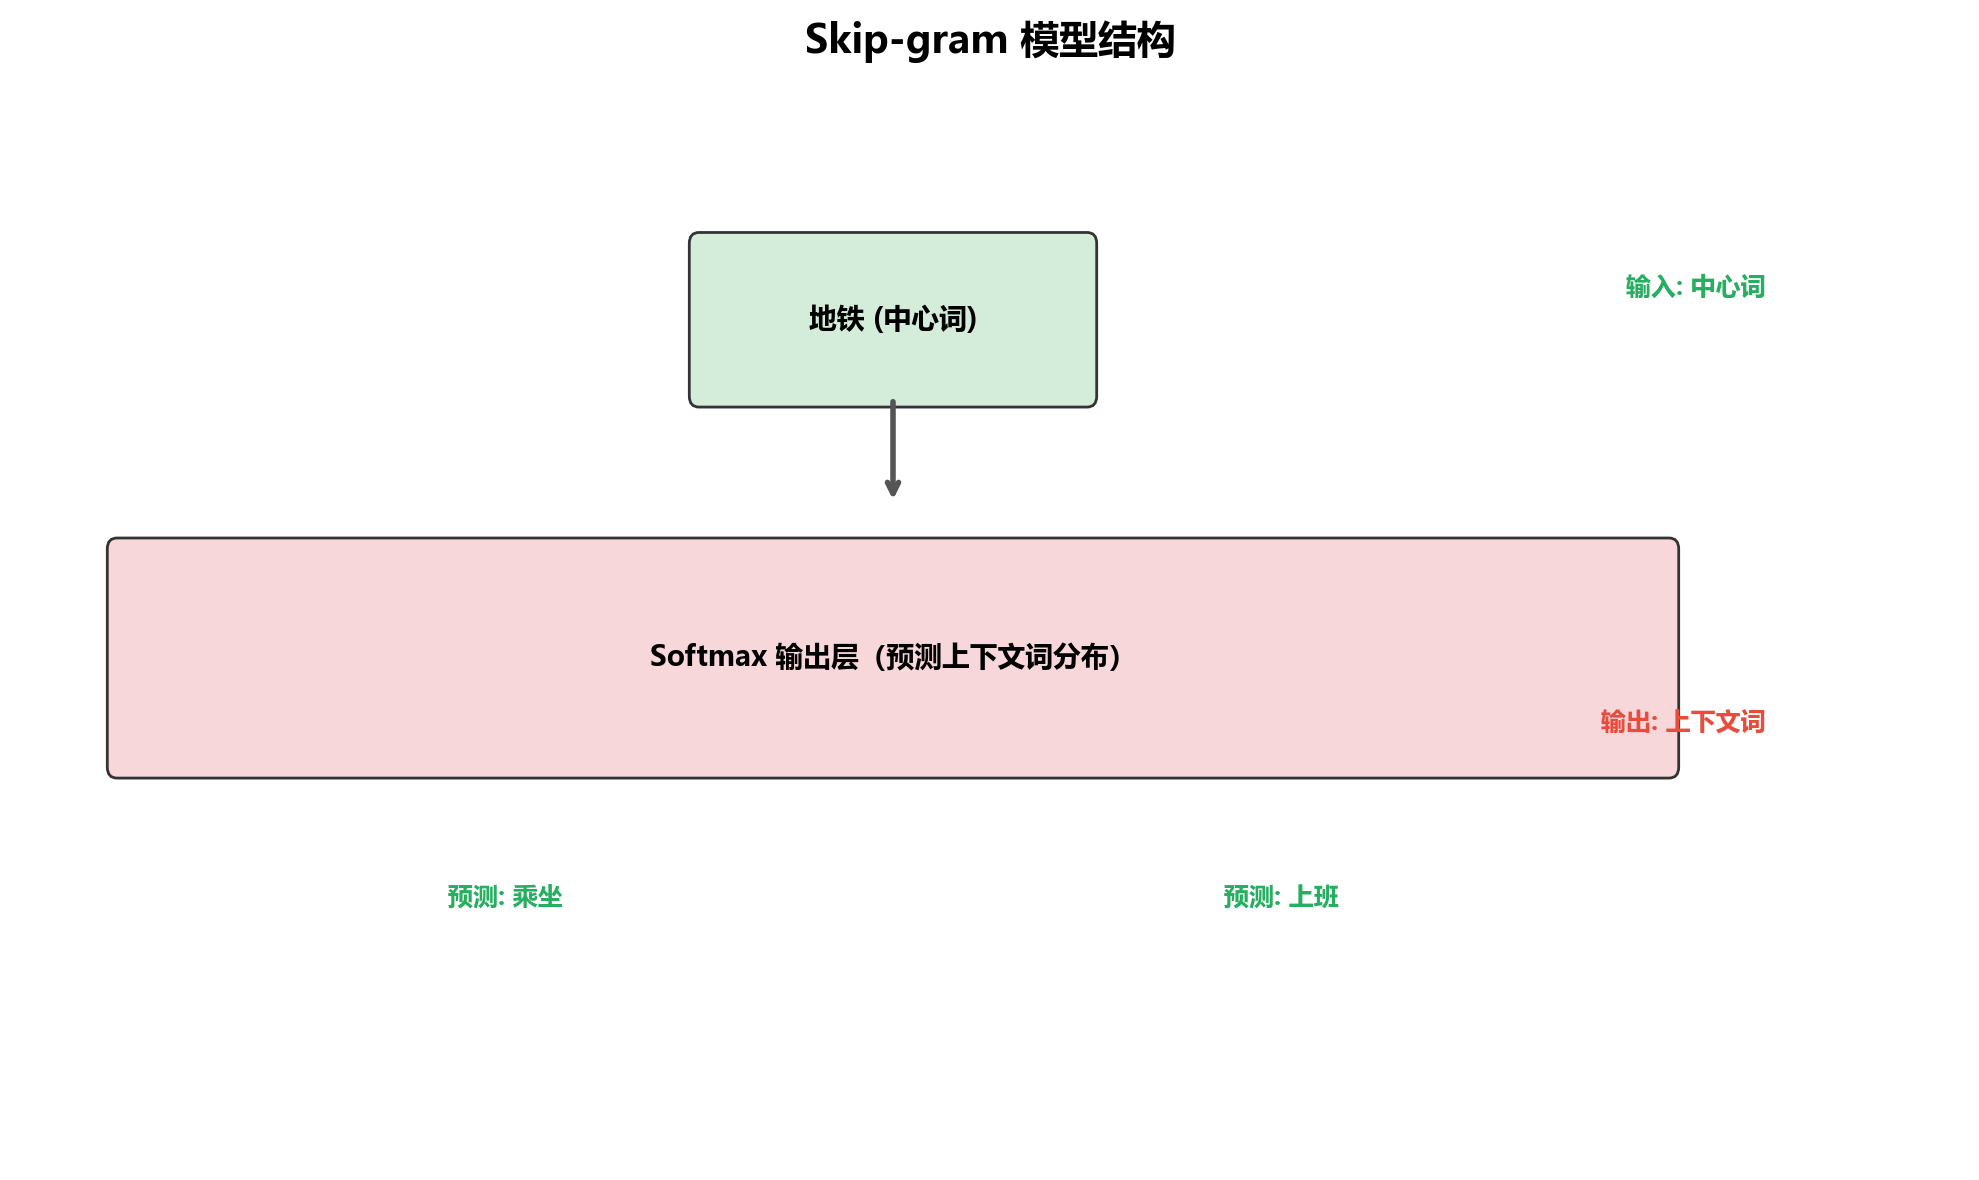
只要按照上述目标训练模型,就能得到语义化的词向量。
3.2 Word2Vec 原理
Word2Vec 不依赖人工标注,而是直接利用大规模原始文本(如书籍、新闻、网页等)作为数据源,从中自动构造训练样本。
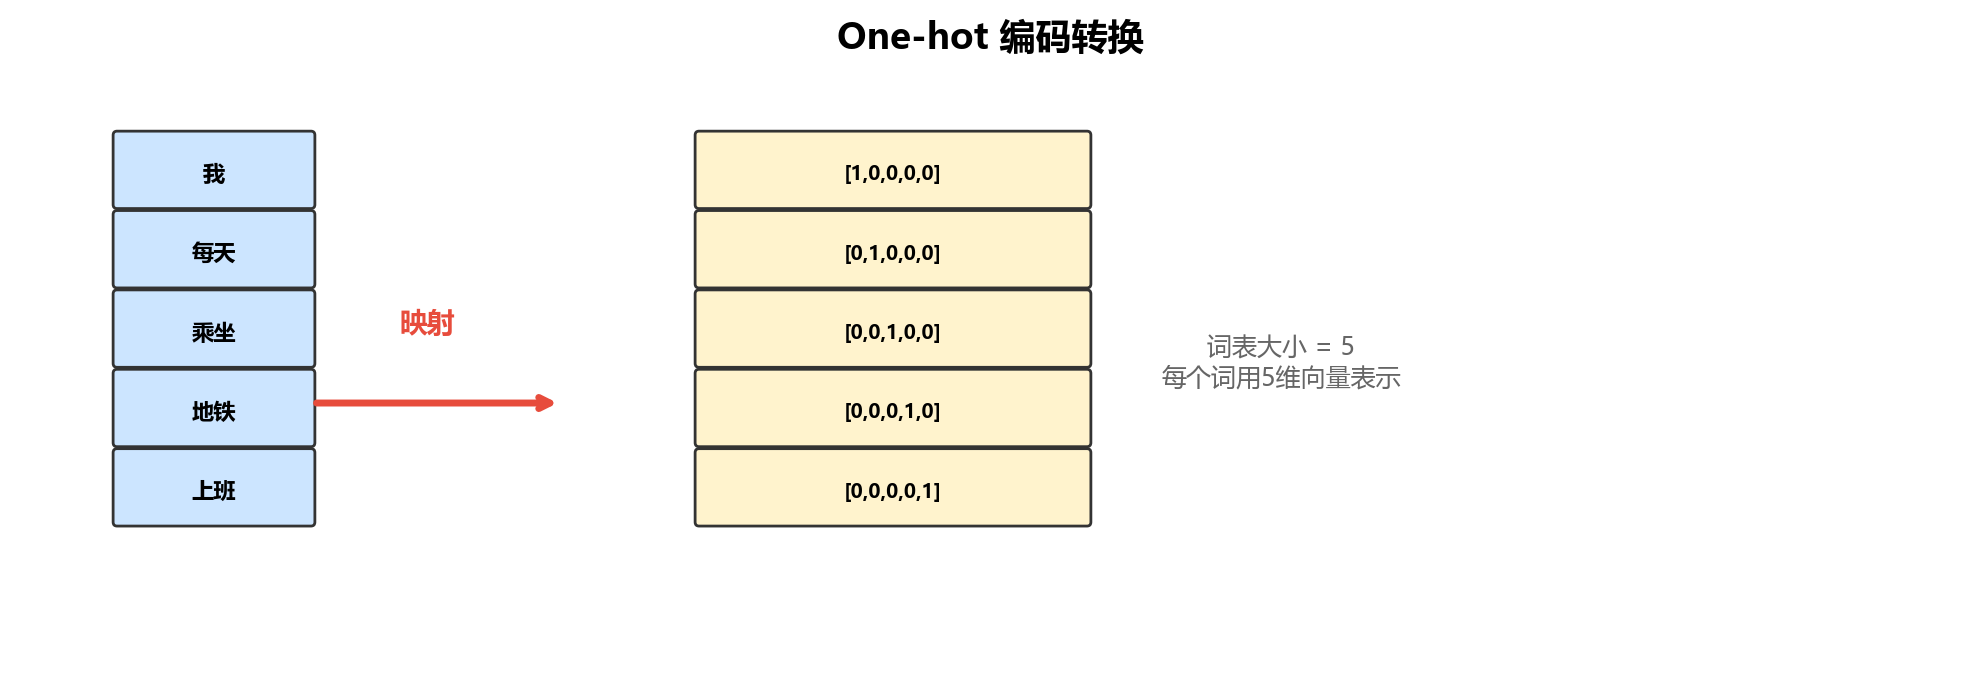
由于两种模型的输入和输出都是词语,首先需要对原始文本进行分词,将连续文本转换为 token 序列。同时,模型无法直接处理文本符号,仍需将词语转换为 one-hot 编码,作为模型的输入和输出进行计算。
Skip-Gram
训练样本
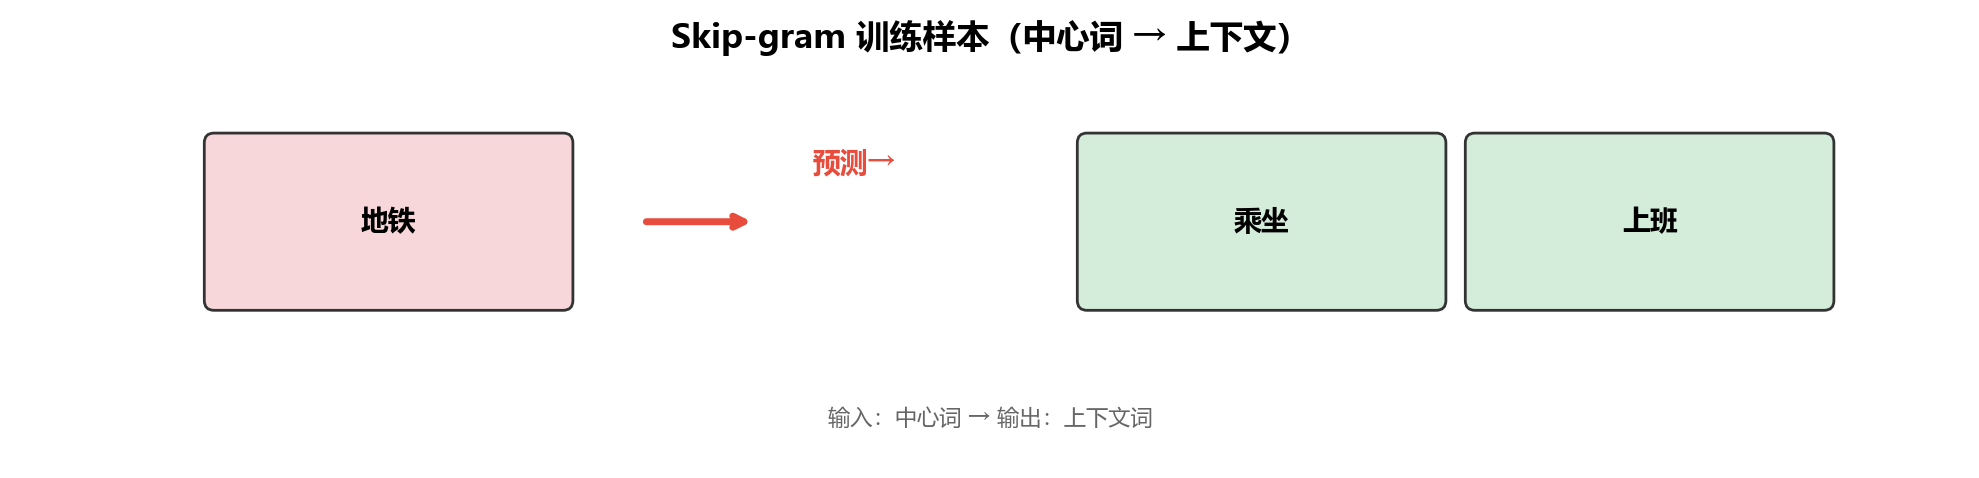
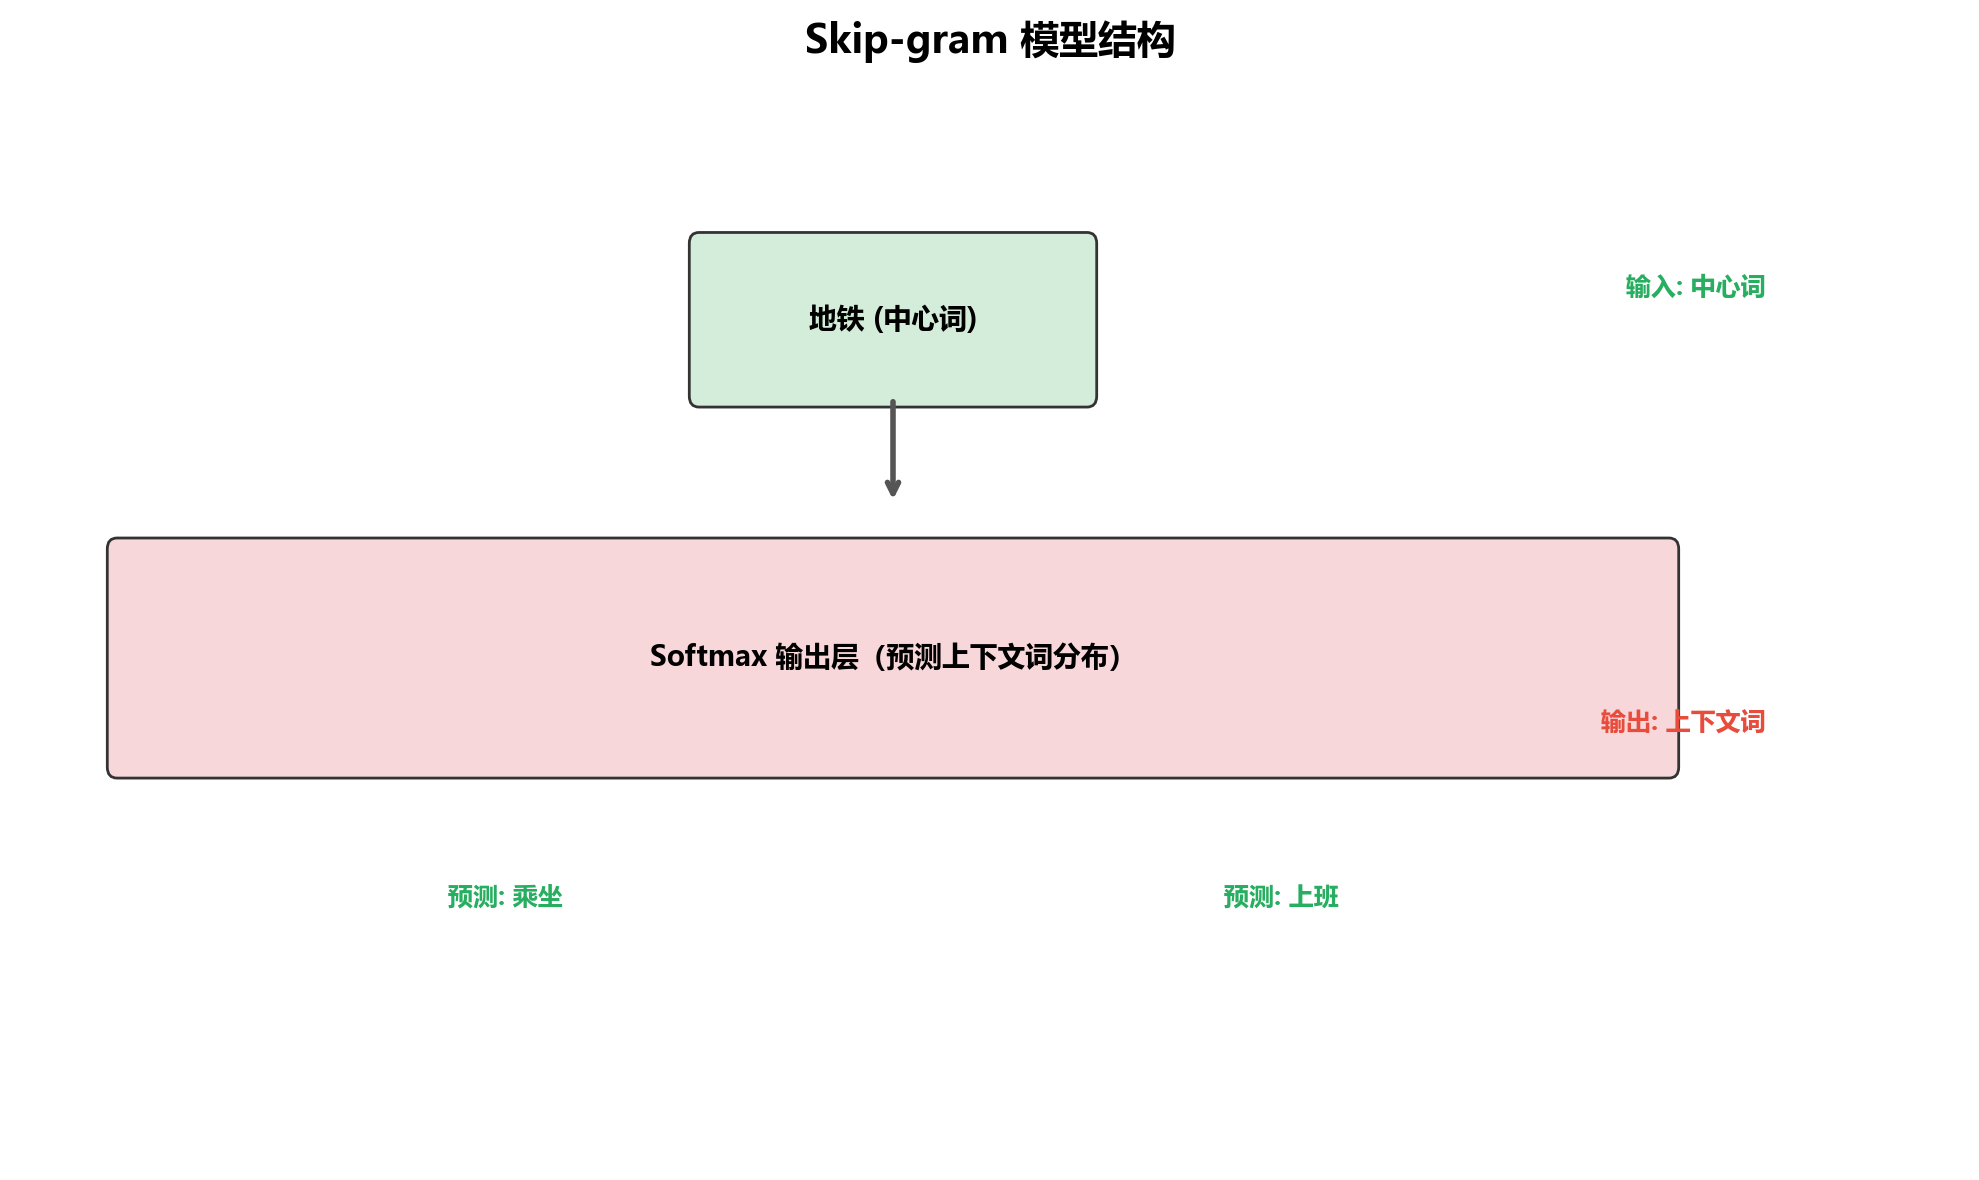
Skip-Gram 的目标是根据中心词预测上下文,其训练样本格式为:
模型结构
Skip-Gram 模型结构如下:
Skip-Gram 模型损失值的计算流程如下:
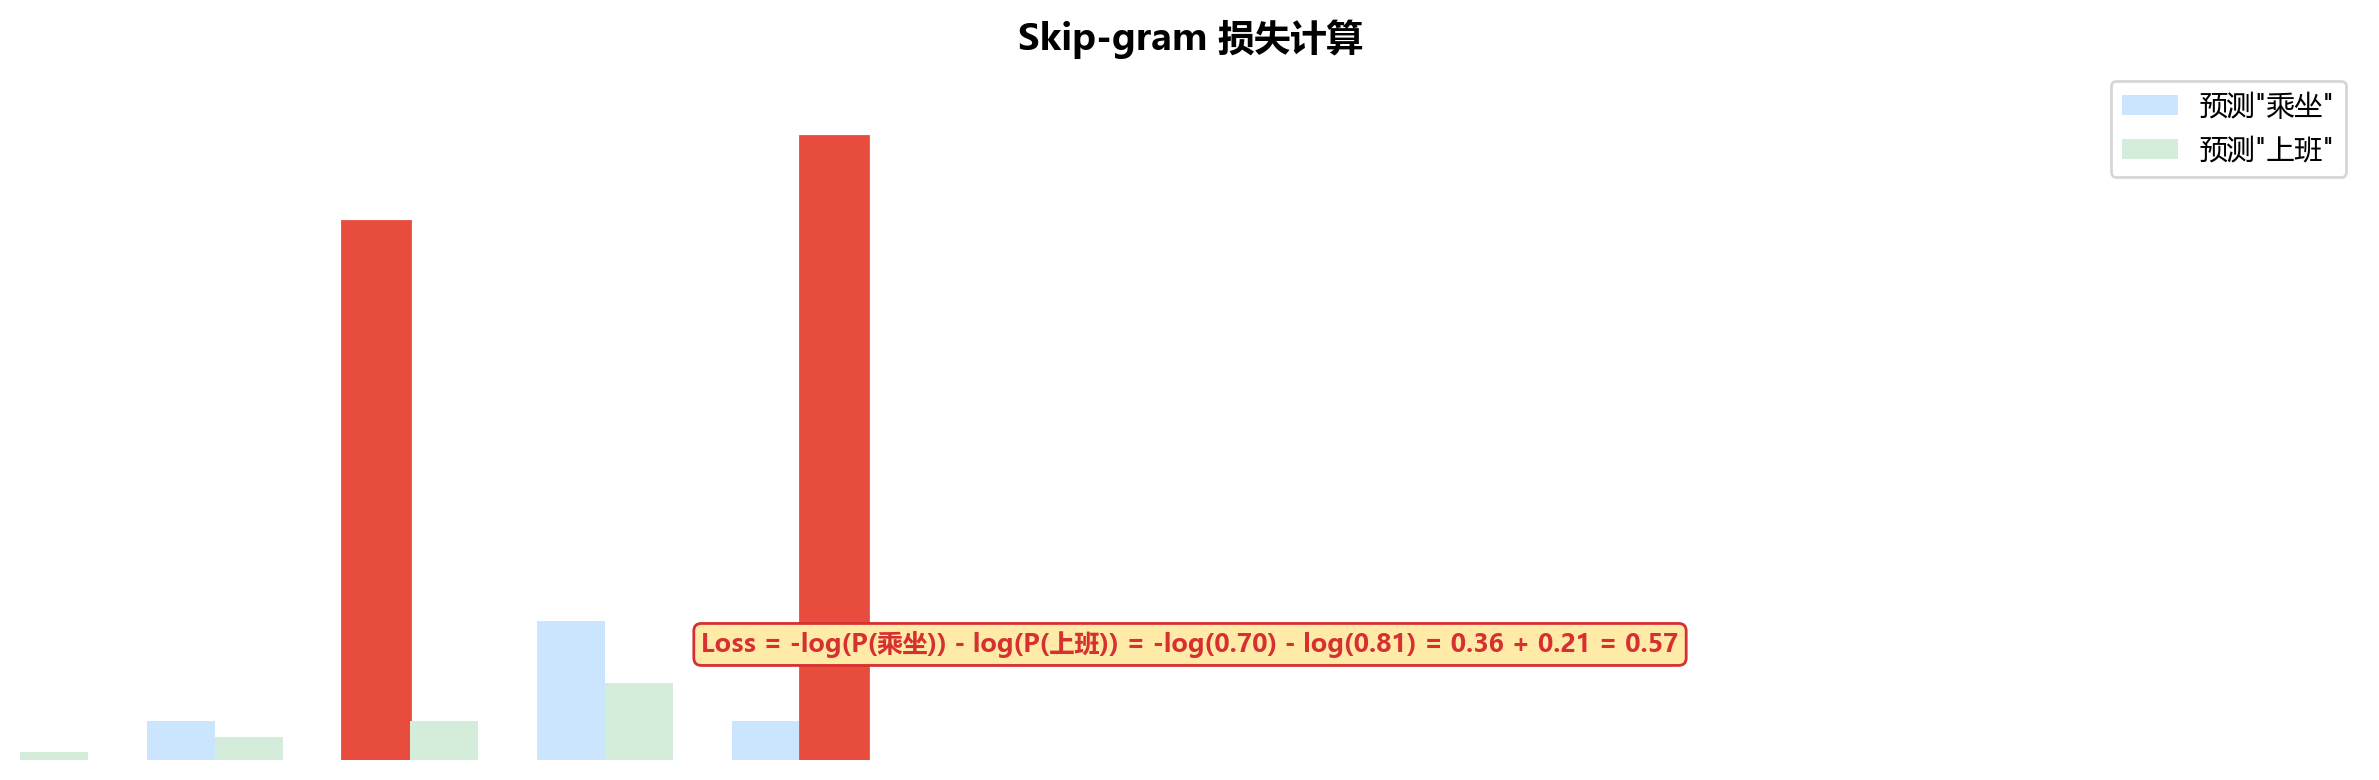
前向传播过程:
在反向传播过程中,参数矩阵 W 中"地铁"对应的词向量会被更新。模型通过不断训练,逐步优化向量,最终得到具有语义的词向量。
CBOW
训练样本
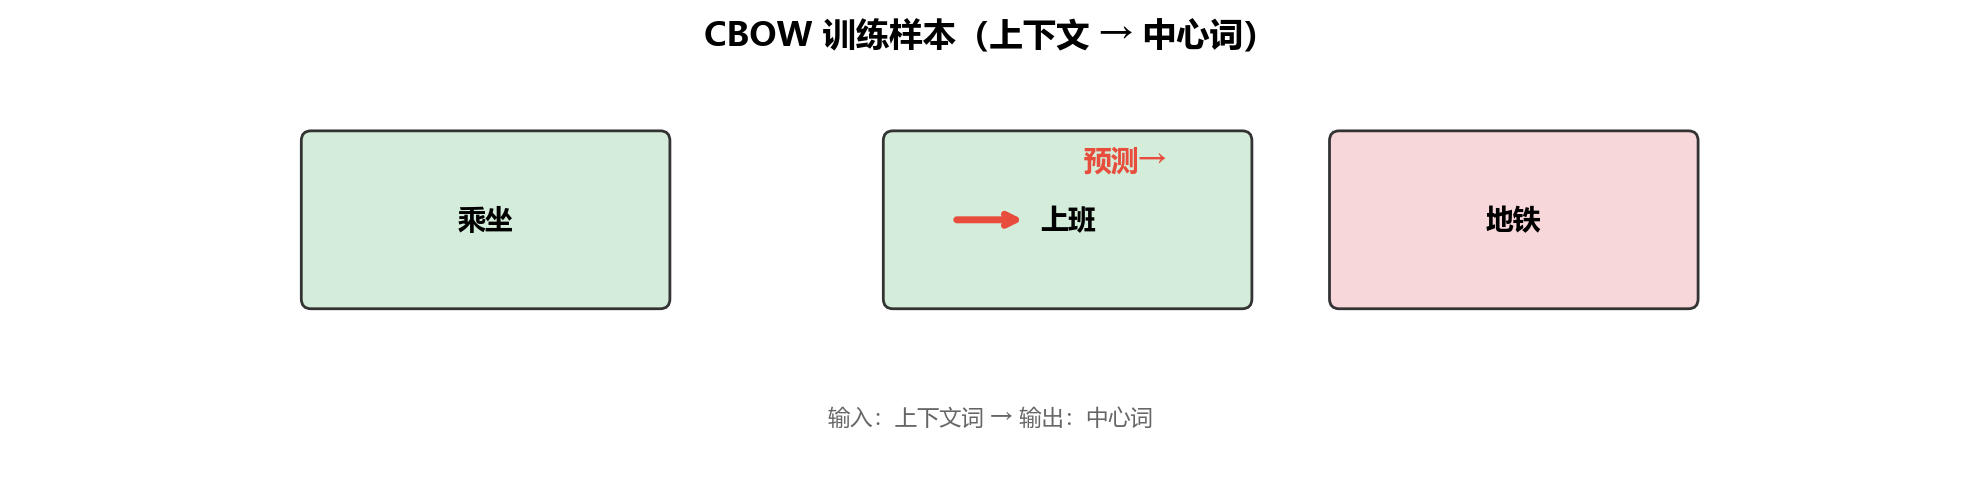
CBOW 的目标是根据上下文预测中心词,其训练样本格式为:
模型结构
CBOW 模型结构如下:
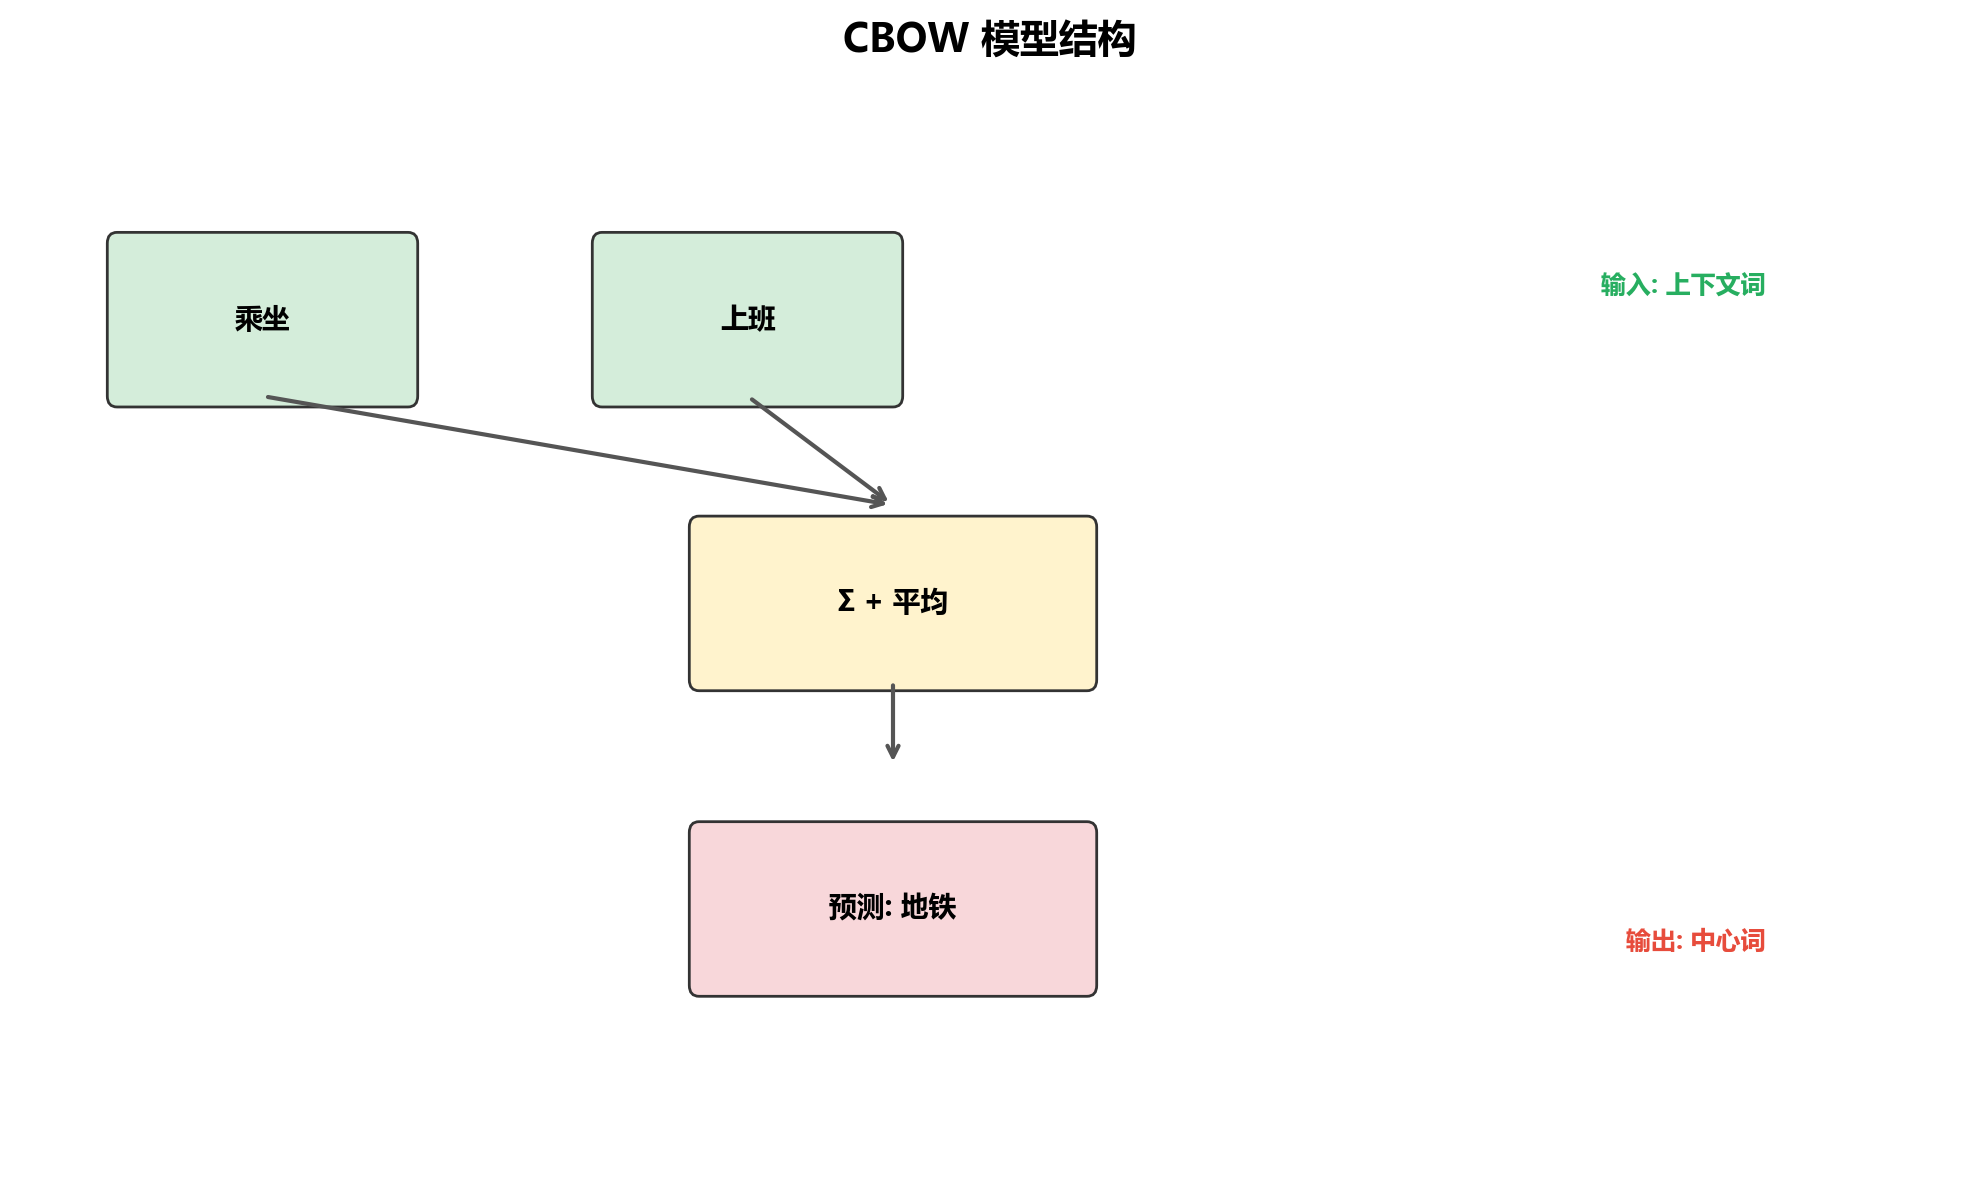
CBOW 模型损失值的计算流程如下:
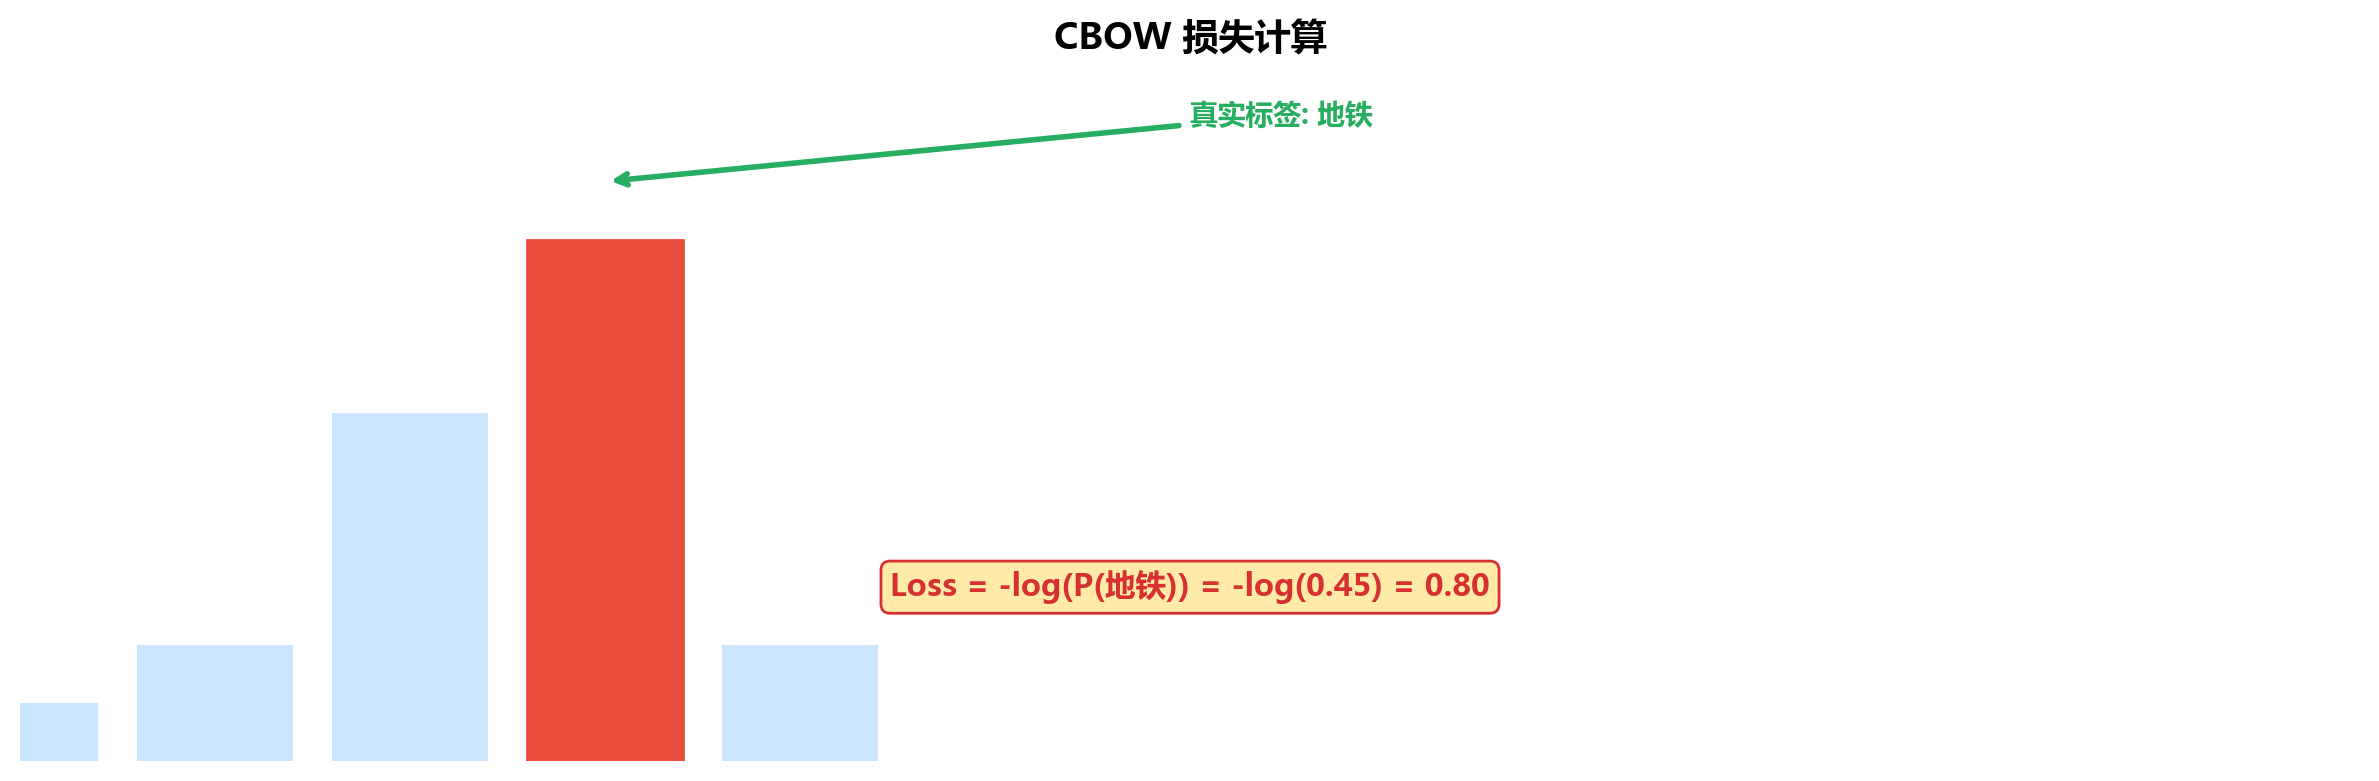
CBOW 前向传播过程:
在反向传播过程中,参数矩阵 W 中"乘坐"和"上班"对应的词向量会被更新。模型通过不断训练,逐步优化这些向量,最终得到具有语义的词向量。
3.3 获取 Word2Vec 词向量
词向量的获取通常有两种方式:直接使用公开词向量 或 在自有语料上自行训练。
使用公开词向量
国内一些大公司提供了训练好的中文词向量,可从以下仓库下载:
https://github.com/Embedding/Chinese-Word-Vectors
词向量文件的通用格式如下: <词汇总数> <向量维度> word1 val11 val12 … val1N word2 val21 val22 … val2N …
可使用 KeyedVectors.load_word2vec_format() 加载词向量文件:
from gensim.models import KeyedVectors
model_path = 'sgns.weibo.word.bz2'
model = KeyedVectors.load_word2vec_format(model_path)
自行训练词向量
1. 准备语料
Word2Vec 的训练语料需要是已分词的文本序列:
sentences = [
['我', '每天', '乘坐', '地铁', '上班'],
['我', '每天', '乘坐', '公交', '上班']
]
2. 训练模型
Gensim 提供了便捷的 Word2Vec 训练 API:
from gensim.models import Word2Vec
model = Word2Vec(
sentences, # 已分词的句子序列
vector_size=100, # 词向量维度
window=5, # 上下文窗口大小
min_count=2, # 最小词频(低于将被忽略)
sg=1, # 1: Skip-Gram, 0: CBOW
workers=4 # 并行训练线程数
)
3. 保存词向量
model.wv.save_word2vec_format('my_vectors.kv')
4. 加载词向量
from gensim.models import KeyedVectors
my_model = KeyedVectors.load_word2vec_format('my_vectors.kv')
3.4 应用 Word2Vec 词向量
训练好的词向量通常用于初始化下游 NLP 任务的嵌入层。
在现代深度学习 NLP 模型中,嵌入层本质上是一个查找表(lookup table):输入是词在词汇表中的索引,输出是该词对应的向量表示。
嵌入层的参数矩阵通常有两种初始化方式:
| 随机初始化 | 向量随机生成,通过反向传播逐步学习 |
| 预训练词向量初始化 | 加载 Word2Vec 等预训练向量作为初始参数,可注入丰富语言知识,尤其在低资源任务中优势明显 |
加载预训练词向量后,可选择是否让嵌入层继续参与训练(即 fine-tune 或 freeze)。