📝 摘要:MongoDB 慢查询告警耗时 2317ms,可 mongod.log 有 87G,grep 跑 5 分钟没结果。给出一套 SOP:tail 抓行尾 20 万行、按 $date 切片、scp 下载,再用约 200 行 Python 归一化查询形状聚类、按总耗时排序出 Top 30 报告。真凶是高频 find 排序字段走不了索引、退化为内存排序,按 ESR 原则建复合索引解决。
早上一条慢查询告警把你吵醒——耗时 2,317ms,filter 是 {account_id: "…"}、sort 是 {ut: -1} limit 20。你抹了把脸 ssh 上去打开 mongod.log 准备一查究竟——好家伙,87 个 G,vim 直接卡死,grep "Slow query" 跑了 5 分钟还没回来。
这时候你心里冒出三个问题:为什么不能直接 grep? 几千条慢查询日志怎么看? 告警那条慢成那样的根因到底在哪?
本文给你一套实战 SOP:行尾抓 20 万行 → 按日期切片下载 → Python 自动聚类按总耗时排序 → 一眼定位真凶。配套脚本 ~200 行,可以直接抄走。
这是 《MongoDB 主从切换排查实战:从 docker ps 到 jq,一套 SOP 定位死因》 第 8 步「从历史日志揪元凶」的深度展开。如果你刚收到 OOM / 主从切换告警,先按那篇前 7 步止血,再回来读本篇做根因深挖。
一、为什么不能直接 grep 几十 G 日志
来 ssh 上服务器先 ls -lh mongod.log 一眼——日志几十 G 起步是常态。这时候新手会本能地 grep "Slow query" mongod.log,然后等着挨教训:
| 慢 | 87G 全表扫一遍 grep 要好几分钟,光是磁盘吞吐就把线上业务影响一波 |
| 量太大 | grep 出来还是几千条 JSON,人肉看不完,看了也记不住 |
| 看错重点 | 即便挑出"最慢的那条",可能只是个偶发抖动——真正吃掉时间的不是最慢的单条,是某一类高频但每条都不快的查询 |
正确姿势是分三步:先抓样、再切片、最后聚类分析。
📌 mongod 6.x 日志格式提示:6.0 起默认是 structured JSON 日志,每行一条 JSON,慢查询条目的 msg 字段是 "Slow query",关键信息都在 attr 里(durationMillis、ns、command、planSummary、queryHash…)。这就是为什么自己写 Python 解 JSON 比传统的 mtools / mloginfo 更靠谱(mtools 设计于 3.x 纯文本日志时代,对 6.x 兼容性看版本)。
二、抓日志三步走
1. tail 抓行尾 20 万行
# 注意:路径以你 mongod 配置的 systemLog.path 为准
tail -n 200000 /var/log/mongod/mongod.log > /tmp/mongod-tail.log
为什么是 20 万行?这是一个经验值,理由:
- 慢查询条目(msg=Slow query)只占总日志的一小部分——大量是连接 accept/end、心跳、副本集状态等噪音
- 20 万行足以覆盖近几小时到一天的慢查询(具体取决于业务量)
- 文件大小可控,后续 grep / scp 都跑得动
- 不够就再 tail 一次(-n 500000),够了就开干
⚠️ 不要用 cat | tail——cat 会把整个几十 G 文件读一遍再丢给 tail,等于白干。tail -n 直接从文件尾倒着读,几秒就出。
2. 按日期切片到目标时间窗口
mongod 6.0 日志里日期字段长这样:"t":{"$date":"2026-05-27T06:07:43.335+08:00"}。所以别直接 grep '2026-05-27'——日期串可能出现在 lsid uuid 等无关字段里,会扫到一堆假阳性。要锚定到 $date:
# 抓 2026-05-27 一整天
grep '"$date":"2026-05-27' /tmp/mongod-tail.log > /tmp/mongod-20260527.log
# 或者抓某个时间段(早上 9-11 点)
grep -E '"\\$date":"2026-05-27T(09|10|11):' /tmp/mongod-tail.log > /tmp/mongod-9to11.log
3. scp 下载到本地
scp -i ~/.ssh/yourkey user@<跳板>:/tmp/mongod-20260527.log ~/Downloads/
下载到本地分析。不要直接在生产机上跑 Python 占 CPU——本地慢一点没关系,生产机敏感操作越少越好。
三、为什么按"总耗时聚类"而不是"单条最慢"
这是本文最想强调的方法论亮点。
很多人拿到日志后第一反应是"找最慢的那条"。这是错的。
举个真实例子,某次抓到的日志里:
- 最慢的单条:7.9 秒——一条 ad hoc 聚合,运营手动跑了一次,这辈子只跑一次
- 出现 1,100+ 次的某类 find:每条平均 ~490ms,看起来不离谱
- 但这类 find 累计吃掉了 9 分钟的数据库时间,是真正的"性能黑洞"
真正该优化的是"该类查询累计吃掉了多少时间",而不是"哪条单次最慢"。
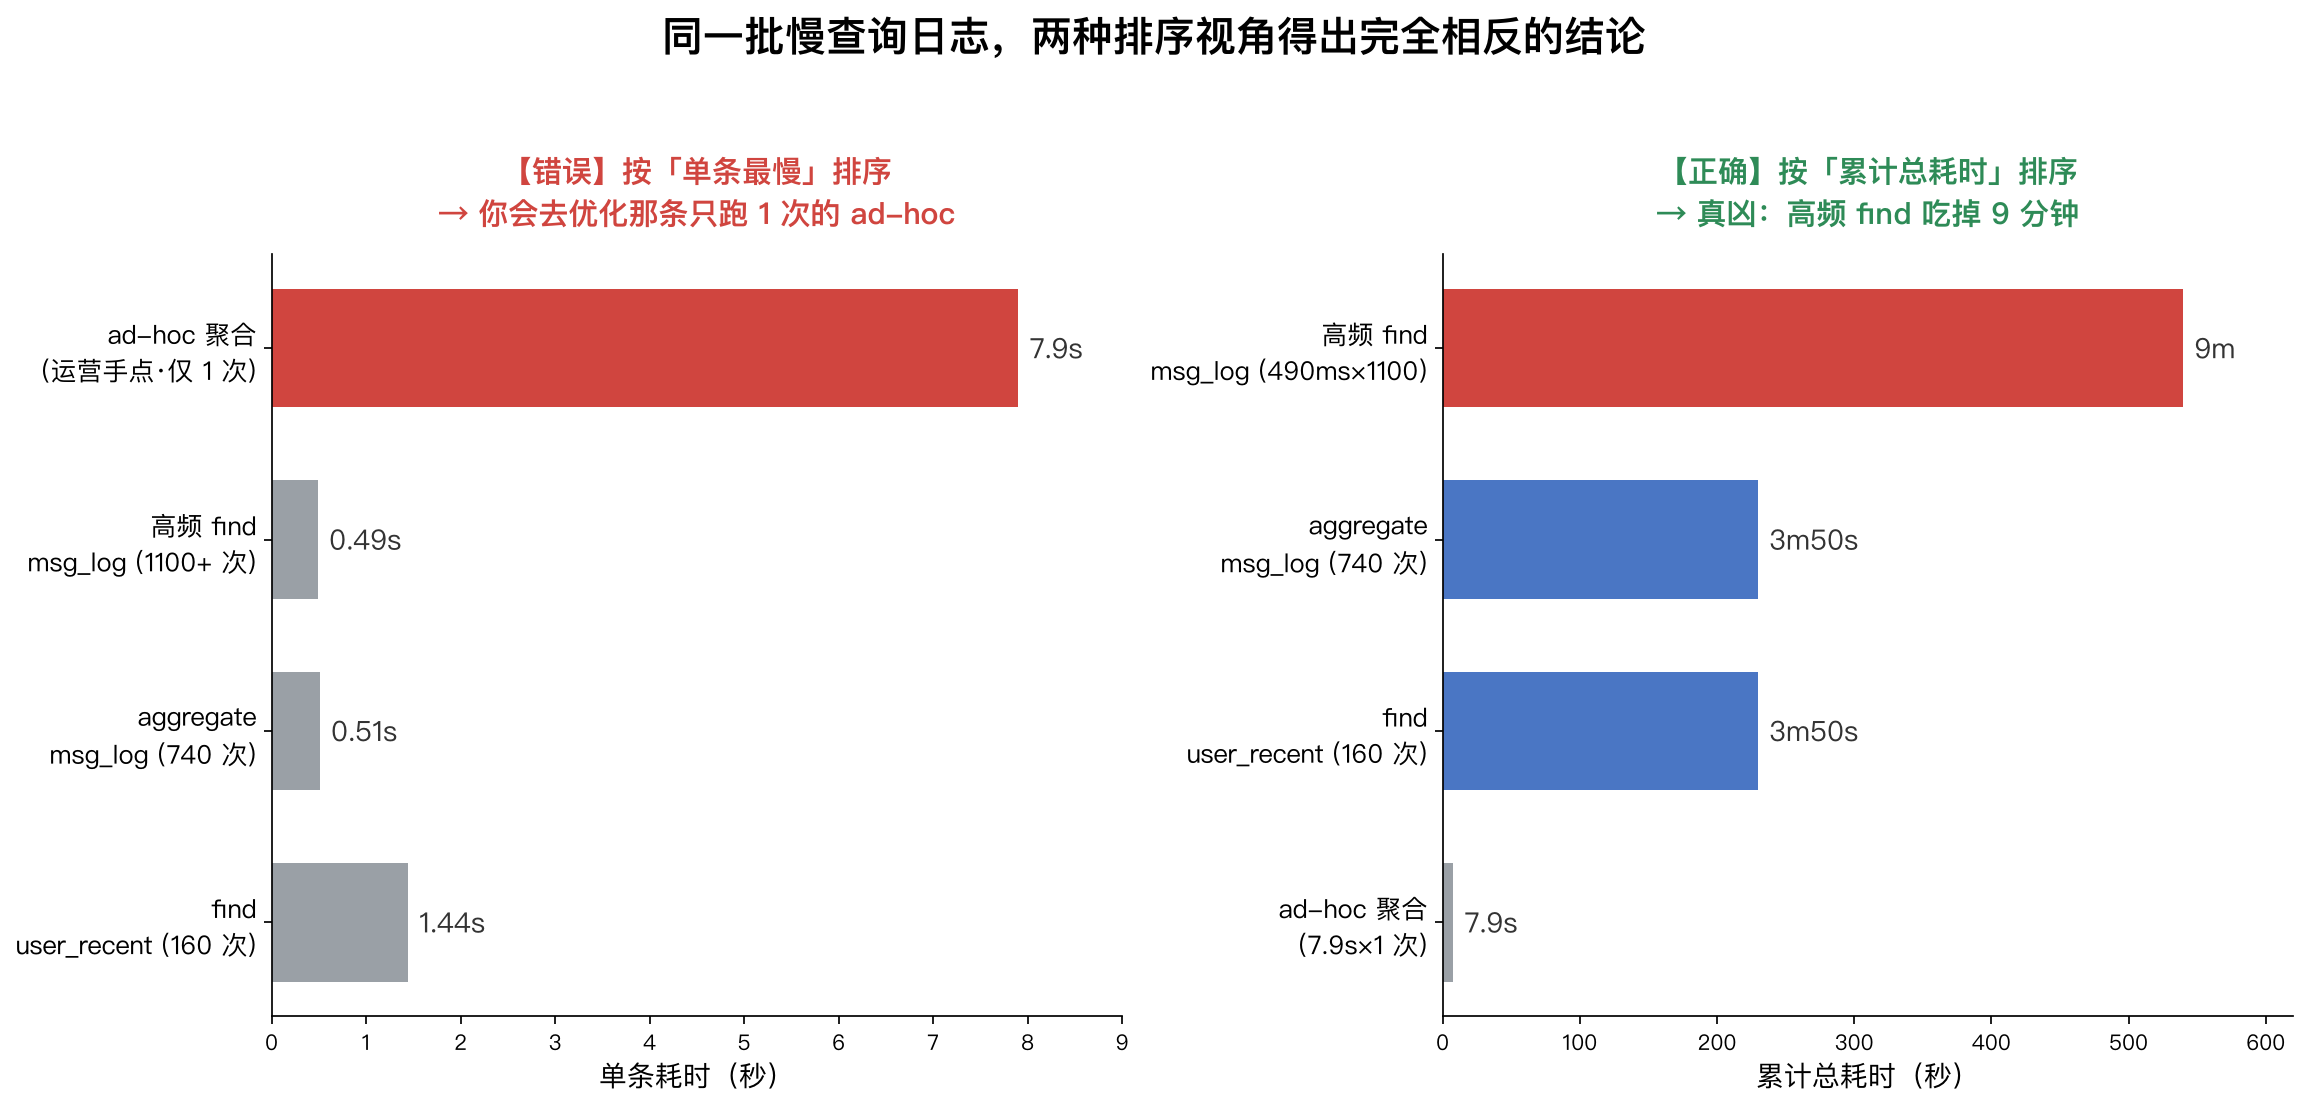
同一批慢查询日志,左边按"单条最慢"排——你会一头扎进那条只跑一次的 7.9s ad-hoc 聚合;右边按"累计总耗时"排——真凶(高频 find,490ms×1100 次≈9 分钟)才浮出水面。
要做累计耗时排序,先得能把"形状相同、值不同"的查询聚到一起。MongoDB 自带 queryHash 字段可以参考——但它对人不友好(就是个十六进制),而且 getMore、写命令没有 queryHash。所以我们自己定义一个**「归一化查询形状」**作为聚类键:
归一化规则:
聚类键 = ns(库.集合) + 操作类型(find / aggregate / getMore / …) + 归一化形状。
举例:
| {account_id: "1001234567890"} + sort: {ut: -1} + limit: 20 | find filter={account_id:?} sort={ut:?} |
| {account_id: "1009876543210"} + sort: {ut: -1} + limit: 50 | find filter={account_id:?} sort={ut:?} |
两条同归一类,累计耗时叠加。
四、Python 一脚本搞定
脚本 ~200 行,做的事:
完整脚本(自己用直接抄,记得改 DEFAULT_FILES):
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""MongoDB 慢查询分析(mongod 6.0+ 结构化 JSON 日志)"""
import json, os, sys, datetime
from collections import Counter, defaultdict
DEFAULT_FILES = ['/path/to/mongod-20260527.log']
META_KEYS = {
'$db', '$clusterTime', '$readPreference', '$audit', '$client',
'lsid', 'signature', 'apiVersion', 'apiStrict', 'apiDeprecationErrors',
'txnNumber', 'autocommit', 'startTransaction', 'readConcern',
'writeConcern', 'comment', 'mayBypassWriteBlocking', 'clientOperationKey',
}
def normalize(node):
"""递归归一化:保留 key/操作符,叶子值替换为 ?,数组只留第一个元素形状"""
if isinstance(node, dict):
parts = []
for k in sorted(node.keys()):
if k in META_KEYS:
continue
parts.append(f"{k}:{normalize(node[k])}")
return "{" + ",".join(parts) + "}"
if isinstance(node, list):
if not node:
return "[]"
return "[" + normalize(node[0]) + (",…" if len(node) > 1 else "") + "]"
return "?"
def extract(attr):
"""从 attr 提取 (op, ns, signature)"""
ns = attr.get('ns', '?')
cmd = attr.get('command', {})
typ = attr.get('type', '')
if typ in ('remove', 'update') and isinstance(cmd, dict) and 'q' in cmd:
op = 'delete' if typ == 'remove' else 'update'
sig = f"{op} q={normalize(cmd.get('q'))}"
if 'u' in cmd:
sig += f" u={normalize(cmd.get('u'))}"
return op, ns, sig
if not isinstance(cmd, dict) or not cmd:
return typ or '?', ns, typ or '?'
op = next(iter(cmd))
if op == 'find':
sig = f"find filter={normalize(cmd.get('filter', {}))} sort={normalize(cmd.get('sort', {}))}"
elif op == 'aggregate':
pipeline = cmd.get('pipeline', [])
stages = []
for st in pipeline if isinstance(pipeline, list) else []:
if isinstance(st, dict) and st:
sk = next(iter(st))
stages.append(f"{sk}={normalize(st[sk])}" if sk == '$match' else sk)
sig = "aggregate [" + " | ".join(stages) + "]"
elif op == 'getMore':
sig = f"getMore {cmd.get('collection', ns)}"
elif op == 'findAndModify':
sig = (f"findAndModify query={normalize(cmd.get('query', {}))} "
f"update={normalize(cmd.get('update', {}))} sort={normalize(cmd.get('sort', {}))}")
elif op in ('count', 'distinct'):
sig = f"{op} query={normalize(cmd.get('query', cmd.get('filter', {})))}"
elif op in ('delete', 'insert', 'update'):
sub = cmd.get(op)
if isinstance(sub, list) and sub:
sig = f"{op} {normalize(sub[0])}"
else:
sig = op
else:
sig = f"{op} {normalize({k: v for k, v in cmd.items() if k != op})}"
return op, ns, sig
def fmt_time(ms):
if ms < 1000:
return f"{ms:.0f}ms"
if ms < 60000:
return f"{ms / 1000:.2f}s"
m = int(ms // 60000)
return f"{m}m{(ms % 60000) / 1000:.1f}s"
def analyze(files):
groups = defaultdict(lambda: {
'count': 0, 'total_ms': 0, 'max_ms': 0, 'min_ms': float('inf'),
'docs_examined': 0, 'keys_examined': 0, 'nreturned': 0,
'plan': Counter(), 'query_hash': set(), 'sample': None, 'ns': '', 'op': '',
})
total = 0
for path in files:
if not os.path.exists(path):
print(f"警告: 文件不存在 – {path}")
continue
print(f"正在分析: {path}")
n_file = 0
with open(path, encoding='utf-8', errors='ignore') as f:
for line in f:
if '"msg":"Slow query"' not in line:
continue
try:
attr = json.loads(line).get('attr', {})
except Exception:
continue
op, ns, sig = extract(attr)
key = (ns, op, sig)
g = groups[key]
g['ns'], g['op'] = ns, op
ms = attr.get('durationMillis', 0)
g['count'] += 1
g['total_ms'] += ms
g['max_ms'] = max(g['max_ms'], ms)
g['min_ms'] = min(g['min_ms'], ms)
g['docs_examined'] += attr.get('docsExamined', 0)
g['keys_examined'] += attr.get('keysExamined', 0)
g['nreturned'] += attr.get('nreturned', 0)
ps = attr.get('planSummary')
if isinstance(ps, str):
g['plan'][ps] += 1
if attr.get('queryHash'):
g['query_hash'].add(attr['queryHash'])
if g['sample'] is None:
g['sample'] = {'command': attr.get('command'), 'planSummary': ps}
n_file += 1
total += 1
print(f" – 发现 {n_file} 条慢查询")
return groups, total
def sort_groups(groups):
return sorted(groups.items(), key=lambda kv: (kv[1]['total_ms'], kv[1]['count']), reverse=True)
def md_report(groups, total, files, out_path, top_n=30):
ordered = sort_groups(groups)
coll_cnt = Counter()
op_cnt = Counter()
collscan = 0
for (ns, op, _), g in groups.items():
coll_cnt[ns] += g['count']
op_cnt[op] += g['count']
for ps, n in g['plan'].items():
if 'COLLSCAN' in ps:
collscan += n
with open(out_path, 'w', encoding='utf-8') as f:
f.write("# 🐢 MongoDB 慢查询分析报告\\n\\n")
f.write(f"**分析时间**: {datetime.datetime.now():%Y–%m–%d %H:%M:%S}\\n\\n")
f.write("**分析文件**: " + ", ".join(f"`{os.path.basename(p)}`" for p in files) + "\\n\\n")
f.write("—\\n\\n## 📊 总体统计\\n\\n")
f.write(f"- **慢查询总数**: {total:,}\\n")
f.write(f"- **查询类数**: {len(groups):,}\\n")
f.write(f"- **COLLSCAN(全集合扫描)条数**: {collscan:,}\\n\\n")
f.write("### 按集合 Top10\\n\\n| 集合 | 慢查询数 | 占比 |\\n|—|—:|—:|\\n")
for ns, n in coll_cnt.most_common(10):
f.write(f"| `{ns}` | {n:,} | {n / total * 100:.1f}% |\\n")
f.write("\\n### 按操作类型\\n\\n| 操作 | 慢查询数 | 占比 |\\n|—|—:|—:|\\n")
for op, n in op_cnt.most_common():
f.write(f"| {op} | {n:,} | {n / total * 100:.1f}% |\\n")
f.write(f"\\n—\\n\\n## 🏆 Top {min(top_n, len(groups))} 查询类(按总耗时排序)\\n\\n")
for i, ((ns, op, sig), g) in enumerate(ordered[:top_n], 1):
c = g['count']
avg = g['total_ms'] / c
eff = g['nreturned'] / max(g['docs_examined'], 1) * 100
plan_top = g['plan'].most_common(1)[0][0] if g['plan'] else 'N/A'
f.write(f"### {i}. {ns} · {op} — {c} 次 ({c / total * 100:.1f}%)\\n\\n")
f.write("| 指标 | 数值 |\\n|—|—|\\n")
f.write(f"| 总耗时 | {fmt_time(g['total_ms'])} |\\n")
f.write(f"| 平均 / 最大 / 最小耗时 | {fmt_time(avg)} / {fmt_time(g['max_ms'])} / {fmt_time(g['min_ms'])} |\\n")
f.write(f"| 平均扫描行数 docsExamined | {g['docs_examined'] / c:.0f} |\\n")
f.write(f"| 平均返回行数 nreturned | {g['nreturned'] / c:.0f} |\\n")
f.write(f"| 扫描效率 (返回/扫描) | {eff:.1f}% |\\n")
f.write(f"| 执行计划 | {plan_top} |\\n")
f.write(f"| queryHash | {', '.join(sorted(g['query_hash'])) or '-'} |\\n\\n")
f.write("**查询形状**:\\n\\n```\\n" + sig + "\\n```\\n\\n")
if g['sample'] and g['sample'].get('command') is not None:
f.write("**真实示例**:\\n\\n```json\\n")
f.write(json.dumps(g['sample']['command'], ensure_ascii=False, indent=2)[:1500])
f.write("\\n```\\n\\n")
f.write("—\\n\\n")
print(f"✅ Markdown 报告已生成: {out_path}")
def main():
files = sys.argv[1:] if len(sys.argv) > 1 else DEFAULT_FILES
files = [p for p in files if os.path.exists(p)]
if not files:
print("错误: 没有可分析的日志文件")
return
groups, total = analyze(files)
if not total:
print("未发现 Slow query 条目")
return
base = os.path.splitext(os.path.basename(files[0]))[0]
out_dir = os.path.dirname(os.path.abspath(__file__))
md_report(groups, total, files, os.path.join(out_dir, f"mongo_slow_report_{base}.md"))
if __name__ == "__main__":
main()
运行:
python3 mongo_slow_analysis.py ~/Downloads/mongod-20260527.log
输出报告里有什么:
五、真实案例:5 分钟定位"IXSCAN 但仍慢"的真凶
某天抓到 ~3,300 条慢查询(阈值 100ms),分析报告的关键观察:
| COLLSCAN 条数 | 0 |
| IXSCAN 条数 | ~3,150 |
| p50 / p90 / p99 耗时 | ~200ms / ~800ms / ~3.2s |
| 慢查询最集中的集合 | app.msg_log,占 ~68% |
没有 COLLSCAN 不代表万事大吉——索引建了,只是没建对。报告 Top 3:
| 1 | app.msg_log · find | 1,100+ | 9m+ | 790 → 20 | 2.5% | {account_id:1} | 按 ut 排序走不了索引 → 内存排序 |
| 2 | app.user_recent · find | ~160 | 3m50s | 28,000 → 60 | 0.2% | {expire_at:-1} | name 非锚定正则,扫全范围 |
| 3 | app.msg_log · aggregate | ~740 | 3m50s | 510 → 1 | 0.2% | {account_id:1} | $match 含 round 范围 + $nin,无复合索引 |
1. Top 1 的执行细节
查询形状:find filter={account_id:?} sort={ut:?}
平均扫 ~790 个文档,返回 20 个
执行计划 IXSCAN { account_id: 1 }(走了索引,但只走了等值字段)
sort {ut: -1} 是在内存里做的(SORT_KEY_GENERATOR + SORT 阶段)
这条就是早上那条 2,317ms 告警的同款形状——区别只是 account_id 的具体值。
为什么慢:单字段索引 {account_id: 1} 只把等值过滤下推到了索引,sort 字段 ut 不在索引里,必须把候选文档全部拉回内存再排序。文档越多,内存排序越慢。
2. 根因 + 优化方案
建复合索引,等值字段在前、排序字段在后(MongoDB 索引设计的 ESR 原则:Equality → Sort → Range):
db.msg_log.createIndex(
{ account_id: 1, ut: –1 },
{ background: true, name: "account_id_1_ut_-1" }
)
建完后,这类 find 的执行计划应该变成纯 IXSCAN { account_id: 1, ut: -1 } + LIMIT,不再有 SORT 阶段——索引天然有序,直接读前 20 个就行。
预期效果:扫 ~790 → 扫 ~20,平均耗时从 ~490ms 掉到几十 ms 级别。
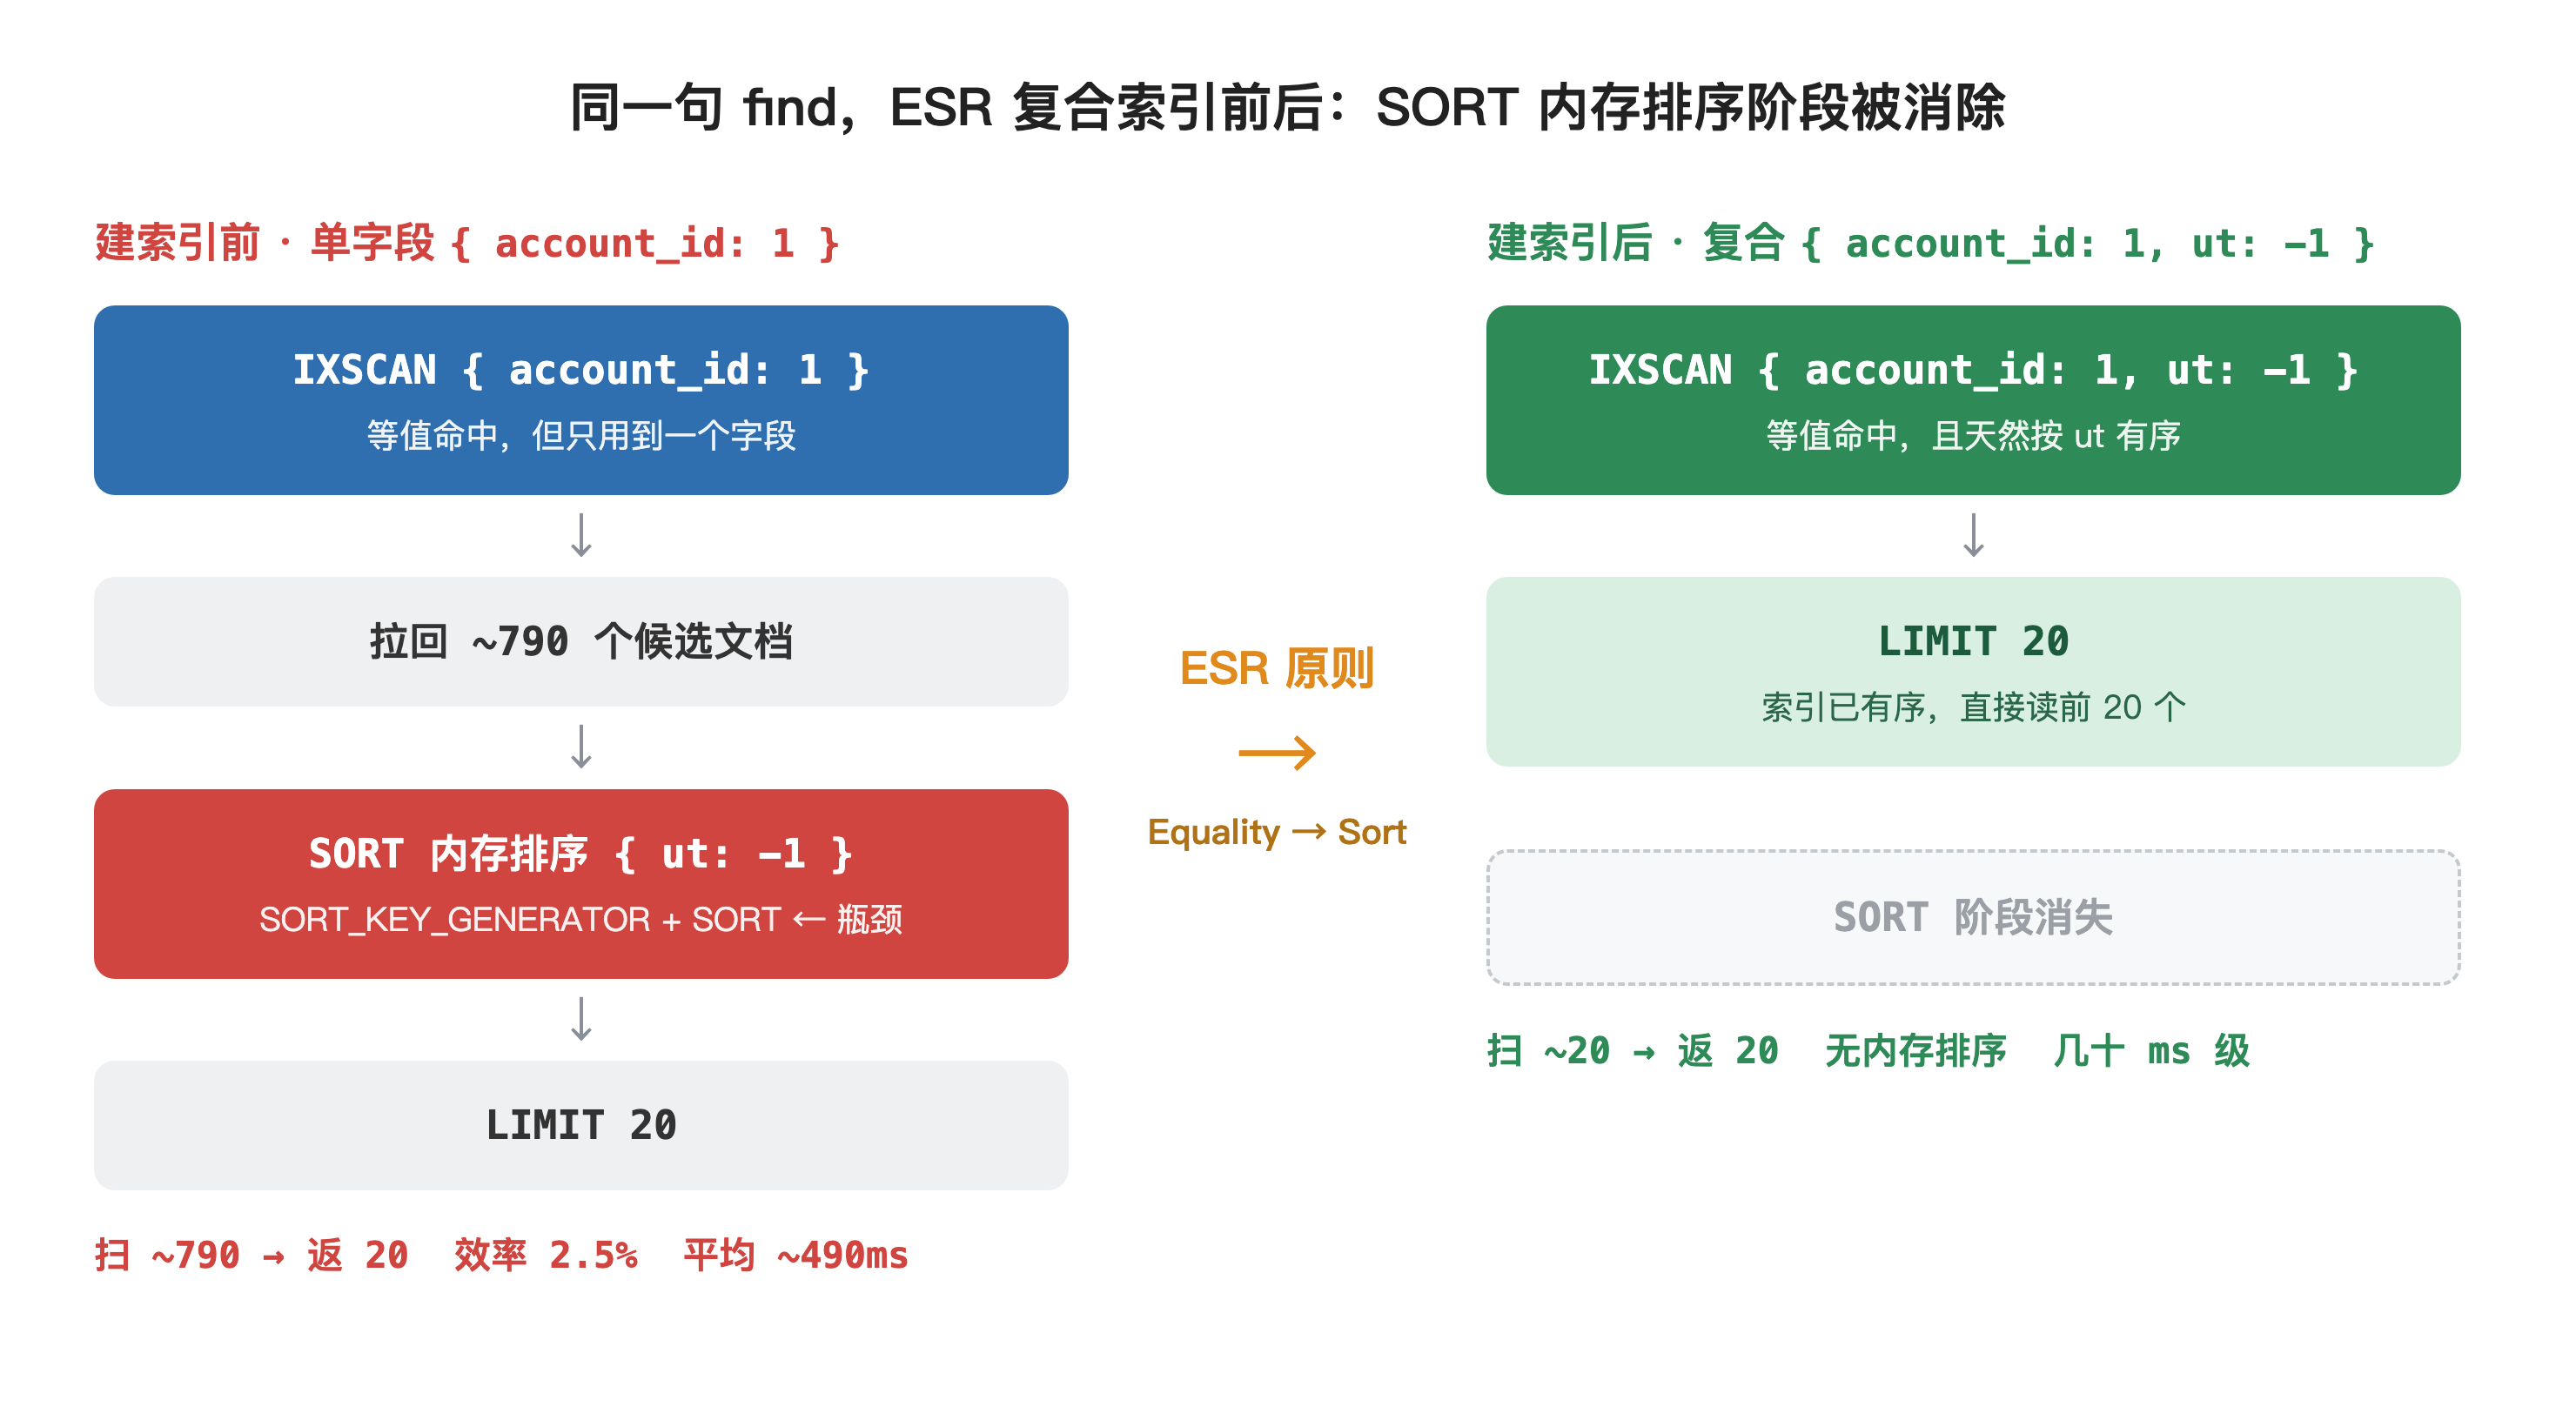
同一句 find,左边单字段索引只把等值下推,ut 排序退化成内存 SORT(扫 790 返 20、效率 2.5%);按 ESR 建成 {account_id:1, ut:-1} 复合索引后,SORT 阶段直接消失,扫 ~20 返 20。
3. Top 2 的正则病根
db.user_recent.find({
name: /关键词/, // ❌ 非锚定正则
expire_at: { $gt: someDate }
})
非锚定正则永远走不了索引前缀扫描——索引是按字符串前缀有序的,/关键词/ 可能匹配任何位置出现"关键词"的值,索引帮不上忙。结果就是扫了 ~28,000 行只返回 ~60 行,效率 0.2%。
如果业务确实是"昵称包含搜索",老老实实接全文索引(MongoDB Atlas Search / Elasticsearch),别在 KV 索引上硬撞。如果业务能改成"前缀搜索",改成锚定正则 /^关键词/,就能走索引前缀扫描了。
六、踩坑记录
1. db.currentOp() 只看当下,不是排查工具
它返回的是正在跑的 op,慢查询往往已经跑完写日志了,等你 db.currentOp() 早没影了。慢查询排查只看日志。
2. 别开 profilerLevel=2 全量记录
profilerLevel=2 会把所有 op 都写进 system.profile,线上 IO 直接翻倍。正确做法:
- 全局慢日志阈值用 slowOpThresholdMs(默认 100ms,够用了)
- 只在临时排查时短时间开 profilerLevel=1(只记超阈值的),用完立刻关
3. mtools / mloginfo 对 mongo 6.x 的 JSON 日志不一定友好
mtools 是 mongo 3.x 时代的工具,4.4 起日志默认就切了 JSON,6.0 起强制 JSON。mtools 部分子命令对新格式的解析(具体表现以版本为准)可能漏字段。自己 ~200 行 Python 解 JSON 反而最稳——本文脚本就是这么来的。
4. IXSCAN ≠ 不慢——看效率比
planSummary: IXSCAN 只能说明"走了索引",不能说明"走得好"。判断方式:
效率 = nreturned / docsExamined
– 100% 或接近:索引完全覆盖
– 10-50%:索引选择性一般,可以接受
– < 10%:索引基本没起到过滤作用,sort 或后续过滤被推到内存做了
本文 Top 1 案例的 2.5% 效率 = 典型的"索引建对了等值字段,但漏了排序字段"。
5. 时间过滤要锚定 "$date" 字段名
裸 grep '2026-05-27' 会扫到 lsid uuid、$clusterTime 里的日期串,假阳性一堆;务必把日期限定到 "$date" 字段(命令见 §二.2)。
6. 别用 cat | tail 读大文件
cat mongod.log | tail 会把几十 G 全文先读一遍再丢给 tail,磁盘白转几分钟;tail -n 直接从文件尾倒着读,几秒就出(命令见 §二.1)。
七、SOP 一图流
抓样 → 切片 → 下载 → 聚类分析 → 按总耗时读 Top N,最后按 planSummary + 效率比分流到对应的优化动作:
#mermaid-svg-SeArnZSdvb5Y3Ikf{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-SeArnZSdvb5Y3Ikf .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-SeArnZSdvb5Y3Ikf .error-icon{fill:#552222;}#mermaid-svg-SeArnZSdvb5Y3Ikf .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-SeArnZSdvb5Y3Ikf .marker{fill:#333333;stroke:#333333;}#mermaid-svg-SeArnZSdvb5Y3Ikf .marker.cross{stroke:#333333;}#mermaid-svg-SeArnZSdvb5Y3Ikf svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-SeArnZSdvb5Y3Ikf p{margin:0;}#mermaid-svg-SeArnZSdvb5Y3Ikf .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-SeArnZSdvb5Y3Ikf .cluster-label text{fill:#333;}#mermaid-svg-SeArnZSdvb5Y3Ikf .cluster-label span{color:#333;}#mermaid-svg-SeArnZSdvb5Y3Ikf .cluster-label span p{background-color:transparent;}#mermaid-svg-SeArnZSdvb5Y3Ikf .label text,#mermaid-svg-SeArnZSdvb5Y3Ikf span{fill:#333;color:#333;}#mermaid-svg-SeArnZSdvb5Y3Ikf .node rect,#mermaid-svg-SeArnZSdvb5Y3Ikf .node circle,#mermaid-svg-SeArnZSdvb5Y3Ikf .node ellipse,#mermaid-svg-SeArnZSdvb5Y3Ikf .node polygon,#mermaid-svg-SeArnZSdvb5Y3Ikf .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-SeArnZSdvb5Y3Ikf .rough-node .label text,#mermaid-svg-SeArnZSdvb5Y3Ikf .node .label text,#mermaid-svg-SeArnZSdvb5Y3Ikf .image-shape .label,#mermaid-svg-SeArnZSdvb5Y3Ikf .icon-shape .label{text-anchor:middle;}#mermaid-svg-SeArnZSdvb5Y3Ikf .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-SeArnZSdvb5Y3Ikf .rough-node .label,#mermaid-svg-SeArnZSdvb5Y3Ikf .node .label,#mermaid-svg-SeArnZSdvb5Y3Ikf .image-shape .label,#mermaid-svg-SeArnZSdvb5Y3Ikf .icon-shape .label{text-align:center;}#mermaid-svg-SeArnZSdvb5Y3Ikf .node.clickable{cursor:pointer;}#mermaid-svg-SeArnZSdvb5Y3Ikf .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-SeArnZSdvb5Y3Ikf .arrowheadPath{fill:#333333;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-SeArnZSdvb5Y3Ikf .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-SeArnZSdvb5Y3Ikf .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-SeArnZSdvb5Y3Ikf .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-SeArnZSdvb5Y3Ikf .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-SeArnZSdvb5Y3Ikf .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-SeArnZSdvb5Y3Ikf .cluster text{fill:#333;}#mermaid-svg-SeArnZSdvb5Y3Ikf .cluster span{color:#333;}#mermaid-svg-SeArnZSdvb5Y3Ikf div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-SeArnZSdvb5Y3Ikf .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-SeArnZSdvb5Y3Ikf rect.text{fill:none;stroke-width:0;}#mermaid-svg-SeArnZSdvb5Y3Ikf .icon-shape,#mermaid-svg-SeArnZSdvb5Y3Ikf .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-SeArnZSdvb5Y3Ikf .icon-shape p,#mermaid-svg-SeArnZSdvb5Y3Ikf .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-SeArnZSdvb5Y3Ikf .icon-shape .label rect,#mermaid-svg-SeArnZSdvb5Y3Ikf .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-SeArnZSdvb5Y3Ikf .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-SeArnZSdvb5Y3Ikf .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-SeArnZSdvb5Y3Ikf :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
COLLSCAN
IXSCAN 且效率 < 10%
docsExamined 巨大
getMore 占比高
① ssh 上服务器
② tail -n 200000 mongod.log抓行尾 20 万行
③ grep 锚定 $date 字段按日期切片到目标时间窗
④ scp 下载到本地
⑤ python3 mongo_slow_analysis.py归一化聚类 + 按总耗时排序
⑥ 读报告 Top N看 planSummary + 效率比
缺索引 → 直接建
sort/range 没走索引→ 按 ESR 建复合索引
正则非锚定 / filter 选择性差→ 改正则或换字段
单次结果集太大→ 业务侧加 limit / 分页
MongoDB 慢查询排查 SOP:从 ssh 抓样到按总耗时聚类,再按执行计划与效率比分流优化。
📌 发 CSDN 时若 mermaid 不渲染,把这段流程图导出成 PNG 再上传(本地 Typora / mermaid.live 都能导)。
八、结语
MongoDB 慢查询排查的核心思路其实就两条:
最后,索引设计的 ESR 原则(Equality → Sort → Range)是 MongoDB 性能优化里最值得记住的一条经验。本文案例的 Top 1 就是教科书级的"等值字段有索引、排序字段没下推"——{ account_id: 1, ut: -1 } 一行 createIndex 解决战斗。
延伸阅读
- 上游 SOP:MongoDB 主从切换排查实战:从 docker ps 到 jq,一套 SOP 定位死因 —— 收到 OOM/主从切换告警先看这篇,本篇是它第 8 步的深度展开
- 背景案例:一次 MongoDB OOM 引发主从切换事故复盘:那口"锅"究竟该谁背? —— 慢查询失控的最坏结果就是 OOM
- MySQL 篇姊妹文:字符集不一致引发的血案:一条 SQL 扫描 11 亿行,CPU 直接拉满 —— "走了索引但仍慢"在 MySQL 侧的等价问题
🏷️ 标签:MongoDB 慢查询 线上排障 索引优化 日志分析 SOP