程序通常需要同时处理多个数据。例如,保存一个班级的学生姓名、记录一件商品的信息,或者统计文章中出现过哪些单词。
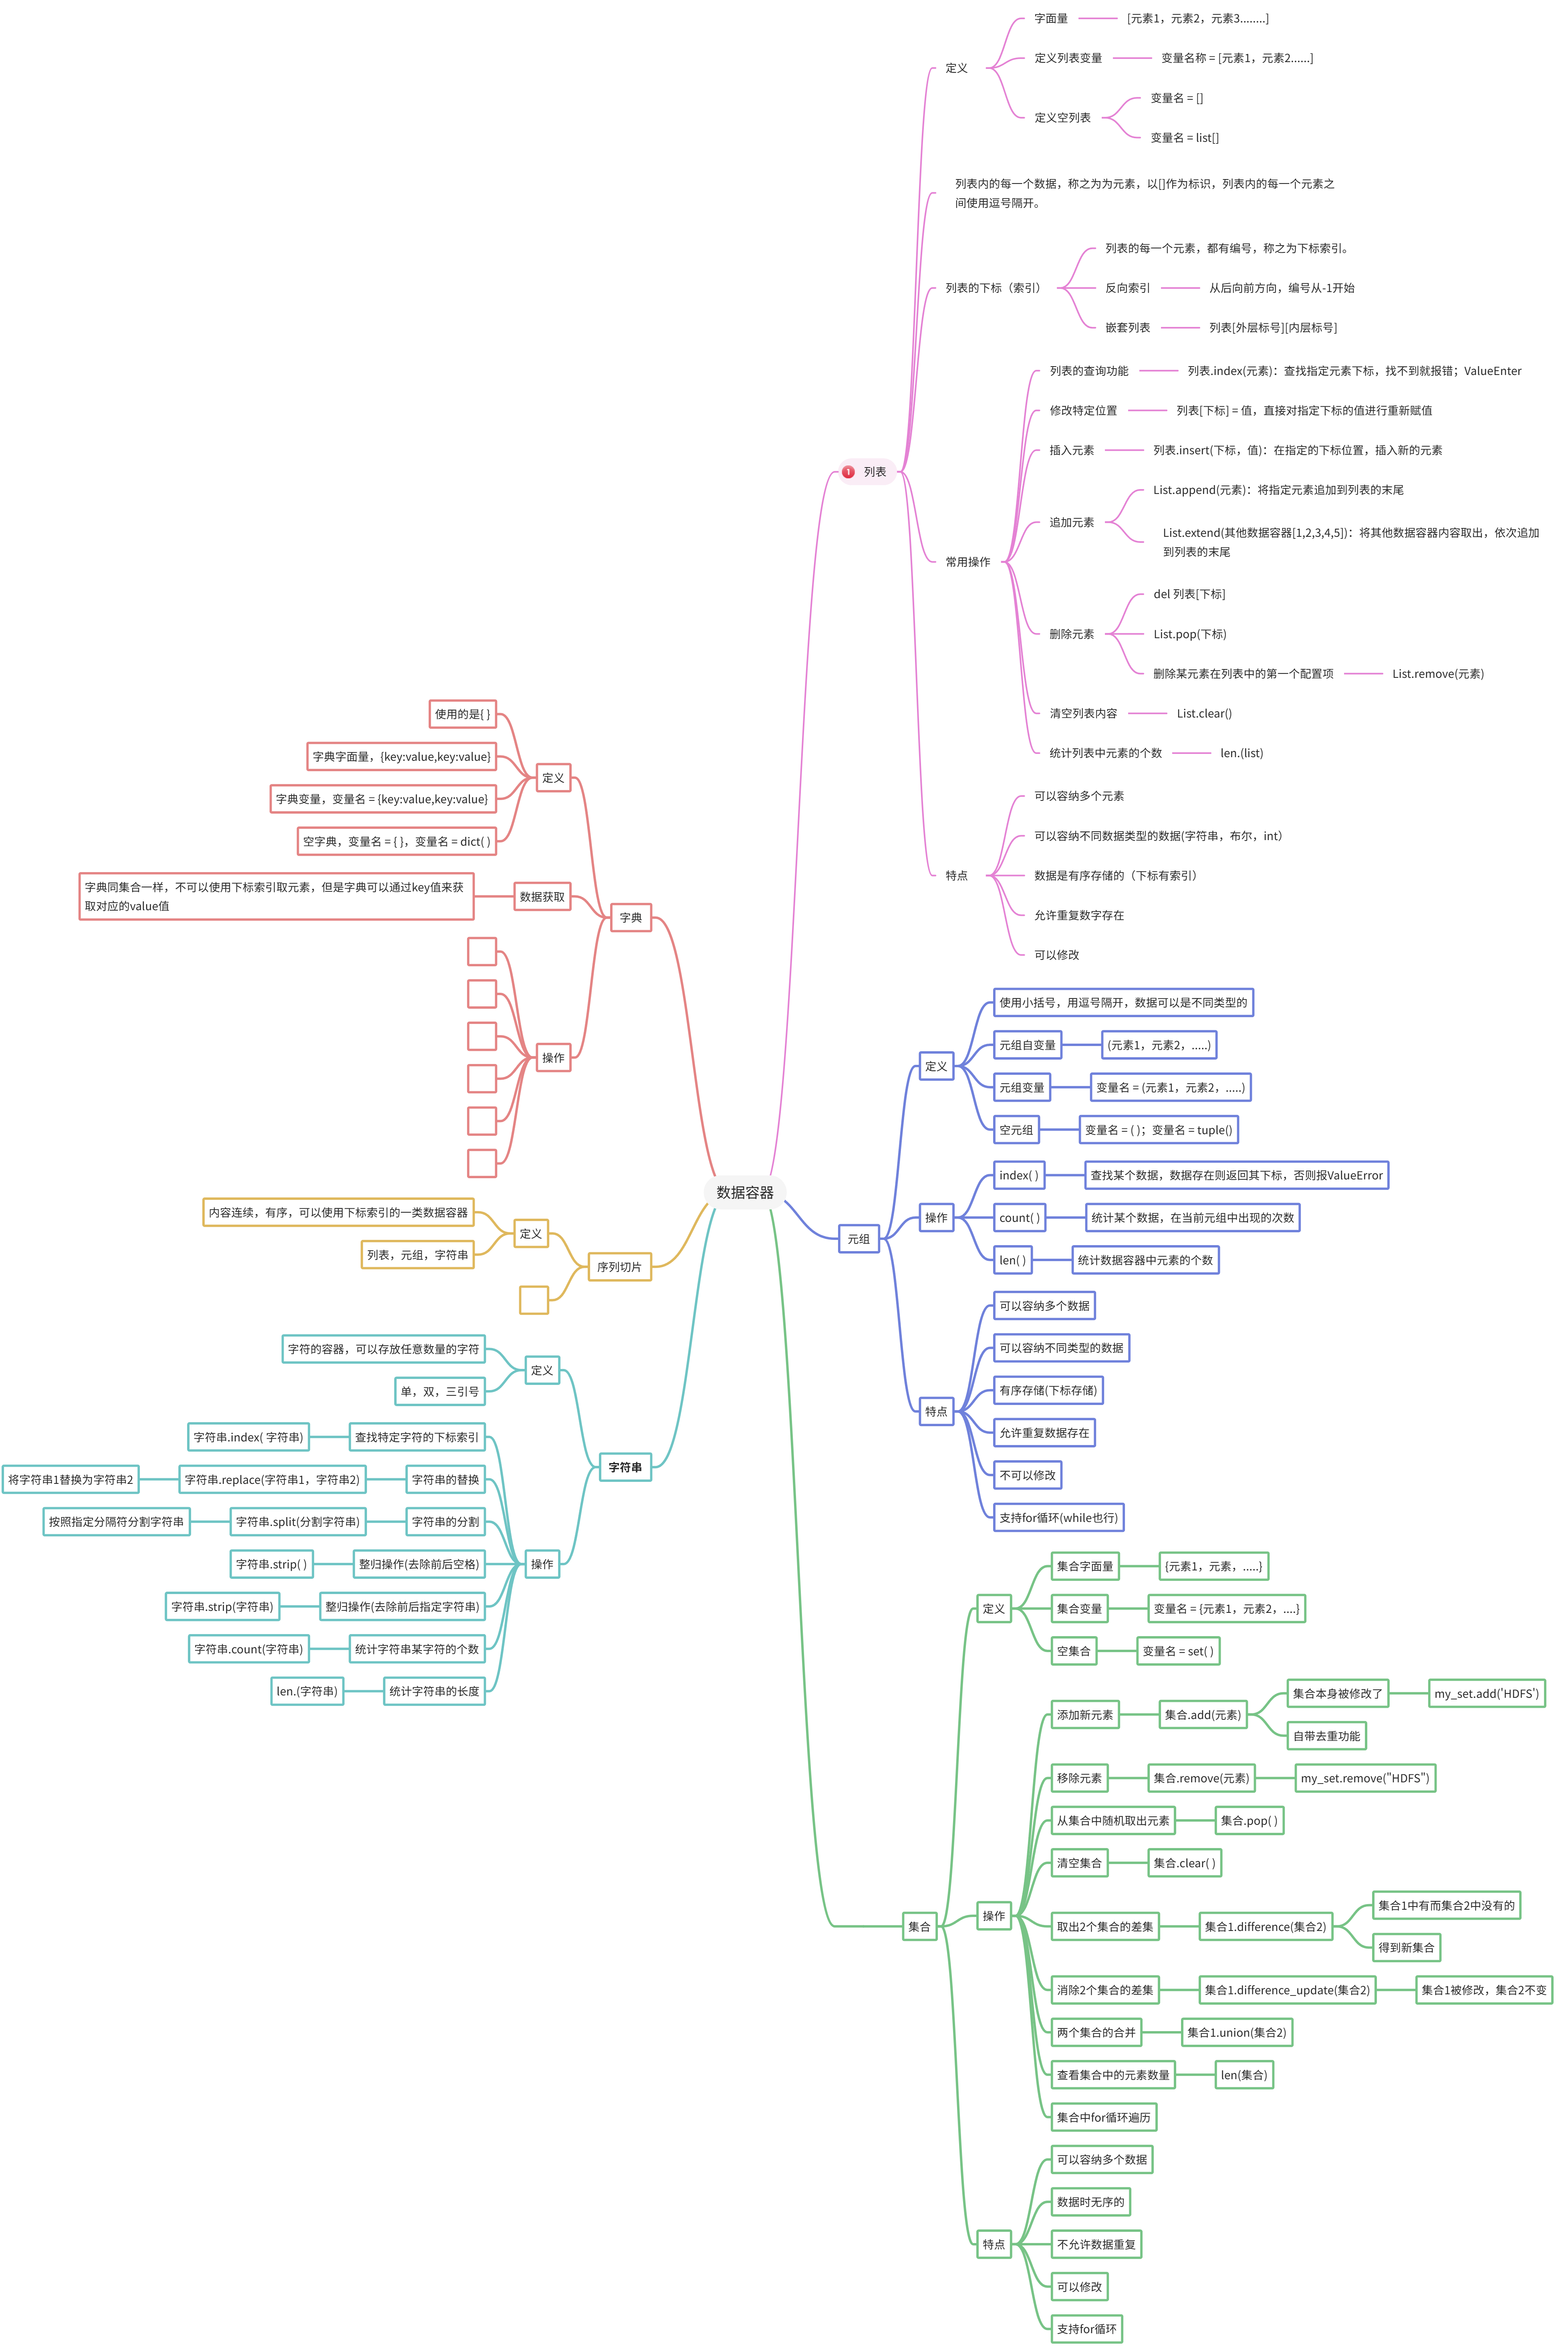
如果为每个数据分别创建变量,代码会变得非常混乱。Python 提供了多种“数据容器”,可以把多个数据组织在一起。常用的数据容器包括列表、元组、字符串、集合和字典。
一、认识数据容器
数据容器就是可以存放多个数据的数据类型。例如:
students = ["小明", "小红", "小刚"]
变量 students 中同时保存了三个学生姓名。
Python 常用容器的特点如下:
| 列表 | [] | 是 | 可以 | 可以 |
| 元组 | () | 是 | 可以 | 不可以 |
| 字符串 | 引号 | 是 | 可以 | 不可以 |
| 集合 | {} | 不依赖下标顺序 | 不可以 | 可以 |
| 字典 | {键: 值} | 按键存取 | 键不能重复 | 可以 |
不同容器适合不同的场景。学习时不必一次记住所有方法,先理解它们之间的区别,再通过练习熟悉常用操作。
二、列表的定义
列表可以保存多个数据,并且列表中的数据可以修改。
定义列表时使用中括号,元素之间使用英文逗号分隔:
names = ["小明", "小红", "小刚"]
numbers = [10, 20, 30]
列表可以保存不同类型的数据:
data = ["Python", 100, 3.14, True]
不过,实际开发中通常会让一个列表保存含义相近的数据,以便阅读和处理。
定义空列表有两种方式:
list1 = []
list2 = list()
列表中的每一个数据都叫作元素。
三、使用下标访问列表
列表中的每个元素都有自己的编号,这个编号叫作下标或索引。
Python 的下标从 0 开始:
names = ["小明", "小红", "小刚"]
print(names[0])
print(names[1])
print(names[2])
运行结果:
小明
小红
小刚
如果访问了不存在的下标,程序会出现 IndexError:
print(names[5])
Python 还支持负数下标。-1 表示最后一个元素,-2 表示倒数第二个元素:
print(names[-1]) # 小刚
print(names[-2]) # 小红
列表中还可以继续保存列表,这叫作嵌套列表:
students = [
["小明", 18],
["小红", 17]
]
print(students[0]) # ["小明", 18]
print(students[0][0]) # 小明
print(students[1][1]) # 17
第一个下标选择外层元素,第二个下标继续选择内层元素。
四、列表的常用操作
1. 查找元素下标
index() 可以查找元素第一次出现的位置:
names = ["小明", "小红", "小刚"]
position = names.index("小红")
print(position) # 1
如果元素不存在,程序会出现 ValueError。因此,可以先使用 in 判断:
if "小李" in names:
print(names.index("小李"))
else:
print("没有找到小李")
2. 修改元素
列表可以根据下标修改数据:
names = ["小明", "小红", "小刚"]
names[1] = "小李"
print(names)
结果为:
['小明', '小李', '小刚']
3. 添加元素
使用 append() 在列表末尾添加一个元素:
names.append("小王")
使用 insert() 在指定位置插入元素:
names.insert(1, "小美")
使用 extend() 把另一个容器中的元素逐个添加到列表末尾:
names.extend(["小张", "小赵"])
要注意 append() 和 extend() 的区别:
numbers = [1, 2]
numbers.append([3, 4])
print(numbers) # [1, 2, [3, 4]]
append() 会把整个列表当作一个元素。
numbers = [1, 2]
numbers.extend([3, 4])
print(numbers) # [1, 2, 3, 4]
extend() 会把元素逐个加入原列表。
4. 删除元素
根据下标删除:
names = ["小明", "小红", "小刚"]
del names[1]
print(names)
pop() 可以删除并返回指定下标的元素:
deleted_name = names.pop(0)
print(deleted_name)
remove() 根据元素内容删除第一次出现的数据:
names.remove("小刚")
清空整个列表可以使用 clear():
names.clear()
5. 统计元素数量
len() 可以获取列表长度:
numbers = [10, 20, 30, 40]
print(len(numbers)) # 4
count() 可以统计某个元素出现的次数:
numbers = [10, 20, 10, 30, 10]
print(numbers.count(10)) # 3
五、遍历列表
使用 for 循环可以逐个处理列表中的元素:
names = ["小明", "小红", "小刚"]
for name in names:
print(name)
也可以配合条件判断进行统计:
scores = [88, 45, 92, 60, 55]
pass_count = 0
for score in scores:
if score >= 60:
pass_count += 1
print(f"一共有{pass_count}人成绩及格")
如果需要根据下标遍历,可以结合 range() 和 len():
for index in range(len(names)):
print(index, names[index])
六、元组
元组和列表很相似,也可以保存多个不同类型的数据。最大的区别是:元组定义后不能修改。
元组使用小括号定义:
info = ("小明", 18, "北京")
也可以省略小括号:
info = "小明", 18, "北京"
定义空元组:
data = ()
data = tuple()
定义只有一个元素的元组时,必须在元素后面添加逗号:
number = (10,)
如果没有逗号:
number = (10)
它只是整数 10,不是元组。
元组支持下标、index()、count() 和 len():
data = ("Python", "Java", "Python")
print(data[0])
print(data.index("Java"))
print(data.count("Python"))
print(len(data))
但不能直接修改元组元素:
data[0] = "C++" # 报错
元组适合保存不希望被意外修改的数据,例如坐标、日期或者固定配置。
七、字符串也是数据容器
字符串可以看作由多个字符组成的容器:
text = "Python"
print(text[0]) # P
print(text[-1]) # n
字符串和元组一样,内容不能直接修改:
text[0] = "J" # 报错
如果需要修改字符串,通常会创建一个新字符串。
常用字符串操作
查找字符串出现的位置:
text = "hello python"
print(text.index("python"))
替换内容:
new_text = text.replace("python", "world")
print(new_text)
replace() 不会修改原字符串,而是返回一个新字符串。
按照指定内容分割字符串:
data = "Python,Java,C++"
languages = data.split(",")
print(languages)
去除字符串两端的空格:
name = " 小明 "
print(name.strip())
去除两端指定字符:
text = "###Python###"
print(text.strip("#"))
统计内容出现的次数:
text = "banana"
print(text.count("a")) # 3
print(len(text)) # 6
八、序列切片
列表、元组和字符串都具有连续、有序、可以使用下标访问等特点,通常可以称为序列。
序列支持切片操作:
序列[开始下标:结束下标:步长]
切片遵循“左闭右开”原则,包含开始位置,但不包含结束位置。
例如:
numbers = [0, 1, 2, 3, 4, 5]
print(numbers[1:4]) # [1, 2, 3]
print(numbers[:3]) # [0, 1, 2]
print(numbers[3:]) # [3, 4, 5]
print(numbers[::2]) # [0, 2, 4]
切片也可以用于字符串和元组:
text = "Python"
print(text[0:3]) # Pyt
使用负数步长可以反转序列:
print(text[::-1]) # nohtyP
切片得到的通常是一个新的序列,不会直接修改原数据。
九、集合
集合使用大括号定义,主要特点是元素不能重复:
numbers = {1, 2, 3, 3, 2}
print(numbers)
重复数据会被自动去除。
定义空集合时不能使用 {},因为 {} 表示空字典。正确写法是:
data = set()
集合不支持下标访问:
numbers[0] # 报错
常用操作包括:
numbers = {1, 2, 3}
numbers.add(4) # 添加元素
numbers.remove(2) # 删除指定元素
value = numbers.pop() # 取出一个元素
numbers.clear() # 清空集合
集合还可以进行数学中的集合运算:
set1 = {1, 2, 3}
set2 = {3, 4, 5}
print(set1.difference(set2)) # set1有、set2没有
print(set1.union(set2)) # 合并两个集合
difference() 不会修改原集合,而 difference_update() 会直接修改调用它的集合。
集合特别适合数据去重:
names = ["小明", "小红", "小明", "小刚"]
unique_names = set(names)
print(unique_names)
十、字典
字典使用“键值对”保存数据。每个键对应一个值:
student = {
"name": "小明",
"age": 18,
"score": 95
}
字典中的数据不是通过数字下标获取,而是通过键获取:
print(student["name"])
print(student["score"])
字典的键不能重复。如果重复定义同一个键,后面的值会覆盖前面的值:
data = {
"name": "小明",
"name": "小红"
}
print(data["name"]) # 小红
定义空字典有两种方式:
data1 = {}
data2 = dict()
字典的常用操作
新增或修改数据:
student["city"] = "北京"
student["score"] = 98
删除数据:
del student["age"]
安全获取数据:
print(student.get("name"))
print(student.get("phone", "暂无手机号"))
如果使用 student["phone"] 获取不存在的键,程序会出现 KeyError;使用 get() 时可以提供默认值。
获取所有键、值和键值对:
print(student.keys())
print(student.values())
print(student.items())
遍历字典:
for key, value in student.items():
print(f"{key}:{value}")
清空字典和统计键值对数量:
print(len(student))
student.clear()
字典适合保存具有明确属性的数据,例如学生信息、商品信息和用户资料。
十一、如何选择数据容器
面对不同需求时,可以按照下面的方式选择:
- 数据需要保持顺序,并且可能修改:使用列表;
- 数据需要保持顺序,但不允许修改:使用元组;
- 需要保存文本:使用字符串;
- 需要去除重复数据,或者进行集合运算:使用集合;
- 需要通过名称查找对应的数据:使用字典。
例如,一个班级的学生姓名可以使用列表:
students = ["小明", "小红", "小刚"]
一个学生的详细信息可以使用字典:
student = {
"name": "小明",
"age": 18,
"scores": [90, 88, 95]
}
不同容器还可以互相嵌套,从而表示更加复杂的数据结构。
十二、总结
数据容器是 Python 中非常重要的基础知识。列表有序、可重复并且可以修改;元组有序但不能修改;字符串用于保存文本;集合中的元素不能重复;字典通过键值对保存数据。