从零到一:系统化掌握数据分析全流程与实战技巧
摘要:本文从实战角度出发,系统化梳理了数据分析的完整流程——从明确问题、数据采集、清洗处理、探索分析、建模预测到可视化报告产出。文章结合电商用户行为分析等真实业务场景,提供了可直接复用的Python/SQL代码模板、可视化最佳实践与常见避坑指南。无论你是刚入门的数据分析新人,还是希望补齐方法论的中级从业者,都能从中获得一套可落地的全链路分析框架,真正实现从数据到洞察的能力跃迁。
📌 模块一:数据分析基础认知
1.1 数据分析的目标与价值
数据分析的本质是用数据回答业务问题。在开始学习之前,我们需要厘清一个核心认知:数据分析不是"为了分析而分析",而是业务驱动下的决策辅助工具。
| 出发点 | 业务问题先行,数据服务于决策 | 从数据中发现规律,反哺业务方向 |
| 典型场景 | “为什么本月用户留存下降了?” | “用户行为数据中是否存在未被发现的细分群体?” |
| 适用阶段 | 问题明确,需要验证假设 | 探索未知,寻找增长机会 |
💡 提示:在实际工作中,两种模式往往交替使用。初级分析师更多面对的是业务驱动型需求,而高级分析师需要具备数据驱动的主动洞察能力。
1.2 必备技能图谱
数据分析是一个跨学科领域,需要统计学、编程工具和业务理解的三重支撑。以下是一份完整的技能图谱:
数据分析技能图谱
├── 统计学基础
│ ├── 描述统计(均值、中位数、方差、分位数)
│ ├── 推断统计(假设检验、置信区间、p值)
│ └── 概率分布(正态分布、二项分布、泊松分布)
├── 工具技能
│ ├── Excel(数据透视表、VLOOKUP、条件格式)
│ ├── SQL(查询、聚合、窗口函数、多表关联)
│ ├── Python(Pandas、NumPy、Matplotlib、Seaborn)
│ └── 可视化工具(Tableau / Power BI / FineBI)
├── 分析方法
│ ├── 描述性分析(发生了什么)
│ ├── 诊断性分析(为什么发生)
│ ├── 预测性分析(将会发生什么)
│ └── 规范性分析(应该怎么做)
└── 业务理解
├── 行业知识(电商/金融/互联网/制造业)
├── 指标体系(北极星指标、AARRR模型)
└── 沟通表达(报告撰写、数据讲故事)
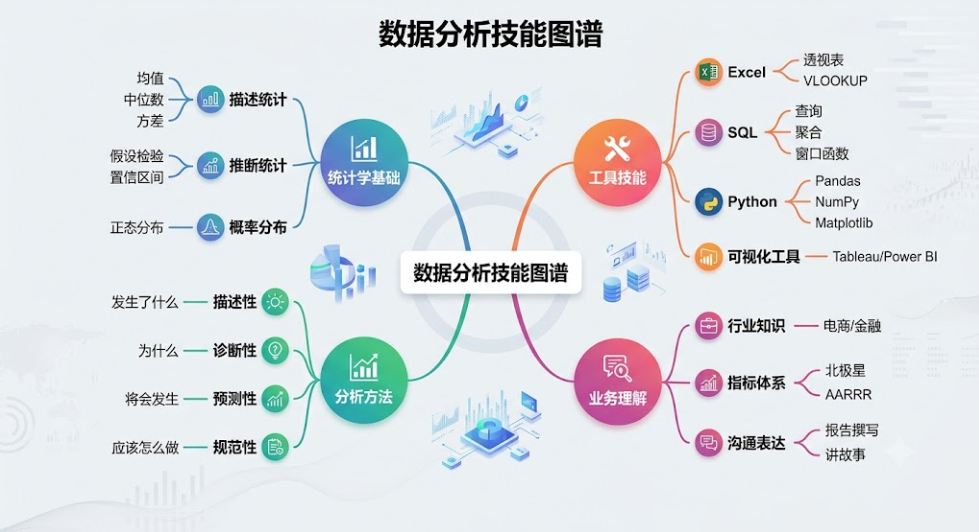
图1:数据分析核心技能图谱
1.3 学习路径建议
很多初学者容易陷入"工具焦虑"——学了一堆工具却不会做实际分析。建议按以下路径循序渐进:
第一阶段:入门期(1-3个月)
- 掌握Excel数据透视表与常用函数
- 学习SQL基础查询(SELECT/WHERE/GROUP BY/JOIN)
- 理解描述统计核心概念
- 能独立完成简单的数据汇总与报表制作
第二阶段:进阶期(3-6个月)
- 系统学习Python数据分析三剑客(Pandas/NumPy/Matplotlib)
- 掌握SQL高级技巧(窗口函数、子查询、性能优化)
- 学习假设检验、A/B测试等推断统计方法
- 开始接触业务指标体系与分析框架
第三阶段:提升期(6-12个月)
- 学习机器学习基础(线性回归、逻辑回归、聚类)
- 掌握至少一款BI工具(Tableau/Power BI)
- 积累行业分析经验,形成自己的分析方法论
- 提升数据叙事与报告撰写能力
⚠️ 注意:不要试图一次性学完所有工具。工具是手段,分析思维才是核心。建议在实战项目中边用边学,效率最高。
🚀 进阶拓展:如果你已经掌握了基础工具,可以尝试学习特征工程和实验设计,这是从中级迈向高级的关键能力。
📌 模块二:数据分析流程解析
数据分析不是随意地"看数据",而是有一套标准化的工作流程。掌握这套流程,能让你面对任何分析需求都有条不紊。
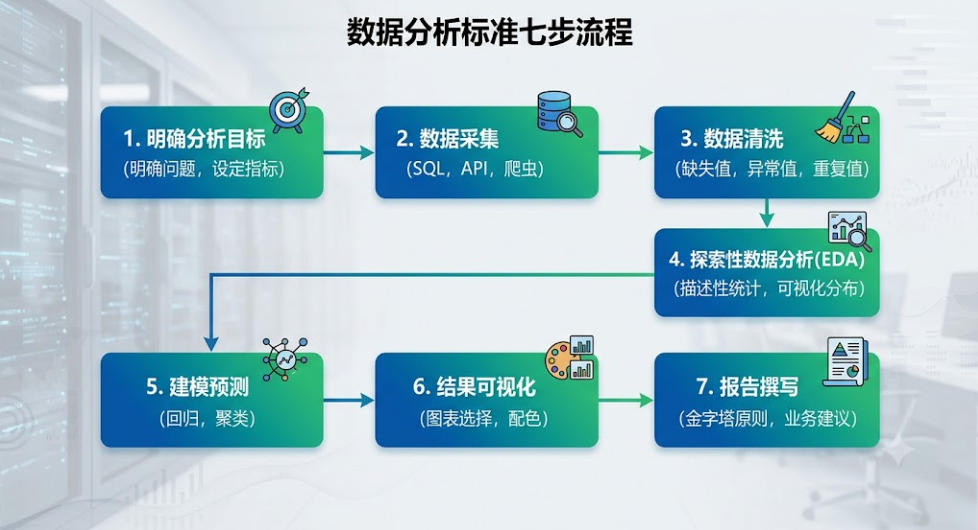
图2:数据分析标准七步流程
2.1 第一步:明确分析目标
没有明确目标的分析,都是无效劳动。
在动手取数之前,必须先回答三个问题:
示例:用户留存分析需求拆解
| “帮我看看用户留存情况” | 分析近3个月新用户次日/7日/30日留存趋势,找出留存下降的关键节点与影响因素 | 次日留存率、7日留存率、30日留存率、留存曲线 |
💡 提示:需求沟通阶段,多问几个"为什么"。很多业务方提的需求是"解决方案"而非"问题本身",你需要挖到真正的业务痛点。
2.2 第二步:数据采集
数据采集是分析的基础,数据质量直接决定分析上限。常见的数据采集方式有以下几种:
方式一:数据库查询(最常用)
通过SQL从业务数据库或数据仓库中提取数据。这是数据分析师的日常基本功。
— 示例:从电商数据库中提取用户行为数据
SELECT
user_id,
event_type,
event_time,
product_id,
category_id,
price
FROM user_behavior
WHERE event_time BETWEEN '2024-01-01' AND '2024-03-31'
AND user_id IS NOT NULL
ORDER BY user_id, event_time
LIMIT 100000;
方式二:API接口调用
从第三方平台或内部系统通过RESTful API获取数据,常用于获取外部数据或实时数据。
# 示例:通过API获取数据
import requests
import pandas as pd
def fetch_data_from_api(api_url, params=None, headers=None):
"""
从API接口获取数据并转为DataFrame
参数:
api_url: API地址
params: 查询参数字典
headers: 请求头字典
返回:
pd.DataFrame: 结构化数据
"""
try:
response = requests.get(api_url, params=params, headers=headers)
response.raise_for_status() # 检查请求是否成功
data = response.json()
return pd.DataFrame(data)
except requests.exceptions.RequestException as e:
print(f"API请求失败: {e}")
return None
# 调用示例
# df = fetch_data_from_api("https://api.example.com/data", params={"start_date": "2024-01-01"})
方式三:网络爬虫(需注意合规性)
当数据没有现成接口时,可以通过爬虫获取公开网页数据。但务必遵守相关法律法规和网站robots协议。
⚠️ 注意:爬虫合规性红线——
- 不爬取个人隐私数据
- 不突破网站反爬机制(如验证码、登录墙)
- 遵守robots.txt协议
- 控制请求频率,不影响网站正常运行
- 爬取的数据不用于商业牟利
2.3 第三步:数据清洗
数据清洗是数据分析中最耗时但也最关键的环节。业界有一个共识:数据清洗占整个分析流程60%-80%的时间。
常见数据问题与处理方法
| 缺失值 | df.isnull().sum() | 删除(缺失率<5%且随机缺失)/ 填充(均值/中位数/众数/模型预测)/ 标记缺失 |
| 异常值 | 箱线图 / 3σ原则 / IQR法 | 确认是否为真实异常 / 截断处理 / 分箱处理 |
| 重复值 | df.duplicated().sum() | 去重 / 保留最新记录 |
| 格式不一致 | 日期格式、字符串大小写 | 统一格式(pd.to_datetime、str.lower()) |
| 数据类型错误 | df.dtypes 检查 | 类型转换(astype、to_numeric) |
Python数据清洗实战代码
import pandas as pd
import numpy as np
# 读取数据
df = pd.read_csv('user_behavior.csv')
# ========== 步骤1:数据概览 ==========
print("数据形状:", df.shape)
print("\\n数据类型:\\n", df.dtypes)
print("\\n缺失值统计:\\n", df.isnull().sum())
print("\\n重复行数:", df.duplicated().sum())
# ========== 步骤2:处理重复值 ==========
df = df.drop_duplicates()
print(f"去重后数据量: {len(df)}")
# ========== 步骤3:处理缺失值 ==========
# 数值型字段用中位数填充(对异常值更鲁棒)
numeric_cols = df.select_dtypes(include=[np.number]).columns
for col in numeric_cols:
df[col] = df[col].fillna(df[col].median())
# 分类型字段用众数填充
categorical_cols = df.select_dtypes(include=['object']).columns
for col in categorical_cols:
if df[col].isnull().sum() > 0:
df[col] = df[col].fillna(df[col].mode()[0])
# ========== 步骤4:处理异常值(IQR法) ==========
def remove_outliers_iqr(df, column, factor=1.5):
"""使用IQR法处理异常值,返回去除异常值后的DataFrame"""
Q1 = df[column].quantile(0.25)
Q3 = df[column].quantile(0.75)
IQR = Q3 – Q1
lower_bound = Q1 – factor * IQR
upper_bound = Q3 + factor * IQR
return df[(df[column] >= lower_bound) & (df[column] <= upper_bound)]
# 对价格字段进行异常值处理
df_clean = remove_outliers_iqr(df, 'price')
print(f"异常值处理后数据量: {len(df_clean)}")
# ========== 步骤5:数据类型转换 ==========
df_clean['event_time'] = pd.to_datetime(df_clean['event_time'])
df_clean['user_id'] = df_clean['user_id'].astype(str)
# ========== 步骤6:特征工程(可选) ==========
# 提取时间特征
df_clean['date'] = df_clean['event_time'].dt.date
df_clean['hour'] = df_clean['event_time'].dt.hour
df_clean['day_of_week'] = df_clean['event_time'].dt.dayofweek
print("数据清洗完成!")
💡 提示:数据清洗不是一次性工作。在探索分析阶段发现新的数据质量问题时,要回到清洗步骤迭代优化。
🚀 进阶拓展:对于大数据量场景,可以使用 Dask 或 PySpark 进行分布式数据清洗,突破单机内存限制。【可替换工具名称:Dask / PySpark / Polars】
2.4 第四步:探索性数据分析(EDA)
探索性数据分析(Exploratory Data Analysis)是用统计方法和可视化手段理解数据、发现规律的过程。它是连接数据清洗和建模的桥梁。
EDA的核心目标
Python EDA实战代码
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# 设置中文字体和样式
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
sns.set_style("whitegrid")
# 读取清洗后的数据
df = pd.read_csv('cleaned_data.csv')
# ========== 单变量分析 ==========
# 1. 数值型变量统计描述
print(df.describe())
# 2. 用户行为类型分布
plt.figure(figsize=(10, 6))
event_counts = df['event_type'].value_counts()
sns.barplot(x=event_counts.index, y=event_counts.values, palette='viridis')
plt.title('用户行为类型分布', fontsize=14)
plt.xlabel('行为类型', fontsize=12)
plt.ylabel('次数', fontsize=12)
plt.xticks(rotation=45)
plt.tight_layout()
plt.savefig('event_distribution.png', dpi=150)
plt.close()
# 3. 价格分布直方图
plt.figure(figsize=(10, 6))
sns.histplot(df['price'], bins=50, kde=True, color='skyblue')
plt.title('商品价格分布', fontsize=14)
plt.xlabel('价格', fontsize=12)
plt.ylabel('频数', fontsize=12)
plt.tight_layout()
plt.savefig('price_distribution.png', dpi=150)
plt.close()
# ========== 双变量分析 ==========
# 4. 不同行为类型的价格对比
plt.figure(figsize=(10, 6))
sns.boxplot(x='event_type', y='price', data=df, palette='Set2')
plt.title('不同行为类型的商品价格分布', fontsize=14)
plt.xlabel('行为类型', fontsize=12)
plt.ylabel('价格', fontsize=12)
plt.tight_layout()
plt.savefig('price_by_event.png', dpi=150)
plt.close()
# 5. 每日活跃用户趋势
daily_active = df.groupby('date')['user_id'].nunique()
plt.figure(figsize=(12, 6))
daily_active.plot(marker='o', linewidth=2, color='#2E86AB')
plt.title('每日活跃用户数趋势', fontsize=14)
plt.xlabel('日期', fontsize=12)
plt.ylabel('活跃用户数', fontsize=12)
plt.xticks(rotation=45)
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.savefig('daily_active_trend.png', dpi=150)
plt.close()
# ========== 多变量分析 ==========
# 6. 相关性热力图(数值型变量)
numeric_df = df.select_dtypes(include=[np.number])
corr_matrix = numeric_df.corr()
plt.figure(figsize=(10, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', center=0,
fmt='.2f', square=True, linewidths=0.5)
plt.title('变量相关性热力图', fontsize=14)
plt.tight_layout()
plt.savefig('correlation_heatmap.png', dpi=150)
plt.close()
print("EDA可视化完成,已保存6张图表。")
💡 提示:EDA没有标准答案,关键是保持好奇心。多问"为什么会这样",每发现一个异常点都深入挖掘,往往能找到最有价值的洞察。
2.5 第五步:建模预测
建模是数据分析的"高级阶段",但并不意味着越复杂的模型越好。能用简单模型解决的问题,就不要用复杂模型。
这里以线性回归预测销量为例,展示建模的基本流程。
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score, mean_absolute_error
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
# ========== 步骤1:准备数据 ==========
# 假设我们有一份包含广告投入、促销活动、节假日等特征的销量数据
data = {
'ad_spend': np.random.normal(5000, 1000, 200), # 广告投入
'promotion': np.random.randint(0, 2, 200), # 是否促销
'holiday': np.random.randint(0, 2, 200), # 是否节假日
'weekday': np.random.randint(0, 7, 200), # 星期几
'sales': np.zeros(200) # 销量(目标变量)
}
df = pd.DataFrame(data)
# 构造销量与特征的关系(模拟真实数据)
df['sales'] = (1000
+ 0.5 * df['ad_spend']
+ 300 * df['promotion']
+ 500 * df['holiday']
+ np.random.normal(0, 200, 200))
# ========== 步骤2:特征工程 ==========
# 对星期几进行独热编码
df = pd.get_dummies(df, columns=['weekday'], prefix='weekday')
# 分离特征和目标变量
X = df.drop('sales', axis=1)
y = df['sales']
# ========== 步骤3:划分训练集和测试集 ==========
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42
)
# ========== 步骤4:特征标准化 ==========
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
# ========== 步骤5:训练模型 ==========
model = LinearRegression()
model.fit(X_train_scaled, y_train)
# ========== 步骤6:模型评估 ==========
y_pred = model.predict(X_test_scaled)
mse = mean_squared_error(y_test, y_pred)
rmse = np.sqrt(mse)
mae = mean_absolute_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)
print("=" * 50)
print("模型评估结果")
print("=" * 50)
print(f"均方误差 (MSE): {mse:.2f}")
print(f"均方根误差 (RMSE): {rmse:.2f}")
print(f"平均绝对误差 (MAE): {mae:.2f}")
print(f"决定系数 (R²): {r2:.4f}")
print("=" * 50)
# 输出特征重要性(线性回归系数)
print("\\n特征系数:")
for feature, coef in zip(X.columns, model.coef_):
print(f" {feature}: {coef:.4f}")
print(f" 截距: {model.intercept_:.4f}")
# ========== 步骤7:可视化预测结果 ==========
plt.figure(figsize=(10, 6))
plt.scatter(y_test, y_pred, alpha=0.6, color='#2E86AB')
plt.plot([y.min(), y.max()], [y.min(), y.max()], 'r–', linewidth=2, label='完美预测线')
plt.xlabel('实际销量', fontsize=12)
plt.ylabel('预测销量', fontsize=12)
plt.title('销量预测:实际值 vs 预测值', fontsize=14)
plt.legend()
plt.tight_layout()
plt.savefig('sales_prediction.png', dpi=150)
plt.close()
print("\\n模型训练完成,预测结果图已保存。")
⚠️ 注意:线性回归有几个前提假设——线性关系、独立性、正态性、同方差性。在实际应用中,需要验证这些假设是否成立,否则模型结果可能不可靠。
🚀 进阶拓展:当线性关系不成立时,可以尝试多项式回归、决策树、随机森林等模型。但记住,模型选择应该基于业务需求和数据特点,而非模型的复杂度。【可替换工具名称:XGBoost / LightGBM / CatBoost】
2.6 第六步:结果可视化
数据可视化是将分析结果传递给受众的关键环节。好的可视化能让复杂数据一目了然,差的可视化则会误导决策。
图表选择原则
| 比较大小 | 柱状图、条形图 | 各品类销售额对比 |
| 展示趋势 | 折线图、面积图 | 月度GMV趋势 |
| 展示占比 | 饼图、环形图、堆叠柱状图 | 用户来源渠道占比 |
| 展示分布 | 直方图、箱线图、小提琴图 | 用户年龄分布 |
| 展示关系 | 散点图、气泡图、热力图 | 广告投入与销量关系 |
| 展示流程 | 漏斗图、桑基图 | 用户转化漏斗 |
| 展示地理 | 地图、热力地图 | 各省份用户分布 |
可视化配色规范
推荐配色方案(专业且友好):
主色调:
– 蓝色系:#2E86AB(主色)、#A23B72(强调色)、#F18F01(辅助色)
– 绿色系:#2D6A4F(主色)、#40916C(辅助色)、#95D5B2(浅色)
数据可视化配色原则:
1. 同一图表中颜色不超过6种
2. 有序数据用渐变色,无序数据用对比色
3. 确保色盲友好(避免红绿搭配)
4. 背景与文字对比度足够
5. 保持整体风格统一
💡 提示:推荐使用 Seaborn 的预设配色方案(如 viridis、Set2、coolwarm),专业且美观。【可替换工具名称:Plotly / ECharts / D3.js】
2.7 第七步:报告撰写
分析报告是数据分析的最终交付物,也是体现分析师价值的重要载体。
报告撰写的金字塔原则
结论先行(金字塔尖)
├── 核心发现1 → 数据支撑 → 业务建议
├── 核心发现2 → 数据支撑 → 业务建议
└── 核心发现3 → 数据支撑 → 业务建议
详细分析(金字塔底)
├── 分析背景与目标
├── 数据来源与方法
├── 详细分析过程
└── 附录(数据明细、技术细节)
报告模板结构
# 【分析报告】XXX数据分析报告
## 一、核心结论(Executive Summary)
> 用3-5句话概括最重要的发现和建议,让读者30秒内掌握核心信息。
## 二、分析背景与目标
– 业务背景:…
– 分析目标:…
– 数据范围:…
## 三、关键发现
### 发现1:XXX
– 数据支撑:…
– 业务解读:…
– 建议行动:…
### 发现2:XXX
– 数据支撑:…
– 业务解读:…
– 建议行动:…
## 四、详细分析
(详细的分析过程、图表、数据)
## 五、行动建议
1. 短期建议(1-2周可落地):…
2. 中期建议(1-3个月可落地):…
3. 长期建议(3个月以上):…
## 六、附录
– 数据来源说明
– 分析方法说明
– 详细数据表
💡 提示:写报告时,永远站在读者的角度思考。业务方关心的是"结论是什么"和"我该怎么做",而不是你用了什么复杂的算法。
📌 模块三:实战技巧与避坑指南
3.1 高效工具组合推荐
工欲善其事,必先利其器。以下是经过实战验证的高效工具组合:
黄金组合:Python + SQL + Tableau
数据分析工具栈推荐
├── 数据提取层:SQL(MySQL / PostgreSQL / Hive / Spark SQL)
├── 数据处理层:Python(Pandas / NumPy)
├── 数据可视化层:Tableau / Power BI / FineBI
├── 自动化报表:Python + 定时任务 / Airflow
└── 协作与版本:Git + Jupyter Notebook / Google Colab
| SQL | 数据提取效率高,大数据量性能好 | 数据查询、聚合、关联 |
| Python | 灵活强大,生态丰富 | 数据清洗、建模、自动化 |
| Tableau | 拖拽式操作,交互性强 | 数据看板、探索式分析 |
| Excel | 上手快,人人都会 | 快速分析、小数据处理 |
🚀 进阶拓展:对于企业级数据分析场景,可以考虑 大数据技术栈——Hadoop + Spark + Hive + Presto,支持PB级数据处理。【可替换工具名称:ClickHouse / Doris / StarRocks】
3.2 常见误区警示
误区一:过度依赖工具,忽略业务理解
很多初学者把大量时间花在学习工具上,却忽略了业务理解。工具只是手段,业务才是目的。一个不懂业务的分析师,就像一个只会用手术刀却不懂医学的医生——工具再熟练也做不出正确的诊断。
避坑方法:
- 主动了解业务流程和行业知识
- 多和业务方沟通,理解他们的痛点
- 每次分析前先想清楚"这个分析能帮业务解决什么问题"
误区二:相关 ≠ 因果
看到两个变量相关,就认为存在因果关系,这是数据分析中最常见的错误之一。
示例:冰淇淋销量和溺水人数正相关,但二者之间没有因果关系——真正的原因是夏天温度升高,导致两者同时增加。
避坑方法:
- 始终考虑是否存在混淆变量
- 因果推断需要严格的实验设计(如A/B测试)
- 用"相关"而非"导致"来描述发现,除非有充分证据
误区三:幸存者偏差
只看到经过某种筛选而产生的结果,没有意识到筛选的过程,因此忽略了被筛选掉的关键信息。
示例:分析"成功企业的共同特征"时,只看存活下来的企业,却忽略了那些失败的企业——也许失败的企业也有同样的特征。
避坑方法:
- 思考数据是怎么来的,是否存在筛选机制
- 对比分析成功和失败两组的差异
- 谨慎下结论,考虑反例
误区四:样本量不足就下结论
用少量数据得出"重大发现",结果经不起验证。
避坑方法:
- 做假设检验,计算统计显著性
- 关注效应量而非只看p值
- 小样本场景用贝叶斯方法或非参数检验
误区五:数据质量差却强行分析
垃圾进,垃圾出(Garbage In, Garbage Out)。数据质量有问题时,再精妙的分析也没有意义。
避坑方法:
- 分析前先做数据质量评估
- 数据质量问题严重时,先解决数据问题再分析
- 在报告中明确说明数据局限性
3.3 性能优化技巧
当数据量达到百万级甚至千万级时,普通的处理方式会变得很慢。以下是一些实用的性能优化技巧:
SQL优化
— 优化前:全表扫描
SELECT * FROM orders WHERE create_time > '2024-01-01';
— 优化后:只查需要的字段 + 索引优化
SELECT order_id, user_id, amount, create_time
FROM orders
WHERE create_time >= '2024-01-01'
AND create_time < '2024-04-01';
— 建议:在create_time字段上建立索引
SQL优化要点:
Python大数据量处理优化
import pandas as pd
# 优化技巧1:指定数据类型,减少内存占用
dtypes = {
'user_id': 'int32',
'event_type': 'category',
'price': 'float32'
}
df = pd.read_csv('large_data.csv', dtype=dtypes, parse_dates=['event_time'])
# 优化技巧2:分块读取大文件
chunk_size = 100000 # 每次读取10万行
chunks = []
for chunk in pd.read_csv('large_data.csv', chunksize=chunk_size):
# 对每个chunk进行处理
chunk_processed = chunk[chunk['event_type'] == 'purchase']
chunks.append(chunk_processed)
df = pd.concat(chunks, ignore_index=True)
# 优化技巧3:用query()方法进行高效筛选
df_filtered = df.query("price > 100 and event_type == 'purchase'")
# 优化技巧4:用分类数据减少内存
df['category'] = df['category'].astype('category')
print(f"内存占用: {df.memory_usage(deep=True).sum() / 1024 / 1024:.2f} MB")
🚀 进阶拓展:当数据量大到单机无法处理时,可以考虑使用 PySpark 进行分布式计算,或使用 DuckDB 进行高性能列式分析。【可替换工具名称:Polars / Vaex / Modin】
📌 模块四:案例实战——电商用户购买偏好分析
理论说了这么多,我们来做一个完整的实战案例。假设你是某电商平台的数据分析师,运营同学提出需求:分析用户的购买偏好,为精准营销提供数据支撑。
4.1 案例背景与目标
业务背景:某电商平台积累了大量用户行为数据,运营团队希望了解用户的购买偏好,以便进行精准营销和商品推荐。
分析目标:
4.2 数据准备
我们使用模拟的电商用户行为数据,包含以下字段:
| user_id | int | 用户ID |
| event_type | string | 行为类型(view/cart/purchase) |
| event_time | datetime | 行为时间 |
| product_id | int | 商品ID |
| category_id | int | 品类ID |
| category_code | string | 品类名称 |
| brand | string | 品牌 |
| price | float | 价格 |
4.3 完整分析代码
# ==========================================
# 电商用户购买偏好分析 – 完整实战代码
# ==========================================
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from datetime import datetime
# ========== 配置 ==========
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
sns.set_style("whitegrid")
colors = ['#2E86AB', '#A23B72', '#F18F01', '#C73E1D', '#3B1F2B']
# ========== 步骤1:数据加载与清洗 ==========
print("=" * 60)
print("步骤1:数据加载与清洗")
print("=" * 60)
# 模拟数据(实际工作中替换为真实数据源)
np.random.seed(42)
n_records = 50000
categories = ['electronics.smartphone', 'electronics.laptop',
'clothing.shoes', 'clothing.tshirt',
'home.furniture', 'home.kitchen',
'beauty.skincare', 'beauty.perfume']
brands = ['apple', 'samsung', 'xiaomi', 'nike', 'adidas',
'uniqlo', 'ikea', 'skii', 'dior']
data = {
'user_id': np.random.randint(1, 5000, n_records),
'event_type': np.random.choice(['view', 'cart', 'purchase'],
n_records, p=[0.7, 0.2, 0.1]),
'event_time': pd.date_range('2024-01-01', '2024-03-31',
periods=n_records),
'product_id': np.random.randint(10000, 99999, n_records),
'category_id': np.random.randint(1000, 1008, n_records),
'category_code': np.random.choice(categories, n_records),
'brand': np.random.choice(brands, n_records),
'price': np.random.lognormal(5, 1, n_records).round(2)
}
df = pd.DataFrame(data)
# 数据清洗
df = df.drop_duplicates()
df['event_time'] = pd.to_datetime(df['event_time'])
df['date'] = df['event_time'].dt.date
df['hour'] = df['event_time'].dt.hour
# 提取一级品类
df['main_category'] = df['category_code'].str.split('.').str[0]
print(f"数据量: {len(df):,} 条")
print(f"用户数: {df['user_id'].nunique():,} 人")
print(f"商品数: {df['product_id'].nunique():,} 个")
print(f"时间范围: {df['event_time'].min()} ~ {df['event_time'].max()}")
# ========== 步骤2:整体行为分析 ==========
print("\\n" + "=" * 60)
print("步骤2:整体行为分析")
print("=" * 60)
# 行为转化漏斗
funnel = df.groupby('event_type')['user_id'].nunique().sort_values(ascending=False)
print("\\n用户行为转化漏斗:")
for event, count in funnel.items():
print(f" {event}: {count:,} 人")
# 计算转化率
view_users = funnel.get('view', 0)
cart_users = funnel.get('cart', 0)
purchase_users = funnel.get('purchase', 0)
print(f"\\n浏览→加购转化率: {cart_users/view_users*100:.2f}%")
print(f"加购→购买转化率: {purchase_users/cart_users*100:.2f}%")
print(f"浏览→购买转化率: {purchase_users/view_users*100:.2f}%")
# 绘制漏斗图
fig, ax = plt.subplots(figsize=(10, 6))
funnel_data = pd.DataFrame({
'stage': ['浏览', '加购', '购买'],
'users': [view_users, cart_users, purchase_users]
})
bars = ax.barh(funnel_data['stage'], funnel_data['users'],
color=colors[:3], height=0.6)
ax.set_title('用户行为转化漏斗', fontsize=14, fontweight='bold')
ax.set_xlabel('用户数', fontsize=12)
# 添加数值标签
for bar, users in zip(bars, funnel_data['users']):
ax.text(users + 50, bar.get_y() + bar.get_height()/2,
f'{users:,}人', va='center', fontsize=11)
plt.tight_layout()
plt.savefig('conversion_funnel.png', dpi=150)
plt.close()
# ========== 步骤3:用户价值分析(RFM模型) ==========
print("\\n" + "=" * 60)
print("步骤3:用户价值分析(RFM模型)")
print("=" * 60)
# 只看购买数据
purchase_df = df[df['event_type'] == 'purchase'].copy()
# 计算RFM指标
reference_date = purchase_df['event_time'].max() + pd.Timedelta(days=1)
rfm = purchase_df.groupby('user_id').agg({
'event_time': lambda x: (reference_date – x.max()).days, # R: 最近一次购买间隔
'product_id': 'count', # F: 购买频次
'price': 'sum' # M: 购买金额
}).rename(columns={
'event_time': 'Recency',
'product_id': 'Frequency',
'price': 'Monetary'
})
# RFM打分(5分制)
rfm['R_Score'] = pd.qcut(rfm['Recency'], 5, labels=[5, 4, 3, 2, 1]).astype(int)
rfm['F_Score'] = pd.qcut(rfm['Frequency'].rank(method='first'), 5, labels=[1, 2, 3, 4, 5]).astype(int)
rfm['M_Score'] = pd.qcut(rfm['Monetary'], 5, labels=[1, 2, 3, 4, 5]).astype(int)
# 用户分层
def segment_user(row):
r, f, m = row['R_Score'], row['F_Score'], row['M_Score']
if r >= 4 and f >= 4 and m >= 4:
return '重要价值用户'
elif r >= 4 and f <= 2 and m >= 4:
return '重要发展用户'
elif r <= 2 and f >= 4 and m >= 4:
return '重要保持用户'
elif r <= 2 and f <= 2 and m >= 4:
return '重要挽留用户'
elif r >= 4 and f >= 4 and m <= 2:
return '一般价值用户'
else:
return '一般用户'
rfm['Segment'] = rfm.apply(segment_user, axis=1)
# 各层级用户统计
segment_stats = rfm.groupby('Segment').agg({
'Recency': 'count',
'Monetary': 'sum'
}).rename(columns={'Recency': '用户数', 'Monetary': '总消费金额'})
segment_stats['用户占比'] = (segment_stats['用户数'] / len(rfm) * 100).round(2)
segment_stats['金额占比'] = (segment_stats['总消费金额'] / rfm['Monetary'].sum() * 100).round(2)
segment_stats = segment_stats.sort_values('总消费金额', ascending=False)
print("\\n用户分层结果:")
print(segment_stats)
# 绘制用户分层饼图
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))
# 用户数占比
ax1.pie(segment_stats['用户数'], labels=segment_stats.index,
autopct='%1.1f%%', colors=colors[:len(segment_stats)], startangle=90)
ax1.set_title('用户数占比', fontsize=12)
# 消费金额占比
ax2.pie(segment_stats['总消费金额'], labels=segment_stats.index,
autopct='%1.1f%%', colors=colors[:len(segment_stats)], startangle=90)
ax2.set_title('消费金额占比', fontsize=12)
plt.suptitle('RFM用户分层分析', fontsize=14, fontweight='bold')
plt.tight_layout()
plt.savefig('rfm_segmentation.png', dpi=150)
plt.close()
# ========== 步骤4:品类销售分析 ==========
print("\\n" + "=" * 60)
print("步骤4:品类销售分析")
print("=" * 60)
# 各品类销售数据
category_sales = purchase_df.groupby('main_category').agg({
'product_id': 'count',
'price': ['sum', 'mean'],
'user_id': 'nunique'
}).round(2)
category_sales.columns = ['销量', '销售额', '均价', '购买人数']
category_sales = category_sales.sort_values('销售额', ascending=False)
category_sales['客单价'] = (category_sales['销售额'] / category_sales['购买人数']).round(2)
print("\\n品类销售排行:")
print(category_sales)
# 绘制品类销售对比图
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))
# 销售额对比
category_sales['销售额'].plot(kind='bar', ax=ax1, color=colors[0])
ax1.set_title('各品类销售额对比', fontsize=12)
ax1.set_ylabel('销售额', fontsize=10)
ax1.tick_params(axis='x', rotation=45)
# 客单价对比
category_sales['客单价'].plot(kind='bar', ax=ax2, color=colors[1])
ax2.set_title('各品类客单价对比', fontsize=12)
ax2.set_ylabel('客单价', fontsize=10)
ax2.tick_params(axis='x', rotation=45)
plt.tight_layout()
plt.savefig('category_sales.png', dpi=150)
plt.close()
# ========== 步骤5:购买时间规律分析 ==========
print("\\n" + "=" * 60)
print("步骤5:购买时间规律分析")
print("=" * 60)
# 按小时分析
hourly_purchase = purchase_df.groupby('hour').size()
# 按星期分析
purchase_df['day_of_week'] = purchase_df['event_time'].dt.dayofweek
weekday_purchase = purchase_df.groupby('day_of_week').size()
weekday_names = ['周一', '周二', '周三', '周四', '周五', '周六', '周日']
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))
# 小时分布
hourly_purchase.plot(kind='line', ax=ax1, marker='o', color=colors[0], linewidth=2)
ax1.set_title('购买行为小时分布', fontsize=12)
ax1.set_xlabel('小时', fontsize=10)
ax1.set_ylabel('购买次数', fontsize=10)
ax1.grid(True, alpha=0.3)
# 星期分布
weekday_purchase.index = weekday_names
weekday_purchase.plot(kind='bar', ax=ax2, color=colors[1])
ax2.set_title('购买行为星期分布', fontsize=12)
ax2.set_xlabel('星期', fontsize=10)
ax2.set_ylabel('购买次数', fontsize=10)
ax2.tick_params(axis='x', rotation=0)
plt.tight_layout()
plt.savefig('purchase_timing.png', dpi=150)
plt.close()
# 找出购买高峰时段
peak_hour = hourly_purchase.idxmax()
print(f"购买高峰时段: {peak_hour}点({hourly_purchase.max():,}次)")
# ========== 步骤6:核心结论与建议 ==========
print("\\n" + "=" * 60)
print("步骤6:核心结论与建议")
print("=" * 60)
# 计算关键指标
total_users = df['user_id'].nunique()
purchase_users = purchase_df['user_id'].nunique()
conversion_rate = purchase_users / total_users * 100
avg_order_value = purchase_df['price'].mean()
print(f"""
📊 核心发现:
1. 转化效率:
– 整体购买转化率为 {conversion_rate:.2f}%
– 浏览→加购转化率 {cart_users/view_users*100:.2f}%
– 加购→购买转化率 {purchase_users/cart_users*100:.2f}%
2. 用户价值:
– 重要价值用户占比 {segment_stats.loc['重要价值用户', '用户占比']:.1f}%,
贡献了 {segment_stats.loc['重要价值用户', '金额占比']:.1f}% 的销售额
– 客单价最高的品类是 {category_sales['客单价'].idxmax()}({category_sales['客单价'].max():.0f}元)
3. 时间规律:
– 购买高峰在 {peak_hour} 点
– 周末购买量 {'高于' if weekday_purchase[5:].mean() > weekday_purchase[:5].mean() else '低于'} 工作日
💡 运营建议:
1. 提升转化:
– 加购→购买环节转化率偏低,建议推送加购提醒和限时优惠
– 对浏览未加购用户进行个性化推荐
2. 用户运营:
– 对重要价值用户提供VIP专属权益,提升忠诚度
– 对重要挽留用户发起召回活动,防止流失
3. 品类策略:
– 重点推广高客单价品类,提升整体GMV
– 对低销量品类进行品类优化或淘汰
4. 营销时机:
– 在购买高峰时段加大营销投放
– 利用周末开展促销活动
""")
print("分析完成!共生成6张可视化图表。")
4.4 案例产出物
通过以上分析,我们产出了以下成果:
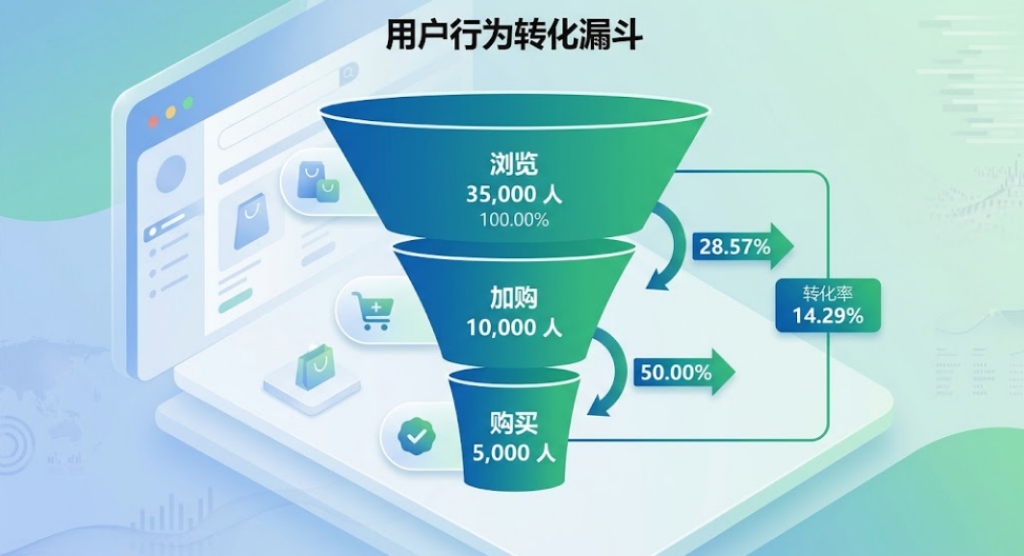
图3:用户行为转化漏斗
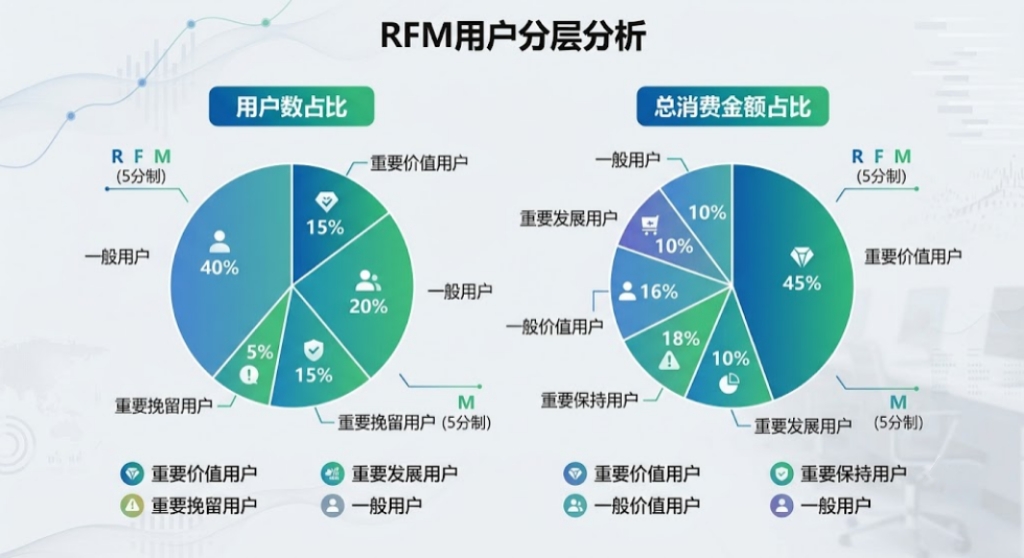
图4:RFM用户分层分析
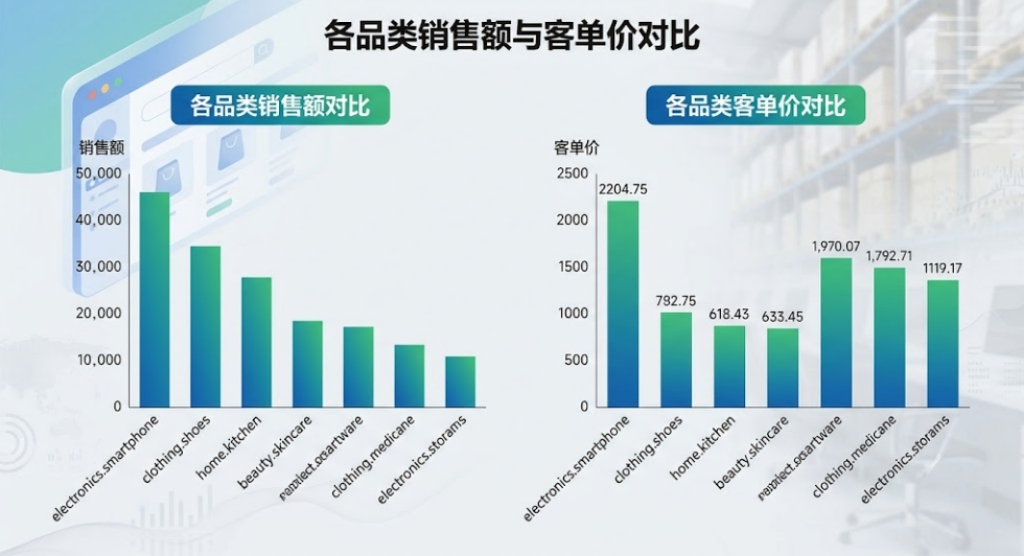
图5:各品类销售对比
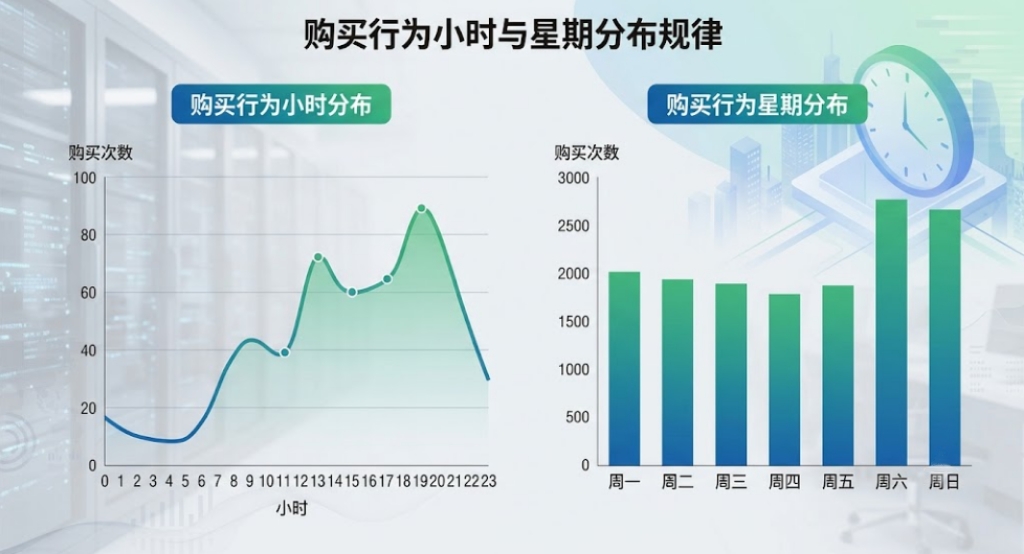
图6:购买行为时间规律
💡 提示:以上代码可以直接运行。将模拟数据部分替换为你的真实数据源,即可快速应用到实际工作中。
📌 学习资源推荐
经典书籍
| 《深入浅出数据分析》 | 入门首选,用案例讲解,通俗易懂 | ⭐ |
| 《利用Python进行数据分析》 | Python数据分析圣经,Wes McKinney著 | ⭐⭐⭐ |
| 《统计学习方法》 | 机器学习经典教材,李航著 | ⭐⭐⭐⭐ |
| 《精益数据分析》 | 业务分析思维必读,结合大量案例 | ⭐⭐ |
| 《故事与数据》 | 数据可视化与数据叙事经典 | ⭐⭐ |
| 《SQL必知必会》 | SQL入门最快的书 | ⭐ |
在线课程与平台
- Kaggle:全球最大的数据科学社区,有大量实战数据集和Notebook
- Coursera – 吴恩达机器学习:机器学习入门经典课程
- DataCamp:交互式学习平台,Python/R/SQL都有
- LeetCode SQL:SQL刷题必备
- B站:搜索"数据分析",有大量免费教程
工具文档
- Pandas官方文档:https://pandas.pydata.org/docs/
- NumPy官方文档:https://numpy.org/doc/
- Matplotlib官方文档:https://matplotlib.org/stable/contents.html
- Seaborn官方文档:https://seaborn.pydata.org/
- Tableau官方教程:https://help.tableau.com/
优质博客与社区
- CSDN数据分析频道
- 知乎数据分析话题
- 掘金数据科学板块
- 人人都是产品经理(数据分析板块)
- DataFaber(数据分析社区)
📌 总结
数据分析是一门实践出真知的技能。光看不练假把式,建议你:
🎯 最后一句话:优秀的数据分析师不是会用最多工具的人,而是能从数据中发现最有价值洞察并推动业务增长的人。
希望这篇文章能帮你建立系统化的数据分析思维框架。如果觉得有帮助,欢迎点赞收藏,有问题也可以在评论区交流~
📝 CSDN发布标签建议
#数据分析 #Python #数据可视化 #业务分析 #实战技巧 #SQL #数据清洗 #EDA #RFM模型
🔧 可替换接口说明
本文中以下位置预留了可替换接口,方便你根据实际需求调整:
- 【可替换工具名称:Dask / PySpark / Polars】 —— 大数据处理工具替换
- 【可替换工具名称:XGBoost / LightGBM / CatBoost】 —— 机器学习模型替换
- 【可替换工具名称:Plotly / ECharts / D3.js】 —— 可视化工具替换
- 【可替换工具名称:ClickHouse / Doris / StarRocks】 —— OLAP引擎替换
- 【可替换工具名称:Polars / Vaex / Modin】 —— 高性能DataFrame替换
本文为原创技术文章,如需转载请注明出处。文中代码均可直接运行,建议在Python 3.8+环境下测试。