-一句话总览:TanStack.com 放弃 RSC,不是因为 RSC 不好,而是因为他们后来发现,自己原本需要解决的核心问题,其实是一套过大的 Markdown 与代码高亮依赖。
快速结论
| TanStack.com 为什么最初使用 RSC | 为了把庞大的 Markdown、Shiki 和代码高亮运行时留在服务端 |
| 为什么后来停用 | 他们把渲染依赖压缩到约 27 KiB,继续维护 RSC 内容通道的收益变小了 |
| 性能有没有退步 | 在作者测量的两条生产路由上,当前 SSR 版本整体更小,TBT 更低;但这不是证明 SSR 普遍胜出的实验 |
| RSC 还有没有价值 | 有。只要服务端边界确实能隔离巨大依赖或昂贵逻辑,RSC 仍然值得考虑 |
| 最重要的工程启示 | 不要用一套更复杂的架构,去掩盖一个本来可以被缩小的依赖问题 |
先别急着把它理解成 RSC 失败
React Server Components 这几年很容易被讨论成一种站队题:支持 RSC,或者反对 RSC;使用 Next.js,或者坚持传统 SSR。
TanStack.com 的这次调整其实没有这么戏剧化。它更像一次很诚实的工程复盘:某个方案曾经解决了真实问题,后来问题本身变了,于是原来的方案也应该跟着变。
这件事有意思的地方,不是他们从 RSC 退回了 SSR,而是他们先重新检查了当初为什么需要 RSC。
RSC 当初确实解决了一个大问题
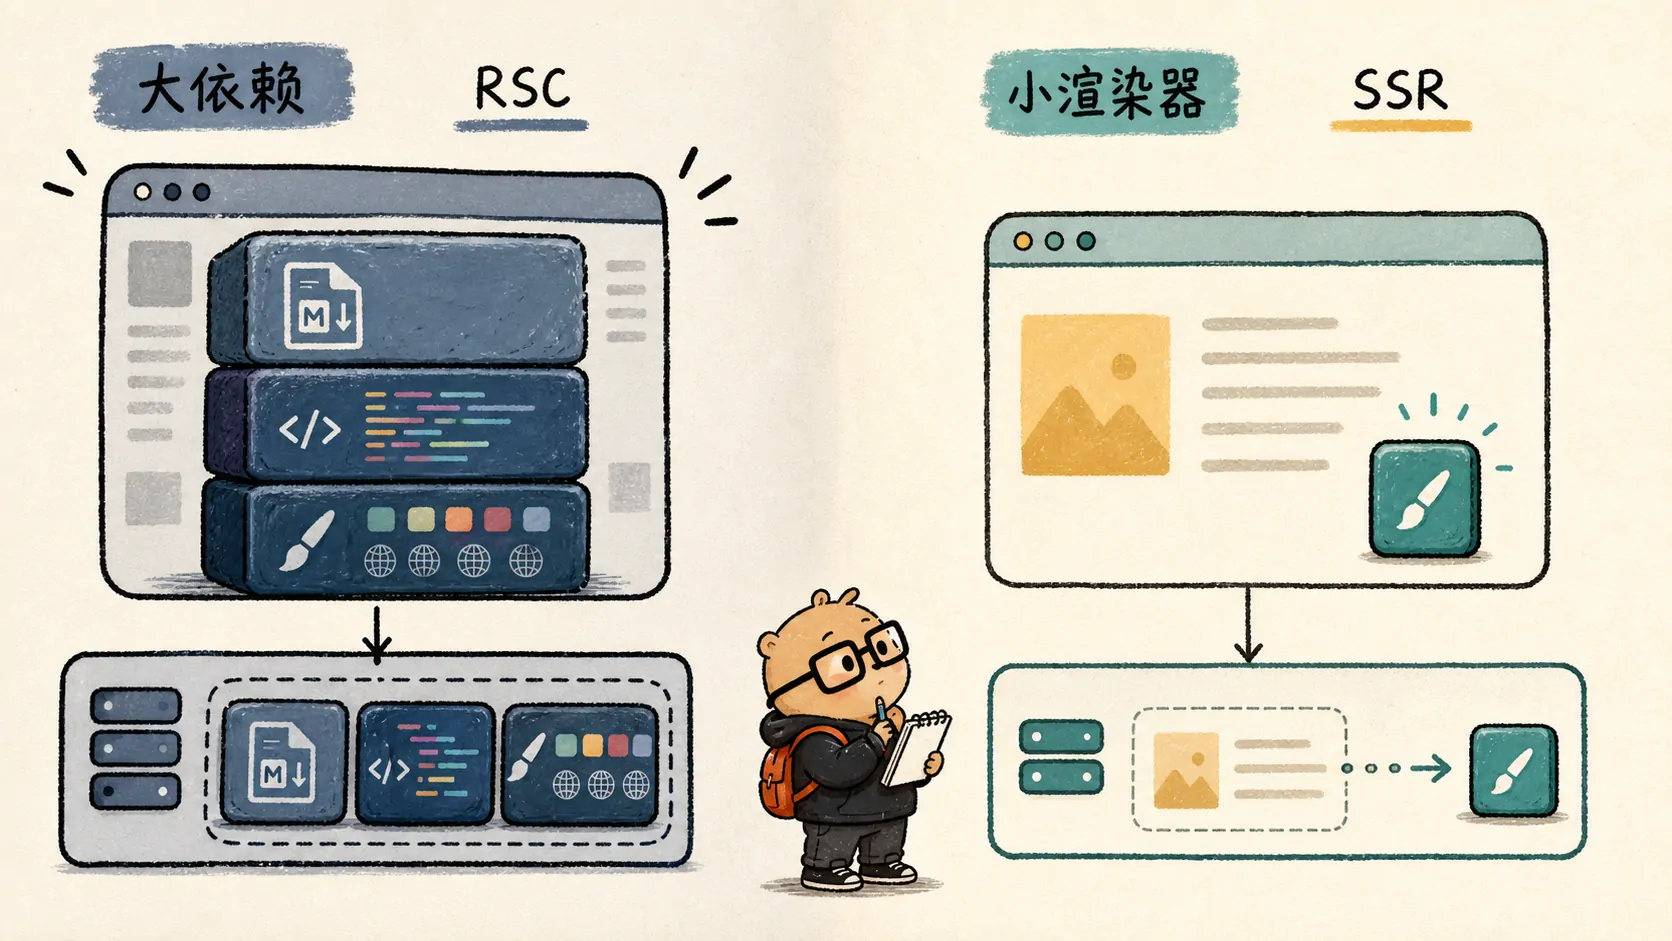
TanStack.com 是一个内容很多的站点:文档、博客、代码示例、语法高亮缺一不可。第一次性能优化时,他们发现一个文档页大约要向浏览器传输 1.1 MiB 的脚本,其中约 358 KiB 与代码高亮有关。
浏览器为了让读者看懂一段代码,下载了 Shiki 的运行时、主题、语言包和一套 Markdown 渲染能力。换句话说,读者只是打开了一篇文档,却顺手下载了一个小型内容发布系统。
RSC 的价值在这里非常直接:把 Markdown 解析和代码高亮放到服务端,浏览器不再携带那套庞大的渲染栈。
第一次迁移的收益也很漂亮。博客页和文档页的客户端 JavaScript 都减少了约 153 KB gzip,文档示例页减少了约 40 KB。部分生产路由的 TBT、传输体积和 Lighthouse 分数也明显改善。
所以,TanStack 并不是后来才发现 RSC 没用。恰恰相反,RSC 曾经把一个很大的性能问题解决得相当有效。
但架构复杂度开始暴露出来
真正让作者不舒服的,是这条内容链路越来越难解释。
原本应该是这样的事情:服务端拿到 Markdown,页面把它渲染出来。
实际却变成了:
这些步骤并不一定错。但当一个开发者想回答“Markdown 到底在哪里变成页面”时,他已经不能只看内容组件,而要先理解整套 RSC 上下文。
这就是架构开始产生反作用的时刻:它还在运行,却不再自然而然地解释系统。
他们真正做的优化:不是继续调架构,而是把依赖做小
TanStack 团队随后用自己维护的 @tanstack/markdown 和 @tanstack/highlight,替换掉旧的 Markdown 和代码渲染栈。
这两个包没有试图实现一个包打天下的内容系统,而是只围绕 TanStack.com 的真实需求提供能力。结果是,显式的 Markdown 与代码渲染器约为 27 KiB。
它比 RSC 方案多传输约 18~19 KiB。乍看之下,这像是一次性能上的退让。但换来的东西是:
- 内容可以继续以 Markdown 和源码数据的形态流动;
- 服务端函数只返回真正变化的数据;
- 浏览器只需支付一次小型渲染器成本;
- 路由文件可以直接解释自己在渲染什么;
- 内容改动不必牵动一整套 RSC 专用管线。
这是一笔很典型的工程交易:多传一点可复用的代码,换回更低的系统复杂度和更清晰的数据边界。
普通 SSR 没有把性能收益全部还回去
TanStack 用当前生产站点与仍运行 RSC 版本的旧站点进行了对比。测试来自 2026 年 7 月 4 日的 Lighthouse CLI 移动端运行,每条路由取两次平均值。
作者很谨慎地说明,这不是一次完美的 RSC-only 对照实验,因为当前站点还包含其他正常生产改动。但就他们最关心的两个指标——传输体积和主线程阻塞——结果很清楚:普通 SSR 版本没有因为多了一点渲染器代码,就回到原来的巨大客户端负担。
| 博客文章 | 1086 KiB | 889 KiB | 139 ms | 66 ms |
| Router 文档概览 | 1017 KiB | 836 KiB | 209 ms | 115 ms |
Lighthouse 综合分数并没有给出一个简单的“SSR 全面胜出”结论:博客页这次测试从 76 降到了 67,文档页都是 71。作者没有回避这个结果,因为一个有噪声的综合分数不应该被包装成架构真理。
更有解释力的是负载构成:当前版本的 Markdown/代码渲染器增加了约 18~19 KiB,但文档和博客的整体传输体积更小,TBT 也更低。
真正改变账本的,是用户不会只打开一个页面
如果只看首屏,RSC 似乎天然占优:渲染器留在服务端,浏览器不用下载它。
但 TanStack.com 的用户平均一次会访问约六个页面。
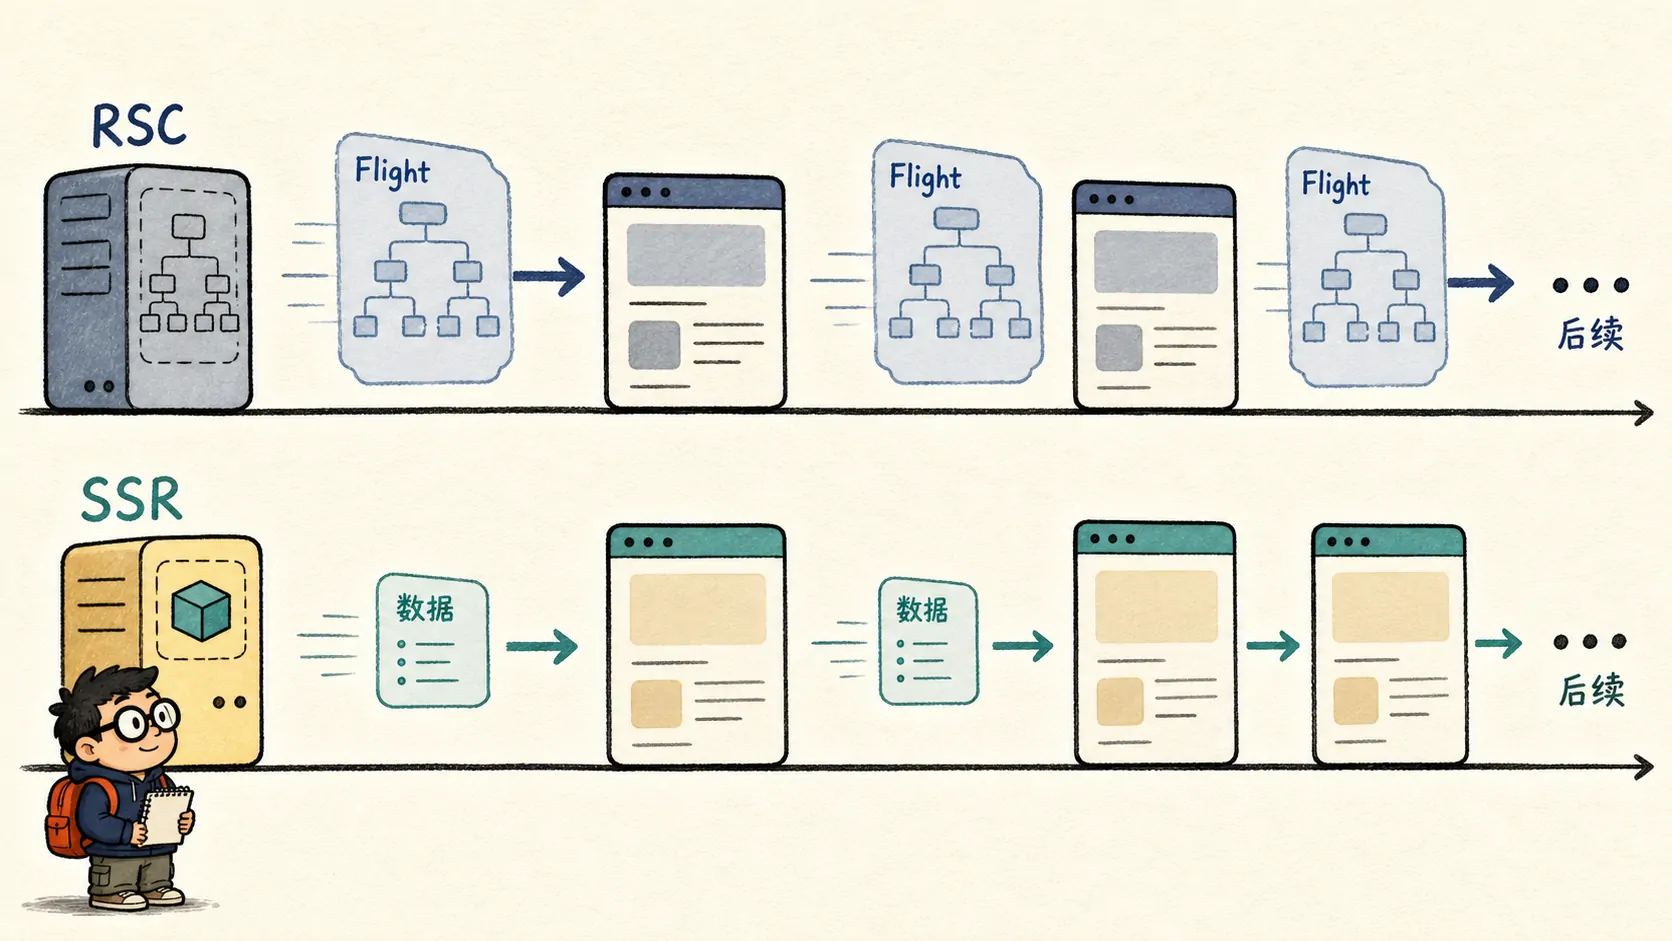
在 RSC 版本中,每个新的服务端内容都可能携带一份序列化后的组件树。渲染器本身没有下发,但每次导航或重新请求,浏览器可能继续接收新的 Flight payload。
普通 SSR 的账本则不同:浏览器第一次下载一套很小的渲染器,之后服务端只发送变化的内容数据。
作者记录了几组典型差异:Query 首页代码示例每次少约 4.6 KB,Router 文档概览少约 1.5 KB,Router 示例少约 4.1 KB,较重的博客文章少约 5.6 KB。
这揭示了一个经常被首屏指标遮住的事实:
复杂架构省下的成本,可能只是换一种形式,在每次后续请求里重新支付。
当可复用的客户端依赖很大时,RSC 这样做很合理;但当依赖已经小到几十 KiB,普通 SSR 的一次性成本可能更适合真实流量。
代码复杂度是很可靠的架构信号
性能数字之外,作者还观察了迁移前后的代码形状。
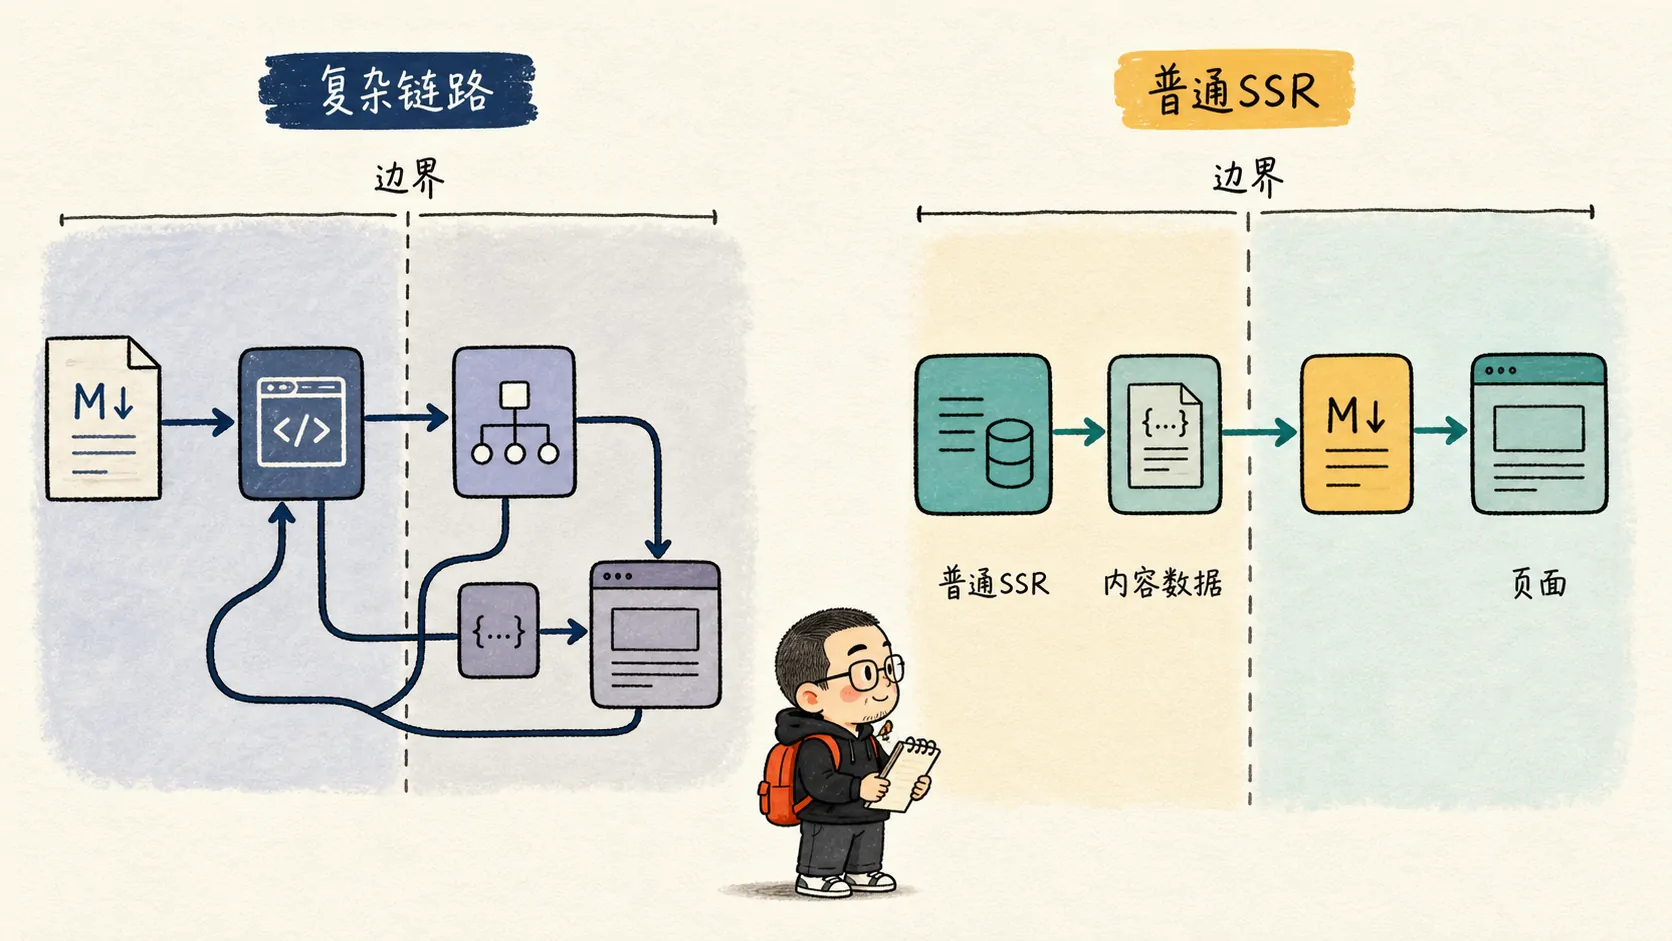
迁移前,从 fetchDocs 或 fetchBlogPost 开始,内容要经过 RSC 专用的 Markdown 处理器、JSX 包装、服务端组件渲染和序列化,最终以 contentRsc 的形式抵达路由。
迁移后,服务端函数返回内容数据,Markdown 组件接收 Markdown 文档并正常渲染。首页代码示例直接传递组件数据,下面媒体较多的部分仍然通过定向 Hydrate 控制首屏工作量。
迁移提交 92b1c481 删除或重命名了整条内容专用 RSC 路径:RSC 专属内容管线移除了 9 个文件、约 555 行代码,旧 Markdown/渲染插件又移除了 8 个文件、约 994 行代码。
这不是为了追求代码行数更少,而是让系统重新回到一个更容易回答的问题:内容在哪里来,组件在哪里渲染,数据经过了什么边界。
浏览器现在多做一点渲染工作,但成本小、可预测、可复用。开发者也不用在打开一个 Markdown 组件前,先在脑子里加载整个 bundler 和 RSC 模型。
这对普通项目有什么启示
TanStack.com 的案例不能直接推出“SSR 永远优于 RSC”。它更适合被当成一套决策顺序。
第一,先确认 RSC 解决的究竟是什么
如果答案只是“某个依赖太大,不想发给浏览器”,先不要马上把问题升级成架构选择。先看看依赖能不能拆分、裁剪、按需加载,或者围绕真实业务契约重写一层更小的实现。
第二,把一次加载和多次导航分开算
首屏节省多少 KB,只是账本的一半。还要看用户一次会访问几页,每次导航是否会重新传输序列化结果,以及浏览器是否需要重复解析和处理这些数据。
第三,把维护成本当成真实成本
当一个内容改动需要同时理解服务端文件、Flight payload、特殊组件、bundler 配置和序列化边界时,系统已经在向团队收取维护税。
这笔税不会总是出现在 Lighthouse 里,但会出现在排查问题、接手代码、写测试和让 AI Agent 修改代码的时间里。
第四,区分支持一种能力和强制使用一种能力
TanStack Start 仍然支持 RSC,但 tanstack.com 不再使用它。这个选择很重要:框架可以保留能力,应用则根据自己的问题决定是否启用。
能力存在,不等于每个项目都应该围绕它组织架构。

结尾:让内容重新成为内容
TanStack.com 的这次迁移,最值得记住的不是 RSC 或 SSR 的胜负,而是一个更普遍的工程判断:
当你发现自己需要一套复杂架构,才能把一个巨大依赖藏起来时,先问问能不能把依赖本身做小。
如果依赖确实足够大,RSC 可能是非常好的解法。如果依赖已经小到可以被浏览器合理地复用,那么继续维持那套架构,可能只是在用更复杂的系统掩盖一个已经不存在的问题。
真正成熟的架构,不是永远坚持第一次的选择,而是在问题改变后,愿意把不再必要的东西拿掉。
原文:We Stopped Using RSC on TanStack.com