YOLO26训练自己的数据集
从代码下载、环境配置、数据集准备、模型训练到实例测试
|
适用任务 |
目标检测、实例分割、语义分割、图像分类、关键点检测、旋转目标检测、目标追踪 |
|
内容范围 |
源码安装 → 训练 → 验证 → 图片/视频实例测试 |
写在前面
本文面向第一次使用 YOLO26 训练自定义目标检测数据集的读者,目标是把“源码在哪里下载、环境怎样安装、数据集怎么摆放、训练代码每一项是什么意思、训练结果到哪里查看、如何使用 best.pt 做真实图片与视频测试”完整串联起来。按照本文步骤操作,最终将得到一套可以复用的训练、验证、断点续训和推理脚本。
你将完成的工作
- 下载官方或定制版 Ultralytics 源码,并以开发模式安装本地代码。
- 检查 Python、PyTorch、CUDA 和 GPU 是否可用。
- 按照 YOLO 格式组织 images、labels 和 data.yaml。
- 使用 yolo26.yaml 从头训练,或根据兼容情况加载预训练权重。
- 理解 cache、imgsz、epochs、batch、close_mosaic、workers、resume、amp、project、name 等参数。
- 读取 weights/best.pt、results.csv、results.png、混淆矩阵和 PR 曲线。
- 在验证集或测试集上评估,并对单张图片、文件夹、视频和摄像头进行实例测试。
本文目录
YOLO26训练自己的数据集
从代码下载、环境配置、数据集准备、模型训练到实例测试
1. 整体流程与项目目录
1.1 推荐项目结构
2. 下载源码与安装环境
2.1 先确认你需要哪一种源码
2.2 克隆官方源码的标准方式
2.3 创建YOLO26 虚拟环境
2.4 安装 PyTorch
2.5 下载YOLO26 的官方Ultralytics 源码
2.6 检查基础环境
3. 检查自定义 yolo26-DMSSP.yaml 模型
3.1 模型配置文件必须存在
3.2 自定义层也必须能够被解析
3.3 从头训练还是使用预训练权重
4. 准备自己的数据集与 data.yaml
4.1 目标检测数据集目录
4.2 data.yaml 完整示例
5. 完整训练代码
5.1 推荐的稳健版本
6. 训练代码逐行解读
6.1 忽略警告信息
6.2 导入 YOLO 类
6.3 Windows 必须使用 main 保护
6.4 构建检测模型
6.5 加载预训练权重
6.6 model.train(…) 参数总表
6.7 cache=False
6.8 imgsz=640
6.9 epochs=30
6.10 batch=4
6.11 close_mosaic=0 的真实含义
6.12 workers=0
6.13 patience、resume 与 amp
6.14 project 和 name
7. 启动训练与查看输出
7.1 在项目根目录打开终端
7.2 第一次不要直接训练 300 个 epoch
7.3 训练日志重点看什么
7.4 训练输出目录
8. 训练指标与结果文件解读
8.1 best.pt 与 last.pt
8.2 Precision、Recall、mAP50 和 mAP50-95
8.3 results.csv
8.4 混淆矩阵和曲线
9. 测试集验证与断点续训
9.1 使用 best.pt 验证 test 集
9.2 断点续训
10. 使用 best.pt 完成实例测试
10.1 单张图片测试
10.2 测试整个图片文件夹
10.3 视频测试
10.4 摄像头实时测试
10.5 conf 和 imgsz 如何选择
10.6 查看预测结果对象
11. 常见报错及解决方法
11.1 训练前自动检查脚本
12. 参数调整与训练优化建议
12.1 推荐的实验顺序
12.2 不同硬件的起始建议
12.3 小目标检测任务建议
12.4 是否应该开启预训练
13. 可直接复制的完整脚本
13.1 训练脚本 train_yolo26.py
13.2 测试集验证脚本 val_yolo26.py
13.3 图片实例测试脚本 predict_yolo26.py
13.4 断点续训脚本 resume_yolo26.py
13.5 data.yaml 模板
13.6 一组可直接运行的命令
14. 训练前后检查清单与参考资料
14.1 训练前检查清单
14.2 训练后检查清单
结语
1. 整体流程与项目目录
一次完整的 YOLO26 自定义数据集训练,可以拆分成“源码与环境、数据与配置、模型初始化、训练、验证、推理测试”六个阶段。建议先跑通最小流程,再增加训练轮数、调整模型结构或加入预训练权重。
训练全流程
|
下载或获取定制版源码 ↓ 创建虚拟环境并安装 PyTorch、Ultralytics 依赖 ↓ 确认 yolo26.yaml 和自定义模块真实存在 ↓ 整理 images/train、images/val、images/test ↓ 整理 labels/train、labels/val、labels/test ↓ 编写 datasets/data.yaml ↓ 运行 train_yolo26.py ↓ 检查 runs/train/exp/weights/best.pt ↓ 使用 val_yolo26.py 评估 test 集 ↓ 使用 predict_yolo26.py 测试图片、视频或摄像头 |
1.1 推荐项目结构
推荐目录
|
YOLO26_AIMGD/ ├── ultralytics/ # Python 包源码 │ ├── cfg/ │ │ └── models/ │ │ ├── 26/ # 官方 YOLO26 配置 │ │ └── yolo26.yaml # 官方 YOLO26模型配置 │ │ └── enhance26/ │ │ └── yolo26-DMSSP.yaml # 你的自定义模型配置 │ └── … ├── datasets/ │ ├── data.yaml │ ├── images/ │ │ ├── train/ │ │ ├── val/ │ │ └── test/ │ └── labels/ │ ├── train/ │ ├── val/ │ └── test/ ├── train_yolo26.py ├── val_yolo26.py ├── predict_yolo26.py ├── resume_yolo26.py └── runs/ └── train/ └── exp/ |
|
路径原则 本文给出的相对路径都默认在项目根目录执行脚本,即当前终端目录中同时能看到 ultralytics、datasets 和训练脚本。若从其他目录运行,建议使用绝对路径或在代码中通过 Path(__file__).resolve().parent 固定项目根目录。 |
2. 下载源码与安装环境
2.1 先确认你需要哪一种源码
如果只是训练官方 YOLO26,可以直接安装 ultralytics 包或克隆官方仓库。
eg:若要运行 yolo26-LPRM.yaml,则必须获取包含 enhance26 目录、LPRM 自定义层及相应解析注册代码的定制版仓库。
仅下载一个 YAML 文件通常不够,因为 YAML 中引用的自定义模块还需要在 Python 源码中定义并注册。
2.2 克隆官方源码的标准方式
Git 下载
|
git clone https://github.com/ultralytics/ultralytics.git cd ultralytics |
官方文档推荐可以通过 pip 安装稳定版,也可以克隆仓库后以开发模式安装源码。
开发模式的好处是:修改本地 Python 文件或模型配置后,当前环境会立即使用这些修改,而不是仍然调用 site-packages 中的另一个版本。文中训练自定义结构时更推荐源码开发模式。
2.3 创建YOLO26 虚拟环境
虚拟环境可以隔离不同项目的依赖,避免其他项目的 PyTorch、CUDA 或 ultralytics 版本影响当前训练。以下命令选择 Conda 或 venv 任意一种即可。
创建并激活环境
|
# Conda 方式 conda create -n yolo26 python=3.10 -y conda activate yolo26 # 或 Windows venv 方式(不推荐,建议使用conda方式) python -m venv .venv .venv\\Scripts\\activate # Linux / macOS venv 激活 source .venv/bin/activate |
进入yolo26虚拟环境后,安装YOLO26需要的包文件:
1.进入虚拟环境指令:conda activate yolo26
2.安装指令:pip install ultralytics
!!!安装ultralytics包要求:在 Python>=3.8 环境中安装包,使用 PyTorch>=1.8。:
2.4 安装 PyTorch
PyTorch 安装命令与显卡驱动、CUDA 运行时和操作系统有关,不建议在教程中永久固定某一条 CUDA 命令。最稳妥的做法是根据本机环境使用 PyTorch 官方安装选择器生成命令。安装后再通过 torch.cuda.is_available() 检查 GPU 是否可用。
检查 PyTorch 与 GPU
|
完整复制下面的代码,进入自己的虚拟环境,在终端输入下面的命令: python -c "import torch; print('torch:', torch.__version__); print('cuda available:', torch.cuda.is_available()); print('cuda:', torch.version.cuda);print('device:', torch.cuda.get_device_name(0) if torch.cuda.is_available() else 'CPU')" |
显示下面的信息:
torch: 2.7.0+cu128 cuda available: True cuda: 12.8 device: NVIDIA GeForce RTX 5060 Laptop GPU

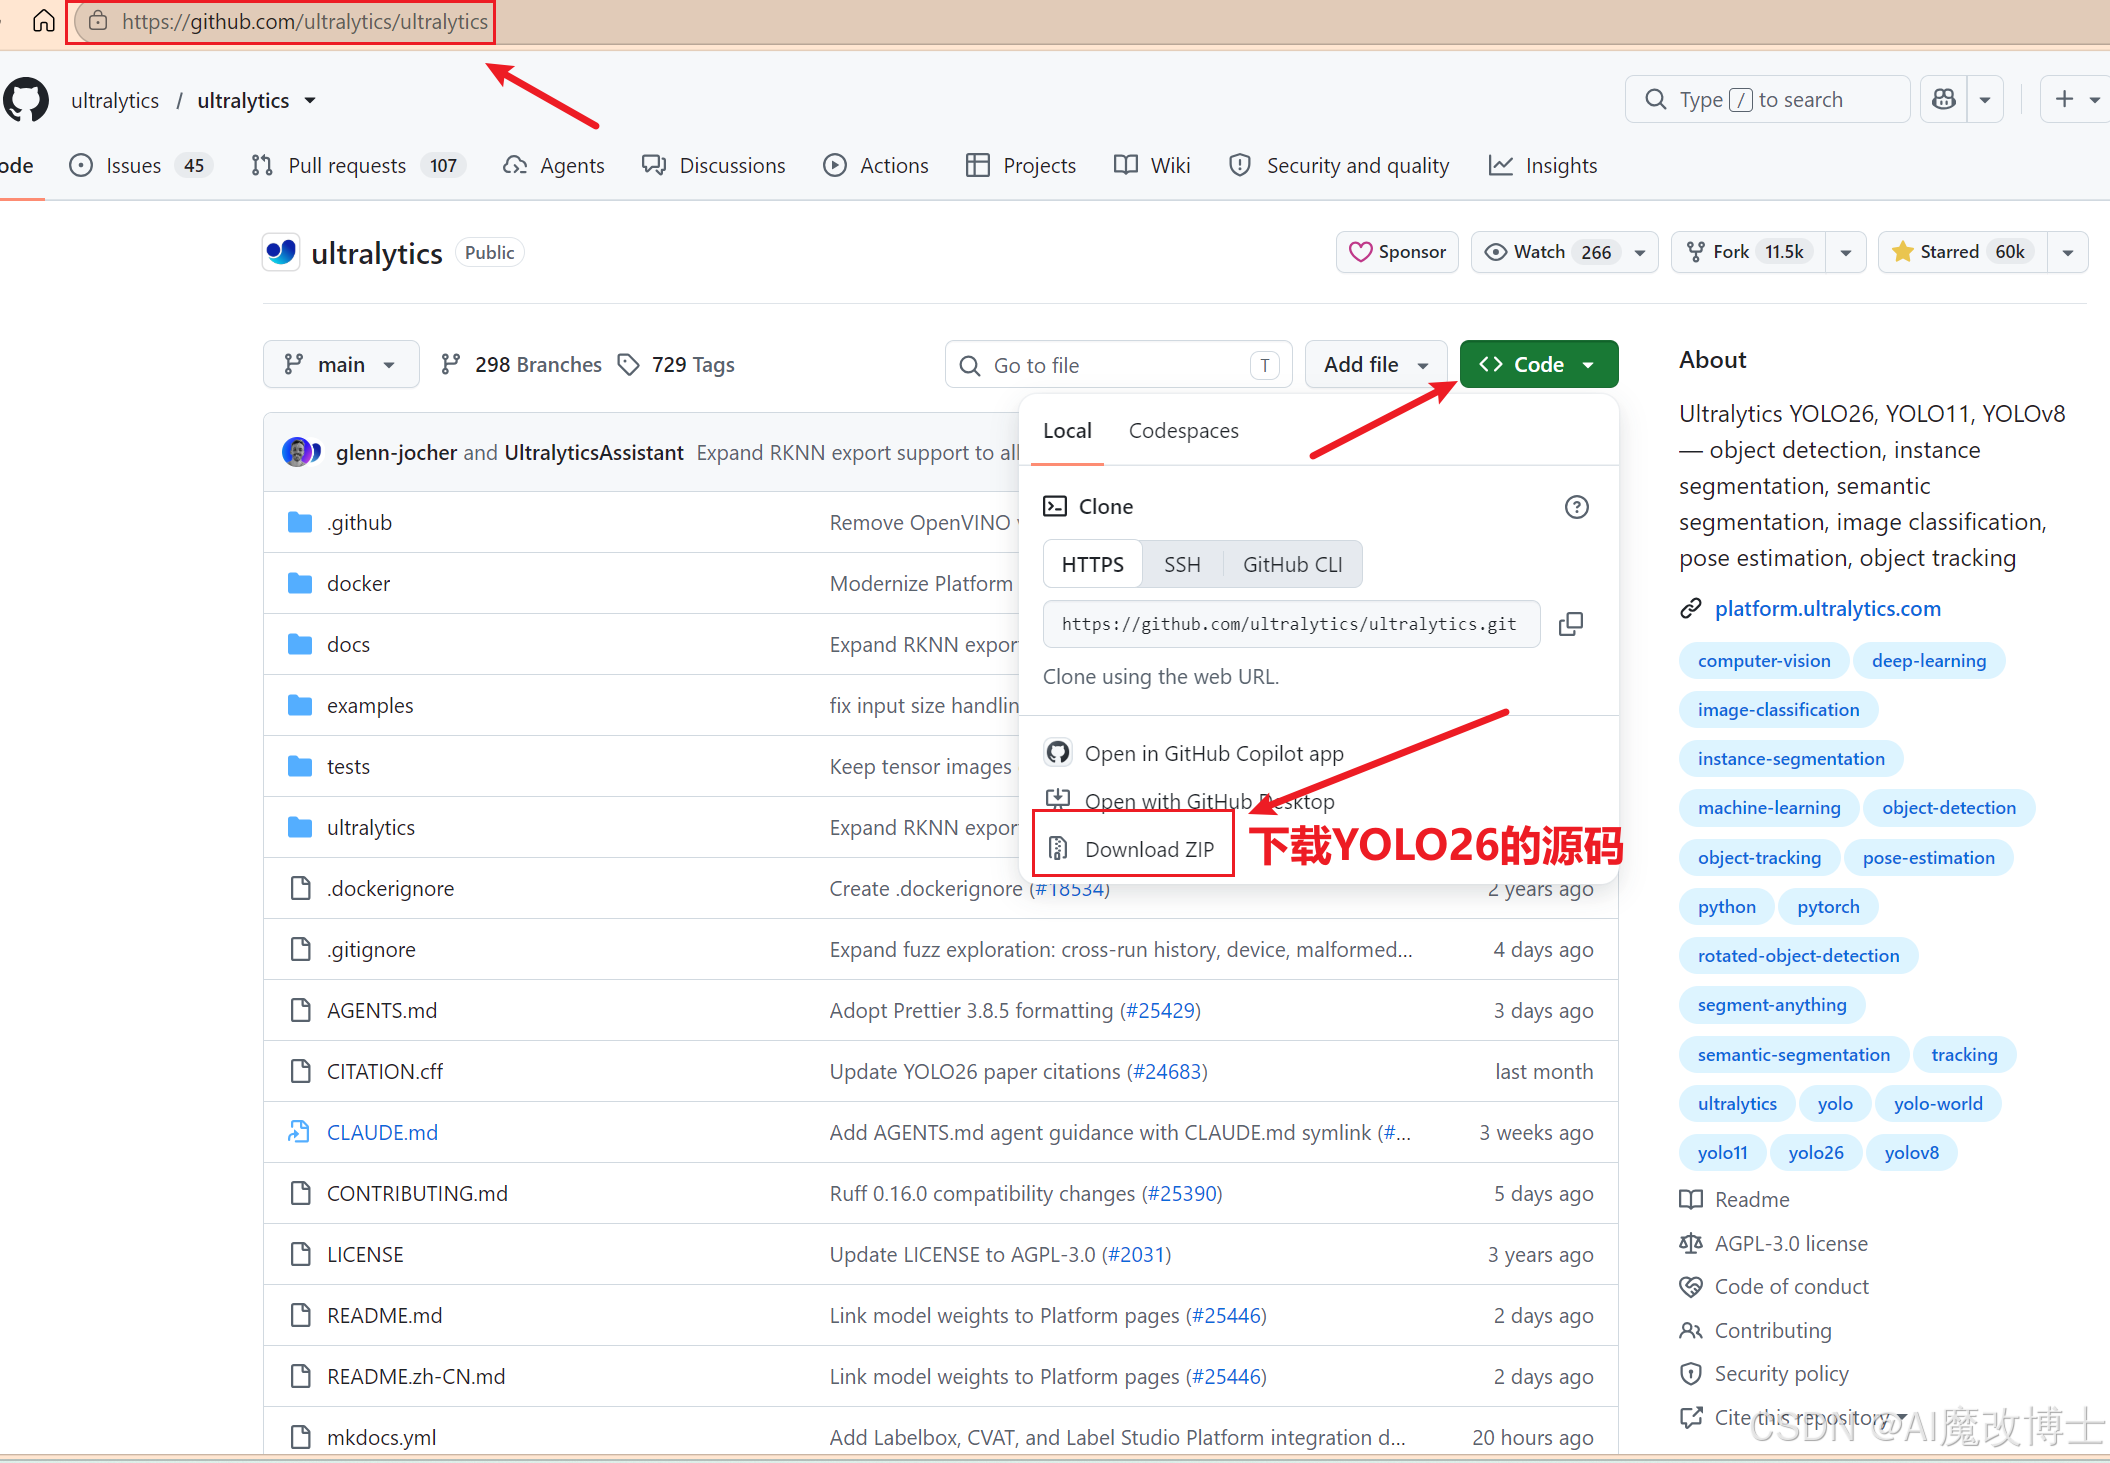
2.5 下载YOLO26 的官方Ultralytics 源码
点击链接自动跳转,进入YOLO26官方网站,下载源码
2.6 检查基础环境
快速环境检查
|
python -c "from ultralytics import YOLO; print('YOLO import OK')" python -c "import torch; print(torch.cuda.is_available())" nvidia-smi |
其中 nvidia-smi 只适用于 NVIDIA GPU。训练时如果未显式设置 device,Ultralytics 会在可用时选择 GPU,否则使用 CPU;正式训练建议显式指定 device=0,以免误在 CPU 上运行较大模型。
3. 检查 yolo26.yaml 模型
3.1 模型配置文件必须存在
检查 YAML 文件
|
python -c "from pathlib import Path; p=Path('./ultralytics/cfg/models/26/yolo26.yaml'); print(p.resolve()); print('exists:', p.exists())" |

如果输出 exists: False,说明模型路径写错、文件未复制到位,或当前工作目录不正确。不要直接改成一个“看起来像”的路径;应先找到真实文件位置。
3.2 自定义层也必须能够被解析
模型 YAML 一般会在 backbone 或 head 中引用模块名称。
举例:若 yolo26-DMSSP.yaml 使用了DMSSP 或其他自定义层,仅有 YAML 文件仍无法运行。对应 Python 类需要存在于源码中,并在 Ultralytics 模块解析链路中可导入。
常见错误是 KeyError、NameError 或模块参数数量不匹配。
|
推荐的最小验证 在正式训练前先执行一次 model.info() 或构建模型。只要模型结构不能成功解析,就不要继续排查数据集和训练参数。 |
test_model_build.py
from ultralytics import YOLO
model = YOLO(
'./ultralytics/cfg/models/26/yolo26.yaml',
task='detect'
)
model.info()
举例:自定义DMSSP模块
|
from ultralytics import YOLO model = YOLO( './ultralytics/cfg/models/enhance26/yolo26-DMSSP.yaml', task='detect' ) model.info() |

3.3 从头训练还是使用预训练权重
本文给出的代码通过 YAML 构建模型,且 model.load(…) 被注释,因此默认是从随机初始化权重开始训练。官方文档通常推荐在模型结构兼容时从预训练权重开始,因为收敛更快、对小数据集更友好;也支持“先用 YAML 构建结构,再调用 load() 迁移兼容权重”;如果模型yaml文件改动比较大,就不建议加载预训练权重,可以直接训练到模型拟合。
|
方式 |
代码 |
适用情况 |
|
从头训练 |
YOLO('yolo26.yaml') |
完全随机初始化。适合结构变化较大、预训练权重不兼容,或需要严格从零实验的情况。通常需要更多数据与训练轮数。 |
|
直接微调 |
YOLO('yolo26n.pt') |
加载官方预训练模型并在自己的数据集上训练。最省事,但不会使用自定义DMSSP结构。 |
|
结构+迁移权重 |
YOLO('model.yaml').load('yolo26n.pt') |
先构建自定义结构,再加载形状兼容的权重。自定义层和通道变化较大时,会有部分权重无法匹配。 |
|
关于你代码中的 yolo26n.pt 示例注释写的是 model.load("yolo26n.pt")。跨代加载是否有效取决于层名称、层数和参数形状兼容性。不要把“能执行”理解成“全部权重都成功迁移”。更合理的做法是优先使用与你的 YOLO26 自定义结构来源一致的预训练权重;没有兼容权重时保留注释,从头训练。 |
4. 准备自己的数据集与 data.yaml
4.1 目标检测数据集目录
标准目录
|
datasets/ ├── data.yaml ├── images/ │ ├── train/ │ ├── val/ │ └── test/ └── labels/ ├── train/ ├── val/ └── test/ |
图片与标签通过“同名主文件名”对应,例如 images/train/0001.jpg 对应 labels/train/0001.txt。Ultralytics 的检测标签格式是一张图片对应一个 TXT,每行一个目标,格式为 class x_center y_center width height,边界框坐标需要归一化到 0~1,类别编号从 0 开始。
标签示例:0001.txt
|
0 0.512500 0.436111 0.225000 0.327778 1 0.741406 0.628472 0.154688 0.209722 |
4.2 data.yaml 完整示例
datasets/data.yaml
|
# 数据集根目录。建议使用绝对路径,或相对于当前工作目录的稳定路径。 path: datasets_xxx # 以下路径相对于 path train: images/train val: images/val test: images/test # 类别名称:编号必须与 TXT 标签中的 class_id 一致 names: 0: license_plate # 多类别示例: # names: # 0: car # 1: license_plate # 2: person |
|
Windows YAML 路径建议 YAML 中优先使用正斜杠,例如 D:/datasets/project,而不是 D:\\datasets\\project。若使用相对路径,必须明确它相对于程序运行时的工作目录,而不是相对于 data.yaml 文件本身的直觉位置。 |
5. 完整训练代码
下面先完整保留你提供的训练代码,随后逐项解释。该脚本需要放在项目根目录运行,并确保模型 YAML 与 data.yaml 路径存在。
train_yolo26.py(推荐版1)
import warnings
warnings.filterwarnings('ignore')
from ultralytics import YOLO
if __name__ == '__main__':
model = YOLO(
'./ultralytics/cfg/models/26/yolo26.yaml',
task='detect'
) # detect, segment, classify, pose, obb
# model.load('yolo26n.pt') # loading pretrain weights
model.train(
data='./datasets/data.yaml',
cache=False,
imgsz=640,
epochs=300,
batch=4,
close_mosaic=0,
# 最后多少个 epoch 关闭 mosaic 数据增强;0 表示全程保持 mosaic
workers=0,
# Windows 下出现卡住可尝试 workers=0
# patience=0, # 设置 0 关闭 early stopping
# resume=True, # 断点续训时应在 YOLO 初始化时加载 last.pt
# amp=False, # loss 出现 NaN 可尝试关闭 AMP
project='runs/train',
name='exp',
)
5.1 推荐的稳健版本
下面的版本增加了路径检查、device、seed、exist_ok 和结果返回值,更适合持续实验。路径仍以你的项目为例。
train_yolo26.py(推荐版2)
import warnings
from pathlib import Path
warnings.filterwarnings('ignore')
from ultralytics import YOLO
ROOT = Path(__file__).resolve().parent
MODEL_YAML = ROOT / 'ultralytics/cfg/models/26/yolo26.yaml'
DATA_YAML = ROOT / 'datasets/data.yaml'
if __name__ == '__main__':
if not MODEL_YAML.is_file():
raise FileNotFoundError(f'模型配置不存在:{MODEL_YAML}')
if not DATA_YAML.is_file():
raise FileNotFoundError(f'数据配置不存在:{DATA_YAML}')
# 使用自定义 YAML 构建检测模型;默认从随机权重开始训练
model = YOLO(str(MODEL_YAML), task='detect')
# 只有确认结构兼容时再加载预训练权重
# model.load(str(ROOT / 'weights/yolo26n.pt'))
results = model.train(
data=str(DATA_YAML),
cache=False,
imgsz=640,
epochs=300,
batch=4,
close_mosaic=0,
workers=0,
device=0, # 无 NVIDIA GPU 时改为 'cpu'
seed=0,
patience=100,
amp=True,
project=str(ROOT / 'runs/train'),
name='exp_DMSSP',
exist_ok=False,
plots=True,
)
print('训练结束。结果保存目录:', results.save_dir)
6. 训练代码逐行解读
6.1 忽略警告信息
|
import warnings warnings.filterwarnings('ignore') |
该设置会隐藏 Python 警告,让终端输出更简洁,但也可能把版本兼容、弃用接口或数据问题提示一起隐藏。首次搭建环境或排查错误时,建议临时删除这两行,让所有警告显示出来。
6.2 导入 YOLO 类
|
from ultralytics import YOLO |
YOLO 类是 Ultralytics Python API 的统一入口,可以通过模型 YAML 或 .pt 权重创建模型,然后调用 train、val、predict、export 等模式.
6.3 Windows 必须使用 main 保护
|
if __name__ == '__main__': … |
Windows 的多进程数据加载使用 spawn 方式。如果训练脚本缺少 main 保护,子进程可能反复执行整份脚本,引发 RuntimeError、重复创建进程或训练卡住。Ultralytics 官方训练文档也明确提醒 Windows 脚本使用这一结构。
6.4 构建检测模型
|
model = YOLO( './ultralytics/cfg/models/26/yolo26.yaml', task='detect' ) |
第一个参数是模型架构 YAML 路径,YOLO 会根据配置构建网络。task="detect" 明确指定目标检测任务。虽然 YOLO 类通常能够从文件自动判断任务,但自定义配置解析不完整时显式指定 task 更稳妥。
|
task |
任务含义 |
|
detect |
目标检测:输出类别、置信度和水平边界框。 |
|
segment |
实例分割:除检测框外还输出每个目标的掩膜。 |
|
classify |
图像分类:对整张图像输出类别。 |
|
pose |
姿态估计:输出关键点。 |
|
obb |
旋转框检测:适合遥感、倾斜目标等。 |
6.5 加载预训练权重
|
# model.load('yolo26n.pt') |
当前行被注释,因此不会加载权重。取消注释后,load() 会尝试把权重映射到当前 YAML 构建的模型中。只要模型结构发生变化,就可能只有一部分参数成功加载。训练日志一般会显示迁移了多少项权重,必须关注该提示。
6.6 model.train(…) 参数总表
|
参数 |
示例值 |
作用与建议 |
|
data |
./datasets/data.yaml |
数据集配置文件。包含训练、验证、测试图片路径和类别名称。 |
|
cache |
False |
不缓存图片。可设 True/"ram" 缓存到内存,或 "disk" 缓存到磁盘;可加速读取,但会占用内存或磁盘。 |
|
imgsz |
640 |
训练输入尺寸。数值越大,小目标信息通常更充分,但显存占用和计算量增加。训练模式通常使用单个整数。 |
|
epochs |
30 |
完整遍历训练集的次数。30 适合先验证流程,正式训练常需要结合数据量和曲线增加。 |
|
batch |
4 |
每个批次的图片数量。越大越占显存。也可尝试 batch=-1 自动估算单卡批量。 |
|
close_mosaic |
0 |
最后 N 个 epoch 关闭 Mosaic。官方默认通常为 10;设置 0 表示不在训练末期自动关闭。 |
|
workers |
0 |
数据加载进程数。Windows 卡住时设置 0 最稳,但加载速度可能较慢。 |
|
patience |
注释 |
早停等待轮数。验证指标长期不提升时提前结束;设置 0 可关闭早停。 |
|
resume |
注释 |
从 last.pt 恢复模型、优化器、学习率调度和 epoch。应先用 YOLO("last.pt") 初始化。 |
|
amp |
默认 True |
自动混合精度。可降低显存并加速;若出现 NaN 或硬件兼容问题,可尝试 False。 |
|
project |
runs/train |
实验总目录。 |
|
name |
exp |
本次实验子目录名;若已存在且 exist_ok=False,通常会自动创建 exp2、exp3。 |
6.7 cache=False
cache=False 表示训练时按需从磁盘读取图片。机械硬盘或网络盘读取较慢时,可以尝试 cache="disk";内存充足时可尝试 cache=True。不要为了追求速度盲目缓存大型数据集,内存不足会导致系统频繁交换甚至训练崩溃。官方训练参数支持关闭缓存、内存缓存和磁盘缓存。
6.8 imgsz=640
训练时图片会按 YOLO 数据管线缩放和填充到目标尺寸。640 是常见起点。车牌、微小缺陷、遥感小目标等场景可以尝试 800、960 或更高,但需要同步降低 batch。评价不同 imgsz 时,必须保持数据划分、随机种子和其他训练设置一致。
6.9 epochs=30
30 个 epoch 更像“流程验证”或小规模初始实验。是否足够不能只看数字,应观察验证 mAP、训练损失和验证损失是否仍在改善。如果曲线在第 30 个 epoch 仍明显上升,说明应继续训练;如果验证指标长时间不提升甚至下降,可能已经过拟合。
6.10 batch=4
batch 由显存决定。显存不足时优先降低 batch,其次降低 imgsz 或改用更小模型。当前官方训练参数还支持 batch=-1 自动尝试约 60% 显存利用率,或使用小数指定目标显存比例。
6.11 close_mosaic=0 的真实含义
close_mosaic=N 表示在最后 N 个 epoch 关闭 Mosaic,以便训练末期回到更接近真实图片的分布并稳定优化。设置 0 并不是关闭 Mosaic,而是关闭“末期关闭 Mosaic 的机制”,即训练全过程仍可能启用 Mosaic。你原代码的注释解释是正确的。官方训练设置中的默认值通常为 10。
6.12 workers=0
workers 表示每个训练进程用于加载数据的工作进程数。Windows、IDE、网络磁盘或自定义数据增强环境中,workers>0 有时会卡住或报多进程错误;设置 0 表示在主进程加载,稳定但速度可能较慢。环境稳定后可以尝试 2、4 或 8。
6.13 patience、resume 与 amp
patience 控制早停;resume 用于完整恢复训练状态;amp 控制自动混合精度。这三个参数解决的是不同问题,不能混为一谈。
|
设置 |
作用 |
|
patience=0 |
关闭早停;即使验证指标不再提升,也训练到 epochs。 |
|
resume=True(加载 last.pt) |
从中断位置继续,恢复优化器、学习率、epoch 等状态。 |
|
amp=False |
关闭自动混合精度。适合排查 NaN、溢出或特殊算子兼容问题,但显存占用可能增加。 |
6.14 project 和 name
|
project='runs/train', name='exp', |
训练结果通常保存到 runs/train/exp。重复运行时,如果目录已存在且不允许覆盖,框架可能自动递增到 exp2、exp3。为了避免不同模型结果混在一起,建议使用能表达模型与实验设置的名称,例如 exp_yolo26_DMSSP_640_seed0。
7. 启动训练与查看输出
7.1 在项目根目录打开终端
Windows CMD
|
cd /d D:\\Otherfiles\\AIMGPhD\\YOLO26_AIMGD conda activate yolo26 python train_yolo26.py |
Windows PowerShell
|
Set-Location "D:\\Otherfiles\\AIMGPhD\\YOLO26_AIMGD" conda activate yolo26 python .\\train_yolo26.py |
7.2 第一次不要直接训练 300 个 epoch
建议先做一次 1~3 epoch 测试,确认模型可构建、数据可读取、标签无错误、GPU 正常、输出目录正确。最小测试通过后再恢复正式 epochs。
模型测试设置
|
model.train( data='./datasets/data.yaml', imgsz=640, epochs=2, batch=2, workers=0, device=0, project='runs/smoke_test', name='yolo26' ) |
7.3 训练日志重点看什么
- 模型是否成功解析,参数量和 GFLOPs 是否符合预期。
- GPU_mem:显存占用是否稳定,是否接近上限。
- box_loss、cls_loss、dfl_loss 或自定义损失是否为有限数值。
- Instances:批次中的目标数量是否长期为 0。
- Precision、Recall、mAP50、mAP50-95 是否随训练改善。
- 是否出现 corrupt image、missing label、duplicate label、NaN 或 CUDA out of memory。
7.4 训练输出目录
典型输出
|
runs/train/exp/ ├── args.yaml ├── results.csv ├── results.png ├── confusion_matrix.png ├── confusion_matrix_normalized.png ├── BoxF1_curve.png ├── BoxP_curve.png ├── BoxPR_curve.png ├── BoxR_curve.png ├── labels.jpg ├── train_batch0.jpg ├── val_batch0_labels.jpg ├── val_batch0_pred.jpg └── weights/ ├── best.pt └── last.pt |
文件名可能随版本、任务和自定义分支略有变化。官方性能指标文档说明,PR、P、R、F1 曲线和混淆矩阵是分析阈值、类别混淆和召回情况的重要可视化。
8. 训练指标与结果文件解读
8.1 best.pt 与 last.pt
|
文件 |
用途 |
|
best.pt |
训练过程中验证指标表现最好的权重。通常用于最终验证、实例测试和部署。 |
|
last.pt |
最后一个 epoch 的完整训练检查点。常用于断点续训,不一定是指标最好的模型。 |
8.2 Precision、Recall、mAP50 和 mAP50-95
|
指标 |
直观含义 |
|
Precision |
模型预测出的目标中,有多少是真正正确的。高 Precision 通常意味着误报少。 |
|
Recall |
真实目标中,有多少被模型找出来。高 Recall 通常意味着漏检少。 |
|
mAP50 |
以 IoU=0.50 计算的平均精度,条件相对宽松。 |
|
mAP50-95 |
在 IoU 0.50 到 0.95 多个阈值上取平均,更严格,也更适合比较整体定位质量。 |
8.3 results.csv
results.csv 按 epoch 保存训练损失、验证指标和学习率。它最适合做二次绘图、对比不同实验和判断最佳 epoch。不要只看最后一行;最好比较 best.pt 对应的 epoch、验证 mAP 峰值以及训练/验证损失变化。
8.4 混淆矩阵和曲线
- confusion_matrix.png:查看类别之间的混淆、漏检和背景误报。
- BoxPR_curve.png:观察 Precision 与 Recall 的权衡。
- BoxF1_curve.png:寻找综合 Precision 与 Recall 的较合理置信度阈值。
- BoxP_curve.png / BoxR_curve.png:观察置信度变化对精确率和召回率的影响。
- val_batch*_labels.jpg 与 val_batch*_pred.jpg:直接检查标注和模型预测是否合理。
|
不要只看 mAP 如果真实应用最怕漏检,应重点关注 Recall 和漏检样例;如果误报会触发高成本操作,应重点关注 Precision。 车牌、缺陷、小目标等任务还应检查不同尺寸、遮挡、光照和视角下的失败案例。 |
9. 测试集验证与断点续训
9.1 使用 best.pt 验证 test 集
val_yolo26.py
|
from pathlib import Path from ultralytics import YOLO ROOT = Path(__file__).resolve().parent WEIGHTS = ROOT / 'runs/train/exp/weights/best.pt' DATA_YAML = ROOT / 'datasets/data.yaml' if __name__ == '__main__': model = YOLO(str(WEIGHTS)) metrics = model.val( data=str(DATA_YAML), split='test', imgsz=640, batch=4, workers=0, device=0, plots=True, project=str(ROOT / 'runs/val'), name='exp_test', ) print('mAP50-95:', metrics.box.map) print('mAP50:', metrics.box.map50) print('mAP75:', metrics.box.map75) |
Ultralytics 验证模式支持通过 split="val"、"test" 或 "train" 选择评估的数据集部分。最终论文或项目报告应明确使用的是 val 还是独立 test 集。
9.2 断点续训
resume_yolo26.py
from pathlib import Path
from ultralytics import YOLO
ROOT = Path(__file__).resolve().parent
LAST_PT = ROOT / 'runs/train/exp/weights/last.pt'
if __name__ == '__main__':
if not LAST_PT.is_file():
raise FileNotFoundError(f'未找到断点权重:{LAST_PT}')
model = YOLO(str(LAST_PT))
model.train(resume=True)
resume=True 与“加载 best.pt 后重新 train”不同。真正的断点续训会恢复优化器状态、学习率调度器和已经完成的 epoch。官方文档建议先用 last.pt 初始化模型,再调用 train(resume=True)。
|
不要这样断点续训 不要先用 yolo26-DMSSP.yaml 初始化,再只写 resume=True 却不指定 last.pt。也不要把 best.pt 当作绝对等价的 last.pt;best.pt 更适合微调或推理,而 last.pt 用于恢复中断训练。 |
10. 使用 best.pt 完成实例测试
训练完成后,应使用 best.pt 在完全未参与训练的真实图片和视频上测试。Ultralytics Predict 模式支持图片、目录、视频、网络流和摄像头等多种 source。[8]
10.1 单张图片测试
predict_yolo26.py
from pathlib import Path
from ultralytics import YOLO
ROOT = Path(__file__).resolve().parent
WEIGHTS = ROOT / 'runs/train/exp/weights/best.pt'
SOURCE = ROOT / 'test_images/example.jpg'
if __name__ == '__main__':
if not WEIGHTS.is_file():
raise FileNotFoundError(f'权重不存在:{WEIGHTS}')
if not SOURCE.is_file():
raise FileNotFoundError(f'测试图片不存在:{SOURCE}')
model = YOLO(str(WEIGHTS))
results = model.predict(
source=str(SOURCE),
imgsz=640,
conf=0.25,
device=0,
save=True,
save_txt=True,
save_conf=True,
project=str(ROOT / 'runs/predict'),
name='single_image',
)
for result in results:
print('图片:', result.path)
print('检测框数量:', len(result.boxes))
if result.boxes is not None:
print('类别:', result.boxes.cls.cpu().tolist())
print('置信度:', result.boxes.conf.cpu().tolist())
10.2 测试整个图片文件夹
model.predict(
source='./test_images',
imgsz=640,
conf=0.25,
save=True,
project='runs/predict',
name='image_folder'
)
10.3 视频测试
model.predict(
source='./test_videos/demo.mp4',
imgsz=640,
conf=0.25,
save=True,
project='runs/predict',
name='video_demo'
)
10.4 摄像头实时测试
model.predict(
source=0,
imgsz=640,
conf=0.25,
show=True,
save=False,
device=0
)
source=0 通常表示第一个摄像头;有多个摄像头时可尝试 1、2。服务器或无图形界面环境不适合 show=True,应使用 save=True 或通过 OpenCV 自行处理结果。
10.5 conf 和 imgsz 如何选择
|
设置 |
说明 |
|
conf=0.25 |
常见起点。降低可提高召回但增加误报;提高可减少误报但可能漏检。 |
|
imgsz=640 |
与训练尺寸一致是稳妥起点。小目标可尝试更大尺寸,但推理更慢。 |
|
save_txt=True |
把检测结果保存为 TXT,便于二次统计。 |
|
save_conf=True |
在 TXT 中同时保存置信度,需要与 save_txt=True 一起使用。 |
10.6 查看预测结果对象
for result in results:
print(result.names) # 类别字典
print(result.boxes.xyxy) # 左上角与右下角坐标
print(result.boxes.xywh) # 中心点和宽高
print(result.boxes.conf) # 置信度
print(result.boxes.cls) # 类别编号
annotated = result.plot() # 绘制后的图像数组
11. 常见报错及解决方法
|
现象 |
处理方法 |
|
FileNotFoundError: yolo26-LPRM.yaml |
确认当前工作目录;用 Path(…).resolve() 打印绝对路径;确认定制仓库确实包含 enhance26/yolo26-LPRM.yaml。 |
|
KeyError / NameError: LPRM |
自定义层未定义、未导入或未加入模型解析注册。必须使用完整定制源码,而不是只有 YAML。 |
|
ModuleNotFoundError: ultralytics |
虚拟环境未激活或未安装。进入项目根目录执行 python -m pip install -e .。 |
|
导入了错误的 ultralytics |
执行 python -c "import ultralytics; print(ultralytics.__file__)";卸载冲突包并重新开发模式安装。 |
|
CUDA out of memory |
降低 batch;降低 imgsz;使用更小模型;关闭其他占显存程序;必要时关闭缓存。 |
|
训练一直卡在扫描数据或第一轮 |
Windows 将 workers 设为 0;确认 main 保护;检查网络盘和损坏图片。 |
|
loss 为 NaN |
检查标签坐标和类别;尝试 amp=False;降低学习率;检查自定义算子数值稳定性。 |
|
No labels found / labels missing |
确认 images 与 labels 目录平行、文件同名,data.yaml 指向正确目录。 |
|
Class index exceeds dataset class count |
TXT 中类别编号超出 data.yaml names 范围,或类别未从 0 连续编号。 |
|
exp 目录不断变成 exp2、exp3 |
这是避免覆盖旧实验的正常行为。修改 name,或明确设置 exist_ok=True(注意会复用目录)。 |
|
预训练权重只迁移少量参数 |
自定义结构与权重不兼容。检查日志中的 transferred 数量;必要时从头训练或寻找同结构权重。 |
|
CPU 训练非常慢 |
检查 torch.cuda.is_available();明确 device=0;确认安装的是支持 CUDA 的 PyTorch。 |
11.1 训练前自动检查脚本
check_environment.py
from pathlib import Path
import sys
import torch
import ultralytics
ROOT = Path(__file__).resolve().parent
MODEL = ROOT / 'ultralytics/cfg/models/enhance26/yolo26-LPRM.yaml'
DATA = ROOT / 'datasets/data.yaml'
print('Python:', sys.version)
print('Ultralytics:', ultralytics.__file__)
print('Torch:', torch.__version__)
print('CUDA available:', torch.cuda.is_available())
print('CUDA runtime:', torch.version.cuda)
if torch.cuda.is_available():
print('GPU:', torch.cuda.get_device_name(0))
print('Model YAML:', MODEL, MODEL.exists())
print('Data YAML:', DATA, DATA.exists())
12. 参数调整与训练优化建议
12.1 推荐的实验顺序
12.2 不同硬件的起始建议
|
硬件 |
建议起点 |
说明 |
|
CPU |
imgsz=640, batch=1, workers=0 |
仅适合流程测试或极小模型;正式训练时间可能很长。 |
|
4~6 GB GPU |
imgsz=640, batch=2~4 |
遇到 CUDA out of memory 先降 batch。 |
|
8~12 GB GPU |
imgsz=640, batch=8 左右起步 |
具体取决于模型规模和自定义模块。 |
|
16 GB 以上 GPU |
尝试更大 batch 或 imgsz |
仍需以实际显存监控为准,LPRM 可能改变占用。 |
12.3 小目标检测任务建议
- 确保标注框紧贴目标,过松或偏移会直接限制定位上限。
- 测试更大的 imgsz,例如 800、960,并同步减小 batch。
- 检查训练集是否包含远距离、模糊、夜间、逆光、遮挡和倾斜样本。
- 按视频、车辆或场景分组划分,避免连续帧泄漏到训练和测试两边。
- 关注 Recall 与失败样例,而不是只追求整体 mAP。
- 若使用自定义小目标结构,应与官方基线在完全相同的数据和参数下比较。
12.4 是否应该开启预训练
小数据集通常更适合预训练,但自定义模型能否加载官方权重要看结构兼容性。
建议设计三个可复现实验:官方 YOLO26 预训练微调、自定义结构从头训练、自定义结构加载兼容权重。
用同一数据划分和训练设置比较,才能判断 DMSSP 改进模块 的真实收益。
13. 可直接复制的完整脚本
本节把训练、验证、预测和断点续训脚本集中放在一起。复制后只需修改路径。
13.1 训练脚本 train_yolo26.py
import warnings
from pathlib import Path
warnings.filterwarnings('ignore')
from ultralytics import YOLO
ROOT = Path(__file__).resolve().parent
MODEL_YAML = ROOT / 'ultralytics/cfg/models/26/yolo26.yaml'
DATA_YAML = ROOT / 'datasets/data.yaml'
if __name__ == '__main__':
if not MODEL_YAML.is_file():
raise FileNotFoundError(f'模型配置不存在:{MODEL_YAML}')
if not DATA_YAML.is_file():
raise FileNotFoundError(f'数据配置不存在:{DATA_YAML}')
# 使用自定义 YAML 构建检测模型;默认从随机权重开始训练
model = YOLO(str(MODEL_YAML), task='detect')
# 只有确认结构兼容时再加载预训练权重
# model.load(str(ROOT / 'weights/yolo26n.pt'))
results = model.train(
data=str(DATA_YAML),
cache=False,
imgsz=640,
epochs=30,
batch=4,
close_mosaic=0,
workers=0,
device=0, # 无 NVIDIA GPU 时改为 'cpu'
seed=0,
patience=100,
amp=True,
project=str(ROOT / 'runs/train'),
name='exp_lprm',
exist_ok=False,
plots=True,
)
print('训练结束。结果保存目录:', results.save_dir)
13.2 测试集验证脚本 val_yolo26.py
from pathlib import Path
from ultralytics import YOLO
ROOT = Path(__file__).resolve().parent
WEIGHTS = ROOT / 'runs/train/exp/weights/best.pt'
DATA_YAML = ROOT / 'datasets/data.yaml'
if __name__ == '__main__':
model = YOLO(str(WEIGHTS))
metrics = model.val(
data=str(DATA_YAML),
split='test',
imgsz=640,
batch=4,
workers=0,
device=0,
plots=True,
project=str(ROOT / 'runs/val'),
name='exp_test',
)
print('mAP50-95:', metrics.box.map)
print('mAP50:', metrics.box.map50)
print('mAP75:', metrics.box.map75)
13.3 图片实例测试脚本 predict_yolo26.py
from pathlib import Path
from ultralytics import YOLO
ROOT = Path(__file__).resolve().parent
WEIGHTS = ROOT / 'runs/train/exp/weights/best.pt'
SOURCE = ROOT / 'test_images/example.jpg'
if __name__ == '__main__':
if not WEIGHTS.is_file():
raise FileNotFoundError(f'权重不存在:{WEIGHTS}')
if not SOURCE.is_file():
raise FileNotFoundError(f'测试图片不存在:{SOURCE}')
model = YOLO(str(WEIGHTS))
results = model.predict(
source=str(SOURCE),
imgsz=640,
conf=0.25,
device=0,
save=True,
save_txt=True,
save_conf=True,
project=str(ROOT / 'runs/predict'),
name='single_image',
)
for result in results:
print('图片:', result.path)
print('检测框数量:', len(result.boxes))
if result.boxes is not None:
print('类别:', result.boxes.cls.cpu().tolist())
print('置信度:', result.boxes.conf.cpu().tolist())
13.4 断点续训脚本 resume_yolo26.py
from pathlib import Path
from ultralytics import YOLO
ROOT = Path(__file__).resolve().parent
LAST_PT = ROOT / 'runs/train/exp/weights/last.pt'
if __name__ == '__main__':
if not LAST_PT.is_file():
raise FileNotFoundError(f'未找到断点权重:{LAST_PT}')
model = YOLO(str(LAST_PT))
model.train(resume=True)
13.5 data.yaml 模板
|
path: datasets_xxx train: images/train val: images/val test: images/test names: 0: license_plate |
13.6 一组可直接运行的命令
|
# 1. 激活环境 conda activate yolo26 # 2. 进入项目 cd /d D:\\Otherfiles\\AIMGPhD\\YOLO26_AIMGD #3 . 开始训练 python train_yolo26.py # 4. 验证测试集 python val_yolo26.py # 5. 单张图片测试 python predict_yolo26.py # 6. 中断后恢复训练 python resume_yolo26.py |
14. 训练前后检查清单与参考资料
14.1 训练前检查清单
- 当前虚拟环境已激活。
- python -c "import ultralytics; print(ultralytics.__file__)" 指向当前定制源码。
- torch.cuda.is_available() 与 device 设置符合预期。
- yolo26-DMSSP.yaml 文件存在,自定义 LPRM 模块能够解析。
- data.yaml 路径正确,train、val、test 目录存在。
- 图片和 TXT 标签同名,类别编号与 names 一致。
- 训练集、验证集、测试集没有重复或连续帧泄漏。
- 先完成 1~3 epoch 训练测试。
- 实验 name 能区分模型、尺寸、随机种子和主要参数。
14.2 训练后检查清单
- weights/best.pt 与 last.pt 已保存。
- results.csv 和 results.png 曲线正常,无明显 NaN。
- 查看训练/验证批次可视化,确认标签方向和类别正确。
- 查看混淆矩阵、PR 曲线和失败样例。
- 在独立 test 集运行 model.val(split="test")。
- 在真实图片、视频和复杂场景中测试 best.pt。
- 记录代码版本、数据版本、随机种子和训练参数。
结语
从自己的数据集训练 YOLO26,真正困难的部分往往不是调用 model.train(),而是确保“使用了正确的源码、模型结构能够解析、数据没有泄漏、训练过程可复现、测试样本足够真实”。本文给出的训练代码已经具备核心流程,本文补齐了源码安装、模型检查、数据配置、参数理解、结果分析、断点续训与实例测试。完成这些步骤后,就可以在同一套工程中继续进行结构改进、消融实验、模型压缩和部署导出。
到此为止本文的讲解就结束了,希望对大家对于YOLO26模型理解有帮助,希望本文能够帮助到大家。
YOLO26创新专栏目录:YOLO26涨点改进目录| 含Conv卷积、主干网络、注意力机制、Neck特征融合、检测头、知识蒸馏、模型剪枝、轻量化改进、损失函数、二次创新C2PSA/C3k2等各种顶会顶刊创新改进
YOLO26订阅专栏地址:全新YOLO26独家创新改进,适合高效发表SCI和CCF小论文、大论文写作。