🔥 本文专栏:高性能网络库与HTTP Server 🌸作者主页:努力努力再努力wz
💪 今日博客励志语录:真正能让一个项目变强的,不是堆功能,而是把每一层职责边界想清楚。
思维导图
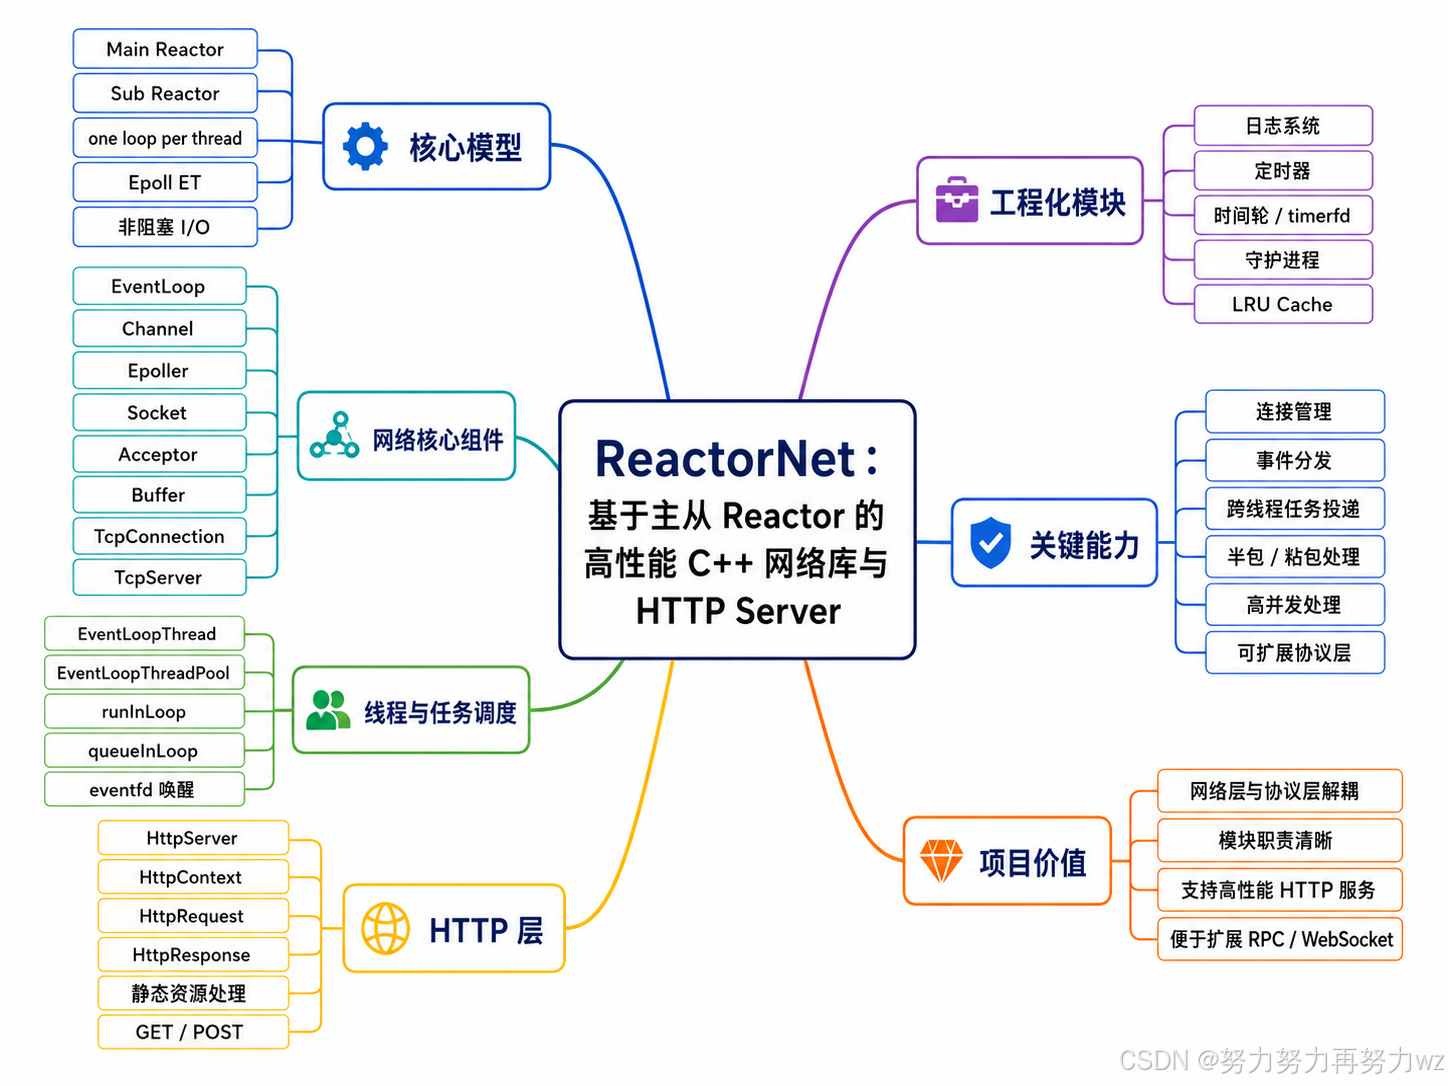
引入
在此前的学习中,我们已经实现过一个基于 epoll 的高并发 HTTP 服务器。
该服务器的核心思路是:主线程通过 epoll 统一监听多个连接的 I/O 事件,当某个连接的读写事件就绪之后,再将对应任务投递给线程池中的工作线程处理。
这种模型已经比传统的“一个连接一个线程”要好很多。
因为它避免了线程数量随着连接数量线性增长的问题,也避免了大量线程阻塞在 read / send 等系统调用上,从而减少线程创建、线程切换以及 CPU 空转带来的开销。
但是,随着继续深入学习网络库的设计,就会发现仅仅实现一个 HTTP Server 其实还不够。
原因在于:HTTP Server 本质上只是一个具体的应用层服务器,而不是一个通用的网络库框架。
例如,在此前的服务器中,网络 I/O、连接管理、HTTP 解析、业务处理、定时器、日志等逻辑可能会耦合在同一套处理流程中。
对于一个学习型项目来说,这种写法可以帮助我们快速跑通 HTTP 请求与响应流程;但是从网络库设计的角度来看,这种结构仍然存在几个问题:
所以,这个项目的目标并不是简单地再写一个 HTTP 服务器,而是进一步抽象出一个类似 Muduo 思想的 C++ 网络库。
也就是说,底层网络库只负责:
连接建立
事件监听
事件分发
非阻塞读写
跨线程任务投递
连接生命周期管理
定时器处理
回调机制
而上层协议层再基于网络库实现 HTTP Server:
HTTP 请求解析
HTTP 响应构造
静态资源访问
GET / POST 处理
LRU 缓存
重定向
错误响应
这样一来,整个项目就从“写一个 HTTP Server”升级为了“实现一个可以支撑 HTTP Server 的 C++ 网络库”。
这便是本文要介绍的项目:
ReactorNet:基于主从 Reactor 的高性能 C++ 网络库与 HTTP Server
从单 Reactor 到主从 Reactor:为什么要进一步拆分线程模型?
在此前的 epoll HTTP Server 中,我们已经知道,I/O 多路复用模型的核心是:
少量线程统一监听大量 fd 的 I/O 就绪事件
当某个 fd 的事件就绪后,线程再去执行对应的读写逻辑。
但是,如果只有一个 Reactor 线程,那么这个线程通常要同时负责:
监听新连接
处理已连接 fd 的读事件
处理已连接 fd 的写事件
执行部分业务逻辑
处理关闭事件
处理超时任务
在低并发或者中等并发场景下,这种模型是可以工作的。
但是当连接数量增加之后,单 Reactor 线程会逐渐成为瓶颈。
因为所有连接的事件分发都集中在一个 epoll_wait 循环中,一旦某些连接的业务处理稍微复杂,或者读写事件比较频繁,就会影响其他连接事件的处理及时性。
因此,我们可以进一步将 Reactor 拆分成两类:
Main Reactor
Sub Reactor
其中:
Main Reactor 只负责监听 listenfd,并接收新连接
Sub Reactor 负责已连接 fd 的 I/O 事件处理和业务回调执行
也就是说,主线程不再直接处理每一个客户端连接的读写事件,而是只负责 accept。
当新连接建立之后,主线程会按照一定策略选择一个 Sub Reactor,并将这个已连接套接字分发给它。
后续该连接的所有读事件、写事件、关闭事件、错误事件以及业务回调,都会在所属的 Sub Reactor 线程中串行执行。
整体流程可以表示为:
客户端连接到来
|
v
Main Reactor 监听 listenfd
|
v
Acceptor 接收新连接,得到 connfd
|
v
TcpServer 选择一个 Sub Reactor
|
v
将 connfd 投递给目标 EventLoop
|
v
目标 Sub Reactor 创建 TcpConnection 并注册 Channel
|
v
后续该连接的 I/O 事件都在所属 Sub Reactor 中处理
从整体上看,这就是典型的:
one loop per thread
即一个线程对应一个 EventLoop,一个 EventLoop 管理一批连接。
主从 Reactor 模型的核心价值
主从 Reactor 模型的核心价值不只是“多开几个线程”。
更重要的是,它让连接和线程之间形成了稳定的归属关系。
也就是说,一个连接一旦被分配给某个 Sub Reactor,那么后续这个连接的 I/O 事件都由这个 Sub Reactor 负责。
这样设计有几个好处。
1. 减少跨线程锁竞争
如果一个连接的读写操作可能被多个线程同时处理,那么就需要给连接对象、输入缓冲区、输出缓冲区等结构加锁。
但是在 one-loop-per-thread 模型下,一个连接只属于一个 EventLoop 线程。
因此,对于这个连接来说,它的读事件、写事件、关闭事件都是在同一个线程中串行执行的。
这就意味着连接内部的大部分状态不需要频繁加锁。
例如:
inputBuffer
outputBuffer
Channel 关注事件
连接状态
HTTP 解析上下文
这些结构都可以在所属 EventLoop 线程中串行访问。
2. 提高缓存局部性
线程切换不仅有调度开销,还会影响 CPU cache 命中率。
如果一个连接今天由线程 A 处理,下一次又被线程 B 处理,那么该连接相关的数据可能不断在不同 CPU 核心之间迁移。
而在 one-loop-per-thread 模型下,一个连接长期绑定在某个 EventLoop 线程上,连接对象、Buffer、HTTP 上下文等数据更容易被当前线程反复访问,从而具有更好的缓存局部性。
3. 连接生命周期更加清晰
在网络服务器中,最容易混乱的问题之一就是连接对象什么时候创建、什么时候销毁、由哪个线程销毁。
如果连接的创建、注册、关闭、销毁分布在多个线程中,就很容易出现悬空指针、重复关闭、事件仍然触发但对象已经释放等问题。
因此,在 ReactorNet 中,连接对象的生命周期需要有明确的归属:
TcpServer 负责维护连接表
TcpConnection 负责描述一个连接
EventLoop 负责执行该连接相关的 I/O 事件
Channel 负责将 fd 上的事件回调到 TcpConnection
同时,为了防止连接在事件处理过程中被提前释放,连接对象通常需要配合 shared_ptr 进行生命周期管理。
ReactorNet 整体模块拆分
整个项目从网络库角度可以拆分为以下几层:
ReactorNet
|
|– reactor
| |– EventLoop
| |– Channel
| |– Epoller
|
|– tcp
| |– Socket
| |– Acceptor
| |– TcpConnection
| |– TcpServer
| |– Buffer
|
|– thread
| |– EventLoopThread
| |– EventLoopThreadPool
|
|– timer
| |– TimerWheel / Timer
|
|– http
| |– HttpServer
| |– HttpRequest
| |– HttpResponse
| |– HttpContext
|
|– log
| |– Logger
|
|– daemon
| |– Daemon
其中,网络库核心层主要包括:
EventLoop
Channel
Epoller
Socket
Acceptor
TcpConnection
TcpServer
Buffer
EventLoopThreadPool
HTTP 层则建立在 TcpServer 之上。
也就是说,TcpServer 并不关心上层协议到底是 HTTP、RPC 还是自定义协议。
它只负责把网络数据读进来,然后通过业务回调交给上层。
EventLoop:一个线程的事件循环
EventLoop 是整个 Reactor 模型中最核心的组件。
它可以理解为:
一个线程级别的事件调度器
或者说:
一个 EventLoop 就代表一个 Reactor 线程
每个 EventLoop 内部通常维护以下内容:
class EventLoop
{
private:
std::thread::id _threadId; // 所属线程 ID
std::unique_ptr<Epoller> _poller; // epoll 封装
std::vector<Channel*> _activeChannels;
int _eventFd; // 跨线程唤醒
std::vector<Functor> _pendingFunctors;
std::mutex _mutex;
bool _quit;
};
它的核心职责包括:
1. 调用 epoll_wait 等待事件就绪
2. 将就绪事件分发给对应 Channel
3. 执行跨线程投递过来的任务
4. 通过 eventfd 完成线程唤醒
5. 处理 timerfd 或时间轮产生的定时任务
EventLoop 的主循环大致如下:
void EventLoop::loop()
{
while (!_quit)
{
_activeChannels.clear();
_poller->poll(&_activeChannels);
for (Channel* channel : _activeChannels)
{
channel->handleEvent();
}
doPendingFunctors();
}
}
从这个结构可以看出,EventLoop 本身并不直接知道某个 fd 是监听套接字,还是客户端连接套接字。
它只知道:
当前有哪些 Channel 就绪了
然后调用这些 Channel 对应的事件处理函数。
Channel:fd、事件和回调的封装
Channel 是 Reactor 模型中非常关键的一层抽象。
在 Linux 中,epoll 监听的是文件描述符 fd 上的事件。
但是在 C++ 网络库中,我们不能只操作裸 fd。
因为一个 fd 背后通常还需要绑定:
关注的事件
实际就绪的事件
读回调
写回调
关闭回调
错误回调
所属 EventLoop
所以,Channel 的本质就是:
fd + 事件 + 回调
一个简化后的 Channel 可以表示为:
class Channel
{
public:
using EventCallback = std::function<void()>;
private:
EventLoop* _loop;
int _fd;
uint32_t _events; // 当前关注的事件
uint32_t _revents; // 当前实际就绪的事件
EventCallback _readCallback;
EventCallback _writeCallback;
EventCallback _closeCallback;
EventCallback _errorCallback;
};
当 epoll_wait 返回后,Epoller 会设置 Channel 的 _revents 字段。
随后 EventLoop 调用:
channel->handleEvent();
Channel 内部再根据实际就绪事件调用不同回调:
void Channel::handleEvent()
{
if ((_revents & EPOLLHUP) && !(_revents & EPOLLIN))
{
if (_closeCallback) _closeCallback();
}
if (_revents & EPOLLERR)
{
if (_errorCallback) _errorCallback();
}
if (_revents & (EPOLLIN | EPOLLPRI | EPOLLRDHUP))
{
if (_readCallback) _readCallback();
}
if (_revents & EPOLLOUT)
{
if (_writeCallback) _writeCallback();
}
}
这里需要注意的是,Channel 本身并不处理业务逻辑。
它只是一个事件分发器。
真正的读写逻辑通常在 TcpConnection 中完成。
Epoller:对 epoll 的简单封装
Epoller 负责封装 Linux 下的 epoll_create、epoll_ctl 和 epoll_wait。
它的核心作用是将底层系统调用封装起来,让 EventLoop 不直接操作 epoll 细节。
Epoller 内部通常会维护:
epoll fd
event 数组
fd 到 Channel 的映射关系
简化结构如下:
class Epoller
{
private:
int _epollFd;
std::vector<epoll_event> _events;
std::unordered_map<int, Channel*> _channels;
public:
void updateChannel(Channel* channel);
void removeChannel(Channel* channel);
void poll(std::vector<Channel*>* activeChannels);
};
其中:
updateChannel 负责添加或修改 fd 关注事件
removeChannel 负责从 epoll 中删除 fd
poll 负责调用 epoll_wait 并返回就绪 Channel
在 ReactorNet 中,Epoller 属于 EventLoop 的底层组件。
也就是说:
EventLoop 负责事件循环
Epoller 负责 epoll 系统调用
Channel 负责 fd 事件回调
三者之间的关系可以表示为:
EventLoop
|
v
Epoller
|
v
epoll_wait 返回就绪事件
|
v
Channel::handleEvent()
Socket:对原生 fd 的 RAII 封装
Socket 用于封装原生套接字 fd。
它主要负责:
创建 socket
bind
listen
accept
设置非阻塞
设置地址复用
关闭写端
析构释放 fd
在 C++ 中,直接到处传递裸 fd 很容易导致资源泄漏或者重复关闭。
因此,可以使用 Socket 对 fd 进行 RAII 管理。
class Socket
{
private:
int _sockfd;
public:
explicit Socket(int sockfd)
: _sockfd(sockfd)
{}
~Socket()
{
::close(_sockfd);
}
int fd() const
{
return _sockfd;
}
void bindAddress(const InetAddress& addr);
void listen();
int accept(InetAddress* peeraddr);
void shutdownWrite();
void setReuseAddr(bool on);
void setNonBlock();
};
Socket 不负责事件监听,也不负责业务处理。
它只负责把系统调用封装成更清晰的 C++ 接口。
Acceptor:只负责接收新连接
Acceptor 是对监听套接字的进一步封装。
它内部通常包含:
Socket listenSocket
Channel acceptChannel
NewConnectionCallback
其中 listenSocket 负责监听,acceptChannel 负责将监听 fd 注册到 Main Reactor 中。
当 listenfd 上有读事件就绪时,说明有新连接到来。
此时 Channel 会触发 Acceptor 的读回调:
void Acceptor::handleRead()
{
InetAddress peerAddr;
int connfd = _listenSocket.accept(&peerAddr);
if (connfd >= 0)
{
if (_newConnectionCallback)
{
_newConnectionCallback(connfd, peerAddr);
}
}
}
需要注意的是,Acceptor 只负责接收新连接。
它不负责创建完整的 TcpConnection,也不负责决定这个连接交给哪个线程。
这些工作应该交给 TcpServer。
也就是说:
Acceptor:负责 accept
TcpServer:负责连接管理和线程分发
这也是网络库中非常重要的职责边界。
Buffer:用户态缓冲区设计
在非阻塞 I/O 中,不能假设一次 read 就能读到完整请求,也不能假设一次 send 就能把所有数据发送出去。
因此,网络库必须为每个连接维护输入缓冲区和输出缓冲区。
在 ReactorNet 中,Buffer 的职责是:
保存从 socket 读取到的用户态数据
支持应用层按需取出数据
保存暂时无法一次性发送完的数据
Buffer 不应该持有 Socket 指针。
因为 Buffer 只是一个数据缓冲区,它不负责执行 I/O 操作。
真正负责协调 Socket 和 Buffer 的是 TcpConnection。
关系如下:
Socket 负责 fd 读写
Buffer 负责用户态数据缓存
TcpConnection 负责把 Socket 中的数据读入 Buffer
TcpConnection 负责把 Buffer 中的数据写回 Socket
简化后的 Buffer 可以表示为:
class Buffer
{
private:
std::vector<char> _buffer;
size_t _readerIndex;
size_t _writerIndex;
public:
size_t readableBytes() const;
size_t writableBytes() const;
const char* peek() const;
void retrieve(size_t len);
void retrieveAll();
void append(const char* data, size_t len);
ssize_t readFd(int fd, int* savedErrno);
};
对于一次读事件来说,流程大致为:
socket 可读
|
v
TcpConnection::handleRead()
|
v
Buffer::readFd()
|
v
数据追加到 inputBuffer
|
v
触发 MessageCallback
对于一次写事件来说,流程大致为:
outputBuffer 中存在未发送数据
|
v
fd 可写
|
v
TcpConnection::handleWrite()
|
v
从 outputBuffer 取数据发送
|
v
如果全部发送完成,关闭写事件关注
TcpConnection:一个连接对象的完整抽象
TcpConnection 是整个网络库中最复杂、也最关键的组件之一。
一个 TcpConnection 对象描述一个已经建立好的 TCP 连接。
它内部通常包含:
所属 EventLoop
连接名称
连接状态
Socket
Channel
输入缓冲区
输出缓冲区
连接建立回调
消息到达回调
写完成回调
关闭回调
简化结构如下:
class TcpConnection : public std::enable_shared_from_this<TcpConnection>
{
private:
EventLoop* _loop;
std::string _name;
State _state;
std::unique_ptr<Socket> _socket;
std::unique_ptr<Channel> _channel;
Buffer _inputBuffer;
Buffer _outputBuffer;
ConnectionCallback _connectionCallback;
MessageCallback _messageCallback;
WriteCompleteCallback _writeCompleteCallback;
CloseCallback _closeCallback;
};
TcpConnection 的核心职责可以概括为:
1. 管理一个连接的状态
2. 处理该连接上的读事件
3. 处理该连接上的写事件
4. 维护输入缓冲区和输出缓冲区
5. 触发上层业务回调
6. 处理连接关闭与资源释放
TcpConnection 的读事件处理
当客户端发送数据后,连接 fd 上会触发读事件。
此时调用链大致如下:
epoll_wait 返回读事件
|
v
EventLoop 遍历 activeChannels
|
v
Channel::handleEvent()
|
v
TcpConnection::handleRead()
|
v
Socket 数据读取到 inputBuffer
|
v
触发 messageCallback
对应代码逻辑大致为:
void TcpConnection::handleRead()
{
int savedErrno = 0;
ssize_t n = _inputBuffer.readFd(_channel->fd(), &savedErrno);
if (n > 0)
{
_messageCallback(shared_from_this(), &_inputBuffer);
}
else if (n == 0)
{
handleClose();
}
else
{
handleError();
}
}
这里需要注意的是,TcpConnection 并不直接处理具体协议。
它只是把读取到的数据放进 Buffer,然后交给上层回调。
如果上层是 HTTP Server,那么 messageCallback 中就会进行 HTTP 解析。
如果上层是自定义协议,那么也可以在 messageCallback 中完成自定义报文解析。
这就实现了网络库和协议层的解耦。
TcpConnection 的写事件处理
在非阻塞 I/O 中,发送数据不能简单地认为一次 send 一定可以全部发送完成。
如果内核发送缓冲区空间不足,send 可能只发送一部分数据,甚至返回 EAGAIN。
因此,TcpConnection 需要维护 outputBuffer。
发送数据时大致分为两种情况:
1. 如果当前没有积压数据,可以先尝试直接 send
2. 如果没有发送完,剩余数据追加到 outputBuffer,并关注 EPOLLOUT
当 fd 再次可写时,触发写事件:
void TcpConnection::handleWrite()
{
if (_channel->isWriting())
{
ssize_t n = ::write(_channel->fd(),
_outputBuffer.peek(),
_outputBuffer.readableBytes());
if (n > 0)
{
_outputBuffer.retrieve(n);
if (_outputBuffer.readableBytes() == 0)
{
_channel->disableWriting();
if (_writeCompleteCallback)
{
_loop->queueInLoop(
std::bind(_writeCompleteCallback, shared_from_this())
);
}
}
}
}
}
当 outputBuffer 中的数据全部发送完成之后,就可以取消对写事件的关注。
因为 EPOLLOUT 通常比较容易触发,如果一直关注写事件,很容易导致 epoll 频繁返回可写事件,从而造成无意义的事件唤醒。
runInLoop 与 queueInLoop:跨线程任务投递
在主从 Reactor 模型中,一个非常关键的问题是:
如果当前线程想让另一个 EventLoop 线程执行某个任务,应该怎么办?
例如,Main Reactor 接收到了一个新连接,但是这个连接最终要交给某个 Sub Reactor 管理。
此时,Main Reactor 不能直接在自己的线程中操作目标 Sub Reactor 的内部结构。
正确做法是:
把任务投递到目标 EventLoop 的任务队列中
然后唤醒目标 EventLoop
让目标 EventLoop 在线程内执行这个任务
这就是 runInLoop 和 queueInLoop 的作用。
runInLoop
runInLoop 的语义是:
如果当前线程就是 EventLoop 所属线程,则直接执行任务;
否则,将任务投递到该 EventLoop 的任务队列中。
void EventLoop::runInLoop(Functor cb)
{
if (isInLoopThread())
{
cb();
}
else
{
queueInLoop(std::move(cb));
}
}
queueInLoop
queueInLoop 的语义是:
无论当前是否在 EventLoop 所属线程,都先将任务加入任务队列。
必要时唤醒 EventLoop。
void EventLoop::queueInLoop(Functor cb)
{
{
std::lock_guard<std::mutex> lock(_mutex);
_pendingFunctors.push_back(std::move(cb));
}
if (!isInLoopThread())
{
wakeup();
}
}
这里为什么需要唤醒?
因为目标 EventLoop 线程可能正阻塞在 epoll_wait 中。
如果没有任何 I/O 事件到来,它就无法及时执行任务队列中的任务。
所以我们需要借助 eventfd 来唤醒它。
eventfd:跨线程唤醒机制
eventfd 是 Linux 提供的一种事件通知机制。
在 ReactorNet 中,每个 EventLoop 内部会创建一个 eventfd,并将其封装成一个 Channel 注册到 epoll 中。
当其他线程向该 EventLoop 投递任务时,会向 eventfd 写入数据。
这样一来,EventLoop 所在线程阻塞在 epoll_wait 时,就会因为 eventfd 可读而被唤醒。
整体流程如下:
线程 A 向线程 B 的 EventLoop 投递任务
|
v
任务加入 pendingFunctors
|
v
向线程 B 的 eventfd 写入 8 字节数据
|
v
线程 B 的 epoll_wait 返回
|
v
处理 eventfd 读事件
|
v
执行 pendingFunctors 中的任务
eventfd 的意义在于:
把“跨线程任务通知”也统一纳入 epoll 事件循环
这样 EventLoop 就可以同时处理:
普通 socket I/O 事件
timerfd 定时事件
eventfd 唤醒事件
这也是 Reactor 模型中非常优雅的一点。
EventLoopThread 与 EventLoopThreadPool:Sub Reactor 线程池
在主从 Reactor 模型中,Main Reactor 通常运行在主线程中,而 Sub Reactor 运行在线程池中。
因此,我们需要对 EventLoop 线程进行封装。
一个 EventLoopThread 通常负责:
创建一个新线程
在线程函数中创建 EventLoop
启动 EventLoop::loop()
对外返回该线程中的 EventLoop 指针
需要注意的是,EventLoop 对象必须属于它所在的线程。
因此,EventLoopThread 在启动线程后,需要通过互斥锁和条件变量同步,确保 EventLoop 创建完成之后,再返回给外部使用。
大致流程如下:
主线程调用 startLoop()
|
v
创建子线程
|
v
子线程中构造 EventLoop
|
v
通知主线程 EventLoop 已经创建完成
|
v
主线程拿到 EventLoop*
|
v
子线程进入 loop()
EventLoopThreadPool 则负责管理多个 EventLoopThread。
它内部通常维护:
baseLoop
线程数量
EventLoopThread 数组
EventLoop 指针数组
next 下标
当 TcpServer 收到一个新连接时,可以通过轮询策略选择一个 Sub Reactor:
EventLoop* EventLoopThreadPool::getNextLoop()
{
EventLoop* loop = _baseLoop;
if (!_loops.empty())
{
loop = _loops[_next];
++_next;
if (_next >= _loops.size())
{
_next = 0;
}
}
return loop;
}
这样就实现了新连接在多个 Sub Reactor 之间的负载分发。
TcpServer:整合所有模块的服务器入口
TcpServer 是网络库对外使用的核心类。
它将前面提到的模块全部组合起来:
EventLoop
Acceptor
EventLoopThreadPool
TcpConnection
连接表
各类回调函数
TcpServer 的职责包括:
1. 创建 Acceptor 并监听新连接
2. 启动 Sub Reactor 线程池
3. 为新连接选择一个 EventLoop
4. 创建 TcpConnection 对象
5. 维护连接表
6. 设置连接回调、消息回调、写完成回调
7. 处理连接关闭和销毁
新连接建立流程如下:
listenfd 可读
|
v
Acceptor::handleRead()
|
v
accept 得到 connfd
|
v
TcpServer::newConnection()
|
v
选择一个 Sub Reactor
|
v
创建 TcpConnection
|
v
保存到连接表
|
v
将连接建立任务投递到目标 EventLoop
|
v
目标 EventLoop 注册 connfd 对应的 Channel
简化代码如下:
void TcpServer::newConnection(int sockfd, const InetAddress& peerAddr)
{
EventLoop* ioLoop = _threadPool->getNextLoop();
std::string connName = _name + "#" + std::to_string(_nextConnId++);
TcpConnectionPtr conn(new TcpConnection(ioLoop, connName, sockfd));
_connections[connName] = conn;
conn->setConnectionCallback(_connectionCallback);
conn->setMessageCallback(_messageCallback);
conn->setWriteCompleteCallback(_writeCompleteCallback);
conn->setCloseCallback(
std::bind(&TcpServer::removeConnection, this, std::placeholders::_1)
);
ioLoop->runInLoop(
std::bind(&TcpConnection::connectEstablished, conn)
);
}
这里最关键的是:
TcpConnection 的初始化与 Channel 注册必须在所属 EventLoop 线程中完成。
这可以避免跨线程直接修改 Sub Reactor 的 epoll 结构。
连接关闭与生命周期管理
连接关闭是网络库中非常容易出错的一部分。
因为连接关闭并不只是简单地调用 close(fd)。
它涉及:
从 epoll 中移除 Channel
关闭 socket
从 TcpServer 连接表中删除 TcpConnection
确保事件处理过程中连接对象不会提前析构
确保销毁逻辑在所属 EventLoop 线程中执行
所以,在 TcpConnection 中通常需要使用 shared_from_this() 延长对象生命周期。
例如在读事件回调中:
_messageCallback(shared_from_this(), &_inputBuffer);
这样可以确保业务回调执行期间,当前连接对象不会被提前释放。
关闭流程大致如下:
客户端关闭连接 / 服务器主动关闭 / 发生错误
|
v
TcpConnection::handleClose()
|
v
关闭 Channel 关注事件
|
v
触发 closeCallback
|
v
TcpServer::removeConnection()
|
v
从连接表中删除
|
v
投递 connectDestroyed 到所属 EventLoop
|
v
移除 Channel
|
v
连接对象最终释放
这个流程的核心是:
TcpServer 负责连接表
TcpConnection 负责连接状态
EventLoop 负责在线程内执行销毁动作
职责边界清晰之后,连接生命周期就不会混乱。
HTTP 层:基于 TcpServer 实现 HttpServer
有了 TcpServer 之后,HTTP Server 就可以作为上层协议模块实现。
HTTP 层主要包括:
HttpServer
HttpRequest
HttpResponse
HttpContext
其中:
HttpRequest:描述 HTTP 请求
HttpResponse:描述 HTTP 响应
HttpContext:保存 HTTP 解析上下文
HttpServer:组合 TcpServer,对外提供 HTTP 服务
TcpServer 只负责网络收发,而 HttpServer 负责设置 messageCallback。
当 TcpConnection 读到数据后,会触发 HttpServer 的消息处理函数:
TcpConnection::handleRead()
|
v
messageCallback
|
v
HttpServer::onMessage()
|
v
HttpContext 解析 Buffer 中的数据
|
v
得到完整 HttpRequest
|
v
业务回调生成 HttpResponse
|
v
TcpConnection::send()
HttpContext:为什么需要 HTTP 解析上下文?
HTTP 请求并不一定一次性完整到达。
例如一个 HTTP 请求可能被拆成多次 TCP 报文到达:
第一次读到:
GET /index
第二次读到:
.html HTTP/1.1\\r\\nHost: xxx\\r\\n\\r\\n
如果没有上下文,就无法知道当前解析到了哪一步。
所以,HttpContext 需要保存解析状态。
常见状态包括:
解析请求行
解析请求头
解析请求体
解析完成
解析错误
可以表示为:
enum HttpRequestParseState
{
kExpectRequestLine,
kExpectHeaders,
kExpectBody,
kGotAll
};
解析流程如下:
Buffer 中存在数据
|
v
解析请求行
|
v
解析请求头
|
v
根据 Content-Length 判断是否需要请求体
|
v
解析请求体
|
v
得到完整 HttpRequest
HttpContext 的意义在于:
让每个连接都拥有独立的 HTTP 解析状态
因为不同连接的数据到达进度是不一样的。
有的连接可能已经收到了完整请求,有的连接可能只收到了一半请求行。
所以 HTTP 上下文必须跟随 TcpConnection 保存,而不能作为全局变量。
HttpRequest:描述请求报文
HttpRequest 主要保存客户端请求中的关键信息:
请求方法
请求路径
HTTP 版本
请求头
请求体
查询参数
简化结构如下:
class HttpRequest
{
private:
std::string _method;
std::string _path;
std::string _version;
std::unordered_map<std::string, std::string> _headers;
std::string _body;
public:
void setMethod(const std::string& method);
void setPath(const std::string& path);
void setVersion(const std::string& version);
void addHeader(const std::string& key, const std::string& value);
std::string getHeader(const std::string& key) const;
const std::string& method() const;
const std::string& path() const;
const std::string& body() const;
};
请求行示例:
GET /index.html HTTP/1.1
解析后可以得到:
method = GET
path = /index.html
version = HTTP/1.1
HttpResponse:构造响应报文
HttpResponse 负责构造服务端返回给客户端的 HTTP 响应。
它通常包含:
状态码
状态描述
响应头
响应体
是否关闭连接
一个 HTTP 响应大致如下:
HTTP/1.1 200 OK
Content-Type: text/html
Content-Length: 1024
Connection: keep-alive
<html>…</html>
HttpResponse 最终需要序列化到 Buffer 中,然后通过 TcpConnection 发送出去:
void HttpResponse::appendToBuffer(Buffer* output) const
{
output->append("HTTP/1.1 " + std::to_string(_statusCode) + " " + _statusMessage + "\\r\\n");
for (const auto& header : _headers)
{
output->append(header.first + ": " + header.second + "\\r\\n");
}
output->append("\\r\\n");
output->append(_body);
}
这样,HTTP 层只需要负责构造响应内容,而真正的网络发送仍然交给 TcpConnection。
静态资源访问与 LRU Cache
对于 HTTP Server 来说,GET 请求最常见的场景就是访问静态资源。
例如:
/index.html
/css/style.css
/js/main.js
/image/logo.png
如果每次请求都直接从磁盘读取文件,会产生较多 I/O 开销。
因此,可以在 HTTP 层增加 LRU Cache,用于缓存热点静态资源。
LRU 的核心思想是:
最近访问的数据保留
长时间未访问的数据淘汰
对于静态资源来说:
第一次访问 index.html:
从磁盘读取,并放入缓存
后续再次访问 index.html:
直接从 LRU Cache 中获取
整体流程如下:
HTTP GET 请求
|
v
根据 URL 找到本地资源路径
|
v
检查 LRU Cache
|
+– 命中:直接构造响应
|
+– 未命中:从磁盘读取文件,并加入缓存
LRU Cache 可以使用:
哈希表 + 双向链表
其中:
哈希表:快速定位缓存节点
双向链表:维护访问顺序
定时器:慢连接与空闲连接清理
在网络服务器中,不能只考虑正常客户端。
还要考虑一些异常场景,例如:
客户端建立连接后长期不发送数据
客户端只发送一半请求,然后一直不继续发送
客户端读取响应非常慢
大量空闲连接占用服务器资源
这类问题如果不处理,就可能导致服务器连接资源被长期占用。
因此,ReactorNet 中需要引入定时器机制,用于处理连接超时。
在 Linux 中,定时器可以通过 timerfd 统一纳入 epoll 事件循环。
整体思路如下:
timerfd 到期
|
v
EventLoop 被唤醒
|
v
执行定时任务
|
v
检查连接是否超时
|
v
关闭长期空闲或异常连接
如果使用时间轮,则可以将连接按照过期时间挂载到不同槽位中。
每次 timerfd 触发时,时间轮向前推进一个槽位,并处理该槽位中的超时任务。
时间轮的意义在于:
避免每次都遍历所有连接
对于大量连接的服务器来说,这比简单全量扫描更适合高并发场景。
日志系统:还原多线程网络程序的执行现场
在多线程网络程序中,调试难度远高于普通单线程程序。
因为多个 Reactor 线程会并发处理不同连接的事件,执行流是交错的。
很多问题并不是稳定复现的,而是和时序有关。
例如:
某个连接什么时候建立?
被分配到了哪个 EventLoop?
什么时候触发读事件?
读到了多少字节?
HTTP 是否解析成功?
响应是否发送完成?
连接为什么关闭?
这些问题单靠断点调试很难还原。
因此,日志对于网络库非常重要。
在 ReactorNet 中,日志系统主要用于记录:
服务器启动
监听地址和端口
新连接建立
连接分发到哪个 EventLoop
读写事件触发
HTTP 请求解析状态
响应发送
连接关闭
错误信息
守护进程启动状态
日志的价值并不只是“打印信息”。
更重要的是:
在多线程和网络场景中还原真实执行流
也就是记录案发现场。
守护进程:让服务器在后台长期运行
对于一个服务端程序来说,最终通常不是在终端中前台运行,而是作为后台服务长期运行。
因此,可以为 TcpServer 或启动入口增加守护进程支持。
守护进程的基本流程通常包括:
fork 创建子进程
父进程退出
子进程调用 setsid 脱离原会话
忽略或处理相关信号
重定向标准输入输出错误
设置工作目录或使用绝对路径
设置 umask
其中比较关键的是 setsid()。
它的作用是让当前进程创建新的会话,并脱离原来的控制终端。
也就是说,服务器进程不再依赖当前终端窗口。
如果终端关闭,服务器仍然可以继续运行。
守护进程流程可以表示为:
启动服务器
|
v
fork()
|
+– 父进程退出
|
v
子进程 setsid()
|
v
重定向标准输入输出
|
v
启动 TcpServer
|
v
EventLoop::loop()
需要注意的是,如果程序变成守护进程后修改了工作目录,那么相对路径可能会失效。
因此,在处理日志路径、静态资源路径、配置路径时,最好使用绝对路径,或者在程序启动阶段统一转换路径。
ReactorNet 一次请求的完整处理流程
接下来,我们把前面的模块串起来,看一次 HTTP 请求在 ReactorNet 中的完整处理路径。
1. 服务器启动
main()
|
v
创建 EventLoop baseLoop
|
v
创建 HttpServer / TcpServer
|
v
设置线程数
|
v
设置 HTTP 请求处理回调
|
v
启动 TcpServer
|
v
baseLoop.loop()
2. 新连接建立
客户端发起连接
|
v
Main Reactor 中 listenfd 可读
|
v
Acceptor::handleRead()
|
v
accept 得到 connfd
|
v
TcpServer::newConnection()
|
v
选择一个 Sub Reactor
|
v
创建 TcpConnection
|
v
保存连接表
|
v
投递 connectEstablished 到目标 EventLoop
|
v
目标 EventLoop 注册连接 Channel
3. 请求数据到达
客户端发送 HTTP 请求
|
v
connfd 读事件就绪
|
v
Sub Reactor epoll_wait 返回
|
v
Channel::handleEvent()
|
v
TcpConnection::handleRead()
|
v
数据读入 inputBuffer
|
v
触发 HttpServer::onMessage()
4. HTTP 解析与响应构造
HttpContext 从 Buffer 中解析请求
|
v
解析请求行
|
v
解析请求头
|
v
解析请求体
|
v
得到完整 HttpRequest
|
v
根据 method + path 处理业务
|
v
构造 HttpResponse
5. 响应发送
HttpResponse 序列化到 Buffer
|
v
TcpConnection::send()
|
v
尝试直接 write
|
+– 全部发送完成:触发写完成回调
|
+– 未发送完成:剩余数据放入 outputBuffer,并关注 EPOLLOUT
6. 连接关闭
客户端关闭 / 服务端关闭 / 超时 / 错误
|
v
TcpConnection::handleClose()
|
v
触发 closeCallback
|
v
TcpServer 从连接表中移除连接
|
v
所属 EventLoop 移除 Channel
|
v
释放 TcpConnection
与此前 epoll HTTP Server 的区别
此前实现的 epoll HTTP Server 更偏向于:
围绕 HTTP 服务本身实现一个可运行服务器
而 ReactorNet 更偏向于:
先实现一个通用网络库,再基于网络库实现 HTTP Server
两者的区别可以总结为:
| 核心目标 | 实现 HTTP 服务器 | 实现 C++ 网络库 + HTTP Server |
| 线程模型 | epoll + 线程池 | Main Reactor + Sub Reactor |
| 连接归属 | 相对弱 | one-loop-per-thread |
| 模块拆分 | 偏应用层 | 网络层与协议层解耦 |
| 事件抽象 | 直接操作 epoll 事件较多 | Channel 封装 fd + 事件 + 回调 |
| 连接对象 | 可运行即可 | TcpConnection 管理完整生命周期 |
| 跨线程任务 | 线程池任务分发 | runInLoop / queueInLoop + eventfd |
| HTTP 层 | 和服务器耦合较多 | 基于 TcpServer 上层封装 |
| 工程化 | 基础服务器 | 日志、定时器、守护进程、缓存等模块更完整 |
从学习路径上看,此前的 epoll HTTP Server 更像是第一阶段:
理解 epoll + 非阻塞 I/O + HTTP 服务器基本流程
而 ReactorNet 则是第二阶段:
理解高性能网络库的分层设计和 Reactor 工程化实现
项目目录结构
ReactorNet 的目录结构可以设计为:
ReactorNet
├── include
│ └── reactornet
│ ├── http
│ │ ├── HttpContext.h
│ │ ├── HttpRequest.h
│ │ ├── HttpResponse.h
│ │ └── HttpServer.h
│ ├── net
│ │ ├── reactor
│ │ │ ├── Channel.h
│ │ │ ├── Epoller.h
│ │ │ └── EventLoop.h
│ │ ├── server
│ │ │ └── TcpServer.h
│ │ ├── tcp
│ │ │ ├── Acceptor.h
│ │ │ ├── Buffer.h
│ │ │ ├── Socket.h
│ │ │ └── TcpConnection.h
│ │ └── timer
│ │ └── TimerWheel.h
│ ├── log
│ │ └── Logger.h
│ └── daemon
│ └── Daemon.h
├── src
│ ├── http
│ ├── net
│ ├── log
│ └── daemon
├── examples
├── tests
├── CMakeLists.txt
└── README.md
这种目录结构的好处是:
网络库核心模块集中在 net 中
HTTP 协议层独立放在 http 中
日志、守护进程等工程化模块独立管理
examples 用于展示如何使用网络库
tests 用于后续模块测试
wrk 压测方式
服务器启动后,可以使用 wrk 对 HTTP Server 进行压力测试。
例如:
wrk -t4 -c1000 -d30s http://服务器IP:端口/
参数含义如下:
-t4 使用 4 个压测线程
-c1000 保持 1000 个并发连接
-d30s 持续压测 30 秒
压测时需要关注:
Requests/sec
Latency
Transfer/sec
Socket errors
Non-2xx or 3xx responses
其中,Requests/sec 可以反映吞吐能力,Latency 可以反映请求响应延迟。
不过,压测结果不仅取决于服务器代码,还会受到机器配置、网络环境、静态资源大小、线程数量、日志开销、系统参数等因素影响。
因此,压测的核心意义并不是单纯追求一个数字,而是通过测试观察服务器在高并发场景下是否稳定,以及瓶颈主要出现在什么位置。
项目总结
ReactorNet 的核心并不是简单地调用 epoll 写一个服务器,而是围绕 Reactor 模型重新组织整个网络库的结构。
从整体上看,这个项目主要完成了以下工作:
1. 基于 epoll ET 和非阻塞 I/O 实现事件驱动网络模型
2. 使用 Main Reactor + Sub Reactor 拆分监听连接和已连接 fd 的 I/O 处理
3. 封装 EventLoop、Channel、Epoller、Socket、Acceptor 等网络库基础组件
4. 使用 TcpConnection 管理连接状态、输入输出缓冲区和连接生命周期
5. 使用 TcpServer 统一管理连接表、线程池和回调注册
6. 使用 EventLoopThreadPool 实现 one-loop-per-thread 的 Sub Reactor 线程池
7. 使用 runInLoop / queueInLoop + eventfd 实现跨线程任务投递与唤醒
8. 基于 Buffer 处理非阻塞 I/O 下的半包、粘包和未完成写入问题
9. 在网络库之上实现 HTTP Server,包括请求解析、响应构造和静态资源访问
10. 引入 LRU Cache 缓存热点静态资源
11. 引入 timerfd / 时间轮处理空闲连接和慢请求
12. 增加日志系统用于记录多线程网络程序的执行流
13. 支持守护进程模式,使服务器可以后台长期运行
通过这个项目,可以更加清晰地理解一个高性能 C++ 网络库的核心设计思想:
不要让所有模块混在一起,而是要让每一层只做自己该做的事。
EventLoop 只负责事件循环。
Epoller 只负责 epoll 系统调用。
Channel 只负责 fd 事件和回调。
Socket 只负责套接字资源管理。
Acceptor 只负责接收新连接。
TcpConnection 只负责一个连接的完整生命周期。
TcpServer 只负责服务器层面的连接管理和线程分发。
HttpServer 只负责 HTTP 协议层逻辑。
当这些模块职责清晰之后,整个服务器的结构才会真正稳定下来。
认识
在学习网络编程的过程中,最开始可能只关注:
socket 怎么创建?
epoll 怎么用?
HTTP 响应怎么返回?
但是当真正开始设计一个网络库时,关注点就会逐渐变化为:
事件如何抽象?
连接如何管理?
线程如何归属?
任务如何跨线程投递?
缓冲区如何处理半包和未完成写?
连接生命周期如何保证安全?
协议层如何和网络层解耦?
这也是从“会写一个服务器”到“理解网络库设计”的关键一步。
ReactorNet 项目正是围绕这些问题展开的。
它不是简单地堆功能,而是通过主从 Reactor、one-loop-per-thread、Channel 回调分发、TcpConnection 生命周期管理、Buffer 缓冲区、HTTP 协议层、定时器、日志和守护进程等模块,将一个高性能 C++ 网络服务器逐步拆解成清晰、可复用、可扩展的网络库框架。
到这里,基于主从 Reactor 的 C++ 网络库与 HTTP Server 的整体设计就基本梳理完成了。
后续如果继续扩展,还可以在这个网络库之上支持:
RPC 框架
WebSocket
异步日志
协程调度
更完善的路由系统
配置文件加载
更细粒度的性能统计
而这些扩展的基础,正是本文实现的 ReactorNet 网络库框架。
源码
高性能网络库与HTTP Server
结语
那么这就是本篇文章的全部内容,我会持续更新,希望你能够多多关注,如果本文有帮助到你的话,还请三连加关注,你的支持就是我创作的最大动力!